
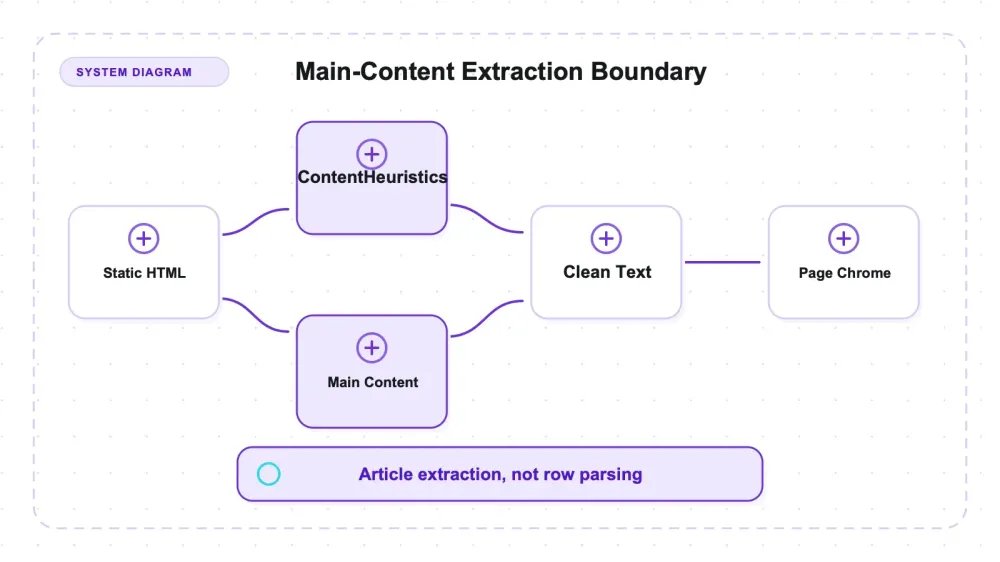
trafilatura är ett Python-baserat innehållsverktyg utan webbläsare. I de märkta testfallen i den här artikeln är dess enda konkurrent med samma HTML och jämförbar extraktionskvalitet Mozilla Readability: trafilatura släppte igenom en av 17 annoterade boilerplate-enheter, medan Readability släppte igenom fem. Webbläsarbaserade verktyg nämns här bara i samband med driftmiljö och testades inte kvalitetsmässigt på de här sidorna.
Dess kärnuppgift är att extrahera huvudinnehåll: HTML in, artikelliknande text och metadata ut, medan sidans dekor och kringelement filtreras bort med heuristik. Den kan serialisera resultat som JSON och i andra format, men den skapar inte ett användardefinierat radschema eller upprepade strukturerade katalogposter. Version 2.1.0 testades. Den kör inte JavaScript, och jämförelsen med Readability visar en avvägning mellan precision och bevarat innehåll snarare än en generell seger.
Var trafilatura passar in, och vad den inte försöker göra
trafilatura beskriver sig som ett Python- och kommandoradsverktyg för att samla in text och metadata på webben — crawlning, scraping, extrahering — med utdata i CSV, JSON, HTML, Markdown, TXT eller XML. Det är en bred beskrivning. I praktiken är det som verktyget faktiskt är bra på snävare och tydligare: det tar ett HTML-dokument och returnerar huvudinnehållet, avskalat från sidans övriga dekor.
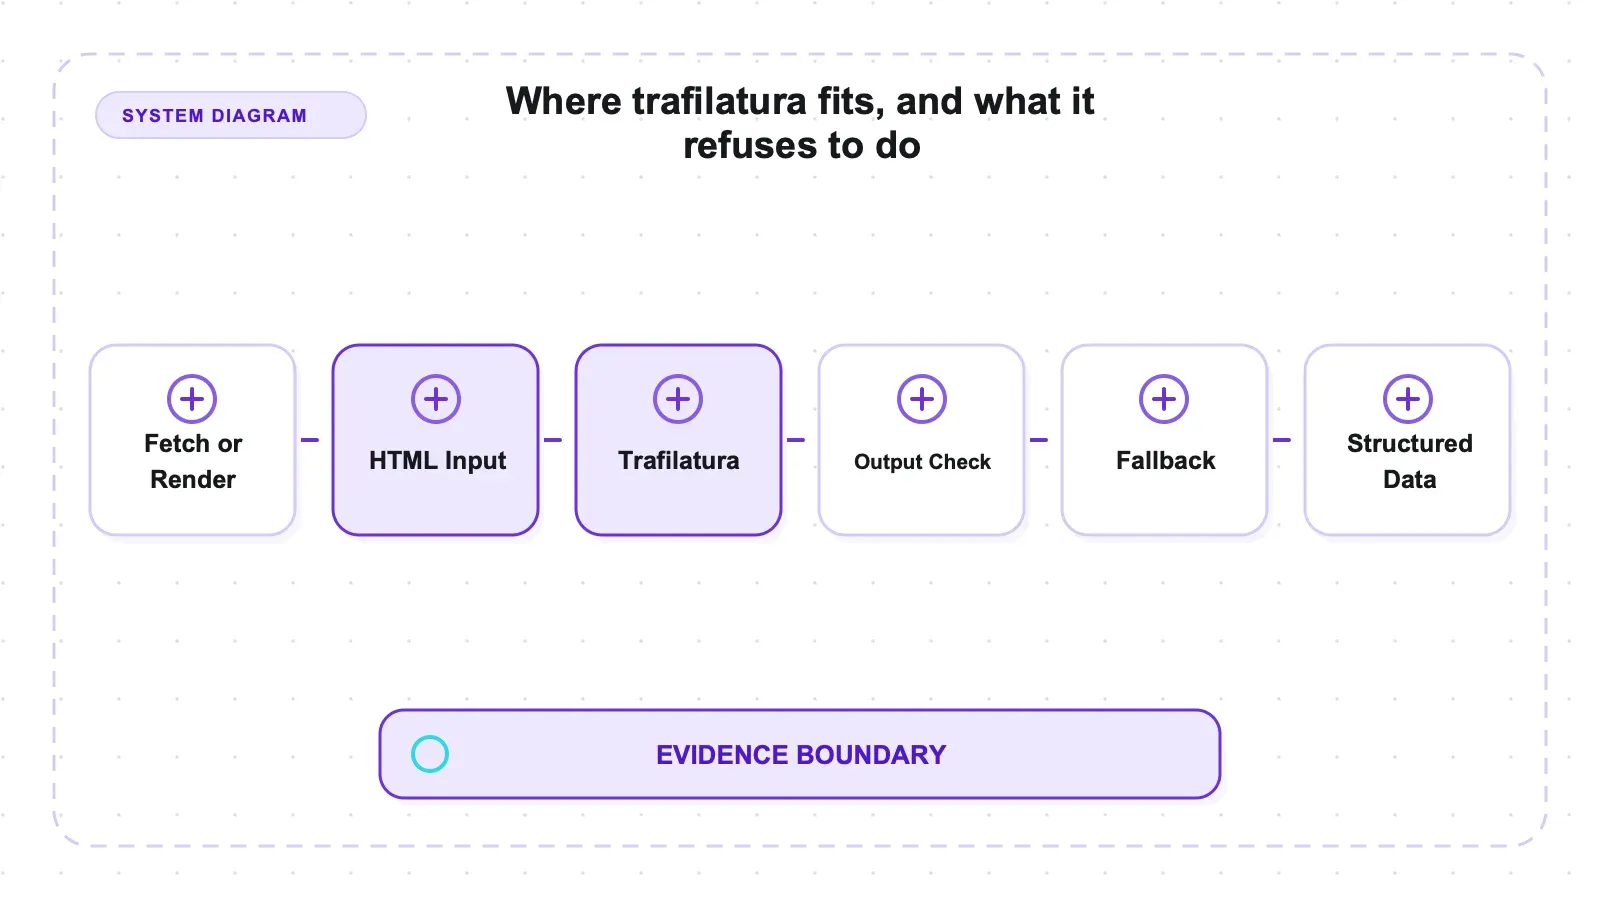
Här är den mentala modellen, eftersom den förklarar både styrkan och gränsen. De flesta scrapers du pekar mot en sida är selector-baserade — du säger "ta elementet med klassen product-price", och de returnerar det som ligger där. trafilatura fungerar tvärtom. Den läser hela dokumentet och avgör vilka block som faktiskt är artikeln och vilka som bara är boilerplate, med hjälp av innehållsheuristik i stället för en selector du själv skrivit. Därför behöver den inga per-sajt-regler för att städa en sida. Och det är också därför den inte kan ge dig en strukturerad katalog: det finns inget schema, inga typade rader, bara "här är den meningsfulla texten". Det är en extraherare, inte en parser du riktar in.
Den kräver heller ingen separat nedladdad webbläsarmiljö. Beroendeträdet innehåller plattformspaket som lxml, så “ingen webbläsarnedladdning” ska inte blandas ihop med en installation helt utan källkod eller native-komponenter.
Installation: liten beroendeprofil, ingen webbläsarinstallation
pip install trafilatura i en ny virtuell miljö på Python 3.14 installerade 17 paket; det största registrerade hjulet var lxml på 8,6 MB, enligt pip-install-trafilatura.log. Ingen separat webbläsarinstallation eller något efterföljande webbläsarkommando krävdes.
För jämförelsens skull behövde Scrapling-paketet i samma forskningsbas fyra separata pip-körningar för att få sina fetchers att fungera och landade på 26 paket, varav två var Playwright-drivrutinshjul på 42,2 MB (tools/scrapling/artifacts/logs/pip-install-scrapling.log) — och då är inte ens någon webbläsarbinär nedladdad ännu. Crawlee-paketet mätte den separata Chromium-nedladdningen till ungefär 81,7 MiB (tools/crawlee/research-materials.md). De verktygen gör mer, så det här är ingen rättvis kapplöpning när det gäller kapacitet; det visar bara vad din disk och din CI-cache faktiskt får hantera. Och versionen som pip gav mig (2.1.0) matchar den aktuella releasen, så det finns ingen asterisk om att testet skulle ha gjorts på något föråldrat.
Praktiskt test: vad extraheraren faktiskt gav tillbaka
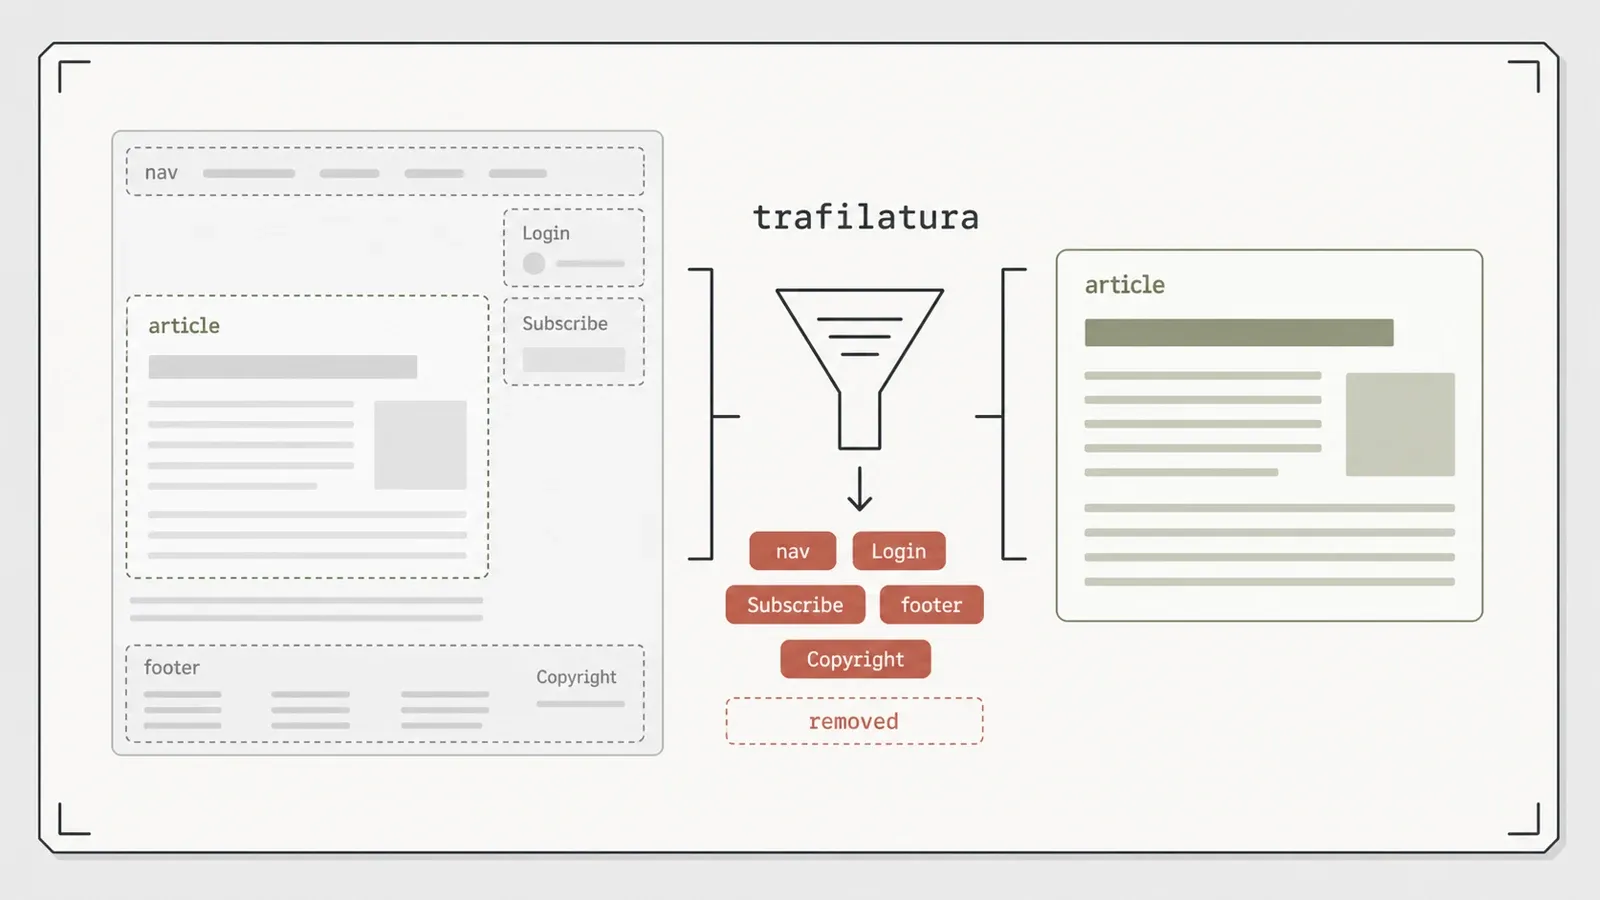
Jag körde den mot testfall som är byggda för att träffa både dess styrka och dess begränsning, och råresultaten finns sparade i benchmark-repot. Artikelfallet är det som övertygade mig.
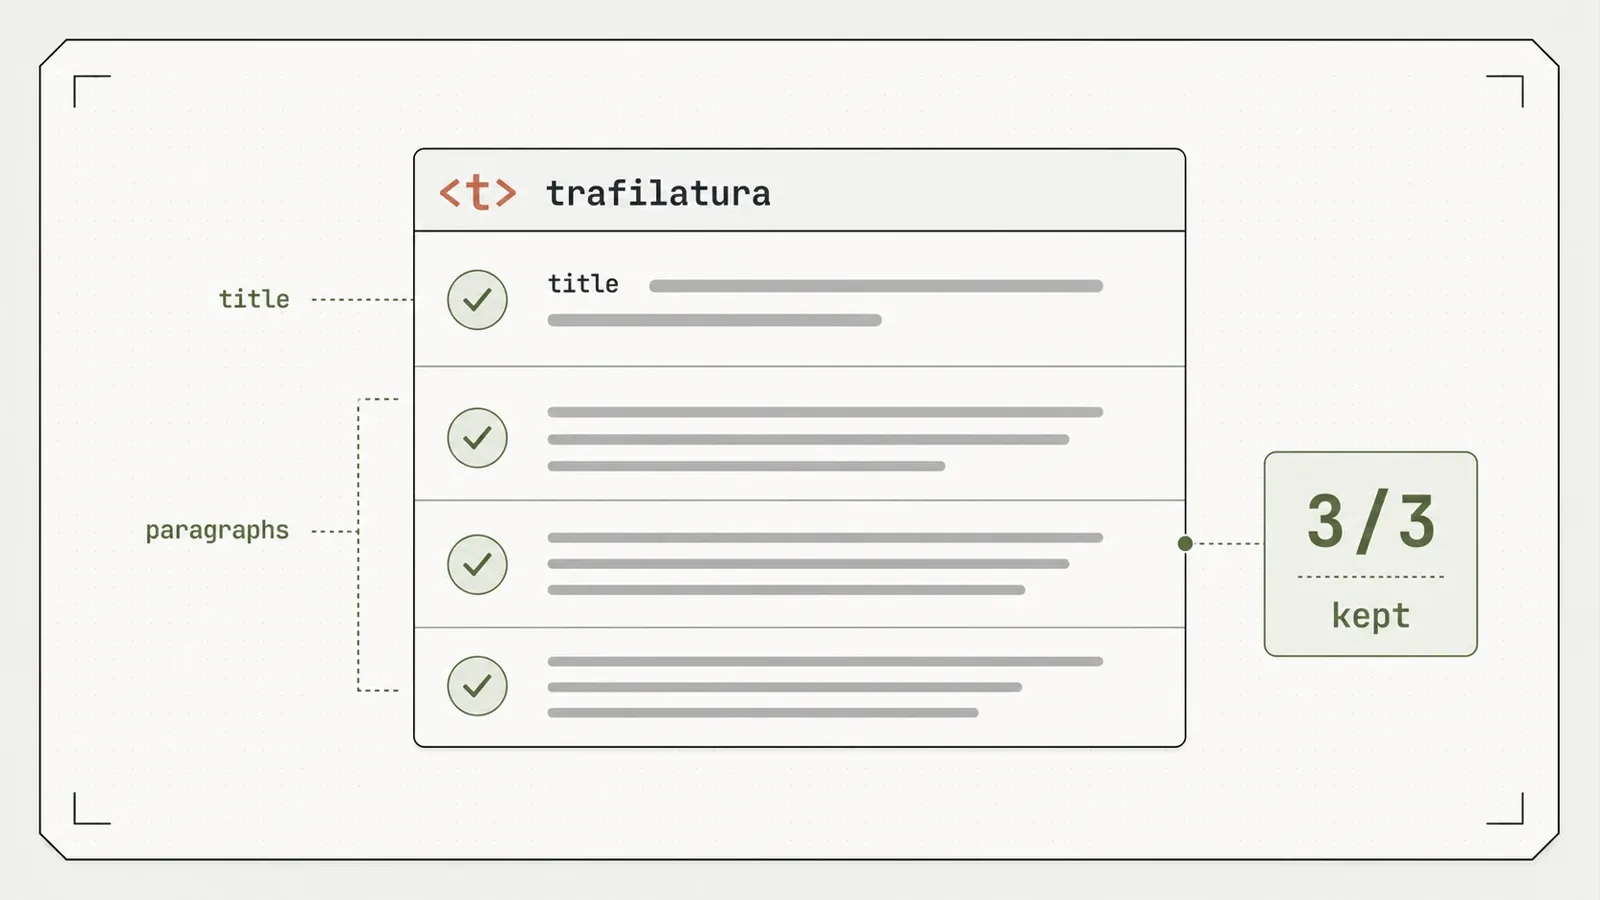
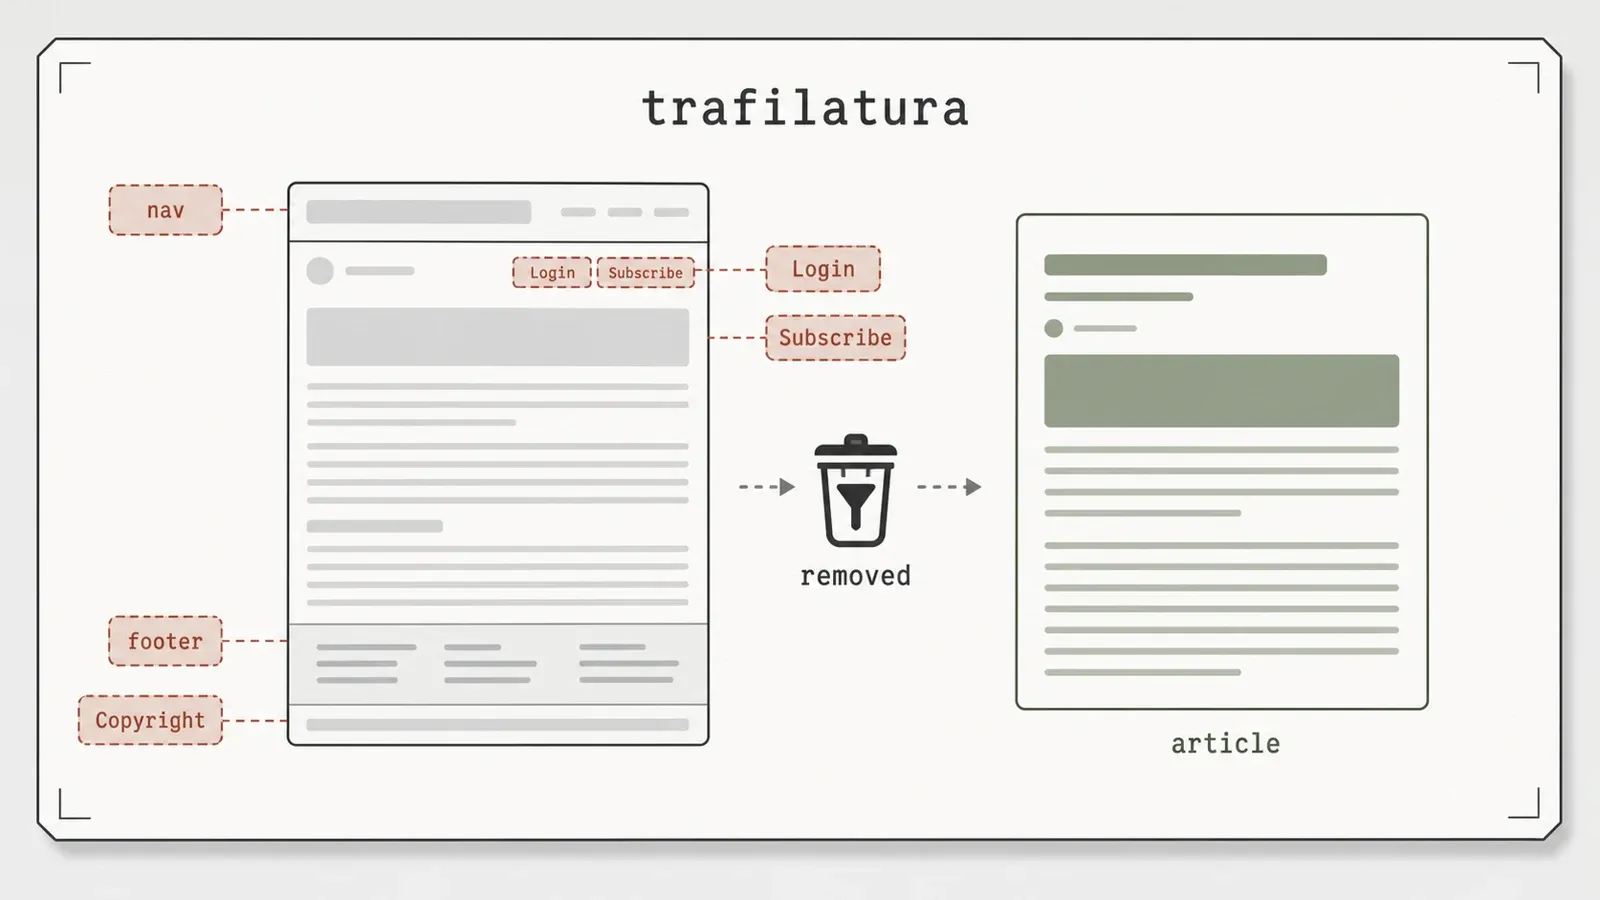
Jag tog ett lokalt artikeltestfall och bäddade in det verkliga innehållet i brus: en inloggningsruta, en "Subscribe"-påminnelse, navigationslänkar, en copyright-footer — den vanliga boilerplate som en naiv scraper annars drar med sig tillsammans med brödtexten. trafilatura returnerade titeln plus alla 3 av 3 brödtextstycken, och varje boilerplate-markör — Login, Subscribe, Copyright — var borta ur resultatet. Utöver texten hämtade den författare och datum korrekt från sidans metadata. Hela resultatet, i .txt, .md och .json, finns i results/local_article.json.
Samma sparade HTML exporterades som vanlig text, Markdown och JSON. Artikeln visar inte att alla tre formaten kom från ett enda samtidigt anrop; de är alternativa serialiseringar av extraktionsflödet. JSON här paketerar extraherad text och metadata, inte användardefinierade upprepade poster.
Här är hela första körningen samlad på ett ställe, så att du kan kontrollera påståendena ovan i stället för att bara ta dem för givna:
| Testfall | Vad som kom tillbaka | Körtid | Bevis |
|---|---|---|---|
| Lokal artikel, inbäddad i nav / login / subscribe / copyright | titel + 3/3 stycken, inga boilerplate-sektioner läckte igenom, författare Thunderbit Research Lab, datum 2026-07-09 | 0.007 s | local_article.json |
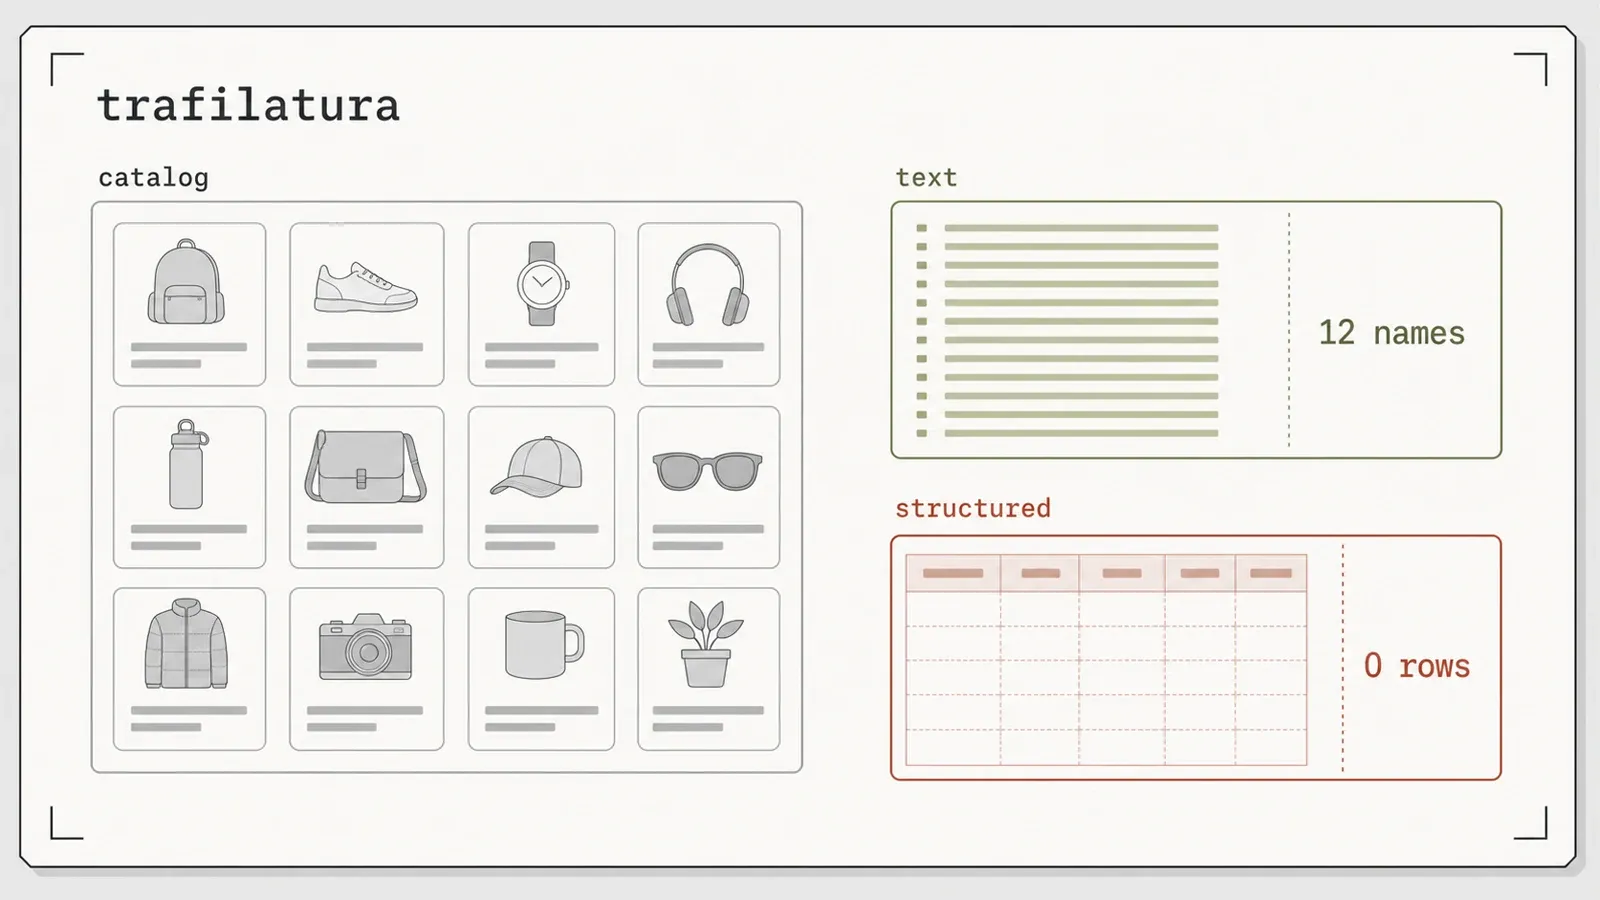
| Lokal produktkatalog | 12 produktnamn och deras 12 priser som platt text, 0 strukturerade rader, 478 tecken | 0.064 s | local_catalog_extraction.txt |
| Sida som returnerar HTTP 500 | fetch_url returnerade None, ingen exception kastades | 30.012 s | local_failure_500.json |
| Books to Scrape-produktsida (publik) | 1 324 tecken ren text, plus motsvarande Markdown | 0.753 s | public_books_product.txt / .md |
Varje rad är hämtad ur artifacts/raw/trafilatura-test-summary.json i trafilatura-paketet — trafilatura 2.1.0, Python 3.14, macOS arm64, en körning på en maskin. Se tiderna som observationer, inte som ett fullskaligt benchmark.
På 500-testfallet returnerade fetch_url None efter ungefär 30 sekunder medan närliggande lokala endpoints var snabba. Körningen visar fördröjningen, men inte om orsaken var retry/backoff, en fast timeout eller någon annan intern väg. Artikeln verifierade inte någon dokumenterad timeout-parameter per anrop för fetch_url; den bevisade kontrollen är att hämta med en klient du styr själv och sedan skicka den HTML du fått till trafilatura.
Samma tester visar också tre tydliga gränser.
Först och viktigast: trafilatura är en innehållsextraherare, inte en strukturerad scraper. Jag körde den mot ett katalogtestfall. Den returnerade alla 12 produktnamn — som text — och exakt 0 strukturerade rader (478 tecken platt text, enligt results/local_catalog_extraction.txt). Priserna kom också med, från $18.00 upp till $51.00, på egna rader under respektive namn. Allt du vill ha finns i utdata; inget av det är ett fält. Om du behöver [{name, price, rating}, …] är detta fel verktyg, och ingen mängd konfiguration ändrar på det — det är ett designval, inte en bugg.
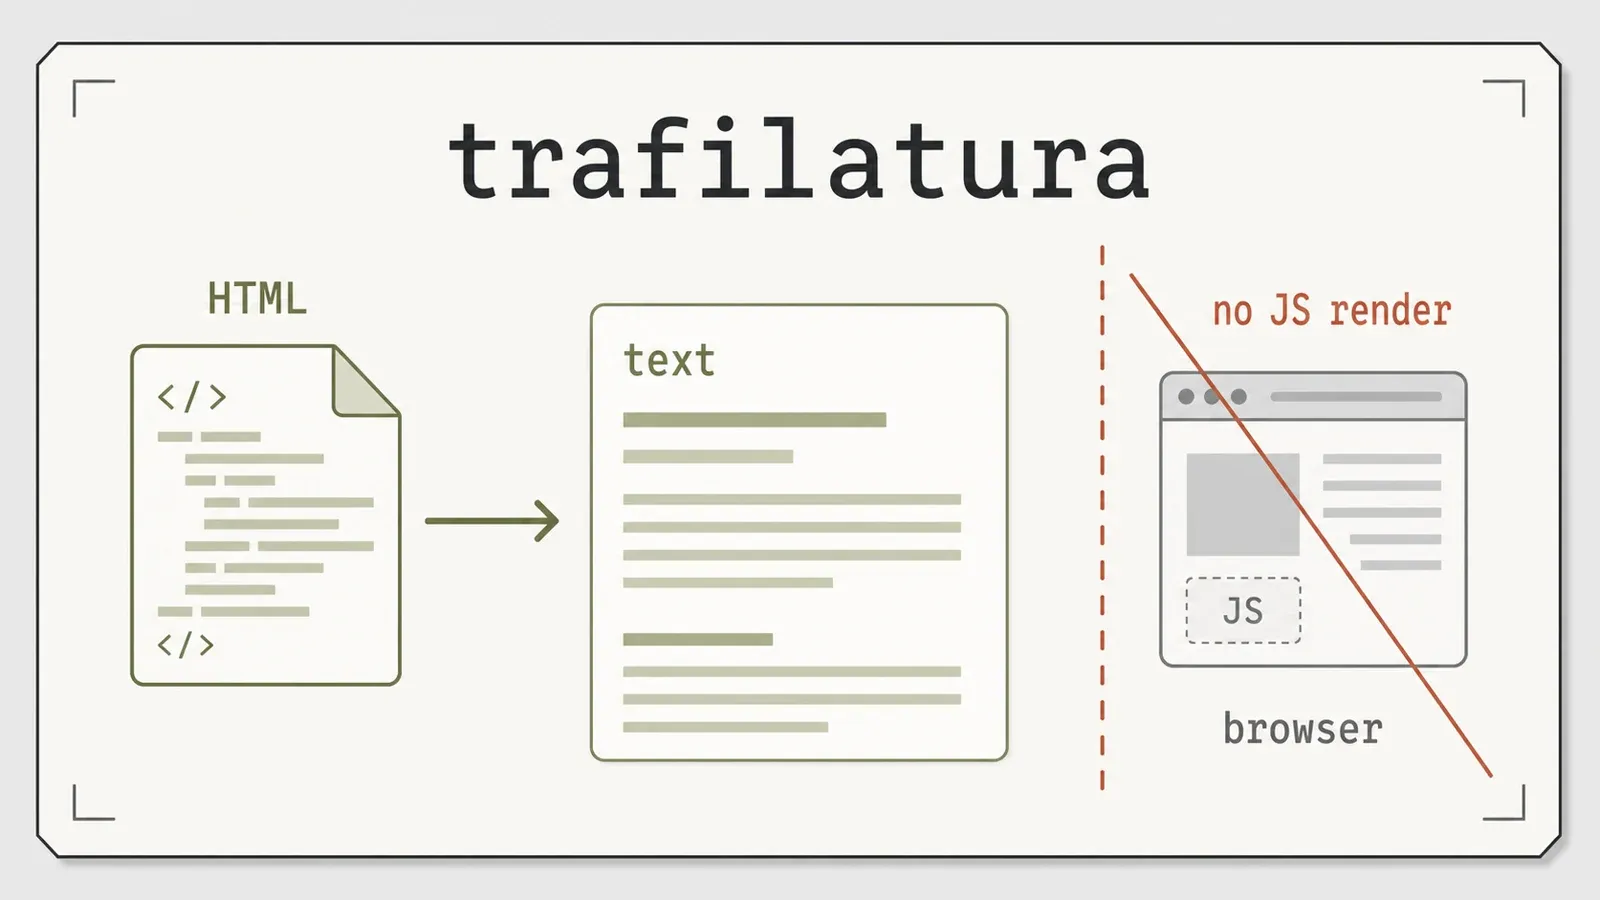
För det andra: den renderar inte JavaScript. Den arbetar mot statisk HTML. Peka den mot en sida som byggs på klientsidan och du får det som servern skickade innan JavaScript hann köras, vilket ofta inte är något användbart. Kombinera den med en renderer om dina mål är JS-tunga; trafilatura gör inte den halvan åt dig.
För det tredje, en brasklapp om mitt eget underlag: det första publika extraktionstestet använde ett produktbeskrivningsblock, inte en riktig nyhetsartikel, eftersom den publika sandlådan saknar nyhetssidor. Resultatet för artikelrensningen ovan kommer från ett kontrollerat lokalt testfall. Jag litar på det — borttagningen av boilerplate är otvetydig — men jag ville inte klä ut en produktsida till bevis för newsroom-kvalitet, så paketet markerade det som ett öppet glapp. En uppföljande körning den 2026-07-14 stängde det, och resultaten kommer i nästa avsnitt.
Kontroll av boilerplate på riktiga sidor
Två riktiga sidor hämtades en gång, sparades som offline-testfall med SHA-256-hashar och kördes om utan nätverksåtkomst. Ingen timing eller märkt facitdata registrerades. Det här är en kontroll av boilerplate på riktiga sidor, inte en sanningsgradsmätning.
| Testfall med riktig artikel | Rå HTML | Extraherad brödtext | Brödtext/rå | Markörer för siddekor borttagna | titel | datum | värdnamn | författare | sajtens namn |
|---|---|---|---|---|---|---|---|---|---|
| Wikipedia, "Web scraping" | 230,049 bytes | 26,673 bytes | 0.116 | 4 av 4 | ja | 2005-09-17 | wikipedia.org | null | null |
| Wikinews, "7th Heaven" (arkiverad) | 79,716 bytes | 2,200 bytes | 0.028 | 5 av 5 | ja | 2005-11-29 | wikinews.org | null | null |
Båda raderna kommer från artifacts/results/trafilatura-fidelity-summary.json. Markörerna som kontrollerades var "Jump to content", "Privacy policy", "Powered by MediaWiki", "This page was last edited" samt "free news source" på Wikinews-sidan — alla försvann, inget läckte igenom, på båda sidorna.
Förhållandet mellan brödtext och rå HTML mäter minskning, inte korrekthet; utelämnat artikelinnehåll poängsattes inte. author och sitename var null på dessa två MediaWiki-mallar, medan det kontrollerade lokala testfallet hade en författare. Detta är ett MediaWiki-specifikt misslyckande som observerades i testet, inte bevis för generell tillförlitlighet för bylines. De extraherade datumen rapporteras som de returnerades och verifierades inte mot facit.
Två extraherare, samma HTML-bytes, ett gemensamt scoringskript
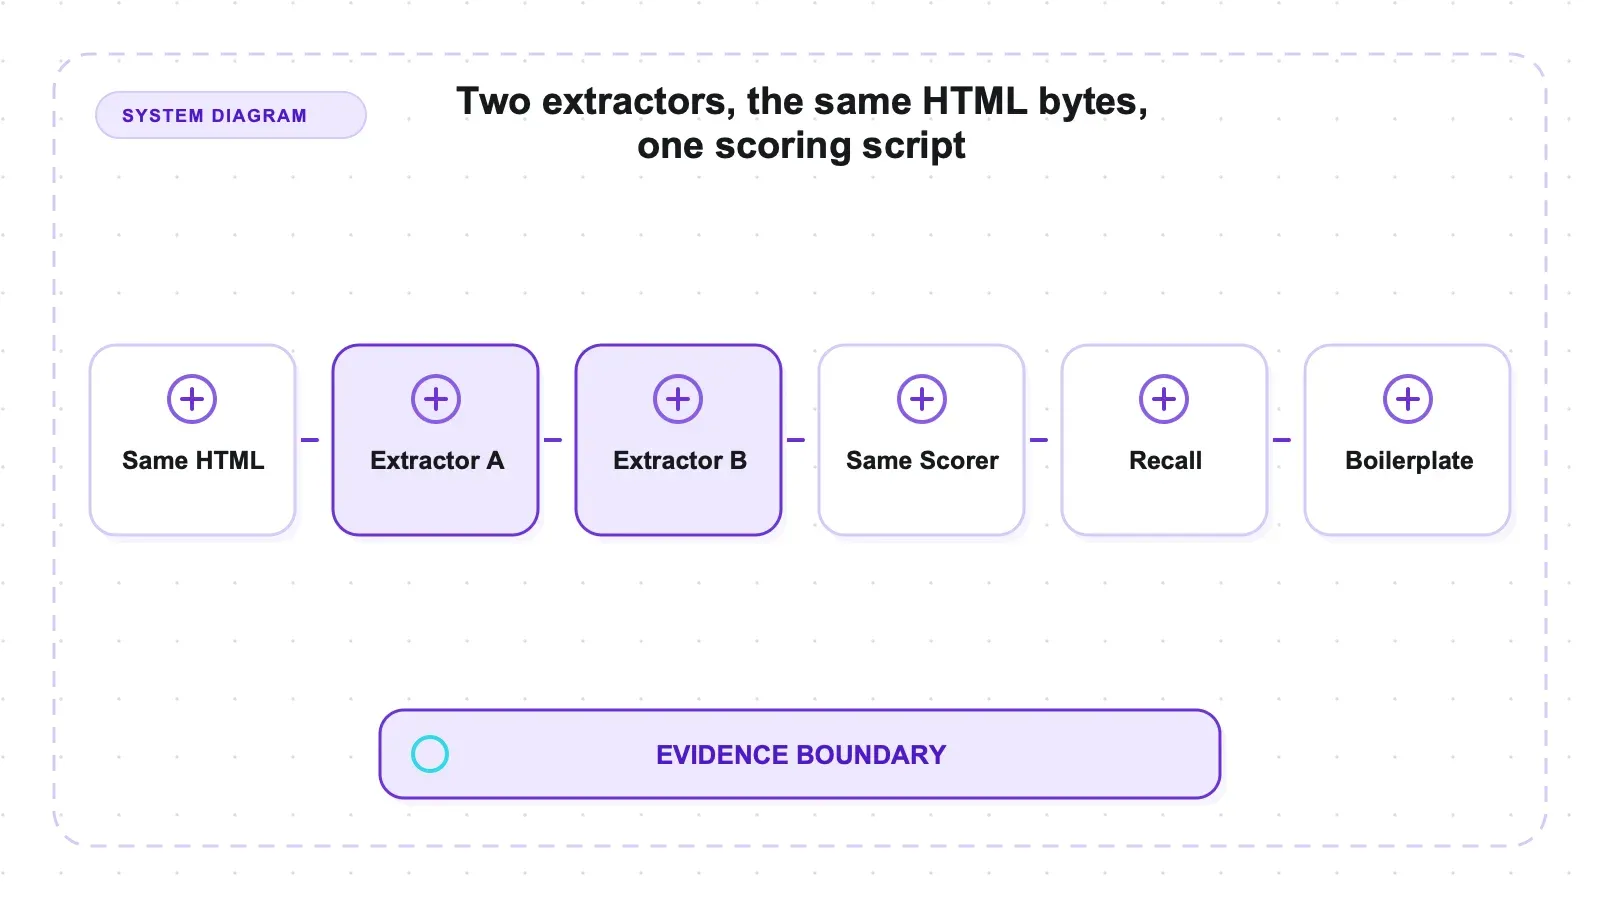
Det finns exakt en jämförelse i samma testmiljö för trafilatura i den här forskningsbasen, och trafilaturas eget paket byggde inte den. Det gjorde mozilla-readability-paketet, som kontrollarm: 22 handmärkta testfall där varje textblock är taggat som ARTICLE eller BOILERPLATE och varje ord bär en unik sentinel-token, så att ett extraherat ord kan spåras tillbaka till exakt ett märkt block. Båda verktygen fick identiska HTML-bytes. Readability kördes under jsdom 29.1.1 på Node v22.22.3; trafilatura körde sin egen parser.
| Metrik (mikro-medel, innehållstrohetsset) | trafilatura 2.1.0 | @mozilla/readability 0.6.0 | Bevis |
|---|---|---|---|
| Återvunna artikel-enheter | 40 av 40 | 40 av 40 | comparison.json |
| Läckta boilerplate-enheter | 1 av 17 | 5 av 17 | comparison.json |
| Boilerplate-token som förorenade utdata | 3 | 41 | comparison.json |
| Tokenprecision | 0.939 | 0.902 | comparison.json |
| Token F1 | 0.969 | 0.948 | comparison.json |
Återkallning för icke-prosa, f6_nonprose-testfall | 7 av 8 | 8 av 8 | comparison.json |
Mycket kort artikel, f3_short_120 F1 | 0.571 | 0.800 | comparison.json |
Källa: tools/mozilla-readability/artifacts/raw/comparison.json i den här forskningsbasen — 11 testfall i innehållstrohetssetet, 40 artikel-enheter och 17 boilerplate-enheter. Det här är syntetiska testfall som medvetet viktats mot svåra gränsfall, så läs dem som mekanism, inte som en ranking på riktig korpus.
Inget av verktygen sopar banan, och skillnaden är det intressanta. trafilatura håller bort siddekor — ett läckt block mot Readabilitys fem, tre förorenande tokens mot 41. Det är precision-delen av "ren artikeltext", och den delen avgör om din LLM-kontext fylls av sidolänkar. Men Readability återvinner innehåll som trafilatura kastar bort: i icke-prosa-testfallet tappade trafilatura en <figcaption> som Readability behöll, och på en mycket kort artikel fick den 0.571 mot Readabilitys 0.800. Aggressiv rensning är en kompromiss, inte en gratis vinst. Om din korpus är full av stubbar, bildtexter och tabelltunga sidor går kompromissen emot dig.
Så gör du jämförelsen till ett urvalstest
Börja med att slå fast vilken typ av fel som är dyrast för din pipeline. Om siddekor förbrukar nedströms-token eller förorenar sökresultat bör läckta boilerplate-enheter och förorenande tokens väga tyngst. Om det är oacceptabelt att tappa en bildtext, ett kort inlägg eller ett icke-prosablock bör återvinning av innehåll beroende på sidans form väga tyngst. Den gemensamma testuppsättningen gör avvägningen synlig, men den väljer inte vikterna åt en nyhetsarkivlösning, dokumentationskorpus eller retrieval-pipeline.
Det bredare stress-test-sammanhanget finns i jämförelsen mellan tio bibliotek för minne och trasig HTML.
Bygg jämförelsen från sparad HTML i stället för live-URL:er så att båda extraherarna får identiska bytes. Inkludera vanliga längre artiklar, korta notiser, bildtexttunga texter, dokument med mycket tabeller eller kod samt mallar från varje publicist du faktiskt tar in. Märk ett litet antal obligatoriska innehållsenheter och kända boilerplate-block innan du kör något av verktygen. Poängsätt sedan tom utdata, återvinning av obligatoriska enheter, läckage av oönskade enheter och metadatafält separat. Ett enda aggregerat "kvalitetsvärde" kan dölja just det felmönster som är operativt viktigt.
Validera också utdataavtalet längre ned i kedjan. trafilaturas JSON kan bära extraherat innehåll och metadata, men en JSON-serialisering är inte samma sak som ett typat radschema. För artikeltext bör du kontrollera minsta brödtextlängd och obligatoriska markörer i stället för att acceptera vilken icke-tom utdata som helst. För metadata bör du skilja mellan frånvaro och felaktiga värden och spara käll-URL samt extraktionsversion så att missar kan spelas upp igen.
Hämtningen bör testas som ett eget lager. Den lokala observationen på 30 sekunder hör till fetch_url, inte till extraktion från HTML som du redan har i minnet, och den interna mekanismen fastställdes inte. Om deadlines, retries, autentisering eller proxypolicy spelar roll bör du använda en klient vars beteende du själv kontrollerar, spara de slutliga responsbytesen och skicka just de bytesen till extraheraren. Då isolerar du insamlingsfel från innehållsvalsfel och gör jämförelserna reproducerbara.
Slutligen bör du mäta drifts-egenskaper på den avsedda plattformen. Installation med 17 Python 3.14-paket krävde ingen separat webbläsare, men det säger inget om throughput, minnesökning, paket-tillgänglighet på alla arkitekturer eller beteende under parallella arbetare. Artikeln visar en användbar precision/retention-mekanism mot Readability; produktionslämplighet beror fortfarande på korpus och runtime-tester.
För en extern kontroll som inte är den här basens eget arbete placerar både trafilaturas egen utvärderingssida och den publika ScrapingHub article-extraction-benchmark den före readability-lxml på word-F1 över ungefär 181 riktiga sidor — samma riktning som tabellen ovan. En brasklapp som många texter som hänvisar till det benchmarket hoppar över: det ofta citerade trafilatura-F1-värdet (~0.945) hör till en äldre 0.5.1-linje, inte till 2.1.0 som testades här.
Fördelar och nackdelar
Fördelar:
- Lägre läckage av märkt boilerplate än Readability i den gemensamma testuppsättningen: 1 block av 17 mot 5.
- Hämtade författare och datum korrekt i det lokala testfallet, samt titel/datum/värdnamn på båda riktiga artikelsidorna.
- Samma HTML kan serialiseras som text, Markdown eller JSON.
- Installation med 17 paket och ingen separat webbläsarmiljö.
- Fel hanteras tyst:
fetch_urlreturnerarNonepå HTTP 500 i stället för att kasta ett undantag. - Testad version är den senaste (2.1.0) — ingen versionsförskjutning.
- Apache-2.0-licens — permissiv och kommersiellt vänlig.
Nackdelar:
- Inte en strukturerad scraper: katalogtestet returnerade 12 namn och 12 priser som text och 0 typade rader. Inget schema, inga fält.
- Ingen JavaScript-rendering — bara statisk HTML; kräver separat renderer för klientsidesidor.
authorochsitenameblevnullpå båda de riktiga MediaWiki-sidorna, så byline-extraktion är inte given.- Aggressiv rensning har ett pris: den tog bort en
<figcaption>som Readability behöll och fick 0.571 mot Readabilitys 0.800 på en mycket kort artikel. - Den tysta 500-händelsen tog 30.012 sekunder innan den returnerade
None; använd en hämtare du själv styr när du behöver tidskontroll. - De inbyggda crawl/sitemap-funktionerna och CSV/XML-formaten testades inte i den här omgången, så jag gör inga påståenden om dem.
Vem den passar för — och vem som bör hoppa över den
trafilatura är byggd för extraktion av huvudinnehåll med fokus på artiklar. Den passar när du vill bygga textkorpusar, läsbara arkiv eller NLP-input från statisk HTML och när heuristisk rensning är acceptabel. Jämförelsen på delade testfall talar för lägre boilerplate-läckage än Readability, medan Readability behöll mer av de korta och icke-prosa-baserade fallen.
Hoppa över den om du faktiskt behöver strukturerad extraktion — prisrader för produkter, typade poster, key: value-fält — eftersom den ger dig text, inte tabeller (katalogtestet återvann alla 12 namn och alla 12 priser, men 0 rader). Hoppa också över den om dina mål renderar innehåll i webbläsaren och du inte vill koppla på en separat renderer, eftersom trafilatura läser statisk HTML och stannar där. Och tänk efter en extra gång om din korpus mest består av korta stubbar, bildtexter och tabelltunga sidor: i de märkta testfallen är det just där rensningen skär in i det verkliga innehållet (0.571 F1 på den mycket korta artikeln, en borttagen <figcaption>). Matcha verktyget med uppgiften: full artikeltext, ja; strukturerad JSON, JS-sidor eller 100-ordsstubbar, leta någon annanstans.
Alternativ, inklusive var Thunderbit passar in
trafilatura är ett självhostat bibliotek med Apache-2.0-licens och ingen avgift per anrop till en leverantör; kostnader för beräkning, bandbredd, hämtning, övervakning och underhåll ligger kvar hos den som driver lösningen. Det hanterar extraktion av artikelliknande innehåll från tillhandahållen HTML, men inte webbläsarexekvering eller användardefinierade upprepade radscheman.
För samma testfall över alla sex extraherare, se jämförelsen mellan sex bibliotek för extraktion.
En hanterad tjänst kan lägga insamling, rendering och schemabyggande bakom en leverantörsgräns. Vi bygger Thunderbit, men körde den inte mot de här testfallen, så den här artikeln stödjer ingen jämförelse av kvalitet, rendering, latens, anti-bot eller kostnad. Valet står mellan självhostad HTML-till-innehåll-kontroll och en hostad gräns för insamling och strukturerad extraktion.
Relaterade benchmark-recensioner: den fullständiga jämförelsen av open source-scrapers, Crawl4AI:s webbläsarbaserade Markdown-recension och Firecrawl:s självhostade Markdown-recension.
Prova Thunderbit för webbaserad dataextraktion
Slutsats
Överväg trafilatura när uppgiften är att extrahera artikelliknande innehåll från statisk HTML och din prioritet är att sortera bort märkt boilerplate. I de delade testfallen läckte den igenom en annoterad boilerplate-enhet mot Readabilitys fem. Den fördelen kom med lägre återvinning i de mycket korta och icke-prosa-baserade testfallen, så korpusens form bör avgöra valet.
Den kör inte JavaScript och kan inte skapa användardefinierade upprepade rader. På de två MediaWiki-sidorna var author och sitename null, en observation begränsad till just de mallarna. Readability behöll bildtexten som trafilatura tog bort och presterade bättre på testfallet märkt f3_short_120; det synliga underlaget stöder "lägre F1 på det mycket korta testfallet", inte ett visst teckenantal eller påståendet att resultatet blev förvanskat.
Prova Thunderbit för webbaserad dataextraktion Get Started Free
Vanliga frågor
Vilken typ av struktur returnerar trafilatura? Den kan serialisera extraherat innehåll och metadata som JSON, Markdown, text, HTML, XML eller CSV. Det är strukturerad serialisering, men inte ett användardefinierat upprepat radschema som produktnamn, pris och betyg. Katalogtestet returnerade värden som platt innehåll snarare än typade rader.
Kan trafilatura extrahera en produktkatalog till strukturerade rader? Nej. Det är en innehållsextraherare, inte en strukturerad scraper. I ett katalogtest returnerade den alla 12 produktnamn som platt text och 0 strukturerade rader — namnen finns i resultatet, men de är inte fält. Om du behöver typade poster som namn/pris/betyg, använd i stället en selector-baserad parser eller ett schema-drivet extraktions-API.
Renderar trafilatura JavaScript? Nej. Den arbetar bara mot statisk HTML. Peka den mot en sida som renderas i webbläsaren och du får det servern skickade innan JavaScript kördes, vilket ofta inte är det innehåll du vill ha. Koppla den till en separat renderer om dina mål är JS-tunga.
Är trafilatura svår att installera?
I den testade virtuella miljön med Python 3.14 drog installationen in 17 paket och krävde ingen separat webbläsarmiljö. Det största registrerade hjulet var lxml på 8,6 MB. Separat tog ett lokalt 500-anrop 30.012 sekunder innan det returnerade None; använd en HTTP-klient du själv styr om du behöver en verifierad deadline.
Är trafilatura gratis för kommersiellt bruk? Den är licensierad under Apache-2.0, vilket är permissivt och kommersiellt vänligt. Kontrollera alltid den aktuella licensen i repo innan du bygger vidare på den.




