
Webben växer i en takt som ärligt talat är svår att hänga med i — år 2026 står nästan hälften av all internettrafik för bottar, och en enorm del av det är företag som samlar in data för att driva försäljning, verksamhet och konkurrensanalys. Jag har själv sett hur web scraping har gått från att vara ”bra att ha” för teknikintresserade till ett absolut måste för alla, från säljteam till mäklare. Men här är haken: alla företag inom web scraping är inte skapade lika, och rätt val kan vara skillnaden mellan ett smidigt, automatiserat arbetsflöde och en vecka av kopiöst copy-paste-trassel.
Så jag har kavlat upp ärmarna och gått igenom de bästa företagen inom web scraping för 2026. Oavsett om du är en icke-teknisk användare som bara vill ha data med två klick, eller en utvecklare som vill ha full kontroll, täcker den här listan det bästa av det bästa — plus ärliga omdömen om var varje lösning verkligen glänser (och var den inte gör det). Nu kör vi.
Varför företag behöver de bästa företagen inom web scraping
Samla data från vilken webbplats som helst med AI Get Started Free
Om du någon gång har försökt bygga en leadlista, bevaka konkurrenters priser eller hämta produktdata från tiotals (eller tusentals) sidor, känner du till smärtan med manuell datainsamling. Det är långsamt, felbenäget och — låt oss vara ärliga — knappast någon favoritaktivitet. Därför har web scraping vuxit till en riktig bransch, där företag använder det till allt från leadgenerering och prisbevakning till marknadsundersökningar och sentimentanalys.
Den stora vinsten? Automatisering. Moderna företag inom web scraping gör det möjligt att:
- Automatisera repetitiv research (inga fler copy-paste-maraton)
- Skala upp till tusentals sidor utan extra ansträngning
- Integrera data direkt i dina favoritverktyg (Excel, Google Sheets, Notion, CRM-system)
- Ligg steget före konkurrenterna genom att få färskare och mer relevant data snabbare
Men med så många alternativ, hur ska man välja? Det är där den här guiden kommer in.
Så utvärderade vi de bästa företagen inom web scraping
Alla scraperverktyg är inte byggda för samma användare — eller samma uppgift. Så här bedömde jag fältet:
- Användarvänlighet: Kan en person utan kodkunskaper få resultat snabbt? Är gränssnittet intuitivt?
- Automatisering och funktioner: Klarar det sidnumrering, undersidor, schemaläggning och dynamiskt innehåll?
- Skalbarhet: Klarar det stora projekt, eller passar det bättre för mindre jobb?
- Integration: Hur enkelt går det att exportera eller koppla data till andra verktyg?
- Pris: Finns det en gratisnivå? Är det prisvärt för små och medelstora företag och skalbart för stora organisationer?
- Support och community: Finns det guider, mallar och riktig hjälp när du behöver det?
Jag tittade också på vad som gör varje företag unikt — för ibland är det bästa verktyget det som passar ditt arbetsflöde, inte bara det som har flest funktioner.
Okej, nu till listan.
1. Thunderbit
 Thunderbit är den AI-drivna web scraper jag är mest entusiastisk över inför 2026 — och det är inte bara för att jag varit med och byggt den! Thunderbit är skapat för affärsanvändare som vill ha data, inte huvudvärk. Chrome-tillägget låter dig samla data från vilken webbplats som helst med naturliga språkprompter och AI-baserade fältförslag. Ingen kod, inga mallar, ingen stress.
Därför sticker Thunderbit ut:
- Scraping med ett klick: Klicka bara på “One-Click Extract” — Thunderbits AI sköter resten.
- Stöd för undersidor och sidnumrering: Samla enkelt in listningar och låt sedan AI besöka varje undersida för fler detaljer.
- Direkta mallar: För populära sajter (Amazon, Zillow, Shopify m.fl.) finns färdiga mallar för scraping med ett klick.
- Gratis export av data: Exportera till Excel, Google Sheets, Notion eller Airtable — utan betalvägg för din egen data.
- AI-baserad databerikning: Märk, kategorisera och översätt data medan du samlar in den.
- Schemalagd och molnbaserad scraping: Ställ in återkommande jobb eller kör scraping i molnet för högre hastighet.
- Helt gratis nivå: Samla in upp till 6 sidor gratis, eller 10 med en testboost. Betalda abonnemang börjar på 15 USD/månad.
Thunderbit används av över 200 000 användare världen över, från säljteam till e-handelsaktörer. Om du vill ha den enklaste och mest användarvänliga upplevelsen för web scraping 2026 är Thunderbit svårslaget.
Vill du se hur det fungerar? Ladda ner Chrome-tillägget och testa själv.
2. Scrapy
 Scrapy är det självklara open source-ramverket i Python för utvecklare som vill ha full kontroll. Det är kraftfullt, flexibelt och beprövat för allt från att crawla små sajter till att skrapa miljontals sidor.
Bäst för: Teknikteam, dataingenjörer och alla som är bekväma med Python.
Nyckelfunktioner:
- Egen regelstyrning: Bygg spiders som kan hantera vilken sajtstruktur som helst.
- Skalbart och snabbt: Klarar storskalig scraping med robust felhantering.
- Integrerar med Python-ekosystemet: Koppla till Pandas, Jupyter och mer.
- Gratis och open source: Inga licensavgifter, stort community-stöd.
Att tänka på: Scrapy har en inlärningskurva. Om du inte kodar själv bör du titta på andra alternativ. Men för utvecklare är det ett riktigt kraftpaket (ScraperAPI).
3. ParseHub
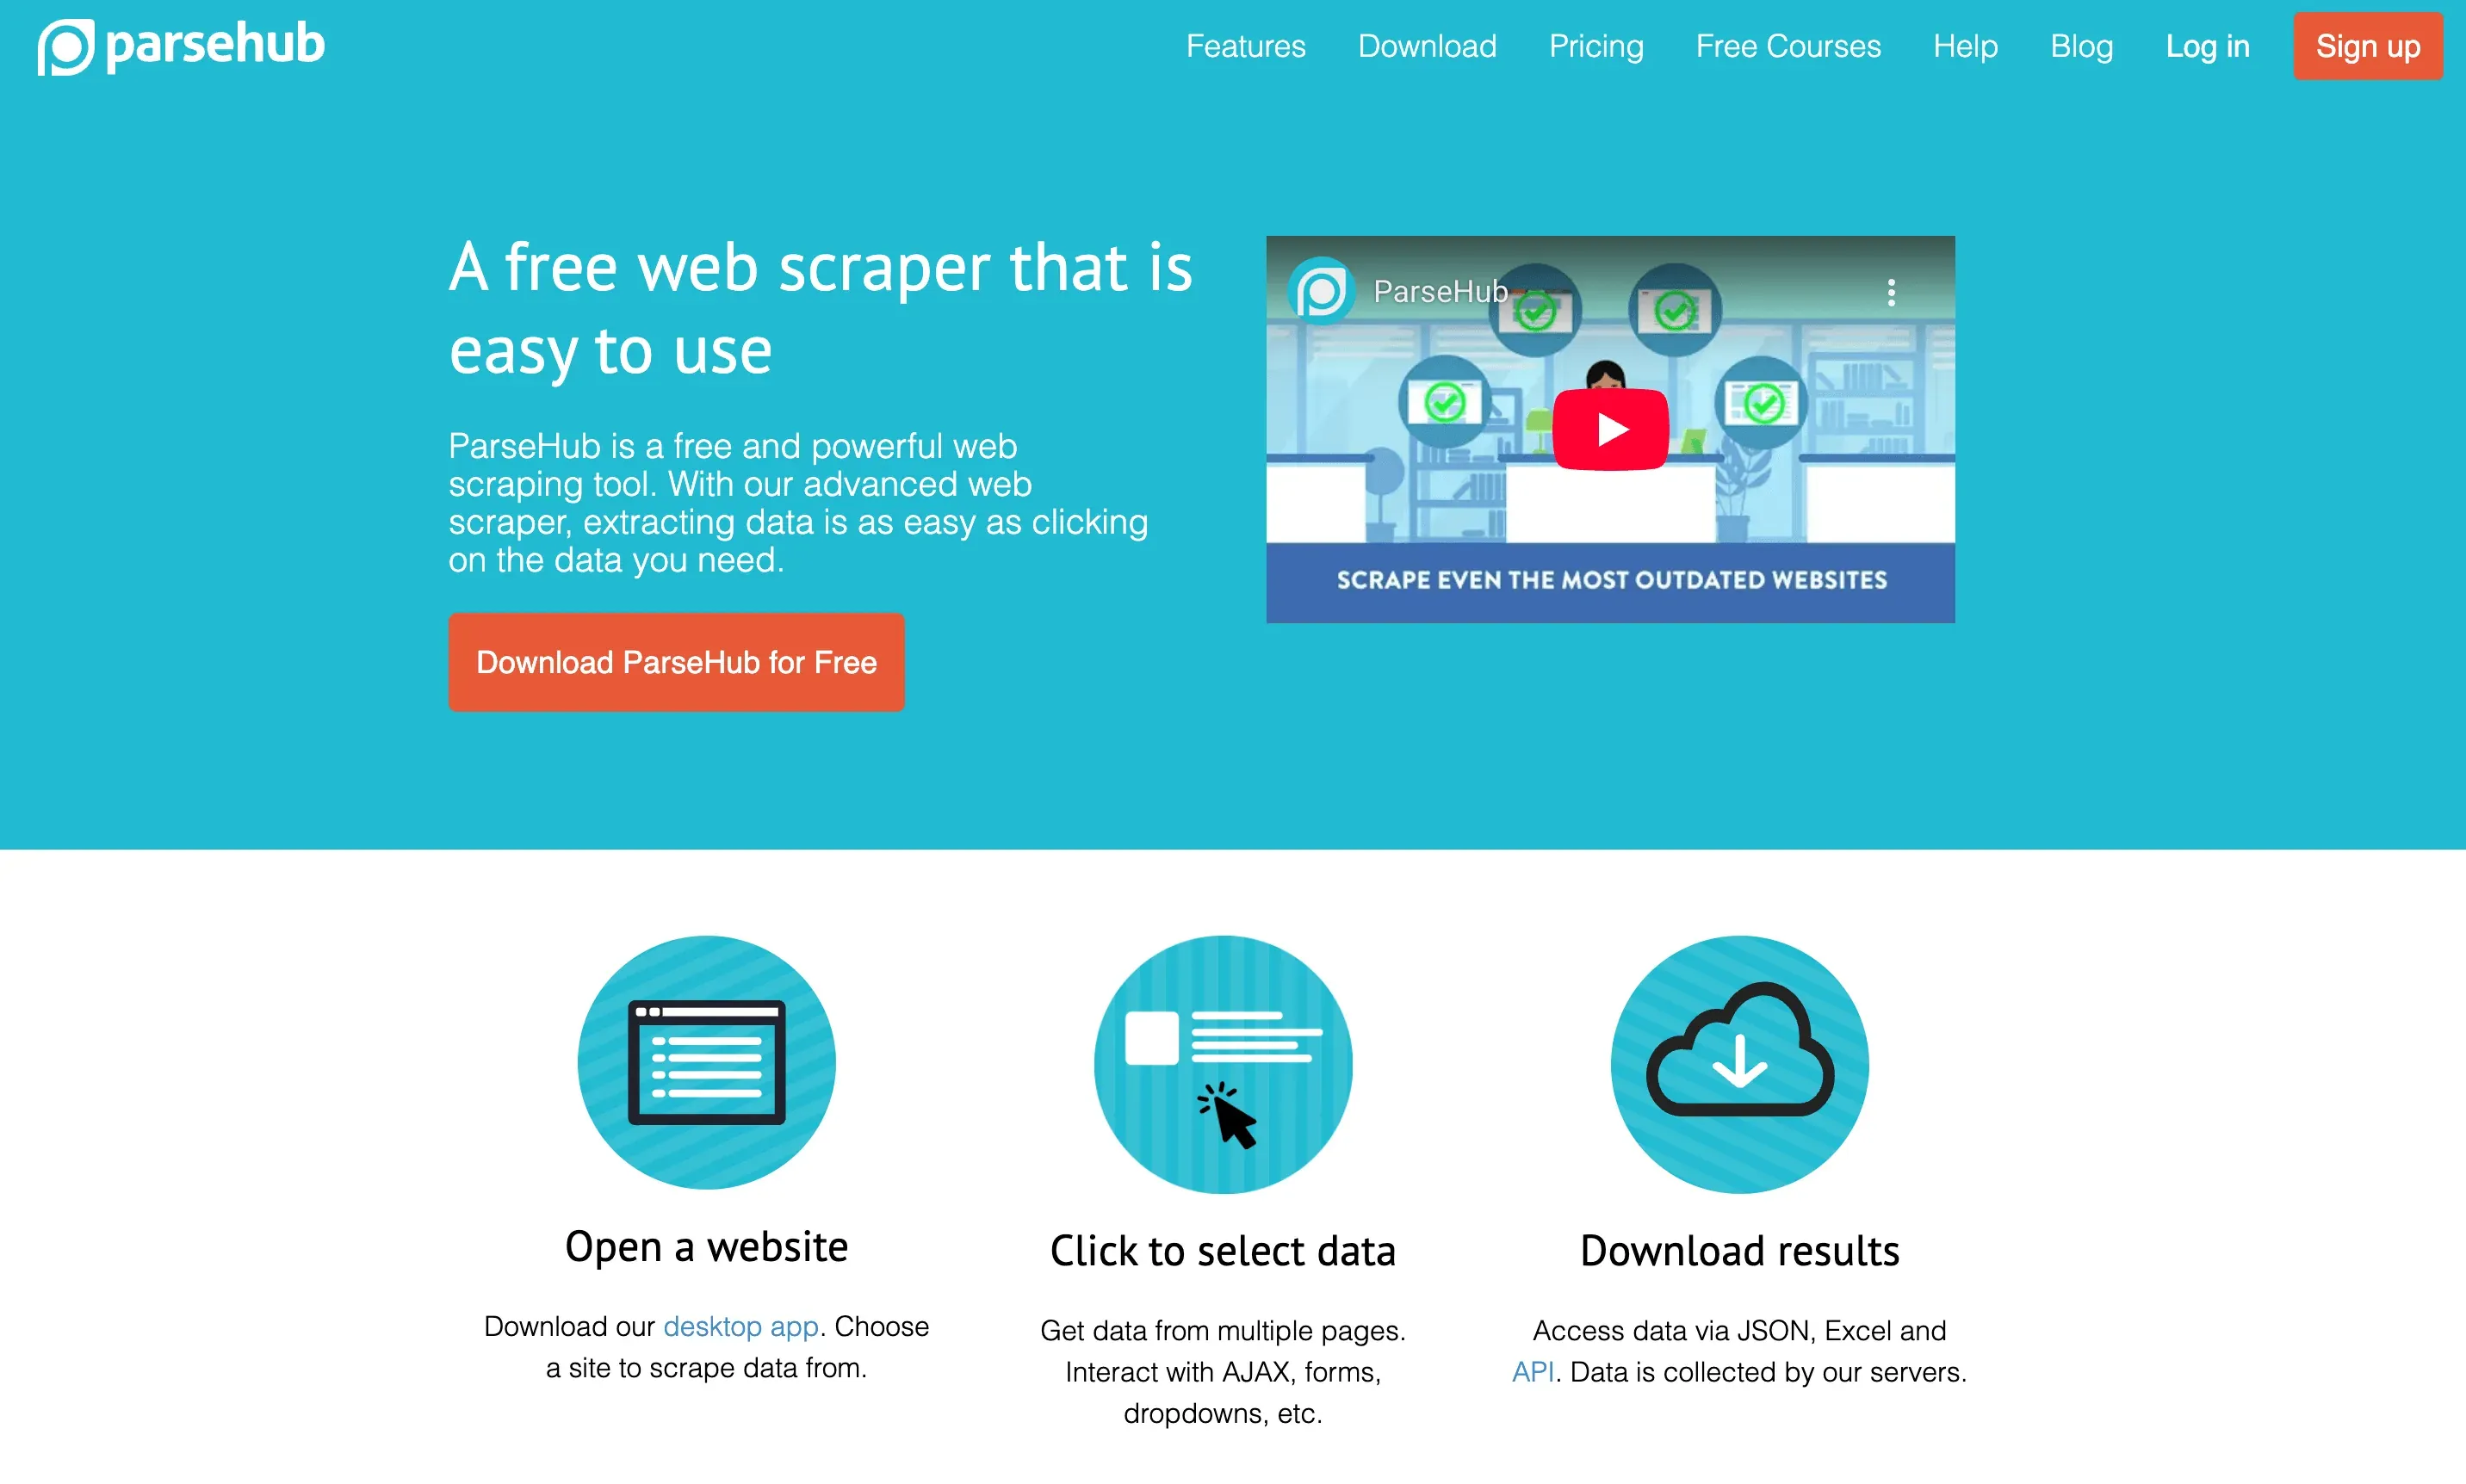 ParseHub är en desktop-app som gör web scraping visuellt och lättillgängligt. Med point-and-click-gränssnittet kan du bygga scrapers utan att skriva kod.
Bäst för: Små och medelstora företag, forskare och icke-kodare som vill ha flexibilitet.
Nyckelfunktioner:
- Visuellt arbetsflöde: Klicka för att välja data och bygg logik för sidnumrering och undersidor.
- Molnbaserad schemaläggning: Kör scraping enligt schema, även när datorn är avstängd.
- Exportalternativ: Ladda ner som CSV, Excel eller JSON.
- Gratis plan: 5 projekt, upp till 200 sidor/körning; betalda planer börjar på 189 USD/månad.
ParseHub är särskilt populärt för att samla in listningar, recensioner och e-handelsdata (ScraperAPI).
4. Octoparse
 Octoparse är en no-code-plattform för web scraping med drag-and-drop-fokus och stor vikt på automatisering i skala. Den passar utmärkt för team som vill sätta upp komplexa jobb utan att skriva skript.
Bäst för: Marknadsförings-, research- och operations-team.
Nyckelfunktioner:
- Drag-and-drop-arbetsflöde: Bygg scrapers visuellt och hantera dynamiskt innehåll samt oändlig scroll.
- Molnscraping och schemaläggning: Kör jobb i molnet och schemalägg återkommande uppgifter.
- IP-rotation och anti-blockering: Inbyggda funktioner för att skrapa svåra sajter.
- Export till Excel, Sheets och databaser: Enkel integration i ditt arbetsflöde.
- Gratis nivå: Upp till 10 000 poster per månad; betalda planer börjar på 83 USD/månad, eller 69 USD/månad vid årsbetalning.
Octoparse uppskattas särskilt för sin snabbhet och förmåga att hantera storskaliga projekt (ScraperAPI).
5. DataMiner
 DataMiner är ett Chrome-tillägg som tar web scraping direkt in i webbläsaren. Det är perfekt för snabba, mallbaserade scrapingjobb av tabeller, listor och enklare webbplatser.
Bäst för: Vanliga användare, säljops och alla som lever i Chrome.
Nyckelfunktioner:
- Mallmarknadsplats: Över 60 000 färdiga recept för populära sajter.
- Point-and-click-extraktion: Välj data visuellt, ingen kod krävs.
- Export till Excel/Google Sheets: Exportera med ett klick.
- Gratis plan: 500 sidor/månad; betalda planer från 19 USD/månad.
DataMiner är en favorit för snabba jobb och icke-tekniska användare (DataMiner).
6. Import.io
 Import.io är en företagsanpassad plattform som fokuserar på att omvandla webb-innehåll till strukturerad data för analys och business intelligence.
Bäst för: Stora företag med stora databehov och integrationskrav.
Nyckelfunktioner:
- Hanterad tjänstemodell: Import.ios team kan bygga och underhålla scrapers åt dig.
- Visuellt gränssnitt: Bygg extraktionsflöden utan kod.
- API-åtkomst: Integrera insamlad data direkt i dina appar och dashboards.
- Efterlevnad och säkerhet: Kontroller på enterprise-nivå, maskering av personuppgifter och mer.
Pris: Skräddarsydd offert, vanligtvis från cirka 199 USD/månad (PromptCloud).
7. Apify
 Apify är en utvecklarvänlig automationsplattform med en stor marknadsplats av färdiga “Actors” (scrapingbotar) och möjlighet att bygga egna arbetsflöden.
Bäst för: Utvecklare, byråer och team som vill ha flexibilitet.
Nyckelfunktioner:
- Actor-marknadsplats: Färdiga scrapers för populära sajter, eller bygg egna.
- Molninfrastruktur: Kör scraping i stor skala, schemalägg jobb och integrera via API:er.
- GitHub-integration: Automatisera arbetsflöden och CI/CD.
- Betala efter användning: Gratis krediter, därefter användningsbaserad fakturering; betalda planer börjar på 29 USD/månad.
Apify passar utmärkt för både enkla och komplexa projekt (Black Bear Media).
8. Diffbot
 Diffbot använder AI och knowledge graphs för att omvandla ostrukturerat webbinnehåll till strukturerad, maskinläsbar data. Tänk på det som web scrapingens ”hjärna”.
Bäst för: Företag, forskare och alla som behöver automatiserad extraktion i stor skala.
Nyckelfunktioner:
- AI-driven extraktion: Känner automatiskt igen artiklar, produkter, organisationer och mer.
- Knowledge graph: Få åtkomst till världens största webbdatagraf via API.
- Databerikning: Hämta in relaterade enheter, nyheter och sammanhang.
- API först: Integrera med BI-verktyg och datapipelines.
Pris: Från 299 USD/månad (Diffbot Pricing).
9. WebHarvy
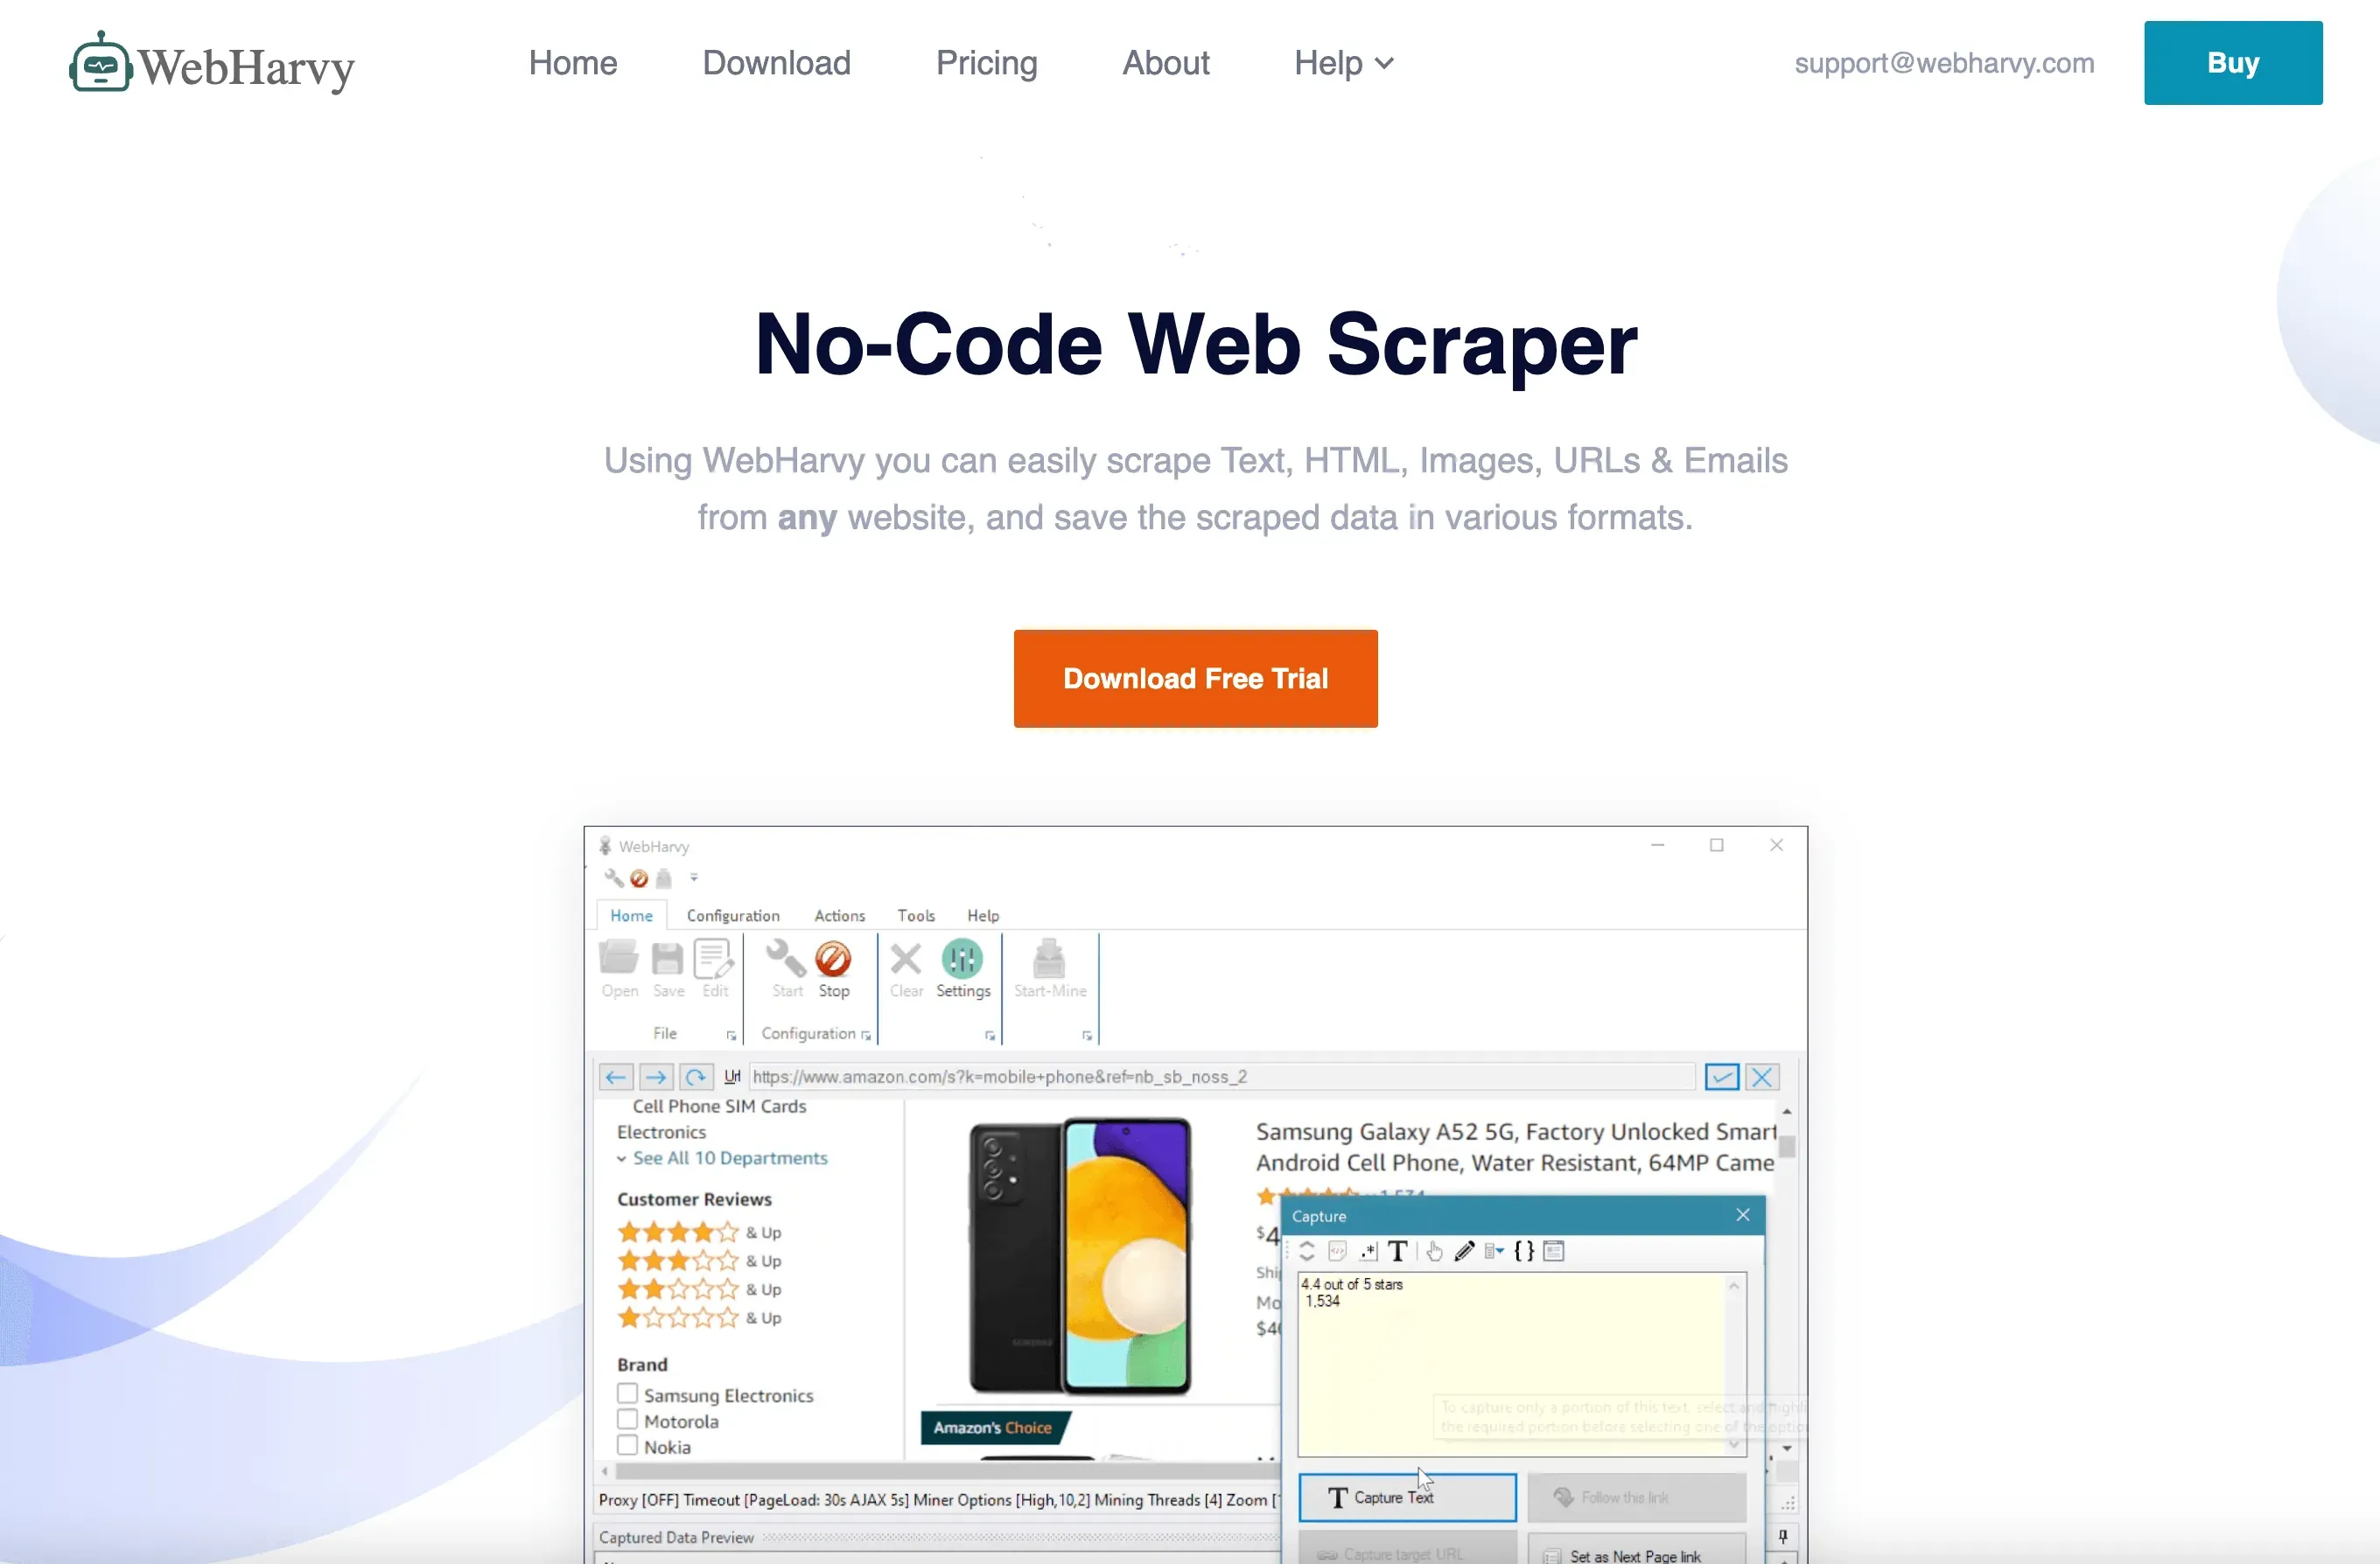 WebHarvy är en Windows-baserad desktop scraper med visuellt point-and-click-gränssnitt. Den passar bra för användare som vill undvika kod och föredrar en desktop-app.
Bäst för: Windows-användare, forskare och små och medelstora företag.
Nyckelfunktioner:
- Visuellt urval: Klicka på data för att definiera fält — ingen kod krävs.
- Hanterar bilder och flersidig navigering: Samla text, bilder och följ sidnumrering.
- Export till Excel, XML och databaser: Flexibla exportalternativ.
- Engångslicens: Betala en gång, använd för alltid (WebHarvy).
WebHarvy är särskilt populärt för scraping av e-handel och annonssajter (Thunderbit Blog).
10. Mozenda
 Mozenda är en molnbaserad plattform byggd för datautvinning och automatisering i enterprise-skala.
Bäst för: Stora organisationer och branscher med höga krav på efterlevnad.
Nyckelfunktioner:
- Molnautomatisering: Schemalägg, övervaka och hantera scrapingjobb centralt.
- Datatransformering: Rensa, berika och exportera data i flera format.
- Samarbete i team: Stöd för flera användare och arbetsflödeshantering.
- Enterprise-support: Efterlevnad, driftsäkerhet och dedikerad hjälp (Appvizer).
Pris: Cirka 99 USD/månad; enterprise-prissättning finns tillgänglig.
11. Sequentum (tidigare Content Grabber)
 Sequentum är en avancerad desktop/web scraper för dataexperter och byråer. Om du känner igen den som Content Grabber så är det namnet borta — Sequentum har döpt om produkten och contentgrabber.com leder inte längre någonstans (Sequentum FAQ).
Bäst för: Dataexperter, byråer och alla som behöver djup automatisering.
Nyckelfunktioner:
- Avancerad skriptning: Automatisera komplex extraktionslogik.
- Rapportering och övervakning: Följ jobb, få aviseringar och hantera stora projekt.
- Integration: Exportera till databaser, API:er eller molnlagring.
- Ingen gratisnivå: Endast betalda licenser (DataOX).
Sequentum är byggt för högvolymsextraktion med hög anpassningsgrad.
12. Helium Scraper
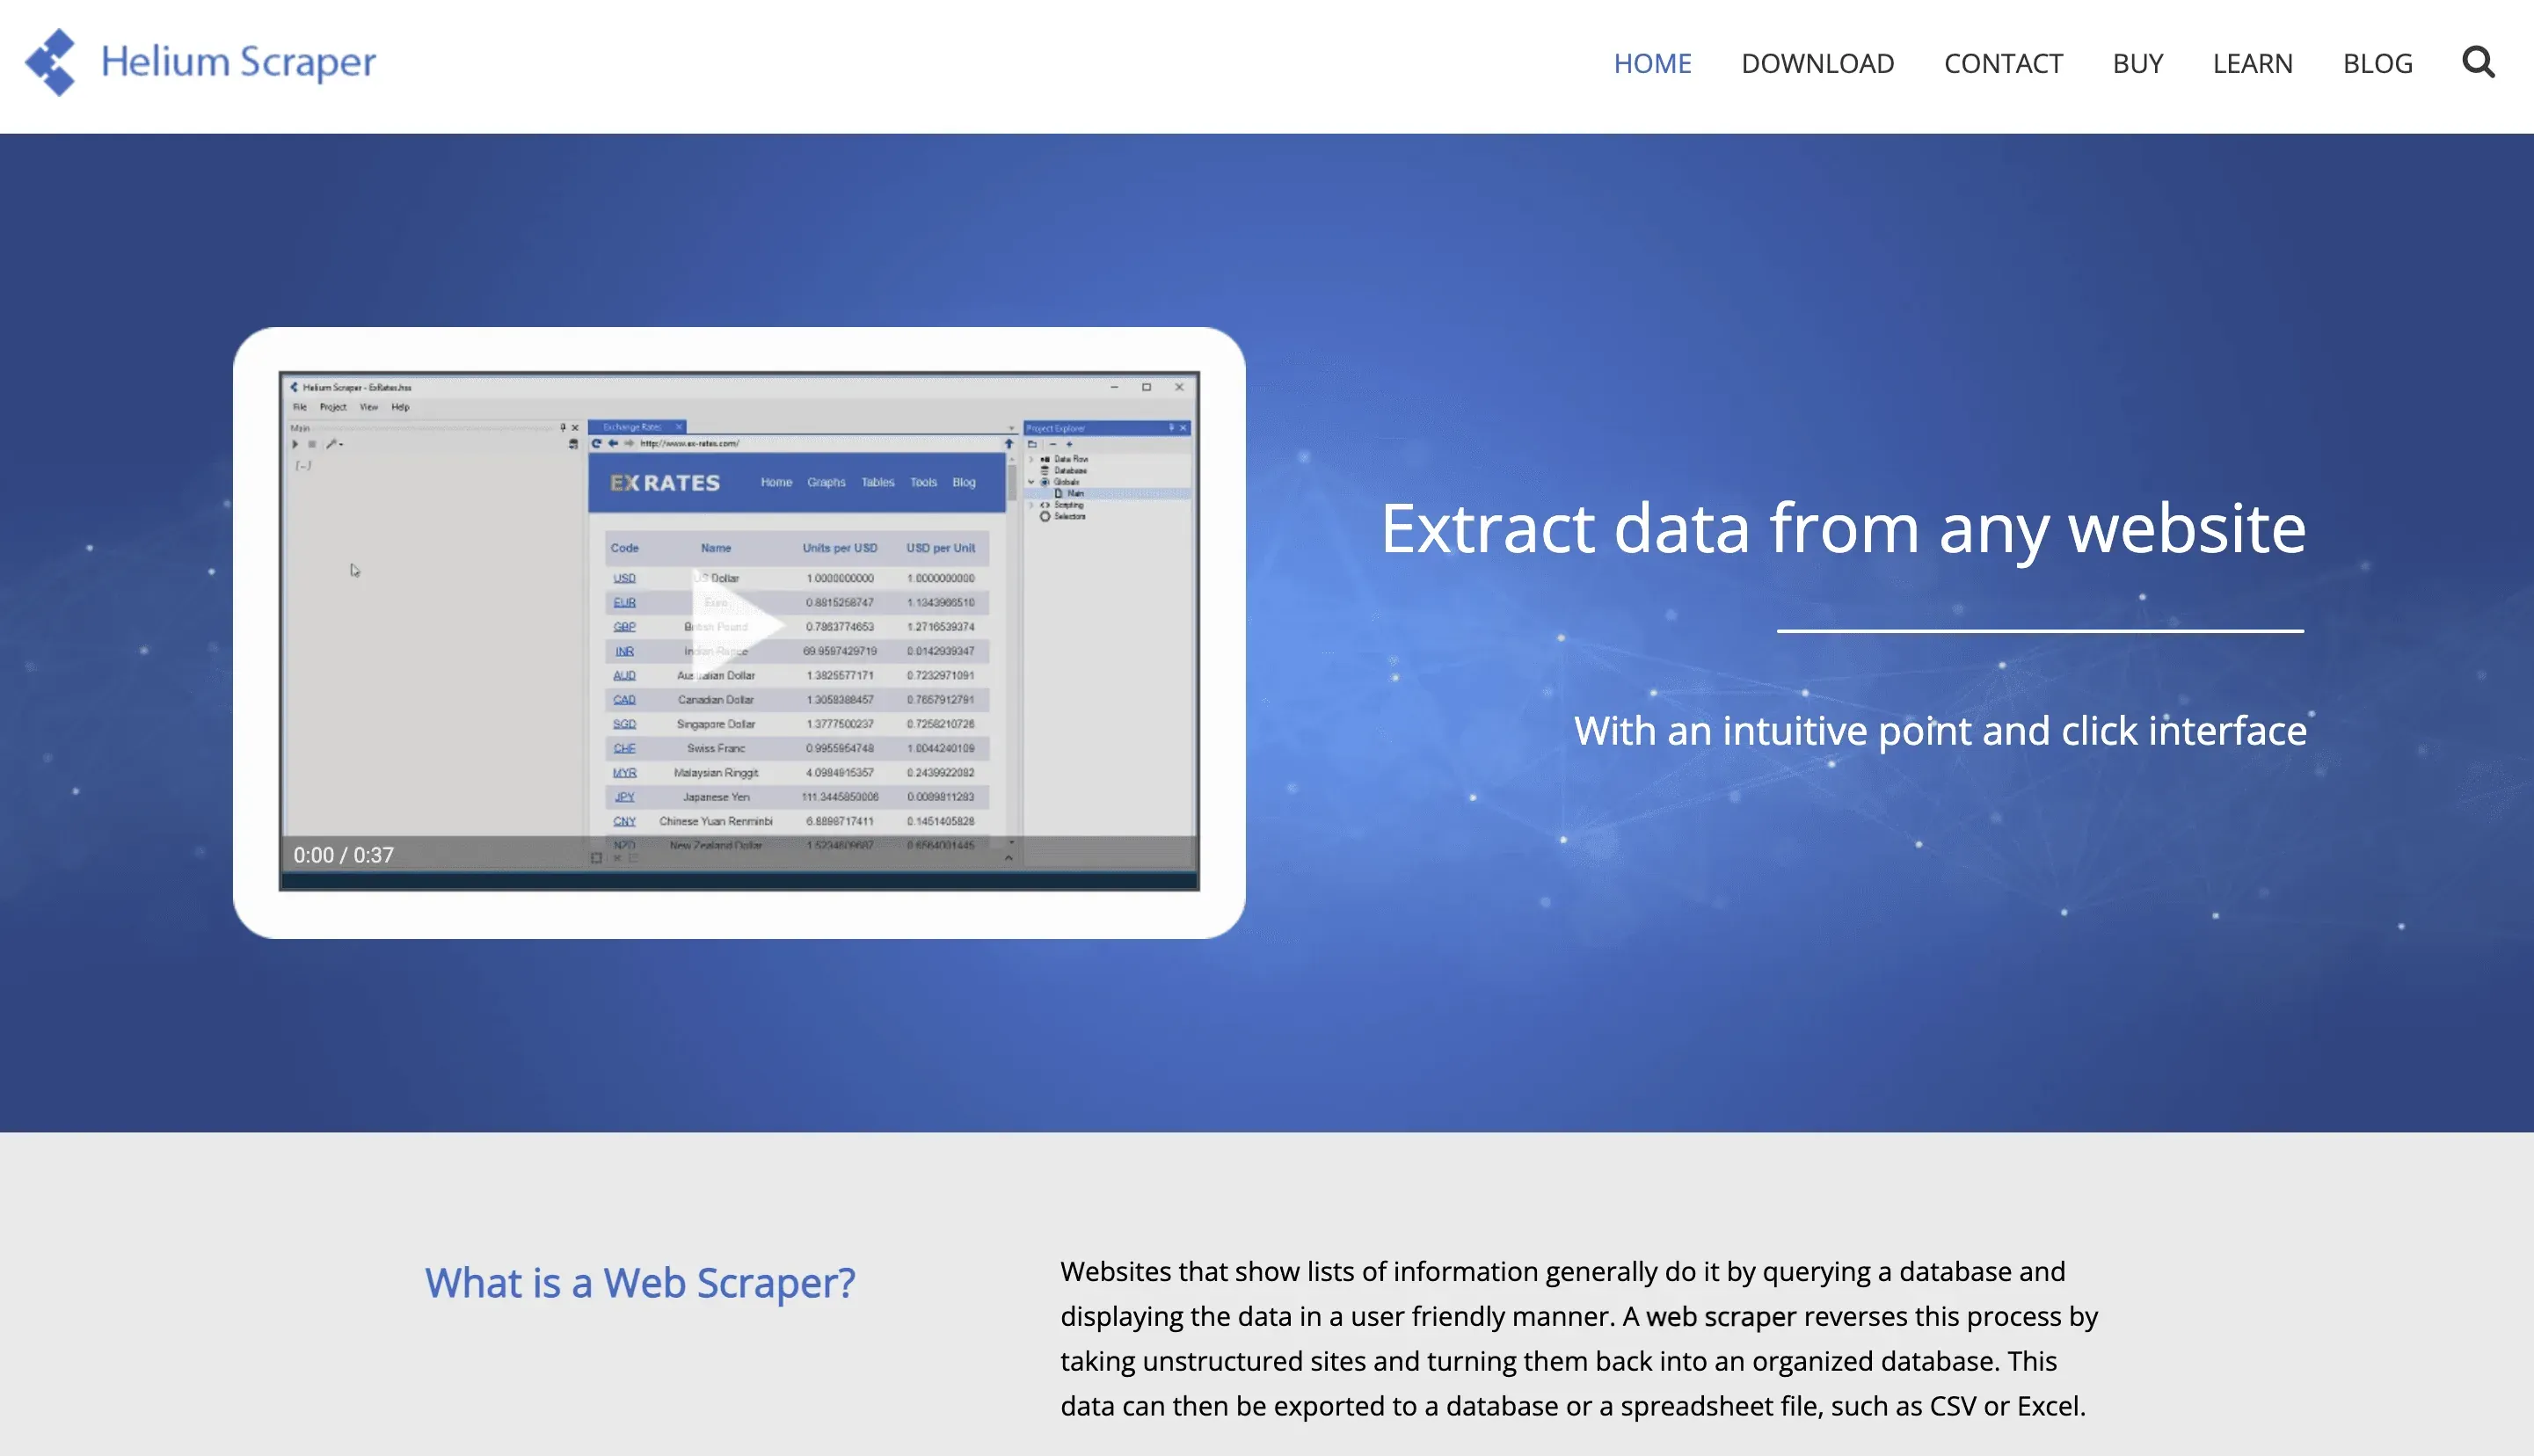 Helium Scraper är ett desktopverktyg med en visuell arbetsflödesbyggare, perfekt för att extrahera data från komplexa och dynamiska sajter.
Bäst för: Power users, analytiker och alla som vill ha flexibilitet utan kod.
Nyckelfunktioner:
- Visuellt arbetsflöde: Dra och släpp för att bygga extraktionslogik.
- Hanterar dynamiskt innehåll: Fungerar med JavaScript-tunga sajter.
- Datatransformering: Rensa och strukturera data innan export.
- Exportalternativ: Excel, CSV, databaser och mer.
- Engångsavgift: Livstidslicenser från 99 USD (Basic, 1 användare) till 699 USD (Enterprise, 10 användare) — ingen prenumeration (Helium Scraper).
Helium Scraper är särskilt bra för ovanliga sajter och skräddarsydda arbetsflöden.
Jämförelse av de bästa företagen inom web scraping: funktioner i korthet
Här är en snabb jämförelse sida vid sida som hjälper dig att välja rätt:
| Företag | Bäst för | Användarvänlighet | Automatisering & AI | Skalbarhet | Exportalternativ | Gratis nivå / pris |
|---|---|---|---|---|---|---|
| Thunderbit | Icke-kodare, SMB | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, Sheets, Notion | Gratis (6 sidor), 15 USD/mån+ |
| Scrapy | Utvecklare | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Python, CSV, DB | Gratis, open source |
| ParseHub | SMB, forskare | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | CSV, Excel, JSON | Gratis (5 projekt), 189 USD+ |
| Octoparse | Ops, marknadsföring | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, DB, API | Gratis (10k rader), 69 USD+ |
| DataMiner | Chrome-användare | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, Sheets | Gratis (500 sidor), 19 USD+ |
| Import.io | Stora företag | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Cloud | Skräddarsytt, 199 USD+/mån |
| Apify | Utvecklare, byråer | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Sheets | Gratis krediter, 29 USD+/mån |
| Diffbot | Research, analys | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, Knowledge Graph | 299 USD+/mån |
| WebHarvy | Windows-användare | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, XML, DB | Engångsavgift, från 129 USD |
| Mozenda | Stora företag | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Excel, API, Cloud | 99 USD+/mån, enterprise |
| Sequentum | Dataexperter, byråer | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | DB, API, Cloud | Endast betald licens |
| Helium Scraper | Power users, analytiker | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | Excel, CSV, DB | Engångsavgift, från 99 USD |
Snabbval:
- För icke-kodare: Thunderbit, DataMiner, ParseHub, WebHarvy
- För utvecklare: Scrapy, Apify, Sequentum
- För företag: Import.io, Diffbot, Mozenda
- För flexibla, visuella arbetsflöden: Thunderbit, Octoparse, Helium Scraper
Slutsats: Välj rätt partner för web scraping för ditt företag
Utforska fler guider om web scraping Get Started Free
Web scraping 2026 är inte bara för tekniknördar — det är en kärnförmåga för alla företag som behöver data för att fatta smartare beslut snabbare. Rätt företag inom web scraping kan spara dig timmar, öka din ROI och låsa upp insikter som konkurrenterna kanske missar.
Här är mitt råd:
- Matcha verktyget med teamet: Icke-tekniska användare kommer att älska Thunderbit eller DataMiner. Utvecklare bör titta på Scrapy eller Apify. Företag bör överväga Import.io eller Diffbot.
- Tänk på skala och integration: Behöver du samla in tusentals sidor? Vill du ha data i Sheets, Notion eller ditt CRM?
- Börja med en gratis testperiod: De flesta verktyg erbjuder en gratis nivå — testa dem i ett skarpt projekt innan du bestämmer dig.
- Var inte rädd för att kombinera verktyg: Ibland blir det bästa arbetsflödet en kombination av flera lösningar.
Och om du är redo att se hur enkelt web scraping faktiskt kan vara, testa Thunderbit. Dina kalkylblad (och ditt tålamod) kommer att tacka dig.
För fler fördjupningar, tips och guider, kolla in Thunderbit Blog.
Börja samla data med Thunderbit
Vanliga frågor
1. Vad är web scraping och varför är det viktigt för företag 2026?
Web scraping är den automatiserade processen att hämta data från webbplatser. Det är avgörande för företag eftersom det möjliggör snabb insamling av stora mängder data för leadgenerering, prisbevakning, marknadsundersökningar och mycket mer — vilket sparar tid och förbättrar beslutsfattandet.
2. Vilket företag inom web scraping är bäst för icke-tekniska användare?
Thunderbit och DataMiner är toppval för icke-kodare, tack vare sina AI-drivna och visuella gränssnitt. Båda låter dig extrahera data med bara några få klick, utan att skriva kod.
3. Vilka funktioner bör jag leta efter hos ett företag inom web scraping?
Titta efter användarvänlighet, automatisering (sidnumrering, undersidor, schemaläggning), skalbarhet, exportalternativ (Excel, Sheets, API:er) och stark kundsupport. Välj ett verktyg som passar både din tekniska nivå och dina affärsbehov.
4. Finns det gratis lösningar för web scraping?
Ja! Thunderbit, DataMiner, ParseHub och Octoparse erbjuder alla gratisnivåer. Scrapy är open source och gratis för utvecklare. Gratisplaner är utmärkta för små projekt eller för att testa innan du skalar upp.
5. Hur håller jag mig kompatibel och etisk när jag samlar in data?
Följ alltid webbplatsens användarvillkor och integritetspolicy. Samla bara in offentligt tillgänglig data, överbelasta inte sajter och var noga med dataskyddsregler som GDPR. Många ledande företag inom web scraping erbjuder efterlevnadsfunktioner och guider för bästa praxis.
Redo att börja samla data smartare? Testa Thunderbit gratis eller utforska fler guider på Thunderbit Blog.
Testa AI Web Scraper Get Started Free
Läs mer



