
Mozilla's Readability är den fristående JavaScript-portningen av motorn bakom Firefox Reader View. Den släpps som Apache-2.0-paketet @mozilla/readability och plockar ut artikelinnehåll direkt ur en levande DOM. Under Node behöver den därför en DOM-implementation som jsdom. Den hämtar inte sidor, kör inte deras JavaScript och gör ingen schema-baserad extrahering.
Versionen som testades här är npm latest på 0.6.0, publicerad den 3 mars 2025, med 11 361 stjärnor i repot när jag kollade den 27 juli 2026 (senaste push 9 juli 2026, så main ligger långt före den publicerade paketversionen). Jag körde den med jsdom 29.1.1 på Node v22.22.3 i macOS arm64, mot 22 märkta HTML-fixtures byggda för just detta ändamål, och alla mätningar här kommer från den uppsättningen. Praktiskt är det det minst krävande verktyget i sin kategori: två minuter att installera, inga binärer, ingen webbläsare som ligger och väntar i cachen, identisk output vid varje omkörning. Det intressanta är inte hur man använder det — utan att felen går att förutse från några få konstanter i källkoden, och en av dem styr mer än dokumentationen antyder.
Över 22 kontrollerade syntetiska fixtures lyckades Readability återställa alla 74 märkta artikelblock. Det avgränsade resultatet betyder inte att det aldrig tappar artikeltext: den publika verkliga sidbenchmarksiffran visar recall 0,982, och kända felmönster gick inte att reproducera här. Det tydligaste felet i fixturetesterna var extra syskoninnehåll som släpptes igenom av en länkdensitetsgräns i källkoden på 0,25. Hur allvarligt det ser ut beror på testmiljön.
Vad readability.js faktiskt är — och tre saker det inte är
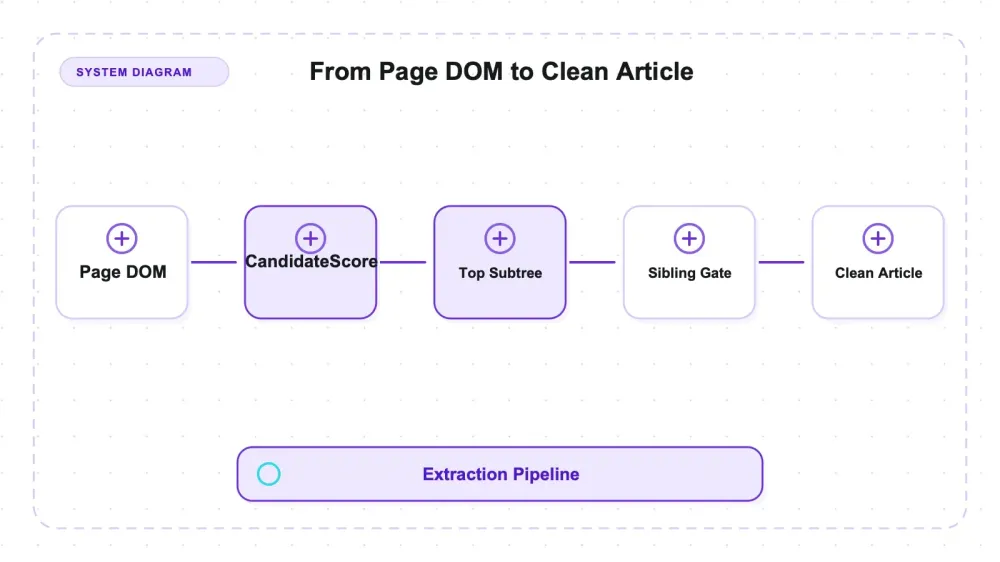
Readability är en regelbaserad poängsättningspassage över en DOM. Den går igenom kandidat-element, tilldelar varje element en innehållspoäng, för upp poängen till föräldrar, väljer underträdet med högst poäng och kör därefter städpass för att rensa bort sådant som liknar sidans fasta yta. Det är hela strategin för artikelutvinning — ingen modell, inga träningsdata, inga regler per webbplats. Det är därför den fungerar på en sida den aldrig sett förut — och därför att dess fel är förutsägbara utifrån källkoden, vilket är det roliga här.
Tre saker det inte är, och alla tre ställer till det för folk:
- Inte en hämtare. Den tar ett
document, inte en URL. Hämtning, återförsök, anti-bot och headers är ditt problem. - Inte en renderare. Ingen JavaScript-körning. Det DOM-innehåll du ger den är allt den ser.
- Inte en strukturextraktor. Du får
title,byline,excerpt,content(HTML),textContent,length,siteName. Ingen schema, inga typade rader, inget{name, price}.
Fyra konstanter gör större delen av jobbet
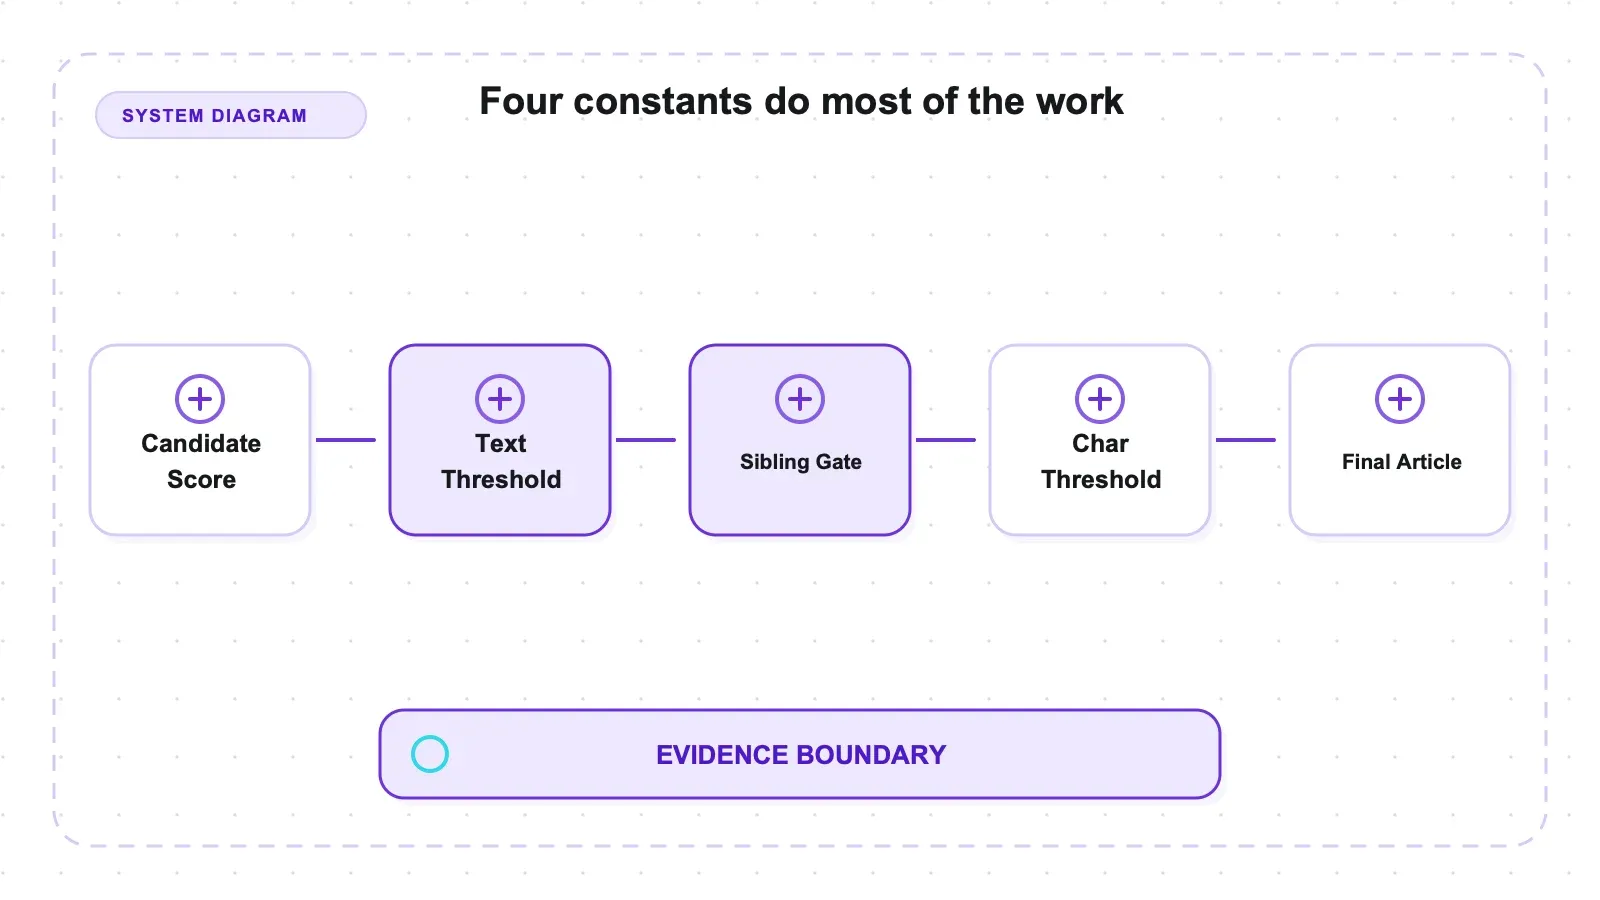
Att läsa Readability.js i node_modules berättar mer om beteendet än någon docs-sida gör. Fyra mekanismer står för det mesta av det biblioteket gör:
- Innehållspoäng per poängsatt paragraf:
1 + (commaCount + 1) + min(floor(len / 100), 3). Stycken under 25 tecken räknas inte alls. Poängen förs vidare till föräldrar med dividerare — föräldern får hela poängen, far-/morföräldern hälften och djupare anorlevel · 3. DEFAULT_CHAR_THRESHOLD = 500— minsta artikel-längd för en "lyckad" parsing. Under den körs ett nytt försök med färre städfilter.unlikelyCandidates-regexen — matchar klass- och id-delar somcomment,footer,menu,related,sidebar,social,sponsor. Matchande noder tas bort innan poängsättning.- Syskon-tilläggsregeln i
grabArticle— när toppkandidaten valts bedöms dess syskon för eventuell inkludering. Ett syskon följer med om dess egen poäng når tröskeln, ellernodeLength > 80 && linkDensity < 0.25, ellernodeLength < 80 && nodeLength > 0 && linkDensity === 0 && den innehåller en punkt.
Länkdensitet är Σ(linkText.length · coef) / textLength, med coef = 0.3 för rena #-href:er och 1 annars. Den regeln förklarar syskonläckagen som mättes här; den är inte hela extraheringsalgoritmen.
Uppställning, och beroendet som inte syns i pitchtexten
npm install @mozilla/readability jsdom och du är igång. Två minuter, inga binärer, ingen nedladdning efter installation, ingen webbläsare liggande i cachen. På installationsaxeln är det nära idealiskt.
Men "inga beroenden" syftar på algoritmen, inte runtime-miljön. Readability arbetar på ett levande document, och under Node betyder det att du själv måste leverera en DOM-implementation — här jsdom, version 29.1.1. jsdom är inte liten, och för de flesta pipelines är den den dominerande kostnaden i loopen, inte extraktionen. Räkna med det.
En till fallgrop som kostade mig en omkörning: Readability.parse() muterar DOM:en den får. Parsar du samma jsdom-document två gånger ser andra anropet en dokumentyta som det första redan har rivit sönder. Varje parse i mitt testbygge skapar en ny jsdom. Om du loopar över sidor och återanvänder ett dokumentobjekt för att spara tid är det den buggen du snart kommer att felsöka.
Hur jag testade det
Jag pekade inte detta mot levande nyhetssajter. Levande sidor ger dig ett resultat utan möjlighet att se varför — och med en heuristik är just "varför" hela poängen. I stället genererade jag 22 HTML-fixtures med 91 märkta block (74 artikel, 17 boilerplate), där varje ord i ett block föregås av blockets unika sentinel-sträng. Ordförråden mellan blocken är helt separata, så varje extraherat token pekar tillbaka till exakt ett block, och "återhämtat" eller "läckt" blir ett exakt medlemskapstest i stället för en ungefärlig matchning.
Extraktionssteget och poängsteget hålls medvetet isär. Node-runnern skriver ut endast rå extraherad text, isProbablyReaderable-värden och uppmätta länkdensiteter. All precision och recall räknas i efterhand från den råa texten mot etiketterna, av ett separat skript. Ingen metrikkonstant skrivs för hand någonstans i testbygget, vilket är det enda sätt jag litar på mina egna siffror.
Sedan matade jag in identiska bytes till trafilatura 2.1.0 för en jämförelse i samma testmiljö. Varje fixture parsades tre gånger; alla 22 gav byte-identisk text vid varje körning.
Du kan granska varje steg i stället för att lita på sammanfattningstabellen. tests/build_fixtures.mjs skapar den annoterade HTML:en och facit; tests/run_readability.mjs loggar extraktion och predictor-utdata; och tests/metrics.py räknar ut mätvärdena i efterhand. Rå Readability-output, beräknade mått och jämförelsen med samma input finns kvar i artifacts/raw/. Den uppdelningen spelar roll när ett resultat ser misstänkt ut: då kan du se om parsern returnerade oväntad text, om etiketteringen var fel eller om poängkoden klassade något fel. Reproduktion i det här paketet verifierar påståendena här, men det är fortfarande ett testbygge — inte bevis för att en verklig sidmix i produktion har samma felprofil.
Begränsningen är verklig och viktig: det här är syntetiska kontrollerade sidor, inte en verklig korpus. De auktoritativa siffrorna för verkliga sidor kommer från den publika article-extraction-benchmark, som ger readability_js 0.6.0 — exakt den version som testades här — word-F1 0,947 ± 0,005 (precision 0,914 ± 0,008, recall 0,982 ± 0,003) över ungefär 181 verkliga sidor. Det hänvisar jag till; det reproducerade jag inte.
Benchmark-raderna för aktuell release används här; historiska ersatta rader har uteslutits. De kontrollerade fixturesen lägger till en uppdelning per block som visar vilken innehållsform som triggar vilken regel, i stället för att ersätta den publika verkliga sidkorpusen.
Recall var perfekt i det syntetiska fixture-paketet
74 av 74. Över alla 22 fixtures tappade Readability inte ett enda märkt artikelblock — och på de elva rena syntetiska fixtures som blandade artikel och boilerplate landade mikro-averaged token recall på 1,000. Inte en enda artikelsats försvann.
Två brasklappar hör till det:
Det här är rena, enkelkolumniga syntetiska sidor. Verkliga artiklar är djupare nästlade, blandar ibland in annonser mitt i brödtexten och tappar ibland första stycket på grund av ett poängartefakt — den typen av missar rapporteras i ärendespåret (#437, #901 och innehåll före en tabell i #922). Mina fixtures utlöste inte någon av dem, så jag påstår inte att de är fixade — jag säger att mitt test inte nådde dit. På verkliga sidor är benchmark-recall för den här versionen 0,982, inte 1,000.
Ändå är riktningen i resultatet det viktiga. Readabilitys problem är inte att den kastar bort din artikel. Det är vad den tar med sig tillsammans med den.
Precisionssiffran, och varför den behöver tre etiketter
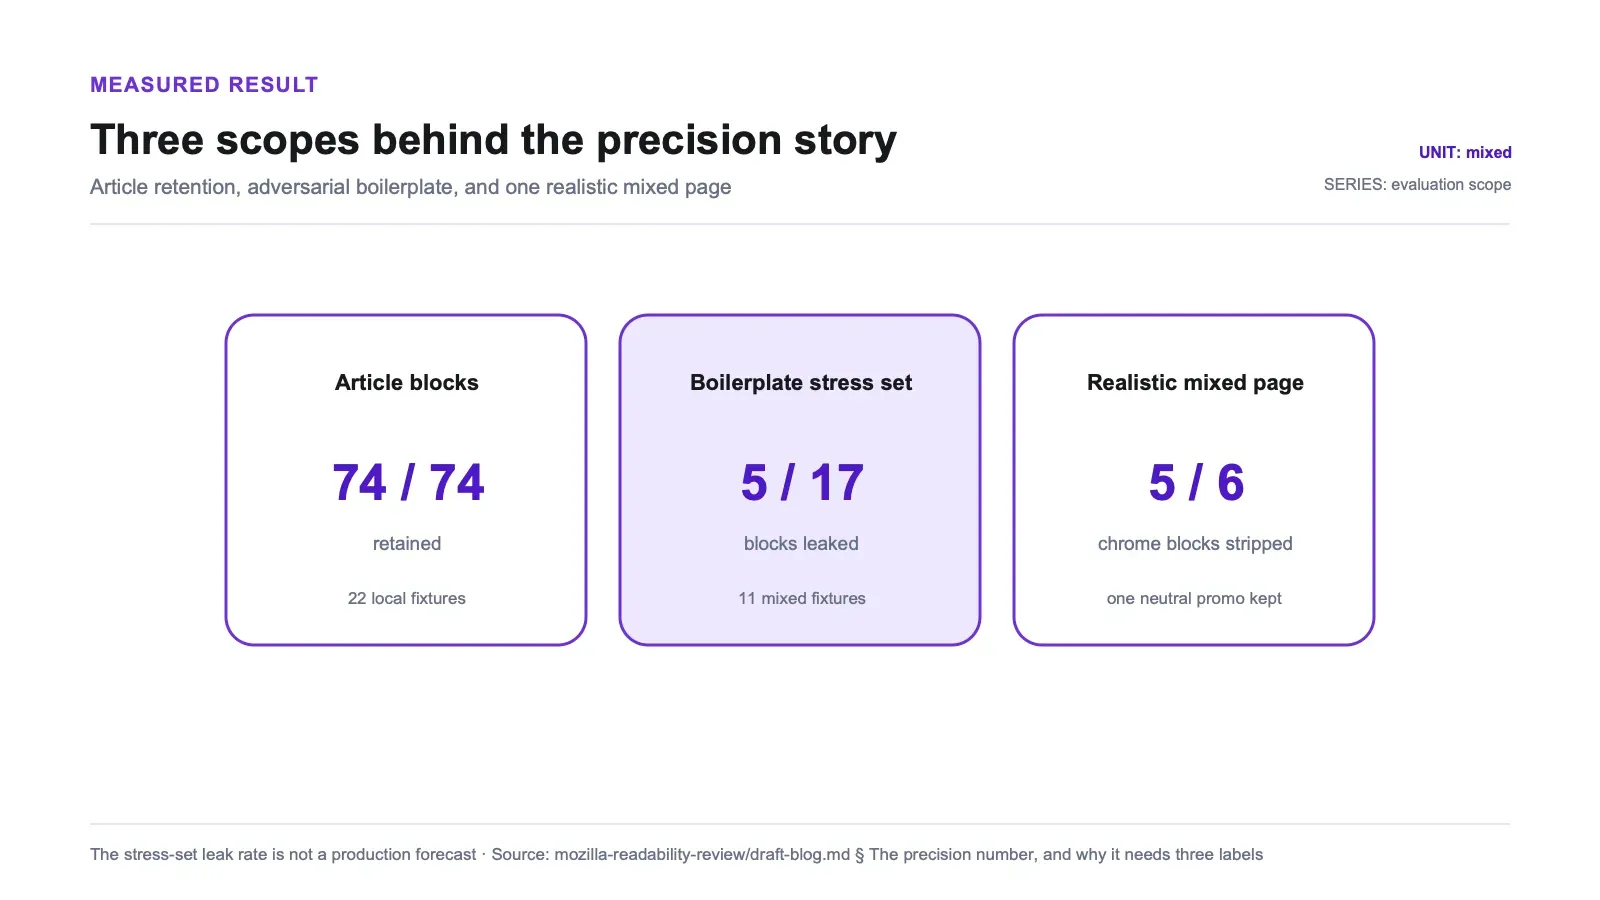
En siffra är lätt att citera och svår att försvara. På de elva blandade fixturesen behöll Readability 5 av 17 boilerplate-block — en läckfrekvens på 0,294.
Det är inte en verklig läckfrekvens. Tre olika upplägg mäter tre olika saker, och bara ett av dem beskriver vanliga sidor:
| Vad siffran mäter | Resultat |
|---|---|
| Fixturuppsättning viktad som motståndstest — 6 av de 11 blandade sidorna byggdes för att slå ut syskongrinden | 5 av 17 boilerplate-block behölls (0,294) |
Den enda realistiska sidan — <article>-kropp omgiven av nav, annonsbanner, sidebar, kommentarer, footer samt en neutralt klassad promo | 5 av 6 chrome-block rensades bort; 1 behölls |
| ~181 verkliga sidor, publik benchmark (inte min körning) | precision 0,914, recall 0,982, word-F1 0,947 — readability_js 0.6.0 |
Läs första raden som ett stresstest, inte som en prognos. Readability läcker inte 29% boilerplate i verkligheten. På den realistiska sidan försvann allt som bar en klass som unlikelyCandidates-regexen matchar — nav-menu, ad-banner, sidebar, comments, site-footer — helt rent, alla fem. Den enda överlevaren var det block jag konstruerade för att undvika regexen.
0,25-grinden: där borttagningen av boilerplate slutar
Regeln för syskon-tillägg finns dokumenterad i källkoden. Det ingen hade mätt, så vitt jag kunnat se, är exakt var den slår om. Så jag byggde en gradient: ett neutralt klassat <p class="teaser-block"> utanför <article>, en tydlig artikel på fyra stycken som säkert vinner som toppkandidat, och inget annat som varierar än promo-textens längd och länkdensitet. Densiteterna räknas med Readabilitys egen formel och mäts vid körning i stället för att antas:
| Promoblock | Längd i innertext | Över 80 tecken | Uppmätt länkdensitet | Utfall |
|---|---|---|---|---|
| Inga länkar alls | 126 | ja | 0,000 | behölls |
| En kort länk | 126 | ja | 0,143 | behölls |
| En längre länk | 126 | ja | 0,278 | släpptes |
| Halva texten länkad | 126 | ja | 0,476 | släpptes |
| Enkel mening, slutar med punkt | 60 | nej | 0,000 | behölls |
| Samma text, utan punkt | 59 | nej | 0,000 | släpptes |
Villkoret i källkoden använder en 0,25-tröskel; de uppmätta proverna låg på båda sidor om den, med 0,143 som behölls och 0,278 som släpptes. En separat gren behöll en 60-teckens mening som slutade med punkt och släppte en 59-teckens variant utan punkt. Artikel-recall låg kvar på 4/4 i varje gren, så dessa prover isolerar en precisionseffekt.
Utanför en testmiljö säger den grinden i praktiken: lång, låg-länkad, neutral prosa bredvid artikeln är artikel. Det beskriver mycket som inte är artikeln — en "Relaterad läsning"-ruta skriven som ett stycke, en nyhetsbrevspitch, en redaktionsnotis, en sponsrad teaser som marknadsteamet skrev i hela meningar med länken borttagen av spårningsskäl.
I ett RAG-index kan ett låglänkigt promotextstycke bli ett extraherat chunk och skapa en risk att retrieval eller generering behandlar det som artikelinnehåll. Källregeln gör det felet plausibelt; den här granskningen körde ingen end-to-end-utvärdering av retrieval eller modellcitat.
För ett webbplatsspecifikt hårt filter: filtrera bort kända DOM-containrar i förväg, behåll ursprungsnodernas anor för jämförelse innan serialisering, eller använd noggrant validerad textmönsterfiltrering i efterhand. Returnerad HTML bevarar inte nödvändigtvis längre om en nod ursprungligen låg utanför primärkontejnen. Syskongrinden går inte att justera via de publika alternativen.
Tre antaganden som fixturesen motsade
Fixturesen motsade tre antaganden: att charThreshold stoppar korta artiklar, att semantiska taggar krävs, och att kort icke-prosa tas bort. Bevisen nedan är den relevanta delen; ingen preregistrering behövs.
charThreshold = 500 är inte ett stup
Folktrons tolkning är att en artikel under 500 tecken ger null. Så är det inte. Jag körde kroppslängder från 120 till 1500 tecken mot charThreshold-värden på 200, 500 och 1000:
| Kroppslängd | Parse lyckades vid varje tröskel | Extraherad längd |
|---|---|---|
| 120 | ja | 161 |
| 300 | ja | 342 |
| 460 | ja | 509 |
| 520 | ja | 569 |
| 800 | ja | 841 |
| 1500 | ja | 1555 |
Platt. Identisk extraherad längd vid alla tre tröskelinställningar, oavsett kroppsstorlek. Tröskeln styr inte returvärdet — den avgör om grabben körs om med färre rensningsflaggor, och på en ren sida finns inget att rensa, så resultatet blir detsamma. Den verkliga null-gränsen är "ingen extraherbar text alls".
Det ger den faktiska missen här, och den är fulare än en falsk null. Jag matade den med en nästan tom sida — en navrad och en blänkare på fyra ord. Den returnerade utan fel, och "artikeln" den gav mig inkluderade navet. Finns ingen riktig artikel, då ger Readability dig boilerplate märkt som artikeln. Om du crawlar i stor skala och behandlar ett icke-null-resultat som "den här sidan hade innehåll" är det antagandet fel.
Semantiska taggar gör inte jobbet
Jag förväntade mig att recall skulle falla när jag tog bort ställningen. Samma artikeltext, två skal: ett med <main><article><h1> och beskrivande klassnamn, ett med <div class="x1"> och stycken som bara <div>. Resultat: 4 av 4 artikelblock återhämtades i båda, noll boilerplate läckte i båda. När artikeln tydligt är den tätaste textblocket på sidan hittar längd- och kommatals-poängningen den utan semantisk hjälp. "Readability behöver <article>-taggar" är folktro.
Den ärliga gränsen för det påståendet: min sida hade ett uppenbart innehållsblock. Där semantik rimligen kan göra skillnad är en sida med två konkurrerande täta underträd, och det testade jag inte.
Icke-prosa överlever intakt
Regeln om att "stycken under 25 tecken inte räknas" fick mig att vänta mig förluster i tabeller och bildtexter. Fel igen — den regeln påverkar kandidatens poängsättning, inte bevarandet. När containern väl vinner följer allt inuti med:
| Innehållstyp i artikeln | Readability | trafilatura |
|---|---|---|
| Prosa-paragrafer (×2) | behölls | behölls |
| Datatabellceller (×2) | behölls | behölls |
<pre>-kodblock | behölls | behölls |
Enradiga <p> under 25 tecken (×2) | behölls | behölls |
<figcaption> | behölls | släpptes |
| Totalt | 8/8 | 7/8 |
Det är en axel där den mer hårdhänta rensaren förlorar. Om dina sidor är dokumentation, guider eller något med kodblock och bildtexter är Readabilitys beteende att behålla hela det vinnande underträdet en styrka.
isProbablyReaderable säger nej när parse() säger ja
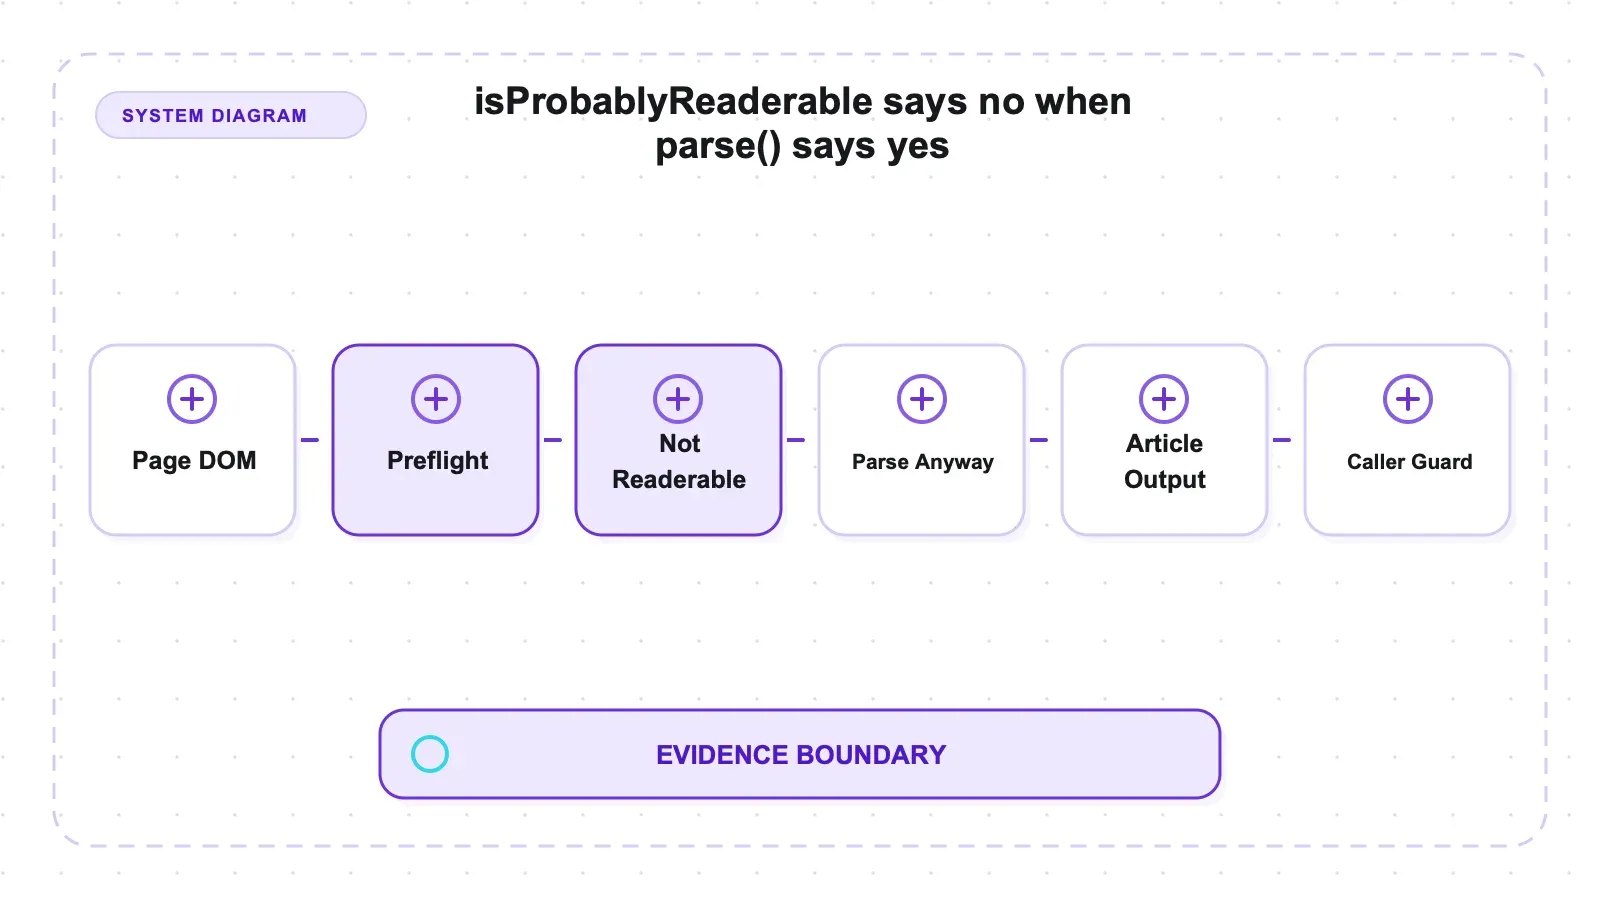
README:n föreslår att isProbablyReaderable(doc) används som en billig förkontroll innan man kör en full parse. I mina tester avvisade den tre olika sidtyper som parse() sedan hanterade fint:
| Sidtyp | Predictorns svar | parse() | Vilken parameter som fixar det |
|---|---|---|---|
Innehåll endast i <li>-element | false | lyckas | ingen — falskt vid varje minScore 1–80 och varje minContentLength 40–200 |
| Tio stycken, alla under 140 tecken | false | lyckas | minContentLength ≤ 100 (minScore gör inget) |
| Ett enda stycke på 408 tecken | false | lyckas | minScore ≤ 10 (poängen är ≈16,4) |
| Normal artikel (kontroll) | true | lyckas | — |
De tre felen har tre olika orsaker, och bara två är justerbara. <li>-fallet är strukturellt: predictor räknar bara p, pre och article-noder (plus div > br-föräldrar), så en sida där innehållet ligger i listobjekt matchar inget, får noll poäng och ingen tröskeljustering räddar den — en form som redan rapporterats i issue #662. Fallet med många korta stycken beror på en minContentLength-gräns som hoppar över varje stycke innan poängsättning, så tio hyfsat långa stycken summeras till noll; sänker du värdet fungerar det, men minScore hjälper inte. Det ensamma stycket är ren aritmetik: poängen är sqrt(408 − 140) ≈ 16,4, under standardvärdet minScore 20 — ett ensamt stycke måste vara 540 tecken långt för att själv nå över gränsen.
README:n varnar för att predictor ger falska negativa. Det jag skulle lägga till är den praktiska regeln: använd den inte som enda grindvakt. Om en sida spelar roll, parsa den och kontrollera resultatlängden. Parse-stegen är inte särskilt dyra jämfört med jsdom-bygget du redan har betalat för.
Samma bytes, två extraktorer
Att köra trafilatura 2.1.0 över identiska fixtures ger en tydligare bild än att ställa två siffror bredvid varandra från två olika testmiljöer, eftersom input är exakt samma bytes:
| Mått (11 blandade fixtures) | @mozilla/readability | trafilatura |
|---|---|---|
| Recall för artikelblock | 1,000 | 1,000 |
| Bevarade boilerplate-block | 5/17 (0,294) | 1/17 (0,059) |
| Token F1 (micro) | 0,948 | 0,969 |
| Bevarande av icke-prosa | 8/8 | 7/8 |
| Mycket kort artikel (120 tecken), token F1 | 0,800 | 0,571 |
Ingen av dem dominerar dessa fixtures. Trafilatura behöll färre syskonblock, medan Readability behöll mer kort innehåll och icke-prosa. Båda verktygens absoluta tokenprecision påverkas av oetiketterad rubriktext, så blocknivå-läckaget är den tydligare direkta signalen. Den publika benchmarken för verkliga sidor råkar ordna deras word-F1 på liknande sätt, men korpus och mått skiljer sig åt och detta är ingen korsvalidering mellan testmiljöer.
Robusthet, kortfattat: jag körde en medvetet trasig tvilling av den kanoniska sidan (oavslutade <p>, felnästlade <b>/<i>, en lös </div>) och recall blev 3/3 utan något läckage, i nivå med den välformade versionen. Där ska creden tillfalla jsdom:s HTML5-trädbyggare, som reparerar röran innan Readability någonsin ser den. Inga fixtures kraschade parsern.
För- och nackdelar
Fördelar
- Artikel-recall är den starka sidan: 74/74 märkta block återställda över 22 syntetiska fixtures, token recall 1,000 på den blandade uppsättningen.
- Regex-klassad sidboilerplate rensas pålitligt — nav, annonsbanner, sidebar, kommentarer och footer försvann alla på den realistiska sidan (5 av 6).
- Icke-prosa bevaras fullt ut: tabeller,
<pre>-kod, bildtexter och rader under 25 tecken överlevde alla (8/8), medan trafilatura släppte en bildtext. - Inget beroende av semantisk markupp — en neutraliserad
<div>-artikel poängsattes identiskt med<article>/<main>-versionen. - Korta artiklar avvisas inte felaktigt: ren text återställdes ned till 120 tecken, identiskt över
charThreshold200/500/1000. - Helt deterministisk: alla 22 fixtures gav identisk text över tre körningar.
- Två minuters installation, Apache-2.0, och versionen på npm är samma version jag testade (0.6.0), så inget här är föråldrat.
Nackdelar
- Syskon-tilläggsgrinden går att utnyttja: lång, låg-länkad, neutralt klassad promo-prosa går inte att skilja från artikeltext och följer med vid
linkDensity < 0,25. - På innehållsfattiga sidor returnerar den boilerplate som artikeln i stället för
null— den nästan tomma fixturen kom tillbaka med sin navrad som brödtext. isProbablyReaderableger falska negativa på tre olika sidformer, varav en inte går att justera bort med någon parameter alls.- Kräver en full DOM vid körning — berättelsen om "inga beroenden" döljer jsdom-kostnaden, som dominerar loopen.
parse()muterar indatadokumentet, så du måste bygga om DOM:en för varje sida.- Ingen hämtning, ingen JavaScript-rendering, ingen strukturerad output. Det är ett steg i en pipeline, inte hela pipelinen.
- Missar på verkliga sidor som rapporterats i ärendehanteraren (första stycket och bortfall före tabell) gick inte att reproducera i mina fixtures, så jag kan inte säga om de är sällsynta eller om mina sidor aldrig nådde dem.
Vem bör använda det, och vem bör hoppa över det
Välj Readability om du redan har HTML i handen och vill plocka ut artikeln i ren JavaScript, i en Node-tjänst där det vore bökigt att lägga till ett Python-beroende. (Jag samlade inte timing som en riktig fördelning, så jag gör inget hastighetspåstående utöver att "jsdom-bygget dominerar loopen, inte extraktionen.") Reader-läge, offline-arkivering av artiklar, nyhetsbrev via e-post, "ren vy"-knappar, webbläsartillägg, dokumentationsflöden med kodblock och bildtexter — det är den banan, och recall-siffrorna säger att det är en bra sådan. Beteendet går dessutom att läsa direkt ur källkoden, vilket är mer värt än det låter när du ska förklara för en kollega varför just ett visst block följde med.
Hoppa över det om precision i borttagning av boilerplate är det du mäts på, och särskilt om du matar ett LLM-index där ett löst promotionsstycke blir ett sökbart chunk. Hoppa över det om dina sidor renderar innehåll klient-side, eftersom det läser den DOM du ger det och inte kör JavaScript. Hoppa över det om du behöver {title, price, sku} snarare än prosa — ingen konfiguration gör en innehållsextraktor till en schema-driven extraktor. Och om du behandlar sidor där "fanns det ens en artikel på sidan" är en verklig fråga, lita inte på ett icke-null-svar som ditt facit.
Alternativ, och var Thunderbit-stacken passar in
Det här är inte en kritik mot ett gratis Apache-2.0-bibliotek som underhålls av Mozilla — Readability är infrastruktur, den har levererat i Firefox i åratal, och för reader-mode-extraktion är den referensimplementationen av en anledning. Vill du ha den bredare bilden har jag en löpande jämförelse i open-source scrapers roundup och en bredare översikt i the best web scraping tools.
För samma fixtures över alla sex extraktorer, se six-library extraction comparison.
Författarnotis: Thunderbit är vårt hanterade alternativ för rendering och extraktion från URL-inmatning. Den kördes inte på dessa fixtures, så ingen matchad kvalitetsgaranti antyds. Den relevanta gränsen är om du redan har en DOM och vill ha lokal artikelutvinning, eller om du vill ha hämtning/rendering och strukturerad output som en tjänst. Egen hosting undviker en leverantörsavgift men innebär fortfarande infrastruktur- och underhållskostnader.
Den ärliga avvägningen: Readability är gratis, transparent och din att köra — du kan läsa den exakta grinden som avgjorde din output, vilket inte är något ett hanterat API ger dig. En hanterad stack kostar pengar och döljer mekanismen, men den täcker stegen fetch-render-struktur som du annars skulle bygga själv. Om du vill åt den AI-assisterade delen av spektrumet har jag skrivit om att skrapa vilken webbplats som helst med AI och om AI-crawlers på andra ställen. Välj utifrån vilka steg du faktiskt vill äga.
Testa Thunderbit för webbdataextraktion
Slutsats
Readability är ett bra val när du redan har en DOM, kör JavaScript/Node och föredrar lite extra syskoninnehåll framför aggressiv utelämning. I det här fixture-paketet återställde den alla 74 märkta artikelblock och behöll tabeller, kod och bildtexter. Det resultatet är begränsat av syntetiska enkelkolumnssidor; publik recall på verkliga sidor är 0,982, kända missar nära öppningsstycke/tabell reproducerades inte, och innehållsfattiga sidor kan returnera boilerplate som artikeln.
Du måste bara väga svagheten rätt. Den största felytan i dessa fixtures är precision, och den ligger vid en specifik, dokumenterad rad i källkoden: ett syskon som är över 80 tecken långt och har länkdensitet under 0,25 läggs till din artikel, oavsett om det hör dit eller inte. Jag såg den växla mellan 0,143 och 0,278 på identisk text. Benchmarken på verkliga sidor rapporterar precision 0,914 och recall 0,982. Om du matar extraherad text till ett index som en modell senare ska citera, inspektera både kvarvarande boilerplate och utelämnad brödtext i stället för att anta att någon av felklasserna saknas.
Testa Thunderbit för webbdataextraktion Get Started Free
Vanliga frågor
Tar Mozilla Readability bort all boilerplate?
Nej, och siffran beror mycket på vad du mäter. I den publika benchmarken på verkliga sidor får readability_js 0.6.0 precision 0,914 — alltså är ungefär 8,6% av det som returneras inte brödtext. På en realistisk testsida hos mig rensades 5 av 6 chrome-block bort (nav, annons, sidebar, kommentarer, footer alla borta), och bara ett neutralt klassat promotionsstycke blev kvar. I en fixture-uppsättning som jag medvetet viktade med block designade för att slå ut heuristiken behöll den 5 av 17 — den sista siffran är ett stresstest, inte en verklig takt.
Behöver jag jsdom för att använda readability.js i Node?
Ja, eller någon annan DOM-implementation. Readability är ren JavaScript, men den arbetar på ett levande document-objekt, så under Node måste du själv leverera DOM:en — i mitt upplägg jsdom 29.1.1. Beskrivningen "inga beroenden" syftar på algoritmen, inte runtime-miljön. Lägg också märke till att parse() muterar dokumentet den får, så bygg en ny DOM för varje sida i stället för att återanvända en.
Vad gör egentligen charThreshold-alternativet?
Inte det de flesta tror. Det gör inte att korta artiklar blir null — jag återfick rena artiklar ned till 120 tecken, med identisk extraherad längd över charThreshold-värdena 200, 500 och 1000. Tröskeln styr om parsern kör om sin extraktion med färre rensningsflaggor; på en ren sida finns inget att rensa, så outputen blir densamma oavsett. Det verkliga null-fallet är en sida utan någon extraherbar text alls, och till och med en sida bara med nav kom tillbaka icke-null, med navet som artikel.
Ska jag köra isProbablyReaderable före parse()?
Använd den som en signal, inte som en låsning. Den gav false på tre sidformer där parse() sedan lyckades: innehåll inuti endast <li>-element, tio stycken under 140 tecken vardera och ett enda stycke på 408 tecken. <li>-fallet går inte att fixa genom att justera värden, eftersom predictor bara poängsätter p, pre och article-noder; fallet med många korta stycken kräver ett lägre minContentLength; det ensamma långa stycket kräver ett lägre minScore, eftersom ett ensamt stycke måste nå 540 tecken för att klara standardgränsen. Om en sida spelar roll, parsa den och kontrollera resultatet.
Readability eller trafilatura för artikelutvinning?
På identiska fixture-bytes behöll trafilatura mindre boilerplate (1/17 block mot 5/17), medan Readability återhämtade mer kort innehåll och behöll en <figcaption> som trafilatura släppte. Välj efter vilken felmarginal du tolererar och vilken runtime du vill ha. Den publika benchmarken är separat kontext, inte en validering av just detta fixture-resultat.




