
Katana är ProjectDiscoverys crawler för endpoint-upptäckt — en Go-binär med MIT-licens som tar en måladress och returnerar URL:er och endpoints för nästa verktyg i en pipeline. Den kan crawla i browserless HTTP-läge eller med -headless, som styr Chromium. Den officiella vägledningen lyfter headless som alternativet med högre täckning; det här testet visar varför typen av endpoint är minst lika viktig som antalet.
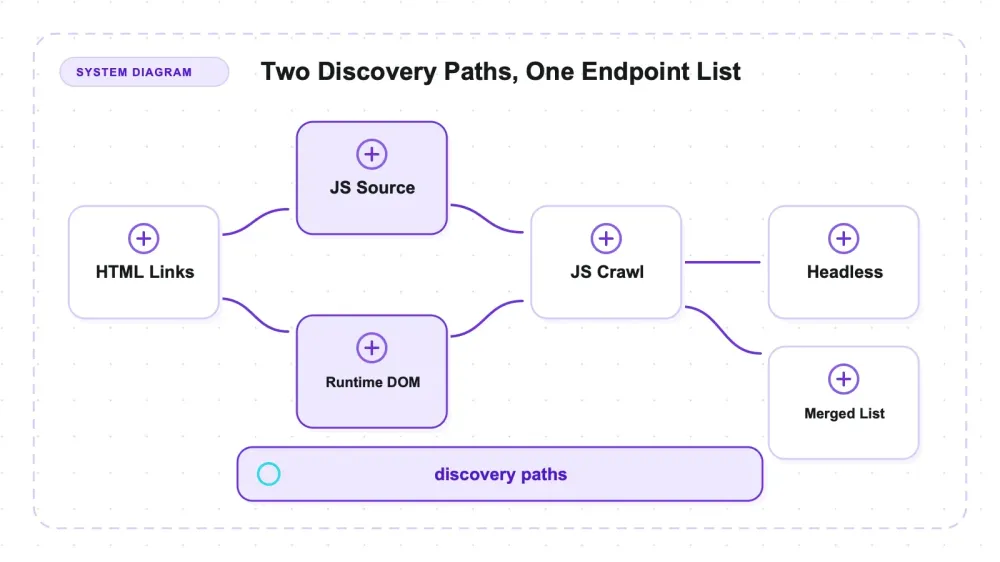
Jag byggde en liten sajt med tre medvetet olika endpoint-klasser och mätte vilket läge som hittade varje typ i v1.6.1 med -d 4. Vanlig HTML nådde 4/4 länkar och hela tre-hopp-kedjan i alla fyra konfigurationer. Skillnaden uppstod i endpoints som exponerades via JavaScript-kod respektive förändringar i DOM vid körning.
I det här testet hittade headless den runtime-DOM-klass som de testade browserless-lägena missade, medan standardläge med -jc hittade JavaScript-filernas literals som båda headless-körningarna missade. Ingen rad i fyrkommandots matris täckte båda klasserna. Scope, resume och known-files gav de andra praktiska gränserna.
Vad Katana faktiskt är
Katana-crawlern — projectdiscovery/katana på GitHub — är skriven i Go och licensierad under MIT. Jag testade v1.6.1 den 27 juli 2026; versionen spelar roll eftersom resultaten nedan om täckning och known-files är observationer bundna till just den byggnaden.
Här spelar kategorin större roll än vanligt. En crawler för endpoint-upptäckt är inte en fältextraktor. Om du vill ha en Go-webbcrawler som ger dig produktnamn och priser som strukturerad JSON, då är Katana helt fel hylla — den berättar gärna att /products/1138 finns, men inte ett dugg om vad som står på sidan. Det är avsikten, och att bedöma den på extraktion vore som att recensera en metalldetektor utifrån hur bra den värderar smycken.
Dess naturliga miljö är offensiv säkerhetsrecon och automationspipelines: STDIN in, URL:er ut, vidare till nästa verktyg. Därför måste en självklar brasklapp sägas direkt: alla mätningar här kördes mot ett lokalt fixture på 127.0.0.1 som jag själv skrev. Kör Katana på system du äger eller uttryckligen har tillstånd att testa, och inget annat. Det här handlar inte om att kringgå försvar, utan om hur mycket av en sajts endpoint-yta ett visst kommando faktiskt hittar.
De tre lägena, och vad de kan se
Standardläge är en Go HTTP-klient. Den hämtar, tolkar HTML, följer href-länkar och startar aldrig någon webbläsare. Snabbt, billigt, men blint för allt som bara uppstår efter att JavaScript körts.
-jc (-js-crawl) lägger till en JavaScript-tolk ovanpå den browserless vägen. Den laddar länkade .js-filer och plockar ut strängliterals som ser ut som URL:er ur källkoden. Ingen exekvering, bara läsning. Det finns också -jsl (jsluice), beskriven i README som en tyngre och mer minneskrävande parser — jag testade den inte, så jag kan inte säga något om huruvida den ändrar täckningsbilden.
-headless styr Chromium och kör sidans skript. I det här testet var det det enda testade Katana-läget som återfick sökvägen som sattes ihop av fragment och injicerades i DOM:en vid körning. Det resultatet säger däremot inget om vad varje parser eller framtida Katana-läge kan återfinna.
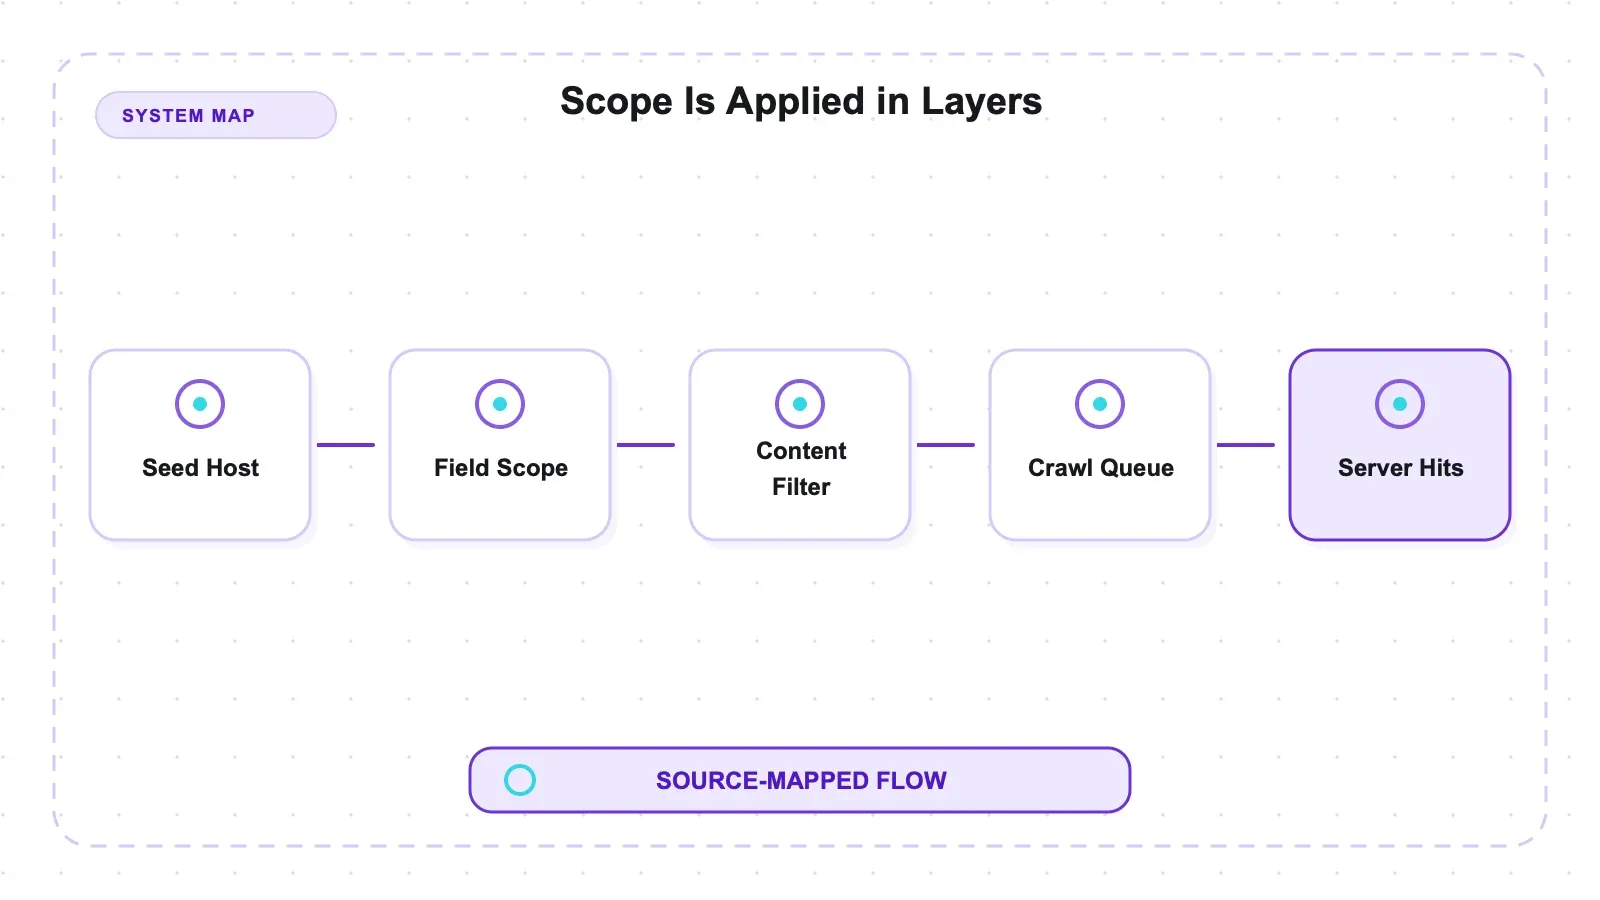
Sedan finns scope-modellen, och den är den del jag hade internaliserat innan jag skrev något alls mot produktion.
| Flagga | Vad den styr | Värden / standard |
|---|---|---|
-fs (field scope) | vilka hosts som är aktuella | dn, rdn, fqdn, eller ett eget regex — standard är rdn |
-cs och -cos | URL-regexar som filtrerar inom det field scope du redan har | — |
-kf | kända filer: robots.txt och sitemap.xml | README säger att det kräver minst djup 3 |
-d | djup | standard 3 |
-resume | återupptar en avbruten crawl | — |
Ordningen är inte kosmetisk: den avgör om ett host-regex breddar en crawl eller tyst gör den tom.
Setup: en binär, en asterisk
Tre vägar in, och bara en av dem vill ha en toolchain:
| Installationssätt | Förutsättning |
|---|---|
Från källkod: go install github.com/projectdiscovery/katana/cmd/katana@latest | Go 1.25 eller senare anges som krav |
| Förkompilerade binärer på releasesidan | ingen toolchain |
| Docker-image | ingen toolchain |
Min installation hamnade i ~/go/bin/katana och rapporterade Current version: v1.6.1 vid varje körning. Hittills den vanliga, trevliga Go-historien: en fil, ingen runtime.
Asterisken är headless, där webbläsaren är ett separat krav utöver binären:
Var -headless körs | Vad som krävs |
|---|---|
| Min maskin | katana hittade automatiskt en redan installerad Chromium; jag noterade inte browser-byggnaden och angav ingen browser-path |
| En ren server, enligt projektets Ubuntu-instruktioner | apt install google-chrome-stable innan headless gör något |
| Docker-vägen | kör headless med -system-chrome |
På en ren server försvinner den bekvämligheten. Räkna med en webbläsare, inte bara en binär, så fort -headless dyker upp i kommandoraden.
En mindre sak värd att känna till om du kör detta i CI: Katana gör ett versionskontroll-anrop till GitHub vid uppstart. -duc stänger av det. På en laptop är det brus; på en air-gappad eller rate-limited runner är det en nätverksrunda per körning du inte bad om. Mina timingkörningar använder -duc så att siffrorna mäter crawling, inte ett hemringningsanrop.
Så testade jag
Tre klasser av endpoint, valda just för att skilja lägena åt. Allt ligger i en lokal fixture-server, och ground truth skrevs ned innan någon crawl kördes, så recall mäts mot en fast mängd i stället för mot vad Katana råkade skriva ut.
- Klass A — vanlig HTML.
/page/a,/page/b,/page/c, plus en tre-hopp-kedja/depth/1 → /depth/2 → /depth/3. Alla crawlers borde hitta dessa. - Klass B — literals i JavaScript-filer.
/api/js-endpoint-7och/api/js-endpoint-8finns bara som strängliterals i en länkad/static/app.js. De går att läsa utan browser, om något faktiskt läser JS-koden. - Klass C — bara runtime-DOM. En sökväg som sätts ihop vid körning från fragment (
'endpoint' + (6 * 7)) och injiceras i DOM:en av skript. Strängen/runtime-only/endpoint42förekommer aldrig sammanhängande i något byte som servern skickar — varken i HTML eller i JS-källan. Bara exekvering avslöjar den.
Dessutom fanns en robots.txt, en sitemap.xml med två <loc>-endpoints som inte syntes någon annanstans, en route som returnerar 500, en död länk och en länk utanför scope som pekar mot en andra server på ett annat hostname.
Instrumentet är lika viktigt som fixturet: servern räknar vad som faktiskt hämtades, så påståenden om scope och resume vilar på träfflogik, inte på Katana:s egen stdout. Råa körningar finns committade i benchmark-repot om du vill kontrollera min matematik.
Täckningsskillnaden ingen brukar kvantifiera
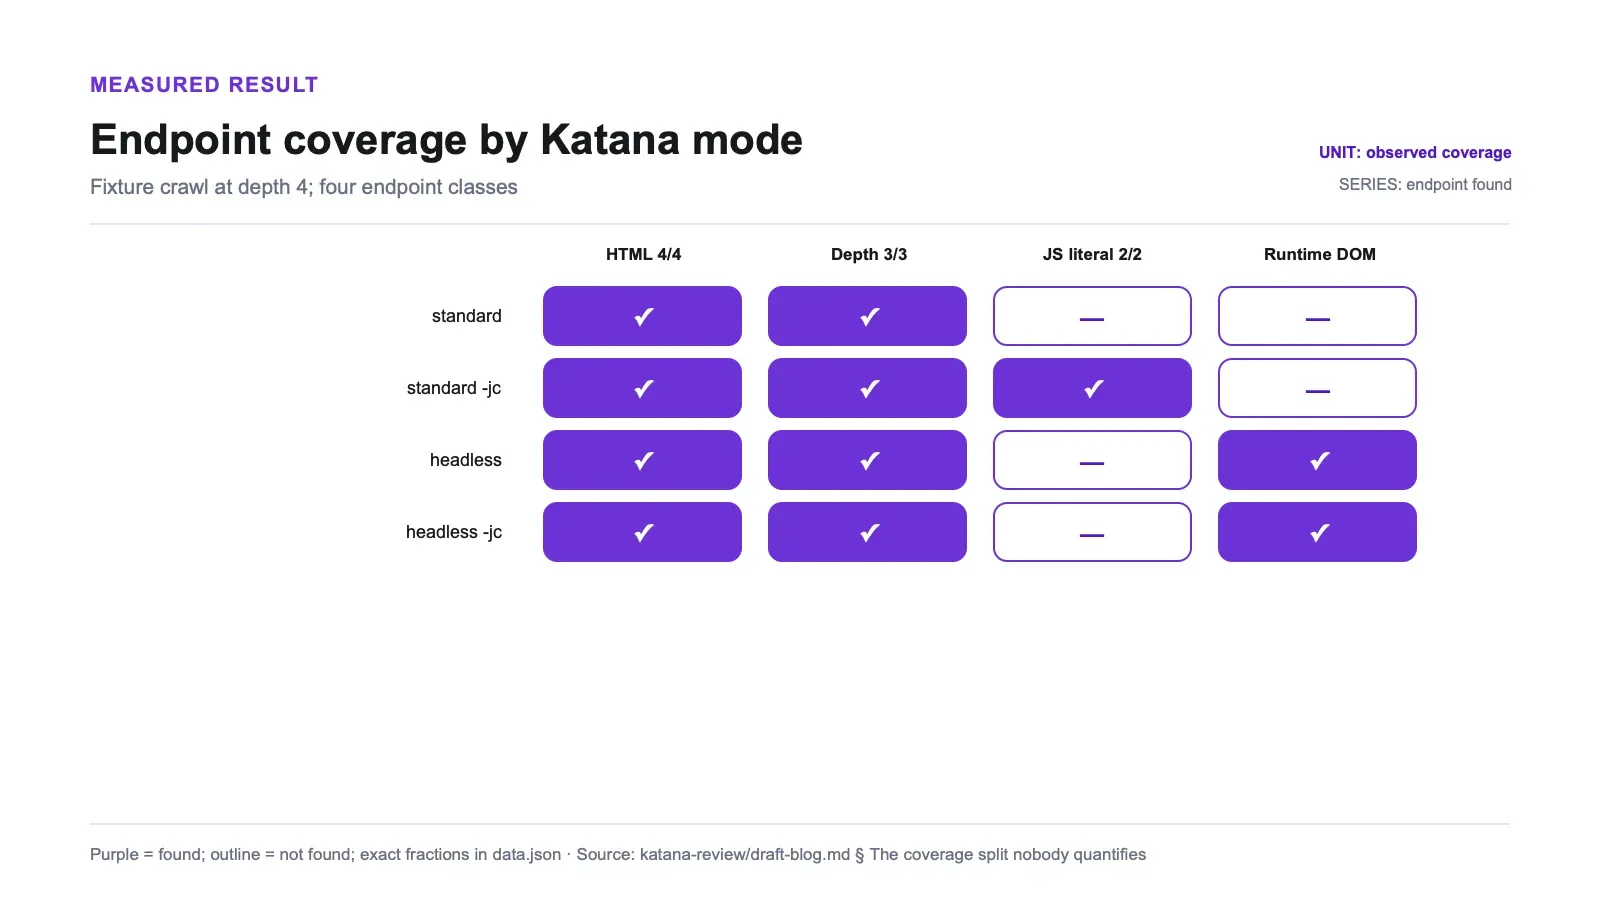
Matrisen, läge per endpoint-klass, vid -d 4:
| Läge | HTML-länkar (A) | Djupkedja (A) | JS-fil-literals (B) | Runtime-DOM (C) |
|---|---|---|---|---|
| standard | 4/4 | 3/3 | 0/2 | hittades inte |
standard -jc | 4/4 | 3/3 | 2/2 | hittades inte |
-headless | 4/4 | 3/3 | 0/2 | hittades |
-headless -jc | 4/4 | 3/3 | 0/2 | hittades |
Läs de två sista kolumnerna tillsammans så blir problemet tydligt. Klass B hittades av exakt en konfiguration: standardläge med -jc. Klass C hittades av exakt två: båda headless-körningarna. Det finns ingen rad med träff i båda kolumnerna. Hela matrisen finns i discovery-summary.json, där det beräknade fältet headless_jc_covers_both är false.
Den praktiska konsekvensen är att ”använd bara headless för bättre täckning” var ofullständigt för det här testet. Headless la inte till klass B ovanpå standardresultatet; det återfick klass C men missade klass B. Att täcka alla planterade klasser i det här fixturet krävde två crawls och en sammanslagning:
katana -u https://target.example -jc -d 4 -silent -o pass-jc.txt
katana -u https://target.example -headless -d 4 -silent -o pass-headless.txt
sort -u pass-jc.txt pass-headless.txt > endpoints.txt
Raden -headless -jc är den jag helst vill ha ett svar från upstream om. Att lägga JavaScript-parsern på headless-körningen gav inget nytt — fortfarande 0/2 på klass B, i varje körning, inklusive en färsk reproduktion. Jag rapporterar beteendet, inte påstår mig ha spårat mekanismen; jag instrumenterade inte Katana:s internals för att ta reda på varför browser-vägen slutar bidra med JS-fil-literals. Se det som en reproducerbar observation och ett bra GitHub-ärende, inte en diagnos. (Värt att notera här också: kombinationen -hl -jc avslutades snyggt med returkod 0 på v1.6.1 på macOS ARM, vilket historiskt inte alltid varit fallet.)
Den officiella dokumentationen beskriver headless som bättre för täckning, och det stämde här för den runtime-renderade klassen. Den granskade vägledningen förklarade däremot inte den här uppdelningen mellan source-literals och runtime-DOM, så se matrisen som en anledning att testa båda vägarna mot dina egna endpoint-klasser, inte som en universell taxonomi.
Vad headless kostar i väggtid
Tre sekventiella körningar per läge på en i övrigt idle maskin:
| Läge | p50 | min–max | medel |
|---|---|---|---|
| standard | 13.08s | 13.07–13.17s | 13.11s |
-headless | 66.82s | 66.78–67.68s | 67.09s |
Det är ett 5,1x-förhållande med intervall som inte ens kommer nära att överlappa — min långsammaste standardkörning (13.17s) slog fortfarande min snabbaste headless-körning (66.78s) med mer än 53 sekunder (cost-summary.json). Det här är inte mätbrus.
En brasklapp om de där 13 sekunderna: mitt fixture innehåller medvetet en 500-route och en död länk, och standardläget sitter igenom den förvalda -timeout 10-retry-svansen på båda. Jag finjusterade inte timeout för att få snabb-läget att se bättre ut, vilket betyder att en justerad standardkörning sannolikt skulle öka gapet snarare än minska det.
Förhållandet är en lokal kapacitetsindikator, inte en prognos för produktion. Verkliga mål varierar i latens, fel, skriptarbete och schemaläggning, medan det här fixturet innehåller en standardiserad timeout-svans. Använd den uppmätta skillnaden på 5,1x för att avgöra om headless förtjänar en egen budget och en egen målsubmängd, och benchmarka sedan den planen mot representativa auktoriserade hosts.
Scope höll, men en flagga gjorde tyst ingenting
Scope-testet använde två servrar: den primära på 127.0.0.1, och en andra som nås som localhost på en annan port och serverar en path som bara finns där. Så en träff på den pathen bevisar att out-of-scope-host faktiskt hämtades, inte bara skrevs ut.
| Konfiguration | Hämtades out-of-scope-host? | Träffar på den andra servern |
|---|---|---|
standard (-fs rdn) | nej | 0 |
-fs fqdn | nej | 0 |
-cs localhost | nej | 0 |
| `-fs '(127.0.0.1 | localhost)'` | ja |
Scope-disciplin är goda nyheter: som standard höll sig Katana hemma, och det krävdes en uttrycklig handling för att bredda. Det är rätt standard för ett verktyg som riktas mot andras infrastruktur.
Den intressanta raden är -cs localhost. Den breddade inte crawlen till den andra hosten — och den gav också noll URL:er alls. Eftersom -cs filtrerar inom field scope, och field scope fortfarande var den primära hosten, matchade regexen ingenting och crawlen returnerade en tom mängd i stället för ett fel. Om du någon gång har skrivit ett crawl-scope-regex som nämnde en host du ville inkludera och sedan stirrat på en tom outputfil, så är det den mekanismen (scope-summary.json). För att lägga till en host, sätt -fs. För att snäva in inom hosts du redan har, använd -cs/-cos.
Resume är grövre än flaggan antyder
README beskriver flaggan som -resume string resume scan using resume.cfg, vilket låter som en fil som läggs i arbetskatalogen. Det är det inte. På min maskin skrevs checkpointen till ~/.config/katana/resume-<xid>.cfg — uppmätt, inte läst från en docsida, eftersom dokumentationen inte anger någon sökväg.
Det viktigare överraskningen är vad som faktiskt ligger i filen. Den innehöll en InFlightUrls-map med exakt en sak: seed-URL:en. Inte besökt mängd, inte fronten. Så här såg det ut när jag avbröt en crawl med SIGINT efter tre sekunder och sedan återupptog den:
| Körning | Distinkta paths |
|---|---|
| Full baseline crawl | 11 |
| Hämtade innan avbrottet | 10 |
| Hämtades om av resume-körningen | alla 11, inklusive alla 10 som redan var klara |
Resume nådde samma slutliga endpoint-mängd, så inget är trasigt. Men checkpointens granularitet är per input-seed, inte per URL — den in-memory dedupe-filtret sparas aldrig, så att återuppta en single-seed crawl gör om den seed:en från början (resume-summary.json). Om du matar Katana med en lista på 500 hosts borde resume spara de hosts som hann bli helt klara; det beteendet för flera seeds följer av hur state lagras, men jag mätte bara single-seed-fallet. Om du är djupt inne i en enorm sajt ger resume dig korrekthet, inte tid.
Known files: begärda, sedan tappade
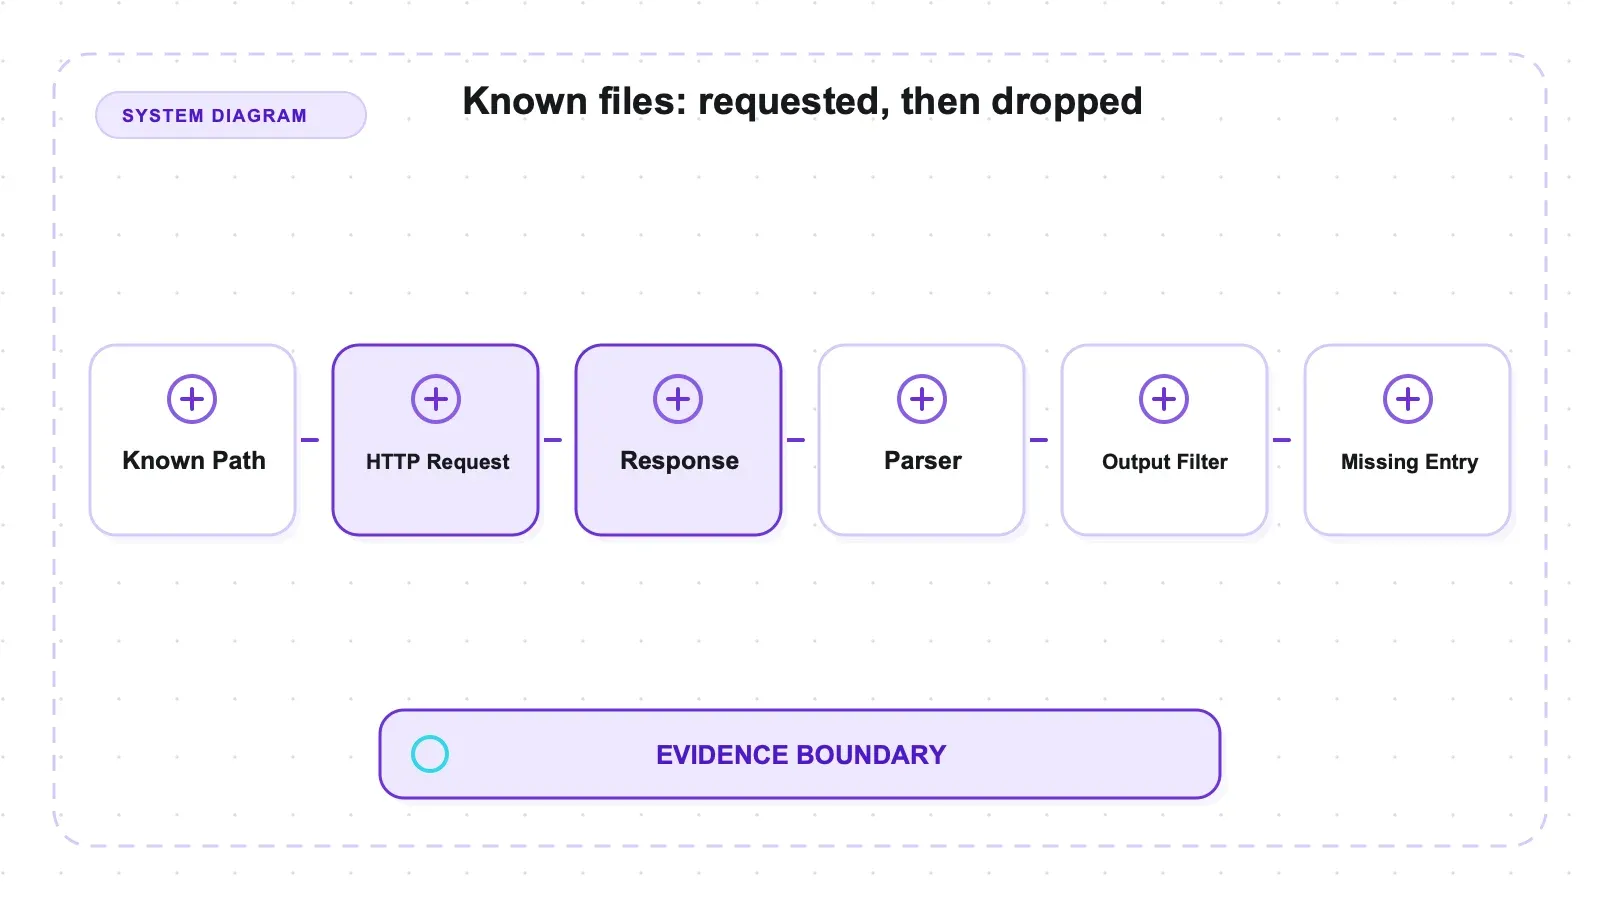
-kf all -d 3 begärde faktiskt båda filerna — robots.txt och sitemap.xml syntes i serverns hitlogg — och återfick sedan 0 av 2 av endpoints som listas i sitemapens <loc>-element. Recall 0,0.
Innan jag kallade det en begränsning försökte jag göra det till mitt fel. Varje variation gav samma resultat:
| Testad variation | Återfick sitemapens <loc>-endpoints |
|---|---|
-kf all | 0/2, recall 0,0 |
-kf sitemapxml | 0/2, recall 0,0 |
-kf robotstxt | 0/2, recall 0,0 |
| djup 3 | 0/2, recall 0,0 |
| djup 4 | 0/2, recall 0,0 |
| djup 5 | 0/2, recall 0,0 |
med -jc tillagt | 0/2, recall 0,0 |
seedad direkt på /sitemap.xml | 0/2, recall 0,0 |
Det dokumenterade kravet — använd -kf, gå minst tre nivåer djupt — uppfylldes varje gång. Det här är alltså inte en missing-flag-historia.
Det användbara beslutet kommer först: på det här IP-litterala fixturet ska du inte anta att en begäran om known files betyder att deras <loc>-URL:er faktiskt lades in i crawlen. Verifiera recall, eller extrahera och seeda de URL:erna själv.
Kodvägen i v1.6.1 stämmer med observationen, men jag instrumenterade den inte under körningen. I sitemapxml.go vid v1.6.1 bygger NewNavigationRequestURLFromResponse navigeringsförfrågningar från en respons utan att RootHostname är ifylld. Begäran når sedan ValidateScope; i scope.go vid v1.6.1 jämför IP-litteral-grenen URL-host med den tomma rooten och kan avvisa den. Det egna kommandot -fs '(127.0.0.1|localhost)' tog en annan scope-gren i ett separat scope-test, så det är en källpredikterad räddning, inte en uppmätt -kf-workaround. Ett försök att bekräfta detta blockerades av intermittent dialing i known-files-klienten på den här hosten; det rapporterade resultatet förblir därför 0/2.
Det jag faktiskt skulle göra i produktion, tills någon bekräftar flaggan: hämta sitemap själv, extrahera <loc>-URL:erna och ge dem till Katana som en seed-lista. Två rader shell, ingen scope-validering inblandad.
En sak betedde sig exakt som utlovat och förtjänar en rad: 500-routen och den döda länken hämtades, loggades och kördes vidare förbi. Varje browserless-körning avslutades med returkod 0. En crawler som dör vid första felaktiga svar är värdelös utan uppsikt, och Katana gör inte det.
En mål-specifik täckningskontroll före driftsättning
Fixturematrisen är mest användbar som mall för att testa dina egna auktoriserade targets. Definiera endpoint-klasser innan du kör Katana: vanliga länkar, literals i länkade skript, routes som bara skapas efter exekvering och poster i known-files är fyra rimliga startkategorier. Behåll ett litet ground-truth-sample för varje klass. Utan den förlistan kan en större stdout-fil se ut som bättre täckning även när en klass har försvunnit.
Kör browserless- och headless-vägarna som separata mätningar först. Spara exakta kommandon, Katana-version, browser-build, returkoder och output. Normalisera och diff:a endpoint-mängderna i stället för att jämföra radantal. Om standard -jc inte bidrar med något unikt på ditt sample kan en headless-only-policy räcka; om mängderna divergerar som här, håll de två passagerna åtskilda och slå ihop efter insamling. Att lägga båda flaggorna i ett kommando ska inte antas vara samma sak som unionen förrän den målspecifika diffen bevisar det.
Validera scope med bevis utanför Katana:s output. Lägg en canary-URL på en host som ska förbli exkluderad och inspektera den serverns request-logg. Testa också en avsedd andra host om crawlen ska breddas. Körningen -cs localhost här gav tom output eftersom content-scope-filtrering inte utökade field scope; det egna -fs '(127.0.0.1|localhost)'-kommandot kontaktade den andra servern. Det är viktigt att logga det exakta regexet, eftersom en enda teckenändring kan ändra själva regexet snarare än bara hur det ser ut.
Testa avbrott och known files separat från discovery recall. För resume, avbryt en representativ seed efter flera sidor, spara den genererade checkpoint-sökvägen och räkna hur många redan klara URL:er som hämtas igen. För -kf, bekräfta både att robots/sitemap faktiskt begärdes och att planterade <loc>-URL:er verkligen schemalades. Det är olika påståenden. I det här fixturet hämtades filerna medan de två sitemap-endpointsen saknades, så både request-loggar och endpoint-output behövdes för att se gränsen.
Slutligen: skapa ett lokalt kostnadsbaseline med sekventiella körningar på en i övrigt idle maskin och upprepa sedan på representativa hosts. Spara min, max och median, inte bara en multipel. 5,1x-siffran här inkluderar fixturets fel- och timeoutbeteende; den säger att headless förtjänar en egen budget, inte hur lång en produktionsinventering kommer att ta.
För- och nackdelar
Fördelar:
- Perfekt recall på vanlig HTML i alla lägen — 4/4 länkar och hela 3/3-djupkedjan, utan extra konfiguration.
-jcfungerar verkligen browserless: 2/2 endpoints återfick från strängliterals i en länkad JS-fil, utan browserkostnad.-headlessär det enda som hittade en endpoint som sattes ihop vid körning — en klass som per konstruktion är osynlig för source parsing.- Scope-standarderna är konservativa. Den out-of-scope hosten hämtades aldrig under standard,
-fs fqdneller-cs. - En enda Go-binär, MIT-licens, förkompilerade byggen och en Docker-image, pipeline-formad I/O.
- Robust vid fel: 500-svar och döda länkar stoppar inte crawlen.
Nackdelar:
- Ingen enskild körning täckte både JS-fil- och runtime-DOM-endpoints. Full täckning krävde två körningar och en merge.
-jcbidrog inte med något under-headless— 0/2 på klass B i varje headless-körning.- Headless kostar 5,1x väggtid (66.82s mot 13.08s p50, ej överlappande intervall).
-resumecrawlar om färdiga sidor inom en seed. Den återställer endpoint-mängden, inte den sparade tiden.- Known files begärde robots.txt och sitemap.xml men återfick 0/2 sitemap-
<loc>-endpoints mot ett IP-target. - Headless kräver tyst och stilla att Chromium finns installerad på maskinen; berättelsen om ”en binär” slutar vid webbläsaren.
- Bara discovery. Ingen strukturerad extraktion, ingen innehållskonvertering, inget fältschema.
Otestat, och därför utanför vad någon av dessa siffror täcker: -jsluice, ett särskilt djupgränstest vid -d 1/-d 2, multi-seed resume, automatisk formulärifyllning och vilken som helst verklig JavaScript-tung eller skyddad produktionssajt. Alla siffror gäller en maskin (macOS arm64) mot ett lokalt fixture.
Vem den är för, och vem som bör hoppa över den
Om ditt jobb är att producera en endpoint-inventering för infrastruktur du har tillstånd att röra, har Katana rätt pipeline-form: STDIN/STDOUT, en distributerbar binär och både browserless- och browser-backed-lägen. Tvåpass-merge var nödvändig för detta fixturets planterade klasser; om dina targets behöver båda passen eller inte måste fastställas från representativa sidor.
Hoppa över den om du vill ha data i stället för adresser. Katana kommer aldrig ge dig en tabell med produkter; den ger dig URL:erna där produkter kan finnas, och något annat gör extraktionen. Hoppa över den också om du behöver att ett enda kommando ska vara komplett — tvåpass-merge funkar fint i en pipeline och är irriterande vid prompten. Och om din enumerering lutar sig mot sitemap-<loc>-endpoints medan du riktar dig mot IP-addrresser, verifiera vad du faktiskt får innan du litar på outputen, eftersom den vägen i mitt fixture gav ingenting.
Alternativ och gränsen mot extraktion
Katana är gratis, MIT-licensierad och self-hosted. Den låter discovery, lägesval, webbläsardrift och resultatsammanslagning ligga på din sida av gränsen.
Inom open source är de användbara jämförelserna jobbför-jobb snarare än språk-för-språk. Colly är det andra Go-alternativet, men det är ett bibliotek du kompilerar med egna callbacks och det renderar inte JavaScript alls. Crawl4AI kör en riktig webbläsare och producerar Markdown för LLM-pipelines, vilket är ett helt annat utfall. Om du väger flera av dessa samtidigt lägger vår översikt över open source-scrapers kategorierna sida vid sida.
Upplysning: Thunderbit är utgivarens produkt och testades inte i det här Katana-fixturet. Den ligger nedströms i kategorin hanterad extraktion och omvandlar sidor till text eller strukturerade poster i stället för att inventera en auktoriserad targets endpoint-yta. Ett arbetsflöde kan använda båda kategorierna, men den här recensionen ger bara bevis för Katana:s discovery-beteende.
Prova Thunderbit för webdataextraktion
Slutomdöme
Använd Katana när leveransen är en endpoint-lista för targets du har tillstånd att crawla och du kan validera läges-täckningen mot just de targets. I det här fixturet återfick standard -jc de planterade JavaScript-file-literals, medan headless återfick runtime-DOM-endpointen; Katana:s testade browserless-lägen återfick inte den runtime-sökvägen. Standard scope höll dessutom den andra hosten ohämtad, och browserless-körningar fortsatte förbi både 500 och död länk.
Brasklapparna är operativa: en tvåpass-merge kan behövas för blandade endpoint-klasser, headless tog ungefär fem gånger lokal väggtid, single-seed resume hämtade om redan klara paths, och known-files-recall var 0/2 mot IP-targetet. Det här är resultat från v1.6.1-fixturet, inte garantier för varje sajt. De räcker för att definiera de kontroller en produktionsutvärdering bör upprepa.
Prova Thunderbit för webdataextraktion Get Started Free
Vanliga frågor
Var sparar Katana sin resume-fil, och hoppar återupptagningen över sidor jag redan crawlat?
Checkpointen hamnade i ~/.config/katana/resume-<xid>.cfg, inte i en resume.cfg i arbetskatalogen som flaggans hjälptext antyder. Och nej, den hoppar inte över redan klara sidor: filen sparar bara seed-URL:er som är i flight, så en återupptagen single-seed crawl hämtade om alla 11 baseline-paths inklusive de 10 som redan var klara. Du får samma slutliga endpoint-mängd, bara inte den sparade tiden.
Varför begärde -kf all min sitemap.xml men crawlande inte URL:erna inuti den?
Mot ett IP-target pekar resultatet på en scope-valideringsgräns snarare än ett flaggfel. I v1.6.1:s kod bygger Katana:s sitemap-parser varje <loc>-request utan att föra vidare root-hostname, och DNS-scope-kontrollen för IP-litterala hosts kan då avvisa URL:en; jag instrumenterade inte körningen för att bekräfta just den mekanismen. Det låg kvar på 0 recall genom varje flagg-, djup- och seed-variation jag testade. Ett eget -fs host-regex går en annan valideringsgren och är den fix som källkoden antyder — men jag kunde inte bekräfta det mot -kf på min maskin, så betrakta det som otestat. Att själv extrahera <loc>-URL:erna och seeda Katana med dem är metoden jag skulle lita på i dag.
Vad bör jag spara när jag rapporterar ett Katana-täckningstest?
Spara exakt Katana-version och kommando, inklusive det byte-för-byte-exakta -fs-uttrycket; definiera endpoint-klasser innan körningen; behåll server-side hitloggar utöver stdout; och skilj uppmätt beteende från hypoteser baserade på källkod. För headless-körningar bör du också spara browser-builden—det här testet gjorde inte det, vilket begränsar reproducerbarheten.
Ska jag använda -jc, -headless, eller båda?
Välj utifrån vilka endpoint-klasser du behöver. I det här fixturet hittade standard -jc literals som låg i en JavaScript-fil, medan headless hittade endpointen som injicerades i runtime-DOM:en. Inget av lägena täckte båda klasserna ensamt, så en tvåpass-körning följd av deduplicering var det försvarbara valet för blandade targets.
Kommer en enda misslyckad URL att stoppa crawlen? Det gjorde den inte i den här kontrollerade körningen. Katana fortsatte efter både ett 500-svar och en död länk och returnerade ändå de andra nåbara paths. Det är inte ett substitut för produktionsmässig felredovisning: behåll loggar för misslyckade requests och definiera en acceptabel felnivå så att en delvis lyckad crawl inte misstas för full täckning.




