
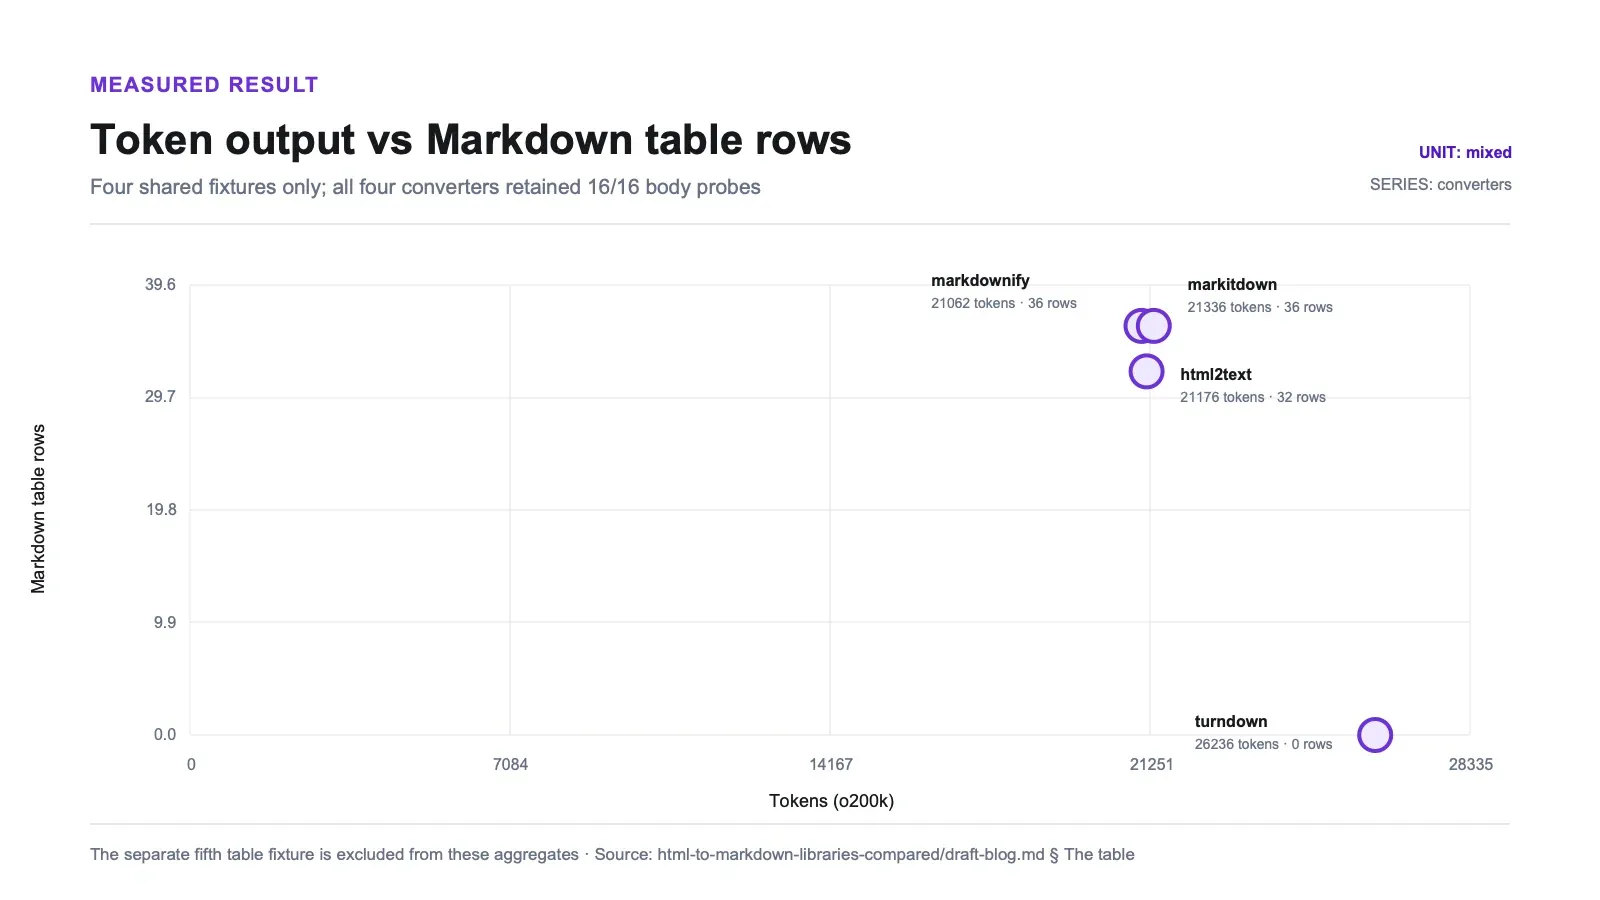
turndown var det av de fyra testade biblioteken som hade flest GitHub-stjärnor vid mättillfället, med 11 386 stjärnor. På de fyra gemensamma HTML-fiksturerna skapade det inga Markdown-tabeller alls med standardinställningarna och använde 24,6 % fler tokens än markdownify för samma indata.
Alla fyra lyckades återställa varje innehållsprobe. Skillnaderna handlar helt om vad som händer med strukturen, och vad den strukturen kostar längre ner i kedjan.
Vad som mättes, och på vems fiksturer
Den här forskningsbasen hade redan ett paket för markitdown med fem HTML-fiksturer och förregistrerade probe-strängar — exakta strängar som kontrollerades för överlevnad, plus boilerplate-strängar för att upptäcka sidans chrome. Den sammanlagda jämförelsen använder de fyra fiksturer som delas av alla fyra konverterare: en bokhandel-katalog, en quotes-sajt, en hockeystatistiktabell och Wikipedia-artikeln om web scraping. En femte fikstur, Nothing but tables, används bara som tabelltung diagnos och räknas inte in i de 24,6 %.
De fyra: turndown 7.2.4 (Node), markdownify 1.2.3, html2text 2025.4.15 och markitdown, där de publicerade raderna används som de är. Sidor: en bokhandel-katalog, en quotes-sajt, en hockeystatistiktabell och Wikipedia-artikeln om web scraping.
Varje metriknamn nedan matchar markitdowns egen artefakt fält för fält, så raderna kan stå bredvid varandra utan att någon behöver förena två definitioner av samma ord.
Tabellen
| Konverterare | Body-probes | Utdatakaraktärer | Tokens (o200k) | Byte/token | Markdown-tabellrader | Länkar |
|---|---|---|---|---|---|---|
| turndown | 16/16 | 95,188 | 26,236 | 3.63 | 0 | 611 |
| markdownify | 16/16 | 76,868 | 21,062 | 3.65 | 36 | 599 |
| html2text | 16/16 | 76,452 | 21,176 | 3.61 | 32 | 545 |
| markitdown | 16/16 | 76,995 | 21,336 | 3.61 | 36 | 598 |
Fyra fiksturer — de som markitdown också körde. Fulla siffror per fikstur finns i fiveway-scores.json. Tokens räknades med o200k_base; markitdowns tabellrader räknades om från dess egen lagrade Markdown med samma räknare som användes för de andra.
Innehållsöverlevnaden är oavgjord. Alla sexton body-probes över de fyra fiksturerna överlevde i varje konverterare. Om din enda fråga är "kommer texten igenom", svarar alla fyra ja.
Strukturen är inte oavgjord. På de fyra gemensamma fiksturerna ger markdownify och markitdown båda 36 Markdown-tabellrader; html2text ger 32; turndown ger inga alls. I den separata diagnosen med bara tabeller gav markdownify 62 rader och html2text 59; de raderna ingår inte i sammanställningen ovan.
Tokennaden är 24,6 % högre för turndown, och orsaken är inte tabellerna. Jag trodde det först, men siffrorna per fikstur säger något annat — se nedan.
Vad turndown gör med en tabell
Här är hockeystatistik-fiksturen, samma rader, tre sätt.
turndown:
Team Name

Year

Wins

Losses

Boston Bruins

1990

44

24
markdownify:
| Team Name | Year | Wins | Losses | ... |
| --- | --- | --- | --- | --- |
| Boston Bruins | 1990 | 44 | 24 | ... |
html2text:
Team Name  |  Year  |  Wins  |  Losses  | ...
---|---|---|---|---
Boston Bruins  |  1990  |  44  |  24  | ...
Varje värde överlever turndowns konvertering, vilket är varför det får 16/16 på proberna. Det som däremot inte överlever är vilken kolumn varje värde hör till. Läs turndowns utdata så är 44 bara ett tal på en rad; du kan inte avgöra att det är Boston Bruins vinstantal utan att räkna positioner och hoppas att ingen cell var tom. I den här fiksturen är vissa celler faktiskt tomma, så positionsräkning hjälper inte heller.
För en modell som läser resultatet är det skillnaden mellan en tabell den kan svara på frågor om och en lista med tal den måste gissa om.
Det här är inte så mycket ett fel som en dokumenterad gräns — turndowns kärna hanterar inte tabeller, och turndown-plugin-gfm finns för att lägga till det. Men standardinstallationen inkluderar inte det, och 11 386 stjärnor tyder på att många använder standardläget.
Var token-gapet egentligen kommer ifrån
Jag skrev stycket ovan i tron att token-gapet på 24,6 % berodde på att plattade tabeller dök upp som extra tecken. Sedan tittade jag per fikstur, och så var det inte.
| Fikstur | turndown tokens ÷ markdownify tokens |
|---|---|
| Quotes-sajt (inga tabeller) | 0.99× |
| Bokhandel-katalog | 1.06× |
| Hockeystatistik (en stor tabell) | 1.37× |
| Wikipedia (mest löptext, 9 tabellrader) | 1.29× |
| Nothing but tables | 0.78× |
På fiksturen som är inget annat än tabeller är turndown 22 % billigare — eftersom pipe-strukturen också kostar tokens, och turndown skriver inte ut någon sådan. Att platta till en tabell är alltså i sig inte ett tokenstraff.
Wikipedia-fiksturen står för 74 % av totalen, och den har nio tabellrader. Dess gap på 15 378 tecken kan inte bero på tabeller. Det här är orsaken:
(function(){var className="client-js vector-feature-language-in-header-enabled…
.mw-parser-output cite.citation{font-style:inherit;word-wrap:break-word}…
(RLQ=window.RLQ||[]).push(function(){mw.config.set({"wgHostname":"mw-web…
turndown tar inte bort innehåll i <script> och <style>. markdownify och html2text gör det. Räknat via markörer som bara förekommer i dessa element: turndowns utdata innehåller 10 script-markörer och 84 style-markörer över fiksturerna; de andra två innehåller noll av varje. På Wikipedia-sidan står åtta rader MediaWikis inline-JavaScript-konfiguration och CSS för 14 644 tecken — 95 % av hela gapet (script-style-stripping.json).
Det är den insikt jag faktiskt skulle agera på. En plattad tabell är ett strukturproblem du kan se. En JavaScript-konfigurationsklump i din Markdown är ren kostnad utan information alls, och på en verklig sida överglänser den allt annat i den här jämförelsen.
html2text skriver tabeller du kanske inte känner igen
html2text fick 32 rader där markdownify och markitdown fick 36, och den första versionen av min räknare gav det 1.
Det var min räkneregel, inte bibliotekets fel. html2text skriver Team Name | Year | Wins utan inledande och avslutande pipes — en vanlig Markdown-tabellform, men osynlig för ett regex som kräver ^\|.*\|$. Jag hade skrivit det regexet, kört det och varit redo att rapportera att html2text inte klarar tabeller.
Det gör det. Den korrigerade räknaren använder en heuristik: en följd av rader med pipes där en avdelningsrad finns inuti. Med den regeln går html2text från 1 till 32. Det här är inte en fullständig Markdown-parser, så radtotalerna ska läsas som mätningar under en dokumenterad räknare, inte som universella renderingsresultat.
Bra att känna till om du efterbearbetar Markdown med egna regexar: två av de fyra biblioteken skriver ut yttre pipes och ett gör det inte.
Licensen ingen pratar om
| Konverterare | Licens | Installation | Kall import | Stjärnor | Senaste release |
|---|---|---|---|---|---|
| turndown | MIT | 3 npm-paket, 8.8 MiB | 0.056 s | 11,386 | 2026-04-03 |
| markdownify | MIT | 5 paket, 1.8 MiB | 0.046 s | 2,235 | 2026-06-30 |
| html2text | GPL-3.0-or-later | 1 paket, 0.2 MiB | 0.077 s | 2,168 | 2025-04-15 |
| markitdown | Se dess paketmetadata | Ej mätt i denna installationskörning | Ej mätt | — | — |
install-and-import.json. Varje bibliotek installerades i sin egen tomma miljö. Licenser bekräftades på tre sätt: registry-metadata, GitHub-repot och det installerade paketets egen METADATA-fil, som säger License-Expression: GPL-3.0-or-later.
Det lättaste biblioteket i denna installationsjämförelse — ett paket, 0.2 MiB — är GPL-3.0-or-later. Om det spelar roll för ett projekt beror på hur mjukvaran kombineras och distribueras. Se det som en urvalspunkt för den som äger licensfrågan; den här artikeln är inte juridisk rådgivning. markitdown visas som omätt här eftersom dess installation och licens inte fångades av just den här artefakten.
Den avvägningen är lätt att missa eftersom licensen är den enda egenskapen som inte syns i ett benchmark.
Alla tre är dramatiskt lättare än artikel-extraktionsbiblioteken i samma kategori — de ligger på 21 till 70 MiB. En konverterare är något mycket mindre än en extractor, och det är värt att skilja dem åt i din beroendebudget.
Två störfaktorer jag var tvungen att rätta innan den här tabellen blev sann
Siffrorna ovan är version tre. De första två var fel på sätt som är värda att namnge, eftersom båda är lätta att återskapa.
Fem fiksturer mot fyra. markitdown körde fyra av dessa fem filer; de andra tre körde alla fem. När jag summerade varje verktyg på sitt eget urval gav markdownify 98 tabellrader mot markitdowns 36 och det såg ut som en förmågebrist. Över samma fyra är det 36 mot 36 — helt oavgjort. Den femte fiksturen är den tabelltunga, så störfaktorn slog åt värsta möjliga håll och blåste upp de nya mot den etablerade med nästan tre gånger.
Två räknare, en kolumn. markitdowns publicerade md_table_rows kom från dess egen kod, som jag inte hade läst. Att jämföra det talet med mitt hade kunnat betyda att jag jämförde två räknare i stället för två konverterare. Dess Markdown-utdata lagras på disk, så lösningen var att köra en räknare över alla fyra — och när jag gjorde det landade markitdowns omräkning exakt på det publicerade värdet per fikstur (0, 0, 27, 9). Definitionerna stämde; jag kunde bara inte veta det utan att kontrollera.
Inget av felen hade synts i utdata. Båda hade producerat en självsäker, felaktig tabell.
Vem ska använda vad
Matar du en modell, eller lagrar strukturerat innehåll från sidor som dessa? Börja med markdownify. Det matchar markitdown på antalet utmatade tabellrader enligt den här räknaren, ligger i det lägsta token-klustret, är MIT-licensierat och installerar på 1,8 MiB. Testa det på dina egna sidtyper innan du standardiserar.
Beroendebudgeten mäts i kilobyte, och du distribuerar inte? html2text. Ett paket, 0,2 MiB, tabellerna bevaras. Kontrollera GPL-frågan först, och notera att senaste releasen var april 2025.
Redan i en Node-stack? turndown, med turndown-plugin-gfm installerat bredvid — och ta bort <script> och <style> från HTML innan du lämnar över den, för turndown gör det inte. De två utelämnandena kostar en fjärdedel fler tokens och din tabellstruktur, och inget av det syns om du inte tittar på utdata.
Konverterar du redan andra dokumentformat? markitdown hanterar PDF, Office och mer, och dess HTML-utdata är konkurrenskraftig mot de dedikerade konverterarna. En beroende i stället för två är ändå värt något.
Var en hanterad API passar in
Alla fyra här tar HTML som du redan har. Ingen av dem hämtar en sida, renderar JavaScript eller hanterar ett anti-bot-lager — och för många verkliga mål är det den svårare halvan.
Vår egen utvecklarstack på Thunderbit täcker den delen. POST /distill tar en URL och returnerar ren Markdown som är redo för LLM-användning, med rendering och hämtning omhändertagna; POST /extract returnerar AI-strukturerad JSON som matchar det JSON Schema du skickar med, vilket är en annan typ av utdata helt och hållet — rader i stället för en Markdown-tabell som du sedan måste tolka. Båda kan nås via en MCP-server och en CLI (npx @thunderbit/thunderbit-cli). Priser finns på Thunderbits prissida.
Den ärliga jämförelsen: om du redan har HTML och vill ha Markdown är markdownify gratis och gör jobbet bra, och den här tabellen visar vilka av dess rivaler som också klarar det. Om du hämtar sidorna, eller vill ha strukturerade rader i stället för löptext, är det ett annat köp.
För det bredare landskapet täcker vår sammanställning av web scraping-API:er hostade alternativ och översikten över open source-scrapers de självhostade. Att konvertera HTML till Markdown i Python är den praktiska genomgången, och vad llms.txt försöker standardisera beskriver vart hela kategorin är på väg.
Testa Thunderbit för webbdatastraktion
Slutsats
För den här arbetsbelastningen med fyra fiksturer är markdownify det starkaste standardvalet: samma antal utmatade tabellrader som markitdown under den gemensamma räknaren, ett tokenantal inom 1,3 % av de andra effektiva konverterarna, MIT-licens och en installation på 1,8 MiB.
Glappet mellan popularitet och uppmätt beteende är själva poängen. turndown är ett utmärkt bibliotek som många har installerat utan pluginet som gör att det hanterar tabeller, och kostnaden syns som en fjärdedel fler tokens och en tabellstruktur som inte längre finns. Inget av detta framgår förrän du räknar.
Om du bara tar med dig en sak: kontrollera vad din konverterare gör med en tabell innan du litar på dess utdata i en modell. Tre av de fyra gör något vettigt. Den mest populära gör det inte, om du inte bad den om det.
Testa Thunderbit för webbdatastraktion Get Started Free
Vanliga frågor
Stöder turndown verkligen inte tabeller?
Kärnan gör det inte. Tabeller kommer från turndown-plugin-gfm, ett separat paket, och en vanlig npm install turndown innehåller det inte. Utan pluginet överlever varje cell som ett eget stycke — alla värden finns där, men relationerna mellan rader och kolumner gör det inte. Över fyra fiksturer gav det noll Markdown-tabellrader och 24,6 % fler tokens än markdownify för samma innehåll.
Varför såg html2text först ut att sakna tabeller?
För att min räknare krävde inledande och avslutande pipes, och html2text skriver inte ut dem. Team Name | Year | Wins är giltig Markdown och renderas korrekt; det är bara en annan stil än | Team Name | Year |. Den korrigerade räknaren letar efter en följd av rader med pipes och en separatorrad, ungefär som en parser gör, och html2text går från 1 rad till 32. Om du efterbehandlar Markdown med egna regexar är det här skillnaden som kommer att bita dig.
Är GPL för html2text ett verkligt problem?
Det beror på hur du kombinerar och distribuerar programvaran. GPL-3.0-or-later kan skapa skyldigheter som MIT inte gör, så involvera den som äger licensfrågan innan du väljer det för en distribuerad produkt. Detta är en compliance-kontroll, inte juridisk rådgivning; licensidentiteten bekräftades i registry-metadata, repot och det installerade paketets METADATA.
Är dessa tokenantal meningsfulla för andra sidor?
Gapet på 24,6 % beror mest på att turndown behåller innehåll i <script> och <style>, så det skalar med hur mycket sådant en sida innehåller — mycket på en modern CMS-sida, nästan noll på en statisk sida. Tabeller drar åt andra hållet: på fiksturen som bara bestod av tabeller var turndown 22 % billigare, eftersom det inte skriver ut någon pipe-struktur. Byte per token låg mellan 3.61 och 3.65 för alla fyra, så utdata-tätheten är densamma överallt och skillnaden är mängd. Mät din egen korpus om siffran spelar roll för budgeten.
Vad testades inte här?
Verklig variation — fyra fiksturer är fyra fiksturer. Nästlade listor, definitionslistor, fotnoter och matematik. Felaktig HTML, där konverterare historiskt skiljer sig mest. Att göra Markdown om till HTML igen. docling, som har samma fiksturer på disk men vars publicerade körning inte rapporterar dessa fält, så den är frånvarande snarare än uppskattad. Och konfiguration: html2text kördes med body_width=0 eftersom standardvärdet 78 radbryter varje rad, vilket hade ändrat varje tecken- och tokental i den här tabellen.




