
cURL finns på uppskattningsvis 20 miljarder installationer världen över — det är inbyggt som standard i macOS, de flesta Linux-distributioner och Windows 10/11. Ändå får du tio lite olika svar om du frågar tio utvecklare hur man skickar en cURL-förfrågan genom en proxy på rätt sätt, och hälften av svaren slutar fungera så fort autentisering eller SOCKS kommer in i bilden.
Det är just den luckan jag vill täcka här. De flesta guider visar ett kommando, säger att det fungerar och går vidare. De visar inte hur du bekräftar att proxyn faktiskt gör något (spoiler: ibland gör den inte det), och de går definitivt inte igenom felkoderna som dyker upp så fort din miljö avviker ens lite från det ideala scenariot. Den här guiden täcker hela spannet — HTTP/HTTPS-proxyer, SOCKS4/SOCKS5/socks5h, miljövariabler (och deras väldigt specifika fallgropar), en ordentlig felsökningstabell och vad du gör när cURL och en proxy helt enkelt inte räcker längre.
Vad är cURL och varför använda det med en proxy?
cURL är ett kommandoradsverktyg för att överföra data till och från en URL. Så enkelt är det — inget grafiskt gränssnitt, inga extra finesser, bara ett program som pratar HTTP, HTTPS, FTP och några andra protokoll. Det enklaste möjliga anropet är:
curl https://example.com
Det hämtar sidan och skriver ut rå HTML i terminalen. Användbart i sig, men den verkliga anledningen till att utvecklare och tekniska affärsanvändare väljer cURL är för att testa API:er, skrapa data, kontrollera geo-begränsat innehåll och köra förfrågningar i CI/CD-pipelines.
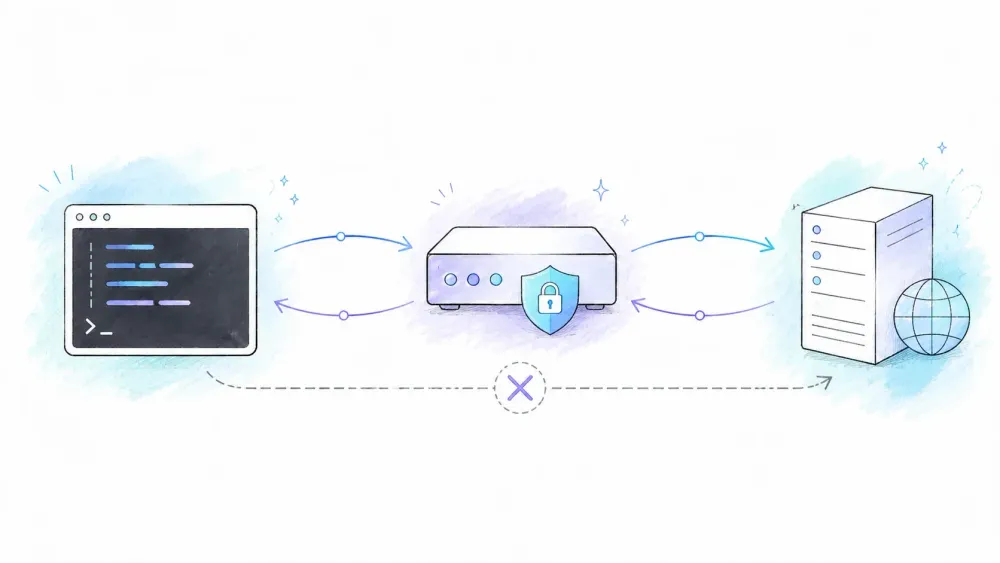
En proxy ligger mellan din dator och målservern och skickar vidare din begäran för din räkning. Målservern ser proxyserverns IP-adress, inte din. Det spelar roll av flera legitima skäl: att testa hur din webbplats ser ut från ett annat land, att arbeta runt hastighetsbegränsningar under QA eller att skicka trafik genom företagets obligatoriska gateway. cURL stöder hela spannet av proxyprotokoll — HTTP, HTTPS, SOCKS4 och SOCKS5 — och de flaggor du kommer att se om och om igen i den här guiden är -x / --proxy (själva proxyadressen), -v (utförlig utdata, din bästa vän vid felsökning) och -k (hoppa över SSL-verifiering, vilket du i princip aldrig ska använda utanför testning).
En snabb notis innan vi går vidare: den här guiden handlar om nätverksmekaniken när du använder en proxy med cURL. Det är inte ett frikort att ignorera en webbplatsts användarvillkor eller din organisations säkerhetspolicy. En proxy ändrar din nätverksväg — den ändrar inte vad som är lagligt eller tillåtet.
Innan du börjar
Svårighetsgrad: Nybörjare till medelnivå Tidsåtgång: Cirka 15 minuter för att gå igenom kärnexemplen Det här behöver du:
- cURL installerat (kontrollera med
curl --version— om du kör macOS, Linux eller Windows 10/11 finns det nästan säkert redan där) - Proxyuppgifter från din leverantör: värd, port, protokoll (HTTP/HTTPS/SOCKS) och användarnamn/lösenord om det krävs
- En terminal (Terminal i macOS, valfritt skal i Linux, PowerShell eller CMD i Windows)
Om cURL av någon anledning inte är installerat är det ett enradskommando: brew install curl på macOS via Homebrew, sudo apt install curl på Debian/Ubuntu eller sudo yum install curl på RHEL/CentOS. På Windows har det följt med operativsystemet sedan Windows 10 build 17063.
I hela guiden använder jag platshållarvärden — proxy.example:8080 för proxyadressen och user:pwd för autentisering. Byt ut dem mot dina riktiga proxyuppgifter och klistra aldrig in verkliga inloggningsuppgifter i shellhistorik, skärmdumpar eller Slack-meddelanden. Jag har sett fler läckta proxy-lösenord i Slack-kanaler än jag gärna erkänner.
Så använder du cURL med en HTTP- eller HTTPS-proxy
Det här är den vanligaste konfigurationen, och den du använder i majoriteten av proxyscenarier.
Använd flaggan -x / --proxy
Grundsyntaxen ser ut så här:
curl -x "http://user:pwd@proxy.example:8080" "https://httpbin.org/ip"
-x och --proxy gör exakt samma sak — välj den du tycker är lättast att minnas. Eftersom HTTP är cURL:s standardprotokoll för proxy kan du tekniskt sett utelämna http://-prefixet och bara skriva proxy.example:8080. Jag skulle ändå skriva ut det explicit, eftersom du om sex månader kommer att tacka dig själv för tydligheten.
Omslut hela URL:en med dubbla citattecken. Om lösenordet innehåller @, # eller & kan en oquotad sträng förstöras av skalet innan cURL ens får se den.
Anslut via en HTTPS-proxy
Vissa leverantörer kör själva anslutningen till proxyn över TLS, inte bara anslutningen från proxyn till ditt mål. Det är något annat än att skrapa en HTTPS-webbplats — proxyprotokollet och målets protokoll är oberoende variabler. Så här anger du det:
curl -x "https://user:pwd@proxy.example:8080" "https://httpbin.org/ip"
Om du får ett certifikatfel här, motstå frestelsen att bara slänga på -k och gå vidare. Den flaggan stänger av SSL-certifikatverifiering helt, vilket är okej för ett femminuters lokalt test men en riktigt dålig idé för allt som rör produktion eller riktiga användardata. Om du hanterar en företagsproxy som avlyssnar TLS (en MITM-lösning, vanlig i företagsmiljöer) är den rätta fixen att importera proxyserverns CA-certifikat, inte att stänga av verifieringen.
Autentisera med --proxy-user
Du kan också lägga ut autentiseringen i en egen flagga istället för att trycka in den i URL:en:
curl -x "http://proxy.example:8080" --proxy-user "user:pwd" "https://httpbin.org/ip"
Observera att versalt -U inte är samma sak som autentisering mot målsidan (-u / --user, gemen) — att blanda ihop dem är ett enkelt sätt att råka skicka ditt proxy-lösenord till fel ställe. För företagsmiljöer som använder NTLM eller Digest i stället för Basic, lägg till --proxy-ntlm eller --proxy-digest tillsammans med --proxy-user.
Så använder du cURL med en SOCKS-proxy: SOCKS4 vs. SOCKS5 vs. socks5h
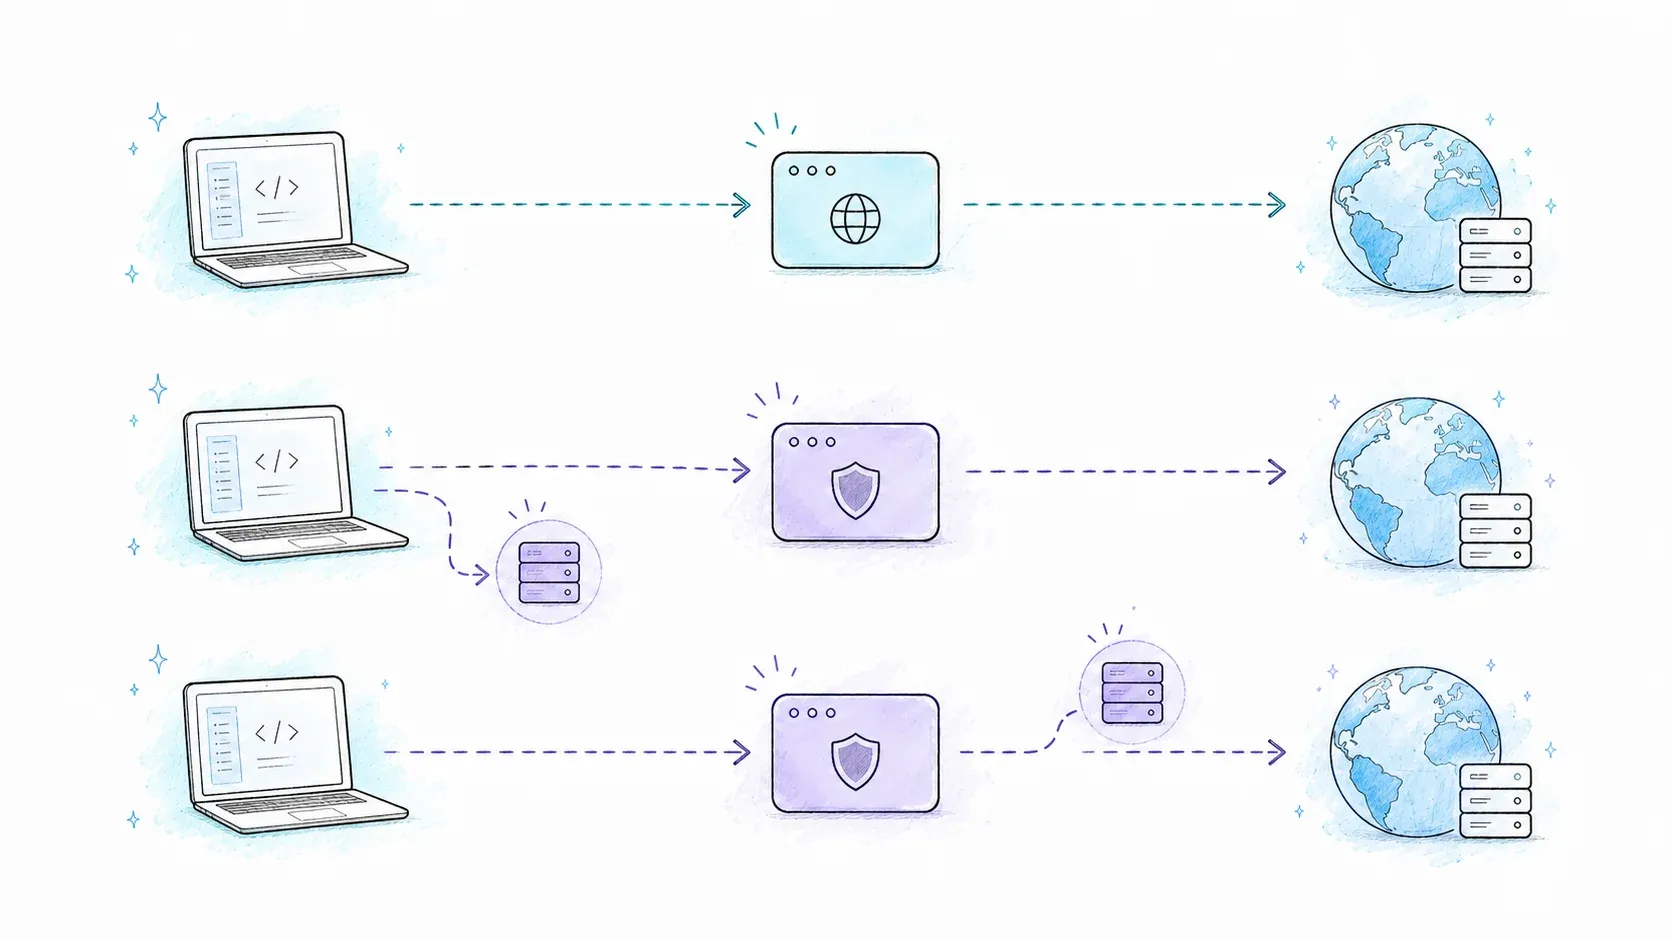
SOCKS-proxyer arbetar på en lägre nivå än HTTP-proxyer — de bryr sig inte om vilket protokoll du tunnlar, vilket gör dem användbara för icke-HTTP-trafik, Tor-cirklar och annat som är extra integritetskänsligt. De flesta konkurrerande guider ger detta ett enda kommando och går vidare. Det är ett misstag, eftersom skillnaderna mellan SOCKS4, SOCKS5 och socks5h:// faktiskt spelar roll.
| Funktion | SOCKS4 | SOCKS5 | socks5h:// |
|---|---|---|---|
| TCP-stöd | Ja | Ja | Ja |
| UDP-stöd | Nej | Ja | Ja |
| Autentisering | Nej | Ja | Ja |
| Fjärr-DNS-uppslagning | Nej | Nej (lokal DNS) | Ja (proxyn slår upp) |
| Kompatibel med Tor | Nej | Riskabelt (DNS-läckage) | Ja |
Raden om DNS-uppslagning är den som folk faktiskt snubblar på. Med socks5:// löser din maskin själv upp värdnamnet innan anslutningen lämnas över till proxyn — vilket betyder att din lokala DNS-resolver (och därmed även din internetleverantör) ser exakt vilken domän du försöker nå, även om själva HTTP-trafiken går genom proxyn. socks5h:// löser detta genom att låta proxyn göra namnuppslagningen i stället, så att inget om målet läcker lokalt. Det är hela skälet till att Tor-dokumentationen insisterar på socks5h:// — att använda vanligt socks5:// undergräver en stor del av den anonymitet som Tor ska ge.
Så här ser varje variant ut i cURL:
curl --socks4 "proxy.example:1080" "http://example.com"
curl -x "socks5://user:pwd@proxy.example:1080" "http://example.com"
curl -x "socks5h://user:pwd@proxy.example:1080" "http://example.com"
Om du inte har en särskild anledning att låta bli, välj socks5h:// som standard. Det kostar inget extra och stänger en läcka som du annars lätt skulle missa.
Sätt proxy med miljövariabler (och undvik fällorna)
Att sätta -x på varje enskilt kommando blir snabbt tröttsamt. Miljövariabler låter dig ställa in proxyn en gång per shell-session och låta alla efterföljande cURL-anrop ärva den automatiskt — cURL:s manual dokumenterar http_proxy, HTTPS_PROXY, ALL_PROXY och NO_PROXY som de stödda variablerna.
Grunderna
export http_proxy="http://user:pwd@proxy.example:8080"
export HTTPS_PROXY="http://user:pwd@proxy.example:8080"
export ALL_PROXY="socks5h://proxy.example:1080"
Här är delen som förvirrar folk hela tiden: variabelnamnet syftar på mål-URL:ens protokoll, inte proxyserverns protokoll. Så http_proxy styr förfrågningar till http://-URL:er och HTTPS_PROXY styr förfrågningar till https://-URL:er — du kan peka båda på exakt samma HTTP-proxyserver, och det är helt normalt.
Gå förbi med NO_PROXY
export NO_PROXY="localhost,127.0.0.1,.internal.example"
Kommaavgränsat, och inledande punkt i .internal.example fungerar som ett jokertecken för alla underdomäner. NO_PROXY går före allt annat — även om -x anges explicit på kommandoraden kommer en träff i NO_PROXY att kringgå proxyn för den begäran.
Fallgroparna som faktiskt ställer till det
- Glömmer
export. Om du bara skriverhttp_proxy=http://...utanexportlever variabeln bara i det aktuella skalet och är helt osynlig för cURL som barnprocess. Enligt min erfarenhet är detta den absolut vanligaste orsaken bakom supportärenden av typen "proxyn fungerar inte". - Skiftlägeskänslighet. cURL kontrollerar specifikt först den gemena varianten
http_proxyoch prioriterar den om båda finns. Vissa andra verktyg läser bara versaler. Om du felsöker varför en variabel "inte plockas upp", kontrollera om det finns en dubblett med fel skiftläge. - PowerShells aliasfälla. I PowerShell 5.1 kör kommandot
curlinte cURL alls — det anroparInvoke-WebRequest, ett helt annat verktyg med andra flaggor. Om din-x-flagga ger konstiga fel i Windows, skrivcurl.exeexplicit för att vara säker på att du faktiskt kör cURL. - Skillnader i Windows-syntax. CMD använder
set http_proxy=...; PowerShell använder$env:http_proxy = "...". Att blanda ihop dessa mellan terminalsessioner är ett enkelt sätt att förlora en eftermiddag. - Gamla variabler.
unset http_proxyochunset https_proxyrensar en död proxykonfiguration som i tysthet routar vidare (och misslyckas med) varje förfrågan.
För snabb växling sparar några alias i din .bashrc verklig tid:
alias proxyon='export http_proxy="http://proxy.example:8080"; export https_proxy="http://proxy.example:8080"'
alias proxyoff='unset http_proxy; unset https_proxy'
Låt cURL alltid använda en proxy (konfigurationsfil)
Om du står bakom en företagsproxy 95 % av tiden kan en .curlrc-fil (på Unix-liknande system i hemmappen) eller _curlrc (på Windows i app-data-mappen) sätta ett permanent standardvärde utan att röra miljövariabler alls:
proxy="http://proxy.example:8080"
För en enstaka begäran där du vill hoppa över den, skriver --noproxy "*" över konfigurationen för just den körningen. Precedence är i allmänhet kommandoradsflagga > miljövariabel > konfigurationsfil, så -x på kommandoraden vinner alltid vid konflikt.
En viktig varning: lägg inte in ett lösenord i klartext i .curlrc om filen kan synkas, säkerhetskopieras eller råka checkas in i ett repo. För CI-pipelines ska du i stället använda plattformens hemlighetshantering och injicera uppgifterna som maskerade miljövariabler.
Så verifierar du att proxyn faktiskt fungerar
Det här är avsnittet som nästan alla andra guider hoppar över, och det är också det som sparar mest felsökningstid. Att sätta upp en proxy och anta att trafiken går igenom den är ett säkert sätt att lägga timmar på att felsöka en scraper som aldrig använde proxyn från början.
Metod 1: Jämför din utgående IP
Kör samma IP-svarsförfrågan två gånger — en direkt, en via proxyn — och jämför:
curl https://httpbin.org/ip
curl -x "http://user:pwd@proxy.example:8080" https://httpbin.org/ip
Om båda kommandona returnerar samma IP-adress gör proxyn inget alls. Kontrollera din flagsyntax, dina miljövariabler eller om NO_PROXY råkar matcha målet.
Metod 2: Läs den utförliga utdata
Lägg till -v på valfri proxyförfrågan så skriver cURL ut hela handskakningen:
curl -v -x "http://user:pwd@proxy.example:8080" https://httpbin.org/ip
Leta efter en rad som * Connected to proxy.example (xx.xx.xx.xx) port 8080, följt av > CONNECT httpbin.org:443 HTTP/1.1 och till slut < HTTP/1.1 200 Connection established. Den sekvensen — anslutning till proxyn, sedan CONNECT-tunnel till målet — är HTTP CONNECT-metoden i arbete, och det är exakt vad som ska hända när ett HTTPS-mål routas genom en HTTP-proxy. Om CONNECT-raden aldrig dyker upp används inte proxyflaggan. En varning när du använder detta: kör bara -v medan du aktivt felsöker, och maskera utdata innan du delar den någonstans — verbose-läget kan skriva proxyuppgifter i klartext.
Metod 3: Jämför sida vid sida
För geo-testning är det särskilt smart att spara båda utfallen i filer och jämföra dem:
curl https://httpbin.org/ip > direct.json
curl -x "http://user:pwd@proxy.example:8080" https://httpbin.org/ip > proxied.json
diff direct.json proxied.json
Om svarstexterna (eller rubrikerna, för geo-begränsat innehåll) skiljer sig åt har du en tydlig bekräftelse på att proxyn faktiskt förändrar din nätverksväg — ett snabbt och lågbefintligt sätt att undanröja tvivel innan du går djupare.
Felsök vanliga cURL-proxyfel
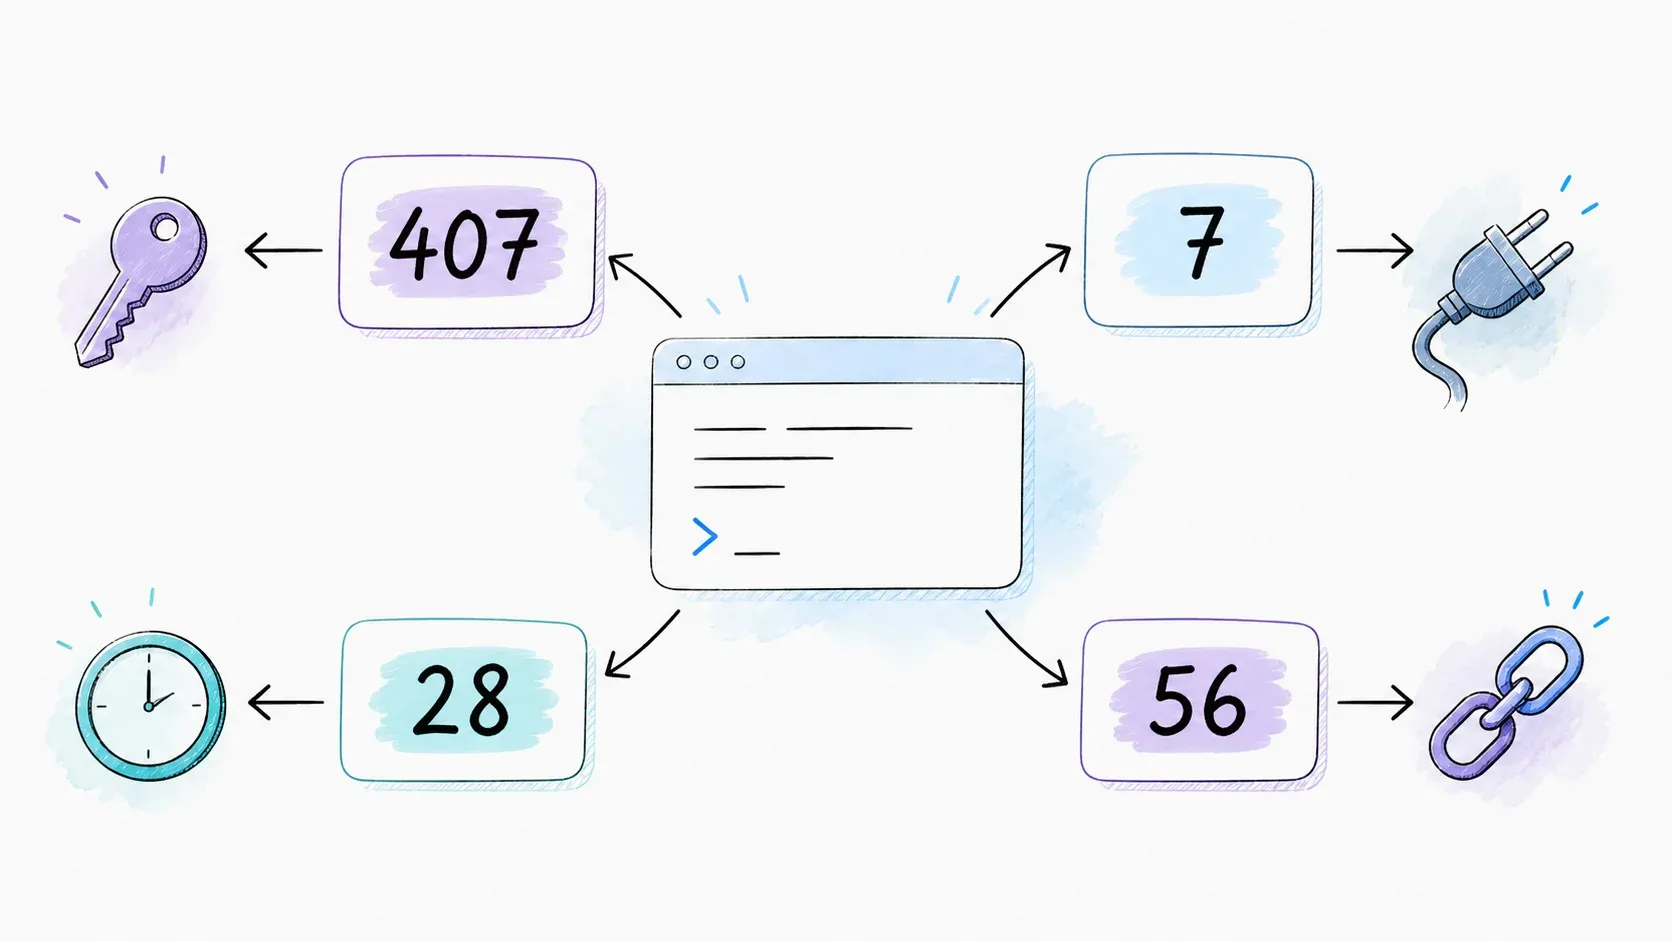
De flesta guider viftar bort detta och nämner -k en gång. Ämnet förtjänar en riktig referenstabell.
| Fel | Trolig orsak | Lösning |
|---|---|---|
curl: (7) Failed to connect | Fel proxyvärd/port, eller så är proxyn nere | Verifiera adressen; testa rå anslutning med telnet host port eller nc -zv host port |
407 Proxy Authentication Required | Saknade eller felaktiga proxyuppgifter | Lägg till --proxy-user user:pass; kontrollera om leverantören kräver NTLM/Digest/Negotiate i stället för Basic |
curl: (56) Recv failure: Connection reset by peer | Proxyn tappade anslutningen mitt i överföringen | Kontrollera proxy-stabilitet med leverantören; om det är en TLS-terminerande proxy, verifiera cert-hanteringen i stället för att tvångsstänga den |
curl: (28) Connection timed out | Brandvägg blockerar, gammal proxy eller fel port | Kör `env |
| Certifikatverifiering misslyckades | Ej betrott eller avlyssnande proxycertifikat | Hämta rätt CA-kedja och använd --proxy-cacert; undvik att stänga av verifieringen annat än för en engångsdiagnos |
Det universella första steget för alla dessa är att lägga till -v. Då ser du exakt var anslutningen bryts — DNS-uppslagning, TCP-anslutning, TLS-handshake eller proxyautentisering — i stället för att gissa utifrån en tresiffrig felkod.
För företagsproxyer täcker --proxy-ntlm och --proxy-negotiate autentiseringsscheman för Windows-domäner. En sak som cURL faktiskt inte hanterar inbyggt är PAC-filer (Proxy Auto-Config-skript som vissa företag använder för att tilldela proxyer dynamiskt). Om ditt företag använder en sådan måste du extrahera den faktiska proxyvärden och porten manuellt — oftast från webbläsarens nätverksinställningar — eftersom cURL saknar inbyggd PAC-tolk.
När cURL + en proxy inte räcker
cURL med proxy hanterar statisk HTML, API-anrop mot REST och enklare datahämtning ungefär så bra som något kan. Där det faller ifrån är moderna webbsidors favoritskydd: JavaScript-renderade single-page-appar, anti-bot-system som Cloudflare eller Akamai och CAPTCHA-väggar. Pekar du cURL mot en React- eller Vue-app bakom något av detta får du tillbaka en tom <div id="root"></div> — tekniskt sett en lyckad begäran, praktiskt sett värdelös data. Det är inte en cURL-bugg. Det är bara inte en webbläsare, och det har den aldrig påstått sig vara.
Om du redan är bekväm med att köra cURL i terminalen och stöter på den väggen är nästa naturliga steg inte att byta till en helt annan verktygskedja — det är att lägga till ett lager som hanterar rendering och struktur åt dig. Det är den lucka som Thunderbits utvecklarverktyg är byggda för att fylla.
| Scenario | cURL + Proxy | Thunderbit API (POST /extract) |
|---|---|---|
| Statisk HTML-sida | Fungerar perfekt | Fungerar, och returnerar dessutom strukturerad data |
| JS-renderad SPA | Ger tom/partiell HTML | renderMode: "full" hanterar JS |
| Anti-bot / CAPTCHA | Blockeras | Inbyggd hantering |
| Strukturerad datautdata | Rå HTML — du parsar själv | JSON enligt din egen schema |
| Batch (100+ URL:er) | Manuell loop + egen rate limiting | POST /batch/extract |
Thunderbits Open API exponerar ett /extract-slutpunkt som returnerar JSON som matchar ditt schema direkt från JS-tunga sidor, och ett /distill-slutpunkt för ren Markdown-konvertering — båda kan anropas från exakt samma terminalsession där du redan har kört cURL-kommandon. Det finns också en MCP-server för AI-assistenter som Claude eller Cursor, samt ett CLI (npx @thunderbit/thunderbit-cli extract <url> --schema fields.json) om du hellre vill hålla dig helt i skript. Inget av detta ersätter cURL för de uppgifter där cURL är bra — det tar bara vid där cURL strukturellt inte kan komma längre. Om du vill ha en bredare bild av var AI-assisterad extrahering passar in jämfört med att skriva egen scraper-logik, täcker vår genomgång av AI-webbskrapning och vår jämförelse av bästa AI-webbskrapare detta mer på djupet, och vår artikel om webbskrapning utan kod är en bra introduktion om du kommer till detta från ett affärs- snarare än utvecklarperspektiv.
Avslutning
Att få cURL och en proxy att prata med varandra korrekt är inte svårt när du väl vet var de verkliga felkällorna finns — och det visar sig att nästan ingen av dem faktiskt är proxyn själv. Att glömma export. Att blanda ihop -u och -U. Att använda socks5:// när du egentligen menade socks5h://. Att köra PowerShells curl-alias i stället för curl.exe. Var och en av dessa ger ett förvirrande, generiskt fel som egentligen inte har något med proxyleverantören att göra.
Den vana som sparar mest tid: verifiera innan du felsöker. Kör IP-svaret, kasta en snabb blick på -v-utdata, och bekräfta att proxyn ens finns i anropsvägen innan du antar att något gått sönder längre ned. Och när ditt mål börjar skicka JavaScript istället för ren HTML, är det inte ett cURL-problem som löses med fler flaggor — det är en signal att använda ett verktyg som är byggt för rendering, som Thunderbits API, som erbjuder en gratisnivå om du själv vill se skillnaden mellan JSON-ut och rå HTML.
Vanliga frågor
Använder cURL en proxy som standard?
Nej. Om du inte har satt miljövariablerna http_proxy / HTTPS_PROXY eller konfigurerat en .curlrc-fil ansluter cURL direkt till målet utan att någon proxy är inblandad.
Hur stoppar jag cURL från att använda en proxy för en enstaka förfrågan?
Lägg till --noproxy "*" i just det kommandot. För att stänga av det för hela shell-sessionen kör du unset http_proxy && unset https_proxy.
Kan jag använda cURL med roterande proxyer?
Ja — om din leverantör erbjuder en roterande gateway (en enda endpoint som tilldelar en ny IP per förfrågan), peka bara -x mot den gateway-adressen som vilken annan proxy som helst. För mer komplex rotationslogik mot JS-renderade mål hanterar ett API-lager som Thunderbits rotation och anti-bot-sida internt, så att du slipper skriva retry-logik för hand.
Varför läcker socks5:// mina DNS-förfrågningar men inte socks5h://?
Med socks5:// slår din lokala maskin upp mål-värdnamnet innan anslutningsbegäran skickas till proxyn — vilket innebär att din ISP:s DNS-resolver ser domänen du besöker. socks5h:// flyttar namnuppslagningen till själva proxyn, så inget om målet syns lokalt.
Är det lagligt att använda cURL med en proxy? Att använda en proxy är i sig lagligt i de flesta jurisdiktioner. Det som spelar roll är vad du gör med den — respektera alltid webbplatsens användarvillkor, robots.txt där det är relevant och tillämplig dataskyddslagstiftning. Den här guiden handlar bara om de tekniska mekanismerna, inte om ett juridiskt godkännande för något särskilt användningsfall.
Läs mer



