
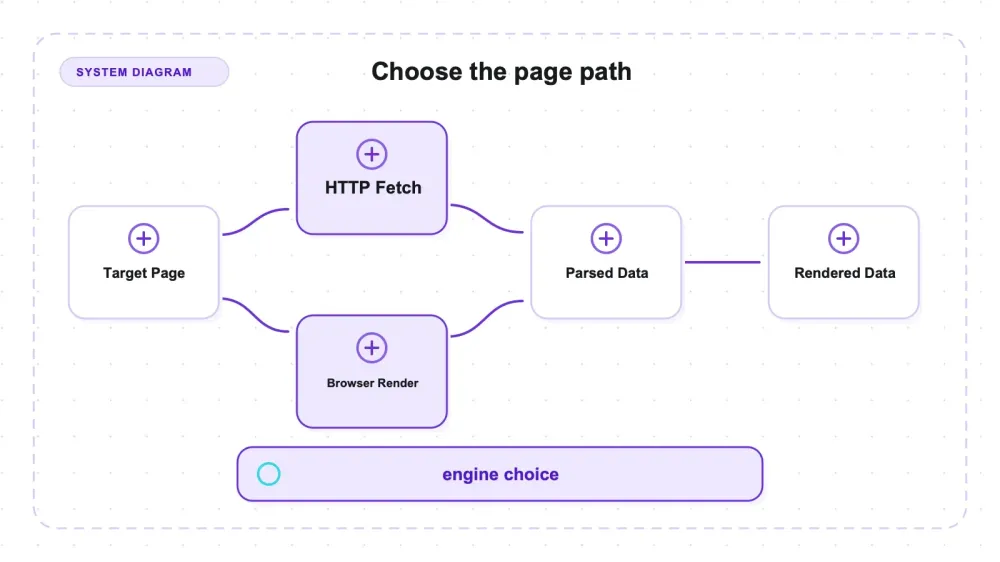
Det som gör Crawlee användbart är att dess crawl-orchestration fungerar både för HTTP-baserad parsing och för körning i webbläsare. Samma URL kan därför ge olika resultat beroende på vald crawler och vilket tillstånd sidan befinner sig i när den anses redo.
På den publika sidan Quotes to Scrape JS hittade CheerioCrawler 0 målcitat, medan PlaywrightCrawler hittade 10 efter att ha väntat på .quote. Själva crawl-flödet är likt, men det här var inte ett enkelt byte av klass på en rad: Cheerio-hanteraren använde $, medan Playwright-hanteraren använde page, en uttrycklig väntan och extrahering direkt i webbläsaren.
Vad Crawlee faktiskt är
Crawlee (projektet apify/crawlee, version 3.17.0) är ett bibliotek för web scraping och webbläsarautomation i Node.js och TypeScript. Det stödjer HTTP-crawling med Cheerio eller JSDOM och browser-crawling med Playwright eller Puppeteer. Projektet använder Apache-2.0; se över krav kring copyright-notis och attribuering innan du distribuerar vidare.
Den viktiga mentala modellen är att skilja på ”hämta sidan” och ”läsa sidan”. Den ena vägen laddar ned rå HTML och kör inte JavaScript. Den andra startar Chromium och kan köra sidans skript, men behöver ändå rätt readiness condition och kan missa innehåll som kräver interaktion, laddas lazy, ligger i shadow DOM, beror på ett misslyckat API-anrop eller spärras av bot-skydd. Crawlee exponerar motsvarande livscykelbegrepp för båda vägarna, inte utbytbara DOM-primitiver.
Det är den delen som är värd att förstå innan du skriver en enda selector, eftersom valet mellan de två motorerna avgör om din scraper levererar data eller kommer tillbaka tom på en viss webbplats.
Viktiga funktioner: två motorer, ett API
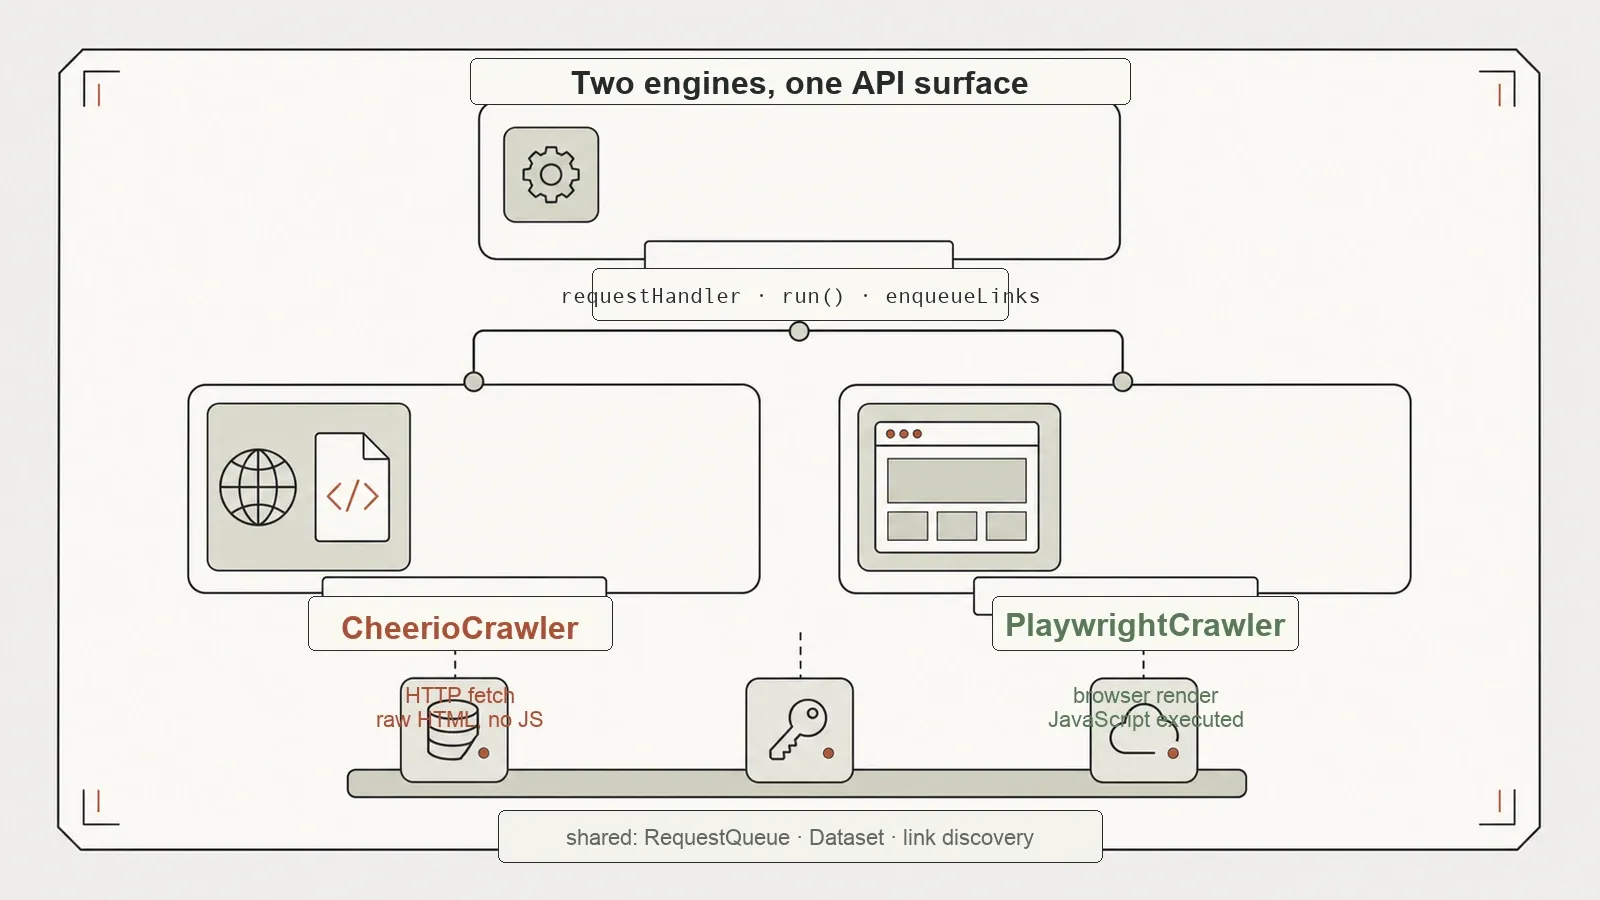
CheerioCrawler hämtar HTML och tolkar den med Cheerio; PlaywrightCrawler styr Chromium och kan ta skärmbilder. Båda använder en requestHandler, har run() och delar crawl-begrepp som köer och länkupptäckt. Deras handler-context skiljer sig dock: den testade Cheerio-vägen extraherade via $, medan webbläsarvägen använde page, waitForSelector och $$eval. Kö- och livscykelhanteringen kan förbli välbekant, men extraktionskoden kan behöva en adapter eller skrivas om.
Under huven ger Crawlee dig det som en riktig crawl behöver. En RequestQueue hanterar vilka URL:er som ska besökas, deduplicerar dem och håller reda på vad som redan är klart. enqueueLinks hittar och lägger till nya URL:er i kön (med selektor- och same-hostname-filtrering) så att en crawl kan växa av sig själv. En Dataset samlar dina scrape:ade poster för export. Som standard sparar Crawlee allt detta lokalt i en storage/-mapp på disk — praktiskt om du vill återuppta, och smått irriterande första gången du upptäcker en storage/-mapp du inte bett om i projektet (mitt testpaket styrde om det till en temporär katalog och stängde av persistens för att hålla testet rent).
Delarna är i sig oansenliga. Poängen är att de delas mellan båda motorerna, så kö, länkupptäckt och dataset beter sig likadant oavsett om du crawlar via HTTP eller genom en webbläsare. Du lär dig ett API och får två sätt att hämta data.
Setup: webbläsaren installeras separat
I den testade installationen ingick ingen Chromium-exekverbar fil efter att paketen installerats.
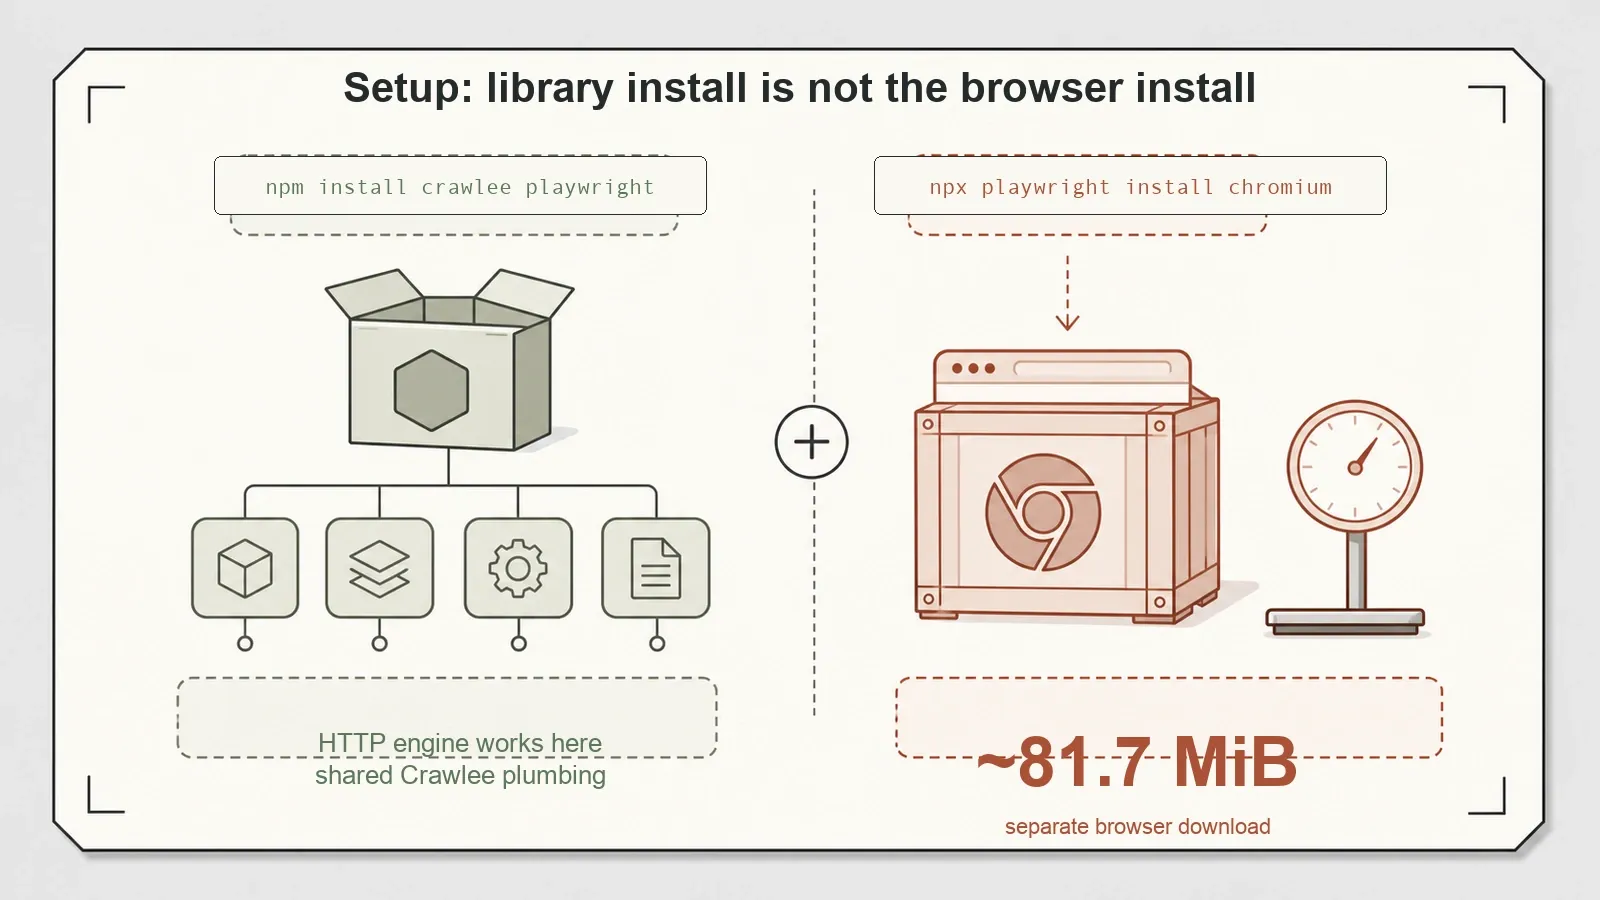
npm install crawlee playwright gick igenom utan problem för mig — 85 paket, 0 sårbarheter, ingen dramatik. Om du stannar där och kör en CheerioCrawler fungerar allt, eftersom HTTP-crawling inte behöver någon webbläsare.
I den här miljön behövde Chromium installeras separat med npx playwright install chromium; utan det lyckades inte PlaywrightCrawler starta. Den observerade webbläsarlasten var ungefär 82 MiB, men de ursprungliga anteckningarna säger inte om det avsåg överföringsstorlek eller storlek på disk. Det är en observation från en specifik maskin, inte en fast egenskap hos produkten. Dokumentationsvägar och paketbeteende kan ändras, så den här artikeln påstår inte att utelämnandet är universellt eller permanent odokumenterat.
Planera den testade setupen som två steg: installera Node-paketen, och installera sedan den webbläsare som Playwright-vägen använder. Kontrollera alltid aktuella instruktioner för Crawlee och Playwright för den version och plattform du faktiskt ska köra i.
Praktiskt test: samma sida, två väldigt olika svar
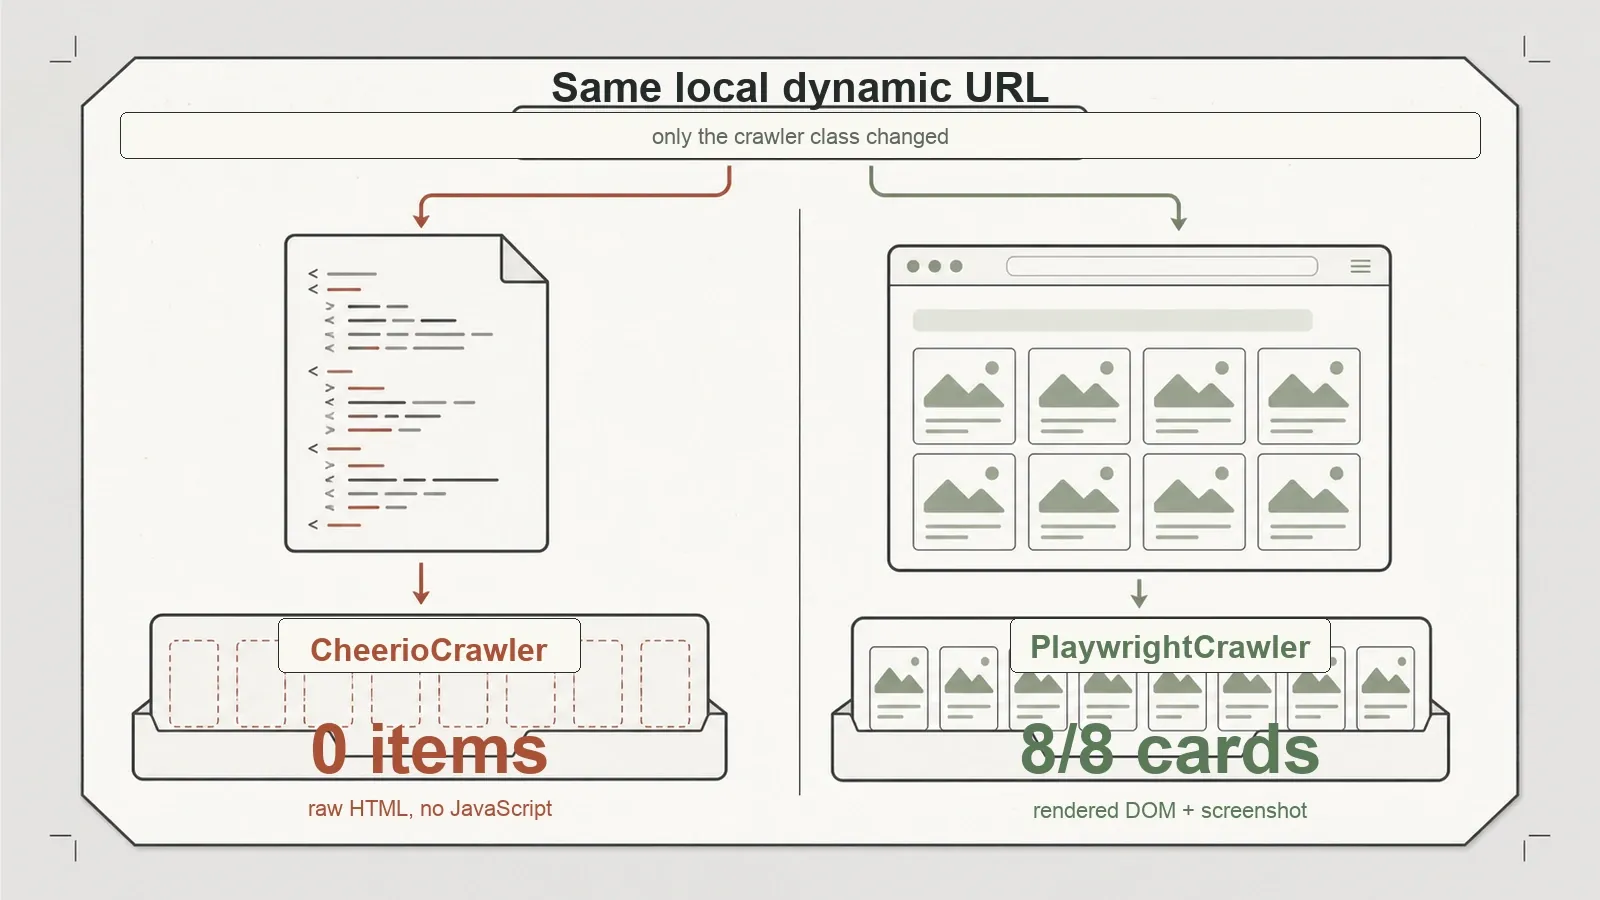
Det centrala testet skickade samma JavaScript-renderade fixture genom båda crawlers. URL och målfält var gemensamma; extraktionsprimitiverna var det inte.
På den lokala fixturen gav CheerioCrawler 0 målkort eftersom de inte fanns i den råa HTML:en. PlaywrightCrawler väntade på #dynamic-products article.product-card och returnerade sedan alla 8 förväntade kort samt tog en skärmbild. Resultatet visar att fixturen blev komplett för de valda fälten efter den väntan; det betyder inte att en webbläsare ser varje möjlig sidstatus. De råa filerna och skärmbilden finns i benchmark-repot.
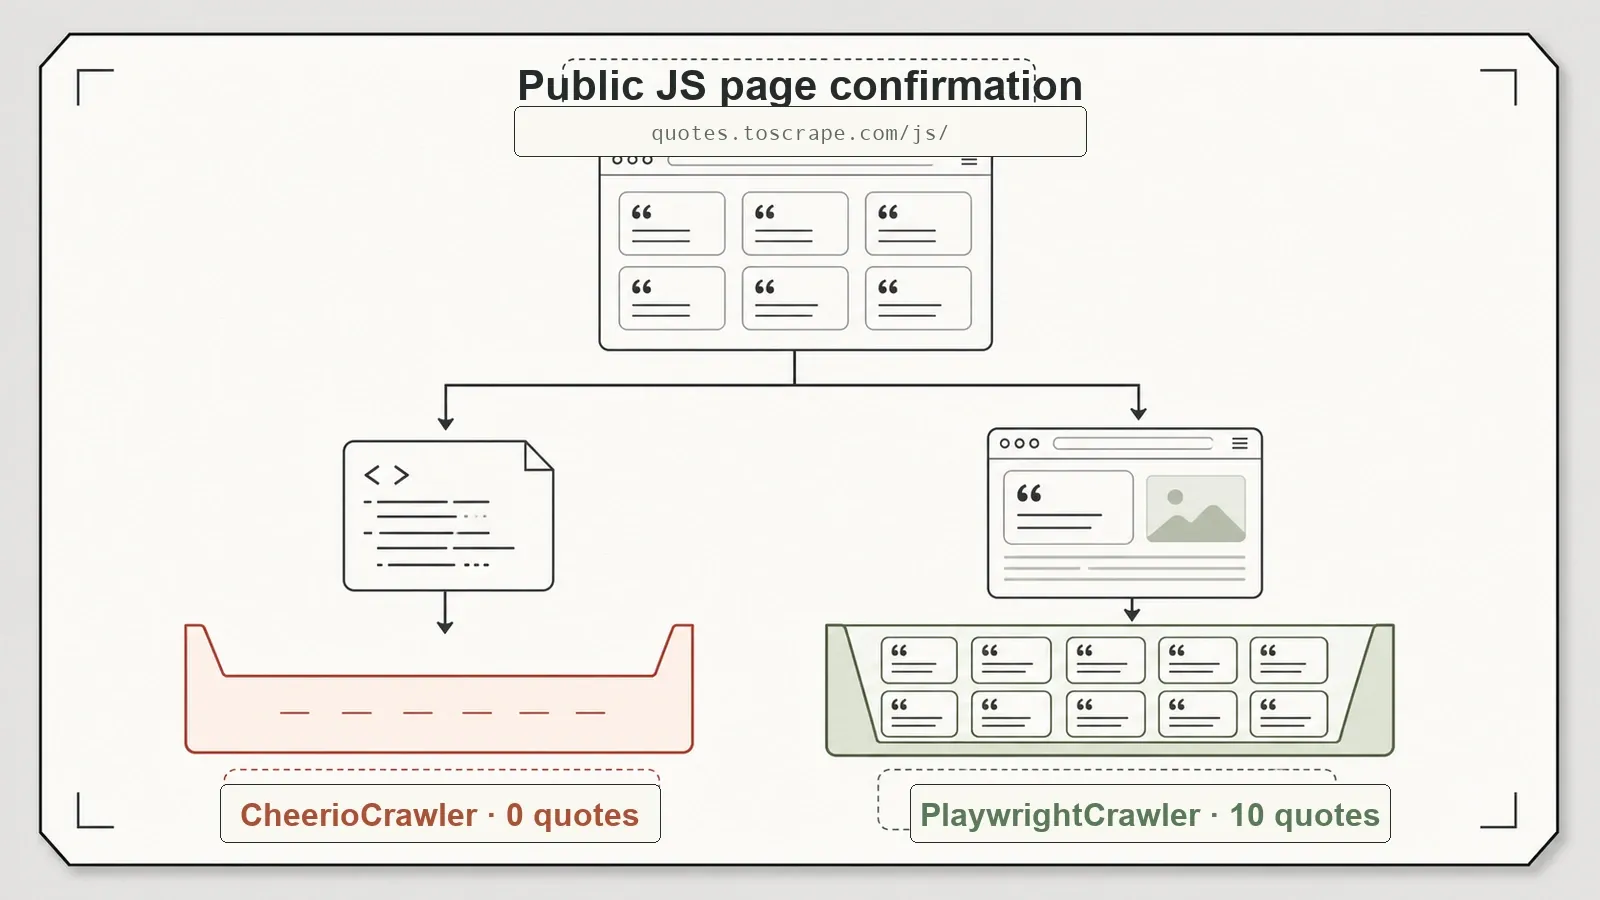
På den publika Quotes to Scrape JS-sidan hittade CheerioCrawler 0 målcitat medan PlaywrightCrawler väntade på .quote innan den extraherade 10. Det bekräftar samma gräns mellan HTTP och webbläsare på en publik målsida, samtidigt som crawler-klass, handler-context, väntelogik och extraktionsprimitiv skiljer sig mellan grenarna.
Den användbara slutsatsen är snävare än så: verifiera obligatoriska fält via HTTP-vägen, och gå upp till en browser-crawler när det råa svaret saknar dem. Webbläsarhanteraren måste dessutom vänta på ett tillstånd som faktiskt hänger ihop med just de fälten.
HTTP-vägen gav alla förväntade poster på de kontrollerade statiska katalog- och artikel-fixturerna, avkodade alla åtta förväntade objekt från ett direkt JSON-svar, besökte en begränsad graf med 11 sidor och skickade ett 500-svar till failedRequestHandler. Det här är separata kapabilitetstester, inte en enda noggrannhetssiffra. Mot den publika Books to Scrape-sidan gav den konfigurerade selectorn 20 produkter som ett smoke test.
| Test | Motor | Resultat |
|---|---|---|
| Statisk extraktion: katalog + paginering | CheerioCrawler | 12/12 förväntade produkter |
| Artikel-extraktion | CheerioCrawler | titel + 3/3 stycken |
| Transport: direkt JSON-svar | CheerioCrawler | 8/8 förväntade produkter |
| Traversering: internlänkad graf | CheerioCrawler | 11 sidor, djup {0:1, 1:3, 2:7} |
| Felhantering: HTTP 500 | CheerioCrawler | status skickades till felhanterare |
| Rendering: lokal fixture | CheerioCrawler | 0 målkort i rå HTML |
| Rendering: lokal fixture | PlaywrightCrawler | 8/8 efter väntan på target-selektor |
| Rendering: Quotes JS | CheerioCrawler | 0 målcitat i rå HTML |
| Rendering: Quotes JS | PlaywrightCrawler | 10 efter väntan på target-selektor |
Fulla tider och siffror per test finns i results/crawlee-test-summary.json.
Nu till de ärliga brasklapparna, eftersom en körning på en enda maskin har begränsningar och jag tänker inte låtsas något annat. Det här är tidsmätningar, inte benchmarkresultat — en maskin, ett körningstillfälle per test, så se webbläsarvägens högre kostnad per sida som "påtagligt långsammare än Cheerio-körningar under en sekund", inte som en publicerad siffra. Och det finns flera saker jag inte testade i den här omgången: proxy rotation, session pools, storskaliga körningar i hundratals till tusentals sidor, persistens och återupptag efter krasch för RequestQueue, Puppeteer-motorn samt exportflödet i Dataset/KeyValueStore (jag skrev exporterna manuellt här). Jag kan stå för tvåmotor-modellen och korrektheten på fixturnivå. Jag kan inte stå för skala eller anti-blocking-beteende, så det gör jag inte heller.
Vad som delas, och vad som måste ändras
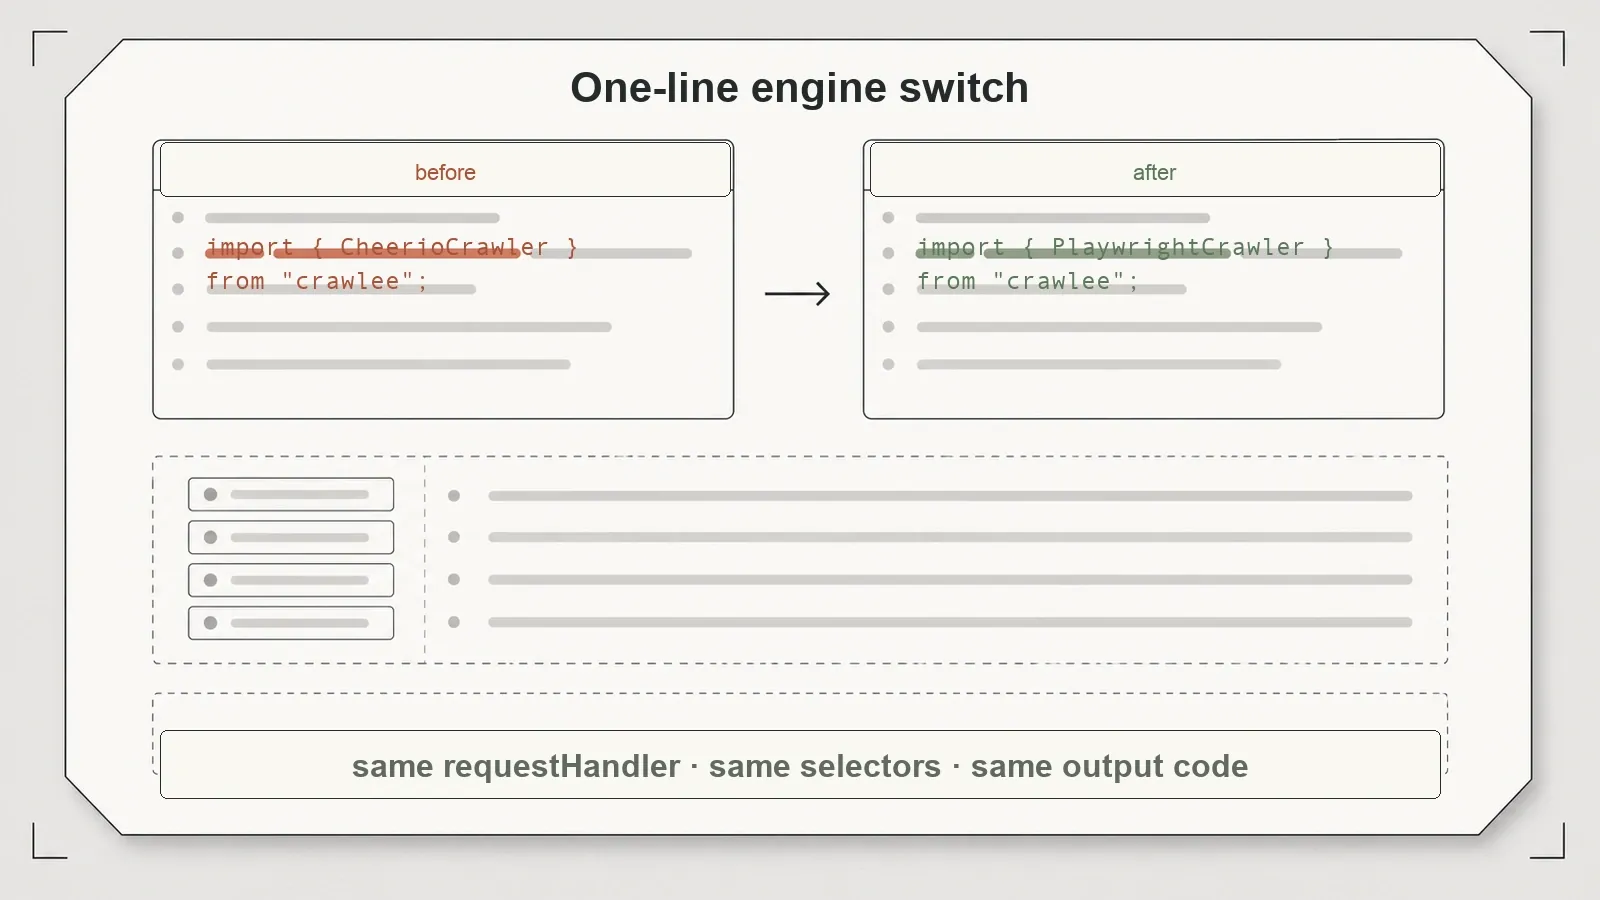
Det gemensamma gränssnittet är crawl-orchestrationen. Båda crawler-klasserna tar en requestHandler och exponerar run(). Köer, request-metadata, länkupptäckt, felhooks och lagringskoncept kan byggas upp konsekvent kring båda körvägarna. Det minskar mängden infrastruktur ett team måste lära om när ett mål kräver en webbläsare.
Ytan för sidåtkomst är inte gemensam. En handler i CheerioCrawler får åtkomst som är anpassad för Cheerio, till exempel $, och kan arbeta med response bodies utan webbläsare. Den testade PlaywrightCrawler-handlern får page; den väntar på en selector och kör utvärderingar mot webbläsarens DOM. Även när båda handlers producerar samma dataschema når de dit via olika API:er. En återanvändbar adapter skulle kunna dölja en del av skillnaden, men det här testet implementerade eller visade ingen sådan.
Den distinktionen spelar roll för uppskattningar. Att byta crawler-klass kan bevara kö, dataset och URL-policy, men selectors, readiness checks, skärmbilder, interaktionssteg och felhantering kan ändå behöva ändras. Artikeln behandlar därför "delad crawl-plumbing" som den verifierade fördelen och avvisar "en rad räcker" som ett ogrundat löfte.
Ett praktiskt flöde för val av motor
Börja med HTTP-vägen när den returnerade HTML:en eller ett direkt JSON-svar innehåller de fält du behöver. Definiera ett krav på fullständighet — obligatoriska nycklar, minsta antal objekt eller en target selector — och låt det falla tydligt om kravet inte uppfylls. En tom array är inte bevis för att sidan saknar data; i de två JavaScript-fallen här betydde det att den valda representationen saknade målelementen.
| Målvillkor | Börja med | Gå vidare när |
|---|---|---|
| Obligatoriska fält finns i returnerad HTML | CheerioCrawler | Obligatoriska selectors eller fält saknas |
| Ett reproducerbart JSON-svar innehåller datan | CheerioCrawler | Begäran beror på browser-only state |
| Sidan lägger till målelement efter körning | PlaywrightCrawler | Inte aktuellt; definiera en målspecifik readiness check |
| Målblandningen är okänd | HTTP först med validering av fullständighet | Valideringen faller med ett typat resultat "representationen är ofullständig" |
För bara detta typade fel vidare till en browser-handler när körning faktiskt behövs. I det här testpaketet väntade den lokala sidan på #dynamic-products article.product-card, medan den publika quotes-sidan väntade på .quote. De villkoren är en del av extraktionskontraktet. En generell load event räcker inte för att visa att applikationsdata har kommit in, och testet stödjer inte någon universell väntregel.
Efter uppskalning till webbläsare: håll samma utgångsschema även om DOM-primitiverna skiljer sig. Logga vilken motor som gav resultatet, vilken readiness condition som passerade och om valideringen av obligatoriska fält lyckades. Då blir en HTTP-till-webbläsare-fallback synlig i stället för att saknade fält tyst accepteras som giltiga poster.
Till sist: behandla installation och driftskostnad för webbläsaren som en del av din driftplan. Observationen på ungefär 82 MiB är bara användbar som en lokal storleksordning; mät exakt webbläsarbuild, plattform, cache-beteende och påverkan från image i din egen miljö. Proxy rotation, sessioner, persistens, återhämtning efter krasch och uthållig parallellism behöver fortfarande egna tester innan just den här fixturen kan användas som underlag för ett produktionsval.
För- och nackdelar
Fördelar:
- HTTP- och browser-crawlers delar livscykelbegrepp men har motoranpassade extraktions-context.
- HTTP-extraktion med återgivning 1,0 på statiska kataloger, artiklar och JSON-API:er.
- Delad plumbing i båda motorerna:
RequestQueue,enqueueLinksmed djupstyrning,Dataset. - Webbläsarvägen körde fixturernas skript och fångade alla förväntade målelement i de två JavaScript-renderade testerna.
- Ren felhantering — HTTP 500 nådde felhanteraren utan att krascha.
- Apache-2.0-licens; nedströmsanvändare bör granska krav på notis och attribuering.
Nackdelar:
- I den testade miljön krävde webbläsarmotorn en separat Chromium-installation; utan den startade inte
PlaywrightCrawler. - HTTP-vägen kan inte exponera målelement som inte finns i rå HTML; utan kontroll av fullständighet kan det se ut som ett giltigt tomt resultat.
- Webbläsarvägen innebär en extra webbläsarbinär och högre lokal kostnad per sida i den här körningen; storlek och tid varierar med build och plattform.
- Standardkörningar lämnar en
storage/-mapp på disk. - Endast Node/TypeScript — ingen hjälp om din stack är Python.
Vem den passar för — och vem som bör hoppa över den
Crawlee passar Node- eller TypeScript-team som behöver både HTTP- och browser-crawling med gemensamma begrepp för kö och livscykel. En praktisk väg är att först försöka med HTTP-crawlern, validera obligatoriska fält och sedan eskalera ett typat fel för ofullständig representation till en browser-handler med en målspecifik readiness condition. Handlerns DOM-kod är motorberoende även om kö- och link-discovery-plumbing delas.
Sänk förväntningarna, eller leta vidare, om du jobbar i en Python-miljö (Crawlee är för Node/TS — det finns en separat Python-port, men det här paketet testade Node-biblioteket), om alla dina mål är statiska och du hellre vill ha en lättare, mer enkelspårig HTTP-scraper, eller om du behöver bevisad stabilitet i skala — proxy rotation, session pools, resume-after-crash — vilket det här praktiska testet inte täckte. Och om du väljer PlaywrightCrawler, installera Chromium först, annars kommer den helt enkelt inte att köra.
Alternativ, inklusive var Thunderbit passar
Crawlee är öppen källkod som du kör och förvaltar själv. Det finns ingen avgift per anrop från en leverantör, men webbläsar-kapacitet, bandbredd, proxies, lagring, observability och utvecklingsarbete är fortfarande driftkostnader. Du ansvarar för crawler-val, webbläsarbinär, lagringstillstånd och readiness-logik.
Relaterad recension: scrapy-playwright review.
En hanterad extraktionstjänst flyttar ansvar för insamling och schemaformning till en leverantör. Vi bygger Thunderbit, men körde inte tjänsten mot de här fixturerna, så artikeln stöder ingen jämförelse av kvalitet, latens, funktionsparitet eller kostnad. Den relevanta frågan är om ditt team vill ha Crawlees in-process-kontroll eller en tjänstegräns per anrop.
Relaterade benchmark-recensioner: den fullständiga jämförelsen av open source-scrapers, Playwright kontra Puppeteer på samma sidor, och Scrapys genomgång utan webbläsarbaserad request replay.
Testa Thunderbit för extraktion av webdata
Slutsats
Crawlee är ett starkt alternativ för Node- eller TypeScript-team som vill ha gemensam crawl-orchestration över HTTP och webbläsarkörning. De testade handlern var inte utbytbara: att gå över till Playwright krävde page, väntan på en target selector och extraktion i webbläsaren. Proxy, sessioner, persistens, återupptag och storskaligt beteende är fortfarande öppna frågor.
Testa Thunderbit för extraktion av webdata Get Started Free
FAQ
Vad är den faktiska skillnaden mellan Crawlees två crawlers?
CheerioCrawler hämtar HTML via HTTP och kör inte JavaScript. PlaywrightCrawler styr Chromium och kan köra sidans skript samt ta skärmbilder, men till en högre lokal kostnad per sida. De delar livscykelbegrepp, men inte identiska handler-context: i det här testet användes $ på HTTP-vägen och page, väntan på target selector samt browser-side evaluation på Playwright-vägen.
Varför startar inte PlaywrightCrawler efter att jag installerat Crawlee?
I den testade miljön följde ingen webbläsarexekverbar fil med paketinstallationen. Att installera Chromium med npx playwright install chromium löste startfelet. Den observerade lasten var ungefär 82 MiB, men den ursprungliga mätningen sa inte om det var överföringsstorlek eller storlek på disk, så mät om det för just din plattform och build.
Kan CheerioCrawler skrapa JavaScript-renderade sidor?
Den kan inte köra sidans JavaScript. Den kan däremot fortfarande anropa en tillgänglig JSON-endpoint som klienten använder, vilket det direkta svar-fixturen visar. När den nödvändiga datan bara finns efter webbläsarkörning, använd en browser-crawler och en readiness condition som är kopplad till just de fälten.
Är Crawlee korrekt för normal statisk extraktion? På de kontrollerade fixturerna producerade handlern 12/12 förväntade produktposter i katalogen, 3/3 förväntade stycken i artikeln och 8/8 förväntade objekt från direkt-JSON. Det här är kontroller av att fixturen är komplett, inte en generell noggrannhetspoäng för oprövade webbplatser.
Är Crawlee gratis för kommersiell användning? Det publiceras under Apache-2.0. Bekräfta aktuell licens i repositoryt och gå igenom krav på notis och attribuering för din distribution.
Innan du går till produktion bör du testa de delar som den här fixturen lämnar öppna: upprepad parallellism på representativa sidor, proxy- och sessionbeteende, beständig köåterställning efter avbrott, städning av browserprocesser och export av dataset vid fel. Spara den verifierade webbläsarversionen och installationsvägen tillsammans med resultaten. De två crawler-klasserna minskar skillnader i orchestration, men de tar inte bort behovet av motorspecifika readiness checks, resursbudgetar och operativ felhantering.




