
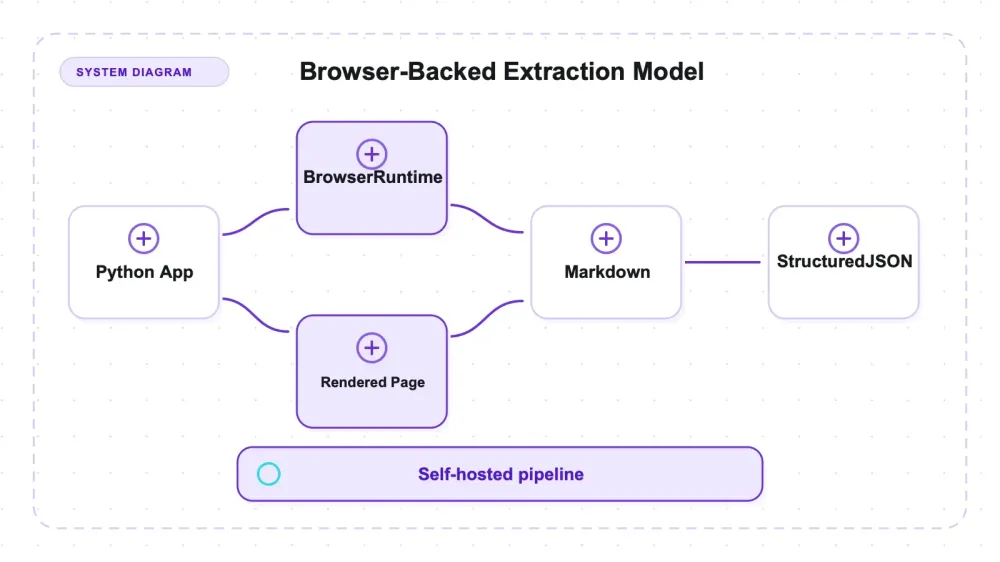
Vissa jämförelser av tredjeparts-scrapers tillskriver Crawl4AI "Adaptive Intelligence" — alltså selektorer som lär sig en webbplats och reparerar sig själva efter ändringar i markup. Jag såg inget sådant beteende i det API som testades. Det Crawl4AI faktiskt erbjuder är webbläsarbaserad Markdown-generering plus extrahering via CSS/XPath. Scrapling har i stället en separat funktion för adaptiva selektorer, inom de gränser som beskrivs i deras egen genomgång.
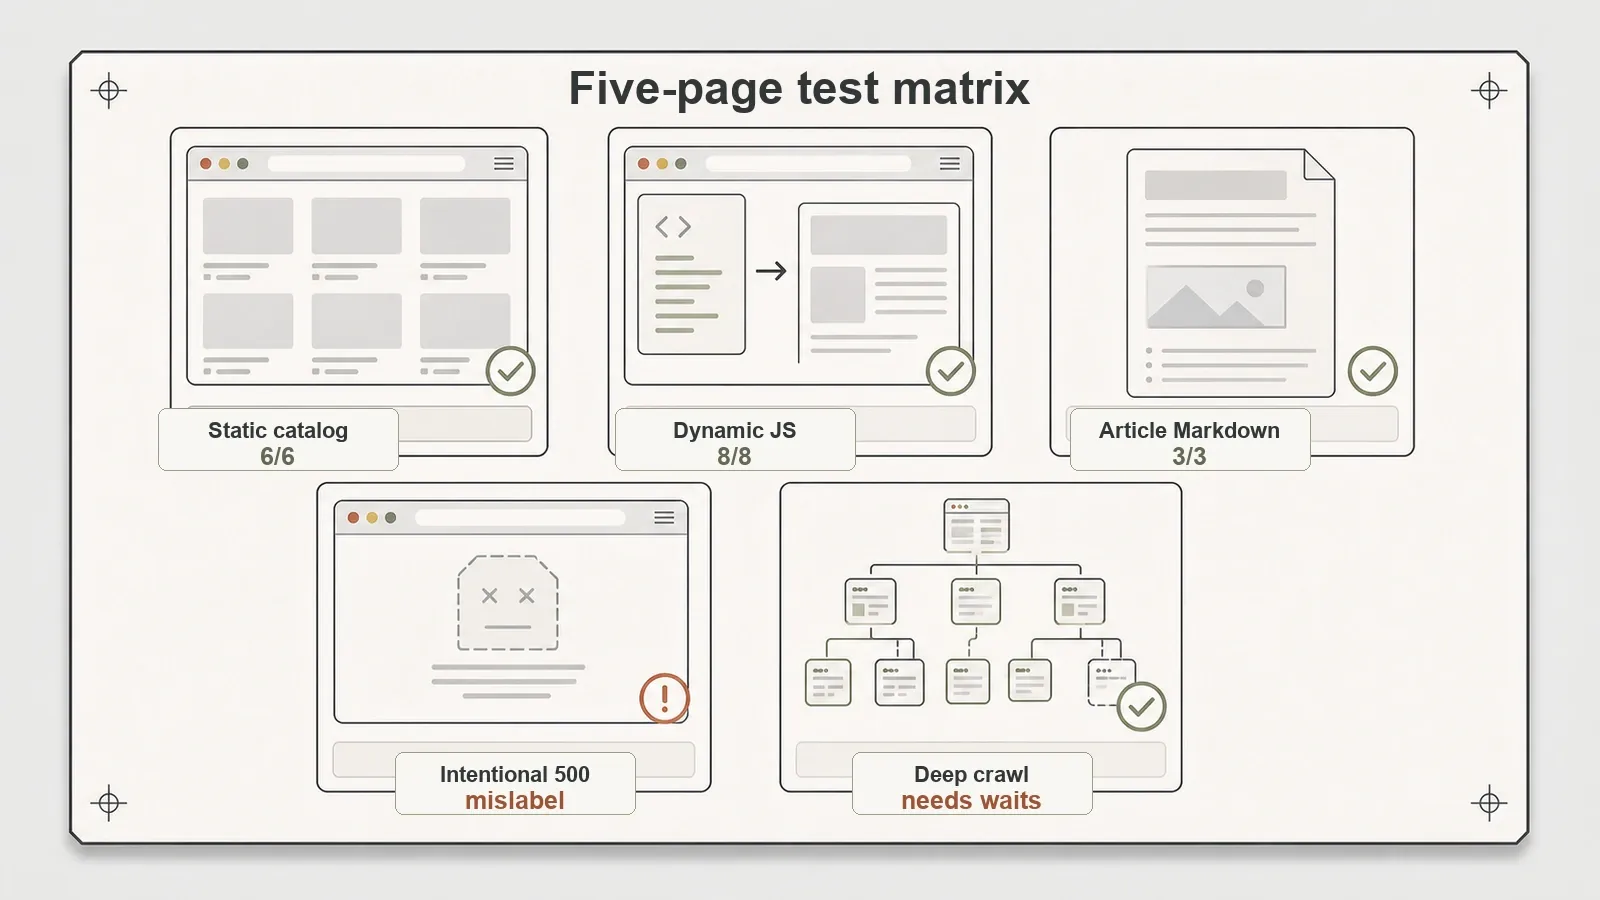
Jag testade Crawl4AI 0.9.0 mot fem sidtyper med kända facit: en statisk katalog, en katalog renderad med JavaScript, en artikel med mycket sidmall, ett avsiktligt 500-fel och en länkad flersidig graf. Både Markdown- och schemaflödena gav det förväntade innehållet i testfilerna. Rå Markdown behöll sidmallens brödtext, djupcrawling krävde sidunika väntelägen, och ett vanligt 500-fel fick en felmärkning som lät som anti-bot-skydd.
Vad Crawl4AI faktiskt är
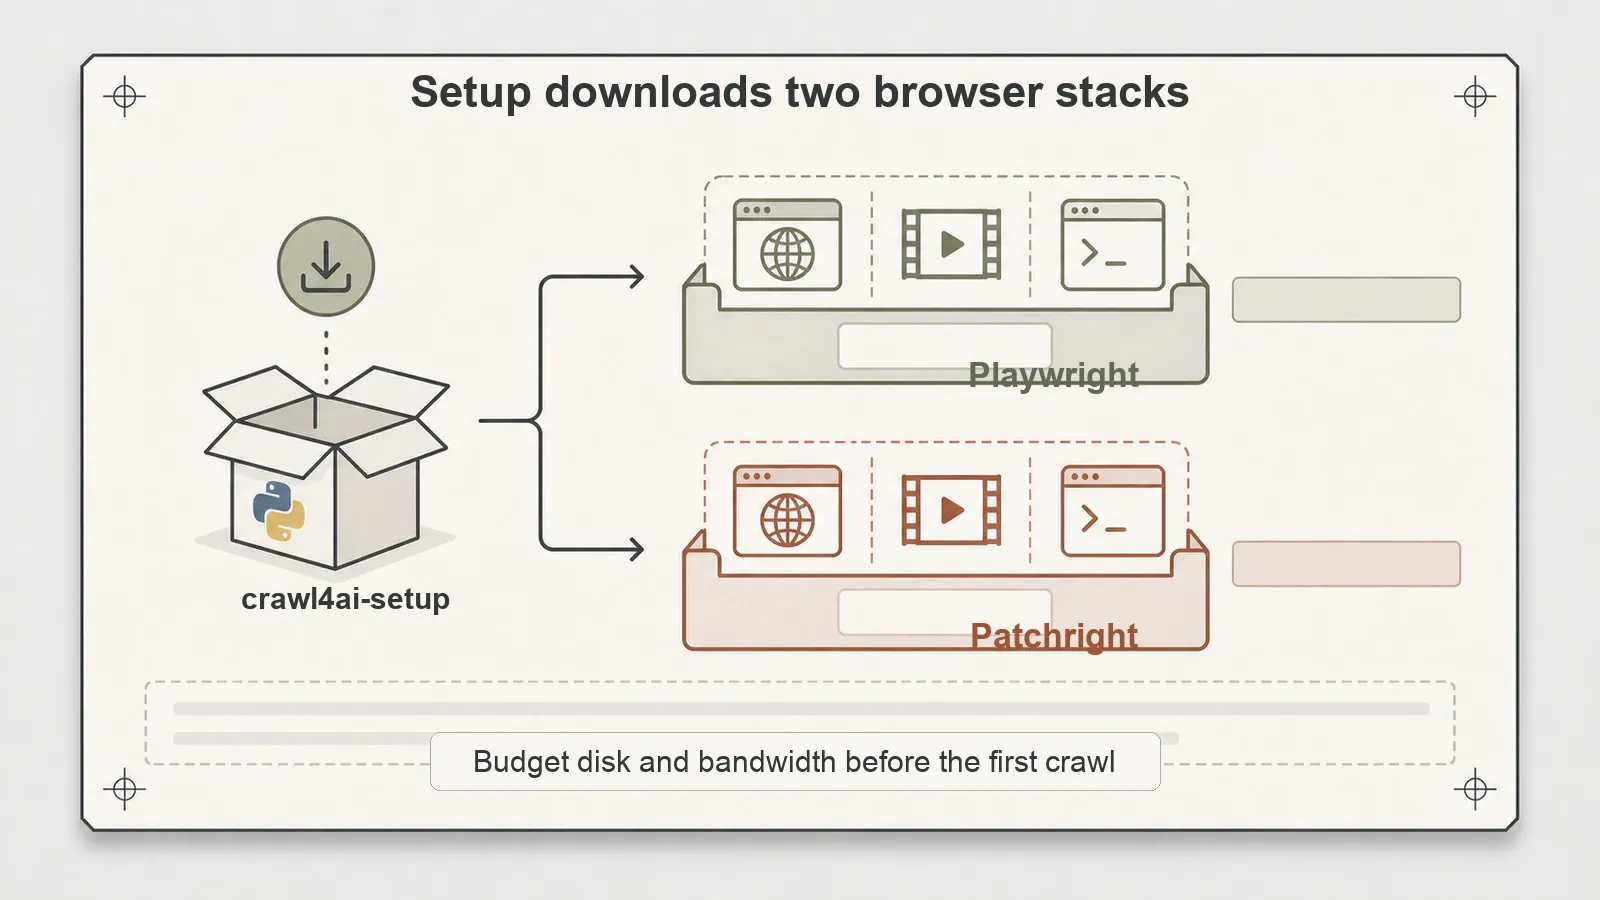
Börja med det de flesta missar redan vid installationen. Crawl4AI är inte en liten Python-parser. Första crawl4ai-setup hämtar tyst ner två kompletta webbläsarstackar — både Playwright och Patchright — och när man ser det faller allt på plats: det här är en styrd headless-webbläsare med en Markdown-konverterare ovanpå, förklädd till scraper.
Officiellt är det ett öppen källkod-bibliotek med Apache-2.0-licens för att omvandla webbsidor till Markdown för RAG-pipelines, agenter och datainflöden. Jag testade v0.9.0. Kärnbyggstenarna är AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, Markdown-generering och extraheringsstrategier baserade på CSS/XPath eller LLM, enligt den officiella snabbstarten.
Här är den mentala modell som spelar roll. De flesta parserbibliotek skickar en HTTP-förfrågan och tolkar de bytes som kommer tillbaka; Crawl4AI styr i stället en riktig webbläsare. Webbläsarrendering är inbyggd, vilket gör installationen tyngre än en ren HTTP-parser, medan tillförlitlig extrahering från asynkront renderade element fortfarande kan kräva ett uttryckligt vänteläge. Inget i det här testet skrev om selektorer efter en redesign. Se därför på påståenden om självläkning som ett fel i en tredjepartssammanställning, om det inte finns en tydlig officiell källa och ett reproducerbart API-exempel.
Viktiga funktioner och hur de fungerar under huven
Ensidiga körningar är kärnan i produkten. Du pekar AsyncWebCrawler mot en URL, den laddar sidan i en webbläsare och lämnar tillbaka Markdown. I den officiella snabbstarten mot example.com tog den rundan 1,81 sekunder och gav ett rent 200-svar. Inget spektakulärt, men det visar att minimiflödet fungerar nästan utan konfigurering — inget schema, inga väntelägen, ingen webbläsarkonfiguration.
Videoguide (1:02:38): Crawl4AI Official Tutorial, Full 1hr with Quickstart Examples.
Strukturerad extrahering är den andra pelaren, och det närmaste Crawl4AI kommer att "förstå" en sida — vilket vill säga, inte faktisk inferens, bara ett schema du själv skriver. I stället för att bara dumpa Markdown anger du ett CSS-schema via JsonCssExtractionStrategy och får tillbaka JSON-objekt med exakt de fält du bad om. På min lokala statiska katalog gav det 6 rena JSON-poster — produktnamn, kategori, pris, betyg, detalj-URL — och de matchade alla 6 förväntade produkter. Det är skillnaden mellan "här är sidan som text" och "här är datan som rader", och Crawl4AI klarar båda i samma körning. Selektorerna måste du dock definiera själv; verktyget matchar det du ger det, men gissar inte fram schemat åt dig.
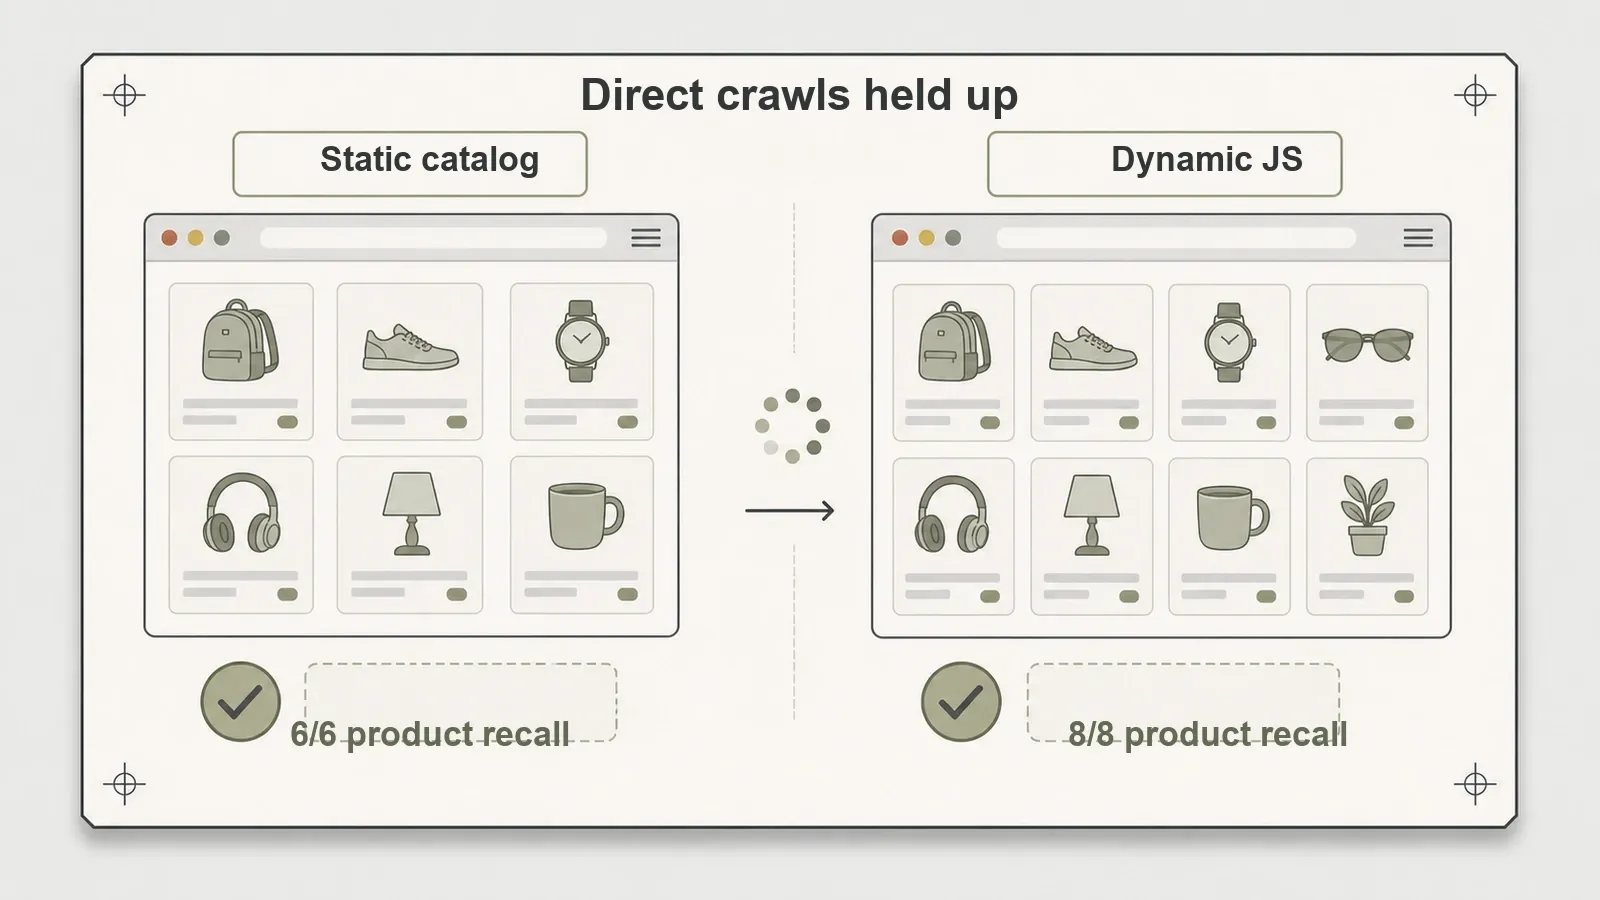
Dynamisk rendering är där webbläsarstöd verkligen gör nytta. Pekar du den mot en JavaScript-renderad katalog med wait_for="css:.product-card" väntar den tills klientrenderingen är klar innan extraheringen sker. Det gav 8/8 träffsäkerhet för produkter i både Markdown- och schemautdata på mitt lokala JS-test, på ungefär 1,56 sekunder. På den publika sidan Quotes to Scrape JS page fångade den de renderade citaten och sparade dessutom en användbar skärmdump — innehåll som en vanlig HTTP-förfrågan aldrig hade sett, eftersom det inte finns något att tolka i den initiala HTML-koden.
Sedan finns skala och crawling. arun_many() körde sex lokala detaljsidor parallellt med full 6/6 träffsäkerhet på 3,76 sekunder. Crawl4AI levererar också strategier för djupcrawl — BFS, DFS och BestFirst — som går igenom en länkgraf med djupgränser, sidtak, filtrering och poängsättning. En BFS-djupcrawl gick igenom min fixtures startsidas länkgraf och hämtade in fem sidor. Det är här marknadsföringen och verkligheten börjar glida isär, och jag kommer till det längre ner.
Installation: det som ingen skriver i README-introt
Installationen på min maskin var på ett sätt smidigare än väntat och på ett annat tyngre. pip install -U crawl4ai och smoke-testet lyckades på Python 3.14.2 på macOS arm64. PyPI-specifikationen >=3.10 inkluderar redan 3.14; det här resultatet bekräftar bara den testade installationen och arbetsflödet, inte bredare kompatibilitet.
Det som känns mest är installationssteget. crawl4ai-setup hämtar browser-assets för både Playwright och Patchright — Chrome for Testing, FFmpeg och en Headless Shell. Har du en laptop med begränsat diskutrymme eller uppkoppling med datatak är det en verklig kostnad, och dokumentationen nämner det mest i förbigående snarare än direkt. crawl4ai-doctor körde sedan utan problem och crawlade crawl4ai.com på 14,65 sekunder, vilket är ett okej end-to-end-smoketest men inte ett prestandatest av något slag — jag skulle inte dra några slutsatser om hastighet av den siffran.
Det viktigaste att ta med sig för din egen utvärdering: budgetera för nedladdningen av webbläsarna, inte bara för pip-installationen. Det här liknar mer att sätta upp en headless browser-miljö än att bara släppa in ett bibliotek i ett script. Två webbläsarstackar landar på disken innan du ens har crawlat en enda riktig sida, och det är en engångskostnad du får oavsett om ditt jobb någonsin behöver Patchrights stealth-lager eller inte.
Praktiskt test: vad som höll, och vad jag skulle flagga för
Fyra resultat är värda att skriva ner noggrant, eftersom de visar precis den typ av nyans som en marknadssida gärna rundar av — och i ett fall, märker fel.
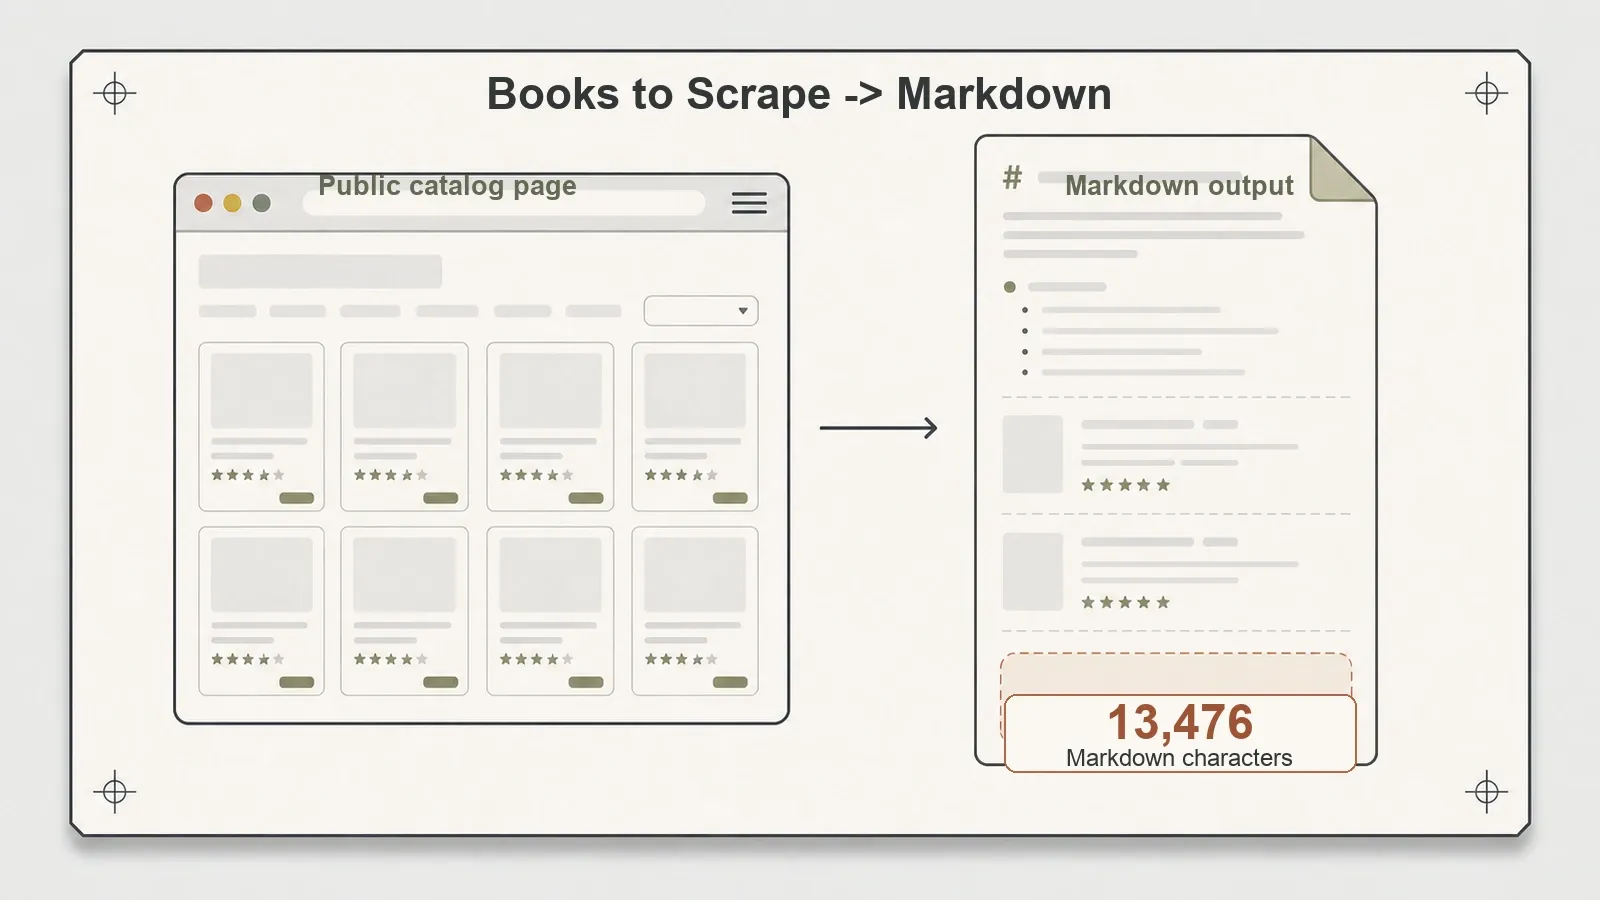
Två publika demosidor klarade också den enkla vägen. På startsidan för Books to Scrape producerade Crawl4AI 13 476 tecken Markdown på 2,43 sekunder. Den publika Quotes JS-sidan gav 1 666 renderade Markdown-tecken på ungefär 3,1 sekunder. Ingen av dem säger något säkert om skala, fientliga sajter, långsiktig stabilitet, sessioner, proxyer, retries eller minnesbeteende.
Artikelfixturen visar en viktig brasklapp kring Markdown-kvalitet. Crawl4AI fångade rubriken och alla 3/3 stycken i brödtexten — bra. Men den råa Markdownen behöll också navigationstext, relaterade länkar, en prenumerationsrad och sidfotstext. Det är inte en bugg; utan content filter eller målselektor betyder "konvertera den här sidan till Markdown" faktiskt hela sidan. Lärdomen är att skilja mellan rå Markdown-konvertering och ren artikelutvinning. Vill du ha det senare använder du ett content filter som PruningContentFilter eller en målselektor — något jag inte har stresstestat än, så jag kan inte ange någon renhetssiffra för det.
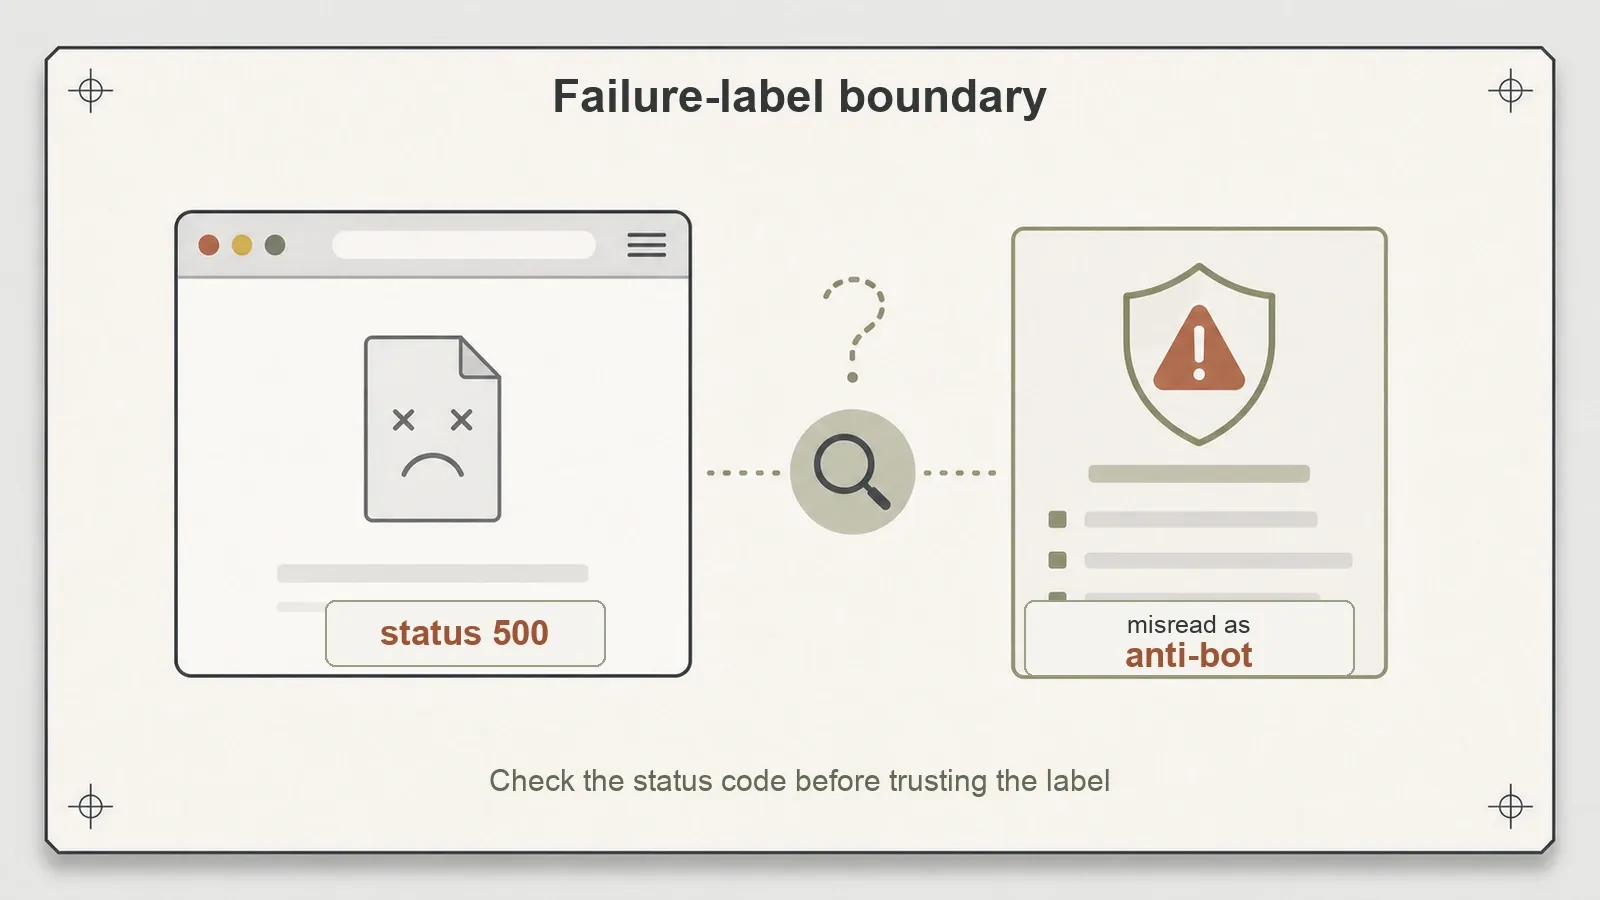
Den trasiga sidan gav det mest avslöjande resultatet. Jag serverade ett avsiktligt HTTP 500 med ett litet innehåll. Crawl4AI svarade med success=false och status 500 — korrekt — men felmeddelandet beskrev det som "Blocked by anti-bot protection: Structural: minimal_text on small page." Det fanns inget anti-bot-skydd. Det var en liten felsida. Crawl4AI:s strukturella heuristik såg väldigt lite synlig text och drog till med en anti-bot-förklaring. För den som bygger vidare på detta spelar det roll: lita inte blint på etiketten "anti-bot". Kontrollera statuskoden och själva svaret innan du drar slutsatsen att sajten aktivt blockerar dig. Råresultatet finns i benchmark-repot på results/local_failure_500.json.
Djupcrawl kräver medveten konfigurering. En direkt dynamisk crawl med wait_for fungerade utan problem, medan BFS-djupcrawlen hittade den dynamiska katalogen men returnerade ett fel. Klassificeringen som minimal text stämmer med att sidan lästes innan korten hade renderats, och djupcrawlen tillämpade inte samma vänteläge som den direkta körningen. Av fem sidor lyckades tre och två misslyckades. Eftersom en omkörning med vänteläge inte visas här är den diagnosen fortfarande en slutsats, inte en bevisad orsak.
Vad siffrorna faktiskt visar
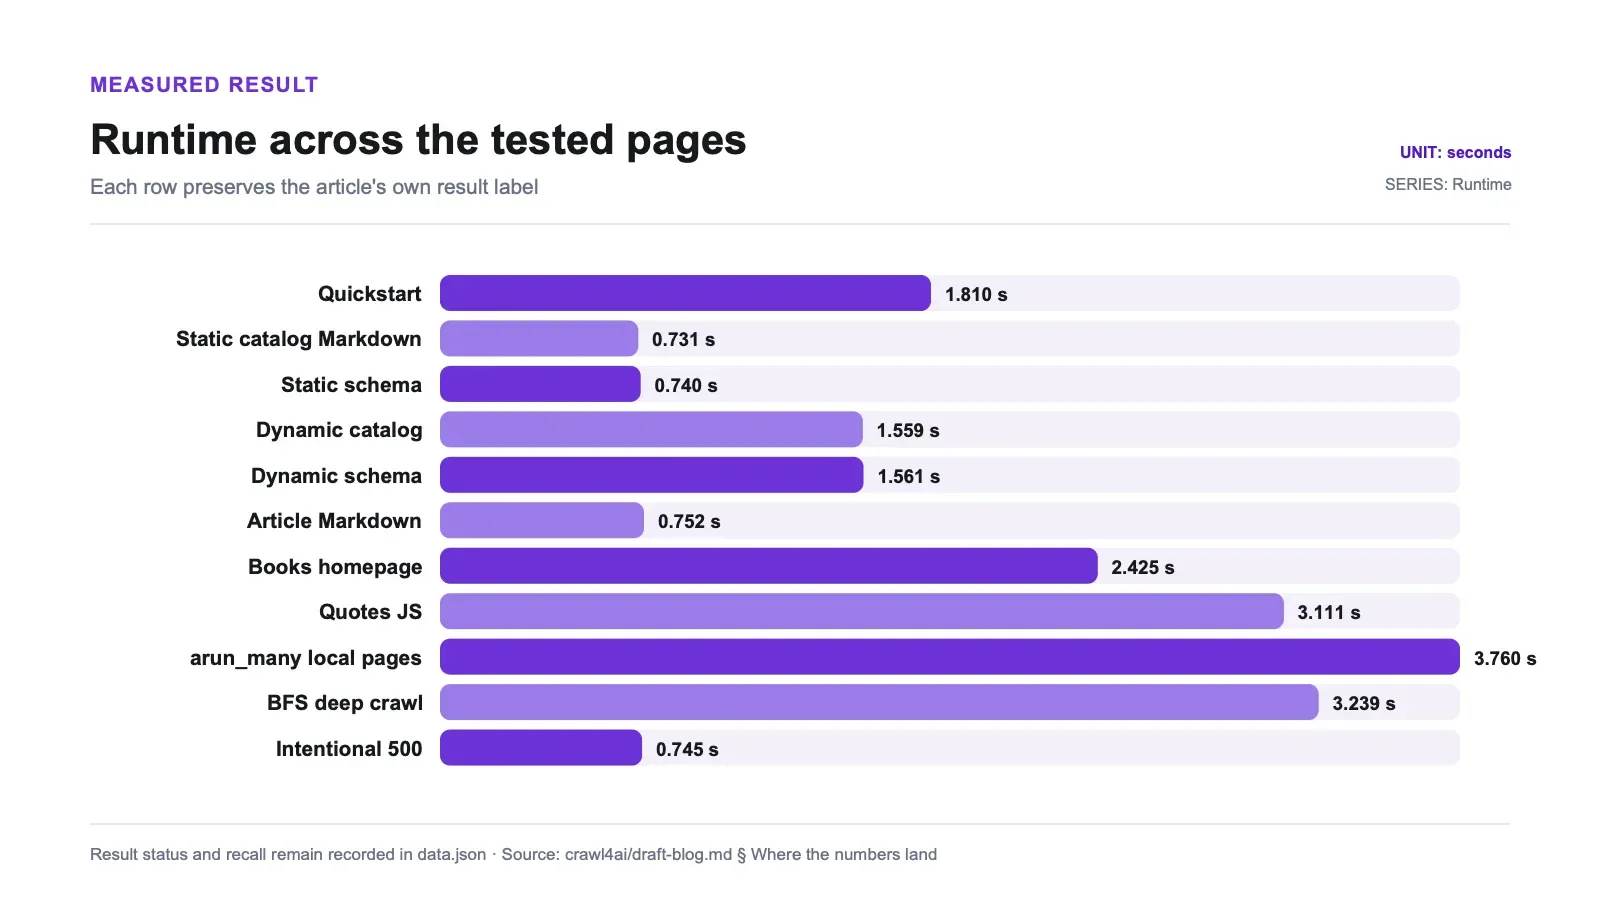
| Test | Resultat | Observerad körtid (en enstaka uppmätt körning) |
|---|---|---|
Snabbstart (example.com) | lyckades, 200 | 1,81 s |
| Lokal statisk katalog (Markdown) | 6/6 produktträffar | 0,731 s |
| Lokal statisk CSS-schemaextraktion | 6 JSON-poster | 0,740 s |
Lokal dynamisk katalog (wait_for) | 8/8 produktträffar | 1,559 s |
| Lokal dynamisk CSS-schemaextraktion | 8 JSON-poster | 1,561 s |
| Artikel-Markdown | 3/3 stycken (+ sidmall) | 0,752 s |
| Publik Books to Scrape-startsida | 13 476 Markdown-tecken | 2,425 s |
| Publik Quotes JS-sida | 1 666 Markdown-tecken, renderat | 3,111 s |
arun_many() (6 lokala sidor) | 6/6 träffsäkerhet | 3,760 s |
| Lokal BFS-djupcrawl | 5 sidor hittade, 3 lyckades / 2 misslyckades | 3,239 s |
| Avsiktlig 500-sida | fel, 500 (felmärkt "anti-bot") | 0,745 s |
Det här är tider från smoketester, inte ett prestandatest: artikeln redovisar inte hårdvara, antal upprepningar, varm/kall start, cacheläge, kontroll av samtidighet eller variation. De visar bara att de listade arbetsflödena fungerade på just den här maskinen. Fullständiga körartefakter finns i benchmark-repots katalog.
För en prestandaundersökning som går att fatta beslut på bör du köra varje arbetsflöde flera gånger i både färska och återanvända webbläsarsessioner, redovisa fördelningar i stället för en decimal, låsa webbläsarversioner och dokumentera CPU, minne, cacheläge och samtidighet. Då går det att skilja bibliotekets overhead från webbläsarstart och nätverksvariation.
| Krav | Passar i den här genomgången | Huvudvillkor |
|---|---|---|
| Rendera en sida och returnera Markdown | Bra kandidat | Filtrera bort sidmall innan du betraktar resultatet som en ren artikel |
| Extrahera schemaformaterad JSON | Bra kandidat | Du måste fortfarande skriva och underhålla CSS-schemat själv |
| Vänta in asynkront sidinnehåll | Stöds | Definiera ett explicit, målspecifikt wait_for-villkor |
| Crawla dynamiska sidor på djupet | Villkorat | För över regler för beredskap; standardläget i testet gav delvisa fel |
| Köras som en liten, lättviktig HTTP-parser | Dålig passform | Webbläsarassets och underhållet av dem ingår i driften |
| Använda självläkande selektorer | Stöds inte av det här testet | Tolka inte detta från annan jämförelsetext |
För- och nackdelar
Fördelar:
- Ett bibliotek klarar både rå Markdown och strukturerad JSON med CSS-schema — du slipper bygga ihop två verktyg.
- Webbläsarrendering är inbyggd; mål som renderas asynkront kan kräva ett uttryckligt
wait_for. - De testade ensidiga arbetsflödena klarade tiderna ovan; ingen jämförande hastighetspåståelse görs.
- Apache-2.0-licens — vänligt för kommersiell användning, utan copyleft-överraskningar.
- Aktivt projekt med en ny release och en stor, engagerad community.
Nackdelar:
- Tung första installation (två webbläsarstackar) som introduktionen tonar ner.
- Rå Markdown innehåller sidmall om du inte konfigurerar content filters.
- Djupcrawling väntar inte automatiskt in dynamiska sidor — du måste ställa in det per crawl, annars får du fel.
- Felmeddelanden kan kalla ett vanligt fel för "anti-bot", vilket skapar förvirring i loggar.
- Inga självanpassande selektorer, trots vad vissa jämförelser antyder — scheman skrivs och underhålls manuellt.
- Du kör och förvaltar själv webbläsarmiljön, inklusive uppdateringar och eventuella avbrott.
För vem det passar — och vem som bör hoppa över det
Crawl4AI är värt att utvärdera om du är utvecklare och bygger en RAG- eller agentpipeline, du är bekväm med att köra en headless browser-miljö, och du vill ha både Markdown och strukturerad JSON från samma crawl. Testerna omfattade inte motståndskraft mot fientliga sajter, långvarig stabilitet, minnesanvändning, sessioner, retries, proxyer eller produktionsdrift, så rekommendationen gäller bara de arbetsflöden som faktiskt testades här.
Hoppa över det — eller åtminstone pausa — om du ville ha en liten, lättviktig HTTP-parser (det här är raka motsatsen), om du inte kan avsätta diskutrymme och bandbredd för browser-nedladdning, eller om du inte vill ansvara för drift och underhåll av en webbläsarstack i produktion. Och hoppa särskilt över det om du var ute efter självläkande selektorer: det är inte vad det här verktyget är, och att bygga ett arbetsflöde kring en funktion som inte finns kommer att straffa sig senare. För ren artikelutvinning där sidmall rensas bort kan ett lättare verktyg som är byggt just för det vara ett bättre val.
Alternativ, inklusive var Thunderbit passar in
Den ärliga bilden: Crawl4AI är ett gratis bibliotek med öppen källkod som du själv hostar och underhåller. Du får full kontroll och ingen licenskostnad till leverantören, men betalar fortfarande för beräkning, bandbredd, lagring, webbläsaruppdateringar, scheman och operativt arbete.
I andra änden finns en hanterad scraping-tjänst som Thunderbit, där hämtning och extrahering ligger bakom ett API. Thunderbit kördes inte mot dessa fixtures, så den här artikeln gör inga jämförbara påståenden om rendering, anti-bot-hantering, CAPTCHA, noggrannhet eller hastighet. Den relevanta jämförelsen handlar om operativt ansvar: hosta själv det webbläsarbaserade biblioteket, eller betala en tjänst för att sköta det lagret.
Skillnaden är vem som kör webbläsaren. Med Crawl4AI äger du rendering, väntelägen, scheman och underhåll. Med ett hanterat API betalar du per anrop och flyttar en del av det operativa ansvaret till leverantören. Det här testet jämförde inte de två vägarna utifrån resultat.
Relaterade benchmark-genomgångar: den fullständiga jämförelsen av öppen källkod-scrapers, Firecrawls self-hosted-genomgång och trafilaturas artikelutvinningsgenomgång.
Testa Thunderbit för extrahering av webdata
Slutsats
Crawl4AI är ett rimligt val om du vill ha öppen källkod, webbläsarbaserad extrahering som ger både Markdown och schemaformad JSON, och du är beredd att själv ansvara för webbläsarmiljön. De direkta statiska flödena och de dynamiska flödena med vänteläge fungerade i de här testfilerna. Apache-2.0 är generös, även om vanlig granskning av beroenden och distribution fortfarande behövs.
Räkna med webbläsarassets i budgeten. Rå Markdown behöver filtreras innan den är en ren artikeltext. Väntelägen för djupcrawl kräver medveten konfigurering, och ett loggmeddelande som säger "anti-bot" bör kontrolleras mot statuskod och svar. Schema-selektorernas utformning och underhåll är fortfarande ditt ansvar. Det här är de testade gränserna för beslut; produktion i stor skala och beteende mot fientliga sajter återstår att utvärdera.
Testa Thunderbit för extrahering av webdata Get Started Free
Vanliga frågor
Har Crawl4AI adaptiva eller självläkande selektorer? Nej. Trots att vissa jämförelser tillskriver den "adaptive intelligence" matchar Crawl4AI det CSS/XPath-schema du själv skriver — den fingerprintar inte element och hittar inte om dem efter en markupändring. I testet nådde den strukturerade extraheringens recall 6/6 och 8/8 med scheman jag skrev för hand. Om en webbplats ändrar sina klasser går schemat sönder tills du uppdaterar det. Självläkande elementspårning är en annan biblioteksfunktion, inte den här.
Varför är installationen så stor?
crawl4ai-setup hämtar kompletta webbläsarassets för både Playwright och Patchright — Chrome for Testing, FFmpeg och en Headless Shell. Det är priset för att leverera riktig webbläsarrendering. Räkna med disk och bandbredd för det; det är tyngre än en ren HTTP-parser, och du betalar det även om ditt arbetsflöde aldrig använder stealth-lagret.
Kan Crawl4AI hantera sidor som renderas med JavaScript?
Ja, eftersom den styr en riktig headless browser. I testet gav en dynamisk katalog med wait_for="css:.product-card" full 8/8 produktträffsäkerhet, och den publika Quotes JS-sidan renderades korrekt. Nackdelen är att djupcrawl inte automatiskt tillämpar samma vänteläge på upptäckta sidor — en BFS-crawl misslyckades på en dynamisk sida den hittade eftersom den inte väntade. Du ställer in väntetiden själv, per crawl.
Ger Crawl4AI mig ren artikeltext eller hela sidan?
Som standard hela sidan. I testet fångade den alla stycken i brödtexten men behöll också navigation, relaterade länkar och sidfotstext. För ren artikelutvinning använder du ett content filter (till exempel PruningContentFilter) eller en målselektor i stället för att förlita dig på rå Markdown.
Kan jag lita på Crawl4AI:s felmeddelanden? Läs dem med viss skepsis. En avsiktlig 500-felsida med litet innehåll markerades som "Blocked by anti-bot protection" enbart på grund av en heuristik för låg synlig text — det fanns inget anti-bot-skydd. Det råa resultatet finns i benchmark-repot. Kontrollera alltid faktisk HTTP-statuskod och svarstext innan du slår fast att en webbplats blockerar dig.




