
Jag byggde en testsajt för att pröva den del av Colly som varken ett sidantal eller ett rykte om snabbhet kan svara på: om dess callbacks faktiskt hämtar de förväntade posterna, skickar vidare HTTP-fel, följer en avgränsad graf och kan ta del av innehåll som levereras utanför den renderade HTML:en. Det här var alltså en granskning av korrekthet och gränser, inte ett prestandatest.
I de kontrollerade fixturesen extraherade Colly alla förväntade statiska poster, skickade ett 500-svar till OnError och besökte 17 URL:er i den konfigurerade djupbegränsade grafen. På två sidor där elementen bara dök upp efter JavaScript-körning fick den 0 träffar på målelementen. Ett direkt åtkomligt JSON-endpoint gick däremot att använda utan webbläsare, vilket är en viktig skillnad jämfört med att rendera klientgränssnittet.
Vad Colly faktiskt är
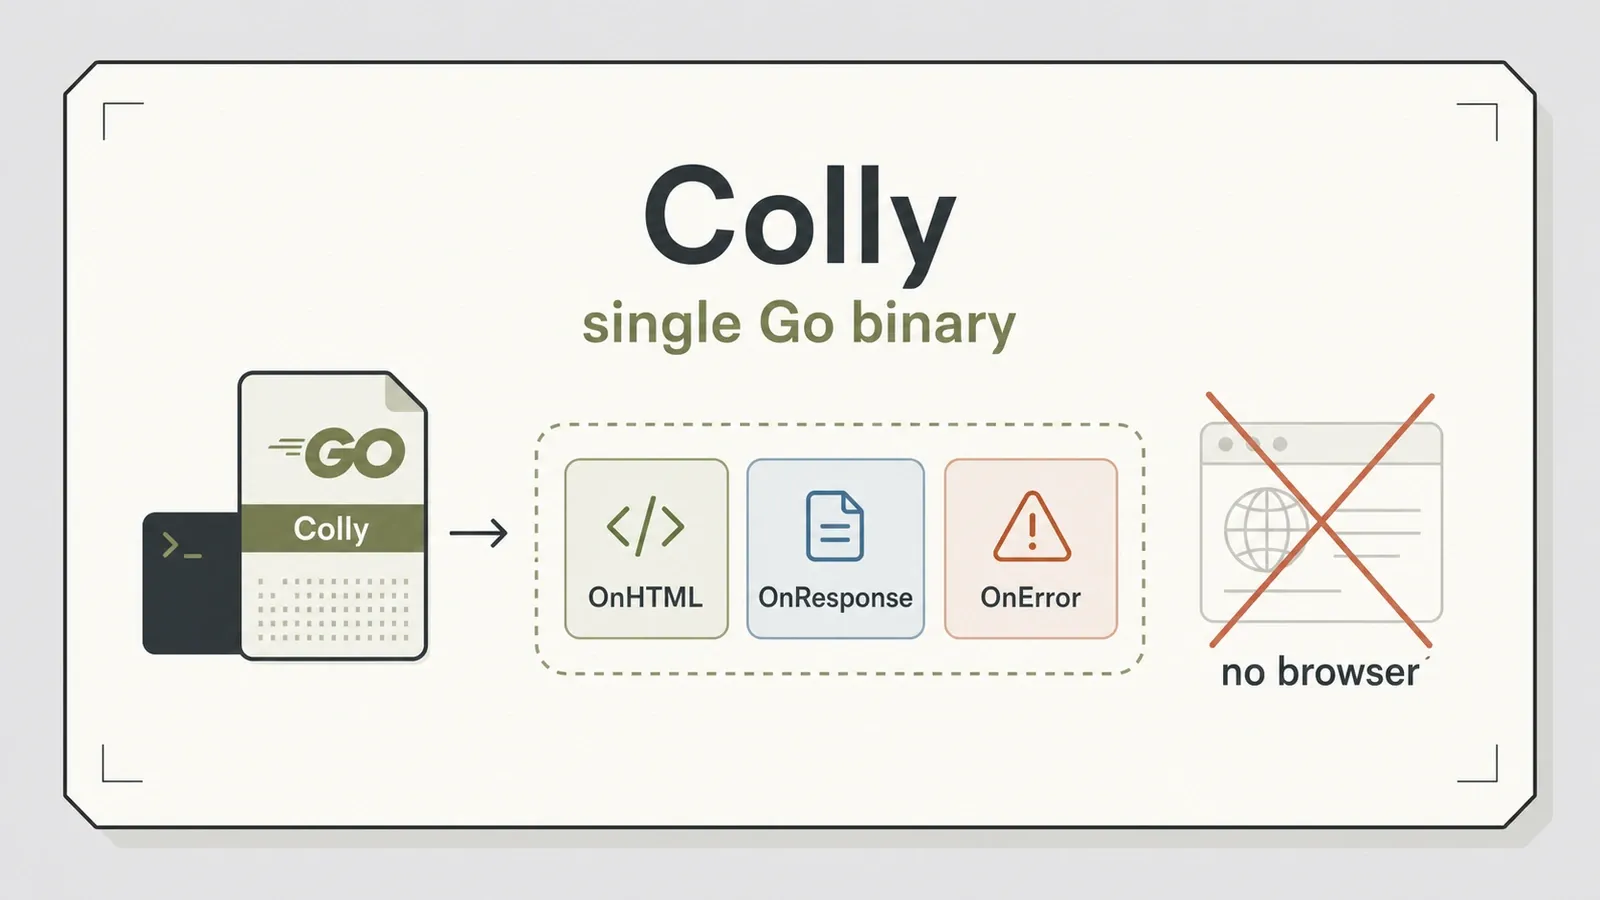
Colly beskriver sig som en "elegant scraper and crawler framework for Golang", och den formuleringen gör mer arbete än man först kan tro. Det är ett Go-bibliotek — runt 25 300 GitHub-stjärnor och 1 850 forks — licensierat under Apache-2.0. Det är inte ett CLI-verktyg du laddar ner och pekar mot en URL. Du skriver Go-kod, importerar Colly, registrerar några callbacks och kompilerar allt till en enda körbar fil.
Den mentala modellen är händelsestyrd. Du kopplar handlers till en Collector: OnHTML kör extraheringslogik för matchande CSS-selektorer, OnResponse ger dig den råa svarstexten och OnError hanterar misslyckade förfrågningar. Länkhandlers anropar Visit() på upptäckta URL:er, medan MaxDepth sätter en gräns för hur djupt Colly får traversera. För dessa HTTP-baserade flöden behöver målhosten varken separat installerad Go-runtime eller webbläsare; om den resulterande binären är helt statisk beror på build-flaggor och CGO-användning, vilket det här testet inte dokumenterade.
Viktiga funktioner och hur de fungerar under huven
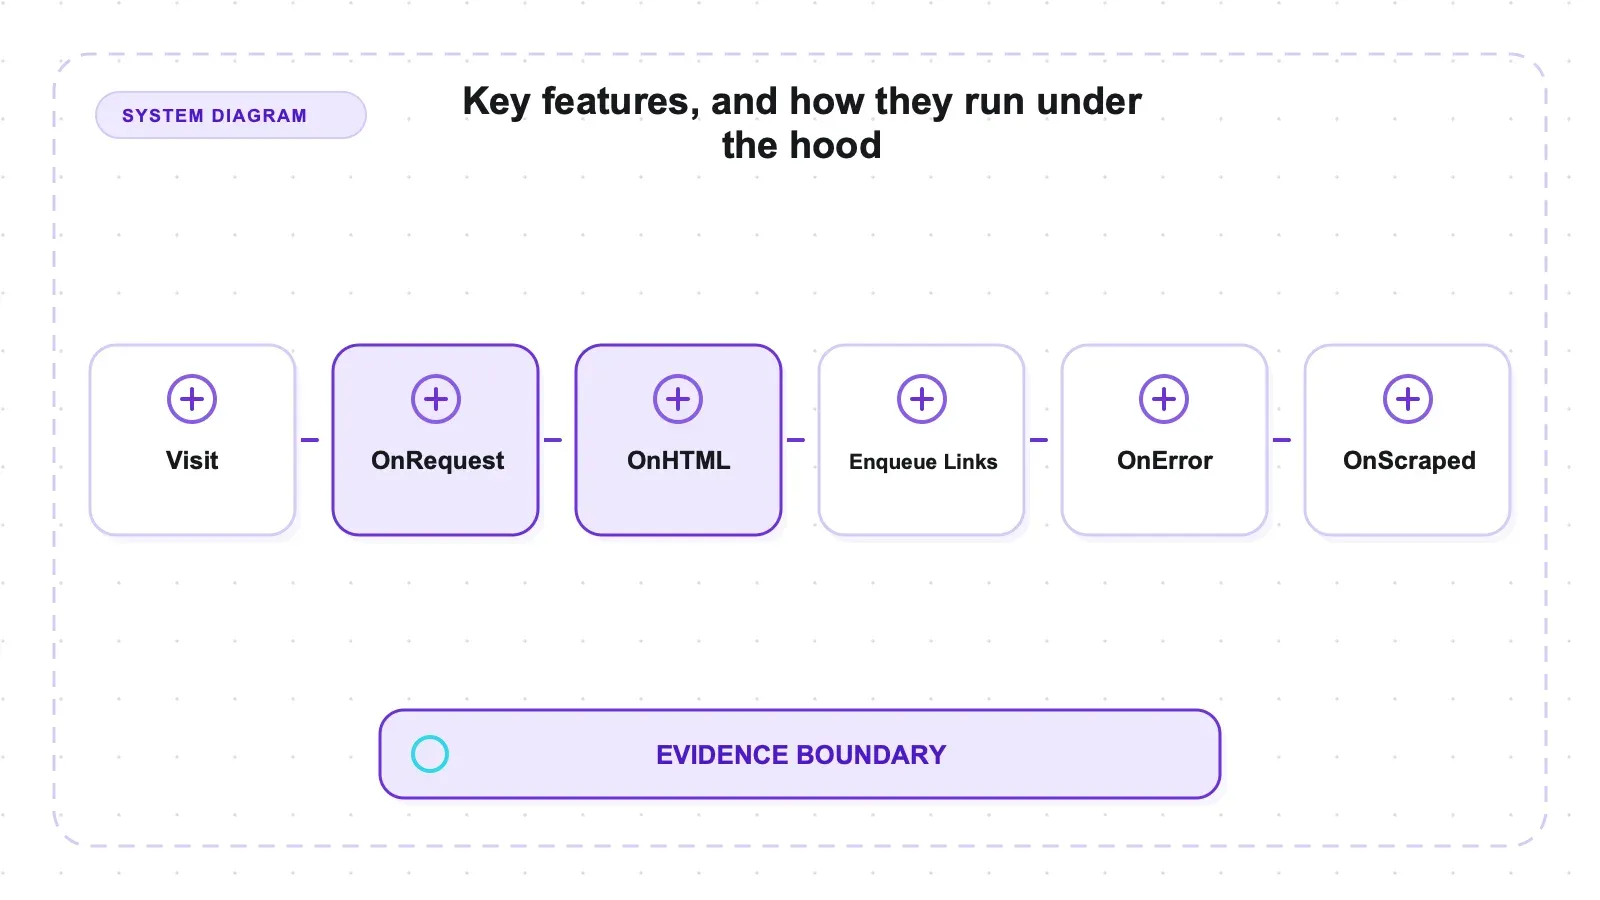
Callback-modellen är det viktigaste att förstå, eftersom det är den som gör att Colly känns annorlunda än ett skript som bara hämtar och parsar. Tre callbacks bar upp varje test jag körde.
OnHTML(selector, handler) är arbetshästen. Registrera den mot .product eller article p, så anropar Colly din handler en gång per matchande element när DOM:en parsas. Det är här strukturerad extrahering hör hemma, och det blir lättläst — du beskriver vad som ska plockas ut, i stället för att skriva en hel parse-loop.
OnResponse(handler) ligger ett steg lägre och ger dig de råa bytena. När ett mål returnerar JSON i stället för HTML hoppar du över DOM:en helt och avkodar kroppen själv. Just den här callbacken är orsaken till att Colly hanterade ett JSON-API snyggt i mitt test utan någon HTML-parsning alls.
OnError(handler) hanterar misslyckade förfrågningar och kan exponera en svarskod för anropande kod. I det här testet nådde ett fixturesvar med status 500 den registrerade callbacken. Retrier, timeouts, DNS-fel, connection resets, callback-fel, persistence och alerting testades inte.
Ovanpå callbacksen finns två operativa funktioner. MaxDepth begränsar länkgenomgång enligt Collys djupsemantik. En kompilerad Go-exe slipper också en separat installerad språk-runtime på målhosten. Den här körningen dokumenterade inte build-flaggor eller CGO-status, så den påstår inte att varje resulterande binär är helt statisk.
Setup: den Go-toolchain som krävs
Beroendet är kort men reellt, så här är det innan du installerar något. Maskinen jag testade på hade inget Go installerat, och Colly är ett Go-bibliotek — så steg ett var att lägga in en Go-toolchain på datorn (jag installerade Go 1.26.5 via Homebrew). Om ditt team inte redan arbetar i Go är det just där friktionen ligger: inte i Colly i sig, utan i språkmiljön som krävs innan en enda rad kan kompileras.
När Go väl fanns på plats löste go get github.com/gocolly/colly/v2 till v2.3.0. De testade flödena krävde varken webbläsare eller headless Chrome.
Det finns en versionsyta som kan förvirra läsaren. Go-modulen löste till v2.3.0 (publicerad i december 2025), medan den nyaste posten som syntes i GitHubs Releases-gränssnitt var v2.2.0 (mars 2025) vid kontrollen. Skillnaden handlar om modul-/repository-version kontra GitHub Release-post, inte modul kontra Git-tag. Jag testade v2.3.0.
Praktiskt test: extrahering och operativa gränser
Jag körde Colly mot en självförsörjande fixture-server (Gos httptest) plus två publika demosajter. Den aktuella benchmark-katalogen och results/colly-test-summary.json visar artefakter, men båda länkarna pekar mot en rörlig branch. Artikeln anger inte något testat commit, exakt kommando, build-flaggor eller fixture-seed, så detta är ännu inte ett reproduktionsrecept som är immutabelt.
| Test | Mål | Resultat |
|---|---|---|
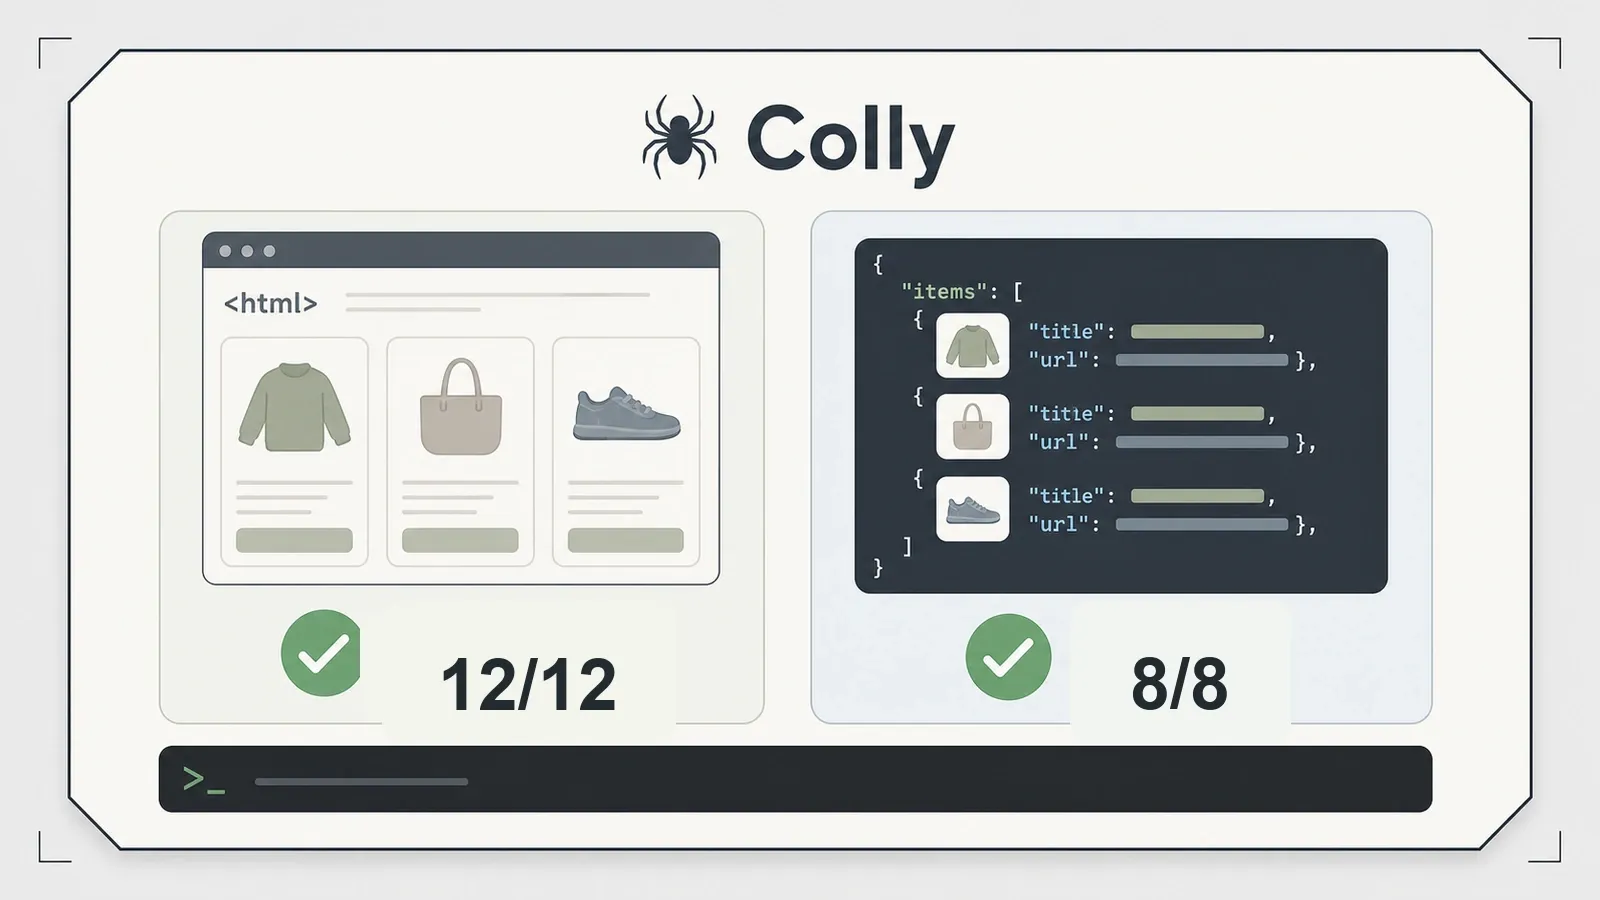
| Statisk katalog + paginering | lokal fixture | 12/12 förväntade produkter extraherade |
| Artikelutdrag | lokal fixture | titel + 3/3 stycken |
| Direkt JSON-svar | lokal fixture | 8/8 förväntade poster via OnResponse |
| Hantering av HTTP 500 | lokal fixture | skickades till OnError, status 500 |
Crawl-graf (MaxDepth 2) | lokal fixture | 17 sidor |
| Books to Scrape | publik demo | 20 produkter |
| Dynamisk sida (utan JS) | lokal fixture | 0 cards (förväntat) |
| Quotes JS (utan rendering) | publik demo | 0 (förväntat) |
I de kontrollerade statiska fixturesen gav de konfigurerade selektorerna 12 av 12 förväntade produktposter och alla tre förväntade artikelstycken. Det direkta JSON-svaret gick aldrig genom någon HTML-parser: OnResponse levererade kroppen och testharnessen avkodade alla åtta förväntade poster. Den ensamma 500-fixturen nådde OnError med sin status exponerad och kraschade inte den körningen; det bevisar inte driftssäkerhet utan tillsyn. På den publika sidan Books to Scrape gav selektorn 20 produkter som ett enkelt smoke test mot en publik webbplats.
För traversering konfigurerades collectorn med MaxDepth(2) enligt harnessens seed-depth-konvention och besökte 17 URL:er i fixture-grafen. Resultatet handlar om crawl-täckning, inte om hastighet. Den observerade tracen — inte ett bredare påstående om godtyckliga grafer — finns i results/local_crawl_graph.json.
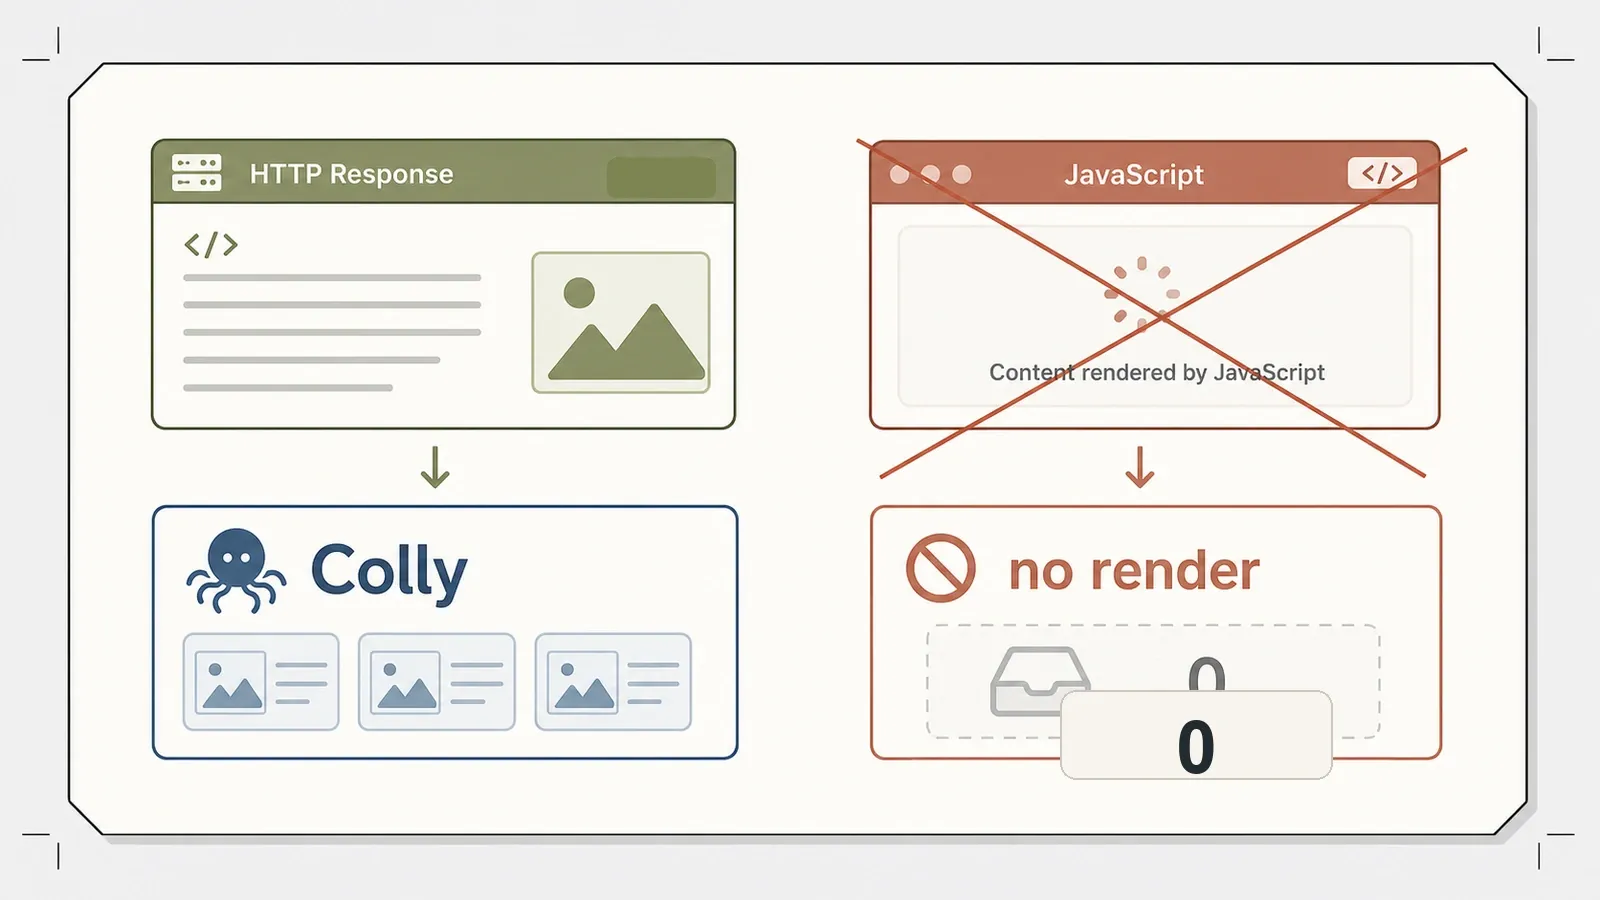
Colly kör inte JavaScript. Den JavaScript-renderade fixturen gav 0 målkort, och den publika sidan Quotes to Scrape JS gav 0 målcitat. Om element bara finns efter webbläsarens körning och inget åtkomligt backing-endpoint levererar dem, kan det HTTP-baserade flödet inte se dem som renderad DOM. Koppla på en renderer, eller anropa backing-endpoint direkt när en sådan finns, vilket JSON-fixturen visar.
Jag belastade inte den asynkrona collectorn, rate limiting eller politeness-konfiguration, proxy-rotation, retries eller queue- och storage-backends. Ingen mätt tid, throughput, samtidighet, CPU, minne, mål-latens eller jämförelsebaseline mättes. Den här artikeln gör därför inget påstående om hastighet eller drift utan tillsyn.
Hur man tolkar fixture-resultaten
De tre lyckade innehållsvägarna testar olika kontrakt. Katalog- och artikel-fallen testar CSS-selektion mot HTML som servern returnerar. Deras nämnare är fixture-förväntningar som skrevs innan extraheringen: tolv produktposter och tre artikelstycken. Att redovisa dem som “förväntade poster extraherade” är medvetet. Körningen definierar inte fuzzy matching, dubbletthantering, tolerans för ofullständiga fält eller ett återkallningsmått för en hel korpus, så resultatet ska inte upphöjas till generell extraheringsnoggrannhet.
JSON-fallet kringgår DOM-selektion. Colly får svarbytes via OnResponse, och harnessen sköter JSON-avkodningen. Därför betyder inte “Colly kör inte JavaScript” att alla sajter med klientstöd är otillgängliga. Om datakällan som klienten använder är ett endpoint som går att anropa direkt, och om förfrågan kan reproduceras utanför webbläsaren, kan en HTTP-crawler fortfarande räcka. Autentisering, genererade signaturer, browser-only state och anti-bot-skydd kan ändra svaret; inget av detta testades här.
500-routen testar dispatch, inte återhämtning. Den visar att den registrerade OnError-callbacken fick just det fixturesvaret och dess status. En produktionscrawler behöver fortfarande en uttrycklig policy för retrierbara koder, backoff, terminala fel, persistence och alerting. Testet ger inget stöd för de valen, och “callbacken kördes” ska inte läsas som “jobbet är säkert att köra utan tillsyn.”
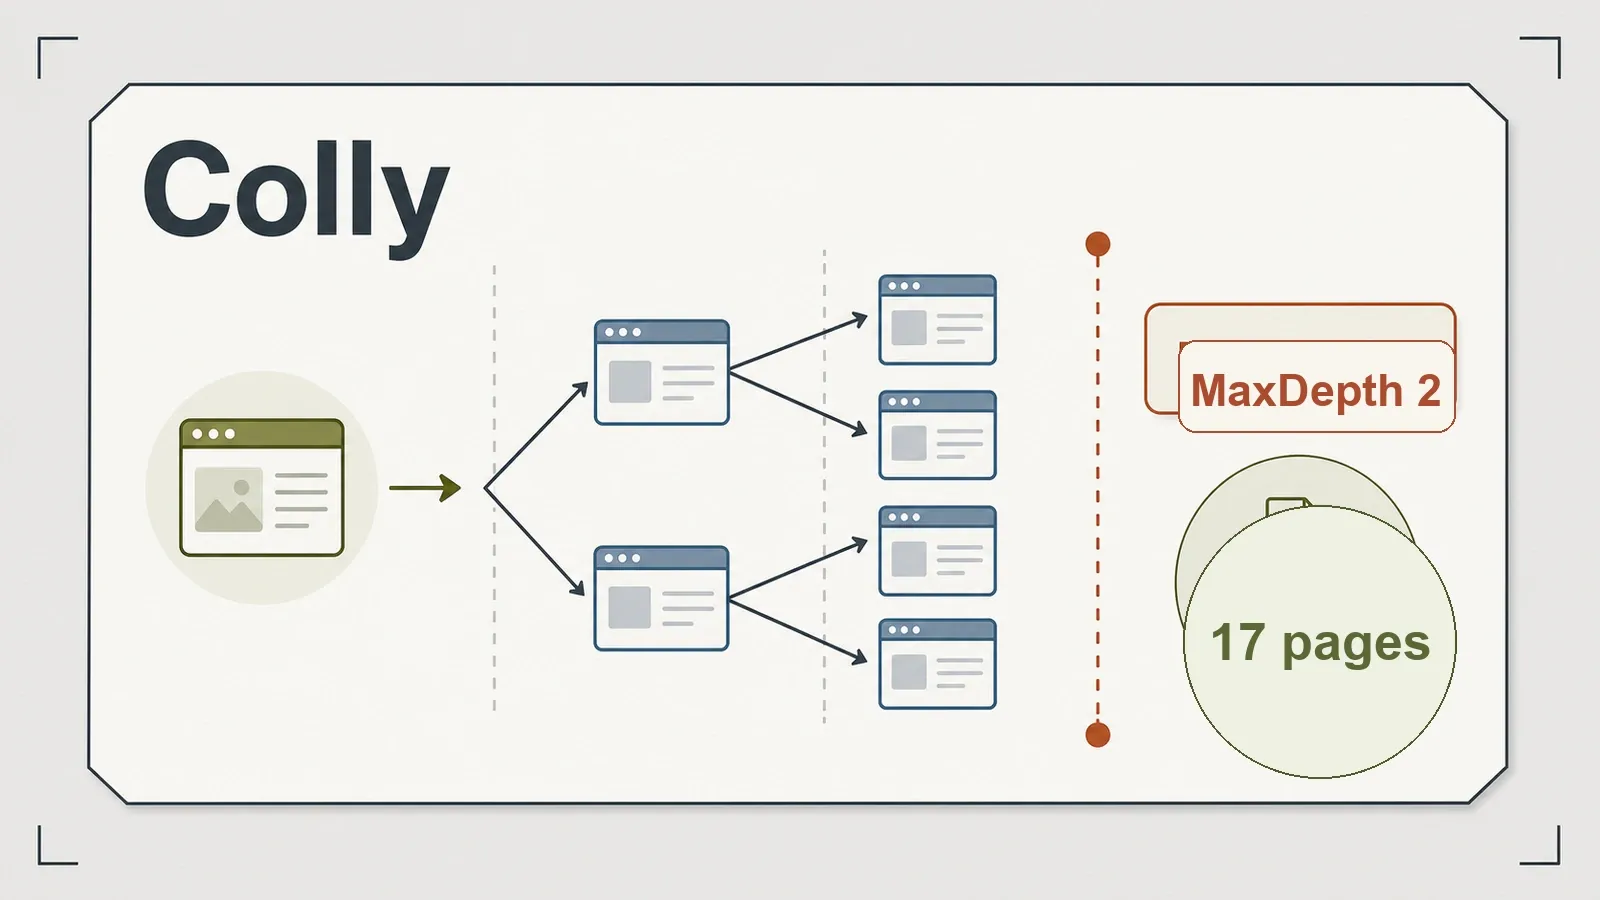
Grafen med 17 URL:er är lika smal. Den bekräftar den mängd sidor som besöktes i just denna fixture, med just denna seed-konvention och MaxDepth(2). Den säger inget om sidor per sekund, rättvisa mellan hosts, minnestillväxt eller beteende vid cykler och dubbletter av URL-former. Sådant kräver separata workload- och queue-tester.
En urvalschecklista förankrad i den här körningen
Börja med att titta på det svar som Colly faktiskt får. Om de nödvändiga fälten finns i HTML som servern returnerar, använd OnHTML och validera fältantal eller obligatoriska nycklar innan du accepterar en post. Om svaret är JSON, hantera kroppen via OnResponse och validera schemat. Om HTML:en bara är ett applikationsskal, undersök om en åtkomlig backing-request innehåller datat innan du lägger till en webbläsare.
| Vad svaret innehåller | Colly-väg | Acceptanskoll |
|---|---|---|
| Obligatoriska fält i HTML som servern returnerar | OnHTML-selektorer | Obligatoriska nycklar och förväntat antal poster |
| Ett direkt anropbart JSON-payload | OnResponse plus JSON-avkodning | Schema- och obligatorisk-fält-validering |
| Ett HTML-skal som backas av en reproducerbar request | Anropa backing-endpoint | Svarskod, schema och fullständighet |
| Data som skapas först efter webbläsarkörning | Lägg till en renderer eller välj en browser crawler | Målspecifik readiness och fullständighet |
När webbläsarkörning behövs bör den behandlas som en egen komponent, inte som något man förväntar sig att en Colly-flagga ska slå på. Webbläsaren måste etablera readiness, exponera det renderade innehållet eller backing-svaren och mata in data i resten av pipelinen. Den här granskningen testade ingen sådan integration.
För driftsättning, dokumentera Go-version, modulversion, build-flaggor, CGO-status, exakt kommando, fixture-seed och repository-commit. De detaljerna saknas i de nuvarande publikationslänkarna och är skillnaden mellan inspekterbara artefakter och reproduktion över tid. För drift, lägg till en felmatris och mät den faktiska arbetslast du bryr dig om innan du kallar systemet snabbt eller pålitligt.
För- och nackdelar
Fördelar:
- Extraherade 12/12 förväntade katalogprodukter och 3/3 förväntade artikelstycken via
OnHTML. - Ren JSON-hantering via
OnResponse, utan DOM-parsning — 8/8 API-poster. - Det testade 500-svaret nådde
OnErrormed statusen exponerad. - Djupbegränsad crawl nådde 17 sidor från en enda collector.
- Kompileras till en Go-exe; målhosten behöver ingen separat installerad Go-runtime för de testade flödena.
- Generös Apache-2.0-licens.
Nackdelar:
- Ingen JavaScript-körning — klientrenderat innehåll ger 0, punkt slut.
- Kräver en Go-toolchain; team som inte använder Go betalar den setup-kostnaden innan de ens skriver någon scraper.
- Den testade modulen (
v2.3.0) ligger före den nyaste GitHub Release-post som observerades (v2.2.0). - Utdatan är din egen kod — Colly ger dig callbacks, inte en inbyggd datafeed-exportör som Scrapy.
- Async-, rate limiting-, proxy- och queue-backends finns, men testades inte här; throughput och skala är därför fortfarande omätta.
Vem den passar för — och vem som bör välja bort den
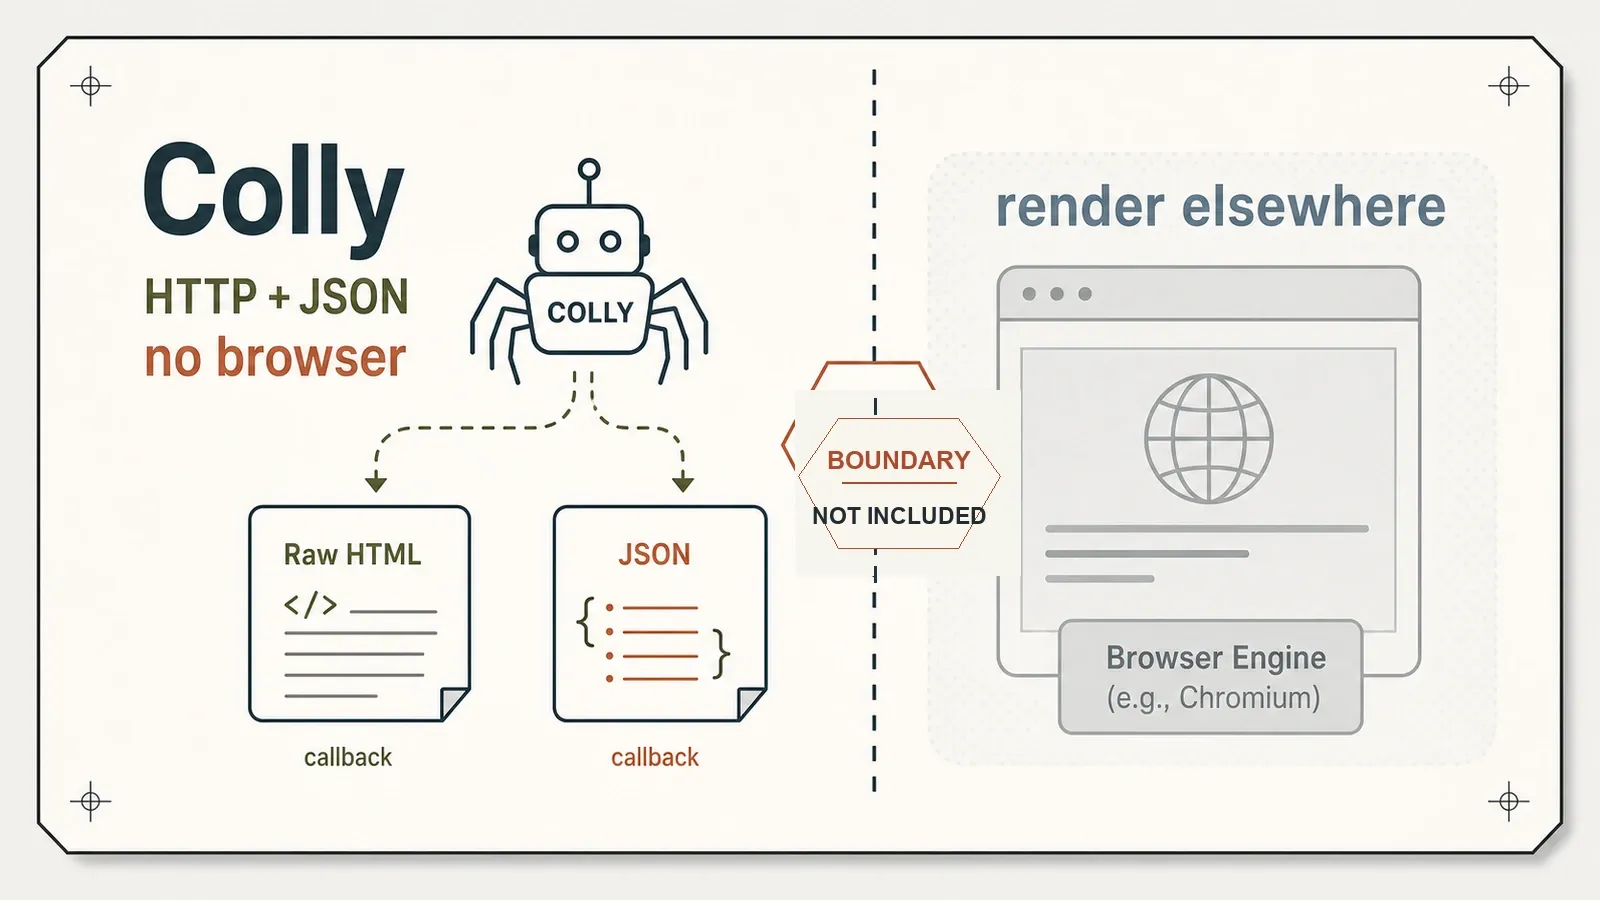
Colly passar om du redan skriver Go och riktar in dig på server-renderad HTML eller direkt åtkomlig JSON. Callback-modellen skiljer på strukturerade matchningar, råa payloads och misslyckade requests. En kompilerad exekverbar fil slipper också en separat installerad språkmiljö på målmaskinen, även om full statisk länkning inte verifierades här.
Lägg till en renderer när de nödvändiga målelementen bara finns efter webbläsarkörning och inget användbart backing-endpoint finns. Ett direkt JSON-endpoint kan fortfarande anropas utan rendering. Colly är också ett svagare val för team som inte vill ha en Go-toolchain eller som vill att en extraheringstjänst ska äga schemabyggande och selector-underhåll.
Alternativ, inklusive var Thunderbit passar in
Colly är öppen källkod som du kör själv. Det finns ingen licenskostnad till en leverantör, men compute, bandbredd, proxies, lagring, observability och utvecklingsinsats betalar du själv. Du äger request-beteende, parse-callbacks, crawl-logik och webbläsarintegration om ett mål kräver rendering.
En hanterad extraktionstjänst flyttar en del av det ansvaret till en leverantör. Vi bygger Thunderbit, men testade inte den mot dessa fixtures, så den här artikeln gör ingen jämförelse vad gäller rendering, anti-bot, kvalitet, latens eller kostnad. Den relevanta skillnaden är ägarskapet: Colly exponerar HTTP-svar och callbacks i din Go-process; en hanterad tjänst kan äga insamling och schematisering mot en avgift per anrop.
Relaterade benchmark-recensioner: den fullständiga jämförelsen av open-source-scrapers, Scrapys Python-crawler-recension och Scraplings granskning av adaptiva selektorer.
Testa Thunderbit för extrahering av webdata
Slutomdöme
Colly är ett starkt alternativ för Go-team som riktar sig mot server-renderad HTML eller direkt JSON och som är beredda att äga sin egen extraheringskod. Fixturesen stödjer extrahering av förväntade poster, en begränsad crawl-trace och en observerad 500-callback — men inte hastighet, skala eller drift utan tillsyn. Browser-renderad DOM kräver en annan väg, såvida inte det underliggande data-endpointet går att anropa direkt.
Testa Thunderbit för extrahering av webdata Get Started Free
Vanliga frågor
Mätte den här granskningen Collys hastighet? Nej. Den mätte extrahering av förväntade poster, direkt JSON-hantering, en fel-callback och täckning av en fixture-baserad crawl-graf. Den mätte inte elapsed time, throughput, samtidighet, CPU, minne eller någon jämförelsebaseline.
Kan Colly skrapa sidor som renderas med JavaScript? Colly kör inte sidans JavaScript. Den testade HTTP-vägen hittade därför inga målelement som bara fanns i den renderade DOM:en. Den kan däremot anropa ett åtkomligt JSON-backing-endpoint direkt, som JSON-fixturen visar. Använd en renderer när körning krävs och ingen reproducerbar backing-request levererar datat.
Måste jag kunna Go för att använda Colly?
Ja. Colly är ett Go-bibliotek, inte ett fristående CLI-verktyg — du importerar det, registrerar callbacks (OnHTML, OnResponse, OnError) och kompilerar. Maskinen jag testade på hade inget Go, så setupen började med att installera en Go-toolchain (1.26.5). Om ditt team inte redan jobbar i Go är just den miljön den verkliga setup-kostnaden.
Varför matchar inte versionen jag installerar Collys senaste GitHub release?
Go-modulen löste till v2.3.0 (december 2025), medan den nyaste GitHub Release-post som observerades var v2.2.0 (mars 2025). Jag testade v2.3.0; det här är en skillnad mellan olika versionsytor, inte bevis på en trasig installation.
Är Colly gratis för kommersiell användning? Ja, den är licensierad under Apache-2.0, vilket är generöst och kommersiellt vänligt. Som alltid bör du kontrollera den aktuella licensen i repo:t innan du bygger vidare på den.
Innan du tar in den i produktion bör du lägga till tester som speglar den faktiska driftsrisken i stället för att bara extrapolera från fixture-resultatet. Tidsätt upprepade crawls mot representativa mål, logga CPU och maxminne, öva retrierbara och terminala fel och verifiera god nätad sed under samtidighet. Om persistence är viktigt, stoppa och återuppta en crawl medan du granskar dubbletthantering och köstatus. Om enkel driftsättning är viktigt, dokumentera exakt compiler- och linker-konfiguration och inspektera den producerade binärens runtime-beroenden. Inget av detta ändrar vad den nuvarande fixturen visade; det avgör om samma bibliotekskonfiguration passar för ett visst produktionsjobb.




