
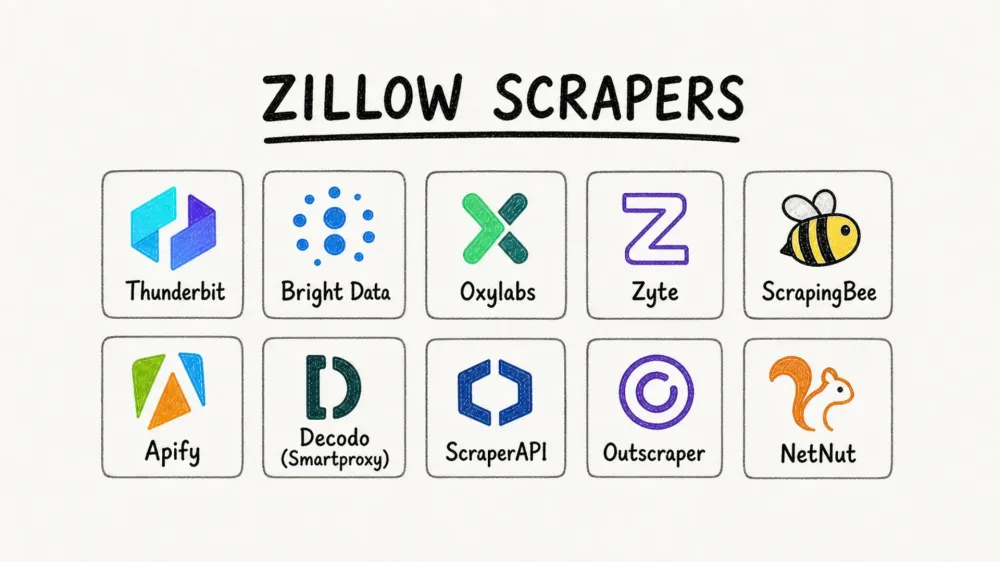
Zillow bevakar omkring 173 miljoner hem i hela USA och lockar i snitt mer än 235 miljoner unika användare per månad.
Det är enorma mängder fastighetsdata samlade på en enda sajt — priser, Zestimates, mäklarkontakter, skattehistorik och områdesstatistik. Problemet? Att faktiskt få ut den datan från Zillow i stor skala är en helt annan femma.
De flesta listor över “bästa Zillow scraper” på nätet skickar dig vidare till API-verktyg och proxy-leverantörer som är byggda för utvecklare. Det funkar förstås fint om du sitter och skriver Python hela dagarna, men utifrån det jag sett när jag arbetat med fastighetsteam, investerare och marknadsförare på Thunderbit, vill många som letar efter Zillow-scrapers egentligen bara få listningsdata in i ett kalkylark — snabbt, utan kod och utan strul.
Så jag har satt ihop den här guiden för att täcka alla tre typerna av Zillow-scrapers: webbläsartillägg för dig som inte vill koda, moln-API:er för utvecklare och proxy-baserad infrastruktur för verksamheter med stora volymer. Jag har också lagt in jämförelser av gratisnivåer, genomgångar av exportflöden och matchning mot olika användningsfall, så att du kan hoppa direkt till verktyget som passar just din situation.
Testa Thunderbit Zillow Scraper
Vad är en Zillow-scraper och vilken data kan du egentligen hämta?
En Zillow-scraper är vilket verktyg som helst som automatiskt samlar in strukturerad fastighetsdata från Zillow — så att du slipper kopiera och klistra in listningsuppgifter en och en i ett kalkylark. Oavsett om du hämtar jämförbara objekt för en investeringsanalys eller bygger en leadlista med FSBO-objekt, tar en scraper hand om det tidskrävande jobbet åt dig.
Här är vad du vanligtvis kan hämta från Zillow-sidor med listningar:
- Listnings- och prisdata: aktuellt pris, slutpris, Zestimate, Rent Zestimate, prishistorik, antal dagar på marknaden
- Fastighetsdetaljer: antal sovrum, badrum, boyta, tomtstorlek, byggår, hustyp, våningar, parkeringsplats, HOA-avgifter
- Platsinformation: fullständig adress, postnummer, områdesnamn
- Listningsmetadata: listningsstatus (till salu, pending, såld), mäklare eller leverantör, listnings-URL
- Media: foton på objektet, beskrivningar
- Historik och ekonomi: försäljningshistorik, skattehistorik, årlig skatt
- Extra funktioner (beroende på verktygets djup): Walk Score, Transit Score, närliggande skolor, restider, tomt-/fastighetsdetaljer
Alla dessa fält är inte lika lätta att få tag på. Rubrikdata som pris, adress och sovrum/badrum går oftast smidigt. Men Zestimates historikdiagram, telefonnummer till mäklare och skattedetaljer laddas ofta dynamiskt eller ligger bakom JavaScript-rendering — och det är just därför valet av scraper-arkitektur spelar roll.
Hur vi utvärderade de bästa Zillow-scrapers
Innan listan, en snabb titt på hur jag jämförde verktygen. De här kriterierna spelar roll eftersom Zillow inte är någon vanlig sajt att skrapa — det är en av de mest skyddade webbplatserna på nätet.
Användarvänlighet: no-code kontra kodkrav
Det finns stor spridning. Vissa verktyg låter dig skrapa Zillow med ett klick direkt i webbläsaren. Andra kräver API-nycklar, Python-skript och proxykonfiguration. Eftersom 75 % av mäklare regelbundet använder pris-historik för jämförbara bostäder och många av dem inte är utvecklare, är enkel användning viktigare än de flesta konkurrentartiklar medger.
Framgångsgrad mot anti-bot-skydd på Zillow
Zillows anti-bot-stack (mer om den nedan) är den vanligaste orsaken till att scrapers misslyckas. Ett billigt verktyg som bara lyckas i 40 % av fallen blir dyrare per post än ett dyrare verktyg som fungerar varje gång.
Prissättningsmodell och kostnad per 1 000 poster
Jag försökte normalisera kostnad per 1 000 poster (CPM) mellan verktygen där det gick. Vissa tar betalt per API-anrop, andra per sida, andra per lyckat resultat. Listpriset kan bli missvisande om du inte tar hänsyn till träffsäkerhet och omkörningar.
Gratisnivå och testmöjlighet
Många vill testa en scraper innan de binder upp sig. Därför har jag lagt in en särskild jämförelse av gratisnivåer längre fram i artikeln — något jag märkt att konkurrenterna sällan bryr sig om.
Exportformat och integrationer
Fastighetsproffs bryr sig om att få in data i kalkylark och CRM-system, inte om att tolka rå JSON. Verktyg som exporterar direkt till Excel, Google Sheets, Airtable eller Notion sparar massor av efterarbete.
Sidnumrering och masshantering
Zillows sökresultat sträcker sig över många sidor. Verktyg som hanterar sidnumrering nativt sparar dig från att bygga egen logik för att bläddra mellan sidor.
Scraper-arkitektur: tillägg kontra API kontra proxy
De flesta artiklar hoppar helt över detta. Vilken typ av scraper du använder — webbläsartillägg, moln-API eller proxyinfrastruktur — förändrar i grunden både upplevelsen, träffsäkerheten och arbetsflödet. Det går vi igenom härnäst.
Tre typer av Zillow-scrapers: vilken passar dig?
När jag först grävde i det här området hittade jag ingen artikel som tydligt förklarade skillnaderna i arkitektur. Varje Zillow-scraper faller egentligen i en av tre kategorier, och rätt val beror på dina tekniska färdigheter, hur mycket data du behöver och hur du vill använda den.
Scrapers som webbläsartillägg (no-code)
Dessa körs i din riktiga Chrome-webbläsare. Du besöker Zillow, klickar på en knapp och tillägget extraherar data från sidan du tittar på. Eftersom de använder din faktiska webbläsarsession — riktiga cookies, riktigt fingeravtryck, riktig inloggningsstatus — kringgår de naturligt mycket av anti-bot-detekteringen utan någon proxykonfiguration.
Bäst för: mäklare, investerare som gör comp-analys, små marknadsteam och alla som snabbt vill ha data i ett kalkylark.
Exempel: Thunderbit (arbetsflöde med 1 klick, Zillow-mall med 1 klick, direkt export till Sheets/Excel).
Moln-API-scrapers (utvecklarvänliga)
Du skickar en URL till en API-slutpunkt och får tillbaka strukturerad JSON eller CSV. De kräver en del teknisk uppsättning — API-nycklar, skript, kanske ett schemaläggningsverktyg — men de skalar bra och passar fint in i återkommande flöden.
Bäst för: PropTech-utvecklare, dataingenjörer och team som bygger SaaS-produkter eller interna datapipelines.
Exempel: Bright Data, Zyte, ScraperAPI, ScrapingBee.
Proxy-baserade scrapers (infrastruktur för stora volymer)
Dessa tillhandahåller IP-rotation och anti-bot-kringgående lager, men du står för själva scraping-logiken. Tänk på dem som rören i väggen, inte kranen.
Bäst för: storskaliga operationer som redan har egen scrapingkod och behöver pålitlig IP-infrastruktur.
Exempel: Oxylabs, Decodo/Smartproxy, NetNut.
Här är ett snabbt beslutsstöd:
- Behöver du bara data snabbt, utan kod? → Webbläsartillägg (Thunderbit)
- Bygger du en produkt eller pipeline? → API-baserat (Bright Data, Zyte, ScraperAPI)
- Behöver du proxy-rotation för stora volymer? → Proxy-först (Oxylabs, Decodo, NetNut)
Bästa Zillow-scrapers i korthet: jämförelse sida vid sida
Innan vi går in på varje verktyg, här är hela jämförelsetabellen. Jag har försökt vara så specifik som möjligt — vaga ja/nej-svar hjälper inte när du väljer verktyg för ett riktigt projekt.
| Verktyg | Typ | No-code? | Gratisnivå | Zillow-mall | Exportalternativ | Sidnumrering | Berikning av undersidor |
|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome-tillägg | ✅ | ✅ (6 sidor gratis) | ✅ (mall med 1 klick) | Excel, Sheets, Airtable, Notion, CSV, JSON | ✅ | ✅ |
| Bright Data | API + datasetmarknadsplats | ⚠️ Delvis | ✅ 5 000 credits/månad | ✅ | JSON, NDJSON, CSV, webhooks, S3, GCS, Snowflake | ✅ | ✅ |
| Oxylabs | API + proxy | ❌ | ⚠️ Testperiod (2 000 resultat) | ⚠️ Delvis (guide, ingen mall) | JSON, CSV via arbetsflöde | ✅ | ✅ |
| Zyte | API + Auto-Extract | ⚠️ Delvis | ✅ (5 USD i kredit) | ❌ | JSON, CSV | ✅ | Delvis |
| ScrapingBee | API | ❌ | ✅ (1 000 credits) | ❌ | JSON, HTML | ✅ | Anpassad |
| Apify | Moln-actors | ⚠️ Delvis | ✅ (5 USD/månad i credits) | ✅ (community actor) | JSON, CSV, XML, Excel, JSONL | ✅ | ✅ |
| Decodo / Smartproxy | API + proxy | ❌ | ✅ (7 dagars test, 1 000 förfrågningar) | ✅ | HTML, JSON, analyserad CSV | ✅ | Delvis |
| ScraperAPI | API + pipeline | ❌ | ⚠️ (7 dagars test) | ✅ | HTML, JSON, CSV, Markdown | ✅ | ✅ |
| Outscraper | Molnbaserad scraper | ⚠️ Delvis | ✅ (gratis före 500 listningar) | ✅ | CSV, Excel, Parquet, JSON | ✅ | Delvis |
| NetNut | Proxy / unblocker | ❌ | ⚠️ Endast testperiod | ❌ | Inget inbyggt | ❌ | ❌ |
Ett mönster sticker ut: Thunderbit är det enda verktyget som kombinerar no-code, en dedikerad Zillow-mall, berikning av undersidor och gratis export till affärsverktyg som Sheets och Airtable. Om du är utvecklare erbjuder Bright Data och ScraperAPI den mest djupgående Zillow-specifika API-täckningen.
1. Thunderbit
 Thunderbit är verktyget mitt team och jag byggde specifikt för människor som vill ha webdata utan att skriva kod. Det är ett AI-drivet Chrome-tillägg som fungerar direkt i webbläsaren — du besöker en sida, klickar på en knapp och får strukturerad data exporterad till ditt favoritverktyg.
Viktiga funktioner för Zillow-skrapning
För Zillow erbjuder Thunderbit en Zillow Scraper-mall med 1 klick som är förbyggd för att direkt extrahera listningsdata. Inga AI-credits krävs för mallbaserad scraping — mallen vet redan vilka fält som ska hämtas (adress, pris, sovrum, badrum, kvadratmeter, mäklarinfo, Zestimate, listnings-URL, bilder och mer).
Om du är på en icke-standardiserad Zillow-sida eller vill ha anpassade fält, sätter Thunderbits AI själv kolumnnamnen, eller så kan du beskriva vilka fält du vill ha i vanliga ord så bygger den utifrån det. Du kan också använda skrapning av undersidor: skrapa en Zillow-sida med sökresultat och skicka sedan data ett steg djupare för att berika varje listning med detaljer som prishistorik, skattehistorik, HOA-avgifter, Walk Score och Transit Score.
Sidnumrering fungerar både för klickbaserade upplägg och oändlig scroll. Det finns också gratis e-post- och telefonextraktorer för att hämta kontaktuppgifter till mäklare utan kostnad, samt en schemalagd scraper som du kan ställa in på vanlig svenska (t.ex. “varje måndag kl. 9”) för löpande prisbevakning.
Export- och integrationsalternativ
Här ligger Thunderbit verkligen före för dig som inte är teknisk. Export till Excel, Google Sheets, Airtable, Notion, CSV eller JSON är helt gratis — ingen betalvägg för export. När du exporterar till Airtable eller Notion visas fastighetsbilder som riktiga bildfält, inte bara URL:er. Det spelar roll om du underhåller en fastighetsdatabas eller delar listningar med kunder.
Pris och gratisnivå
- Gratisnivå: 6 sidor (10 med gratis provperiod), plus helt gratis e-post-/telefon-/bildextraktorer och dataexport
- Kreditsystem: 1 credit = 1 utgående rad; mallskrapning använder inte AI-credits
- Betalda planer börjar runt 15 USD/månad månadsvis eller 9 USD/månad årsvis
- Webbläsarskrapning använder din inloggningssession; molnskrapning hanterar upp till 50 sidor åt gången för offentligt tillgänglig data
Varför den sticker ut
Eftersom Thunderbit körs inne i din riktiga Chrome-webbläsare ärver det dina faktiska cookies, fingeravtryck och inloggade status — vilket naturligt kringgår många av Zillows kontroller utan någon proxykonfiguration. AI:n läser om sidan varje gång, så när Zillow ändrar sitt upplägg (vilket händer ofta) behöver du inte bygga om din scraper. Ett klick: AI:n räknar ut vad som ska hämtas → den kör → klart. Om du hellre vill styra själv kan du bara säga på vanlig svenska vad du behöver. Och det stöder 34 språk, vilket är en trevlig bonus om du jobbar med internationella team.
Bäst för: mäklare, investerare, marknadsteam och alla som vill ha Zillow-data i ett kalkylark utan att röra en API-nyckel.
2. Bright Data
 Bright Data är den största och mest omfattande dataplattformen på listan. Om Thunderbit är fickkniven du tar fram för vardagliga uppgifter, är Bright Data hela verkstaden för företagsteam som bygger produktionspipelines.
Viktiga funktioner för Zillow-skrapning
Bright Data erbjuder en dedikerad Zillow Scraper som en del av sitt bibliotek med 437+ scrapers. Den extraherar stad, delstat, bostadsstatus, rum, byggår, Zestimate, prishistorik, mäklarinfo, bilder och mer. Det finns också en Zillow Dataset — förinsamlade amerikanska fastighetsregister för storskalig historisk analys utan att du själv kör någon scraper.
På infrastruktursidan har Bright Data en dedikerad Zillow CAPTCHA-lösare för PerimeterX-utmaningar, en Scraping Browser (hanterad molnwebbläsare med inbyggd unblockning), 400M+ residential IPs i 195 länder och en MCP Server för AI/LLM-agentflöden.
Pris
- Betalning per lyckat resultat: cirka 1,50 USD per 1 000 lyckade poster för web scrapern
- Dataset-priser från 250 USD per 100K poster, med volymrabatter i skala
- Residential proxies från 8,40 USD/GB
- Gratisnivå med 5 000 credits per månad, inget kreditkort krävs
För- och nackdelar
- Fördelar: högsta oberoende benchmark-träffsäkerheten (rapporterat 98,44 %), integrerat ekosystem med scraper + dataset + proxy + leverans, betalning per lyckat resultat
- Nackdelar: högre startkostnad för små projekt, mängden produktalternativ kan vara överväldigande för nybörjare, inte byggt för icke-tekniska kalkylarksanvändare
Bäst för: enterprise-datateam, PropTech-bolag och alla som bygger en storskalig Zillow-datapipeline.
3. Oxylabs
 Oxylabs är en enterprise-klassad leverantör av proxy- och scraping-API:er. Den har ingen publik Zillow-mallsida för konsumenter, men den har en detaljerad guide för Zillow-scraping byggd på Web Scraper API.
Viktiga funktioner
- Web Scraper API med rotation av residential proxies
- 100M+ residential proxies
- JavaScript-rendering för Zillows dynamiska sidor
- Dedikerad account management för företagskunder
- Dokumenterad extraktion av Zillow-fält: adress, priser, foton, sovrum/badrum/kvadratmeter, listad av, tid på Zillow, visningar/sparningar, uppskattat marknadsvärde, prishistorik, offentlig skattehistorik
Pris och åtkomst
- Gratis test upp till 2 000 resultat på Web Scraper API
- Planer från cirka 49 USD/månad
- Generiska mål av typen “Other” från cirka 1,50 USD per 1 000 resultat; JS-renderade från cirka 3,50 USD
- Utdata: JSON, CSV via klientarbetsflöde
För- och nackdelar
- Fördelar: mycket hög träffsäkerhet i oberoende tester, support i enterprise-klass, enorm proxy-pool
- Nackdelar: kod krävs, ingen Zillow-specifik mall i gränssnittet, inte lämplig för icke-tekniska användare
Bäst för: enterprise-utvecklingsteam som behöver robust proxyinfrastruktur och hög tillförlitlighet för Zillow-data.
4. Zyte
 Zyte grundades av skaparna av Scrapy, så om ditt team redan lever i Scrapy-ekosystemet är Zyte ett naturligt val. Dess API erbjuder AI-driven automatisk extraktion som kan tolka strukturerad data från webbsidor utan anpassade selektorer.
Viktiga funktioner
- Zyte API med automatisk extraktion (AI-driven)
- Smart proxy-rotation och anti-bot-hantering
- Djup integration med Scrapy
- Snabba svarstider i oberoende benchmarktester
- Stöd för datatypen fastigheter med priser, objektspecifikationer, beskrivningar, bilder, plats och tillgänglighet
Pris och gratisnivå
- 5 USD i gratis kredit i 30 dagar
- Förbrukningsbaserad prissättning; konkurrenskraftig CPM i tester
- Ingen dedikerad Zillow-mall — använder generell auto-extraktion
För- och nackdelar
- Fördelar: mycket snabba svarstider, stark integration med Scrapy-ekosystemet, AI-driven extraktion minskar underhåll av selektorer
- Nackdelar: endast delvis no-code-stöd, ingen Zillow-specifik mall, endast JSON-utdata, kräver teknisk uppsättning
Bäst för: tekniska team som redan använder Scrapy eller behöver AI-driven auto-extraktion för långsiktiga Zillow-pipelines.
5. ScrapingBee
 ScrapingBee är ett av de enklaste scraping-API:erna som finns. Skicka en URL och få tillbaka renderad HTML eller JSON. Det är inte Zillow-specifikt, men hanterar JavaScript-rendering och proxyrotation direkt från start.
Viktiga funktioner
- Enkel REST API: en request, renderad output
- JavaScript-rendering ingår
- Inbyggd proxyrotation och anti-bot-hantering
- Rak och tydlig dokumentation — jag tyckte att uppsättningen gick snabbast bland API-verktygen
Pris och gratisnivå
- 1 000 gratis API-credits vid registrering (räcker för ungefär 50–100 Zillow-sidor beroende på omkörningar)
- Betalda planer börjar på 49 USD/månad
För- och nackdelar
- Fördelar: generös gratisnivå, enkel API-design, bra dokumentation, pålitlig för prototyper
- Nackdelar: kod krävs, ingen Zillow-mall, utdata är JSON/HTML (du behöver själv tolka den), ingen berikning av undersidor, ingen inbyggd export till kalkylark
Bäst för: utvecklare som vill prototypa en Zillow-scraping-pipeline snabbt utan tung infrastruktur.
6. Apify
 Apify är en molnplattform med en marknadsplats för färdiga scraping-"actors". För Zillow finns flera community-byggda actors — Search Scraper, Detail Scraper, API Scraper, ZIP Code Scraper — som du kan köra utan att skriva egen extraktionslogik.
Viktiga funktioner
- 4+ community-byggda Zillow actors med dokumenterad fält-täckning: zpid, status, pris, Zestimate, Rent Zestimate, sovrum, badrum, kvadratmeter, tomtstorlek, byggår, fastighetstyp, HOA-avgift, pris per kvadratmeter, dagar på Zillow, adress, mäklare, agent, telefon, beskrivning, foton, prishistorik, skattehistorik, skolor, egenskaper
- Inbyggd schemaläggning, proxyrotation och sidnumrering
- Tvåstegsmodell: Search Actor samlar in URL:er, Detail Actor berikar varje listning
- Utdata i JSON, CSV, XML, Excel eller JSONL
Pris och gratisnivå
- $5 i gratis månadskrediter på plattformens gratisplan
- Betalda planer från 29 USD/månad; pay-as-you-go till 0,25 USD per Compute Unit
För- och nackdelar
- Fördelar: Zillow-actors byggda för ändamålet med bra fältdjup, schemaläggning inbyggd, delvis no-code via plattformens UI
- Nackdelar: community-actors kan bli föråldrade om Zillow ändrar layout, berikning av undersidor beror på actor-kvalitet, brantare inlärningskurva än ett webbläsartillägg
Bäst för: användare som är bekväma med ett moln-UI och vill ha färdiga Zillow-flöden med schemaläggning.
7. Decodo (Smartproxy)
 Decodo (tidigare Smartproxy) erbjuder en dedikerad Zillow Scraper API-sida — vilket är mer än de flesta proxy-leverantörer kan säga. Den kombinerar scraping-API-funktionalitet med rotation av residential proxies och har visat nästan perfekt träffsäkerhet på Zillow i Proxyways benchmark 2025.
Viktiga funktioner
- Dedikerad Zillow Scraper API med målspecifik positionering
- Dokumenterade Zillow-fält: prisdata, fastighetsdetaljer, hyreslistningar, platsdata, närliggande objekt, listningsstatus, skatt, mäklarinfo, fakta och funktioner
- Stöd för JavaScript-rendering
- Rotation av residential proxies
Pris och åtkomst
- 7 dagars gratis test med 1 000 förfrågningar
- Betalda nivåer från 9, 49, 99 USD och anpassade lösningar
- Utdata: HTML, JSON, parserad CSV i vissa lägen
För- och nackdelar
- Fördelar: stark Zillow-specifik dokumentation, konkurrenskraftig prissättning, hög benchmark-träffsäkerhet på Zillow (rapporterat 99,98 % i Proxyway-test)
- Nackdelar: kod krävs, inget no-code-alternativ, begränsad berikning av undersidor, ingen inbyggd export till kalkylark
Bäst för: utvecklare som vill ha ett hanterat API med stark anti-bot-hantering till konkurrenskraftigt pris och tydligt Zillow-fokus.
8. ScraperAPI
 ScraperAPI har en av de tydligaste Zillow-sidorna bland API-verktygen. Den dokumenterar extraktion av fastighetspriser, adresser, foton, Zestimate, kvadratmeter, HOA, visningar/sparningar, tidpunkt för listningsuppdatering, listningsleverantör, restider, fakta och funktioner, årlig skatt, datum på marknaden och tomt-/fastighetsdetaljer.
Viktiga funktioner
- Dedikerad Zillow Scraper API-sida med djup fält-dokumentation
- API-integration med en rad kod
- Automatisk proxyrotation och anti-bot-hantering
- JavaScript-rendering
- DataPipeline-produkt för schemaläggning (inklusive varje timme via cron)
- Utdata: HTML, JSON, CSV, Markdown, text
Pris och gratisnivå
- 7 dagars gratis test
- Betalda planer från 49 USD/månad (från Hobby-planen och uppåt)
För- och nackdelar
- Fördelar: en av de starkaste dokumenterade historierna för Zillow-berikning, bra pipelineverktyg för återkommande jobb, tydlig dokumentation på fältnivå
- Nackdelar: kod krävs, inget no-code-alternativ, API-först-utdata kräver tolkning för användning i kalkylark
Bäst för: utvecklare som bygger produktionspipelines för Zillow-data och vill ha detaljerad fältextraktion och schemaläggning.
9. Outscraper
 Outscraper är en molnbaserad scraping-tjänst med en dedikerad Zillow Search Scraper-sida. Det är ett av de enklare alternativen för användare som bara behöver hämta Zillow-data ibland utan tung uppsättning.
Viktiga funktioner
- Molnbaserat gränssnitt med Zillow-fokuserad scraping
- Strukturerad output: listningar, priser, adresser, beskrivningar, foton
- Export till CSV, Excel, Parquet, JSON
- Delvis no-code-upplevelse via webbpanel
Pris och gratisnivå
- Gratis före 500 listningar
- Cirka 2 USD per 1 000 poster efter 500 listningar
- Företagsnivå cirka 1 USD per 1 000 efter 5 000 listningar
För- och nackdelar
- Fördelar: Zillow-fokuserat, delvis no-code-upplevelse, flera exportformat, mycket prisvärt i skala
- Nackdelar: liten gratiskvot, ingen berikning av undersidor, lättare dokumentation än ledarna, begränsade integrationsmöjligheter jämfört med Thunderbit
Bäst för: engångshämtningar eller sporadiska Zillow-uttag med begränsad budget.
10. NetNut
 NetNut är i första hand en leverantör av proxy och website-unblocker. Den har ingen dedikerad Zillow-mall eller endpoint — bara en bloggguide om hur du bygger en Zillow-scraper själv med deras proxyinfrastruktur.
Viktiga funktioner
- Stort nätverk av residential- och ISP-proxies
- Snabba svarstider i benchmarktester
- Website Unblocker-produkt för att kringgå anti-bot-skydd
- API-åtkomst för integration med egna scraping-skript
Pris och åtkomst
- Ingen publik gratisnivå; testperiod finns via formulär
- Website Unblocker börjar på 99 USD/månad
- Ingen Zillow-mall — kräver egen scraping-setup
- Utdata: inget inbyggt (du hanterar det själv)
För- och nackdelar
- Fördelar: snabb proxyinfrastruktur, starkt nätverk för högvolymsanvändning
- Nackdelar: kod krävs, inget no-code-alternativ, ingen Zillow-mall, ingen inbyggd export, ingen berikning av undersidor — det är infrastruktur, inte en färdig scraper
Bäst för: team som redan har egen scrapinglogik och behöver pålitlig proxy-/unblocker-infrastruktur för storskalig Zillow-datainsamling.
Zillows anti-bot-försvar: varför ditt val av scraper spelar roll
Det här förtjänar ett eget avsnitt eftersom det är den vanligaste frustrationen jag hör från folk som försöker skrapa Zillow. Om du förstår varför scrapers misslyckas, väljer du rätt verktyg snabbare.
Vad Zillows anti-bot-stack faktiskt gör
ScrapeOps bedömer Zillow till 8/10 i svårighetsgrad för scraping. Det är inget skrivfel. Zillow använder PerimeterX (nu HUMAN Security) tillsammans med Cloudflare-skydd och AWS WAF Captcha. De systemen:
- Fingeravtryck av webbläsarbeteende (musrörelser, renderingsmönster, JavaScript-körning)
- Upptäcker automationsmönster (headless-webbläsare, snabba upprepade förfrågningar)
- Blockerar datacenter-IP-adresser direkt
- Använder obfuskerade CSS-selektorer — autogenererade klassnamn som ändras ofta och gör DOM-baserade scrapers sköra
Om du någon gång fått ett 403-fel eller en CAPTCHA av typen “press and hold” när du försökt skrapa Zillow, så är det PerimeterX som slår till.
Hur olika scraper-typer hanterar anti-bot
Webbläsartillägg (som Thunderbit) körs i användarens riktiga Chrome-session. De ärver riktiga cookies, riktiga fingeravtryck och inloggad status — vilket naturligt kringgår många fingeravtryckskontroller utan någon proxykonfiguration. Thunderbit erbjuder också molnskrapning med inbyggd anti-bot-hantering för offentligt tillgängliga sidor.
API- och proxyverktyg hanterar anti-bot via roterande residential proxies, server-side webbläsarrendering och retry-logik. De är effektiva men kräver konfiguration — och du betalar för den infrastrukturen.
Egenhändiga Python-skript (med BeautifulSoup, Selenium osv.) kräver manuell proxyrotation, header-hantering och konstant underhåll när Zillow uppdaterar sitt skydd. Forumanvändare rapporterar konsekvent att dessa går sönder ofta: “Scraping projects need to be on constant maintenance due to changes.”
Det är därför arkitektur inte bara är en teknisk detalj — den avgör direkt om din scraper faktiskt fungerar på Zillow.
Gratisnivåduellen: skrapa Zillow på en budget på 0 kr
Jag hittade ingen konkurrerande artikel som går igenom gratisalternativ på riktigt djup — vilket är en miss, eftersom många vill testa innan de betalar. Här är vad du faktiskt kan göra gratis:
| Verktyg | Gratisutrymme | Zillow-specifikt? | Tillräckligt för ett test? |
|---|---|---|---|
| Thunderbit | 6 sidor (10 med provperiod) + gratis export + gratis e-post-/telefonextraktorer | ✅ Zillow-mall ingår | ✅ Räcker för 1–2 områden |
| ScrapingBee | 1 000 API-credits | ❌ Generiskt | ⚠️ Cirka 50–100 sidor beroende på omkörningar |
| ScraperAPI | 7 dagars test | ❌ Generiskt | ✅ Bra testvolym |
| Apify | 5 USD i månadskrediter | ⚠️ Community-byggd Zillow actor | ⚠️ Actor kan vara föråldrad |
| Zyte | 5 USD i kredit i 30 dagar | ❌ Generiskt | ⚠️ Kräver uppsättning |
| Outscraper | Gratis före 500 listningar | ✅ Zillow-fokuserat | ✅ Bra för små tester |
| Decodo | 7 dagars test, 1 000 förfrågningar | ✅ Zillow API | ✅ Bra testvolym |
| Bright Data | 5 000 gratis credits/månad | ✅ Zillow-scraper | ✅ Återkommande månadsutrymme |
| Oxylabs | Test upp till 2 000 resultat | ⚠️ Delvis | ⚠️ Endast testperiod |
| NetNut | Test via formulär | ❌ | ⚠️ Endast infrastruktur |
En sak värd att lyfta fram: Thunderbits gratis dataexport (Excel, Google Sheets, Airtable, Notion, CSV, JSON) är helt gratis utan betalvägg. De flesta API-verktyg kräver att du bygger din egen exportpipeline även på deras gratisnivåer.
Om du bara vill testa att skrapa ett eller två områden för att se om ett verktyg fungerar i ditt arbetsflöde, är Thunderbits gratisnivå och Outscrapers modell gratis före 500 det mest praktiska stället att börja för dig som inte vill koda. För utvecklare ger ScrapingBees 1 000 credits och Decodos 7-dagars test tillräckligt med utrymme för prototyper.
Från skrapning till kalkylark: exportflöden som faktiskt betyder något
Jag återkommer hela tiden till det här eftersom det är glappet jag ser oftast. Ingen vaknar och tänker “jag vill skrapa Zillow.” Folk vill ha Zillow-data i sitt kalkylark, CRM eller sin fastighetsdatabas så att de kan fatta beslut. Scraping är bara medlet.
Vilka exportformat varje verktyg stöder
De flesta API-verktyg matar ut rå JSON. Det är okej för utvecklare, men för en mäklare som behöver en comp-analys i Google Sheets betyder rå JSON extra steg — att skriva en parser, använda Zapier eller formatera om data manuellt. Jämförelsetabellen ovan visar hela bilden, men kortversionen är:
- Thunderbit: direkt export till Excel, Google Sheets, Airtable, Notion, CSV, JSON — helt gratis
- Apify: JSON, CSV, XML, Excel, JSONL
- Outscraper: CSV, Excel, Parquet, JSON
- Alla andra: främst JSON/HTML via API, vilket kräver extra skript för att få fram ett användbart format
Så får du Zillow-data in i Google Sheets eller Excel med Thunderbit
Arbetsflödet är verkligen enkelt: skrapa en Zillow-sida med sökresultat → klicka på exportknappen → välj Google Sheets eller Excel → klart. Ingen tolkning, inget Zapier, inga extra verktyg. Om du exporterar till Airtable eller Notion visas fastighetsbilder som riktiga bildfält — inte bara URL-strängar — vilket är användbart om du underhåller en visuell fastighetsdatabas.
Varför det här betyder mer än du tror
För team som underhåller fastighetsdatabaser, kör CRM-importer eller bygger kalkylark för marknadsanalys är “sista milen” från skrapning till användbar data där de flesta verktyg brister. Ett verktyg som matar ut ren, strukturerad data direkt i dina affärsverktyg sparar timmar av efterarbete per projekt. Enligt min erfarenhet är det skillnaden mellan en scraper som används en gång och en som blir en del av teamets dagliga arbetsflöde.
Vilken Zillow-scraper passar DITT arbetsflöde? Rekommendationer efter användningsfall
Om du inte vill läsa alla tio posterna, här är genvägen baserad på vad du faktiskt försöker göra.
Mäklare: leadgenerering och kontaktutdrag
Du behöver FSBO- eller expired-listningars kontaktuppgifter, telefonnummer, e-postadresser och grundläggande fastighetsdetaljer — exporterade till ett kalkylark eller CRM.
Bästa val: Thunderbit. Kombinationen av en Zillow-mall med 1 klick, gratis e-post-/telefonextraktorer och direkt export till Google Sheets är byggd för just det här scenariot.
Fastighetsinvesterare: affärsanalys, comps och objektdetaljer
Du behöver massdata om fastigheter plus prishistorik, skattehistorik och berikade fält från detaljsidor för ARV-analys eller kassaflödesmodellering.
Bästa val: Thunderbit (skrapning av undersidor för berikade objektsdetaljer) för mindre batcher, eller Bright Data (dataset med 173M+ poster) för stora historiska analyser eller analys över flera marknader.
Marknadsteam: marknadsrapporter och konkurrensbilder
Du behöver ögonblicksbilder av listningar över postnummerområden, schemalagda hämtningar för löpande övervakning och export till Sheets för kundrapporter.
Bästa val: Thunderbit (schemalagd scraper + export till Google Sheets) för team som vill ha ett no-code-flöde. Apify är ett bra alternativ om ditt team trivs med en molnplattform och vill ha actor-baserad schemaläggning.
PropTech-utvecklare: bygga en SaaS-produkt eller datapipeline
Du behöver API-åtkomst i hög volym, stabil upptid, strukturerade JSON-svar och stark anti-bot-infrastruktur.
Bästa val: Bright Data, Oxylabs, ScraperAPI eller Zyte — alla erbjuder stark API-infrastruktur med Zillow-specifik dokumentation eller slutpunkter.
Avslutning: så väljer du den bästa Zillow-scraper för dina behov
Den “bästa” Zillow-scraper beror helt på din tekniska nivå, din budget och vad du vill uppnå.
Om du är en icke-teknisk användare som vill få Zillow-data snabbt in i ett kalkylark är Thunderbit det självklara valet. Det är det enda verktyget på listan som kombinerar no-code, en dedikerad Zillow-mall, berikning av undersidor, gratis export till affärsverktyg och en webbläsarbaserad arkitektur som naturligt hanterar Zillows anti-bot-skydd. Du kan testa Thunderbits gratis Zillow-scraper-mall och se själv — inget kreditkort, ingen API-nyckel, ingen kod.
Om du är utvecklare och bygger produktionspipelines erbjuder Bright Data, Oxylabs och Zyte den mest robusta infrastrukturen. ScraperAPI och Decodo är starka mellannivåalternativ med tydligt Zillow-stöd.
Om du är prismedveten och vill testa innan du binder upp dig, börja med gratisnivåerna från Thunderbit, Outscraper eller ScrapingBee.
Och om du behöver proxyinfrastruktur för stora volymer, erbjuder Decodo och NetNut starka rörledningar — du behöver bara ta med din egen scrapinglogik.
Oavsett vad du väljer är fastighetsdatamarknaden 2026 för snabb för manuell copy-paste. Välj ett verktyg, testa det på ett eller två områden och gå tillbaka till det som faktiskt spelar roll — att analysera affärer, stänga kunder och fatta smartare beslut.
Testa Thunderbit Zillow Scraper Get Started Free
Vanliga frågor
Är det lagligt att skrapa Zillow?
Zillow visar offentligt en stor mängd fastighetsinformation, men dess användarvillkor begränsar uttryckligen automatiserad scraping, robotar och kringgående av CAPTCHA. Den juridiska bilden kring scraping av offentligt tillgänglig data förändras fortfarande. För kommersiell eller storskalig användning är det värt att granska Zillows villkor och rådgöra med jurist. Den här artikeln handlar om verktyg och teknik, inte juridisk rådgivning.
Kan jag skrapa Zillow utan att koda?
Ja. Webbläsartillägg som Thunderbit möjliggör scraping med 1 klick med förbyggda Zillow-mallar. Inga API-nycklar, ingen kod, ingen utvecklare behövs. Du besöker en Zillow-sida, klickar en gång, låter AI läsa sidan och välja data, eller beskriver bara vad du vill ha med egna ord, och exporterar direkt till Excel eller Google Sheets.
Hur många Zillow-listningar kan jag skrapa gratis?
Det beror på verktyget. Thunderbit erbjuder 6 sidor gratis (10 med provperiod) plus helt gratis export. Outscraper är gratis före 500 listningar. ScrapingBee ger 1 000 gratis API-credits. Apify erbjuder 5 USD i månadscredits gratis. Decodo har en 7-dagars testperiod med 1 000 förfrågningar. För de flesta användare räcker Thunderbits gratisnivå för att testa på ett eller två områden.
Vilken är den bästa Zillow-scraper för mäklare?
Thunderbit — det kombinerar en Zillow-mall med 1 klick, gratis extraktorer för e-post och telefon, direkt export till Google Sheets, schemalagd scraping och ett no-code-gränssnitt byggt för icke-tekniska användare. Du behöver inte konfigurera API:er, hantera proxies eller skriva någon kod.
Varför blir Zillow-scrapers blockerade?
Zillow använder PerimeterX (HUMAN Security) och Cloudflare för att upptäcka automatiska förfrågningar. De systemen fingerprintar webbläsarbeteende, blockerar datacenter-IP:er och använder dynamiska CSS-selektorer som bryter DOM-baserade scrapers. Verktyg som använder datacenter-IP:er eller saknar hantering av webbläsarfingeravtryck blockeras snabbt. Webbläsartillägg och verktyg baserade på residential proxies klarar sig bättre eftersom de efterliknar verkligt användarbeteende mer exakt.
Läs mer



