
Om du jämför web scraping-lösningar 2026 är den verkliga frågan oftast inte "vilken produkt har flest funktioner?" utan "vilket alternativ tar mitt team från en stökig webbplats till användbar data med minst friktion?"
Det valet brukar snabbt delas upp när man tittar på det faktiska jobbet. Säljavdelningar och driftteam vill oftast ha extrahering direkt i webbläsaren och smidiga exportmöjligheter. Analytiker vill ha upprepningsbara no-code-flöden. Tekniska team bryr sig mer om API:er, anti-bot-hantering och om de själva ska äga hela crawler-stacken.
Det här är 2026 års upplaga av vår årliga kortlista, nedbantad från den bredare lista med 15 verktyg som vi tog fram 2025. Jag gick igenom officiella produktsidor, prissignaler och aktuell positionering för verktygen nedan i augusti 2026, och höll sedan listan fokuserad på de tio alternativ som fortfarande är relevanta för verkliga affärs- och utvecklarflöden.
Snabba val per arbetsflöde
- Behöver du snabbaste vägen från webbplats till kalkylark? Börja med Thunderbit.
- Behöver du återkommande no-code-övervakning eller körningar i molnet? Kortlista Browse AI, Octoparse och ParseHub.
- Behöver du plattformsflexibilitet eller scraping-infrastruktur? Titta närmare på Apify, Bright Data, Oxylabs och ScrapingBee.
- Behöver du fullt kodägarskap? Scrapy och Playwright hör hemma högst upp på utvecklarnas kortlista.
Testa en Web Scraper på en live-sida Ingen installation och inga selectors — peka AI:n mot en sida och få en strukturerad tabell med 1 klick. Get Started Free
Varför web scraping-lösningar fortfarande är viktiga för affärsteam
De flesta team behöver inte "web scraping" som ett tekniskt fritidsintresse. De behöver strukturerad data från publika sidor för leadgenerering, prisbevakning, marknadsplatsanalys, rekrytering, innehållsarbete eller bevakning av konkurrenter. Problemet är att rådata från webbplatser fortfarande ofta kommer i format som är långsamma att återanvända manuellt.
Därför konkurrerar de bästa verktygen numera på hur väl de passar arbetsflödet, inte bara på extraktionskraft. De viktiga frågorna är om verktyget klarar paginering, undersidor och dynamiska sidor, om det exporterar snyggt till Sheets eller interna system, och hur mycket underhåll teamet måste ta på sig efter uppsättning.
Om du vill se ett snabbt exempel på hur ett browser-first-flöde för extraktion ser ut på en live-sida med sökresultat, är den här aktuella Browse AI-videon en bra första referens:
Så valde vi ut de bästa web scraping-lösningarna
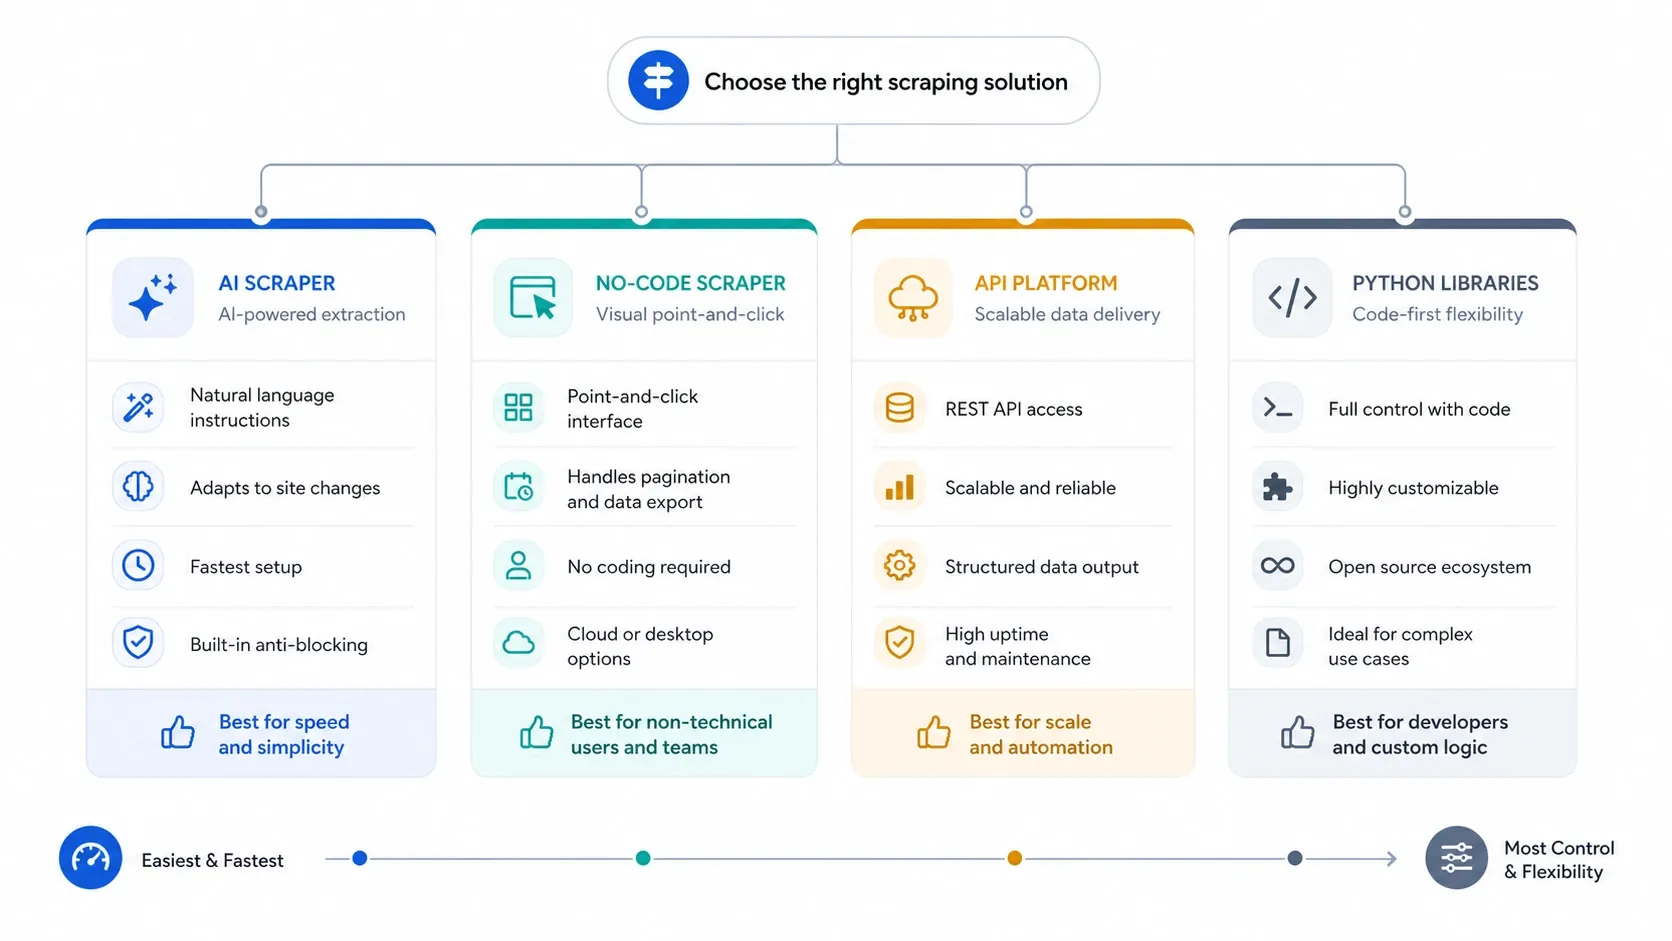
Det här är en årlig kortlistasida, inte ett lager av alla produkter som fortfarande har en startsida. Jag prioriterade verktyg som fortfarande visar tydlig produktutveckling 2026 och som passar minst en av fyra verkliga driftsmodeller:
- AI-först för affärsscraping: snabbaste uppsättning, minst friktion, resultat som är redo för kalkylark.
- Upprepningsbar no-code-scraping: visuella flöden, schemaläggning och mer explicit kontroll över extraktionen.
- Skalbar plattform och API: körning i molnet, unblock-infrastruktur och programmerbar åtkomst.
- Utvecklarägda pipelines: open-source-ramverk och webbläsarautomation för team som vill ha full kontroll.
Bedömningskriterierna var enkla:
- Tid till första användbara scraping-körning: hur snabbt en verklig användare kan nå exportbar data.
- Underhållsbehov: om lösningen förblir praktisk när sidor eller arbetsflöden ändras.
- Skalbarhet: om produkten fortfarande är rimlig efter den första lyckade körningen.
- Prisklarhet: om det finns en användbar gratisplan, en självbetjäningsnivå eller åtminstone en tydlig enterprise-modell.
- Teamfokus: om verktyget faktiskt matchar köparens arbetssätt.
Snabb jämförelsetabell: bästa web scraping-lösningarna 2026
Prissignalerna nedan kontrollerades mot aktuella officiella produkt-, pris- eller supportsidor i augusti 2026.
| Verktyg | Prissignal | Kärnmodell | Bäst för |
|---|---|---|---|
| Thunderbit | Gratisplan; Starter från $15/månad; Pro från $38/månad; företagsprissättning | AI-web scraper och verktyg för webbläsarflöden | Sälj-, drift-, e-handels- och researchteam som vill komma igång snabbast möjligt |
| Browse AI | Gratisplan; Personal från $19/månad vid årsbetalning; Professional från $69/månad vid årsbetalning; Premium från $500/månad vid årsbetalning | AI-plattform för no-code-robotar | Övervakning, förändringsdetektering och återkommande affärsscraping |
| Octoparse | Gratisplan; Standard från $69/månad; Professional från $249/månad | Visuell no-code scraper med molnkörning | Analytiker och operativa team med större återkommande jobb |
| ParseHub | Gratisplan; betalplaner från $189/månad | Visuell desktop-scraper för dynamiska webbplatser | Användare som vill ha mer kontroll utan att skriva kod |
| Apify | Gratisplan; Starter från $29/månad; Scale från $199/månad; Business från $999/månad | Molnplattform för actors och scraping-infrastruktur | Hybridteam som behöver både färdiga verktyg och egna flöden |
| Bright Data | Användningsbaserad och produktbaserad prissättning för scraper API:er, proxies och datatjänster | Enterprise-stack för datainsamling | Storskaliga, compliance-medvetna dataprogram för publika webbdata |
| Oxylabs | Web Scraper API från $49/månad; övriga proxy- och unblocker-priser varierar per produkt | Infrastruktur för proxies och scraper API:er | Team som köper tillförlitlighet och unblock-förmåga som infrastruktur |
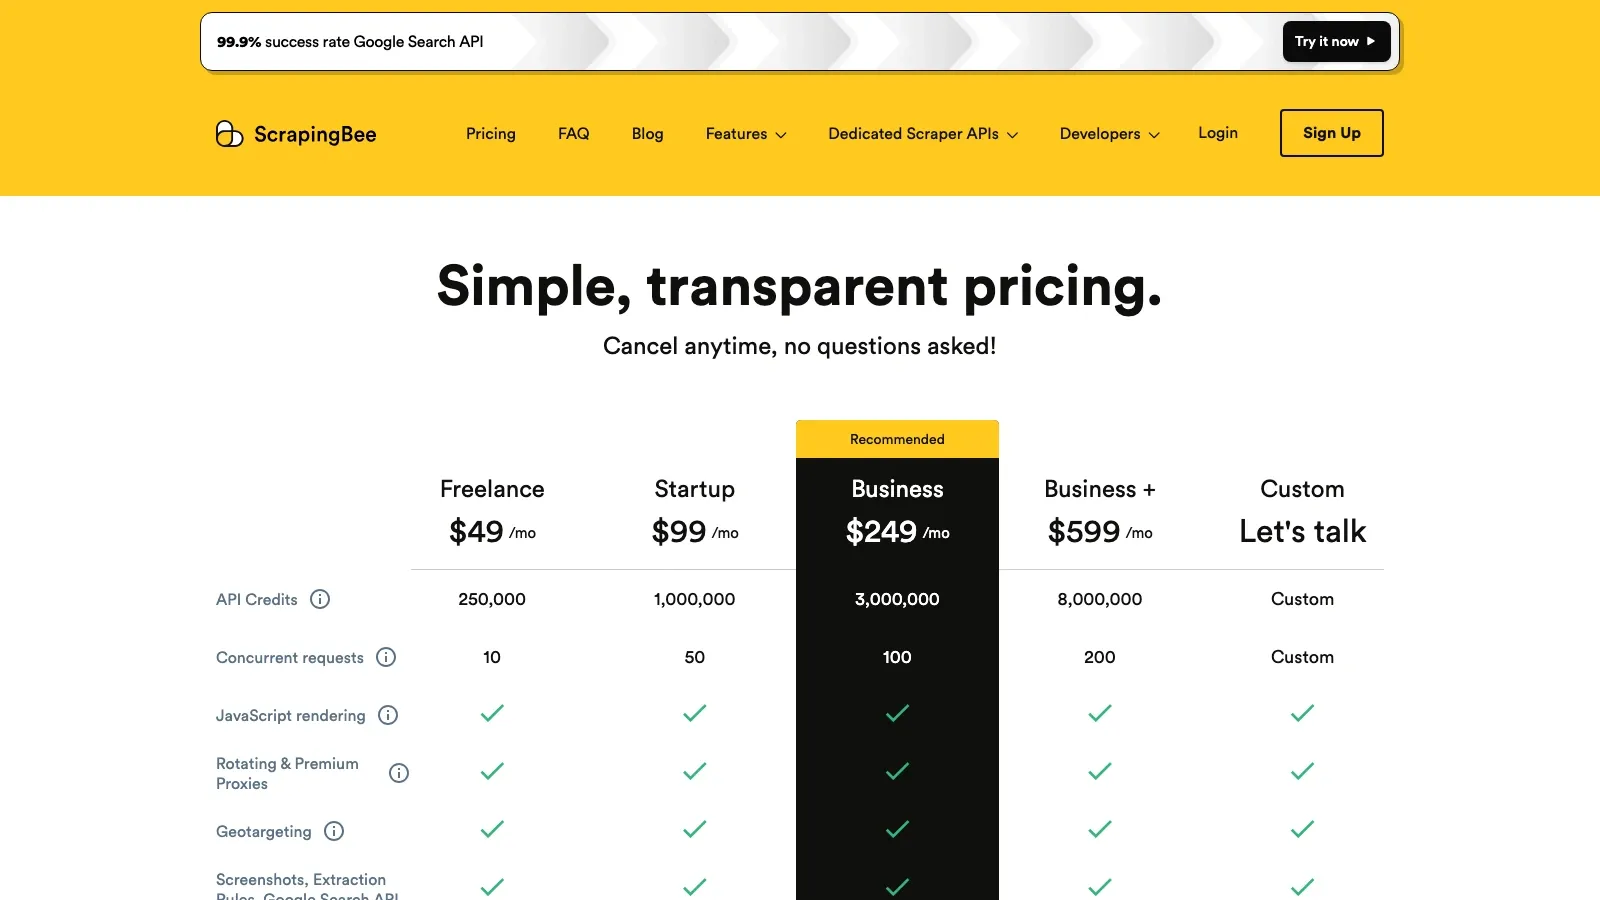
| ScrapingBee | Freelance från $49/månad; Startup från $99/månad; Business från $249/månad | Scraping API med fokus på rendering | Utvecklare som skrapar JavaScript-tunga sajter utan att drifta egen webbläsarflotta |
| Scrapy | Gratis och open-source | Python-ramverk för crawling | Utvecklingsteam som bygger egna scraping-pipelines |
| Playwright | Gratis och open-source | Modernt bibliotek för webbläsarautomation | Team som vill ha skriptstyrning i Chromium, Firefox och WebKit |
De 10 bästa web scraping-lösningarna 2026
1. Thunderbit
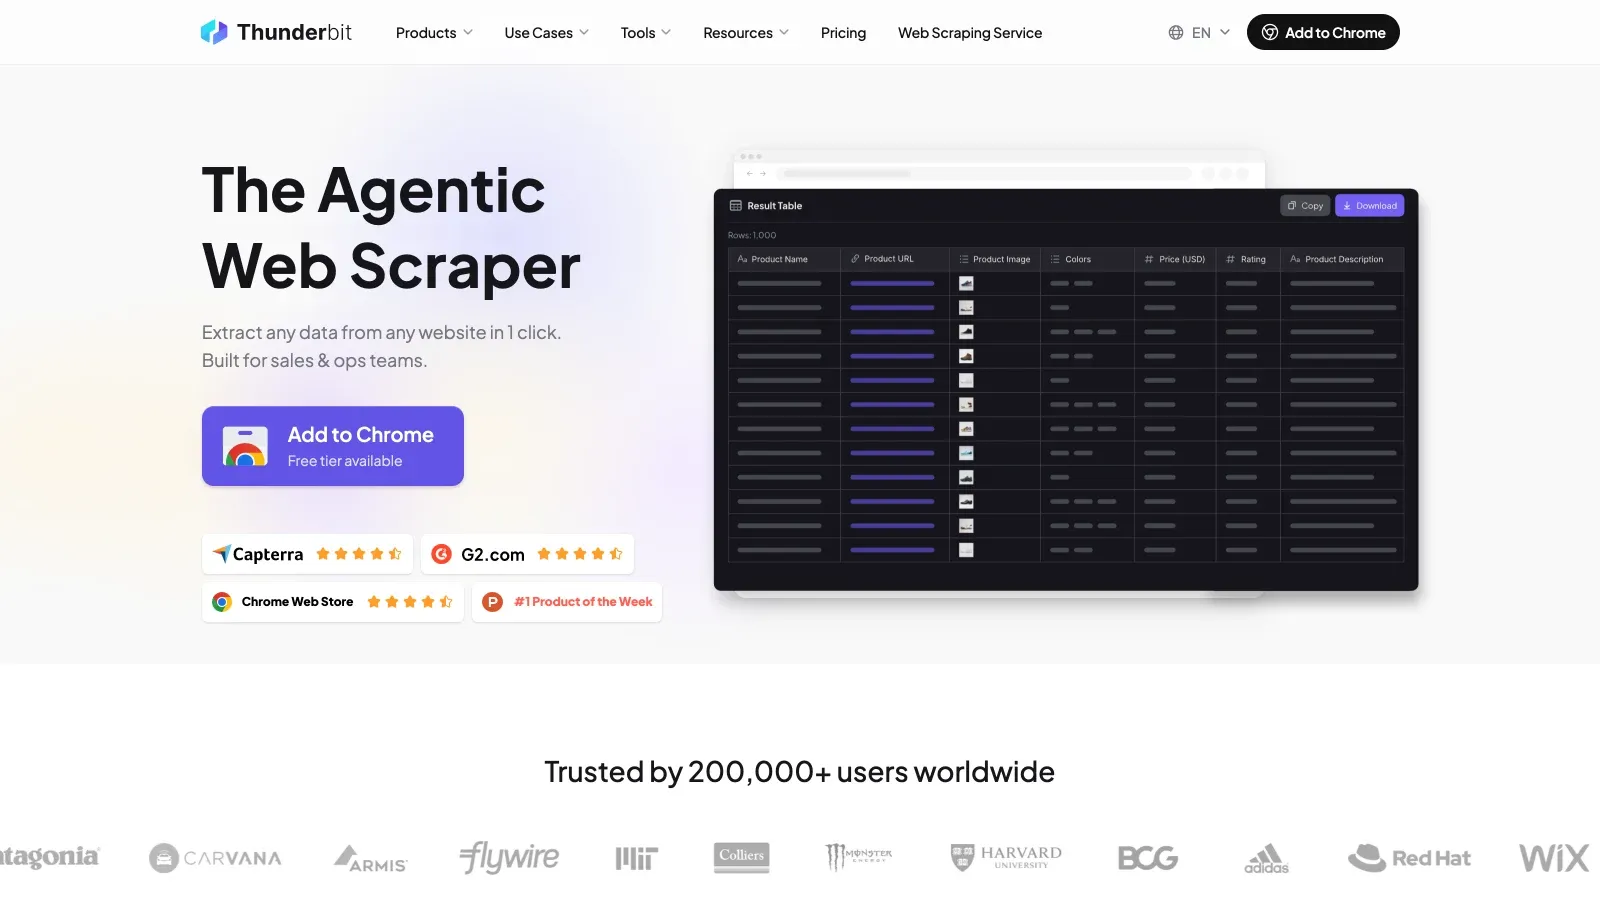
Thunderbit är det starkaste startvalet när uppdraget börjar med: "Jag behöver in den här datan i ett kalkylark idag." Produktens riktning är byggd kring AI-baserade fältförslag, berikning av undersidor och export som passar affärsanvändare snarare än scraper-utvecklare.
- Bäst för: sälj, operationer, e-handel, fastigheter och researchflöden som bygger mycket på webbläsaren.
- Det den gör bra: föreslår fält automatiskt, hanterar paginering och undersidor, och exporterar snabbt till Sheets, Excel, Airtable, Notion, CSV och JSON.
- Varför den kom med på listan: den har fortfarande kortast väg från publik sida till strukturerad data för användare utan kod.
- Prissignal: gratisplan, Starter från $15/månad, Pro från $38/månad, plus företagsprissättning.
Testa Thunderbit AI Web Scraper gratis Skrapa vilken webbplats som helst med 1 klick och exportera sedan till Sheets, Excel, Airtable eller Notion. Get Started Free
2. Browse AI
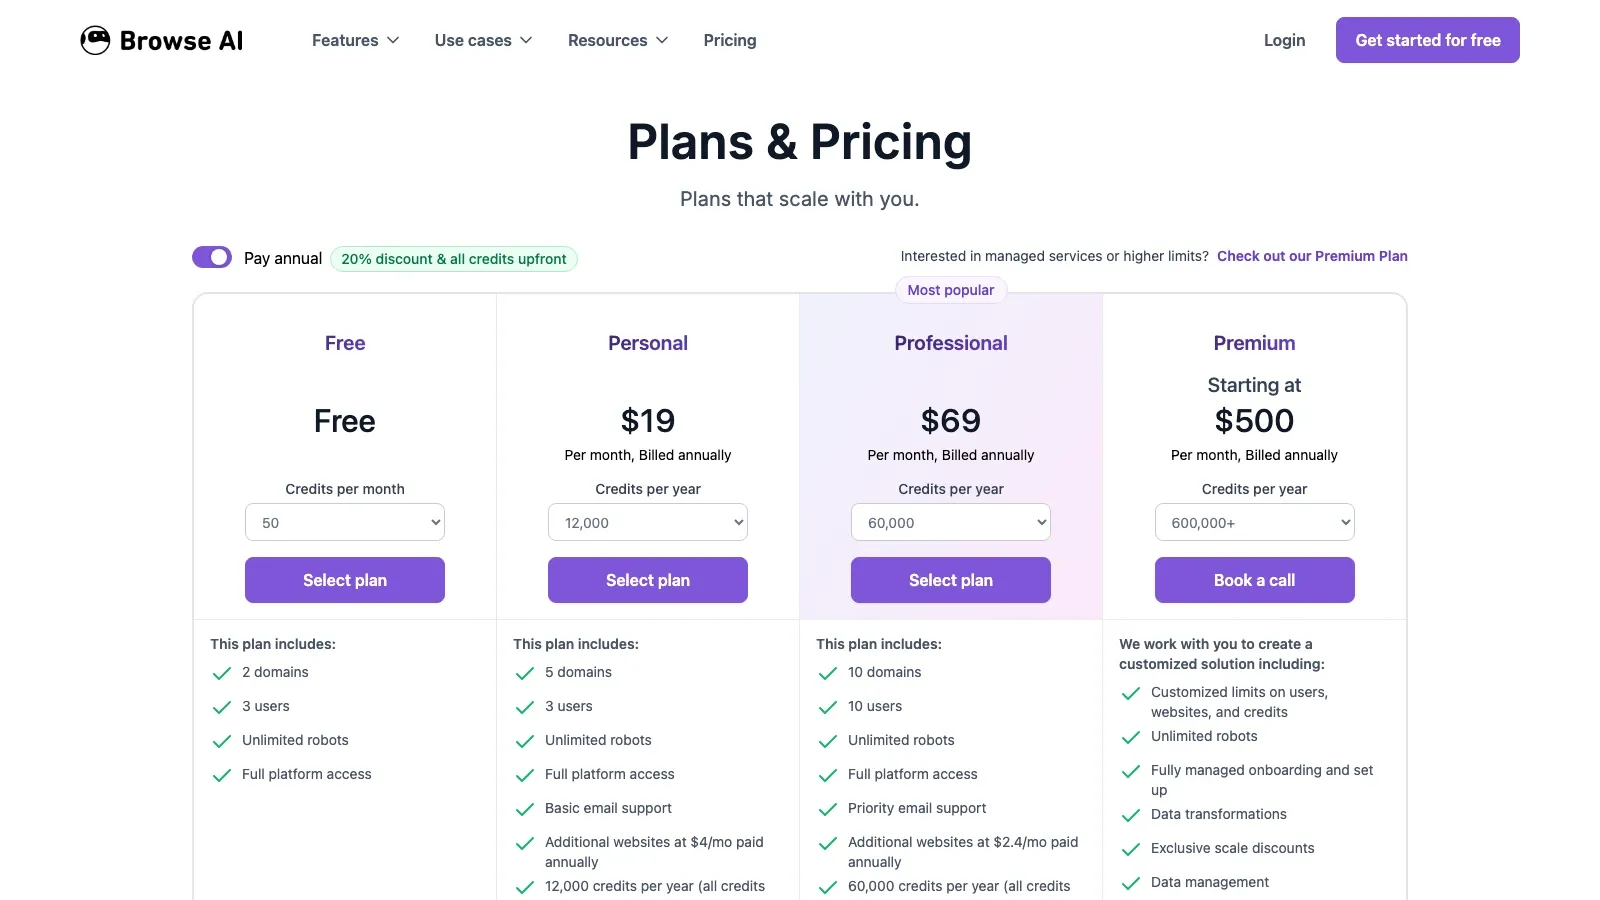
Browse AI är fortfarande ett av de mest trovärdiga no-code-alternativen för team som vill ha återupprepbara robotar, övervakning och kalkylarksvänliga resultat utan att skriva kod. Positioneringen är starkast när scraping och förändringsdetektering behövs samtidigt.
- Bäst för: konkurrentbevakning, prisbevakning, katalogscraping och återkommande förändringsdetektering.
- Det den gör bra: robotinspelning, upprepningsbar övervakning, browser-lik extraktion och stöd för premium-sajter.
- Varför den kom med på listan: den är fortfarande ett av de tydligaste no-code-valen när arbetsflödet är löpande, inte engångsbaserat.
- Prissignal: gratisplan, Personal från $19/månad vid årsbetalning, Professional från $69/månad vid årsbetalning, Premium från $500/månad vid årsbetalning.
3. Octoparse
Octoparse ligger fortsatt högt eftersom det fortfarande är en av de bästa uppgraderingsvägarna när en web scraper med ett klick inte räcker till. Här får du en tydligare task-byggare, molnextraktion och ett högre kontrolltak än lättare tilläggsverktyg.
- Bäst för: analytiker, pristeam och operativa användare som kör återkommande extraktionsjobb i högre volym.
- Det den gör bra: visuell uppsättning av uppgifter, molnkörningar, mallar, anti-blockeringsalternativ och återkommande schemaläggning.
- Varför den kom med på listan: den är fortfarande en av de renaste bryggorna mellan enkel affärsscraping och tyngre no-code-automation.
- Prissignal: gratisplan, Standard från $69/månad, Professional från $249/månad.
Om du vill jämföra ett strukturerat task-builder-flöde med de lättare AI-first-verktygen är den här aktuella Octoparse-genomgången den tydligaste mellanpositionen:
4. ParseHub
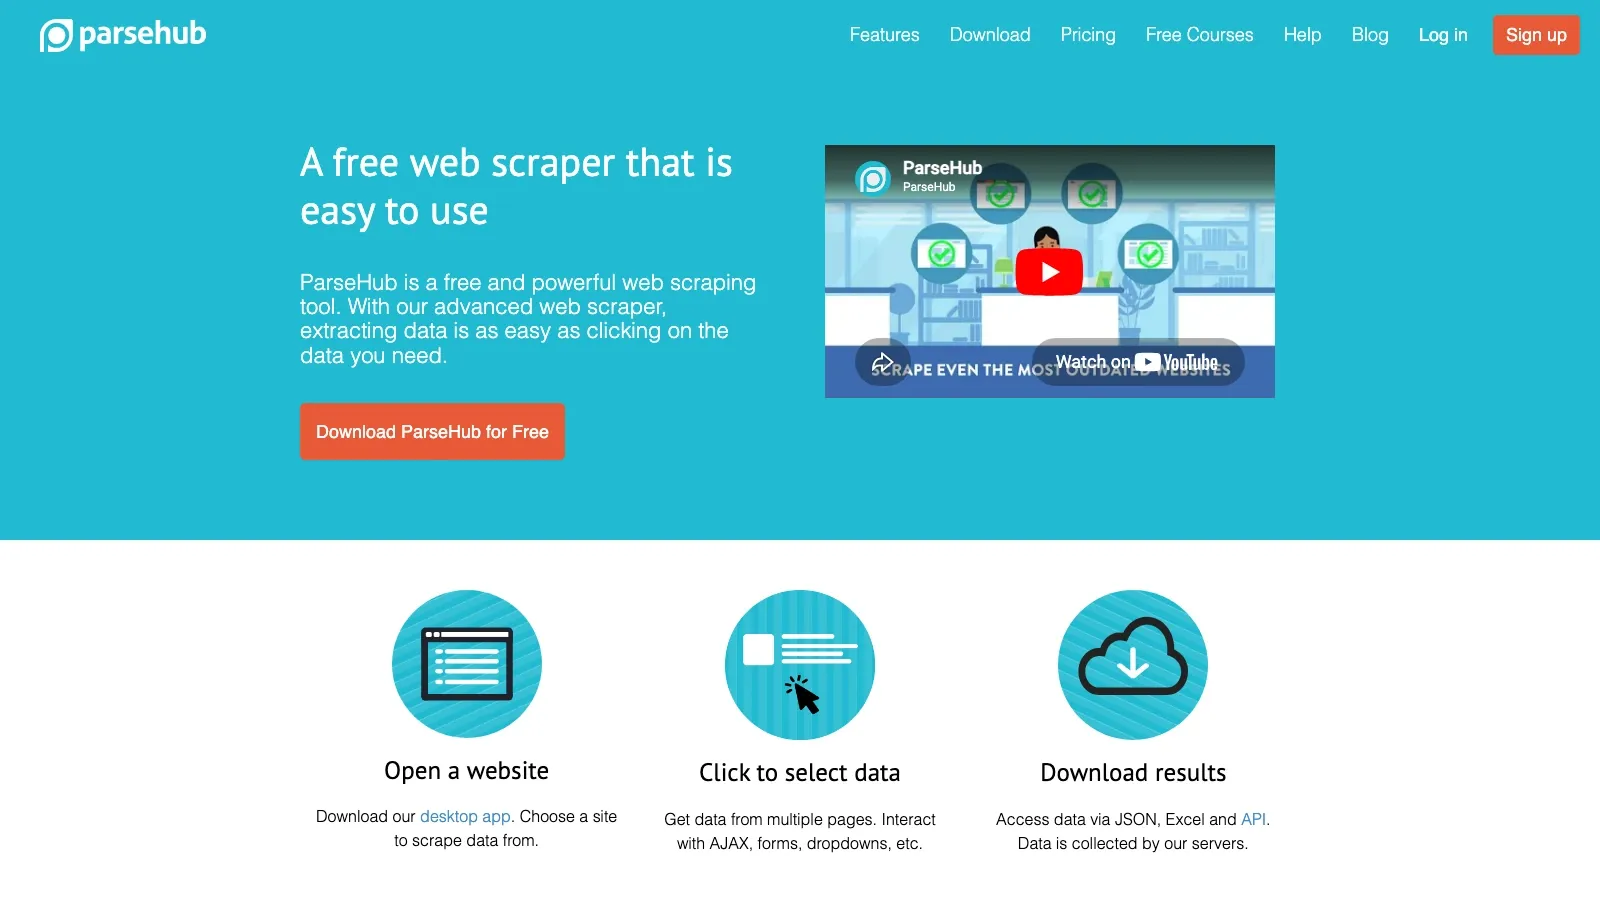
ParseHub hör fortfarande hemma på kortlistan för användare som behöver mer kontroll över dynamisk navigering men inte är redo att underhålla en kodbas. Arbetsflödet är tyngre än Thunderbit eller Browse AI, men det hjälper fortfarande när en sidstruktur kräver mer uttrycklig logik från desktop.
- Bäst för: användare som skrapar interaktiva eller dynamiska sajter och kan acceptera mer uppsättning.
- Det den gör bra: desktop-baserad flödesbyggnad, AJAX-hantering, nästlad navigering och anpassad extraktionslogik.
- Varför den kom med på listan: den ger mer kontroll än lätta webbläsarverktyg utan att kräva ett fullskaligt utvecklarflöde.
- Prissignal: gratisplan; betalplaner från $189/månad enligt ParseHubs aktuella officiella supportdokumentation.
Bästa plattforms- och API-verktygen för skala
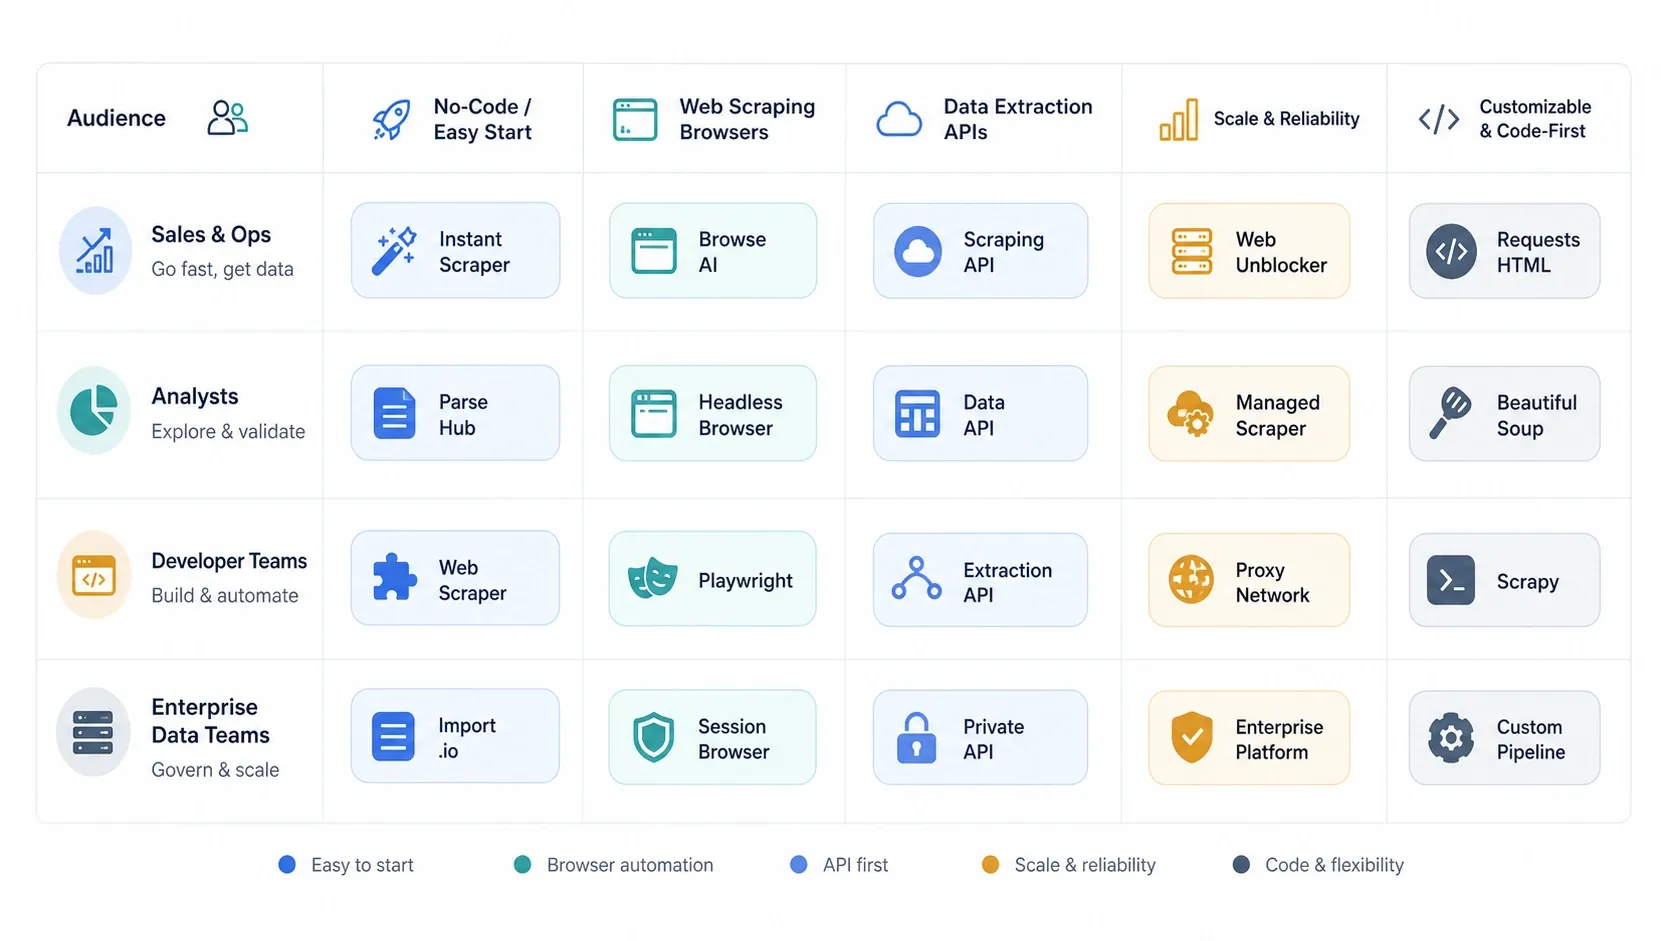
När frågan går från "Kan jag skrapa den här sidan?" till "Kan jag köra detta stabilt i skala?" förändras kortlistan. Plattformverktyg blir viktigare när rendering, unblock-frekvens, proxy-routing eller programmerbara flöden blir den verkliga flaskhalsen.
5. Apify
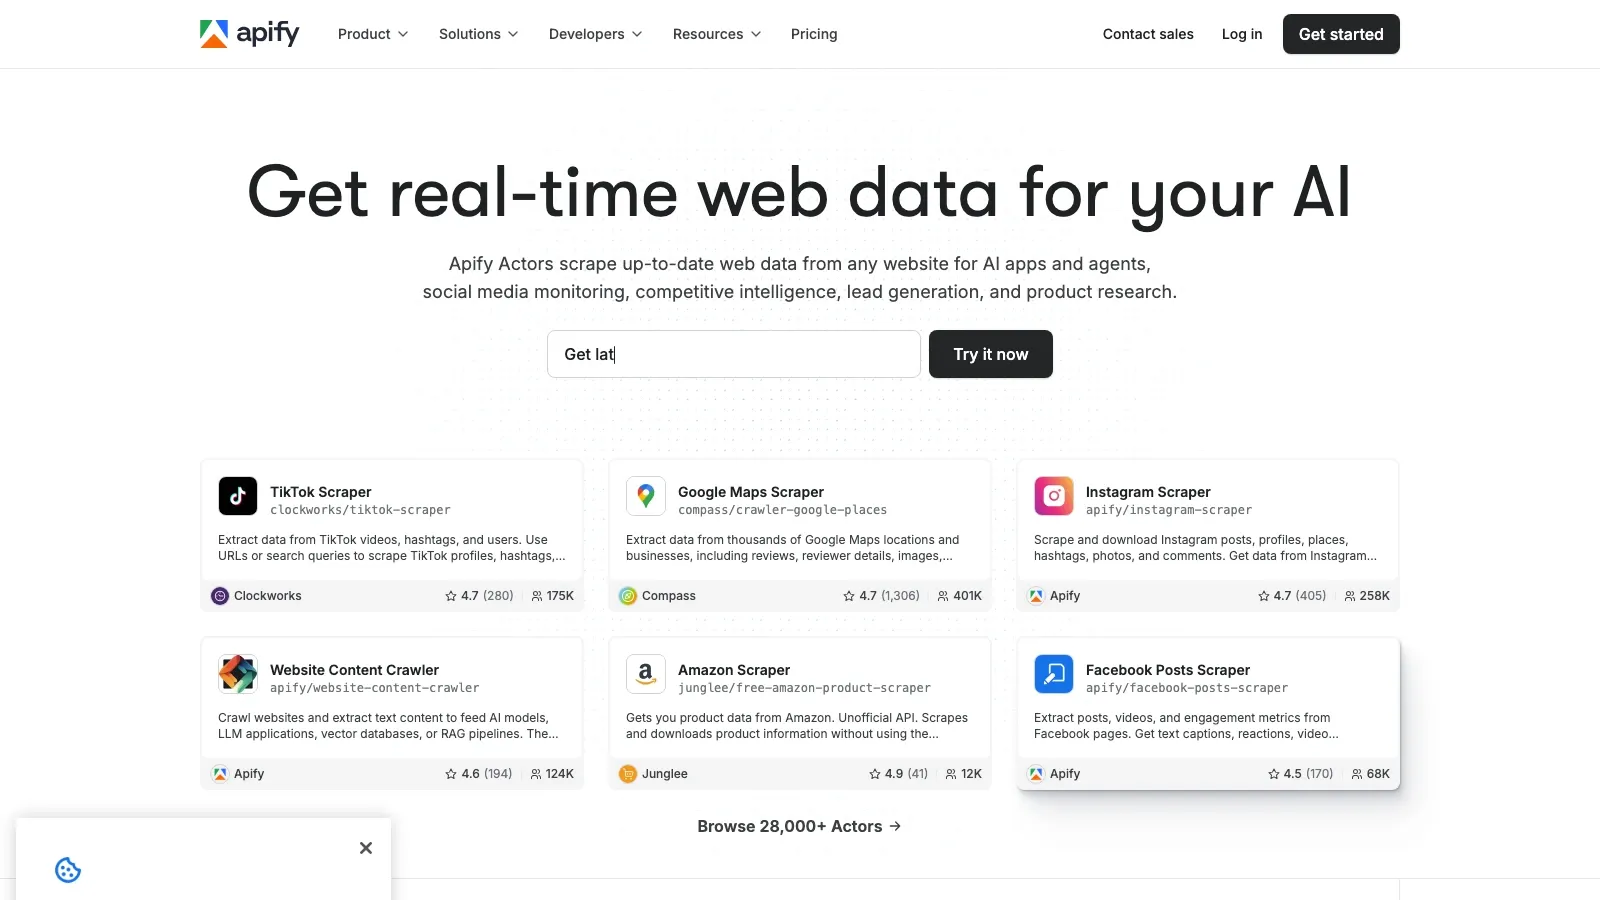
Apify är den mest flexibla plattformen på listan om du vill ha både färdiga scrapers och utrymme att bygga egen automation senare. Marknadsplatsen för actors tillsammans med den egna körmiljön ger mycket större bredd än ett vanligt webbläsartillägg.
- Bäst för: hybridteam som vill ha en plattform för färdiga scrapers, API:er och egna flöden.
- Det den gör bra: actor-marknadsplats, molnkörningar, API-åtkomst, integrationer och utrymme för egen kod.
- Varför den kom med på listan: den bygger en bättre brygga mellan självbetjänad scraping och riktig infrastruktur än de flesta konkurrenter.
- Prissignal: gratisplan, Starter från $29/månad, Scale från $199/månad, Business från $999/månad.
6. Bright Data
Bright Data finns här för team som inte bara köper en scraper. De köper unblock-förmåga, proxy-inventarie, hanterade insamlingsalternativ och en bred datainsamlingsstack som klarar tuffare mål och större volymer.
- Bäst för: enterprise-program för datainsamling, compliance-medvetna operationer med publika webdata och team som behöver mer än en enkel scraping-app.
- Det den gör bra: scraper API:er, proxynätverk, hanterade datamängder, webbläsarverktyg och djup infrastruktur.
- Varför den kom med på listan: den är fortfarande ett av de starkaste svaren när tillförlitlighet och skala väger tyngre än enkelhet.
- Prissignal: Bright Data använder produktbaserad och användningsbaserad prissättning för scraper API:er, proxies och hanterade datatjänster.
7. Oxylabs
Oxylabs är fortfarande ett av de tydligaste infrastrukturköpen för team som vill samla in data från öppna webbplatser på ett tillförlitligt sätt utan att själva sätta ihop hela proxy- och unblock-stacken. Produktlinjen är särskilt stark för prisbevakning, marknadsresearch och löpande dataprogram.
- Bäst för: team som köper scraping som infrastruktur snarare än som ett klickverktyg.
- Det den gör bra: Web Scraper API, Web Unblocker, proxyprodukter och enterprise-vänlig upphandling.
- Varför den kom med på listan: den är fortfarande ett av de mest trovärdiga alternativen när köparen bryr sig mer om tillförlitlighet och support än om snabb uppsättning.
- Prissignal: Web Scraper API börjar från $49/månad; andra proxy- och unblocker-produkter varierar beroende på produkt och användning.
8. ScrapingBee
ScrapingBee passar bra när den egentliga frågan är: "Rendera sidan, rotera proxies och låt mitt team fokusera på parsning." Det är smalare än en bred plattform som Apify, men just den fokuseringen är också anledningen till att många utvecklingsteam gillar det.
- Bäst för: utvecklare som skrapar JavaScript-tunga sajter och inte vill drifta en egen webbläsarflotta.
- Det den gör bra: rendering i headless browser, roterande proxies, geotargeting och ett enklare API-first-flöde.
- Varför den kom med på listan: den avlastar de fulaste problemen med webbläsarinfrastruktur utan att tvinga fram ett helt plattformsbyte.
- Prissignal: Freelance från $49/månad, Startup från $99/månad, Business från $249/månad.
Bästa ramverken för utvecklarägda pipelines
9. Scrapy
Scrapy är fortfarande det open-source-ramverk för crawling som betyder mest när ett team vill äga hela pipelinen. Det är inte det enklaste sättet att komma till första scrapingen, men det är fortfarande ett av de bästa valen för långlivade interna crawlersystem.
- Bäst för: Python-team som bygger interna crawlers eller produktionsklara datapipelines.
- Det den gör bra: högpresterande crawling, middleware, pipelines och utbyggbarhet.
- Varför den kom med på listan: den ger fortfarande tekniska team en av de bästa kombinationerna av kraft och mognad inom open-source scraping.
- Prissignal: gratis och open-source.
10. Playwright
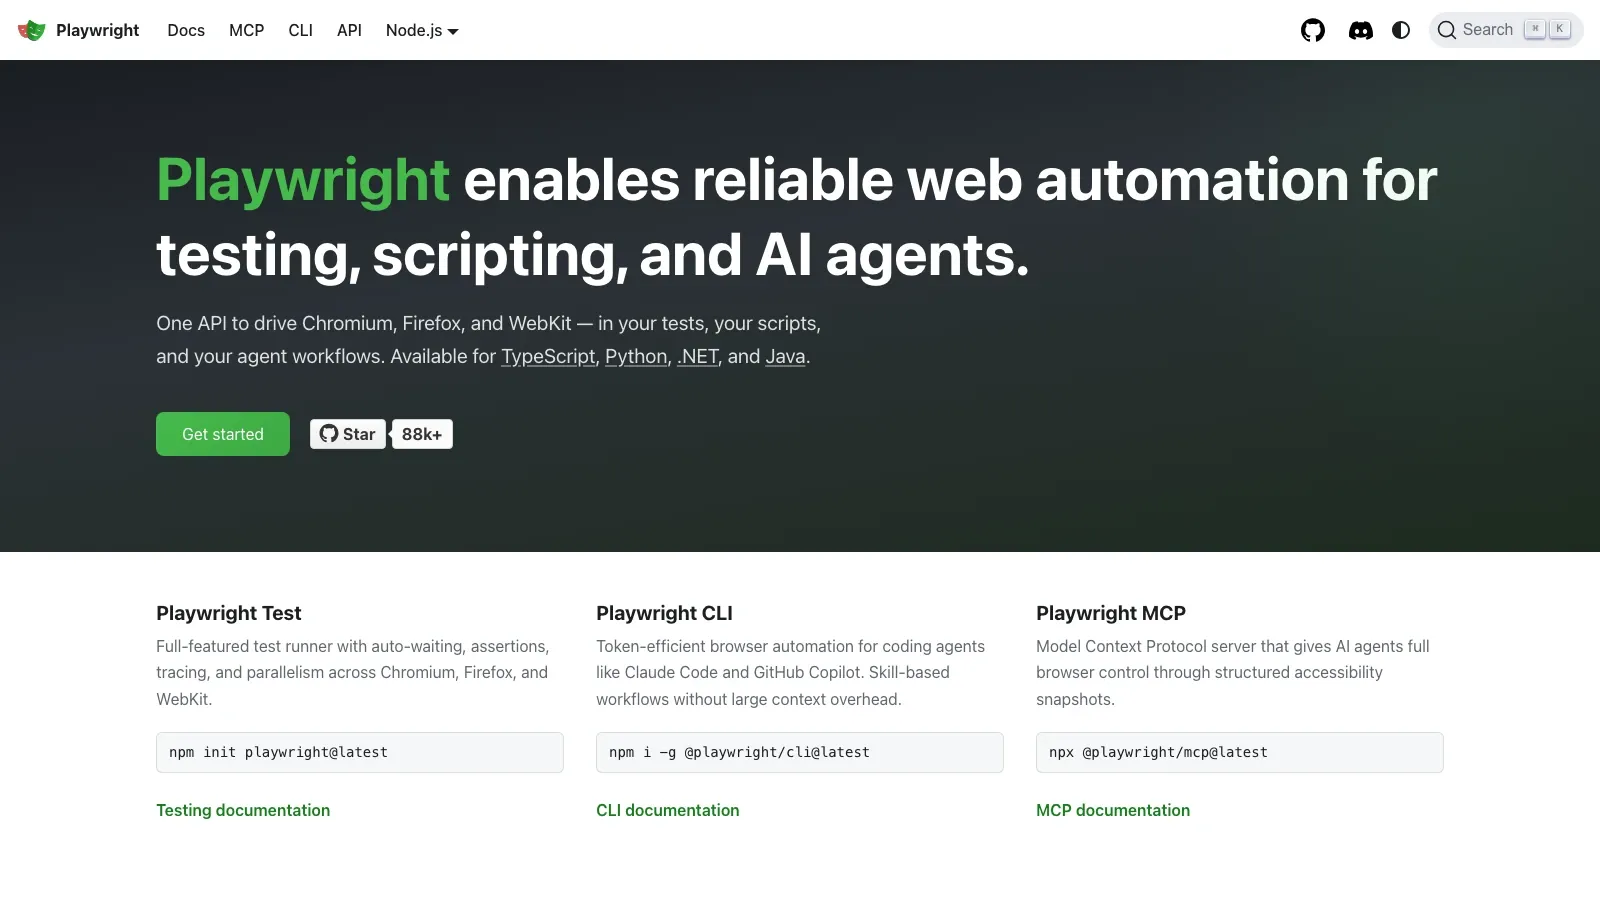
Playwright är mitt standardrekommenderade val när ett team vill ha modern, skriptstyrd webbläsarkontroll i stället för ett klassiskt crawler-ramverk. Den officiella sidan gör positionen tydlig: ett API för Chromium, Firefox och WebKit för testning, skript och agentflöden.
- Bäst för: modern webbläsarautomation, JavaScript-tunga sajter och team som bryr sig om utvecklarupplevelse.
- Det den gör bra: pålitlig väntelogik, stöd för flera webbläsare och rik automationkontroll för skriptade flöden.
- Varför den kom med på listan: den är ofta det renaste alternativet när arbetet kräver verklig interaktion i webbläsaren snarare än ren HTTP-crawling.
- Prissignal: gratis och open-source.
Min kortlista efter teamtyp
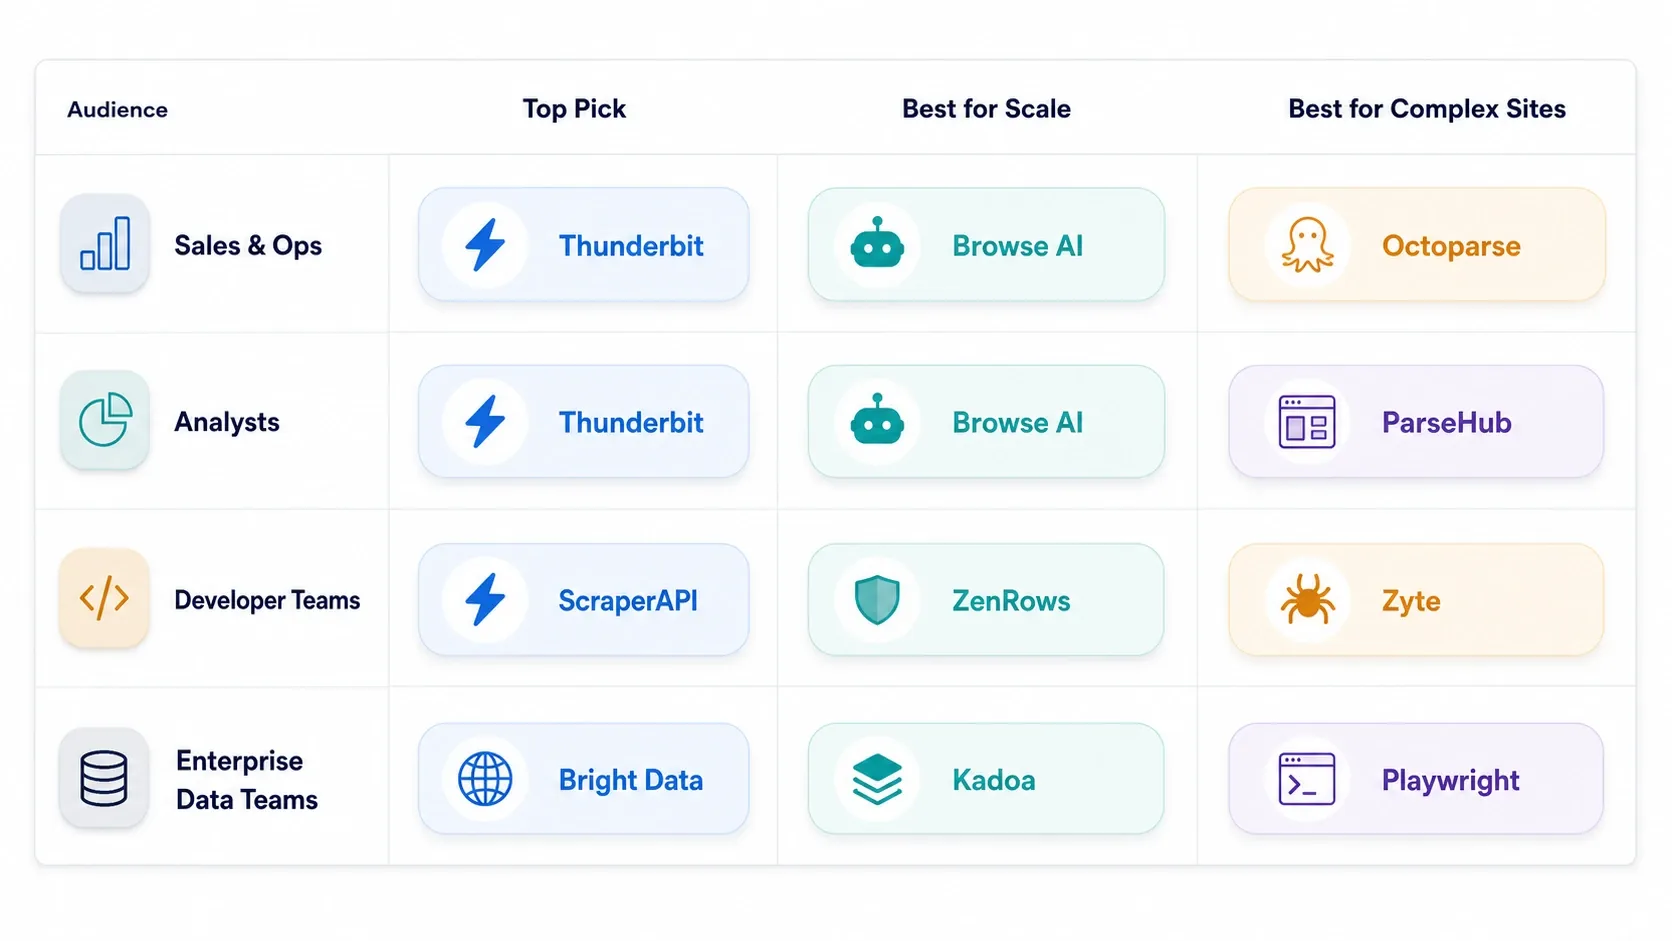
- Sälj- och driftteam: börja med Thunderbit och jämför sedan Browse AI om övervakning är viktigare än berikning av undersidor.
- Analytiker och team med återkommande extraktion: Octoparse först, sedan ParseHub om du behöver mer uttrycklig sidlogik.
- Hybridteam med teknisk profil: Apify om du vill ha en plattform för både färdiga verktyg och egna flöden.
- Enterprise-dataprogram: Bright Data och Oxylabs om unblock-frekvens, upphandling och tillförlitlighet är viktigast.
- Utvecklarägda pipelines: Scrapy för full kontroll över crawlers, Playwright för skriptstyrd automation med webbläsarfokus.
Om din kortlista redan håller på att skifta från webbläsartillägg till återkommande övervakning och arbetsflöden i marknadsskala, är den här aktuella Apify-videon en bättre referens i ett senare skede än ännu ett generiskt sammanfattningsklipp:
Så väljer du utan att köpa för mycket
Det vanligaste misstaget i den här kategorin är att köpa fel nivå i stacken.
- Välj en AI-scraper direkt i webbläsaren om huvudproblemet är uppsättningstid och tillgänglighet för affärsanvändare.
- Välj ett no-code-flödesverktyg om återkommande jobb, molnkörningar eller knepig paginering är viktigare än enkelheten i ett klick.
- Välj en plattform eller API-stack om rendering, proxyrotation och unblock-frekvens nu är det verkliga kravet.
- Välj open-source-ramverk bara om utvecklingsteamet redan äger underhållsbehovet och vill ha full kontroll.
Den praktiska tumregeln är enkel: köp det lättaste verktyget som faktiskt kan lösa det jobb du har idag.
Slutsats
Det finns ingen universell bästa web scraping-lösning eftersom kategorin numera rymmer flera olika köpscenarier. Thunderbit är det bästa valet när arbetet börjar i webbläsaren och snabbt måste sluta i ett kalkylark. Browse AI, Octoparse och ParseHub passar bättre när återupprepbarhet och tydlig no-code-kontroll väger tyngre. Apify, Bright Data, Oxylabs och ScrapingBee blir viktiga när infrastrukturen blir flaskhalsen. Scrapy och Playwright är rätt svar när utvecklingsteamet vill äga hela stacken.
Börja med det lättaste verktyget som faktiskt kan göra jobbet Get Started Free
Relaterad läsning
- Bästa AI Web Scraper-verktygen 2026
- Så skrapar du vilken webbplats som helst med AI
- Så skrapar du webbplatsdata till Excel
Vanliga frågor
1. Vilket web scraping-verktyg är bäst för icke-tekniska användare 2026?
För de flesta icke-tekniska användare är Thunderbit den bästa starten eftersom det minimerar uppsättningsarbetet och exporterar snabbt till affärsverktyg. Browse AI och Octoparse är starka uppföljare när återkommande övervakning eller mer tydlig no-code-kontroll blir viktig.
2. Vilket web scraping-verktyg är bäst för återkommande no-code-flöden?
Octoparse är den starkaste mittenvägen om du behöver molnkörningar, mallar och upprepningsbar schemalagd extraktion. Browse AI är bättre när övervakning och förändringsdetektering är kärnan i jobbet.
3. Vad bör utvecklare välja om de behöver mer skala eller kontroll?
Apify är det starkaste plattformsvalet om du vill ha molninfrastruktur plus återanvändbara verktyg. Scrapy är bättre när teamet vill äga en Python-crawlerstack. Playwright passar bättre när webbläsarautomation är själva navet i arbetsflödet.
4. När är Bright Data eller Oxylabs mer logiskt än en webbläsarscraper?
De passar bättre när det svåra inte är att extrahera en sida, utan att hantera infrastrukturen: unblock-frekvens, proxy-routing, upphandling, compliance eller tillförlitlig insamling i stor skala.
5. Räcker gratis- och open-source-verktyg för seriöst scraping-arbete?
Ja, men bara om teamet är redo att äga underhåll, parslogik, anti-bot-arbete, retries och infrastruktur. Den avvägningen är ofta värd det för utvecklingsteam, men är vanligtvis fel startpunkt för affärsanvändare.




