
Någonstans runt den fjortonde webbläsarfliken och den tredje priskalkylatorn insåg jag att det är svårare att välja en web scraping-tjänst 2026 än att faktiskt göra själva scraping-jobbet. Marknaden har exploderat — no-code Chrome-tillägg, råa API:er, proxy-tunga enterprise-stackar, AI-extraktorer och fullservicelösningar slåss alla om samma budgetpost.
Jag lade flera veckor på att testa 12 web scraping-tjänster mot riktiga uppgifter: att hämta produktdata från e-handelssajter, extrahera leads från företagsregister och skrapa jobbannonser med paginering och undersidor. Målet var inte att rangordna funktioner i ett vakuum, utan att svara på en praktisk fråga: vilken tjänst passar faktiskt vilken typ av team?
Enligt Bright Data's offentliga rapport om web data anser 82% av organisationer i dag att offentlig web data är avgörande för deras framtid. ScrapeOps marknadsrapport för 2025 visade att över 65% av organisationer använder web scraping för att bygga datamängder för analys och AI. Och ändå visar Apifys undersökning från 2026 att 46,7% av yrkesverksamma fortfarande förlitar sig helt på intern kod, med allt underhållsarbete som följer med det.
Innan vi går in på verktygen får du här en kort genomgång av den juridiska sidan av scraping.
Så utvärderade jag de bästa web scraping-tjänsterna
Här är vad jag tittade på. Jag valde ut dessa efter att ha sett vad som brukar gå sönder efter demo-fasen, inte utifrån en funktionslista.
- Enkel uppsättning / teknisk nivå som krävs — Kan en icke-utvecklare få nytta inom 10 minuter?
- Anti-bot och proxy-hantering — Sköter tjänsten proxies och CAPTCHA-lösning, eller är det ditt problem?
- JavaScript-rendering — Klarar den dynamiska sidor med mycket JS direkt från start?
- Exportformat och integrationer — Kan du få in datan i Sheets, Airtable eller Notion utan att bygga limkod?
- Schemaläggning / automatisk övervakning — Kan du köra återkommande scraping utan cron-jobb?
- Skalbarhet — Fungerar det för 100 sidor och fortsätter fungera för 1 miljon?
- Pristransparens och kostnad i skala — Går det att förutse nästa månadsnota, eller kommer den som en överraskning?
- AI-baserad extraktion vs manuella selectors — Använder den AI för att tolka fält, eller skriver du CSS/XPath för hand?
- Underhåll över tid — Vad händer när målsidan gör om sin design?
Den sista punkten förtjänar extra vikt. Användarrecensioner för verktyg som Octoparse, Apify, Browse AI och Bright Data lyfter gång på gång samma klagomål: förvirrande kreditprissättning, selectors som går sönder efter sidändringar, molnjobb som misslyckas på skyddade sidor och en brant inlärningskurva efter den första demon. "Underhållsbelastning" är inte en trevlig bonusparameter. Det är den faktor som avgör om du fortfarande använder verktyget om sex månader.
Vilken typ av web scraping-tjänst passar ditt team?
Innan vi jämför enskilda verktyg är det mest hjälpsamma jag kan göra att hjälpa dig hoppa direkt till rätt kategori. Web scraping-marknaden är inte en enda marknad. Den består av fem överlappande marknader, och att välja fel kategori slösar mer tid än att välja fel verktyg inom rätt kategori.
| Din situation | Rekommenderad tjänstetyp | Varför | Bra alternativ från den här listan |
|---|---|---|---|
| Icke-tekniskt team (sälj, marknad, drift) som behöver data snabbt | No-code Chrome-tillägg | Snabbaste vägen från webbplats till kalkylblad, lägst startmotstånd | Thunderbit, Browse AI, Octoparse |
| Utvecklare som bygger in scraping i en app eller pipeline | Scraping API | Mer kontroll, webhooks, asynkrona jobb, bättre passform för CI/CD | ScrapingBee, ScraperAPI, ZenRows |
| Team som matar data till AI/LLM-flöden | AI-native extraktions-API | Markdown-/JSON-först-utdata, mindre städning av HTML | Thunderbit API, Firecrawl, Diffbot |
| Enterprise som behöver proxy-infrastruktur och hög volym | Fullstack-plattform för datainsamling | Inbyggda proxies, anti-bot, SLA:er, hög samtidighet | Bright Data, Oxylabs, Apify |
| Företag som vill ha data levererad, inte verktyg att driva själva | Managed service / byrå | Leverantören ansvarar för bygg, övervakning, QA och leverans | ScrapeHero |
Det här är inte teori. Zyte's guide för 2026 om bygga-vs-köpa gör avvägningen tydlig: egen lösning ger kontroll men skapar löpande underhåll; blandade stackar blir operativa lapptäcken; managed services tar bort det interna ansvaret men minskar flexibiliteten.
AI-driven extraktion kontra traditionella CSS/XPath-selectors
Det här är just nu den största tekniska skiljelinjen på marknaden.
Traditionell scraping är som att följa en skattkarta med exakta koordinater. Du inspekterar sidan, hittar en selector som .product-title, skriver en extraktionsregel, testar den och hoppas att sajten ser likadan ut i morgon. När frontend-teamet byter klassnamn eller lägger innehåll i en ny div går din scraper sönder.
AI-driven scraping fungerar mer som att fråga en smart assistent: "Hitta produktnamn, pris och lagerstatus på den här sidan." I stället för att hårdkoda rutten beskriver du målet.
Så här ser de två arbetsflödena ut i praktiken:
Traditionellt flöde:
- Inspektera element i DevTools
- Identifiera
.product-title-klassen eller XPath - Skriv extraktionsregeln
- Testa på exempelsidor
- Fixa när sajten ändrar klassnamn
AI-drivet flöde (t.ex. Thunderbit):
- Öppna sidan och klicka en gång
- AI:n väljer kolumnerna — produktnamn, pris, betyg
- Justera om du vill ha något annat, eller säg bara vad du behöver
- Annars kör den bara, och du får tabellen
Den publicerade forskningen är mer begränsad än marknadsföringen. En Scientific Reports-artikel från 2025 rapporterar 35% bättre extraktionsnoggrannhet och 40% bättre bearbetningseffektivitet för en AI-crawler jämfört med traditionella alternativ, men testmiljön är tidningsarkiv, inte produktsidor eller företagsregister, så jag skulle inte överföra de siffrorna rakt av till sidorna i den här artikeln. Springer-översikten från 2025 är mer användbar: AI-modeller anpassar sig bättre till dynamiska strukturer men behöver fortfarande omträning eller fallback-logik när domäner eller mönster förändras tydligt.
| Dimension | Traditionell (CSS/XPath) | AI-driven extraktion |
|---|---|---|
| Uppstartstid | 15–60 min per sajt | ~30 sekunder |
| Teknisk nivå | Utvecklarnivå | Ingen krävs |
| Klarar layoutändringar och nya sajter | Går sönder — nya regler efter varje omdesign, nya regler för varje ny sajt | Anpassar sig oftast — läser sidan på nytt varje körning |
| Förutsägbarhet | Deterministisk — samma regel hämtar samma fält varje gång | Probabilistisk — kan välja fel fält, så resultat behöver stickprovskontrolleras |
| Datamärkning / transformation | Separat efterbearbetningssteg | Kan märka, översätta och kategorisera under scraping |
| Bäst för | Stabil, högvolyms pipeline som ägs av utvecklare | Långsvanssajter, varierande layouter, icke-utvecklare |
Den tydligaste skillnaden i verkligheten är underhåll. Det finns ingen pålitlig offentlig siffra för hur ofta scrapers går sönder, så jag hittar inte på någon här. Det som däremot är konsekvent är klagomålsmönstret i G2- och Capterra-recensioner av selector-baserade verktyg i den här listan: sällan att verktyget inte kunde få fram datan alls, nästan alltid att det slutade få fram datan efter att sajten ändrades.
Thunderbit är det tydligaste exemplet på AI-first-modellen i den här listan. Dess AI väljer vilka fält som är värda att hämta efter ett enda klick, eller så kan du beskriva datan du vill ha i en enda rad, och dess Field AI Prompts kan märka, översätta, sammanfatta eller kategorisera data under extraktionen — inte bara efteråt. Dess Open API exponerar både Distill- och Extract-endpoints så att samma AI-extraktionsmodell även fungerar programmatiskt.
Testa AI-driven scraping med Thunderbit
Alla 12 bästa web scraping-tjänster i en översikt
| Tjänst | Typ | Bäst för | Anti-bot/proxy | JS-rendering | AI-extraktion | Gratis nivå | Startpris (månadsvis) | Exportalternativ |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code Chrome-tillägg + API | Icke-tekniska team | ⚠️ Molnbaserad hantering | ✅ | ✅ AI-mappade fält | ✅ 6 sidor gratis | Gratis; betald från $15/mån | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | Fullstack-plattform | Enterprise-pipelines | ✅ Marknadsledande proxynätverk | ✅ | ⚠️ Delvis / nyare AI-lager | ✅ 5K poster/mån | Ingen månatlig miniminivå | JSON, CSV, API, webhook |
| Oxylabs | Enterprise proxy + scraping | SERP-scraping, skyddade sajter | ✅ Residential/DC-proxies | ✅ | ⚠️ Begränsad | ⚠️ Testperiod | ~$49/mån | JSON, CSV, API |
| Apify | Plattform + marknadsplats | Utvecklare, automationsbyggare | ✅ Via proxy-konfiguration | ✅ | ⚠️ Vissa actors | ✅ $5 gratis/mån | $29/mån + användning | JSON, CSV, Excel, API |
| ScrapingBee | API-tjänst | Developer pipelines | ✅ Inbyggd | ✅ | ⚠️ Viss AI-extraktion | ✅ 1,000 credits | $49/mån | JSON, HTML, Markdown, API |
| ScraperAPI | API-tjänst | Prisövervakning i skala | ✅ Inbyggd rotation | ✅ | ❌ | ⚠️ 7-dagars test, 5K credits | $49/mån | JSON, CSV, API |
| ZenRows | API-tjänst | Sajter med stark anti-bot | ✅ Premium anti-bot | ✅ | ⚠️ Beta | ✅ 5K credits/mån | $19/mån | JSON, API |
| Octoparse | No-code desktop + moln | Visuell no-code scraping | ✅ Inbyggt | ✅ | ⚠️ Begränsad auto-detektion | ✅ Gratis plan (10 uppgifter) | $39/mån | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | AI/NLP-plattform | Strukturerad enterprise-data | ⚠️ Enkel till måttlig | ✅ | ✅ NLP-baserad | ✅ 10K credits/mån | $299/mån | JSON, CSV, API |
| Firecrawl | Developer API (AI) | LLM/RAG-pipelines | ✅ Inbyggd | ✅ | ✅ Markdown + strukturerad | ✅ 1,000 credits/mån | $19/mån | Markdown, JSON, HTML, API |
| Browse AI | No-code övervakning | Förändringsdetektering, icke-utvecklare | ⚠️ Grundläggande | ✅ | ⚠️ Mallbaserad | ✅ 50 credits/mån | $48/mån | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | Managed service/byrå | Företag som vill vara hands-off | ✅ Helt hanterad | ✅ | N/A | ❌ | Från $199/mån | Anpassad leverans |
Mönstret är ganska tydligt.
Thunderbit, Browse AI och Octoparse optimerar för snabb uppstart. ScrapingBee, ScraperAPI och ZenRows optimerar för utvecklarkontroll. Bright Data, Oxylabs och Apify optimerar för skala och infrastruktur. Firecrawl och Diffbot optimerar för AI-anpassad utdata. ScrapeHero optimerar för att du själv inte ska behöva driva någonting.
1. Thunderbit
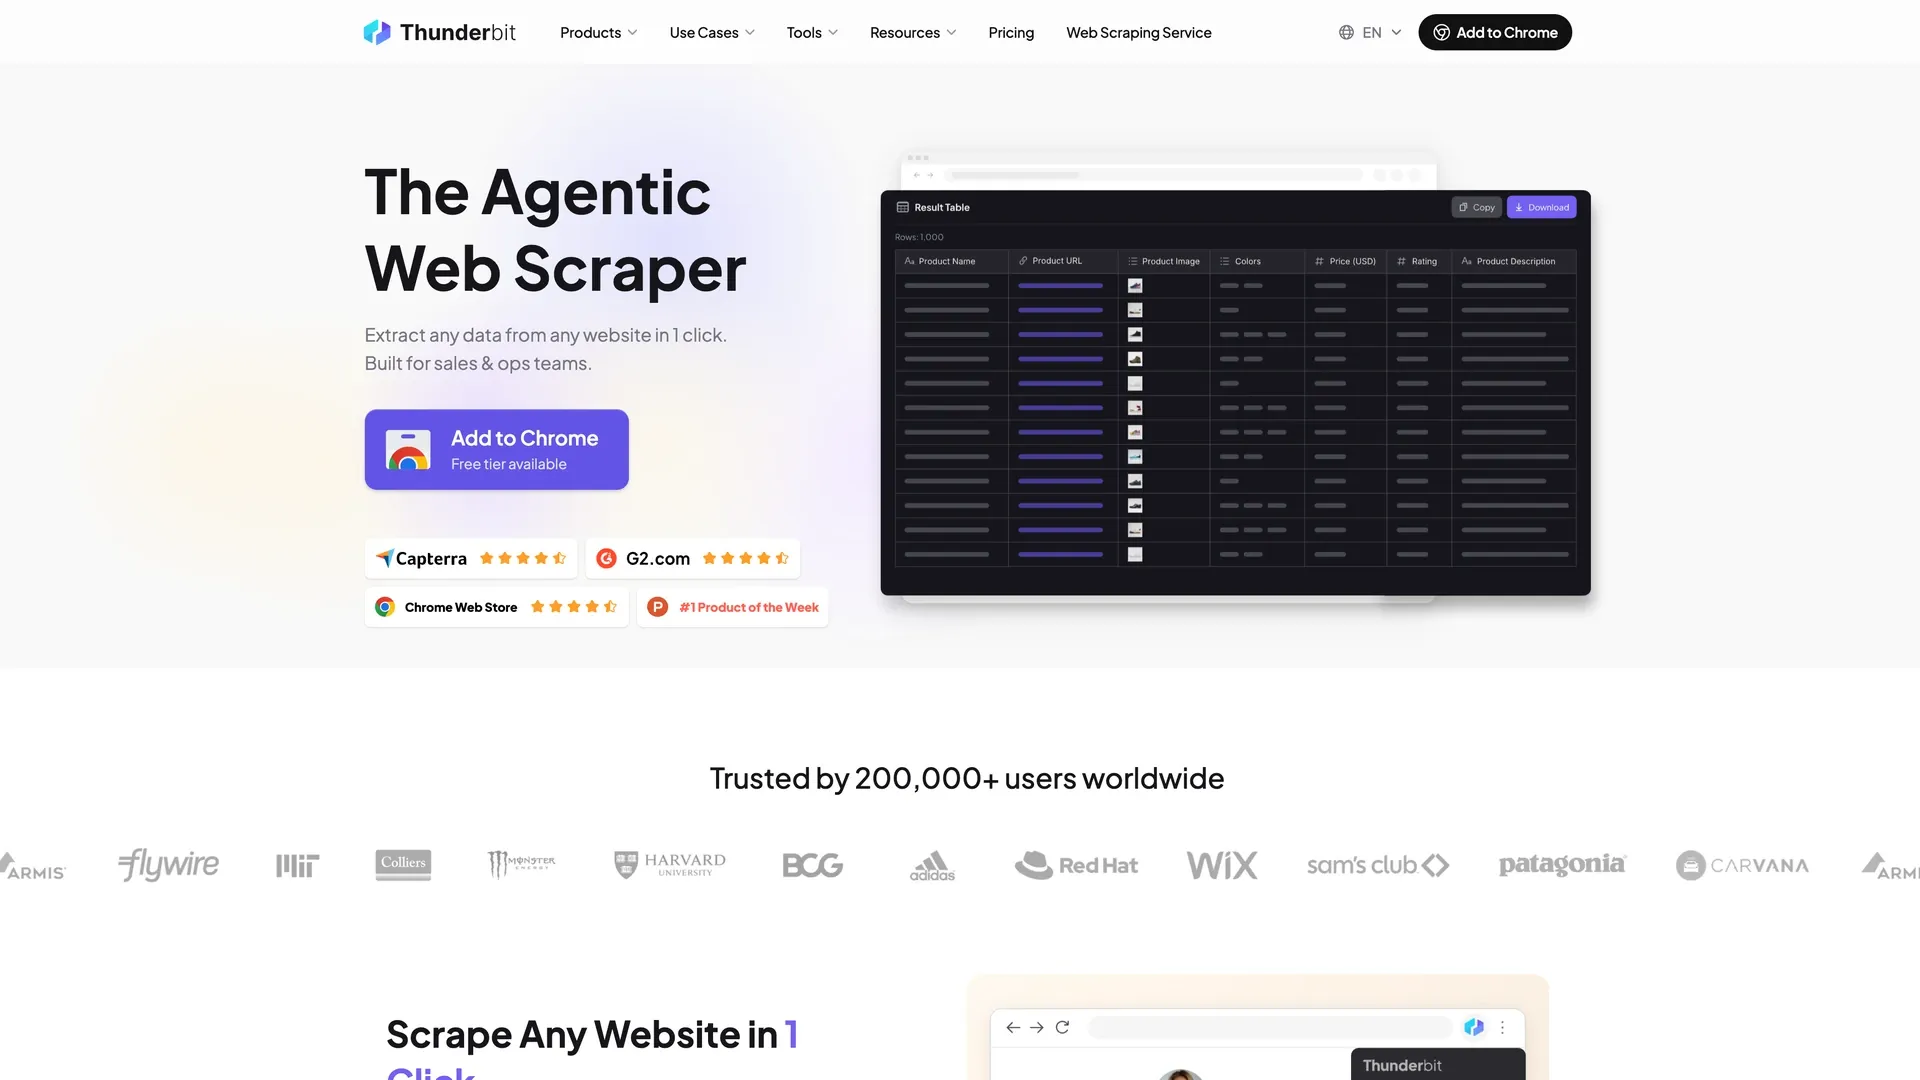 Thunderbit är den enklaste produkten i den här listan för icke-tekniska användare som vill gå från webbplats till kalkylblad utan att röra en enda selector. Kärnflödet är ovanligt rakt på sak: öppna Chrome-tillägget på valfri sida och klicka en gång — AI:n räknar ut vilka fält som är värda att hämta och kör jobbet själv, och om du vill ha något specifikt kan du bara beskriva det på vanlig svenska. Det är faktiskt hela processen för de flesta sidor. Inga CSS-selectors. Ingen XPath. Ingen elementinspektion.
Det som skiljer Thunderbit från mängden är att det inte bara extraherar fält. Det kan också märka, översätta, sammanfatta, kategorisera och omforma data under själva scraping-jobbet med Field AI Prompts. Det spelar roll eftersom den verkliga flaskhalsen för affärsanvändare ofta inte är själva extraktionen, utan städningen efter export. Med Thunderbit kan du skrapa en fransk produktsida och få engelsk utdata med sentimentetiketter — i ett enda steg.
Nyckelfunktioner:
- Zero-selector-uppsättning — ett klick och AI:n väljer kolumnerna åt dig, eller så berättar du bara vad du vill ha
- Browser mode för inloggade sidor och cloud mode (50 sidor åt gången) för snabb scraping av publika sidor
- Subpage scraping för att automatiskt berika list-sidor med data från detaljsidor
- Paginering och infinite scroll-hantering inbyggt
- Schemaläggning på naturligt språk för återkommande övervakning (t.ex. "varje måndag kl. 09.00")
- Omedelbara scraper-mallar för populära sajter som Amazon, Zillow, Google Maps och Indeed
- Open API med
Distill- ochExtract-endpoints för utvecklarfall - Stöd för 34 språk inklusive översättning under extraktionen
Exporten är en av Thunderbits tydligaste styrkor. Det erbjuder gratis, inbyggd export till Excel, CSV, JSON, Google Sheets, Airtable och Notion — inklusive bildhantering i Airtable- och Notion-exporter. För ett säljteam som lever i Sheets eller ett marknadsteam som organiserar research i Notion försvinner ett helt transformationssteg som API-först-verktyg lämnar till dig.
Pris: Kreditbaserat. Gratisnivå med 6 sidor per månad, plus en 7-dagars test av Pro-funktionerna. Betalda browser-planer börjar på $15/mån månad-för-månad eller $9/mån vid årlig fakturering. API:t har egen prissättning: 600 gratis enheter att börja med, sedan $29/mån för 6,000 enheter på Starter, $72/mån för 60,000 på Pro 1, $120/mån för 120,000 på Pro 2, och en slider som går upp till 480,000 enheter per månad. Vid årlig fakturering är det $16/mån för 60,000 enheter per år på Starter och $40/mån för 600,000 på Pro 1.
Fördelar:
- Lägst startfriktion i hela jämförelsen
- Inbyggd export direkt till kalkylblad i första hand, inte "JSON och så får du lösa resten"
- AI-transformation under extraktionen, inte bara efteråt
- Stark passform för sälj, e-handel, research och fastigheter
Nackdelar:
- Två kreditssystem i olika enheter: tillägget tar 1 kredit per utdatam rad (2 med subpage scraping), API:t tar 1 enhet per Distill-sida och 20 per Extract-sida — du måste budgetera dem separat
- Gratisnivån är 6 sidor i månaden, långt under vad API-leverantörerna här ger bort (Firecrawl 1,000 credits/mån, ZenRows 5,000, Diffbot 10,000)
- Självservice slutar före enterprise-volym: den högsta publicerade browser-planen är Pro på $38/mån månad-för-månad, och efter det är det en skräddarsydd Business-offert
Bäst för: Säljgenerering, övervakning av konkurrenter inom e-handel, marknadsresearch, jobb- och katalogscraping, fastighetsannonser.
2. Bright Data
 Bright Data är vad enterprise-köpare väljer när de vill ha en enda leverantör för proxies, scraping-API:er, datasets, SERP API:er och i allt högre grad AI-assisterad extraktion. Det är mindre en enskild produkt och mer en komplett stack för datainsamling.
Prissättningen för Web Scraper API är offentlig: gratisnivå på 5,000 poster per månad, pay-as-you-go från cirka $1.50 per 1,000 poster, och en scale-plan för $499/mån med 384,000 inkluderade poster och $1.30 per 1,000 efter det. En post här är ett extraherat objekt — en rad i tabellen — inte en laddad sida. Residential proxies börjar på $4/GB. Det finns också strukturerade datasets, Scraper Studio, AI scrapers och MCP-stöd.
Nyckelfunktioner:
- Extremt starkt proxynätverk (residential, datacenter, mobil, ISP)
- Full browser-rendering och CAPTCHA-lösning ingår i Web Scraper API-prissättningen
- Marknadsplats för datasets med förinsamlad data
- Enterprise-compliance med Trust Center och certifieringar
Pris: Pay-as-you-go från cirka $1.50/1K poster; scale-plan från $499/mån.
Fördelar: Oöverträffad skala och proxy-infrastruktur. Bred enterprise-governance. Nackdelar: Mer komplexitet än de flesta medelstora team behöver. Priset blir snabbt högt när du kombinerar API:er, proxies och tilläggslager. Plattformen kräver fortfarande oftast en teknisk ägare, även med nyare AI-funktioner.
Bäst för: Fortune 500-pipelines, datateam som skrapar miljontals sidor, scraping över flera regioner där proxykvalitet spelar roll, företag som behöver formell compliance.
3. Oxylabs
 Oxylabs är det starkaste rena enterprise-alternativet för proxy + scraping för team som främst bryr sig om tillförlitlighet på skyddade mål. De erbjuder residential- och datacenter-proxies, Web Scraper API, SERP Scraper API, Web Unblocker och ett nyare Headless Browser-lager.
Prissättningen börjar på $49/mån för Web Scraper API, och priset per resultat beror både på målsajt och vilken plan du ligger på. På $49 Micro-planen kostar en generell sajt — allt som inte är Amazon eller Google — $1.15 per 1,000 resultat utan JS-rendering och $1.35 med den; på $249 Advanced-planen är de siffrorna $0.95 och $1.25, och de fortsätter sjunka i högre nivåer. Residential proxies börjar på $6/GB och sjunker till $2.50/GB vid 1 TB.
Nyckelfunktioner:
- Mycket stark proxy-infrastruktur med automatisk rotation och sessionshantering
- SERP Scraper API särskilt byggt för sökmotorövervakning
- Betala bara för lyckade resultat på de viktigaste produkterna
- Tydligt Trust Center och stark compliance-profil
Pris: Från $49/mån; ingen löpande gratisnivå (endast testperiod).
Fördelar: Tillförlitliga proxies, utmärkt för SERP-scraping, stark enterprise-trovärdighet.
Nackdelar: Det marknadsförda antalet resultat per plan utgår från Amazon utan JS-rendering — på en generell sajt ger $49 Micro-planen ungefär 42,600 resultat, inte 98,000. Eftersom priset per 1,000 varierar både med målsajten och plannivån kan två team som skrapar samma volym få helt olika fakturor.
Bäst för: SEO-team, enterprise SERP-övervakning, stora proxy-tunga arbetsflöden.
4. Apify
 Apify är den mest flexibla plattforms- och marknadsplatsmodellen här. Den kombinerar molnkörning, lagring, schemaläggning, loggar, API:er och ett enormt ekosystem av färdiga "Actors" — Apify Store listar nu mer än 59,000 Actors. I stället för att bygga varje scraper själv kan du ofta börja från en befintlig actor för Google Maps, Amazon, Instagram, TikTok eller en generell crawler för webbplatsinnehåll.
Nyckelfunktioner:
- Enorm marknadsplats med färdiga scrapers
- Apify SDK för egen actor-utveckling
- Inbyggd proxyhantering och molnkörning
- Starkt API, lagring, schemaläggning och loggar
Prissättningen är användningsbaserad: gratisplan med $5 i spend, sedan $29/mån på Starter, $199 på Scale, $999 på Business — alla med beräkning per compute-unit ovanpå. Flexibiliteten är kraftfull, men det är svårare att förutse månadskostnaden än med enklare API-produkter.
Fördelar: Stor community, många färdiga scrapers, bra för allt från hobby till produktion och seriös automation.
Nackdelar: Att anpassa eller felsöka actors har en tydlig inlärningskurva. Pris baserat på compute units plus actor-avgifter plus proxies kan vara svårt att förutsäga. Bättre för byggare än för kalkylbladsanvändare.
Bäst för: Utvecklare och automationsbyggare, team som vill återanvända befintliga scrapers, blandade build-and-buy-flöden.
5. ScrapingBee
 ScrapingBee är ett av de enklaste scraping-API:erna att förstå och integrera. Fokus ligger på headless Chrome-rendering, proxyrotation och ren API-design i stället för att försöka vara en visuell plattform.
Prissättningen börjar på $49/mån för 250,000 credits och 50 samtidiga requests, med Startup på $99/mån för 1,000,000 credits och 100 samtidiga requests. Nya användare får 1,000 gratis API-credits. Haken: JS-rendering, premium proxies, screenshots och AI-extraktion drar alla mer credits per anrop.
Nyckelfunktioner:
- Mycket ren REST API-design
- Särskilda endpoints för Amazon, Google, YouTube, Walmart och ChatGPT
- Kan returnera HTML, JSON, Markdown eller ren text
- Bra passform för AI/LLM-pipelines eftersom Markdown minskar städarbete
Fördelar: Utvecklarvänligt, pålitlig JS-rendering, transparent grundpris.
Nackdelar: $49-planen ger 250,000 credits, men det gäller endast 250,000 vanliga requests — JS-rendering, premium proxies, screenshots och AI-extraktion kostar alla mer än en credit per anrop, så på riktiga mål blir det betydligt färre sidor än rubriknumret antyder. Samtidigheten är kopplad till planen (50 parallella requests på Freelance), så genomströmningen kan tvinga dig upp en nivå innan volymen gör det. Kräver fortfarande eget kodansvar.
Bäst för: Utvecklare som bygger in scraping i backend, team som vill ha enkel API-ergonomi, LLM-pipelines som vill ha text först.
6. ScraperAPI
 ScraperAPI är fortfarande ett av de starkaste strukturerade API-alternativen för e-handelsövervakning och återkommande bulk scraping. Produktidén är enkel: en endpoint som buntar ihop proxies, retries, JS-rendering, geotargeting och strukturerad output.
Prissättningen börjar på $49/mån för 100,000 credits och 20 trådar, med Startup på $149/mån för 1,000,000 credits och 50 trådar. Det finns också en 7-dagars test med 5,000 credits, utan krav på kort. Det som gör ScraperAPI intressant är det strukturerade lagret: asynkrona API:er, webhook-leverans, DataPipeline för projekt med mindre kod, och strukturerade endpoints för Amazon, eBay, Google, Redfin och Walmart.
Nyckelfunktioner:
- Starka strukturerade endpoints för stora e-handels- och sökdomaner
- Bra stöd för asynkrona jobb och webhooks
- Konkurrenskraftigt för högvolymövervakning
- Bred geotargeting och renderingskontroll
Fördelar: Generösa testcredits, bra dokumentation, pålitligt för e-handelsövervakning.
Nackdelar: Credit-multiplikatorer gör kostnadsmodelleringen svårare. Ingen riktig AI-extraktion för godtyckliga sidor. Endast för utvecklare.
Bäst för: Prisövervakning inom e-handel, konkurrensanalys, sök- och marketplace-pipelines.
7. ZenRows
 ZenRows är anti-bot-specialisten. Fokus ligger på att slå igenom Cloudflare, DataDome, Akamai, Imperva och liknande skydd, samtidigt som man behåller en modern utvecklarupplevelse.
Prissättningen börjar på $19/mån i Build-planen (45,000 credits, 20 samtidiga requests). Build är i sig en slider — $29 för 80,000 credits, $39 för 120,000 — och ovanför den finns Launch på $69/mån för 250,000 credits och 50 samtidiga requests samt Growth på $199/mån för 1.2 miljoner; det är månadspriser, och årlig fakturering ger 17% rabatt. Kostnadsmodellen är multiplikatorbaserad: JS-rendering är 5x, premium proxies är 10x, och att använda båda är 25x.
Nyckelfunktioner:
- Mycket starkt fokus på hårt skyddade sajter
- Bred dokumentation och god anti-bot-täckning
- Modernt integrations-ekosystem inklusive LangChain, LlamaIndex och MCP
- Tar bara betalt för lyckade requests
Fördelar: Utmärkt träffsäkerhet mot svåra mål.
Nackdelar: Kostnaden stiger snabbt på skyddade arbetsflöden. En sida som behöver både JS-rendering och premium proxy kostar 25 credits i stället för 1, så $19-planen som ser ut som 45,000 sidor blir i praktiken 1,800 sidor på svåra mål.
Bäst för: Utvecklare som skrapar svåra mål, anti-bot-tunga övervakningsjobb, team som bryr sig mer om att komma igenom än om kalkylblads-UX.
8. Octoparse
 Octoparse är den klassiska no-code-desktopscrapern: en visuell arbetsflödesbyggare med körning på skrivbordet, molnschemaläggning, inbyggd webbläsarnavigering och ett brett exportutbud. Om Thunderbit är AI-first-alternativet med "ett klick", är Octoparse den visuella flödesbyggaren för användare som vill modellera extraktionslogik steg för steg.
Prissättningen är mer komplex än den ser ut vid första anblicken. Hjälpcentret listar månadspriserna — Basic på $39/mån, Standard från $83/mån och Professional på $299/mån — medan huvudsidan utgår från årlig fakturering, vilket är varför rubrikpriserna där är $69/mån för Standard och $249/mån för Professional. Det är samma planer med två olika faktureringsvillkor, inte två motstridiga prislistor; det verkliga glappet är Basic, som prissidan inte visar alls. Kontrollera därför alltid vilket faktureringsvillkor ett pris avser innan du jämför med något annat. Prissidan lyfter också tillägg som residential proxies, CAPTCHA-lösning, crawler-setup och helt hanterad datatjänst.
Nyckelfunktioner:
- Mogen visuell arbetsflödesbyggare
- Brett exportstöd: Excel, CSV, JSON, HTML, XML, Google Sheets, databaser
- Molnschemaläggning och automation inbyggt
- Scraper-mallar för vanliga sajter
Fördelar: Ingen kod krävs, bra för återkommande scraping i medelstor skala, breda exportmöjligheter.
Nackdelar: Mer underhåll än AI-native-verktyg när layouter ändras (selector-baserat). Dynamiska eller skyddade sajter kan fortfarande skapa friktion. Desktop-först-UX kan kännas tyngre än browser-först-verktyg.
Bäst för: No-code-användare som vill ha mer kontroll än en enkel AI-prompt, återkommande scraping i medelstor skala, team som trivs med visuella flöden.
9. Diffbot
 Diffbot är den mest enterprise-klassade AI-extraktionsplattformen i listan. Deras pitch är inte "skrapa den här sidan" utan "förstå vilken sidtyp det är och omvandla den till strukturerad data i stor skala." Produkter inkluderar Extract, Crawl, Natural Language och Knowledge Graph.
Prissättningen börjar gratis med 10,000 credits, sedan $299/mån för Startup (250,000 credits), $899 för Plus (1,000,000 credits) och anpassade enterprise-avtal. En standardiserad extraherad webbsida kostar en credit; export av Knowledge Graph-poster är betydligt dyrare.
Nyckelfunktioner:
- Stark automatisk förståelse för sidtyper (artiklar, produkter, diskussioner)
- Mycket bra för att bygga knowledge graphs och entity-pipelines
- NLP-baserad extraktion — inga selectors behövs
- Premiumsupport och enterprise-positionering
Fördelar: Kraftfull AI-förståelse av sidstruktur, utmärkt för knowledge graph-byggande.
Nackdelar: Dyrt för små eller sporadiska projekt. DQL- och KG-flöden har en inlärningskurva. Överkurs för enkel scraping till kalkylblad.
Bäst för: Företag som bygger strukturerade datamängder, knowledge graph- och entity resolution-projekt, NLP-tunga ingest-pipelines.
10. Firecrawl
 Firecrawl är det mest utvecklarnära verktyget för LLM-ingest i gruppen. Det omvandlar URL:er till ren Markdown, HTML, screenshots eller strukturerad JSON, och är byggt runt ett enkelt API snarare än en visuell app.
Prissättningen är tydlig: gratis med 1,000 credits per månad, Hobby med 5,000 credits, Standard med 100,000, Growth med 500,000, Scale med 1,000,000 och Enterprise över det. Startplanen är $19/mån, eller $16/mån vid årlig fakturering.
Nyckelfunktioner:
- Ren Markdown-utdata för RAG och LLM-pipelines
- Stöd för strukturerad JSON med schema eller prompt
- Bra utvecklardokumentation och aktiv open source-användning
- Stark samtidighet på högre planer
Fördelar: Byggt för att mata data till LLM:er. Prisvärd startnivå. Ren utdata.
Nackdelar: Byggt för utvecklare. Det finns en playground och ett antal gratis engångsverktyg, men inget av dem kör återkommande jobb — allt du vill schemalägga, batcha eller koppla in i en pipeline blir ett API-anrop eller ett SDK-anrop. Credits går ut i slutet av månaden på alla planer under $749 Scale-nivån. Och planstegen har ett hopp i mitten: kredit-slidern går 5,000, 6,500, 8,000 sidor i månaden och hoppar sedan direkt till 100,000 — $99 Standard-planen.
Bäst för: RAG-pipelines, AI-agenter, innehållsingest och analys.
11. Browse AI
 Browse AI förstås bäst som en övervakningsprodukt som också skrapar, inte bara som en scraper som också övervakar. Dess starkaste användningsområde är återkommande förändringsdetektering: priser, lager, text, screenshots och sidändringar över tid.
Prissättningen börjar med en gratisplan på 50 credits i månaden, sedan Personal på $48/mån för 2,000 credits och Professional på en slider — $87 för 5,000 credits, $162 för 10,000, upp till $399 för 30,000 — med Premium från $500/mån vid årlig fakturering. Vid årlig fakturering kostar Personal $19/mån och Professional $69. Credits förbrukas baserat på rader och uppgiftens komplexitet: en sida du öppnar för dess egen data är en uppgift med minst en credit, tio rader kostar också en credit, och premiumsajter kostar två till tio gånger mer.
Nyckelfunktioner:
- Utmärkt orientering mot övervakning och aviseringar
- Bra för återkommande pris- eller lagerkontroller
- Integrerar med Sheets, Airtable, webhooks och API-flöden
- Snabb första uppsättning för icke-tekniska användare
Fördelar: Perfekt för "vad har ändrats"-användningsfall, enkel setup för icke-utvecklare.
Nackdelar: Mindre flexibel än allmänna scrapers på okända eller komplexa sajter. Begränsad inbyggd AI-transformation jämfört med Thunderbit.
Bäst för: E-handels-team som bevakar konkurrentpriser, icke-tekniska användare som behöver ändringslarm.
12. ScrapeHero
 ScrapeHero är undantaget här eftersom det inte främst är ett mjukvaruverktyg. Det är en managed scraping-tjänst. Du berättar vilken data du behöver, och deras team bygger, underhåller, kvalitetssäkrar och levererar datamängden.
Prissättningen speglar tjänstemodellen: on-demand-projekt börjar på $550 per sajt, månadsplanen Business från $199 för upp till två sajter med 1–5K sidor vardera, Enterprise Basic från $1,500/mån för upp till fyra sajter med sidor fördelade över dem och extra volym för $650–$2,200 per miljon, och Enterprise Premium från $8,000. En separat engångsavgift för uppsättning tillkommer på Business och Enterprise Basic. Leveransprocessen inkluderar dedikerade projektteam, mänsklig QA och anpassade format.
Nyckelfunktioner:
- Nära nog noll underhåll för kunden
- Mänsklig QA och anpassade leveransformat
- Bra för komplexa projekt med flera sajter
- Compliance-profil för enterprise-krav
Fördelar: Inget underhåll, hanterar komplexa projekt, white-glove-service.
Nackdelar: Dyrt jämfört med självserviceverktyg. Långsammare initial leverans än att göra det själv. Inte självservice alls.
Bäst för: Företag som outsourcar scraping, team som bryr sig mer om leverans än verktygsägande, komplexa fler-sajtsprojekt med ofta återkommande ändringar.
Den verkliga kostnaden för web scraping-tjänster vid 10K, 100K och 1M sidor
Att jämföra dessa tjänster på pris är knepigt eftersom leverantörerna fakturerar i olika enheter — sidor, poster, credits, beräkningstid, rader eller projektminima. Tabellen nedan visar därför det enda tal som faktiskt överlever översättningen: vad ditt kort blir belastat med den månaden. Varje belopp är ett månadspris på den billigaste plan som täcker volymen i vanliga sidor — ingen JavaScript-rendering, inga premium-proxies — med leverantörens egen månatliga gratisnivå redan bortdragen. Proxyavgifter, CAPTCHA-tillägg och ingenjörstid är aldrig inbakade i siffran; de anges i sista kolumnen. Där ingen publicerad nivå räcker till volymen anges Custom quote i stället för att tänja ut toppnivån. Och där en leverantör inte säljer per sida, anger vi vad den faktiskt säljer i stället för att hitta på ett sidpris.
| Tjänst | Gratis nivå | Månatlig nota vid 10K sidor | Månatlig nota vid 100K sidor | Månatlig nota vid 1M sidor | Hur den mäts, och vad siffran inte inkluderar |
|---|---|---|---|---|---|
| Thunderbit API | 600 enheter, engångs | $72 Pro 1 | $120 Pro 2 | Custom quote | Distill debiterar 1 enhet per sida, Extract 20. De fria enheterna är en engångsgåva, inte en månatlig kvot, så inget dras av. Självservice slutar vid 480,000 enheter i månaden. |
| Bright Data | 5,000 poster/mån | $7.50 för 10K poster | $142.50 för 100K poster | $1,293 för 1M poster | Debiterar per post — ett extraherat objekt, en rad i tabellen — inte per laddad sida, så en list-sida kan motsvara många poster. De 5,000 fria posterna dras av i alla tre fallen. Vid 1M slår Scale pay-as-you-go: $499 plus 611,000 extra poster à $1.30/1K. |
| Oxylabs | Testperiod, 2K resultat | $49 Micro | $249 Advanced | $999 Business | Debiterar per lyckat resultat till en sats som styrs av målsajt och plan. De marknadsförda resultatantalet utgår från Amazon utan JS-rendering — på en generell sajt för $1.15 per 1,000 blir $49 Micro-planen ungefär 42,600 resultat, inte 98,000. Testresultat förnyas inte, så inget dras av. |
| Apify | $5 användning/mån | Från $29/mån plus användning | Från $29/mån plus användning | Från $29/mån plus användning | Debiteras inte per sida. Planavgiften är förbetald användning — $29 Starter, $199 Scale, $999 Business — som används på compute units och på Store Actors som själva sätter pris per resultat, så sidantalet ensamt avgör inte notan. Proxies är ett separat tillägg. |
| ScrapingBee | 1,000 credits, engångs | $49 Freelance | $49 Freelance | $99 Startup | 1 credit per vanlig request. JS-rendering, premium proxies, screenshots och AI-extraktion kostar alla flera credits, så på ett riktigt mål köper du betydligt färre sidor än rubrikantalet. Signup-credits förnyas inte, så inget dras av. |
| ScraperAPI | 7-dagars test, 5,000 credits | $49 Hobby | $49 Hobby | $149 Startup | 1 credit per vanlig request, men 5 på Amazon och 25 på Google. Vid 100K sidor är Hobby-planen helt fylld, med inget kvar för ett retry-försök. Testcredits förnyas inte, så inget dras av. |
| ZenRows | 5,000 credits/mån | $19 Build | $39 Build | $199 Growth | 1 credit per vanlig sida, 25 för en som kräver både JS och premium proxy. De fria 5,000 credits dras av först — 5,000, 95,000 och 995,000 debiterbara sidor — vilket inte ändrar vilket steg du hamnar på. |
| Octoparse | Gratis plan, 10 uppgifter | Från $39/mån | Från $39/mån | Från $39/mån | Prissätts efter antal uppgifter och molnsamtidighet, inte per sida, så ingen sidvolym mappar direkt till en nivå: Basic $39, Standard $83, Professional $299 månad-för-månad. Residential proxies och CAPTCHA-lösning säljs som tillägg: $3/GB och $1–1.5 per tusen lösningar. |
| Diffbot | 10,000 credits/mån | $0, gratisnivån räcker | $299 Startup | $899 Plus | 1 credit per extraherad sida. De 10,000 gratis credits per månad dras av här precis som överallt annars: vid 10K täcker de hela månaden, vid 100K återstår 90,000 sidor att betala för, vid 1M återstår 990,000. |
| Firecrawl | 1,000 credits/mån | $99 Standard | $99 Standard | $749 Scale | 1 credit per skrapad sida. När de fria credits dras av återstår 9,000 sidor att köpa vid 10K-nivån, fortfarande över Hobby-planens 5,000, så nivån ändras inte. Credits rullar inte över under Scale. |
| Browse AI | 50 credits/mån | $162 Professional | Custom quote | Custom quote | Debiterar i credits: en detaljsida är en uppgift med minst en credit, och tio rader kostar också en credit, så en list-sida med femtio rader kostar fem. Premiumsajter kostar två till tio gånger mer. Självservice slutar vid 30,000 credits i månaden, så allt över det offereras. |
| ScrapeHero | Ingen | Från $199/mån | Från $1,500/mån | Från $1,500/mån | Prissätts per sajt, komplexitet och uppdateringsfrekvens snarare än per sida: Business täcker upp till 2 sajter med 1–5K sidor vardera, Enterprise Basic buntar sidor över upp till 4 sajter och lägger till $650–$2,200 per extra miljon. Setupavgifter är engångsavgifter och faktureras separat. |
Några viktiga saker att notera:
- Thunderbits browser-produkt är radbaserad och användarvänd, så raden ovan använder API:t — och specifikt Distill-endpointen, 1 enhet per sida Markdown, eftersom det är så de andra API-raderna fungerar. Structured Extract kostar 20 enheter per sida, vilket skulle göra 10K sidor till $240 i stället för $72.
- Apifys kostnad beror mycket på actor-körtid, minne och tilläggstjänster som proxies.
- ZenRows, ScrapingBee och ScraperAPI ser alla billiga ut på enkla publika sidor men blir snabbt dyrare när JS-rendering, premium-proxies eller anti-bot-tunga mål kommer in i bilden.
- ScrapeHeroes enhetslogik är annorlunda eftersom du betalar för ingenjörsarbete, QA och projektledning — inte bara beräkning.
Den dolda kostnaden som nästan varje prissida tonar ned är underhåll. Proxy-kostnader ser billigare ut på pappret, men när du lägger till retries, parser-underhåll, blockerade sessioner och ingenjörstid vinner ofta bundlade scraping-tjänster på total ägandekostnad.
Om du bara skrapar ibland är no-code-sidan billigast att börja på: Thunderbits gratisplan inkluderar 6 sidor i månaden, och dess betalda browser-planer börjar på $15/mån, eller ungefär $9/mån vid årlig fakturering. API-tjänsterna här är inte enhetligt dyrare vid dörren — ZenRows och Firecrawl börjar båda på $19/mån — men det minsta block någon av dem säljer är tusentals sidor i månaden, så du betalar för kapacitet du inte använder. För enterprise-pipelines på 1M+ sidor blir fullstack-plattformar eller managed services mer ekonomiska trots högre listpris, eftersom de paketerar proxykostnaderna.
Vart tar din skrapade data vägen? Jämförelse av export och integration
JSON är inte samma sak som Google Sheets. För icke-utvecklare är målet för den skrapade datan minst lika viktigt som själva extraktionen.
| Tjänst | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM/API/Webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Inbyggt | ✅ Inbyggt | ✅ Inbyggt | API tillgängligt |
| Bright Data | ✅ | ✅ | ❌ Ingen native | Indirekt | Indirekt | Indirekt | Starkt API/webhook |
| Oxylabs | ✅ | ✅ | ❌ Ingen native | Indirekt | Indirekt | Indirekt | Starkt API |
| Apify | ✅ | ✅ | ✅ | Via integrationer | Via integrationer | Via integrationer | Starkt API |
| ScrapingBee | Via verktyg | ✅ | ❌ | ❌ | ❌ | ❌ | Starkt API |
| ScraperAPI | ✅ på strukturerade endpoints | ✅ | ❌ | ❌ | ❌ | ❌ | Starkt API/webhook |
| ZenRows | Begränsat | ✅ | ❌ | ❌ | ❌ | ❌ | Starkt API |
| Octoparse | ✅ | ✅ | ✅ | ✅ Inbyggt | ⚠️ Via Zapier | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | Stödda flöden | Indirekt | Indirekt | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Inbyggt | ✅ Inbyggt | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | Skräddarsydd leverans | Skräddarsydd leverans | Skräddarsydd leverans | Anpassad API/DB-leverans |
Det här är en av Thunderbits tydligaste fördelar. Om du är ett affärsteam som lever i Google Sheets eller Notion lägger API-endast-tjänster till extra steg: skriv kod för att transformera JSON, ladda upp manuellt, upprepa. Thunderbits gratis export till Sheets, Airtable och Notion — inklusive bilduppladdningar till Notion och Airtable — tar bort den här friktionen helt. Tillsammans med schemalagd scraping kan data flöda automatiskt till en specifik destination med regelbunden frekvens utan någon limkod.
Vad händer när webbplatsen ändras? Underhåll och tillförlitlighet
Scrapers går sönder. Det är den främsta smärtan i hela marknaden.
Marknaden delar sig i tre underhållsprofiler:
- Selector-baserade verktyg (Octoparse, många Apify actors, Browse AI-mallar): går sönder när sajter ändrar layout, kräver manuella regeluppdateringar.
- API-tjänster med parser-abstraktioner (ScraperAPI strukturerade endpoints, Bright Data strukturerade datasets): hanterar vanliga sajter väl men har svårare på långsvans- eller nischsidor där parsern inte var förbyggd.
- AI-drivna verktyg (Thunderbit, Firecrawl, Diffbot): läser sidan på nytt varje gång, så de flesta layoutändringar kräver inga regeluppdateringar. Felmodellen flyttas från "selector gick sönder" till "AI:n tolkade fel" — vilket oftast är enklare att rätta till med en promptjustering än en fullständig omskrivning av selectors.
Det finns en andra tillförlitlighetsflaska hals utöver layoutförändringar: anti-bot-hantering.
- Bright Data, Oxylabs och ZenRows är starkast här.
- ScraperAPI och ScrapingBee är stabila för vanliga skyddade mål.
- Browse AI och Octoparse har oftare problem på hårt skyddade dynamiska sajter.
- Thunderbits browser mode hjälper på inloggade och personaliserade sidor där API-endast-verktyg ofta kräver mer komplexitet.
Slutsatsen: om du vill ha lägsta underhållsbelastning hanterar AI-driven extraktion (Thunderbit, Firecrawl, Diffbot) layoutförändringar bättre än selector-baserade verktyg. Om din största tillförlitlighetsfråga är anti-bot-skydd är Bright Data, Oxylabs och ZenRows de starkaste alternativen. De flesta team brottas med båda problemen, vilket är varför beslutet om "vilken typ som passar ditt team" högst upp i artikeln är viktigare än någon enskild funktionsjämförelse.
Juridiska och etiska överväganden för web scraping
Att skrapa offentligt tillgänglig data är ofta lagligt, men det betyder inte att alla användningsfall är riskfria. Team bör fortfarande respektera robots.txt där det är relevant, kontrollera användarvillkor och följa integritetslagar som GDPR och CCPA när personuppgifter är inblandade. HiQ v. LinkedIn-rättsfallen stödjer tanken att scraping av offentlig data inte automatiskt är ett CFAA-brott i USA, men avtals-, upphovsrätts- och integritetsfrågor är separata risker. Enterprise-leverantörer som Bright Data, Oxylabs och ScrapeHero marknadsför uttryckligen compliance- och governance-funktioner. För alla andra: ta juridisk rådgivning som är specifik för just ditt användningsfall innan du skrapar i stor skala. För mer bakgrund, se vår guide om web scraping och juridiska konsekvenser.
Vilken web scraping-tjänst ska du faktiskt välja?
Nog med jämförelsetabeller. Här är den korta versionen efter att ha testat alla 12:
Icke-tekniska affärsteam (sälj, drift, marknad): Thunderbit. Ett-klicks AI-scraping, gratis export till Sheets/Airtable/Notion och mycket mindre omarbete när en sajt ändrar layout. Den tar bort de två största friktionskällorna — uppsättningskomplexitet och exportfriktion efter scraping — samtidigt.
Utvecklare som bygger scraping-pipelines:
- ScrapingBee om du vill ha den renaste API-upplevelsen
- ScraperAPI om du vill ha strukturerade endpoints och återkommande e-handelsövervakning
- ZenRows om ditt verkliga problem är anti-bot-skydd
Team som matar data till AI/LLM-flöden:
- Firecrawl om utdata ska vara Markdown eller schema-baserad JSON
- Thunderbit API om samma team också behöver en no-code-väg, eftersom tillägget och API:t kör samma extraktionsmodell
- Diffbot om du bygger ett enterprise-lager av kunskap
Enterprise som behöver massiv skala och proxy-infrastruktur:
- Bright Data för den bredaste enterprise-stacken
- Oxylabs om tillförlitlighet på skyddade mål är viktigast
Team som vill ha en marknadsplats med förbyggda scrapers: Apify.
Företag som vill ha hands-off-leverans: ScrapeHero.
Budgetmedvetna team som behöver no-code-övervakning: Browse AI.
No-code-användare som vill ha en visuell desktop-byggare med mer manuellt kontroll: Octoparse.
För det bredaste spannet av affärsanvändare vinner Thunderbit fortfarande eftersom det tar bort de två hinder som dödar adoption: teknisk setup och exportfriktion. Testa gratisnivån eller hämta Chrome-tillägget för att se själv. Och om Thunderbit inte passar, prova några andra från listan — det har aldrig varit bättre timing för att sluta copy-pasta för hand. För en videogenomgång av hur verktygen fungerar i praktiken, kolla in Thunderbits YouTube-kanal.
Testa Thunderbit Chrome-tillägget
Vanliga frågor
Vad är en web scraping-tjänst?
En web scraping-tjänst är ett verktyg eller en managed leverantör som samlar in data från webbplatser åt dig. Vissa är no-code-appar du kör i webbläsaren, vissa är API:er för utvecklare, och vissa är helt hanterade byråer som levererar rensad data utan att du behöver drifta någon infrastruktur.
Behöver jag kunna koda för att använda web scraping-tjänster?
Inte alltid. Verktyg som Thunderbit, Browse AI och Octoparse är byggda för icke-tekniska användare. API-tjänster som ScrapingBee, ScraperAPI, Firecrawl och ZenRows förutsätter utvecklarinvolvering. ScrapeHero ligger i andra änden — deras team driver hela projektet åt dig.
Vilken web scraping-tjänst är bäst för småföretag?
För de flesta småföretag är Thunderbit det säkraste valet. Det har en gratisplan som inte går ut (6 sidor i månaden), låg startfriktion och direkt export till affärsvänliga destinationer som Google Sheets, Airtable och Notion. Browse AI passar också bra om huvudbehovet är att övervaka förändringar över tid.
Hur mycket kostar web scraping-tjänster?
Spannet är stort. Vissa tjänster erbjuder gratisnivåer eller testperioder. Developer API:erna i den här listan börjar mellan $19 och $49 per månad, och enterprise AI-plattformarna börjar mycket högre — Diffbot på $299. No-code-verktyg börjar ungefär mellan $15 och $48 per månad. Enterprise- och managed services kan snabbt hamna på hundratals eller tusentals dollar per månad. Den större kostnadsbilden handlar inte bara om prenumerationspriset, utan också om multiplikatorer för JS-rendering, premium-proxies och den interna tid som krävs för att hålla scrapers igång.
Är web scraping-tjänster lagliga att använda?
Vanligtvis ja för offentlig data, men lagligheten beror på sajten, datatypen, din jurisdiktion och vad du gör med resultatet. Integritets-, upphovsrätts- och avtalsfrågor spelar fortfarande roll, även när du skrapar offentliga sidor. Konsultera juridisk vägledning för ditt specifika fall.
Testa Thunderbit för AI-web scraping Get Started Free
Läs mer



