
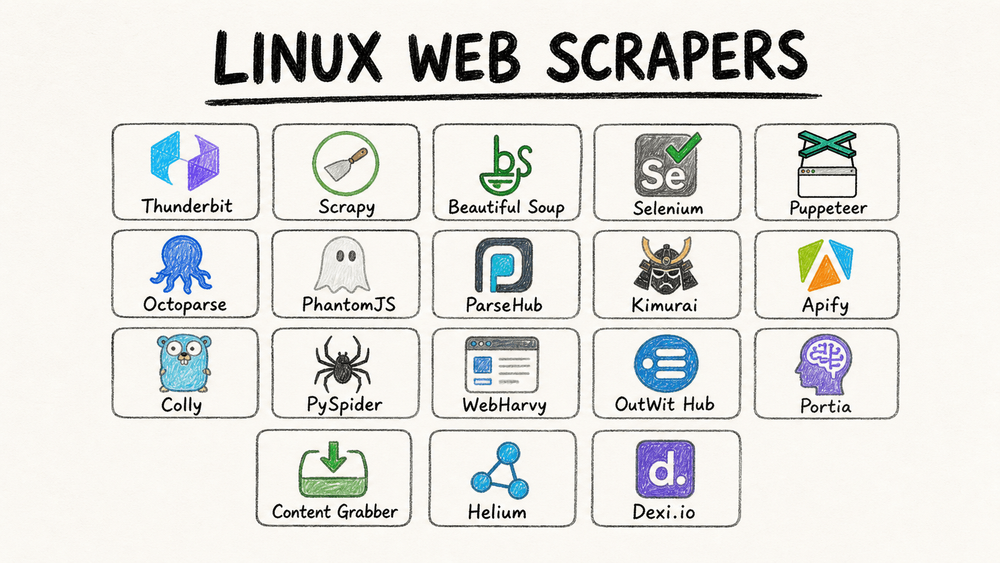
Webben svämmar över av data, och låt oss vara ärliga – ingen har tid att sitta och kopiera och klistra in sig igenom tusen produktlistor eller konkurrenters prissidor. Om du kör Linux (som jag gör för det mesta av mitt automations- och utvecklingsarbete) vet du redan att plattformen är en riktig kraftmaskin för datadrivna team. Faktum är att Unix-baserade system driver 91,9 % av webbplatserna där operativsystemet är känt, där Linux är den klart största identifierade varianten. Men här kommer haken: att hitta rätt web scraper för Linux som faktiskt passar ditt arbetsflöde – oavsett om du är en icke-teknisk affärsanvändare eller en hårdkodande utvecklare – kan kännas som att leta efter en nål i en höstack.
Därför har jag satt ihop den här djupdykningen i de 18 bästa Linux-webbskrapningsverktygen för 2026. Från AI-drivna, kodfria lösningar som Thunderbit (ja, den som mitt team och jag byggt) till klassiska ramverk för utvecklare som Scrapy och Beautiful Soup – den här listan är din genväg till att välja bästa Linux-web scraper för dina behov, utan frustrerande testande och gissande.
Varför Linux-webbskrapningsverktyg är viktiga för affärsanvändare
Slipp kopiera och klistra innan du väljer verktyg Thunderbit körs i Chrome på din Linux-dator — inga paket, inga drivrutiner, bara en strukturerad tabell med ett klick. Get Started Free
Låt oss vara raka: manuell datainsamling dödar produktiviteten. Studier visar att team som förlitar sig på copy-paste slösar bort timmar varje vecka och får felnivåer på nära 5 % – en perfekt grogrund för dyra misstag och missade möjligheter (Thunderbit Blog). Linux, med sin stabilitet, säkerhet och flexibilitet, är förstahandsvalet för att köra skrapare som måste fungera dygnet runt – oavsett om du kör på en dator, en server eller i molnet.
Vanliga affärsanvändningsfall för Linux-webbskrapningsverktyg:
- Leadgenerering: Säljteam skrapar kataloger, sociala medier eller recensionssajter för färska kontakter och slipper det manuella slitet (Thunderbit Blog).
- Prisbevakning: E-handels-team hämtar konkurrenters priser och lagerstatus automatiskt för att hålla sin egen prissättning skarp och aktuell.
- Konkurrentanalys: Marknads- och operations-team följer produktlanseringar, recensioner och SEO-nyckelord – inga fler beslut i blindo.
- Marknadsintelligens: Analytiker samlar in nyheter, forum och social data för att upptäcka trender i realtid.
- Automatisering av arbetsflöden: Vissa verktyg (särskilt AI-drivna) kan till och med automatisera webbflöden, som att fylla i formulär eller navigera dashboards, direkt från din Linux-maskin.
Det bästa av allt? Rätt Linux-webbskrapningsverktyg kan ge även icke-tekniska användare makt – inte bara kodare – att använda webbdata för smartare och snabbare affärsbeslut.
Så valde vi bästa web scraper för Linux
Alla skrapare är inte skapade lika, särskilt inte på Linux. Här är vad jag letade efter:
- Linux-kompatibilitet: Varje verktyg här körs native på Linux, via webbläsare eller med en enkel workaround (som Wine eller molnåtkomst).
- Enkel användning: Från AI-promptar i naturligt språk till visuella point-and-click-gränssnitt prioriterade jag verktyg som låter icke-kodare få resultat snabbt – men jag glömde inte heller de avancerade användarna som vill ha full kontroll.
- Extraktionskraft: Klarar det dynamiskt innehåll, paginering, undersidor och olika datatyper? Klarar det anti-skrapningsskydd?
- Skalbarhet och automatisering: Schemaläggning, molnskrapning, distribuerad crawling – det här är måste-ha för seriösa dataprojekt.
- Integration och export: CSV, Excel, Google Sheets, API:er – om du inte får ut datan, vad är poängen?
- Pris och licens: Gratis, open source eller betald – det finns något för varje budget, från solo-grundare till enterprise-team.
- Community och support: Aktiv användarbas, bra dokumentation och snabb support gör stor skillnad när du kör fast.
Jag har också vävt in riktig användarfeedback, branschrecensioner och min egen hands-on-erfarenhet av verktygen. Nu kör vi listan.
1. Thunderbit
 Thunderbit är mitt förstaval för affärsanvändare som vill ha en web scraper för Linux som faktiskt är lätt att använda. Som ett AI-drivet Chrome-tillägg fungerar det perfekt på Linux (öppna bara Chrome eller Chromium) och låter dig skrapa data från vilken webbplats som helst med ett klick.
Det som gör Thunderbit unikt:
- Promptar i naturligt språk: Beskriv bara vad du vill ha (“Extrahera alla produktnamn och priser från den här sidan”) så tar Thunderbits AI hand om resten.
- AI föreslår fält: Klicka en gång så skannar Thunderbit sidan och föreslår kolumner och datatyper – ingen manuell fältmarkering.
- Skrapning av undersidor och paginering: Behöver du mer detaljer? Thunderbit kan besöka varje undersida (till exempel produktsidor) och berika din tabell automatiskt.
- Moln- eller lokal skrapning: Skrapa upp till 50 sidor samtidigt i molnet, eller använd webbläsarläge för sajter som kräver inloggning.
- Direkt export: Exportera med ett klick till Excel, Google Sheets, Airtable, Notion, CSV eller JSON – alltid gratis.
- Extra funktioner: Extrahera e-postadresser, telefonnummer och bilder med ett klick. AI autofill kan även automatisera formulärinmatning.
Pris: Gratis nivå (6 sidor/månad), betalplaner från $15/månad för 500 rader (Thunderbit Pricing). Användare älskar att det finns “ingen inlärningskurva” och att det “förvandlar timmar av arbete till minuter” (Product Hunt Reviews). För stora jobb kan du behöva dela upp körningarna i mindre omgångar, men för de flesta affärsbehov sparar det enormt mycket tid.
Linux-kompatibilitet: 100 %. Kör bara Chrome/Chromium på din Linux-dator eller server.
Bäst för: Icke-tekniska affärsanvändare (sälj, marknad, operations) som vill ha snabbast och enklast möjliga setup.
Testa Thunderbit gratis på Linux Körs i Chrome på alla Linux-datorer — inga paket att bygga, inga drivrutiner att installera, ett klick för att extrahera. Get Started Free
2. Scrapy
 Scrapy är guldstandarden för Python-utvecklare som vill ha en flexibel och skalbar web scraper för Linux. Det är open source, blixtsnabbt (asynkron crawling) och kan hantera allt från enkla skrapningar till massiva, distribuerade crawls.
Nyckelfunktioner:
- Asynkron, höghastighets-crawling – perfekt för att skrapa tusentals sidor.
- Mycket utbyggbart: tillägg för proxies, CAPTCHA och mer.
- Integreras med Python-stacken: export till JSON, CSV, databaser eller pandas.
- Hanterar cookies, sessioner och automatisk throttling.
Pris: 100 % gratis och open source.
Linux-kompatibilitet: Native (installera via pip). Fungerar utmärkt på servrar och containers.
Bäst för: Utvecklare som bygger anpassade skrapare i stor skala.
Obs: Det finns en inlärningskurva för icke-kodare, men om du kan Python är Scrapy svårslaget.
3. Beautiful Soup
 Beautiful Soup är ett lättviktigt Python-bibliotek för tolkning av HTML och XML. Det är ett självklart val för snabb och enkel skrapning eller för att städa upp röriga webbsidor.
Nyckelfunktioner:
- Enkelt, mänskligt API – perfekt för nybörjare.
- Passar bra ihop med requests för att hämta sidor.
- Hanterar trasig HTML på ett smidigt sätt.
Pris: Gratis och open source.
Linux-kompatibilitet: 100 % (ren Python).
Bäst för: Utvecklare och dataanalytiker som gör små till medelstora skrapnings- eller tolkningsuppgifter.
Begränsningar: Klarar inte JavaScript eller dynamiskt innehåll – kombinera med Selenium eller Puppeteer om du behöver det.
4. Selenium
 Selenium är det klassiska ramverket för webbläsarautomatisering. Det låter dig styra Chrome, Firefox eller andra webbläsare för att skrapa dynamiska sajter med mycket JavaScript.
Nyckelfunktioner:
- Automatiserar riktiga webbläsare – kan logga in, klicka, scrolla och interagera som en människa.
- Stöd för Python, Java, C# med flera.
- Headless-läge för körning på Linux-servrar.
Pris: Gratis och open source.
Linux-kompatibilitet: Fullt stöd (installera bara rätt webbläsardrivrutin).
Bäst för: QA-ingenjörer, scrapingutvecklare och alla som behöver simulera användarbeteende.
Obs: Resurskrävande och långsammare än rena HTTP-skrapare, men ibland är det enda sättet att få tag på datan.
5. Puppeteer
 Puppeteer är ett Node.js-bibliotek från Google för att styra headless Chrome/Chromium. Det är lite som Selenium, men med ett modernt JavaScript-API och tät integration med Chromes funktioner.
Nyckelfunktioner:
- Kör JavaScript, hanterar dynamiskt innehåll och tar skärmbilder.
- Snabbt, stabilt och lätt att använda för Node.js-utvecklare.
- Kan avlyssna nätverksanrop och blockera oönskade resurser.
Pris: Gratis och open source.
Linux-kompatibilitet: Installerar Chromium automatiskt; fungerar headless som standard.
Bäst för: Utvecklare som skrapar moderna webbappar eller single-page-sajter.
6. Octoparse
 Octoparse är en kodfri web scraper med drag-and-drop-gränssnitt och mängder av färdiga mallar. Även om skrivbordsappen bara finns för Windows/Mac kan Linux-användare nå Octoparses molnplattform via webbläsare eller köra Windows-appen med Wine.
Nyckelfunktioner:
- Över 100 färdiga skrapmallar för sajter som Amazon, eBay, Zillow med flera.
- Visuell arbetsflödesdesigner – peka och klicka för att bygga din skrapare.
- Molnskrapning och schemaläggning – låt Octoparses servrar göra det tunga jobbet.
- Export till Excel, CSV, JSON och databaser.
Pris: Gratis nivå (10 uppgifter, cirka 50 000 rader/månad). Betalplaner från $69/månad för Standard (faktureras årligen); Professional kostar $249/månad. (Octoparse Pricing)
Linux-kompatibilitet: Moln/webbåtkomst; skrivbordsapp via Wine.
Bäst för: Icke-kodare som snabbt behöver e-handels- eller marknadsplatsdata.
7. PhantomJS
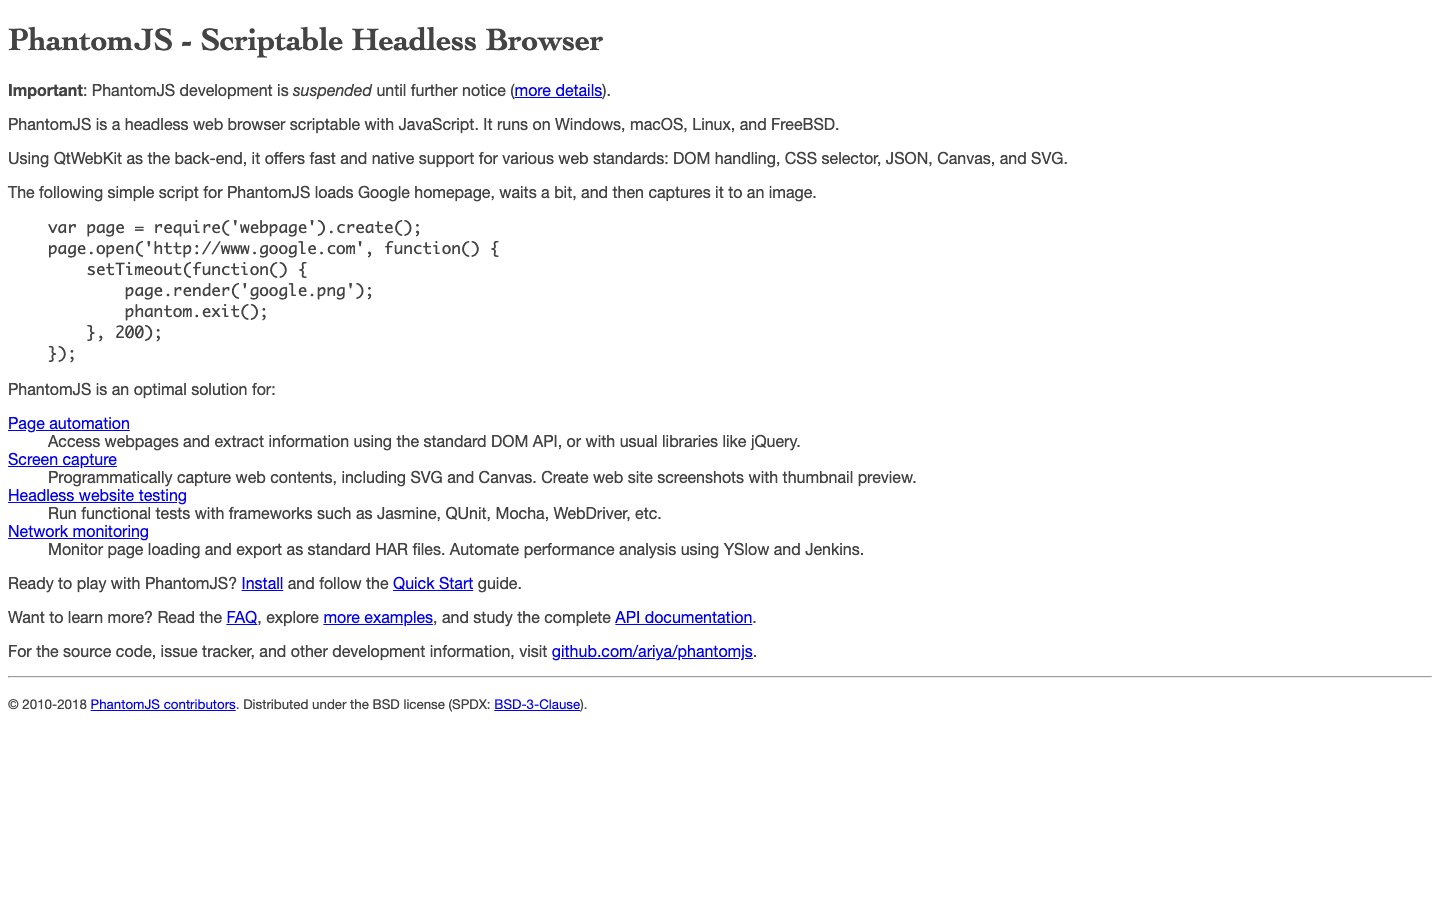 PhantomJS är en headless WebKit-webbläsare som en gång var förstahandsvalet för lätt webbläsarautomatisering. Den är numera deprecated, men körs fortfarande på Linux för äldre eller enklare uppgifter.
Nyckelfunktioner:
- Skriptbar i JavaScript.
- Hanterar måttligt JavaScript och tar skärmbilder/PDF:er.
- Ingen GUI krävs.
Pris: Gratis och open source.
Linux-kompatibilitet: Native binär.
Bäst för: Äldre projekt eller miljöer där Chrome inte kan installeras.
Viktigt: Officiellt deprecated 2017 och utvecklingen stoppades i mars 2018; sista versionen var v2.1.1. Inga säkerhetsuppdateringar, ingen modern JS-motor, och den fungerar dåligt på de flesta moderna sajter. För nya projekt bör du använda Puppeteer eller Playwright i stället. Den finns med här eftersom den fortfarande dyker upp i äldre Linux-skrapningsstackar som du kan ärva.
8. ParseHub
 ParseHub är en visuell, plattformsoberoende web scraper med en native Linux-app. Den är utmärkt för icke-kodare som vill skrapa komplexa, dynamiska sajter.
Nyckelfunktioner:
- Point-and-click-gränssnitt – välj element och bygg arbetsflöden visuellt.
- Hanterar dynamiskt innehåll, kartor, infinite scroll med mera.
- Molnkörning och schemaläggning.
- Export till CSV, JSON eller via API.
Pris: Gratis plan (5 projekt), betalplaner från $189/månad.
Linux-kompatibilitet: Native app för Linux, Windows och Mac.
Bäst för: Analytiker och semitekniska användare som vill ha kontroll utan att koda.
9. Kimurai
 Kimurai är ett Ruby-baserat webbscraping-ramverk med inbyggt Linux-stöd. Det är lite som Scrapy, fast för Ruby-utvecklare.
Nyckelfunktioner:
- Stöd för flera webbläsare: Headless Chrome, Firefox, PhantomJS eller vanlig HTTP.
- Asynkron bearbetning för hög samtidighet.
- Ren Ruby-DSL för att skriva spiders.
Pris: Gratis och open source.
Linux-kompatibilitet: 100 % (Ruby).
Bäst för: Ruby-utvecklare eller Rails-team som behöver anpassad scraping med hög samtidighet.
10. Apify
 Apify är en molnbaserad plattform för webbskrapning med open-source SDK:er och en marknadsplats med färdiga “actors”. Du kan köra skrapare på din Linux-maskin eller i molnet.
Nyckelfunktioner:
- SDK:er för Node.js, Python och fler.
- Marknadsplats med färdiga skrapare.
- Molnkörning, schemaläggning och API-integration.
Pris: Gratis nivå, pay-as-you-go för molnanvändning.
Linux-kompatibilitet: CLI/SDK fungerar på Linux; molnplattformen nås via webbläsare.
Bäst för: Utvecklare som vill kombinera egen kod med färdig molninfrastruktur.
11. Colly
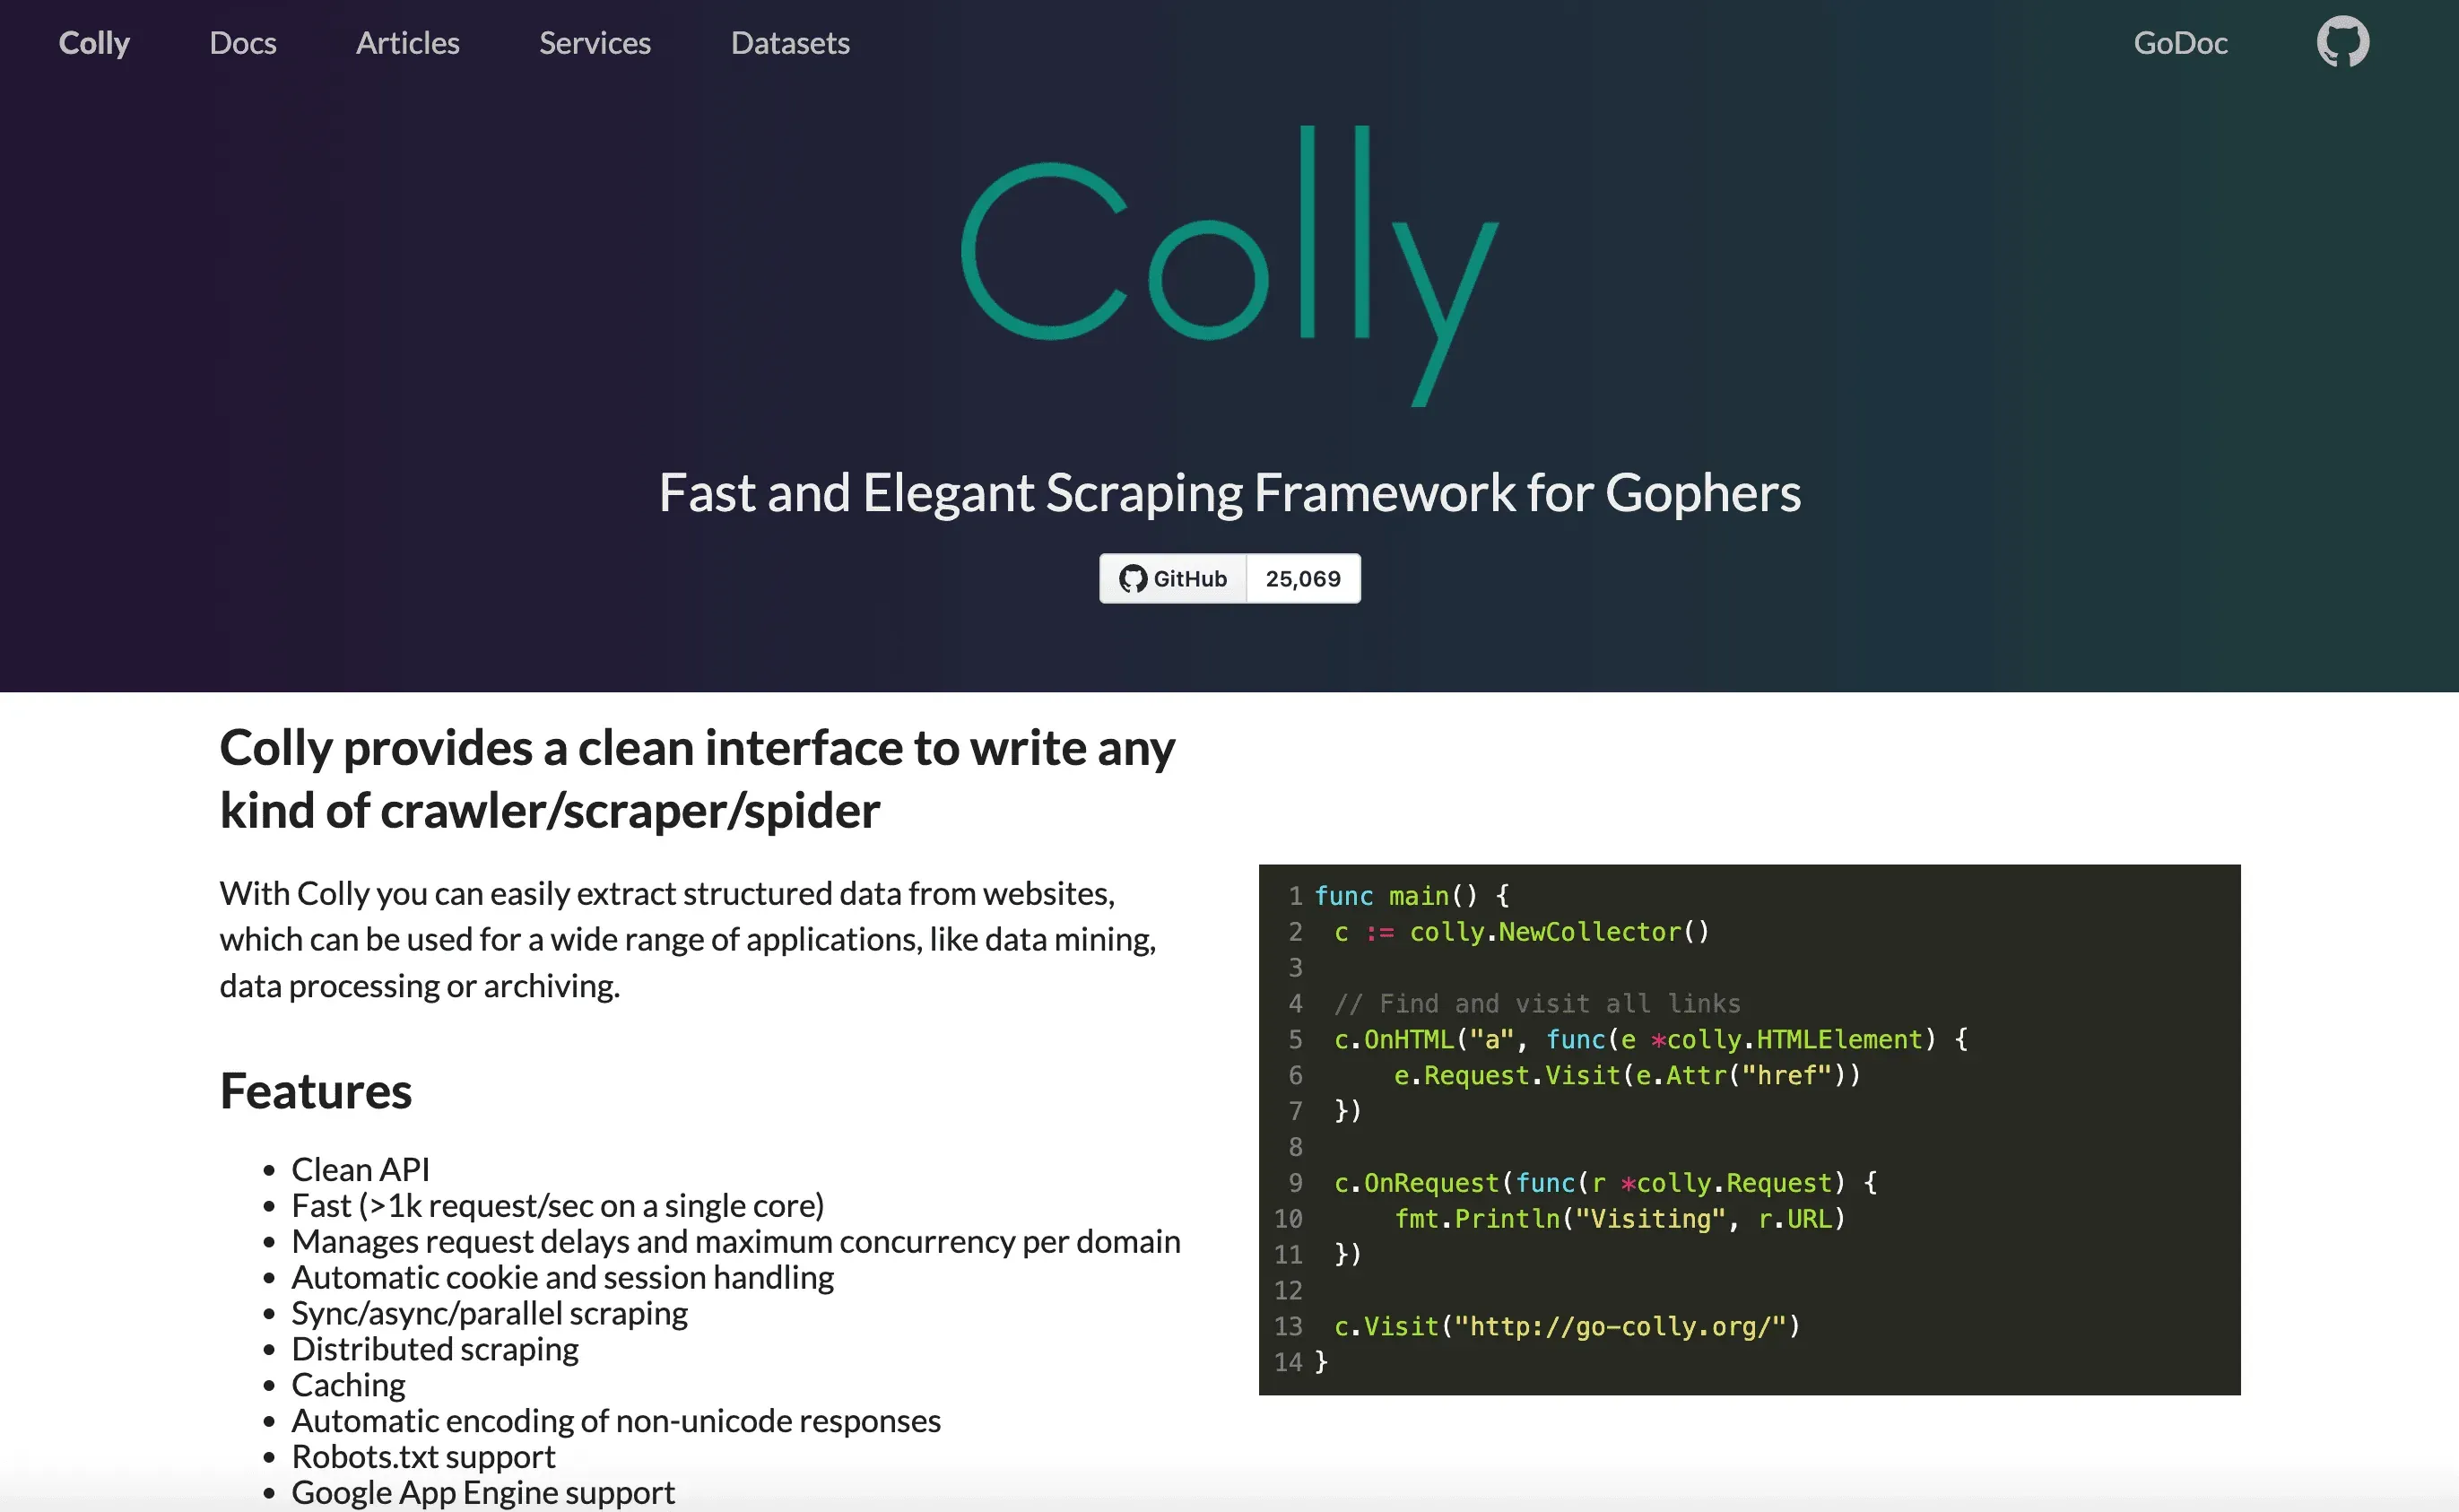 Colly är ett Go-baserat webbscraping-ramverk byggt för hastighet och effektivitet. Om du är Go-utvecklare är det här ditt verktyg.
Nyckelfunktioner:
- Super-snabb, samtidig skrapning – över 1 000 förfrågningar per sekund på en enda kärna.
- Artigt crawlande (respekterar robots.txt), hantering av sessioner/cookies.
- Låg minnesförbrukning.
Pris: Gratis och open source.
Linux-kompatibilitet: Native Go-binärer.
Bäst för: Go-utvecklare som behöver högpresterande scraping.
12. PySpider
 PySpider är ett Python-baserat webcrawler-system med webbgränssnitt – du kan hantera, schemalägga och övervaka crawls direkt i webbläsaren. Värt att nämna direkt: repot är markerat som ett offentligt arkiv på GitHub och originalförfattaren släpper inga nya versioner, så det är vad det är. Om du bara behöver dess UI/dashboard-mönster på Linux fungerar det fortfarande; för allt du planerar att förlita dig på långsiktigt bör du se det som ett legacy-verktyg.
Nyckelfunktioner:
- Webbaserat gränssnitt för skriptning och övervakning.
- Distribuerad crawling, schemaläggning och återförsök.
- Integreras med databaser och meddelandeköer.
Pris: Gratis och open source.
Linux-kompatibilitet: Utformat för Linux-driftsättning.
Bäst för: Team som är bekväma med att forka och själva underhålla ett webbgränssnitt för scraping i flera projekt (förvänta dig inga uppdateringar upstream).
13. WebHarvy
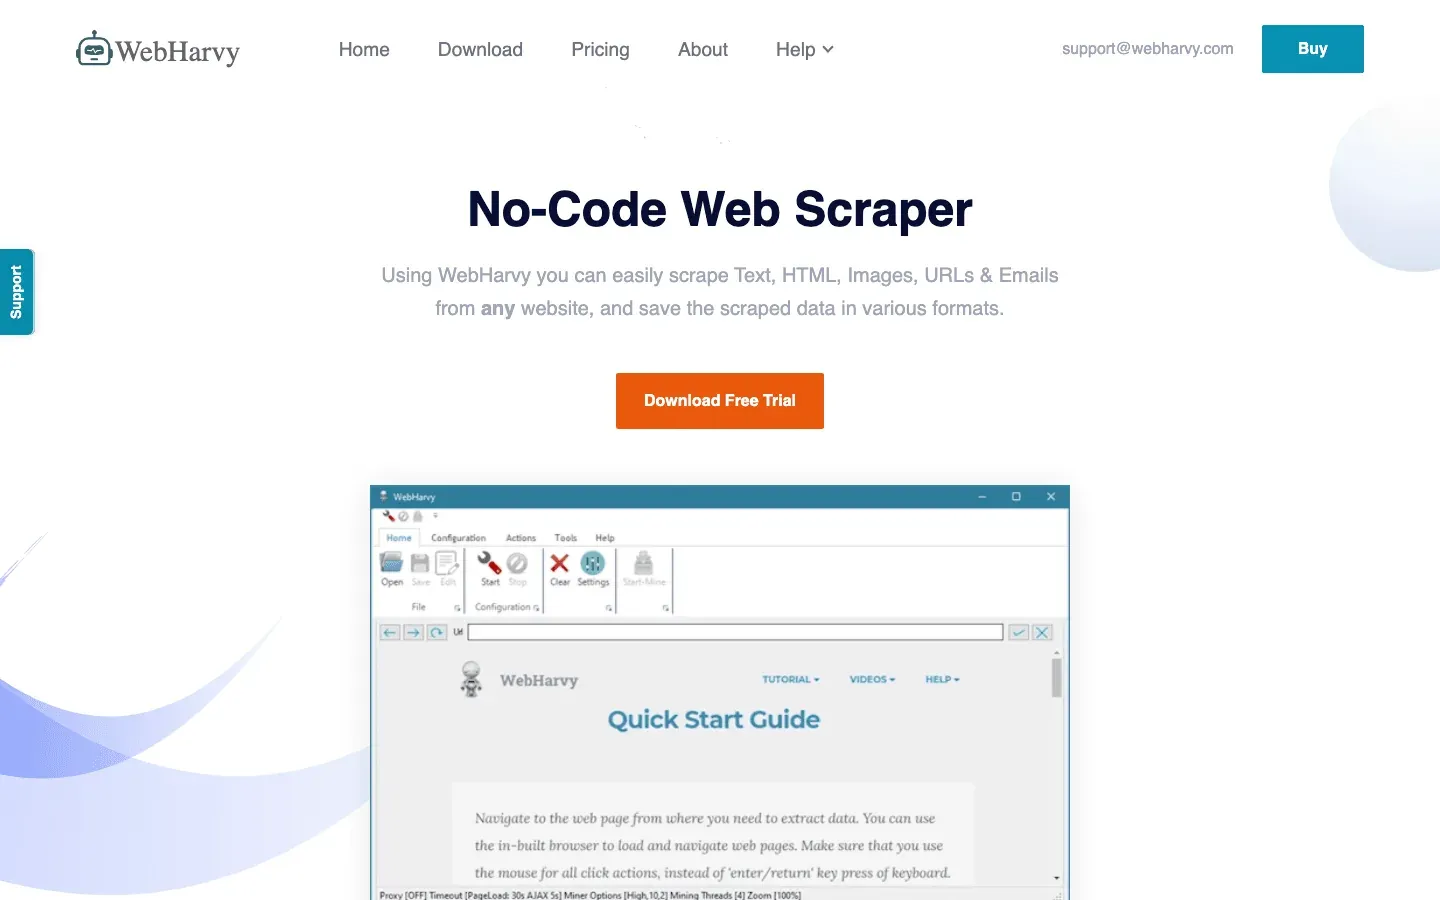 WebHarvy är en visuell point-and-click-skrapare för Windows, men Linux-användare kan köra den via Wine. Den är känd för sin mönsterigenkänning och sin engångslicensmodell.
Nyckelfunktioner:
- Bläddra och klicka för att välja data – ingen kodning behövs.
- Automatisk mönsterigenkänning för listor.
- Export till CSV, JSON, XML, SQL.
Pris: Cirka $129 i engångslicens.
Linux-kompatibilitet: Körs via Wine eller VM.
Bäst för: Nybörjare eller solo-proffs som vill ha en snabb, visuell skrapare.
14. OutWit Hub
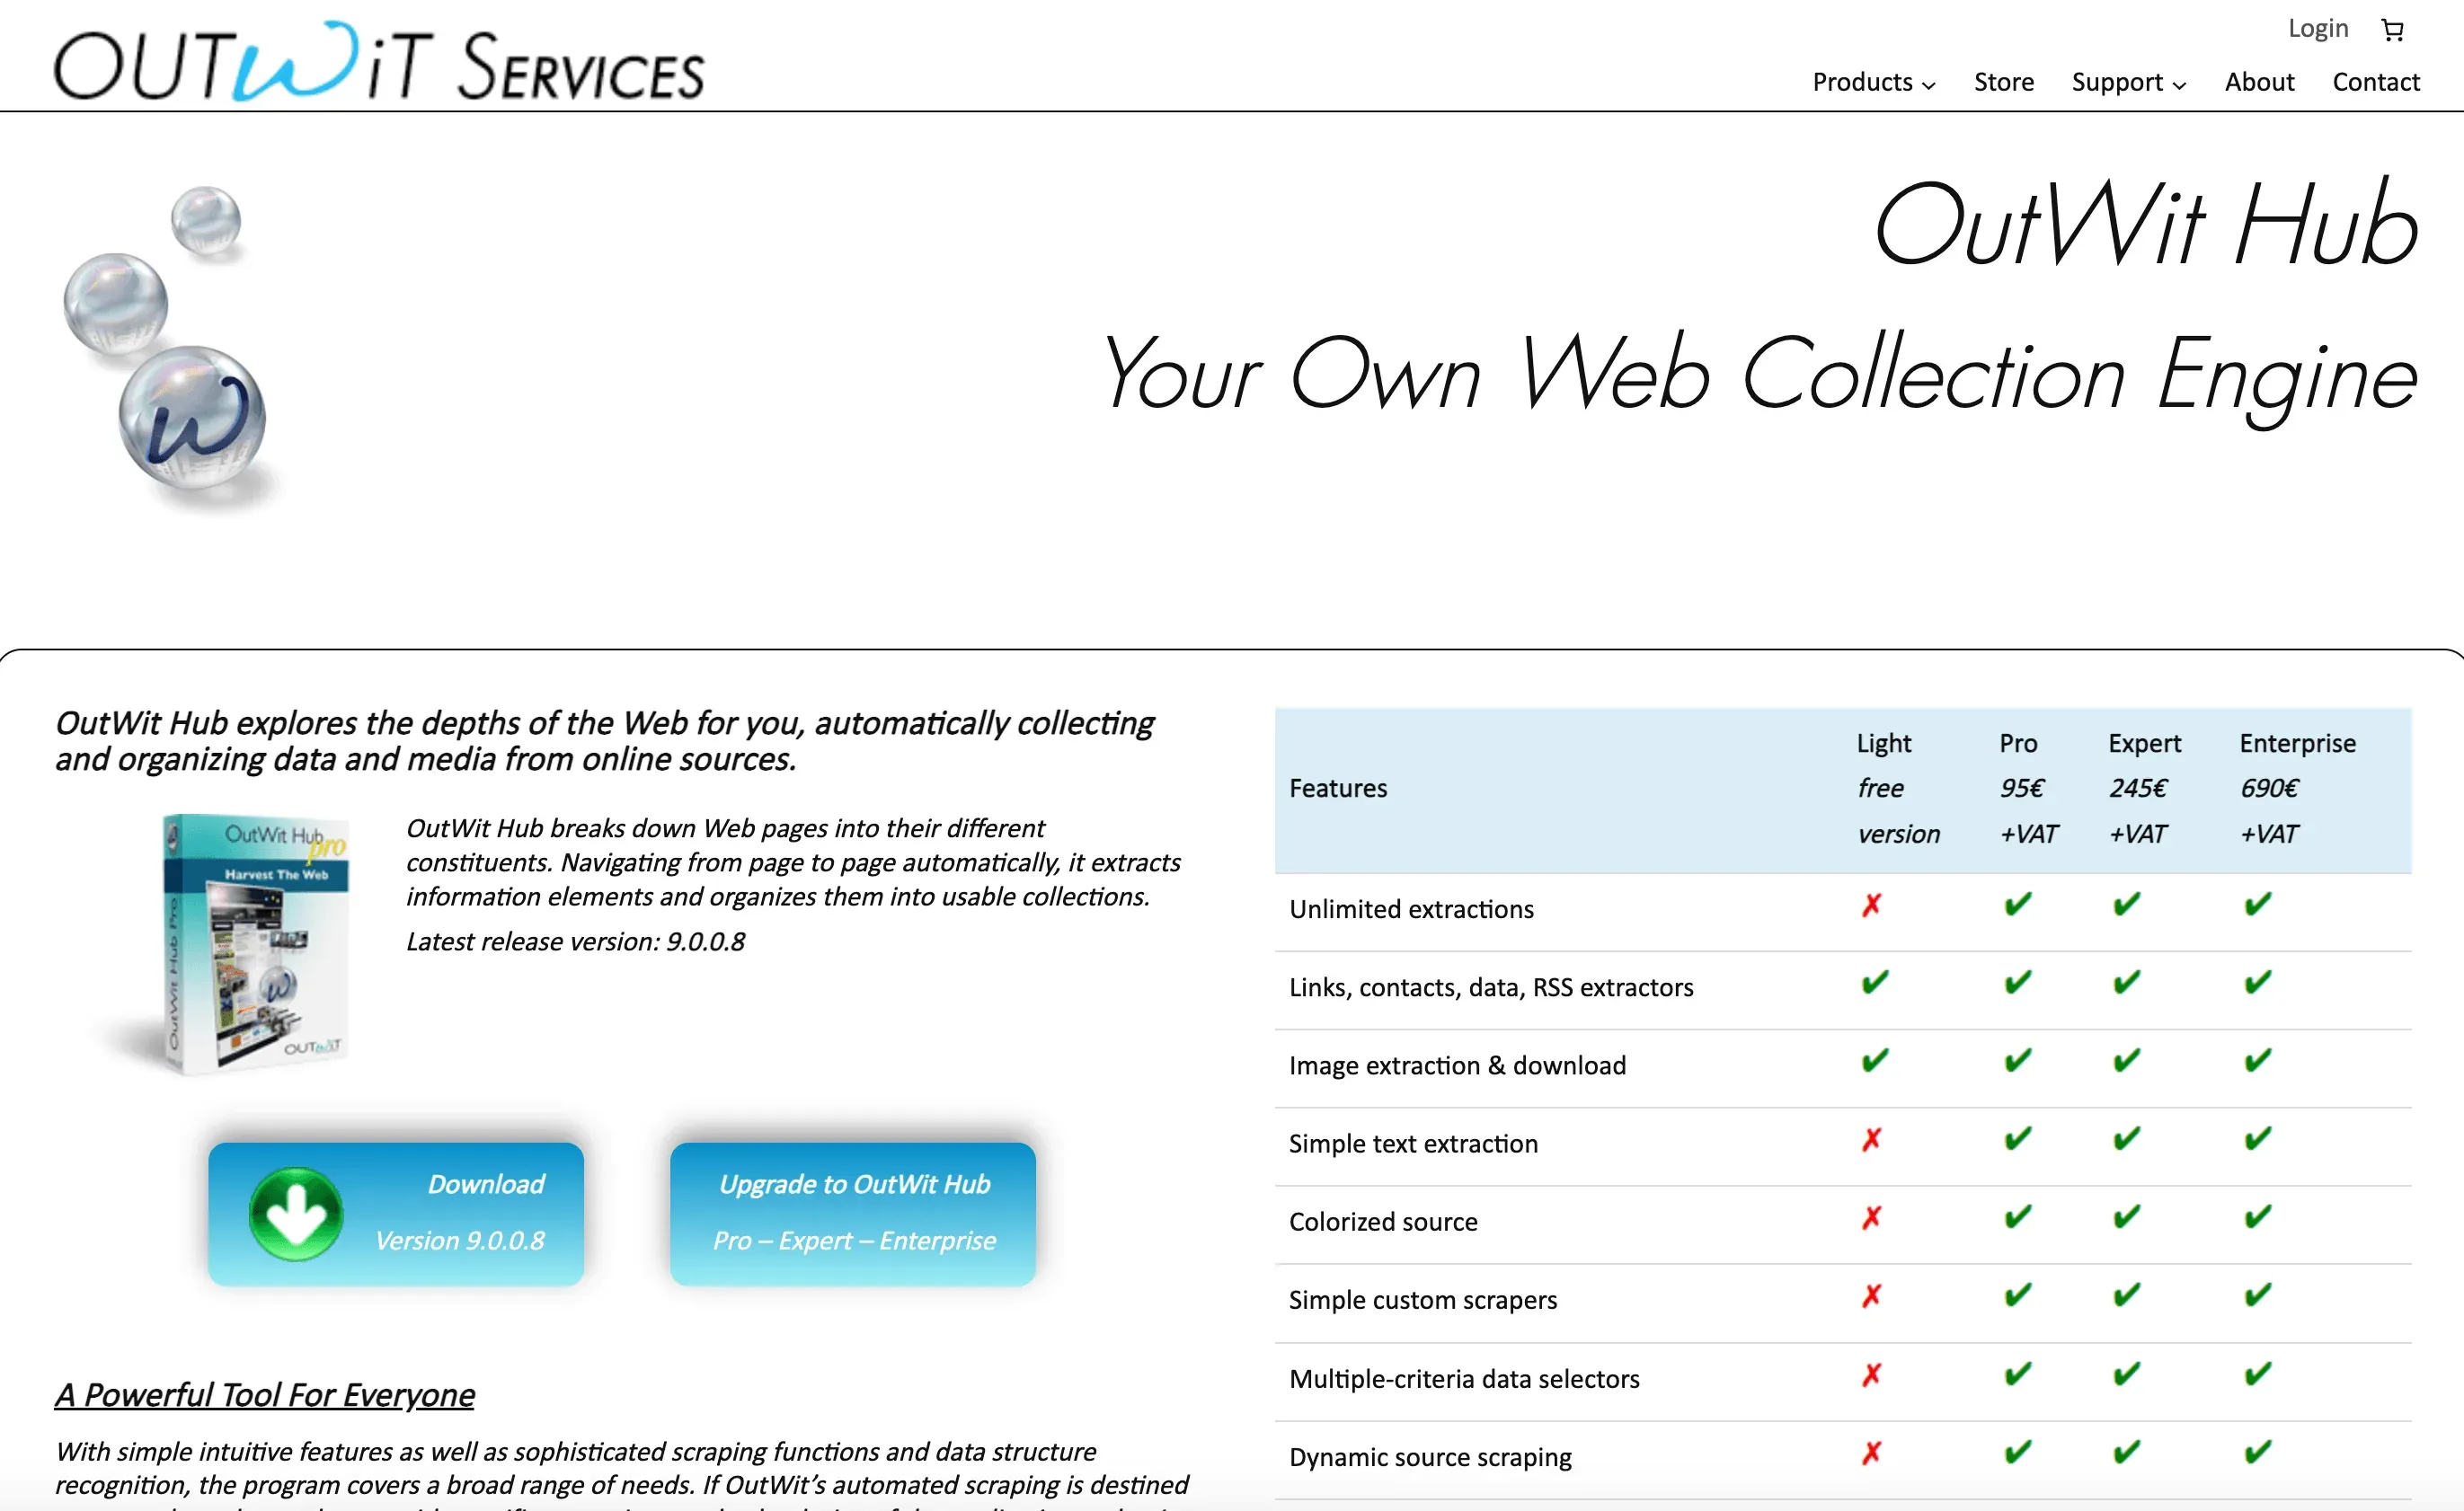 OutWit Hub är en native Linux-GUI-applikation för webbskrapning. Den känner automatiskt igen datamönster och erbjuder kraftfulla funktioner för extraktion och automatisering.
Nyckelfunktioner:
- Upptäcker automatiskt länkar, bilder, tabeller, e-post och mer.
- Skriptredigerare för anpassad extraktion.
- Makroautomatisering och schemaläggning.
Pris: Gratis version (begränsad); betald Pro-licens — kolla leverantörens butik för aktuella priser.
Linux-kompatibilitet: Native app för Linux, Windows och Mac.
Bäst för: Icke-kodare med viss teknisk fallenhet som vill ha en desktop-GUI-skrapare.
15. Portia
 Portia är en open source, visuell web scraper från Scrapinghub. Den körs i webbläsaren och låter dig annotera sidor för att träna skrapare — men obs, repot har inte sett någon riktig utvecklingspush på över ett år, så det har glidit in i ett “använd på egen risk”-läge. Om du vill ha den visuella annoteringsidén med aktiv utveckling bakom dig är ParseHub eller Thunderbit renare val.
Nyckelfunktioner:
- Webbläsarbaserat gränssnitt för visuell extraktion.
- Integreras med Scrapy för anpassade projekt.
- Open source och utbyggbart.
Pris: Gratis och open source.
Linux-kompatibilitet: Webbläsarbaserat; fungerar på alla operativsystem.
Bäst för: Användare som vill ha öppen källkod, visuell scraping med integration till Scrapy.
16. Sequentum Enterprise (tidigare Content Grabber)
 Sequentum Enterprise är en enterprise-klassad visuell skrapare för Windows, men kan köras på Linux via Wine eller virtualisering.
Nyckelfunktioner:
- Visuell editor plus C#-skriptning för avancerad logik.
- Hantering av flera agenter och schemaläggning.
- Integreras med databaser, API:er och mer.
Pris: Enterprise-licens, pris lämnas på offert per installation.
Linux-kompatibilitet: Via Wine eller VM.
Bäst för: Byråer och stora team som hanterar många scrapingprojekt.
17. Helium
 Helium är ett Python-bibliotek som förenklar Selenium-automatisering. Det är gjort för att göra webbläsarskript mer mänskliga och lättanvända.
Nyckelfunktioner:
- Intuitiva kommandon som
click("Login")ellerwrite("email"). - Automatiserar Chrome och Firefox.
- Perfekt för snabb skriptning och automationsuppgifter.
Pris: Gratis och open source.
Linux-kompatibilitet: Fungerar på Linux (byggt ovanpå Selenium).
Bäst för: Python-användare som tycker att Selenium känns för klumpigt.
18. Dexi.io
 Dexi.io är en molnbaserad plattform för dataextraktion och automatisering. Den nås via webbläsare, så Linux-användare kan använda den utan att installera något.
Nyckelfunktioner:
- Visuell arbetsflödesdesigner för skrapning och automatisering.
- Schemaläggning, datatransformation och API-integration.
- Skalbarhet och support på enterprise-nivå.
Pris: Säljs nu under Mozenda: gratis 14-dagars test, Pilot för $500/månad, enterprise via offert.
Linux-kompatibilitet: Webbapp – fungerar på alla operativsystem.
Bäst för: Proffs och företag som behöver skalbar och integrerad webbdataextraktion.
Snabb jämförelsetabell: Linux-webbskrapningsverktyg i korthet
| Verktyg | Typ / Nyckelfunktioner | Passar bäst för | Pris | Linux-kompatibilitet |
|---|---|---|---|---|
| Thunderbit | AI Chrome-tillägg, ett klick, undersidor, moln/lokalt | Icke-tekniska affärsanvändare | Gratis, från $15/mån | ✔ Chrome på Linux |
| Scrapy | Python-ramverk, async, CLI, mycket utbyggbart | Utvecklare, storskaliga anpassade skrapare | Gratis | ✔ Native |
| Beautiful Soup | Python-bibliotek, enkel HTML/XML-tolkning | Utvecklare, dataanalytiker, små uppgifter | Gratis | ✔ Native |
| Selenium | Webbläsarautomatisering, JS-tunga sajter | QA, utvecklare, dynamiskt innehåll | Gratis | ✔ Native |
| Puppeteer | Node.js, headless Chrome, JS-rendering | Node-utvecklare, moderna webbappar | Gratis | ✔ Native |
| Octoparse | Kodfritt, drag-and-drop, molnmallar | Icke-kodare, e-handel | Gratis, från $69/mån | ◐ Moln/Wine |
| PhantomJS | Headless WebKit, skriptbar JavaScript | Legacy, lättviktigt, utan Chrome | Gratis | ✔ Native |
| ParseHub | Visuell, plattformsoberoende, point-and-click | Analytiker, semitekniska användare | Gratis, från $189/mån | ✔ Native |
| Kimurai | Ruby-ramverk, flera webbläsare, async | Ruby-utvecklare, hög samtidighet | Gratis | ✔ Native |
| Apify | Molnplattform, SDK:er, marknadsplats | Utvecklare, hybrid mellan kod och moln | Gratis nivå, användningsbaserat | ✔ Native/Moln |
| Colly | Go-ramverk, snabbt, samtidigt | Go-utvecklare, hög prestanda | Gratis | ✔ Native |
| PySpider | Python, webbgränssnitt, schemaläggning, distribuerat | Team, flera projekt | Gratis | ✔ Native |
| WebHarvy | Visuell, mönsterigenkänning, engångslicens | Nybörjare, solo-proffs | ~$129 engångslicens | ◐ Wine/VM |
| OutWit Hub | Native GUI, upptäcker data automatiskt, skriptning | Icke-kodare, desktop GUI | Gratis; betald Pro (se leverantör) | ✔ Native |
| Portia | Open source, visuell, webbläsarbaserad | Open source, Scrapy-integration | Gratis | ✔ Webbläsare |
| Sequentum Enterprise | Enterprise, visuell, skriptning, multi-agent | Byråer, stora team | $$$, offertbaserat | ◐ Wine/VM |
| Helium | Python, förenklad Selenium, intuitivt API | Python-användare, snabb automatisering | Gratis | ✔ Native |
| Dexi.io | Moln, visuellt arbetsflöde, schemaläggning, API | Enterprise, skalbar automatisering | Från $500/mån (via Mozenda) | ✔ Webbläsare |
Så väljer du rätt web scraper för Linux: viktiga saker att tänka på
Osäker på vilken nivå du behöver? Börja i den enkla änden Om du helst slipper underhålla selektorer kan du låta AI räkna ut fälten åt dig — ett klick, sedan export till Sheets, Excel, Airtable eller Notion. Get Started Free
Att välja rätt verktyg handlar om att matcha dina behov och din kompetens:
- Teknisk nivå: Icke-kodare bör luta mot Thunderbit, ParseHub, Octoparse eller OutWit Hub. Utvecklare får mer kraft med Scrapy, Puppeteer, Colly eller Kimurai.
- Datakomplexitet: För statiska sidor är Beautiful Soup eller Colly snabba och enkla. För dynamiska sajter med mycket JavaScript behöver du Selenium, Puppeteer eller ett visuellt verktyg som stöder JS.
- Skala och frekvens: För engångsjobb räcker kodfria verktyg eller molnskrapare. För schemalagda, storskaliga crawls, välj Scrapy, PySpider eller Apify.
- Integrationsbehov: Behöver du exportera till Excel, Sheets eller en databas? Se till att verktyget passar ditt arbetsflöde.
- Budget: Gratis och open source-alternativ finns det gott om för kodare. För affärsanvändare erbjuder Thunderbit och ParseHub prisvärda insteg, medan enterprise-team kan investera i Dexi.io eller Sequentum Enterprise.
- Support och community: Open source-verktyg har stora communityn; kommersiella verktyg erbjuder dedikerad support.
Proffstips: Var inte rädd för att kombinera verktyg. Använd Thunderbit för att prototypa och identifiera datamönster, byt sedan till Scrapy för produktionsskalig crawling. Eller använd Selenium för att logga in och hämta sessionscookies, och lämna sedan över till Colly eller Scrapy för snabb skrapning.
Slutsats: Hitta ditt bästa Linux-webbskrapningsverktyg för 2026
Linux-användare har ett enormt urval år 2026. Oavsett om du vill ha ett kodfritt AI-drivet verktyg som ger resultat på minuter (Thunderbit), ett robust utvecklarramverk (Scrapy, Colly) eller en enterprise-plattform (Dexi.io), finns det en web scraper för Linux som passar dina behov och ditt arbetsflöde.
Viktiga slutsatser:
- Linux är ryggraden i modern datainfrastruktur – de flesta toppskrapare kör native eller via webbläsare.
- AI- och kodfria verktyg gör webbskrapning mer tillgängligt för affärsanvändare.
- Utvecklarramverk är fortfarande bäst när det gäller flexibilitet, hastighet och skala.
- Testa innan du köper – de flesta verktyg har gratisnivåer eller testperioder.
Redo att komma igång? Ladda ner Thunderbit eller kolla in Thunderbit Blog för fler guider om webbskrapning, automatisering och datadriven tillväxt.
Utforska Thunderbits AI-web scraper Hoppa över skript och cron-jobb — låt AI läsa sidan och ge dig en tabell med ett klick. Get Started Free
Vanliga frågor
1. Vilken är den enklaste web scraper för Linux om jag inte kan koda?
Thunderbit är toppvalet för icke-tekniska användare. Den körs som ett Chrome-tillägg på Linux, använder AI för att automatisera allt och låter dig skrapa data med bara ett klick.
2. Vilken Linux-web scraper är bäst för stora, anpassade projekt?
Scrapy är förstahandsvalet för utvecklare. Det är snabbt, skalbart och mycket anpassningsbart – perfekt för stora, återkommande crawls.
3. Kan jag skrapa JavaScript-tunga eller dynamiska sajter på Linux?
Ja! Använd Selenium eller Puppeteer för att styra riktiga webbläsare och extrahera dynamiskt innehåll. Visuella verktyg som ParseHub och Thunderbit stöder också dynamiska sajter.
4. Finns det gratis Linux-webbskrapningsverktyg för affärsanvändning?
Absolut. Scrapy, Beautiful Soup, Selenium, Colly, PySpider och Kimurai är alla gratis och open source. Thunderbit och ParseHub erbjuder gratisnivåer för mindre jobb.
5. Hur väljer jag mellan kodfria och kodbaserade Linux-skrapare?
Om du vill ha snabbhet och enkelhet, välj kodfritt (Thunderbit, ParseHub, Octoparse). Om du behöver flexibilitet, automatisering eller integration med andra system är kodbaserade verktyg (Scrapy, Puppeteer, Colly) det bästa valet.
Lycka till med skrapandet – och må dina Linux-drivna dataprojekt rulla smidigare än en nyinstallerad Ubuntu. Om du vill se fler tips om webbskrapning, kolla in Thunderbit Blog eller prenumerera på vår YouTube-kanal för praktiska guider.
Testa AI-web scraper för Linux Get Started Free
Läs mer



