
Förra veckan hörde en av våra användare av sig till oss: "Jag behöver priser, beskrivningar och variantdata från 14 konkurrenters Shopify-butiker — senast på fredag." Det handlar om ungefär 4 000 produktsidor. Kopiera och klistra? Inte en chans.
Om du någon gång har försökt hämta produktdata från en Shopify-butik — priser, bilder, beskrivningar, varianter, recensioner — så känner du igen frustrationen. Det finns över 2,8 miljoner aktiva Shopify-butiker i början av 2026, och ingen av dem har någon knapp som heter "export för utomstående". Samtidigt uppger 72 % av företag att de aktivt bevakar konkurrenters prissättning, och e-handelsleverantörer rapporterar att det kan ta 15 till 30 minuter att manuellt lägga upp ens en enda produkt med varianter och bilder. Multiplicera det med några hundra produkter, så är hela veckan borta.
Därför har Chrome-tillägg för Shopify-scraping blivit ett standardverktyg i e-handelsarsenalen — för konkurrentanalys, produktjakt inom dropshipping, katalogmigrering och mer. Men de flesta artiklar om "bästa scraper" listar bara funktioner utan att visa vad som faktiskt händer när de körs mot riktiga Shopify-butiker. Den här är annorlunda. Jag testade åtta tillägg mot verkliga butiker, stötte på riktiga anti-bot-skydd och såg vilka verktyg som faktiskt levererar den djupa produktdata du behöver — och vilka som bara skrapar på ytan.
Varför e-handelsteam behöver ett Chrome-tillägg för Shopify-scraping
Shopify-butiker är guldgruvor av kommersiellt användbar produktdata. Men som utomstående får du ingen CSV-export. Du får en butiksyta. För att omvandla den till handlingsbar insikt behöver du en scraper — och användningsområdena sträcker sig långt bortom "jag vill ha en lista med produktnamn".
Den verkliga frågan är: vilken data behöver du egentligen, och för vilket arbetsflöde? Här är hur de vanligaste e-handelsfallen mappar till specifika fält:
Prisbevakning av konkurrenter
Du behöver: produkttitlar, priser, jämförpris och variantnivå-prissättning. Det här är kärnan i dynamisk prissättning — att inte bara veta vad en konkurrent tar betalt, utan hur de rabatterar, paketerar och prissätter över storlekar eller färger.
Hitta produkter för dropshipping
Du behöver: titlar, alla bilder (inte bara miniatyrer), fullständiga beskrivningar och publiceringsdatum. Om du sorterar på senaste publiceringsdatum kan du upptäcka trendande eller nyligen lanserade produkter innan marknaden blir mättad.
Import av katalog till din egen butik
Du behöver: titlar, body HTML, alla bilder, varianter, SKU:er och priser — helst i en Shopify-anpassad CSV för import. Alla verktyg klarar inte att skapa det snyggt.
Bedömning av försäljningshastighet
Du behöver: produkttitlar och lagersaldon, över tid. Genom att ta lagersnapshots enligt ett schema kan du uppskatta hur snabbt en konkurrent säljer sina produkter — ett grovt men användbart mått när direkt försäljningsdata inte finns.
Leadgenerering (hitta butikägare)
Du behöver: butiksnamn, kontaktmejl, telefonnummer och ibland vilka appar eller vilken teknikstack butiken använder. Säljteam använder detta för att bygga prospekteringslistor segmenterade efter nisch eller teknik.
Här är en snabb översikt:
| Användningsfall | Viktiga fält som behövs | Rekommenderat arbetsflöde |
|---|---|---|
| Prisbevakning av konkurrenter | Titel, pris, jämförpris, variantpriser | Skrapa listningssidan + berika via produktsidor för varianter |
| Produktjakt för dropshipping | Titel, pris, bilder (alla), beskrivning, publiceringsdatum | Skrapa produktsidor + sortera på senaste publiceringsdatum |
| Import av katalog till din butik | Titel, body HTML, bilder, varianter, SKU, pris | Full skrapning av produktsidor → export som Shopify-import-CSV |
| Försäljningsestimat | Titel, lagermängd (över tid) | Schemalagd scraping → spårning i Google Sheets |
| Leadgenerering (butikägare) | Butiksnamn, mejl, telefon, appar som används | Skrapa kontaktsidor + mejl-/telefonextraktorer |
Så utvärderade jag de 8 Chrome-tilläggen för Shopify-scraping
Jag installerade alla åtta tillägg och körde dem mot samma uppsättning riktiga Shopify-butiker — inklusive publika butiker, Cloudflare-skyddade butiker och butiker där products.json var avstängt. Jag tittade inte bara på funktionslistor. Jag ville se vad som faktiskt händer när man trycker på "scrape" på en live Shopify-kategorisida.
Här är de åtta kriterier jag använde, och varför varje punkt är viktig specifikt för Shopify:
| Kriterium | Varför det spelar roll för Shopify-scraping |
|---|---|
| Enkel installation | Kan en icke-teknisk dropshippare börja skrapa på under 5 minuter? |
| Extraherade datafält | Får du titel, pris, bilder, beskrivningar, varianter OCH recensioner — eller bara ytlig data? |
| Berikning via produktsidor | Kan verktyget skrapa en listningssida och sedan automatiskt besöka varje produktsida för fullständig information? |
| Hantering av paginering | Klarar det att skrapa förbi första produktsidan (klickpaginering eller oändlig scroll)? |
| Motstånd mot anti-bot | Klarar det Cloudflare Turnstile eller Shopifys bot-skydd utan att krascha? |
| Exportformat | CSV, Excel, Google Sheets, Airtable, Notion, Shopify-anpassad CSV? |
| Schemalagd/återkommande scraping | Kan det bevaka priser eller lagerförändringar automatiskt över tid? |
| Pristransparens | Gratisnivåns gränser, kreditsystem, fast pris — och vad du faktiskt får |
Med det ramverket på plats så här presterade varje verktyg.
1. Thunderbit — AI-drivna Shopify-scrapern byggd för icke-kodare
Thunderbit är verktyget vi byggt på Thunderbit specifikt för affärsanvändare som vill ha djup produktdata utan att skriva kod, konfigurera CSS-selectors eller lägga 20 minuter på installation. Arbetsflödet i en Shopify-butik är faktiskt ett klick: öppna en kategorisida och klicka One Click Extract — AI:n läser sidan, listar ut kolumnerna (titel, pris, bild osv.) och hämtar listningsdatan.
Men den verkliga skillnaden — och det som de flesta jämförande artiklar missar — är vad som händer efteråt.
Berikning via produktsidor: funktionen som förändrar allt
Efter att listningssidan har skrapats klickar du på "Scrape Subpages". Thunderbits AI besöker varje enskild produkt-URL och lägger till data från produktsidan i din ursprungliga tabell: fullständiga beskrivningar, alla bilder i galleriet, variantalternativ, SKU:er, antal recensioner och mer. Det är det här steget som förvandlar ett ytligt kalkylblad till en användbar datamängd för konkurrensanalys.
Jag går djupare in på varför det här spelar så stor roll (och visar en före/efter-jämförelse) i ett särskilt avsnitt längre ner.
Viktiga styrkor för Shopify-scraping
- One Click Extract läser Shopify-sidan och hittar rätt kolumnstruktur — inga CSS-selectors, ingen manuell konfiguration
- Skrapning av undersidor fyller i luckorna som listningssidor missar (fulla beskrivningar, variantalternativ, bildgallerier, recensioner)
- Molnläge för snabb massuttagning på publika butiker; webbläsarläge för Cloudflare-skyddade eller inloggningskrävande butiker
- Hantering av paginering (klickbaserad och oändlig scroll)
- Schemalagd scraping för löpande pris-/lagerbevakning — beskriv schemat på vanligt språk, t.ex. "varje måndag kl. 9"
- Gratis extraktorer för mejl och telefonnummer för leadgenerering
- Export till Excel, Google Sheets, Airtable, Notion, CSV, JSON — inklusive Shopify-vänliga format
- Field AI Prompt låter dig lägga till egna instruktioner per kolumn (t.ex. "kategorisera i 3 produkttyper" eller "översätt beskrivningen till engelska")
Där den kommer till korta
- Kreditbaserad prissättning gör att mycket stora jobb (tiotusentals produkter) kräver betalplan
- AI-bearbetning lägger på några sekunder per rad jämfört med mallbaserade scrapers på mycket enkla sidor
Pris
- Gratisnivå: 6 sidor (eller upp till 10 med gratis provperiod), alla exports gratis
- Starter: $15/månad, 500 krediter/månad
- Professionella nivåer: från $38/månad (3 000 krediter) upp till $249/månad (20 000 krediter)
- Kreditregler: 1 outputrad = 1 kredit för web scraping; 1 outputrad = 2 krediter för skrapning av undersidor; export är alltid gratis
Bäst för: Icke-tekniska e-handelsteam som behöver den djupaste Shopify-produktdatan med minimal installation — och vill kunna bevaka konkurrenter över tid.
Testa Thunderbit för Shopify-scraping Produkttitlar, priser, varianter och bilder från vilken Shopify-butik som helst — ett klick, inga selectors att konfigurera. Get Started Free
2. Instant Data Scraper — alternativet som auto-upptäcker utan konfiguration
Instant Data Scraper är ett gratis Chrome-tillägg som använder heuristiska algoritmer för att automatiskt identifiera tabulär data på webbsidor. Det kräver ingen som helst konfiguration — öppna en Shopify-kategorisida, klicka på tillägget, och det försöker hitta och visa produktdatan i en tabell.
I mina tester fungerade det bra på standardiserade Shopify Dawn-temas kategorisidor och plockade upp titlar, priser och URL:er till miniatyrbilder på några sekunder. På butiker med ovanliga layoutlösningar hämtade det ibland navigationslänkar eller innehåll från sidfoten i stället för produkter — du måste alltså granska resultatet med ögat.
Viktiga styrkor för Shopify-scraping
- Helt gratis utan användningsgränser
- Auto-detektering innebär noll installationstid — bra för snabba engångsexporter
- Stöd för paginering (kan klicka på "nästa sida" automatiskt)
- Export till CSV och XLSX
Där den kommer till korta
- Auto-detektering är träffsäker bara ibland på Shopify-butiker med ovanliga layouter
- Ingen berikning via undersidor: du får det som finns på listningssidan (titel, pris, miniatyr) men inte fullständiga beskrivningar, varianter eller recensioner
- Ingen AI för att rensa, märka eller omvandla data
- Ingen schemaläggning, ingen molnskrapning
- Ingen direkt export till Google Sheets, Airtable eller Notion
Pris
- Helt gratis
Bäst för: Alla som behöver en snabb, gratis och enkel export av synlig listningsdata från en standardiserad Shopify-butik.
3. Web Scraper — den visuella sitemap-byggaren
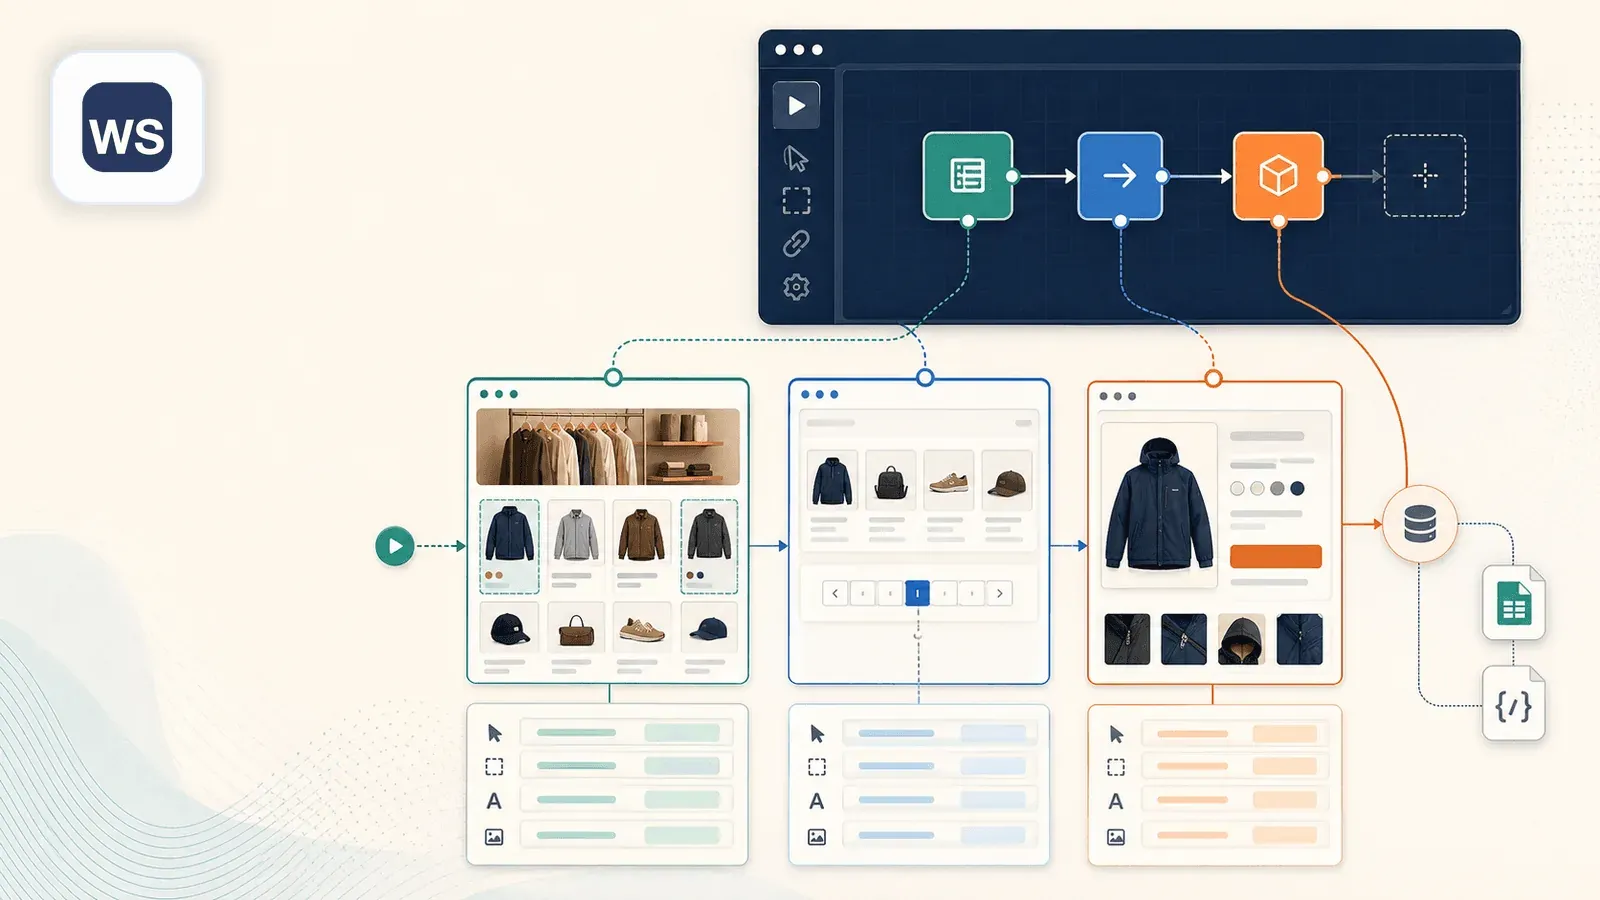
Web Scraper (webscraper.io) är det klassiska Chrome-tillägget för klick-och-peka som låter dig bygga "sitemaps" — scraping-recept där du väljer element på sidan och definierar ett arbetsflöde. I Shopify skulle du skapa en sitemap genom att klicka på produkttitlar, priser, bilder och definiera regler för paginering och länkföljning.
Viktiga styrkor för Shopify-scraping
- Visuell selector-byggare ger mer kontroll än auto-detekterande verktyg
- Kan följa länkar till undersidor (produktsidor) — men kräver manuell konfiguration av parent-child-selectors i sitemapen
- Klarar paginering med korrekt uppsättning
- Gratis webbläsarscraping; betalda molnplaner finns (från $50/månad)
- Export till CSV; molnplaner stöder Google Sheets och andra format
Där den kommer till korta
- Mer tidskrävande installation: att skapa en sitemap med parent-child-selectors tog mig cirka 15 minuter för en ny Shopify-butik
- Skrapning av undersidor kräver manuell konfiguration av länkselectors och child sitemaps — inte en berikning med ett klick
- Sitemaps går sönder när Shopify-butiker ändrar layout eller CSS-klasser
- Brantare inlärningskurva än AI-drivna alternativ
Pris
- Webbläsartillägg: Gratis
- Molnplaner: Project $50/månad, Professional $100/månad, Scale från $200/månad
Bäst för: Tekniska användare som vill ha finmaskig kontroll över sitt scraping-flöde och inte har något emot att bygga receptet själva.
4. Data Miner — scrapern som bygger på recept
Data Miner (dataminer.io) bygger på "recept" — förbyggda eller egna scrapingmallar som du applicerar på en sida. Det finns ett publikt receptbibliotek, så du kan kanske hitta en Shopify-mall som delats av någon annan, eller bygga din egen genom att markera element på sidan.
Viktiga styrkor för Shopify-scraping
- Receptbiblioteket kan innehålla färdiga Shopify-mallar delade av andra användare
- Visuell receptbyggare för egna scrapingkonfigurationer
- Klarar paginering med receptinställningar
- Export till CSV, Excel, Google Sheets och TSV
- Crawl-flöden för att besöka detaljsidor efter listsidor
Där den kommer till korta
- Gratisnivån är begränsad till 500 sidor/månad
- Recept är baserade på CSS-selectors, så de går sönder när butikens layout ändras
- Ingen AI för att föreslå fält eller omvandla data
- Inget inbyggt arbetsflöde för berikning via undersidor med ett klick — kräver ett separat crawl-recept för detaljsidor
- Schemalagda crawls finns, men det är inte den smidigaste lösningen för schemaläggning
Pris
- Gratis: 500 sidor/månad
- Solo: $19,99/månad
- Small Business: $49/månad
- Business: $99/månad
- Business Plus: $200/månad
Bäst för: Användare som gillar att arbeta med mallar och vill ha ett receptbibliotek som snabbar upp uppstarten på vanliga webbplatser.
5. Simplescraper — den lätta extraktorn
Simplescraper (simplescraper.io) är ett minimalistiskt Chrome-tillägg och molnbaserad scraper som satsar på enkelhet. Du klickar på dataelement på en Shopify-sida, Simplescraper genererar CSS-selectors och extraherar matchande data.
Viktiga styrkor för Shopify-scraping
- Rent, avskalat gränssnitt — snabbt att lära sig
- Molnscraping finns för schemalagda jobb och större jobb
- API-åtkomst för utvecklare som vill integrera data i arbetsflöden
- Export till CSV, JSON, Google Sheets, Airtable och via webhooks
- Koncept för deep scraping för att följa länkar till detaljsidor
- Arbetsflöden som klarar inloggning för sessionkänsliga butiker
Där den kommer till korta
- Manuellt, selector-baserat upplägg — ingen AI som auto-upptäcker fält
- Skrapning av undersidor kräver extra konfiguration
- Mindre community och färre färdiga mallar jämfört med Web Scraper eller Data Miner
- Gratisnivån: 100 krediter (1 JS-renderad sida = 2 krediter)
- Prissättningen på betalda nivåer är mindre transparent på den officiella sajten än hos de flesta konkurrenter
Pris
- Gratis: 100 krediter
- Betalda planer: Tredjepartskällor listar Plus till cirka $39/månad, Pro till cirka $70/månad och Premium till cirka $150/månad (enligt G2-prisdata)
Bäst för: Användare som vill ha en lätt, modern molnscraper med bra integrationer och inte behöver AI-baserad fältigenkänning.
6. Octoparse — Chrome-tillägget med desktop-kraft i ryggen
Octoparse (octoparse.com) är i grunden en desktop-applikation med ett kompletterande Chrome-tillägg. Det erbjuder både en visuell arbetsflödesbyggare och färdiga mallar för populära webbplatser, inklusive en Shopify-specifik scraping-guide.
Viktiga styrkor för Shopify-scraping
- Färdiga Shopify-mallar för vanliga scrapinguppgifter
- Kraftfull desktop-app med avancerade funktioner: IP-rotation, schemalagd scraping, molnextraktion
- Klarar paginering, oändlig scroll och AJAX-laddat innehåll bra
- Starkast dokumenterade anti-bot-förmåga i listan, inklusive automatisk CAPTCHA-hantering
- Export till CSV, Excel, JSON, HTML, XML, databaser och Google Sheets
Där den kommer till korta
- Chrome-tillägget i sig är begränsat — de flesta kraftfulla funktioner kräver desktop-appen
- Desktop-appen har en brantare inlärningskurva med sin visuella arbetsflödesbyggare
- Gratisnivån är begränsad; meningsfull användning kräver betalplan
- Tyngre installation än rena Chrome-tillägg — inte idealiskt för en snabb 5-minutersscrape
- Desktop-appen finns bara för Windows/Mac (inte rent webbläsarbaserad)
Pris
- Gratisplan finns
- Basic: $39/månad
- Standard: cirka $83/månad (månad), cirka $75/månad (årsvis)
- Professional: cirka $299/månad (månad), cirka $208/månad (årsvis)
- Enterprise: skräddarsydd
Bäst för: Team som behöver scraping i stor skala med IP-rotation, anti-bot-hantering och återkommande molnjobb — och inte har något emot en desktop-app.
7. Bardeen — scrapern med automation i centrum
Bardeen (bardeen.ai) är en webbläsarautomationsplattform som kombinerar web scraping med arbetsflödesautomation. Användare bygger "playbooks" som kan skrapa data och sedan skicka den vidare till andra appar — tänk "om jag skrapar det här, så pushar jag det till mitt CRM".
Viktiga styrkor för Shopify-scraping
- Arbetsflödesautomation utöver scraping: skrapa Shopify-data → berika → skicka till CRM eller kalkylblad i en och samma playbook
- Integrationer med 100+ appar (Google Sheets, Airtable, Notion, HubSpot, Slack osv.)
- AI-drivna funktioner för dataextraktion och klassificering
- Körs i webbläsaren — ingen desktop-app behövs
- Tids- och datumstyrda automations för schemaläggning
Där den kommer till korta
- Framför allt ett automationsverktyg, inte en dedikerad scraper — scrapingfunktionerna är mindre djupa än i specialiserade verktyg
- Att bygga playbooks kan kännas rörigt för användare som bara vill hämta en produktlista
- Gratisnivån är begränsad till 100 krediter
- Berikning via undersidor och hantering av paginering är mindre intuitivt än i dedikerade scrapingverktyg
- Onödigt mycket om du bara behöver skrapa data utan efterföljande automation
Pris
- Gratis: 100 krediter
- Basic: $10/månad, 100 krediter/månad
- Premium: $50/månad, 1 000 krediter/månad (cirka $40/månad årsvis)
- Enterprise: skräddarsydd
- Kreditmodell: 1 kredit per scraper-rad, 3 krediter per berikningsrad
Bäst för: Team som vill skrapa Shopify-data och direkt skicka den vidare till andra appar i samma automatiserade arbetsflöde.
8. Listly — omvandlar listor till kalkylblad
Listly (listly.io) är särskilt byggt för att konvertera webbsidors listor och tabeller till data som är redo för kalkylblad. Klicka på tillägget på en Shopify-kategorisida och Listly försöker identifiera produktlistan och exportera den som ett kalkylblad.
Viktiga styrkor för Shopify-scraping
- Extremt enkelt gränssnitt — byggt för listuttag med ett klick
- Bra på att känna igen återkommande liststrukturer (som produktgridar)
- Exporterar direkt till Excel och Google Sheets
- Gruppskrapning för att behandla flera URL:er samtidigt
- Schemaläggning finns på Business-planer
Där den kommer till korta
- Begränsat till det som auto-upptäcks på sidan — ingen egen fältkonfiguration
- Ingen berikning via undersidor — exporterar bara data på listningsnivå
- Har svårt med ovanliga Shopify-teman eller butiker med tung JavaScript-rendering
- Gratisnivån är väldigt begränsad (10 URL:er/månad)
- Färre exportalternativ än konkurrenterna (främst Excel och Sheets)
Pris
- Gratis: 10 URL:er/månad, grundläggande 1-sidigt uttag, Excel-nedladdning, export till Google Sheet
- Light: $30/månad ($187,20/år vid årsbetalning)
- Business: $90/månad ($993,60/år vid årsbetalning) — lägger till avancerad extraktion, gruppextraktion, schemaläggning, auto-scroll/click, API-beta
Bäst för: Användare som vill ha den enklast möjliga vägen från en Shopify-kategorisida till ett kalkylblad — och inte behöver djup produktdata.
Alla 8 Chrome-tillägg för Shopify-scraping jämförda
Här är hela jämförelsen sida vid sida. Jag har försökt vara specifik i varje ruta i stället för att bara kryssa i boxar — för att "stöder paginering" betyder väldigt olika saker beroende på verktyg.
| Verktyg | Enkel installation | Datafält | Berikning via undersidor | Paginering | Hantering av anti-bot | Exportformat | Schemaläggning | Gratisnivå / pris |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Mycket enkel (AI-ledd, 1 klick) | Starkast för icke-tekniska användare (AI:n listar ut alla relevanta fält) | Ja — berikning med ett klick | Ja (klick + oändlig scroll) | Moln för publika sidor, webbläsare för skyddade | Sheets, Airtable, Notion, CSV, JSON, Excel | Ja (schemaläggning på vanligt språk) | Gratis 6 sidor; betal från $15/mån |
| Instant Data Scraper | Extremt enkel (ingen konfiguration) | Bra för data på listningsnivå | Nej | Ja (auto-upptäcker nästa sida) | Endast i webbläsaren, ingen anti-bot-strategi | CSV, XLSX | Nej | Gratis |
| Web Scraper | Medel-svår (manuell sitemap) | Flexibel om sitemap byggs bra | Ja, men manuellt via länkselectors | Ja (med sitemap-konfiguration) | Lokalt i webbläsaren; proxyrotation i molnplaner | CSV lokalt; bredare i molnet | Ja i molnplaner | Gratis tillägg; moln från $50/mån |
| Data Miner | Medel (receptbaserad) | Bra om recept finns eller byggs | Ja, men fler steg för crawl | Ja (receptkonfiguration) | Mest i webbläsaren | CSV, Excel, Sheets, TSV | Automatiserade crawls finns | Gratis 500 sidor/mån; betal från $19,99/mån |
| Simplescraper | Enkel–medel (selector-baserad) | Stabil för lättare extraktion | Deep scraping finns, men inte med ett klick | Ja (oändlig scroll stöds) | Proxyrotation och inloggningsvänligt | CSV, JSON, Sheets, Airtable, webhooks | Ja | Gratis 100 krediter; betalda nivåer finns |
| Octoparse | Svårare (desktop-app) | Mycket stark när den väl är konfigurerad | Ja, via arbetsflöden eller mallar | Ja (AJAX, oändlig scroll) | Starkast anti-bot (IP-rotation, CAPTCHA) | CSV, Excel, JSON, HTML, XML, DB, Sheets | Ja från Standard och uppåt | Gratis; Basic $39/mån; moln från cirka $83/mån |
| Bardeen | Medel (playbook-byggare) | Bra när det kopplas till automation | Möjligt i arbetsflödet, men inte Shopify-först | Möjligt | Körs i webbläsaren, anti-bot är inte kärnan | CSV, Sheets, Airtable, Notion | Ja via automations | Gratis 100 krediter; Basic $10/mån; Premium $50/mån |
| Listly | Mycket enkel (ett klick för listigenkänning) | Bäst för synliga list-rader | Nej | Begränsat till upptäckt liststruktur | Minimal | Excel, Sheets, CSV/JSON API på Business | Ja på Business | Gratis 10 URL:er/mån; Light $30/mån; Business $90/mån |
Snabb slutsats utifrån prioritet
Om du behöver den djupaste Shopify-produktdatan med minsta möjliga installation är Thunderbits AI + berikning via undersidor den starkaste kombinationen. Om du behöver en helt gratis, snabb och enkel export fungerar Instant Data Scraper bra för enkla sidor. Om du vill ha full kontroll och inte har något emot att bygga recept, ger Web Scraper eller Octoparse dig den kraften. Och om ditt verkliga mål är skrapa → automatisera → skicka till CRM, då är Bardeen arbetsflödesplattformen att titta på.
Att skrapa listningssidan är bara halva jobbet: arbetsflödet för berikning via undersidor
Det här är avsnittet jag önskar att varje annan Shopify-scrapingartikel skulle ta med — för det är den största luckan i konkurrerande innehåll, och den största frustrationen jag hör från e-handelsanvändare.
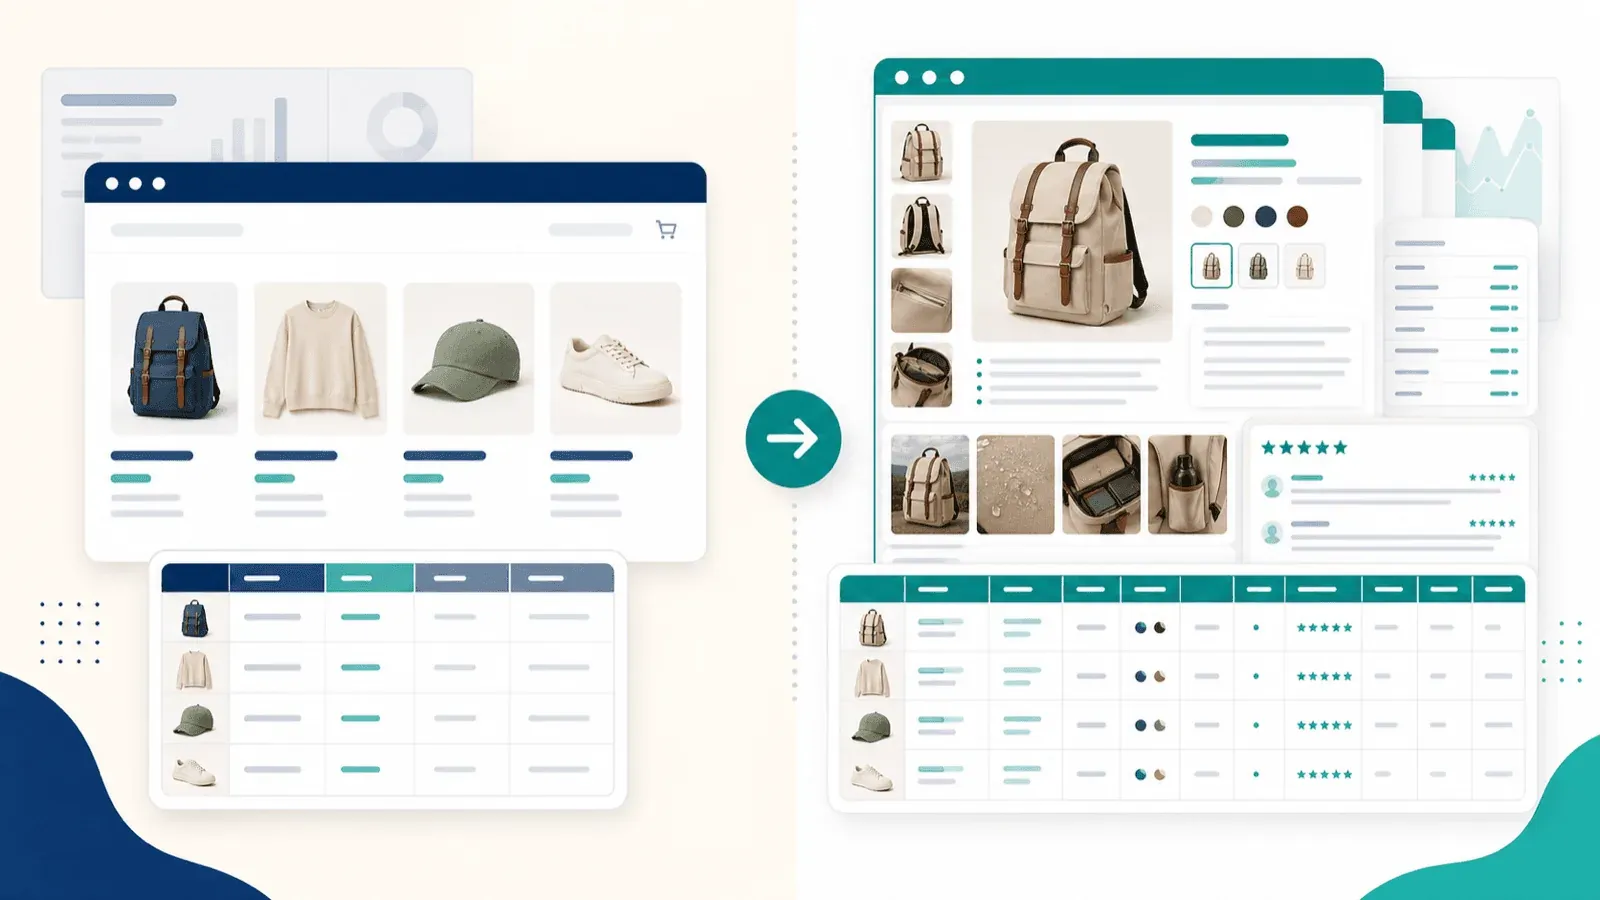
När du skrapar en Shopify-kategorisida (listningssidan) får du ytlig data: titlar, priser, miniatyrbilder, kanske en kortad beskrivning. Men de fält du faktiskt behöver för konkurrentanalys, katalogimport eller dropshippingresearch finns på de enskilda produktsidorna.
Vad du får från listningssidan jämfört med efter berikning via undersidor
| Datafält | Endast från listningssidan | Efter berikning via undersidor |
|---|---|---|
| Produkttitel | ✅ | ✅ |
| Pris | ✅ | ✅ |
| Miniatyrbild | ✅ | ✅ + alla bilder i galleriet |
| Kort beskrivning | ⚠️ Avkortad | ✅ Fullständig HTML-beskrivning |
| Varianter (storlek, färg) | ❌ | ✅ |
| SKU / lager | ❌ | ✅ |
| Recensioner / betyg | ❌ | ✅ |
Det är en enorm skillnad.
En export som bara bygger på listningssidan ger dig ett ytligt kalkylblad. En export som har berikats via undersidor ger dig ett användbart dataset för konkurrensanalys.
Så fungerar skrapning av undersidor i Thunderbit steg för steg
- Gå till Shopify-butiken och öppna en kategori-/listningssida
- Klicka "One Click Extract" — Thunderbit läser sidan och listar ut kolumnerna (titel, pris, bild, länk osv.)
- Klicka "Scrape" för att extrahera data från listningssidan
- Klicka "Scrape Subpages" — AI:n besöker varje produkt-URL och lägger till data från produktsidan (full beskrivning, alla bilder, varianter, recensioner) i den ursprungliga tabellen
- Exportera den berikade tabellen till Excel, Google Sheets, Airtable, Notion eller CSV
Hela processen tar några minuter för en typisk kategori, och du får ett dataset som annars hade tagit timmar att bygga manuellt.
Testa Thunderbit för skrapning av undersidor Gå bortom kategorisidan: Thunderbit besöker varje produktsida och lägger till de djupare fälten i din tabell. Get Started Free
Vilka andra verktyg stöder berikning via undersidor?
- Web Scraper: Ja, men kräver manuell sitemap-konfiguration med länkselectors och child sitemaps — räkna med 15–20 minuters installation per butik
- Octoparse: Ja, via arbetsflödesbyggaren eller mallar — kraftfullt men mer omständligt att sätta upp
- Data Miner: Ja, via flerstegs-crawl-flöden — inte en operation med ett klick
- Simplescraper: Koncept för deep scraping finns, men är inte lika färdigpaketerat
- Instant Data Scraper, Listly, Bardeen: Ingen dokumenterad berikning via undersidor med ett klick för Shopify
Skillnaden mellan "kan tekniskt följa länkar med 20 minuters manuell inställning" och "berikning med ett klick" är skillnaden mellan ett verktyg för scraper-utvecklare och ett verktyg för e-handelsoperatörer.
När Shopifys products.json inte räcker — och varför Chrome-tillägg är din backup-plan
Om du har läst andra guider om Shopify-scraping har du säkert sett /products.json-tricket: lägg bara till /products.json på en Shopify-URL så får du strukturerad produktdata i JSON-format. Det är ett riktigt endpoint, och när det fungerar är det väldigt praktiskt.
Så fungerar products.json
Shopify-butiker exponerar ett JSON-API-endpoint på /products.json som returnerar strukturerad produktdata. Du kan paginera med ?page=2&limit=250 (max 250 produkter per sida).
Fält som vanligtvis returneras är: title, body_html, vendor, product_type, tags, published_at, variants (med price, compare_at_price, sku, available) och images.
Vad products.json missar
- Ingen recensionsdata eller antal betyg
- Begränsad formatering av beskrivning jämfört med renderade sidor
- Egna metafields ingår ofta inte
- Variantbilder kan vara inkonsekventa
- Inget renderat merchandising-innehåll, badges eller social proof
När products.json slutar fungera
Jag körde direkta HTTP-kontroller mot åtta riktiga Shopify-butiker den 27 april 2026. Resultatet var tydligt:
| Butik | Resultat |
|---|---|
| kith.com | ✅ Fungerade — ren JSON |
| colourpop.com | ✅ Fungerade |
| allbirds.com | ✅ Fungerade |
| brooklinen.com | ✅ Fungerade |
| negativeunderwear.com | ✅ Fungerade |
| gymshark.com | ❌ Blockerad — 403 HTML i stället för JSON |
| mvmt.com | ⚠️ Delvis avstängt — 200 HTML-sida, inte JSON |
| fashionnova.com | ❌ Avstängt — 404 |
Fem av åtta returnerade ren JSON. Tre gjorde inte det.
Forumanvändare rapporterar samma sak: "Av någon anledning väljer vissa Shopify-butiker att inte exponera products.json." Lösenordsskyddade butiker, butiker med egna API-lösningar och domäner skyddade av Cloudflare kan alla bryta mönstret.
Fallbacken med Chrome-tillägg
När products.json inte finns tillgängligt extraherar en scraper som Chrome-tillägg data direkt från den renderade sidan (DOM). Det här är kärnan i webbläsarbaserade scrapers: de ser och hämtar det du ser i webbläsaren, oavsett om ett API finns eller inte. Därför blir Chrome-tillägg din pålitliga Plan B — och ofta Plan A när du behöver renderad siddata som recensioner, merchandising-innehåll eller fullständiga bildgallerier.
Anti-bot-skydd: vad som faktiskt händer när du skrapar Shopify-butiker
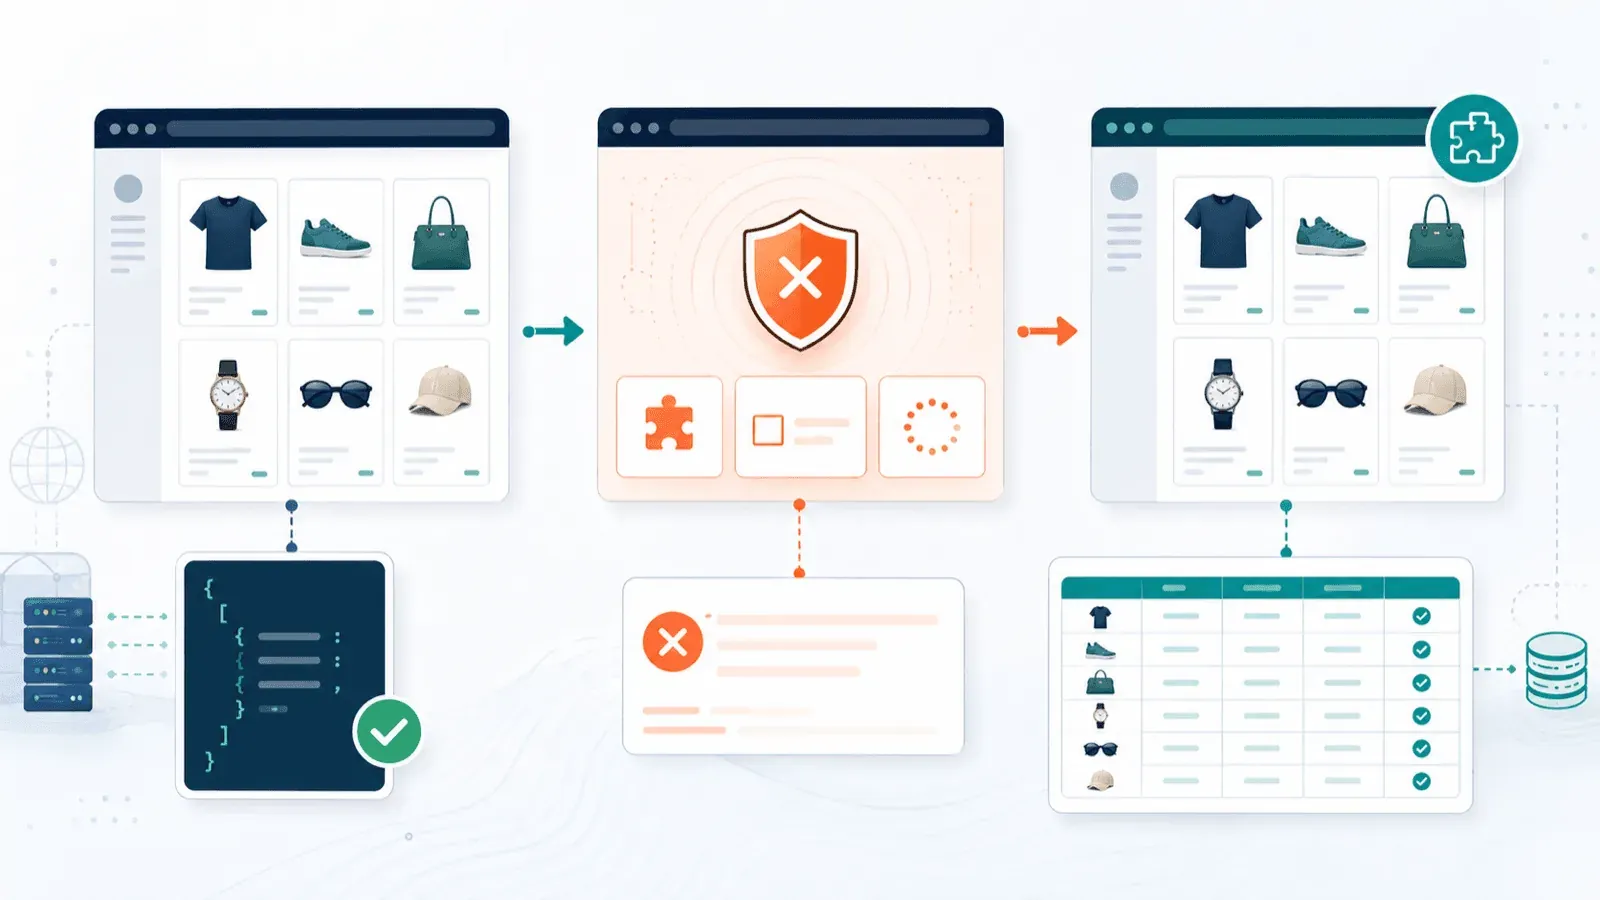
De flesta artiklar om Shopify-scraping låtsas att varje butik är vidöppen. Det är de inte. Store Leads rapporterar att 99,2 % av alla Shopify-butiker använder Cloudflare-infrastruktur. Det betyder inte att alla butiker aggressivt blockerar scrapers, men det betyder att infrastrukturen för att göra det finns överallt.
I praktiken ser spektrumet ut så här:
Lätt att skrapa
- Publika butiker utan aggressivt Cloudflare-skydd
- Butiker där products.json är aktiverat
- Butiker med standardiserade Shopify-teman (konsekvent DOM-struktur)
Svårare att skrapa
- Cloudflare-skyddade butiker (CAPTCHA-utmaningar, Turnstile)
- Butiker som kräver inloggning eller lösenord
- Shopify Plus-butiker med anpassade säkerhetslager
- Butiker med aggressiv rate limiting
Så hanterar varje verktyg anti-bot-scenarier
| Scenario | Bästa tillvägagångssätt | Verktyg som klarar det |
|---|---|---|
| Publik butik, inget anti-bot | Molnscraping (snabbt) | Thunderbit (molnläge), Instant Data Scraper, de flesta andra |
| Cloudflare-skyddad butik | Webbläsarbaserad scraping (använder din session) | Thunderbit (webbläsarläge), Web Scraper, Octoparse |
| Kräver inloggning / privat butik | Webbläsarscraping med din inloggade session | Thunderbit (webbläsarläge), Web Scraper, Simplescraper |
| products.json avstängt | DOM-baserad extraktion från renderad sida | Alla Chrome-tillägg (det är deras styrka) |
Thunderbits dubbla lägen för moln-/webbläsarscraping är verkligen relevanta här. Molnläget är snabbt för massuttag från publika butiker. Webbläsarläget använder din riktiga Chrome-session när anti-bot-skydd kräver det. Den flexibiliteten räddade mig på gymshark.com, där molnrequests blockerades men webbläsarläget fungerade fint.
Schemalagd Shopify-scraping: bevaka priser och lager över tid
Engångsscraping är användbart. Men e-handels- och operations-team behöver oftast löpande konkurrentinsikt — inte bara en enstaka ögonblicksbild. Prisändringar, lagerförändringar, nya produktlanseringar: allt detta sker kontinuerligt. En användare i ett forum uttryckte det tydligt: "Det är mer hjälpsamt att se deras aktuella lagernivå och ögonblicksbilder av hur nivån sjunker."
Ändå nämner nästan inga jämförande artiklar schemalagd eller återkommande scraping. Det är en tydlig blind fläck.
Så fungerar schemalagd Shopify-bevakning
- Ställ in en återkommande scraping av en konkurrents kategori- eller produktsidor
- Data exporteras till Google Sheets (eller Airtable) vid varje körning, vilket skapar en tidsserie för pris- och lagerdata
- Använd datan för att följa: prissänkningar/-höjningar, slutsålda varor, nya produktlanseringar, säsongsmönster
Så sätter du upp schemalagd scraping med Thunderbit
Thunderbit gör det här löjligt enkelt.
Du beskriver schemat på vanligt språk (t.ex. "varje måndag kl. 9"), anger Shopify-URL:erna och klickar på "Schedule". Thunderbit kör sedan scrapen automatiskt och exporterar till den destination du valt. Inga cron jobs, ingen kod, ingen extern schemaläggare.
Stöd för schemaläggning i alla 8 verktyg
| Verktyg | Schemaläggning? |
|---|---|
| Thunderbit | Ja — schemaläggning på vanligt språk |
| Instant Data Scraper | Nej |
| Web Scraper | Ja — i molnplaner |
| Data Miner | Automatiserade crawls finns, men inte den smidigaste schemaläggningen |
| Simplescraper | Ja |
| Octoparse | Ja — från Standard och uppåt |
| Bardeen | Ja — via tids-/datumautomations |
| Listly | Ja — på Business-planen |
Om löpande konkurrentbevakning ingår i ditt arbetsflöde är det här en viktig skillnad. De flesta gratis Chrome-tillägg erbjuder det inte alls.
Vilket Chrome-tillägg för Shopify-scraping passar ditt behov?
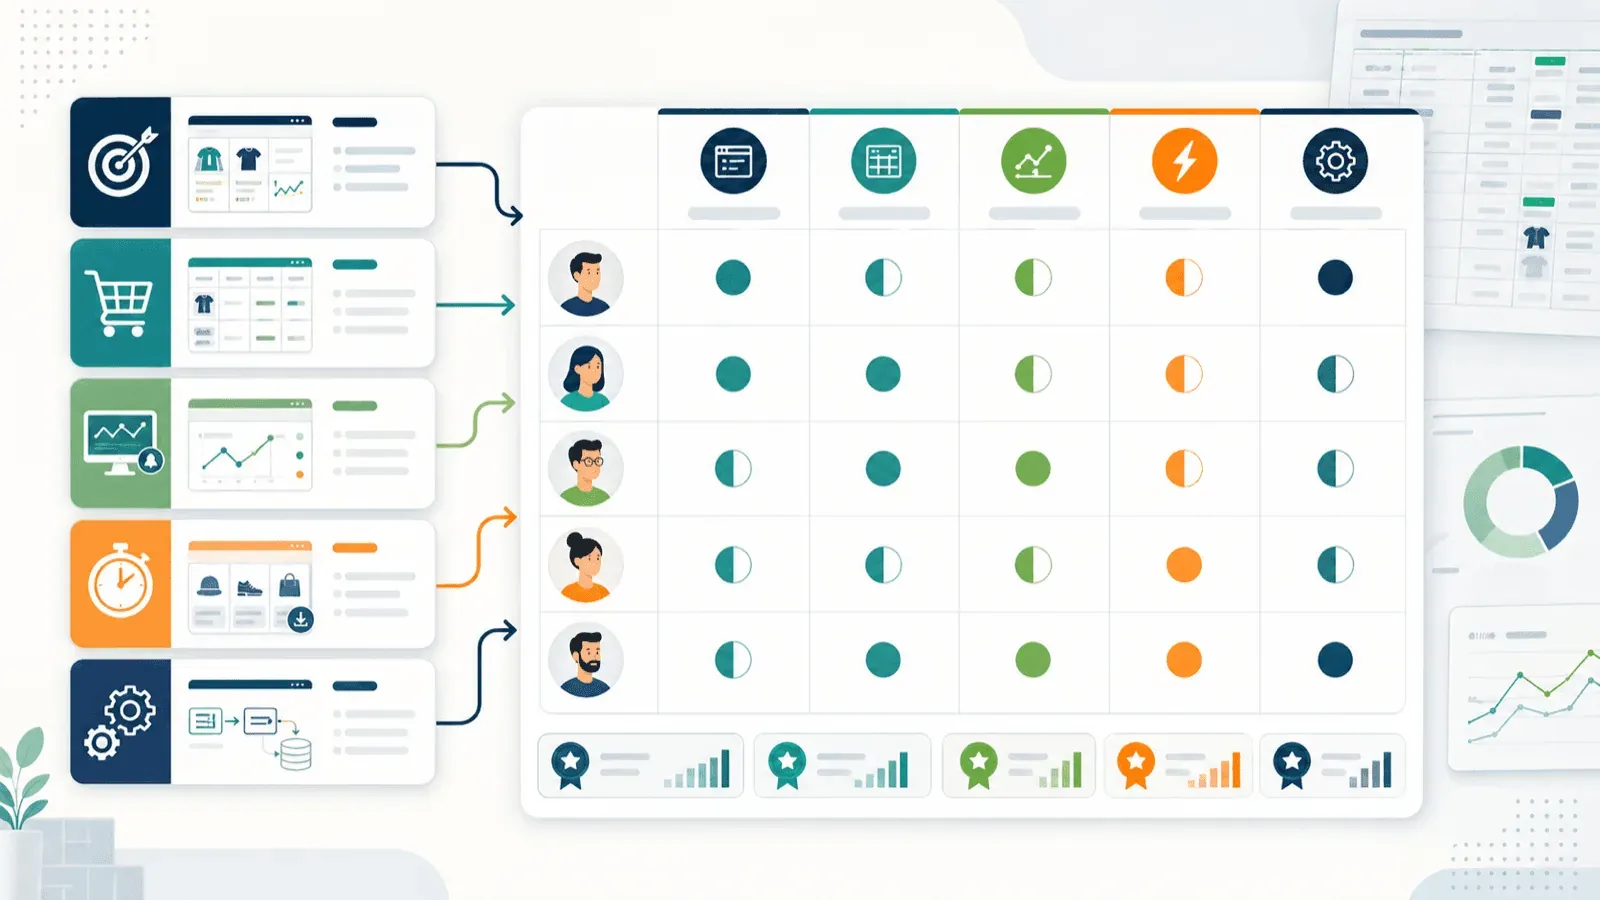
I stället för ett generiskt "välj det du gillar"-avslut, här är en beslutsmatris kopplad till konkreta användningsfall:
| Användningsfall | Bästa rekommendation | Varför |
|---|---|---|
| Prisbevakning av konkurrenter | Thunderbit | Listningssida + berikning via undersidor + schemaläggning = komplett prisflöde |
| Snabb engångsexport | Instant Data Scraper | Snabbaste gratisvägen när allt du behöver är synlig listdata |
| Import av katalog till din Shopify-butik | Thunderbit | Full data från undersidor + export som Shopify-importvänlig CSV/Excel |
| Löpande pris-/lagerbevakning | Thunderbit eller Octoparse | Enklast no-code-schemaläggning vs. starkast enterprise-liknande schemaläggning |
| Leadgenerering (kontaktuppgifter till butikägare) | Thunderbit | Inbyggda extraktorer för mejl/telefon + strukturerad export |
| Komplexa fler-stegs-automationer | Bardeen | Skrapa, berika och skicka vidare till andra appar i ett arbetsflöde |
| Tekniska användare som vill ha full kontroll | Web Scraper eller Octoparse | Bäst manuell kontroll över selectors, flöde och extraktionslogik |
Avslutning
Shopify-scraping år 2026 handlar inte om huruvida du kan få ut produktdata — utan om hur djup, hur snabb och hur repeterbar din process är. De flesta artiklar i det här området stannar vid listningssidan. Det verkliga värdet finns i berikning via undersidor, schemalagd övervakning och att hantera de anti-bot-överraskningar som riktiga Shopify-butiker kastar på dig.
Om du vill se hur det här ser ut i praktiken — från kategorisida till fullt berikad datamängd på några få klick — prova Thunderbit. Och om Thunderbit inte är den perfekta lösningen är Instant Data Scraper en bra gratis startpunkt för enkla jobb, medan Web Scraper och Octoparse är starka alternativ för tekniska användare som vill ha mer kontroll.
Lycka till med scrapen — och må din produktdata alltid vara komplett, strukturerad och rik på varianter.
Testa Thunderbit för Shopify-scraping Get Started Free
Vanliga frågor
1. Är det lagligt att skrapa data från Shopify-butiker?
Publikt tillgänglig produktdata i Shopify-butiker går i regel att nå för alla som besöker sidan. Med det sagt beror lagligheten på din jurisdiktion, butikens användarvillkor och vad du gör med datan. Att skrapa publika priser för konkurrentanalys är vanligt; att kopiera innehåll i sin helhet för återpublicering innebär större risk. Det här är inte juridisk rådgivning — rådgör med en expert för just din situation.
2. Kan jag skrapa Shopify-butiker som kräver inloggning eller lösenord?
Ja, men då behöver du en webbläsarbaserad scraper som använder din inloggade Chrome-session. Molnscrapers kommer i regel inte åt sidor bakom inloggning. Thunderbits webbläsarläge, Web Scraper (lokalt) och Simplescrapers inloggningsflöden stödjer detta scenario.
3. Hur många produkter kan jag skrapa från en Shopify-butik samtidigt?
Det beror på verktyg och plan. Shopifys products.json-endpoint paginerar med 250 produkter per sida. Thunderbits molnläge hanterar upp till 50 sidor åt gången. Gratisnivåer i de flesta verktyg sätter gränser för sidor, rader eller krediter — så kontrollera planens begränsningar innan du startar ett stort jobb.
4. Vad är skillnaden mellan molnscraping och webbläsarscraping för Shopify?
Molnscraping körs på fjärrservrar — det är snabbare och bättre för publika butiker utan anti-bot-skydd. Webbläsarscraping använder din lokala Chrome-session, vilket gör att den kan hantera Cloudflare-skyddade, inloggningskrävande eller regionkänsliga butiker. Thunderbit erbjuder båda lägena, och valet handlar oftast om huruvida butiken blockerar fjärrförfrågningar.
5. Kan jag exportera skrapad Shopify-data direkt till Google Sheets eller Airtable?
Ja, men inte alla verktyg stödjer det. Thunderbit exporterar till Google Sheets, Airtable, Notion, Excel, CSV och JSON — och det kostar inget extra. Data Miner och Listly stödjer Google Sheets. Simplescraper stödjer Sheets och Airtable. Octoparse stödjer Google Sheets på premiumplaner. Bardeen integrerar med Sheets, Airtable och Notion. Instant Data Scraper exporterar bara till CSV och XLSX utan direktkoppling till Sheets.
Läs mer




