
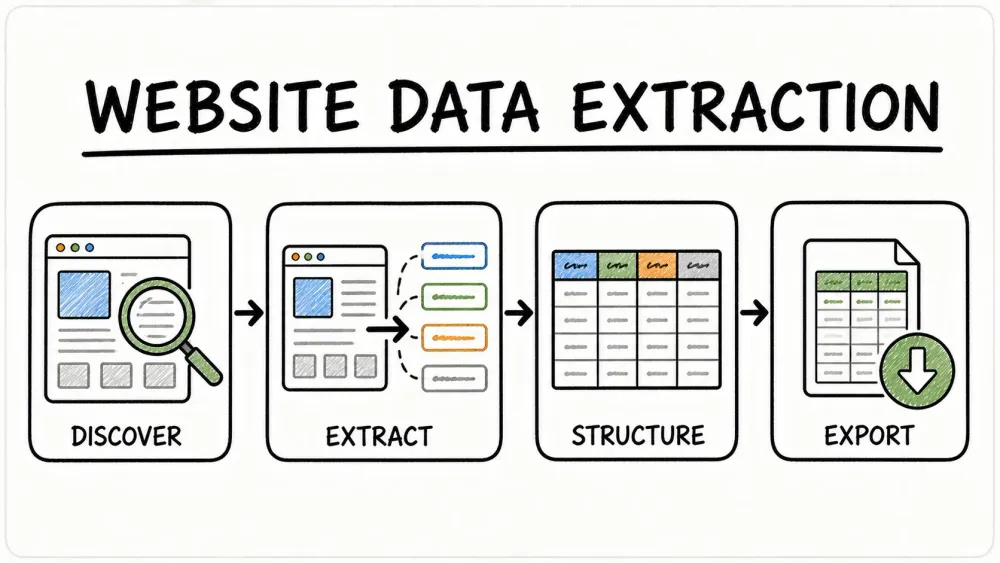
Webben svämmar över av information, men att förvandla det där kaoset till användbar affärsdata? Det är där den verkliga utmaningen — och möjligheten — finns. Under mina år med att bygga SaaS- och automationsverktyg har jag sett hur världen har gått från magkänsla till att nästan allt styrs av data. Det gäller inte längre bara teknikjättar; även små team jagar nu data från webbplats för att driva försäljning, marknadsföring, prissättning och produktbeslut. Men i takt med att webben blir stökigare och mer dynamisk är det en helt annan nivå att få fram ren, compliant och användbar data.
Låt oss vara praktiska: jag går igenom varför det är så viktigt för moderna företag att extrahera data från webbplats, de största hindren du kommer att stöta på och de bästa metoderna (inklusive några hårt vunna lärdomar från Thunderbit-teamet) för att göra det rätt — lagligt, effektivt och i stor skala. Oavsett om du hanterar ostrukturerat innehåll, oroar dig för GDPR eller bara vill slippa copy-paste till kalkylblad, är den här guiden för dig.
Varför det är viktigt för moderna företag att extrahera data från webbplats
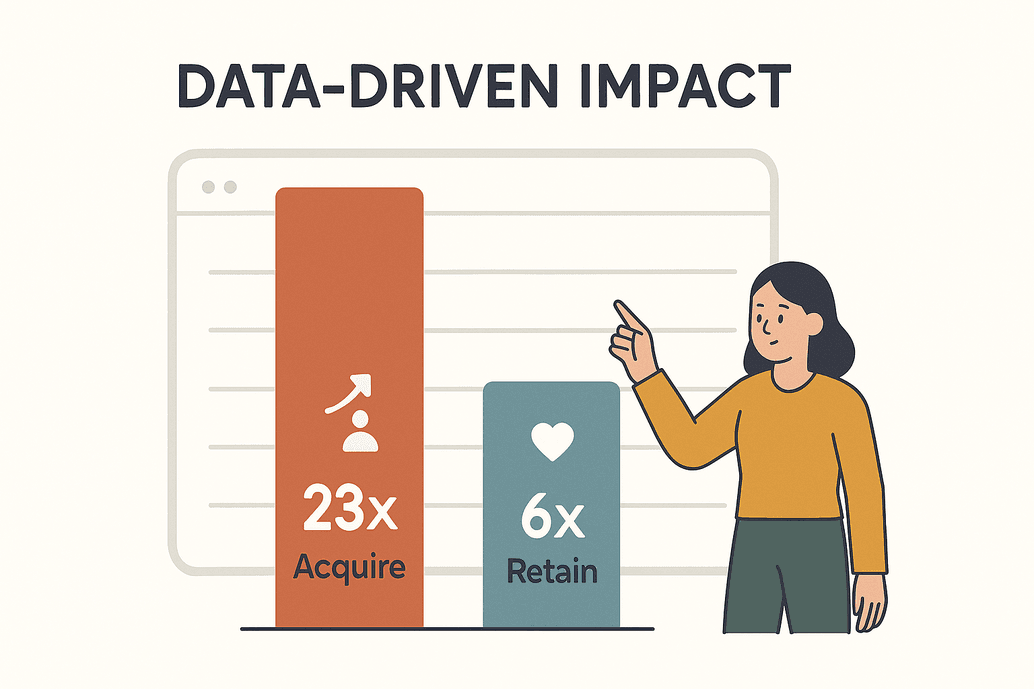 Data är inte bara ett buzzword — det är själva blodomloppet i konkurrenskraftiga företag i dag. Enligt en McKinsey-undersökning är datadrivna organisationer 23 gånger mer benägna att skaffa kunder och 6 gånger mer benägna att behålla dem. Det är inte bara imponerande — det är avgörande. Till 2025 kommer företag att skrapa miljarder webbsidor varje dag för att mata analys, AI-modeller och beslut i realtid (kanhasoft.com).
Så hur ser det här ut i praktiken? Här är några scenarier jag ser varje vecka:
| Affärstillämpning | Beskrivning och nytta | Exempel/statistik |
|---|---|---|
| Prisövervakning | Följ konkurrenters priser, lager och kampanjer i realtid; justera din egen strategi för att ligga steget före. | Över 80 % av de största e-handelsaktörerna skrapar konkurrenters priser dagligen (kanhasoft.com). |
| Leadgenerering | Extrahera kataloger, sociala medier eller recensionssajter för nya leads och kontaktuppgifter. | Automatiserad dataextraktion fyller CRM-system snabbare än manuell research. |
| Analys av marknadstrender | Samla recensioner, forum och nyheter för att tidigt upptäcka trender eller förändringar i sentiment. | 26 % av all scraping fokuserar på sociala medier för trendinsikter (blog.apify.com). |
| Innehållssamling | Samla nyheter, produktlistningar eller evenemang från flera sajter för enkel åtkomst. | Mediagrupper kuraterar flöden för sina målgrupper. |
| Produkt- och forskningsdata | Samla produktdetaljer, recensioner eller forskningsdata för analys och utveckling. | 67 % av investeringsrådgivare använder alternativa webdata (scrap.io). |
| AI-träningsdata | Hämta stora mängder text, bilder eller poster för att träna AI-modeller. | Cirka 70 % av stora AI-modeller förlitar sig på skrapad webdata (kanhasoft.com). |
Om du inte extraherar data från webbplats ligger du inte bara efter — du blir osynlig på din marknad. Jag har sett e-handelsteam tredubbla sin ROI på sex månader bara genom att automatisera skrapning av konkurrentpriser (kanhasoft.com). Slutsatsen: webdata är en strategisk tillgång, och att extrahera den väl är numera en grundförutsättning.
De största utmaningarna när du extraherar data från vilken webbplats som helst
Självklart är det inte bara solsken och CSV-filer. Webben är en vild plats, och att extrahera data från webbplats kommer med riktiga utmaningar:
- Ostrukturerad data: Cirka 80 % av all data på nätet är ostrukturerad — begravd i rörig HTML, utspridd över sidor eller dold bakom interaktiva element. Att göra om det till en ren tabell är ingen liten uppgift (scrapingapi.ai).
- Webbplatser som ändras: Sajter uppdaterar sina layouter hela tiden. Jag har sett skrapare gå sönder 15 gånger på en enda månad bara för att en målsajt justerade sin design (scrap.io).
- Volym och skala: Företag behöver extrahera data från hundratals eller tusentals sidor — ofta enligt schema. Manuell copy-paste hinner helt enkelt inte med.
- Anti-scraping-skydd: CAPTCHAs, begränsningar i anropsfrekvens, inloggningsväggar… Sajter blir allt bättre på att stoppa bottar. Över en tredjedel av all webbtrafik är nu bottar (scrap.io), och anti-bot-tekniken utvecklas snabbt.
- Manuella fel: Mänsklig copy-paste är långsam och felbenägen. Ett felaktigt selector-val, och du hämtar fel data — eller ingenting alls.
Traditionella metoder skalar helt enkelt inte. Därför går fler team över till smartare, automatiserade lösningar (och därför är jag så optimistisk kring AI-drivna verktyg).
Bästa praxis för juridik, compliance och säkerhet vid extraktion av webbdata
Låt oss reda ut det direkt: bara för att du kan extrahera data från en webbplats betyder det inte att du bör göra det — åtminstone inte utan att tänka på det juridiska och etiska. Här är vad varje företag behöver veta:
- Offentlig vs privat data: Att skrapa offentligt tillgänglig information är i allmänhet lagligt på många platser. Men allt bakom inloggning? Off limits. Att kringgå autentisering är inte okej (xbyte.io).
- Användarvillkor: Kontrollera alltid sajtens ToS. Om scraping är förbjudet riskerar du stämningar eller att bli blockerad. Är du osäker, be om tillstånd eller använd officiella API:er.
- Integritetslagar (GDPR, CCPA): Om du samlar personuppgifter behöver du en laglig grund (till exempel berättigat intresse), måste minimera det du samlar in och vara beredd att radera uppgifter på begäran. Bristande efterlevnad kan leda till enorma böter (xbyte.io).
- Respektera robots.txt: Den är inte juridiskt bindande, men det är god etikett. Följ crawl-delay-regler och överbelasta inte servrar.
- Datasäkerhet: Behandla skrapad data som känslig. Lagra den säkert, begränsa åtkomst och rensa den innan användning.
Compliance-checklista:
| Att tänka på | Bästa praxis |
|---|---|
| Laglig åtkomst | Skrapa endast offentlig data; kringgå aldrig inloggningar (xbyte.io). |
| Användarvillkor | Granska och respektera sajtens villkor; använd API:er om scraping är förbjudet. |
| Personuppgifter | Undvik om möjligt; om det behövs, minimera och följ GDPR/CCPA. |
| robots.txt och crawl-fördröjningar | Följ sajtens regler; begränsa antalet förfrågningar. |
| Datasäkerhet | Kryptera, begränsa åtkomst och radera när uppgifterna inte längre behövs. |
Öka effektiviteten: hur AI förbättrar extraktion av webbdata
Här blir det riktigt spännande. AI har totalt förändrat spelplanen för att extrahera data från webbplats. I stället för att brottas med selectors eller skriva sköra skript kan du nu använda AI-drivna verktyg som ”läser” sidan och själv listar ut vad som ska extraheras — ofta med bara några klick.
Vad betyder det i praktiken?
- Minimal uppsättning: AI-drivna skrapare som Thunderbit kan automatiskt identifiera fält. Klicka bara på ”One Click Extract” så föreslår verktyget rätt kolumner — ingen kod, inget trial and error.
- Anpassningsförmåga: AI-skrapare känner igen mönster, inte bara fasta layouter. Om en sajt ändras anpassar sig AI:n ofta automatiskt. Det betyder mindre underhåll och färre akuta kvällsproblem.
- Noggrannhet: AI kan filtrera bort brus, ta bort dubletter och till och med städa upp stökig data medan den skrapar. Vissa team rapporterar noggrannhet på så högt som 99,5 % med AI-baserade extraktorer (scrapingapi.ai).
- Dynamiskt innehåll: AI-skrapare kan hantera JavaScript-tunga sajter, oändlig scrollning och till och med extrahera text från bilder eller PDF-filer.
- Bearbetning i farten: Behöver du översätta, kategorisera eller sammanfatta data medan du skrapar? AI kan göra allt i ett svep.
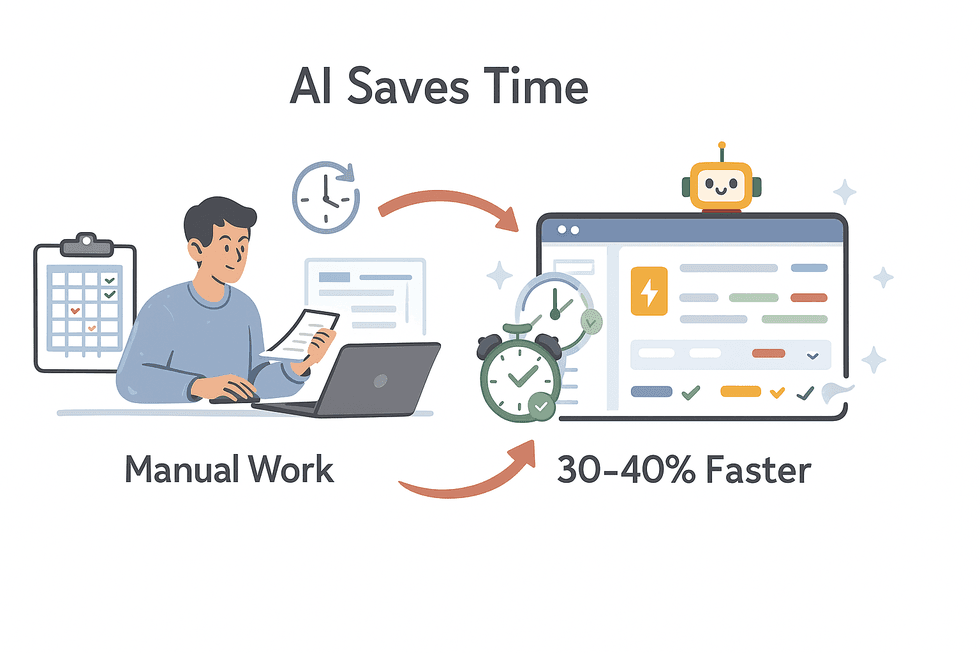 Jag har sett team spara 30–40 % av sin tid på dataextraktion bara genom att byta till AI-drivna verktyg (scrapingapi.ai). Det är inte bara en produktivitetsboost — det är ett konkurrensövertag.
Skrapa data från vilken webbplats som helst med AI Thunderbits agentiska webbskrapare läser själv igenom vilken webbplats som helst och väljer fälten att extrahera, ett klick i taget. Get Started Free
Thunderbit handlar om att göra extraktion enkel, exakt och tillgänglig — även för människor som aldrig skrivit en rad kod. (Och ja, min mamma kan använda det. Hon jobbar fortfarande på Netflix, däremot.)
Thunderbit Agentic Web Scraper: viktiga funktioner för affärsanvändare
Låt mig skryta lite om vad vi har byggt på Thunderbit (hej, jag får väl det?). Thunderbit är designat för affärsanvändare — sälj, drift, marknad, fastigheter — som vill ha resultat, inte huvudvärk. Här är det som gör att det sticker ut:
- One Click Extract: Klicka en gång så skannar Thunderbits AI sidan, föreslår kolumner och sätter upp skraparen åt dig. Inget mer pill med selectors.
- 2-klicksscraping: När fälten är klara klickar du bara på ”Scrape” och får en ren tabell — ingen kod, ingen konfiguration.
- Skrapning av undersidor: Behöver du mer detaljer? Thunderbit kan automatiskt besöka varje undersida (som produkt- eller profilsidor) och berika tabellen med extra information.
- Förbyggda mallar: För populära sajter (Amazon, Zillow, Instagram, Shopify osv.) väljer du bara en mall och kör — ingen installation krävs.
- Exportera överallt: Gratis export till Excel, Google Sheets, Airtable, Notion eller CSV. Inga dolda avgifter.
- Schemalagd scraping: Automatisera återkommande körningar — beskriv bara intervallet (”varje måndag kl. 08.00”) så sköter Thunderbit resten.
- Moln- eller webbläsarscraping: Använd Thunderbits molnservrar för snabbhet eller din egen webbläsare för sajter som kräver inloggning.
- Flerspråkigt stöd: Skrapa på 34 språk, inklusive engelska, spanska, kinesiska och fler.
Testa Thunderbit Agentic Web Scraper gratis Gratisplanen täcker 6 sidor per månad, ingen kreditkortsinformation krävs — ett bra sätt att testa extraktion på din målsajt. Get Started Free
Automatisera och skala: använd schemaläggning och integrationsverktyg för att extrahera data
Manuell scraping känns väldigt 2015. Det verkliga värdet kommer när du automatiserar och integrerar dataextraktionen i dina arbetsflöden:
- Schemalagd scraping: Ställ in Thunderbit att köra extraktioner dagligen, veckovis eller enligt vilket schema du vill. Perfekt för prisövervakning, leadgenerering eller nyhetsinsamling.
- Direktintegration: Exportera skrapad data direkt till Google Sheets, Excel, Airtable eller Notion. Inga fler nedladdningar och uppladdningar av filer.
- CRM- och analysintegration: Mata in data i ditt CRM- eller BI-verktyg för dashboards i realtid, aviseringar eller automatiserad outreach.
Exempel: automatiserat arbetsflöde för prisövervakning
- Ställ in Thunderbit på en konkurrents produktsida.
- Använd ”One Click Extract” för att fånga produktnamn, pris och URL.
- Schemalägg extraktionen till varje morgon kl. 07.00.
- Exportera resultaten till Google Sheets, kopplat till en dashboard.
- Prisansvarig granskar förändringarna och justerar strategin innan konkurrenterna ens har vaknat.
Med automation är du inte bara snabbare — du är alltid uppdaterad.
Bästa praxis för att hantera ostrukturerad data vid extraktion från webbplats
Låt oss vara ärliga: det mesta webbinnehållet är inte prydligt och rent. Det är ostrukturerat, inkonsekvent och ibland bara märkligt. Så här får du ordning på det:
- Låt AI:n definiera strukturen: Använd One Click Extract eller en mall för att skapa ordning — AI:n räknar ut kolumner och datatyper, och du kan justera efteråt om det behövs.
- AI-prompter per fält: Thunderbit låter dig lägga till egna instruktioner för varje fält. Vill du kategorisera produkter, formatera telefonnummer eller översätta beskrivningar? Säg bara till AI:n vad du vill ha.
- Utnyttja NLP: För recensioner, kommentarer eller artiklar kan du använda inbyggda NLP-funktioner för att sammanfatta, bedöma sentiment eller extrahera nyckelord.
- Normalisera data: Rensa format (datum, priser, telefonnummer) medan du skrapar, inte efteråt. Konsistens är nyckeln.
- Ta bort dubletter och validera: Rensa dubbletter och kontrollera ett urval av resultaten för noggrannhet. Om något ser fel ut, justera dina prompts eller inställningar.
AI-prompter per fält: anpassa dataextraktionen för bättre resultat
Det här är en av mina favoritfunktioner. Med AI-prompter på fältnivå kan du:
- Märka och kategorisera: ”Klassificera den här produkten som Elektronik, Möbler eller Kläder baserat på beskrivningen.”
- Tvinga fram format: ”Ange datum i formatet YYYY-MM-DD.” ”Extrahera endast det numeriska priset.”
- Översätta i farten: ”Översätt produktbeskrivningen till engelska.”
- Rensa bort brus: ”Extrahera användarbiografin och ignorera länkarna ’Läs mer’ eller annonser.”
- Kombinera fält: ”Slå ihop adressrader till ett enda fält.”
Det är som att ha en junioranalytiker inbyggd i din skrapare — en som aldrig klagar på kaffepauser.
Säkerställ datakvalitet och konsekvens i webbdataextraktion
Bra dataextraktion tar inte slut när du klickar på ”Export”. Så här håller du din data ren och tillförlitlig:
- Valideringskontroller: Använd intervallkontroller, obligatoriska fält och unika nycklar för att fånga fel.
- Stickprovsgranskning: Granska ett urval av den skrapade datan manuellt mot källsidan — särskilt efter uppsättning eller om sajten ändras.
- Felhantering: Logga misslyckade körningar och sätt upp varningar för avvikelser (som ett plötsligt fall i antal rader).
- Löpande rensning: Använd kalkylbladsverktyg eller skript för att trimma mellanslag, rätta kodning och normalisera text.
- Konsekvent schema: Håll fältnamn och format stabila över tid. Dokumentera ändringar så att teamet slipper gissa.
Förtroende för din data är allt. Lite noggrannhet i början sparar mycket huvudvärk senare.
Se hur Thunderbit står sig Se var Thunderbits AI-drivna extraktion med ett klick passar in bland marknadens andra webbskrapningsverktyg. Get Started Free
Jämförelse av extraktionsverktyg: vad du ska titta efter när du väljer lösning
Alla webbskrapningsverktyg är inte likadana. Här är vad du bör tänka på:
| Verktyg | Styrkor | Att tänka på |
|---|---|---|
| Thunderbit | Enklast för icke-tekniska användare; AI-baserad fältidentifiering; skrapning av undersidor; förbyggda mallar; gratis export; prisvärda planer (Thunderbit Blog). | Inte byggt för extremt stora, utvecklarintensiva projekt; använder ett kreditsystem. |
| Browse AI | No-code, bra för att övervaka förändringar; integration med Google Sheets; massuttag. | Dyrare startplaner; installationen kan ta tid. |
| Octoparse | Kraftfullt, hanterar dynamiska sajter; avancerade funktioner för tekniska användare. | Brant inlärningskurva; högre prissättning. |
| Web Scraper (webscraper.io) | Gratis för små projekt; visuell uppsättning; stark community. | Manuell konfiguration kan vara förvirrande; begränsat AI-stöd. |
| Diffbot | AI-drivet, tolkar ostrukturerade sidor via API; utmärkt för utvecklare. | Dyrt, API-baserat, inte för icke-tekniska användare. |
Mitt råd: Om du är en affärsanvändare som vill ha snabba och korrekta resultat är Thunderbit ett riktigt bra val. För avancerade användare eller utvecklare kan Octoparse eller Diffbot vara värt den extra komplexiteten. Testa alltid en gratisnivå eller provperiod innan du bestämmer dig.
Slutsats: sätt bästa praxis för webbdataextraktion i arbete
Att extrahera data från webbplats är inte längre något ”trevligt att ha” — det är ett måste för alla företag som vill hålla sig konkurrenskraftiga. Här är det jag hoppas att du tar med dig:
- Värde: Webdata driver smartare och snabbare beslut. Låt inte den möjligheten gå förlorad.
- Övervinn utmaningar: Använd AI-drivna verktyg för att hantera ostrukturerad data, volym och sajtändringar.
- Håll dig laglig: Respektera integritetslagar, sajtregler och datasäkerhet.
- Automatisera: Schemalägg och integrera extraktionen i dina dagliga arbetsflöden.
- Kvalitet först: Validera, rensa och övervaka din data löpande för att behålla förtroendet.
Redo att se hur enkelt det kan vara? Ladda ner Thunderbit Chrome Extension och testa den i ditt nästa dataprojekt. Och om du vill gå ännu djupare, kolla in Thunderbit Blog för fler guider, tips och verkliga exempel.
Lycka till med scraping — och må din data alltid vara strukturerad, compliant och redo för action.
Börja extrahera data med Thunderbit Installera Thunderbits gratis Chrome-tillägg och börja extrahera strukturerad data från vilken sida som helst med ett klick. Get Started Free
Vanliga frågor
1. Är det lagligt att extrahera data från vilken webbplats som helst?
I allmänhet är det lagligt att skrapa offentligt tillgänglig data i många jurisdiktioner, men du måste undvika att kringgå inloggningar eller säkerhetsmekanismer. Granska alltid sajtens användarvillkor och följ integritetslagar som GDPR och CCPA (xbyte.io).
2. Hur förbättrar AI processen att extrahera data från webbplats?
AI-drivna verktyg som Thunderbit kan automatiskt identifiera fält, anpassa sig till förändrade layouter, städa och formatera data och till och med hantera dynamiskt innehåll eller översättningar — allt med minimal uppsättning och hög noggrannhet (scrapingapi.ai).
3. Vilka är de bästa metoderna för att hantera ostrukturerad data?
Definiera datastrukturen i förväg, använd AI-prompter på fältnivå för att styra extraktionen, normalisera format medan du skrapar och validera resultaten. Verktyg som Thunderbit gör det enkelt att kategorisera, formatera och märka data direkt.
4. Hur kan jag automatisera och skala webbdataextraktion?
Använd schemaläggningsfunktioner för att köra extraktioner med jämna mellanrum och integrera resultaten direkt i verktyg som Google Sheets, Airtable eller ditt CRM. Automation säkerställer att din data är färsk och minskar manuellt arbete.
5. Hur säkerställer jag kvalitet och konsekvens i extraherad data?
Inför valideringskontroller, granska stickprov regelbundet, hantera fel smidigt och håll ditt schema konsekvent över tid. Kontinuerlig förbättring och övervakning är nyckeln till tillförlitlig data.
Vill du se dessa bästa praxis i praktiken? Testa Thunderbits gratisnivå och upplev hur enkelt, lagligt och skalbart webbdataextraktion kan vara.
Testa agentisk webbskrapare Get Started Free
Läs mer




