
Nästan hälften av all internettrafik kommer numera från bottar. De flesta av dem samlar in länkar, data och URL:er i stor skala. Om du fortfarande gör det manuellt tappar du tempo direkt.
Jag testade 12 olika verktyg för länkextraktion — från AI-drivna Chrome-tillägg till Python-bibliotek — för att se vilka som faktiskt levererar när du behöver tusentals URL:er snabbt.
Det här är vad jag kom fram till.
Varför länkextraktorer är viktiga
Låt oss vara ärliga: webben svämmar över av data, och företag tävlar om att omvandla det där kaoset till användbara insikter. Länkextraktorer och URL-extraktorer har därför blivit affärskritiska för team som vill:
- Generera leads: Säljteam kan på några minuter hämta länkar till företagsprofiler från kataloger eller LinkedIn och sedan mata in URL:erna i verktyg som extraherar kontaktuppgifter. Inget mer oändligt klickande.
- Samla innehåll och stärka SEO: Marknadsförare kan samla alla artikel-URL:er från en blogg, bevaka konkurrenters backlinks eller granska sajtstrukturer efter trasiga länkar.
- Bevaka konkurrenter och göra marknadsundersökningar: Operationsteam kan automatiskt samla länkar till nya produkter, prissidor eller pressmeddelanden — och hålla koll på konkurrenterna utan att svettas.
- Automatisera arbetsflöden och spara tid: Moderna länk-scrapers hanterar massimport av URL:er, crawlar undersidor och exporterar data i strukturerade format (CSV, Excel, Google Sheets, Notion — you name it). Det betyder slut på copy-paste-maraton och städning av röriga textfiler.
Med tanke på att tiotals miljarder webbsidor crawlas varje dag är manuell hantering inte ett alternativ. Rätt länkextraktor är som en superladdad assistent som aldrig blir trött, aldrig missar en länk och aldrig behöver en kaffepaus.
Så valde vi de bästa länkextraktorerna
Med så många verktyg där ute kan valet av rätt länkextraktor kännas som speed-dejting på en techkonferens — alla lovar att vara "den rätta", men bara några få levererar på riktigt. Så här tog jag fram topp 12:
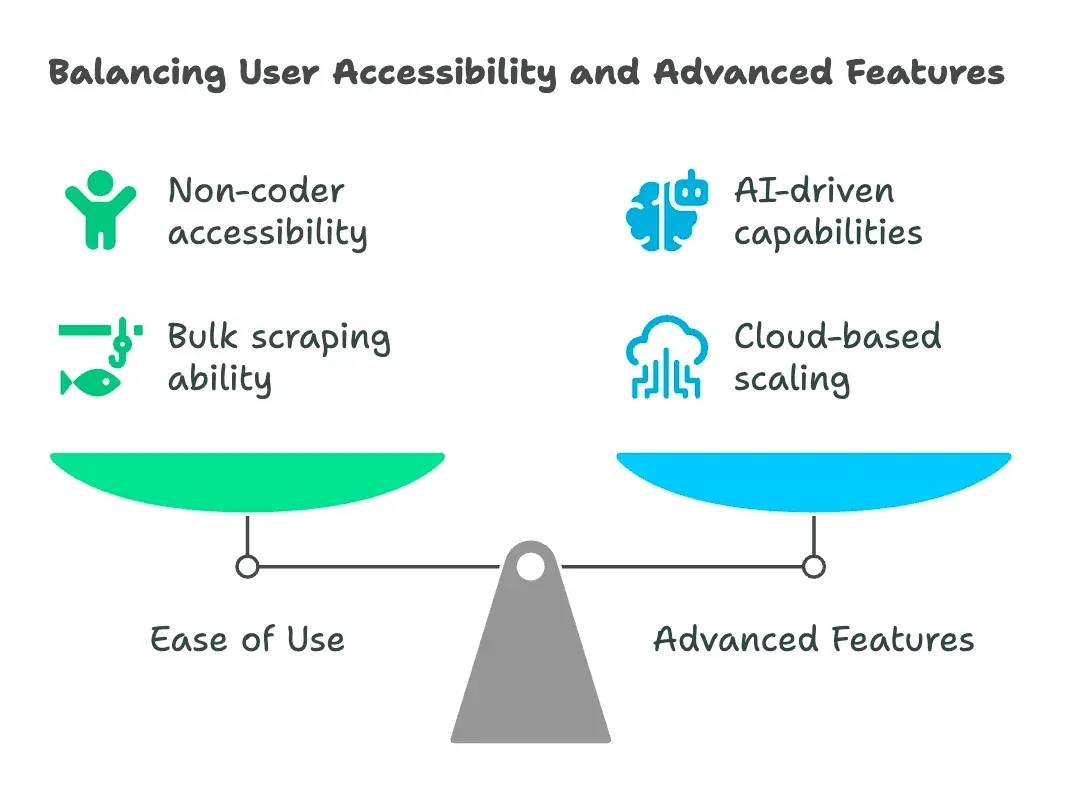
- Användarvänlighet: Kan personer utan kodning använda det utan en doktorsexamen i regex? No-code och low-code-lösningar fick extra poäng.
- Bulk- och flernivåextraktion: Klarar det hundratals URL:er samtidigt? Crawlar det undersidor och följer länkar automatiskt?
- Export och integration: Kan det exportera till CSV, Excel, Google Sheets, Notion, Airtable eller via API? Ju mindre manuellt arbete, desto bättre.
- Användartyp och flexibilitet: Är det byggt för affärsanvändare, analytiker eller utvecklare? Vissa verktyg är gjorda för alla, andra är mer nischade.
- Avancerade funktioner: AI-baserad igenkänning, schemaläggning, molnskalning, datarensning och mallar för vanliga webbplatser.
- Pris och skalbarhet: Gratisnivåer, pay-as-you-go eller enterprise? Jag tittade på vad du faktiskt får för pengarna.
Jag har tagit med allt från webbläsartillägg till enterprise-plattformar, så oavsett om du är ensam grundare eller ett datateam på Fortune 500-nivå finns det något som passar.
Thunderbit: den smartaste länkextraktorn för affärsanvändare
Vi börjar i toppen. Thunderbit är min självklara rekommendation för länkextraktion, och det är inte bara för att jag varit med och byggt det. Thunderbit är ett AI-drivet Chrome-tillägg för web scraping som är utvecklat för affärsanvändare som vill ha resultat snabbt.
Vad gör Thunderbit unikt? Det är som att ha en AI-praktikant som faktiskt lyssnar. Du kan beskriva vad du vill ha i naturligt språk (“Hämta alla produktlänkar och priser från den här sidan”), och Thunderbits AI tar hand om resten. Inget behov av att pilla med selektorer eller skriva skript.
Men det stannar inte där:
- Stöd för bulk-URL:er: Klistra in en enda URL eller en lista med hundratals — Thunderbit hanterar allt i ett svep.
- Navigering mellan undersidor: Behöver du extrahera länkar från en listsida och sedan besöka varje detaljsida för fler URL:er? Thunderbits flernivålogik för scraping fixar det.
- Strukturerad export: När länkarna är extraherade kan du döpa om fält, kategorisera dem och exportera direkt till Google Sheets, Notion, Airtable, Excel eller CSV. Inget mer efterarbete som ger huvudvärk.
Extrahera länkar från vilken webbplats som helst med AI Get Started Free
Thunderbit används av över 200 000 användare världen över, från säljteam till mäklare och mindre e-handelsföretag. Och ja, det finns en gratisnivå (extrahera upp till 6 sidor, eller 10 med en provboost), så du kan testa riskfritt.
Testa Thunderbit Link Extractor gratis
Thunderbits mest utmärkande funktioner
Låt oss titta närmare på vad som verkligen skiljer Thunderbit åt:
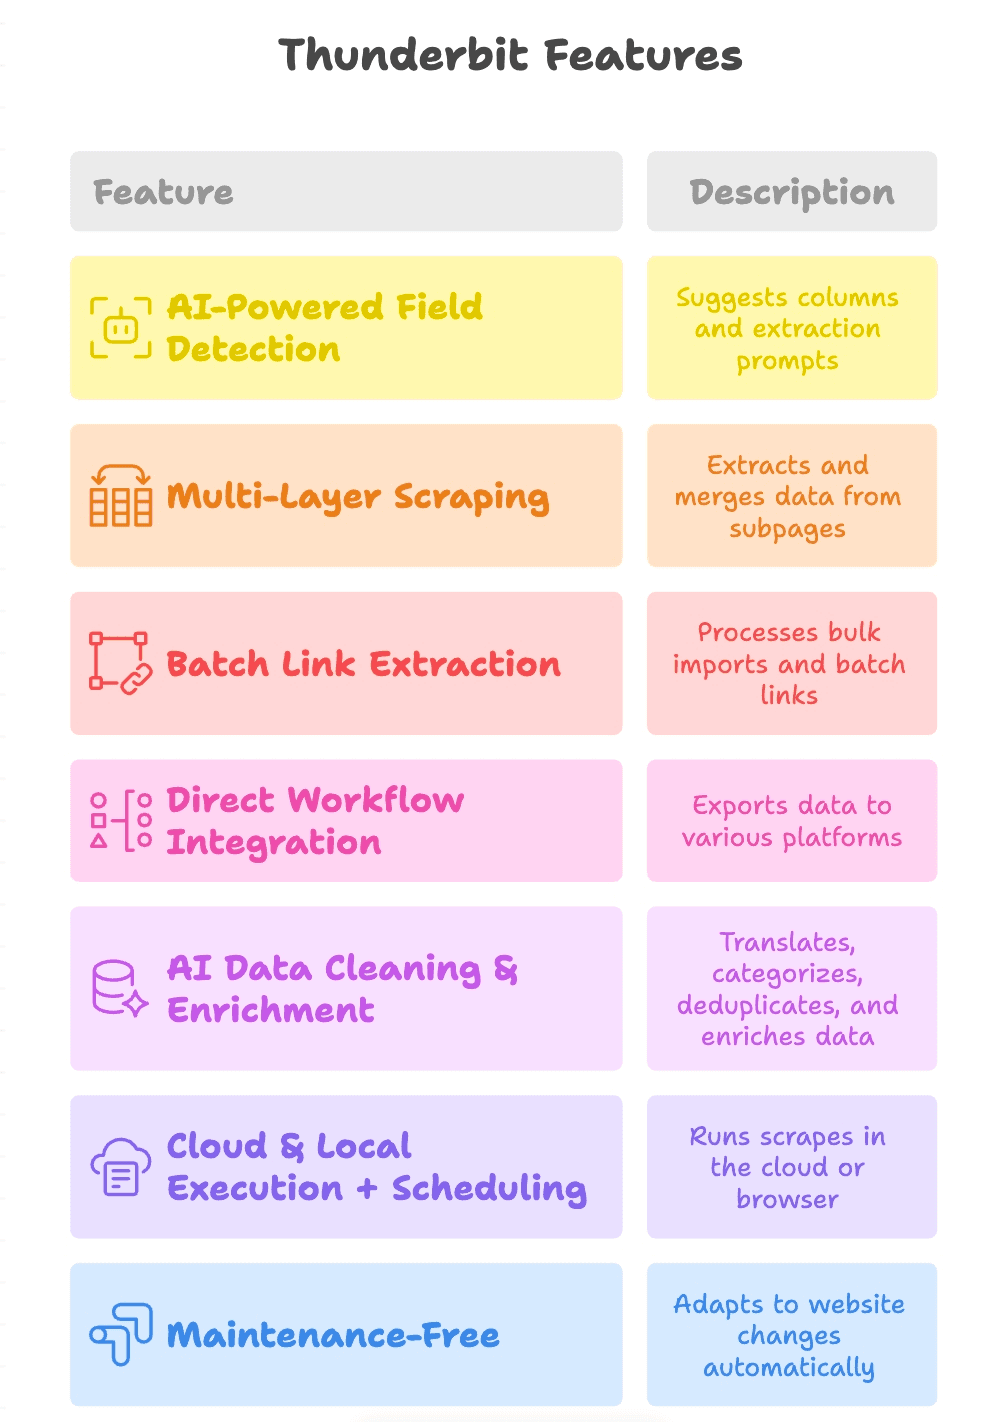
- AI-driven fältigenkänning: Klicka bara på “AI Suggest Fields”, så läser Thunderbit sidan, föreslår kolumner (till exempel “Produktlänk”, “PDF-URL”, “Kontakt-e-post”) och skapar till och med extraktionsprompter för varje fält.
- Flernivå-scraping: Thunderbit kan följa länkar från en huvudsida till undersidor (som produktsidor eller PDF-nedladdningar), extrahera fler länkar och slå ihop allt till en enda tabell.
- Batchad länkextraktion: Oavsett om du extraherar från en sida eller tusen kan Thunderbit hantera massimport och batchad länkextraktion utan problem.
- Direkt integration i arbetsflödet: Exportera resultat direkt till Google Sheets, Notion, Airtable eller ladda ner som CSV/Excel. Datan hamnar precis där teamet behöver den.
- AI-baserad datarensning och berikning: Thunderbit kan översätta, kategorisera, ta bort dubbletter och till och med berika datan medan den extraheras — så att resultatet är klart att använda, inte bara ett rått datautkast.
- Moln- och lokal körning + schemaläggning: Kör scraping i molnet för högre hastighet, eller i webbläsaren för sajter som kräver inloggning. Schemalägg återkommande jobb så att datan hålls uppdaterad.
- Underhållsfritt: Thunderbits AI anpassar sig efter webbplatsändringar, så du lägger mindre tid på att fixa trasiga scrapers och mer tid på att få resultat.
Octoparse: no-code-länkextraktor för alla
Octoparse är en klassiker i no-code-världen för scraping. Det är en datorapp (Windows/Mac) med ett visuellt gränssnitt där du klickar dig fram. Du laddar in en webbsida, klickar på de länkar du vill ha, och Octoparse sköter resten.
- Bra för nybörjare: Ingen kod behövs. Bara klicka, extrahera och kör.
- Hantera paginering och dynamiskt innehåll: Octoparse kan klicka på “Nästa”-knappar, scrolla och till och med logga in på sajter.
- Molnscraping och schemaläggning: Betalda planer låter dig köra jobb i molnet och schemalägga återkommande uppgifter.
- Exportalternativ: Ladda ner data som CSV, Excel, JSON eller skicka vidare till databaser.
Gratisplanen är generös för mindre jobb (upp till 10 uppgifter och 50 000 rader per månad), men tyngre användare behöver en betald plan (från cirka 69 USD/månad).
Apify: flexibel URL-extraktor för anpassade arbetsflöden
Apify är web scraping-världens schweiziska armékniv. Det erbjuder en marknadsplats med färdigbyggda “actors” (scrapingverktyg) samt möjligheten att skriva egna skript i JavaScript eller Python.
- Färdigbyggt men anpassningsbart: Använd community-actors för vanliga uppgifter eller bygg egna för specifika flöden.
- Bulk- och schemalagd scraping: Köa URL:er, kör jobb parallellt och schemalägg återkommande körningar.
- API-först: Exportera till JSON, CSV, Excel eller Google Sheets och koppla in det i din datapipeline.
- Pay-as-you-go: Gratis krediter varje månad, därefter användningsbaserad debitering.
Apify passar perfekt för halvtekniska team och utvecklare som vill ha flexibilitet och skalbarhet.
Bright Data URL Scraper: enterprise-nivå för länkextraktion
Bright Data är byggt för företag som behöver scrapa i stor skala. Deras Web Scraper API erbjuder förinställda, färdiga scrapers för jobb med höga volymer.
- Hantera massiv skala: Scrapa tusentals eller miljontals sidor med en robust proxy-infrastruktur som minskar risken för blockering.
- Förinställda mallar: Färdiga scrapers för e-handel, sociala medier, fastigheter och mycket mer.
- Enterprise-funktioner: Verktyg för compliance, expertstöd och avancerat skydd mot blockering.
- Prissättning: Gratisnivå (5 000 credits/månad), därefter 1,50 USD/1k poster pay-as-you-go eller 499 USD/månad för Scale — fortfarande enterprise-prissatt.
Om du är ett startup kanske detta är i överkant. Men för affärskritisk scraping i hög volym är Bright Data ett kraftpaket.
WebHarvy: visuell länkextraktor med point-and-click
WebHarvy är en Windows-app där du kan extrahera länkar genom att helt enkelt klicka på dem i den inbyggda webbläsaren.
- Supersimpelt: Klicka på en länk så markerar WebHarvy alla liknande element för extraktion.
- Stöd för reguljära uttryck: Inbyggda mönster för vanliga uppgifter, utan kod.
- Export till Excel, CSV, JSON, XML, SQL: Bra för affärsanvändare som vill ha data i välbekanta format.
- Engångslicens: Betala en gång, använd för alltid.
Perfekt för småföretag, forskare eller andra som vill ha ett snabbt och smidigt sätt att få ut länkar utan kod.
Web Scraper (Chrome Extension): snabb länkextraktion direkt i webbläsaren
Web Scraper Chrome Extension är ett gratis, open source-verktyg som förvandlar din webbläsare till en scraper.
- Definiera sitemaps: Tala om hur den ska navigera och vad som ska extraheras.
- Hantera paginering och crawla i flera nivåer: Crawla kategorier, underkategorier och detaljsidor.
- Export till CSV/XLSX: Ladda ner data direkt från webbläsaren.
- Community-mallar: Många delade sitemaps för populära webbplatser.
Det passar perfekt för snabba engångsjobb eller för studenter och små team med begränsad budget.
ScraperAPI: skalbar länkextraktor för utvecklare
ScraperAPI riktar sig till utvecklare som vill hämta webbsidor i stor skala utan att behöva oroa sig för proxies, blockering eller CAPTCHAs.
- API-drivet: Skicka en URL och få tillbaka HTML eller extraherad data.
- Klarar skala och anti-bot-skydd: Inbyggd proxyrotation, JS-rendering och CAPTCHA-lösning.
- Integreras med din kod: Använd med Python, Node.js eller vilket språk som helst.
- Prissättning: Gratis provperiod (~5 000 API-credits), därefter betalning per förfrågan.
Perfekt för skräddarsydda crawlers eller när du behöver pålitlighet och hastighet i stor skala.
ParseHub: visuell länkextraktor med avancerat urval
ParseHub är en desktop-app (Windows, Mac, Linux) där du bygger scrapingprojekt visuellt.
- Avancerat urval och navigering: Klicka, loopa och extrahera länkar villkorligt — även från dynamiska eller dolda element.
- Hantera nästlade sidor: Crawla kategorier, sedan detaljsidor, och extrahera därefter fler länkar.
- Export till CSV, Excel, JSON: Molnkörningar och API-åtkomst ingår i betalda planer.
- Gratisplan: 5 projekt, upp till 200 sidor per körning.
ParseHub är en favorit bland marknadsförare och forskare som vill ha kraft utan kod.
Scrapy: Python-länkextraktor för utvecklare
Scrapy är guldstandarden för Python-utvecklare som vill ha full kontroll.
- Code-first: Bygg anpassade spiders för att crawla och extrahera länkar i vilken skala som helst.
- Hantera distribuerad crawling: Effektivt, asynkront och mycket anpassningsbart.
- Export till CSV, JSON, XML eller databas: Du styr utdata.
- Open source och gratis: Men du behöver hantera din egen miljö.
Om du är bekväm med Python är Scrapy så kraftfullt som det blir.
Diffbot: AI-drivna länkextraktorer för strukturerad data
Diffbot är web scraping-världens “AI-hjärna”. Det analyserar sidor och returnerar strukturerad data — inklusive länkar — utan manuell konfiguration.
- Automatisk innehållsigenkänning: Mata in en URL och få tillbaka strukturerad data (artiklar, produkter, länkar osv.).
- Crawlbot och Knowledge Graph: Crawla hela webbplatser eller sök i deras massiva webbindex.
- API-drivet: Integrera med BI-verktyg eller din datapipeline.
- Enterprise-prissättning: Från cirka 299 USD/månad, men du får vad du betalar för.
Bäst för företag som vill ha ren, strukturerad data utan att själva behöva hantera scrapers.
Cheerio: lättviktig länkextraktor för Node.js
Cheerio är en snabb HTML-parser för Node.js som liknar jQuery.
- Supersnabb: Tolkar HTML på millisekunder.
- Bekant syntax: Kan du jQuery kan du Cheerio.
- Perfekt för statiska sidor: Renderar inte JS, men är idealisk för servergenererat innehåll.
- Open source och gratis: Kombinera med axios eller fetch för att göra förfrågningar.
Idealisk för utvecklare som bygger egna skript och vill ha fart och enkelhet.
Puppeteer: webbläsarautomatisering för avancerad länkextraktion
Puppeteer är ett Node.js-bibliotek för att styra Chrome i headless-läge.
- Full webbläsarautomatisering: Ladda sidor, klicka, scrolla och interagera som en riktig användare.
- Hantera dynamiskt innehåll och inloggningar: Perfekt för JavaScript-tunga sajter eller komplexa arbetsflöden.
- Finmaskig kontroll: Vänta på element, ta skärmdumpar, intercepta nätverksförfrågningar.
- Open source och gratis: Men resurskrävande och långsammare än lättviktsverktyg.
Använd Puppeteer när du behöver extrahera länkar från sajter som inte samarbetar med enklare scrapers.
Jämförelse i korthet: vilken länkextraktor passar dina behov?
Här är en snabb jämförelse av alla 12 verktyg:
| Verktyg | Bäst för | Stöd för bulk och undersidor | Exportalternativ | Prissättning |
|---|---|---|---|---|
| Thunderbit | Icke-kodare, företag | Ja (AI, flernivå) | Excel, CSV, Sheets, Notion, Airtable | Gratis provperiod, från ca 9 USD/mån |
| Octoparse | No-code-användare, analytiker | Ja | CSV, Excel, JSON, molnlagring | Gratisnivå, ca 69 USD/mån |
| Apify | Halvtekniska användare, utvecklare | Ja | CSV, JSON, Sheets via API | Gratis krediter, användningsbaserat |
| Bright Data | Enterprise | Ja (hög volym) | CSV, JSON, NDJSON via API | Gratisnivå, därefter 1,50 USD/1k poster |
| WebHarvy | Icke-kodare, desktop | Ja | Excel, CSV, JSON, XML, SQL | Betald licens |
| Web Scraper Extension | Alla, snabbt/gratis | Ja | CSV, XLSX | Gratis, open source |
| ScraperAPI | Utvecklare, API-användare | Ja | JSON (HTML via API) | Gratis 5k provcredits, betalda nivåer |
| ParseHub | Icke-kodare, avancerat | Ja | CSV, Excel, JSON, API | Gratis 5 projekt, betalt |
| Scrapy | Utvecklare, Python | Ja | CSV, JSON, XML, DB | Gratis, open source |
| Diffbot | Enterprise, AI | Ja (AI-crawl) | JSON (strukturerad data via API) | ca 299 USD/mån+ |
| Cheerio | Utvecklare, Node.js | Ja (egen kod) | Anpassat (JSON osv.) | Gratis, open source |
| Puppeteer | Utvecklare, komplexa sajter | Ja (full automatisering) | Anpassat (skriptad utdata) | Gratis, open source |
Att välja rätt länkextraktor för ditt företag
Så, hur väljer du? Här är min fusklapp:
- Inga kodkunskaper? Börja med Thunderbit, Octoparse, ParseHub, WebHarvy eller Web Scraper-tillägget.
- Behöver du anpassade arbetsflöden? Apify, ScraperAPI eller Cheerio är starka val för utvecklare.
- Enterprise-skala? Bright Data eller Diffbot är byggda för det.
- Python- eller Node.js-utvecklare? Scrapy (Python) eller Cheerio/Puppeteer (Node.js) ger dig full kontroll.
- Vill du exportera direkt till Sheets/Notion? Thunderbit är ditt bästa alternativ.
Matcha verktyget med din tekniska nivå, datamängd och integrationsbehov. De flesta har gratis provperioder, så var inte rädd för att testa dig fram.
Utforska fler guider om web scraping Get Started Free
Thunderbits unika värde för länkextraktion 2026
Låt oss återvända till det som verkligen gör Thunderbit annorlunda:
- AI-driven enkelhet: Beskriv vad du vill ha på vanlig svenska — Thunderbits AI sköter resten.
- Flernivå-scraping: Extrahera länkar från huvudsidor, följ vidare till undersidor och hämta fler URL:er — allt i ett enda flöde.
- Massimport och batchbearbetning: Klistra in hundratals URL:er, extrahera länkar i bulk och exportera strukturerad data direkt.
- Workflow-integration: Exportera direkt till Google Sheets, Notion, Airtable eller ladda ner som CSV/Excel.
- Inget underhåll: Thunderbits AI anpassar sig till webbplatsändringar, så du slipper ständigt laga trasiga scrapers.
Thunderbit bygger en bro mellan “att bara samla in data” och “att få data du faktiskt kan använda”. Det är verktyget jag önskar att jag hade för flera år sedan när jag drunknade i manuella datauppgifter.
Kom igång gratis med länkextraktion i Thunderbit
Slutsats: extrahera länkar smartare och förbättra ditt arbetsflöde
Webbdata är bränslet för tillväxt — och rätt länkextraktor är din motor. Oavsett om du bygger leadlistor, bevakar konkurrenter eller automatiserar research finns det ett verktyg här som passar både dina behov och din kompetens.
Om du vill se hur modern länkextraktion ser ut, testa Thunderbits gratisperiod. Jag tror att du kommer att bli förvånad över hur mycket du kan få gjort på bara några klick. Och om Thunderbit inte är den perfekta lösningen, prova några andra verktyg i listan — det har aldrig varit en bättre tid att automatisera det tråkiga och fokusera på det som verkligen spelar roll.
Glad scraping — och må dina länkar alltid vara rena, strukturerade och redo att användas. Vill du fördjupa dig i web scraping, kolla in Thunderbit Blog för fler guider och tips.
Testa Thunderbit Link Extractor gratis Get Started Free
FAQ
1. Varför är länkextraktorer så viktiga?
Med nästan hälften av internettrafiken från bottar och företag som aggressivt samlar in data är länkextraktorer avgörande för att omvandla webbstök till användbara insikter. De hjälper till att automatisera uppgifter som leadgenerering, innehållssamling, SEO-granskningar och konkurrentbevakning, vilket sparar enormt mycket tid och arbete.
2. Vad gör Thunderbit speciellt jämfört med andra länkextraktorer?
Thunderbit använder AI för att förenkla scraping — beskriv bara ditt mål med vanliga ord, så sköter den resten. Den stödjer massinmatning av URL:er, flernivå-scraping, smart fältigenkänning och smidig export till plattformar som Google Sheets och Notion. Den är idealisk för icke-kodare och affärsanvändare som vill ha kraftfulla resultat utan tekniskt krångel.
3. Finns det länkextraktorverktyg för utvecklare och anpassade arbetsflöden?
Ja. Verktyg som Apify, ScraperAPI, Cheerio, Puppeteer och Scrapy riktar sig till utvecklare. De erbjuder skriptning, API-integration och flexibilitet för att hantera komplexa scrapinguppgifter, storskaliga jobb och avancerad automatisering.
4. Vilka verktyg är bäst för personer utan kodningserfarenhet?
Thunderbit, Octoparse, ParseHub, WebHarvy och Web Scraper Chrome-tillägget är toppval för icke-tekniska användare. De här verktygen erbjuder visuella gränssnitt, färdiga mallar och AI-drivna funktioner som gör länkextraktion tillgänglig för alla.
5. Hur väljer jag rätt länkextraktor för mina behov?
Tänk igenom din tekniska nivå, datamängd och exportbehov. Icke-kodare bör välja verktyg som Thunderbit eller Octoparse, medan utvecklare kanske föredrar Scrapy eller Puppeteer. Företag i större skala kan titta på Bright Data eller Diffbot för verksamhet med höga volymer. Börja alltid med en gratis provperiod för att se vad som passar bäst.




