
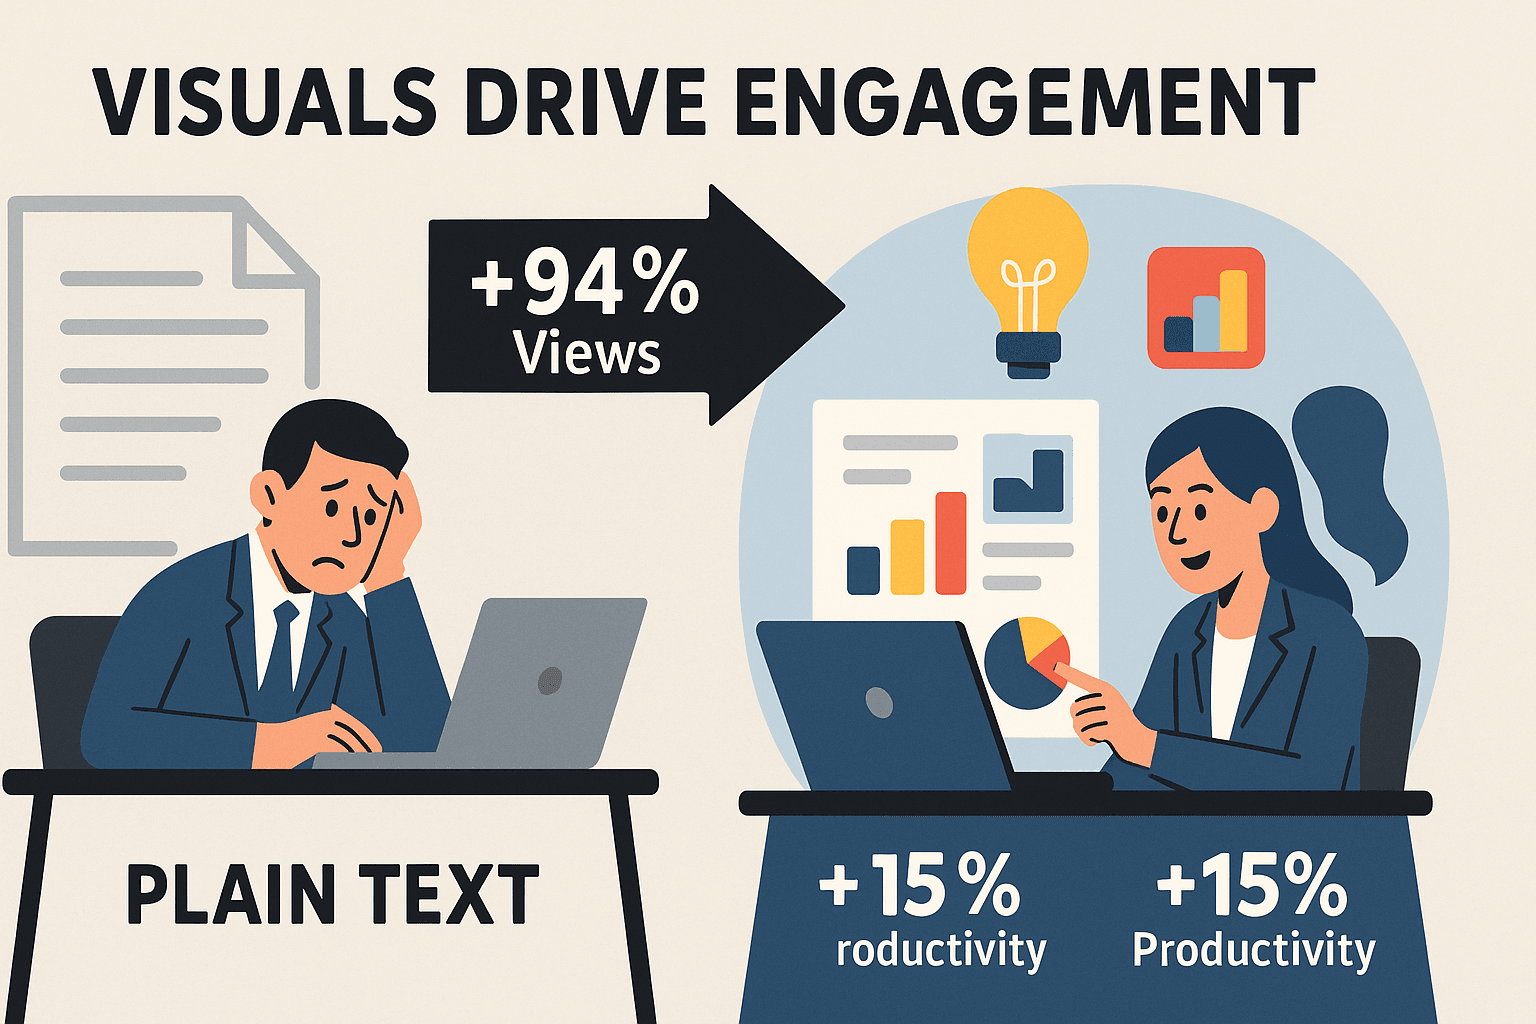
Webben har blivit en visuell djungel – bilder överallt, från produktgallerier och bostadsannonser till flöden i sociala medier och konkurrentkataloger. Jag har själv sett hur team inom sälj, e-handel och marknadsföring kämpar för att hänga med, inte bara med ord och siffror, utan med den enorma våg av bilder som påverkar beslut och formar varumärken. Visste du att artiklar med bilder får 94% fler visningar än inlägg med enbart text? Eller att instruktioner som kombineras med visuella element kan öka produktiviteten med 15%? Visuella data är inte bara “trevligt att ha” – det är den nya affärsvalutan.
Men här är nackdelen: att extrahera bilder i stor skala är krångligt. Att manuellt högerklicka och spara varje bild? Det är ett säkert sätt att få ont i handleden. Och när webbplatser blir allt mer dynamiska – tänk oändlig scroll, popup-gallerier och innehåll som laddas via AJAX – hänger gamla typer av scrapers helt enkelt inte med. Därför har jag satt ihop den här listan med de 5 bästa verktygen för bildcrawling för effektiv datainsamling 2026. Oavsett om du är en icke-teknisk användare som bara vill ha resultat, en utvecklare som gillar att pilla och optimera, eller ett företag med stora databehov, finns det ett verktyg här för dig.
Låt oss gå igenom vad som gör en bildcrawler riktigt bra, hur verktygen står sig mot varandra och vilket som kan bli den hemliga komponenten som din arbetsprocess saknat.
Varför det är viktigt att välja bästa bildcrawler
Upptäck de bästa verktygen för web scraping Get Started Free
Bilder finns överallt, men att få ut dem från webben och in i din arbetsprocess är allt annat än enkelt. Företag använder bilddata till allt från marknadsundersökningar och konkurrentanalys till träning av AI-modeller och innehållsproduktion. Inom retail och fastigheter kan bilder avgöra om en affär går i lås – kunder vill se, inte bara läsa. Marknadsteam följer användargenererade bilder för att hitta trender, medan forskare hämtar produktbilder för att analysera designförändringar.
Men det är här det blir svårt:
- Dynamiskt innehåll: Många sajter laddar bara bilder efter att du scrollat eller klickat – enkla scrapers missar detta helt.
- Sidindelning och oändlig scroll: Produktgallerier sträcker sig ofta över många sidor, och de bästa crawlarna måste kunna hantera “Nästa”-knappar eller ändlös scroll automatiskt.
- Filtrering av relevanta bilder: Alla bilder är inte användbara – annonser, ikoner och dekorativa grafik-element kan snabbt förstöra datamängden.
- Integrationsproblem: Efter scraping behöver du få in bilderna (eller deras URL:er) i Excel, Sheets, Notion eller din databas – helst utan en vecka av copy-paste.
Väljer du fel verktyg riskerar du ofullständig data, bortkastad tid eller att bli blockerad av webbplatser. Rätt bildcrawler kan däremot spara timmar eller dagar, förbättra precisionen och hjälpa dig att fatta bättre beslut snabbare.
Hur vi valde ut de bästa verktygen för bildcrawling
Alla bildcrawlers är inte skapade lika. När jag letade efter de bästa tittade jag på:
- Enkel användning: Kan personer utan teknisk bakgrund komma igång snabbt? Krävs kod, eller kan man bara klicka sig fram?
- Skalbarhet: Klarar den hundratals eller tusentals sidor? Kan den köras i molnet för högre hastighet?
- Precision och flexibilitet: Kan den extrahera bilder från dynamiska sajter med mycket JavaScript? Klarar den undersidor, filtrering och anpassad logik?
- Integration och export: Hur lätt är det att få in datan i Excel, Google Sheets, Notion, Airtable eller din egen databas?
- Pris och värde: Finns det en gratisnivå? Är kostnaden rimlig för mindre team, eller är den byggd för företagsbudgetar?
Jag tog också hänsyn till att användare har olika behov – vissa vill ha en no-code-lösning, andra behöver utvecklarstyrning, och vissa företag kräver kompromisslös driftsäkerhet och efterlevnad.
Med det sagt, här är mina val av de 5 bästa verktygen för bildcrawling 2026.
1. Thunderbit
Thunderbit är mitt förstahandsval för alla som vill att bildextrahering ska gå snabbt, smart och – vågar jag säga – faktiskt vara roligt. Som medgrundare är jag förstås lite partisk, men jag byggde Thunderbit eftersom jag tröttnade på att se team kämpa med klumpiga, föråldrade scrapers.
Därför sticker Thunderbit ut:
- AI-driven enkelhet: Beskriv bara vad du vill ha (“hämta alla produktbilder och priser”), så löser Thunderbits AI resten. Inga selectors, ingen kod, inga gissningar.
- Arbetsflöde med ett klick: Ett klick, och Thunderbit bestämmer vilka fält som ska byggas – bild-URL:er, titlar och mer – fyller tabellen och du är klar. Vill du bara ha produktbilderna? Be om det, så hoppar den över resten.
- Scraping av undersidor: Behöver du bilder från detaljsidor? Thunderbit kan gå in på varje undersida och hämta varje bild – perfekt för e-handel, fastigheter eller sajter med gallerier.
- Hanterar dynamiskt innehåll och sidindelning: Oavsett om det är oändlig scroll, knappen “Ladda fler” eller bilder som laddas via JavaScript kan Thunderbits browser- och cloud-lägen hantera det (docs).
- Direkt export: Skicka din bilddata (inklusive faktiska bildfiler, inte bara URL:er) direkt till Excel, Google Sheets, Airtable eller Notion.
- Gratis bildextrahering: Thunderbits funktioner för bildextrahering och export är gratis för mindre jobb (6–10 sidor), med ett kreditsystem per rad för större projekt – inga dolda avgifter eller överraskningar.
Thunderbits viktigaste funktioner för bildextrahering:
- AI-baserad fältigenkänning: Thunderbits AI skannar sidan och väljer bildfälten själv, så du slipper leta efter rätt HTML-tag (docs).
- Automatisering av undersidor och sidindelning: Hämta bilder från listningssidor och gå sedan vidare in på varje detaljsida – allt i ett och samma flöde.
- Moln- kontra webbläsarcrawling: Använd molnläge för fart (upp till 50 sidor samtidigt), eller webbläsarläge för sajter som kräver inloggning eller tung JavaScript.
- Export och integration: Exportera med ett klick till Excel, Sheets, Notion eller Airtable. Bilder visas direkt i Notion/Airtable – inga extra uppladdningssteg (docs).
- Stöd för flera språk: Thunderbit fungerar på 34 språk, så det är redo för globala team.
Vem passar det för?
- Sälj-, marknads- och researchteam som vill ha resultat utan att koda.
- Alla som snabbt behöver hämta bilder från moderna, dynamiska webbplatser.
Pris: Gratis för upp till 6–10 sidor. Betalda planer börjar på 15 USD/månad för 500 credits (rader), vilket gör det tillgängligt för små team och skalbart för större projekt.
Testa Thunderbit gratis för bildextrahering
Om du vill se hur enkelt bildcrawling kan vara, ladda ner Thunderbits Chrome-tillägg och prova själv.
2. Scrapy
Scrapy är web scraping-världens schweiziska armékniv för utvecklare. Det är öppen källkod, byggt i Python och skapat för dem som vill kontrollera varje steg i crawlingen.
Därför sticker Scrapy ut:
- Maximal flexibilitet: Skriv dina egna “spiders” i Python för att crawla vilken sajt som helst, hantera inloggningar, tolka knepig HTML och extrahera exakt de bilder – eller den data – du vill ha.
- Hög prestanda: Scrapys asynkrona arkitektur gör att det kan crawla tusentals sidor och ladda ner bilder parallellt – perfekt för stora projekt.
- Images Pipeline: Scrapy har en inbyggd Images Pipeline som inte bara kan hämta bild-URL:er, utan faktiskt ladda ner filerna, skapa miniatyrer och filtrera efter storlek eller format.
- Utbyggbart: Massor av plugins för proxies, inloggning och mycket mer. Stort community-stöd.
Scrapys möjligheter för bildextrahering:
- Anpassad logik: Behöver du bara hämta bilder över en viss storlek? Vill du hoppa över dubbletter? Scrapy kan göra allt detta i kod.
- Integration: Skicka utdata till din egen databas, molnlagring eller vilket format du vill.
- Öppen källkod: Gratis att använda – du behöver bara Python-kunskaper och en server.
Vem passar det för?
- Utvecklare, dataingenjörer och tekniska team som vill ha full kontroll.
- Projekt där scraping behöver integreras i en större pipeline eller automatiseras i stor skala.
Pris: Gratis (öppen källkod), men du behöver investera i utveckling och infrastruktur.
3. Octoparse
Octoparse är ett visuellt no-code-verktyg för web scraping som gör bildextrahering tillgängligt för alla – även om din senaste kodvana var att byta bakgrund på MySpace.
Därför sticker Octoparse ut:
- Peka och klicka-gränssnitt: Klicka bara på bilderna du vill ha, så identifierar Octoparse resten automatiskt. Ingen kod, ingen XPath, ingen stress.
- Autodetektering och mallar: Octoparses auto-detect kan skanna en sida och föreslå bilder, listor och mer. Mallar för populära sajter gör att du kan börja på några sekunder.
- Hanterar sidindelning och oändlig scroll: Det visuella arbetsflödet låter dig lägga till “Nästa sida” eller automatisk scroll med ett par klick.
- Molnscraping och schemaläggning: Betalda planer låter dig köra jobb i molnet, schemalägga återkommande scraping och hantera större volymer.
Octoparses visuella arbetsflöde för bildextrahering:
- Massuttag: Hämta tusentals bild-URL:er på några minuter och använd sedan ett Chrome-tillägg för att ladda ner filerna vid behov.
- Exportalternativ: Ladda ner resultat som CSV, Excel eller skicka dem till din databas/API.
- Gratis plan: Begränsade körningar för små jobb; betalda planer börjar runt 119 USD/månad för mer kapacitet.
Vem passar det för?
- Icke-tekniska team, marknadsförare, forskare och småföretag.
- Alla som vill hämta bilder utan att skriva en enda rad kod.
4. ParseHub
ParseHub är en annan visuell scraper, men den är särskilt bra på att hantera komplexa, dynamiska webbplatser – tänk JavaScript-tunga sidor, single-page-appar eller sajter som kräver villkorlig logik.
Därför sticker ParseHub ut:
- Stöd för dynamiskt innehåll: ParseHub kan interagera med innehåll som laddas via AJAX, popup-fönster och flerstegsnav. Om bilder bara visas efter klick eller scroll kan ParseHub hämta dem.
- Visuell scripting med logik: Lägg till villkor, loopar och variabler i ditt arbetsflöde – ingen kod behövs, men det finns gott om kraft för avancerade användare.
- Extrahering av flera datatyper: Hämta bilder, text, länkar och mer i samma projekt.
- Molnkörning och schemaläggning: Kör jobb i molnet, schemalägg återkommande scraping och integrera via API.
ParseHubs avancerade funktioner för bilddata:
- Sidindelning och undersidor: Extrahera enkelt bilder över flera sidor eller gå vidare till detaljsidor för mer information.
- Export: Ladda ner som CSV, Excel eller koppla till BI-verktyg som Tableau.
- Gratisnivå: Upp till 200 sidor per körning; betalda planer börjar runt 189 USD/månad för högre volymer.
Vem passar det för?
- Användare som vill ha ett no-code-verktyg men arbetar med komplexa eller moderna webbplatser.
- Dataanalytiker och forskare som vill ha mer kontroll utan att koda.
5. Sequentum Enterprise
Sequentum Enterprise (tidigare Sequentum Enterprise) är tungviktaren för bildcrawling i företagsklass. Om du hanterar enorma, pågående scraping-projekt med strikta krav på regelefterlevnad är det här verktyget för dig.
Därför sticker Sequentum Enterprise ut:
- Plattform i enterprise-klass: Windows-programvara för lokal drift, byggd för hög volym och affärskritisk scraping.
- Visuell editor + scripting: Bygg arbetsflöden visuellt, men lägg till egna C#/VB.NET-skript för avancerade scenarier.
- Trådad crawling: Ladda ner bilder från tusentals sidor parallellt.
- Robust felhantering och schemaläggning: Inbyggd schemaläggare, felåterhämtning och övervakning för stabil, obevakad drift.
- Integration: Exportera till databaser, API:er, molnlagring eller vilket format som helst som IT-avdelningen behöver.
- Samarbete i team: Versionshantering, användaråtkomst och central administration för stora team.
Sequentum Enterprises arbetsflödesautomatisering för bilder:
- Hantera komplexa sajter: AJAX, JavaScript, popup-fönster, CAPTCHAs och mer.
- Säkerhet och regelefterlevnad: Körs i din egen miljö – ingen data lämnar dina servrar.
- Anpassat pris: Ofta en större investering, men fullt rimlig för företag med löpande behov i stor skala.
Vem passar det för?
- Företag, dataleverantörer och alla som driver stora, återkommande pipelines för bild- och dataextrahering.
- Team som kräver stabilitet, efterlevnad och tät integration.
Snabb jämförelse: de bästa verktygen för bildcrawling i korthet
| Verktyg | Styrkor | Passar bäst för | Pris (ungefär) |
|---|---|---|---|
| Thunderbit | AI-driven, 1-klicksinstallation, undersidor/sidindelning, direkt export | Icke-kodare, snabba resultat, små och medelstora företag | Gratis för 6–10 sidor, sedan betalning per rad (från 15 USD/mån) |
| Scrapy | Python-baserad, flexibel, skalbar, laddar ner bilder direkt | Utvecklare, anpassade projekt, stor skala | Gratis (öppen källkod) |
| Octoparse | No-code, visuellt, autodetektering, mallar, molnscraping | Icke-tekniska team, marknadsföring, research | Gratis plan, betalda från ca 69 USD/mån |
| ParseHub | Visuell, klarar dynamiska sajter, logik/villkor, molnschemaläggning | Komplexa sajter, analytiker, avancerade no-code-användare | Gratis nivå, betalda från ca 189 USD/mån |
| Sequentum Enterprise | Enterprise-klass, visuellt + scripting, multitrådad, lokal drift | Företag, hög volym, regelefterlevnad | Anpassad/enterprise-prissättning |
Att välja bästa bildcrawler för dina affärsbehov
Så hämtar du data från vilken webbplats som helst med AI Get Started Free
Så, vilket verktyg ska du välja? Här är min rekommendation:
- Behöver du resultat snabbt, utan någon uppsättning? Välj Thunderbit. Det är det enklaste sättet att hämta bilder, särskilt om du vill exportera till Sheets, Notion eller Airtable.
- Har du en utvecklare och vill ha full kontroll? Scrapy är svårslaget för anpassade projekt i stor skala.
- Ingen kodvana, men vill ha ett visuellt arbetsflöde? Octoparse passar små till medelstora team, medan ParseHub är bättre för komplexa och dynamiska sajter.
- Driver du verksamhet i företagsklass? Sequentum Enterprise är byggt för dig – tänk stora datamängder, compliance och automation.
Tänk alltid på teamets tekniska nivå, hur komplexa målsajterna är och hur ofta du behöver köra dina scraping-jobb. De flesta av dessa verktyg erbjuder gratis testperioder eller nivåer – så var inte rädd för att testa dig fram och se vad som passar ditt arbetsflöde.
Slutsats: effektiv datainsamling med bästa bildcrawlern
Visuell data kommer bara att bli viktigare. Oavsett om du bevakar konkurrenter, matar dina AI-modeller eller bara försöker hålla produktkatalogerna uppdaterade kan rätt bildcrawler förvandla dagar av manuellt arbete till minuter av automation. Verktyg som Thunderbit gör den här kraften tillgänglig för alla, inte bara utvecklare eller stora företag.
Börja hämta bilder med Thunderbit
Redo att förändra ditt arbetsflöde för bildextrahering? Prova Thunderbit gratis eller utforska något av de andra toppverktygen på listan. Och om du vill fördjupa dig i web scraping, kolla in Thunderbit Blog för fler guider, tips och verkliga användningsfall.
Vanliga frågor
1. Vad är en bildcrawler och varför behöver företag en sådan?
En bildcrawler är ett verktyg som automatiskt extraherar bilder (eller deras URL:er) från webbplatser. Företag använder bildcrawlers för att samla produktbilder, bevaka konkurrenter, träna AI-modeller och effektivisera innehållsarbete – vilket sparar tid och förbättrar datakvaliteten.
2. Hur gör Thunderbit bildextrahering enklare än andra verktyg?
Thunderbit använder AI för att automatiskt identifiera bilder och andra fält, så du kan starta en scraping med bara ett klick – ingen kod eller teknisk installation behövs. AI:n sköter körningen därifrån, och om du bara vill ha vissa bilder säger du bara vilka, så begränsar den sig till dem. Den kan också crawla undersidor, hantera dynamiskt innehåll och exportera data direkt till Excel, Sheets, Notion eller Airtable.
3. Kan jag använda dessa verktyg om jag inte har någon kodvana?
Absolut. Thunderbit, Octoparse och ParseHub är alla byggda för användare utan kodbakgrund och erbjuder visuella gränssnitt och AI-drivna funktioner. Scrapy passar bäst för den som kan Python, medan Sequentum Enterprise riktar sig till IT-team i företag.
4. Vad bör jag tänka på när jag väljer en bildcrawler?
Tänk på din tekniska nivå, hur komplexa målsajterna är (dynamiskt innehåll, inloggningar osv.), hur mycket data du behöver och hur du vill exportera eller integrera resultatet. Titta också på priset – vissa verktyg är gratis, medan andra är byggda för enterprise.
5. Är det lagligt att hämta bilder från vilken webbplats som helst?
Kontrollera alltid webbplatsens användarvillkor och respektera upphovsrättslagar. Hämta bara offentligt tillgänglig data och undvik att samla in personliga eller känsliga uppgifter utan tillstånd. Ansvarsfull och etisk scraping är avgörande för att hålla sig inom reglerna och undvika juridiska problem.
Vill du se Thunderbit i praktiken? Ladda ner Chrome-tillägget och prova att hämta bilder från din favoritwebbplats. Och om du har frågor eller vill ha fler scraping-tips, titta in på Thunderbit Blog för de senaste guiderna och insikterna.
Läs mer Bästa 10 gratisalternativ för webb-crawler online 2025 Topp 10 automatiserade verktyg för web scraping 2025 Topp 12 gratis verktyg för data scraping 2025 Topp 10 AI-webbscraperverktyg för att öka produktiviteten 2025
Testa Thunderbit AI-bildscraper Get Started Free




