Baidu Scraper для поиска и статей













Превратите результаты Baidu в аккуратные и полезные данные
Храните поисковые результаты и доступные сведения из статей в одной понятной таблице.
Очищайте данные Baidu прямо в процессе сбора
Thunderbit раскладывает видимые заголовки, URL, сниппеты, даты и источники по понятным колонкам. Если результат не показывает какое-то поле, ячейка остаётся пустой.

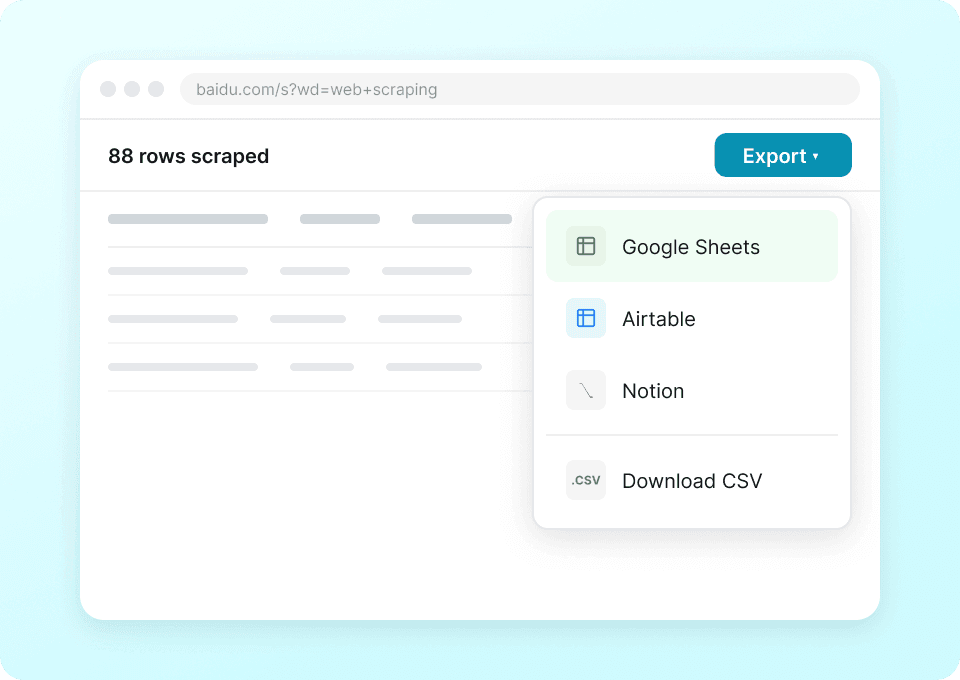
Экспортируйте исследование Baidu в один клик
Отправляйте каждый запуск в таблицу для проверки результатов поиска. Позиции, источники, даты и данные со связанных страниц остаются рядом с соответствующим результатом Baidu.
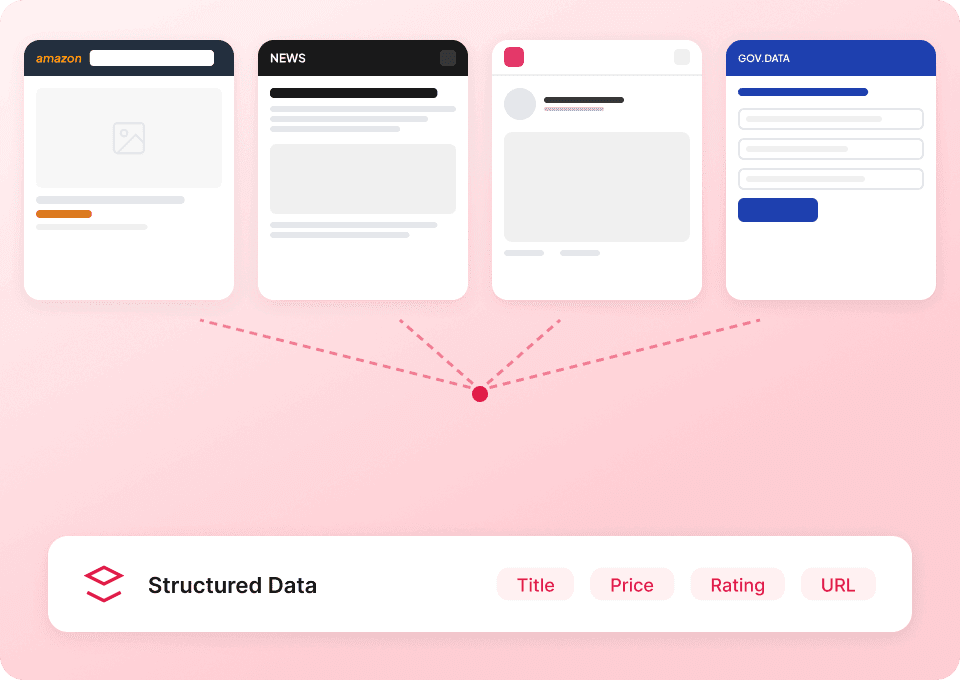
Используйте тот же процесс на любом сайте
Thunderbit читает поля по смыслу, а не под конкретную структуру Baidu. Используйте тот же подход на любом доступном публичном сайте, когда ваше исследование выходит на новый источник.
Сохраняйте контекст у каждого результата Baidu
Список ссылок теряет контекст. Thunderbit сохраняет видимые детали рядом с каждым результатом.
Скопированные ссылки и разрозненные заметки
Детали результата оказываются разделеныСтруктурированное исследование Baidu
Видимый контекст остаётся с каждым результатомКакие данные можно извлечь из Baidu?
Выбирайте из этих публично видимых полей. Модули результатов и связанные страницы показывают не все поля для каждого запроса.
- Поисковый запрос
- Позиция результата
- Заголовок результата
- URL результата
- Отображаемый URL
- Сниппет результата
- Дата результата
- Иконка сайта результата
- Связанный поисковый запрос
- Подсказка по написанию
- Подсказка по пиньиню
- Номер страницы результатов поиска
- Сайт-источник
- Домен источника
- Автор статьи
- Дата публикации статьи
- Аннотация статьи
- Название документа
- Описание документа
- Хлебные крошки документа
- Жанр документа
- Формат файла документа
- Количество страниц документа
- Время загрузки документа
- URL документа
- Тип контента результата
- Миниатюра изображения
- Миниатюра видео
- Адрес местоположения
- Модуль функций Baidu
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Вопросы о сборе поисковых данных Baidu
Доступные поля зависят от запроса, типа результата и информации, показанной на связанных страницах.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Скрапер для Teams
Скрапер Thunderbit для Teams помогает извлекать сообщения чатов и сведения об участниках сообществ в Microsoft Teams. Благодаря подсказкам полей на базе ИИ вы быстро соберёте текст сообщений, данные отправителей, временные метки и профили участников для аналитики или отчётности. Отлично подходит руководителям проектов, HR-специалистам и исследователям, которым нужны структурированные данные из Teams.
Подробнее ->
Framer Scraper
Framer Scraper от Thunderbit помогает с помощью ИИ извлекать списки шаблонов и примеры из Framer Showcase. Собирайте данные по категориям (например, шаблоны Portfolio), а затем переходите на страницу каждого шаблона или кейса, чтобы дополнить таблицу деталями: названием, тегами, ссылками на превью и метаданными. Экспортируйте результат в Excel, Google Sheets, Airtable или Notion всего в пару кликов.
Подробнее ->
Скрапер WordPress.org
Скрапер WordPress.org от Thunderbit помогает с помощью ИИ извлекать структурированные данные из каталога плагинов WordPress и библиотеки паттернов блоков. Собирайте данные со страниц списков и дополняйте их деталями с подстраниц — статистикой плагинов, версиями, рейтингами и метаданными паттернов — а затем выгружайте в Excel, Google Sheets, Airtable или Notion.
Подробнее ->
Capterra 爬虫
Извлекайте названия программ, рейтинги и модели ценообразования с Capterra за 2 клика — затем сразу экспортируйте в Excel, Google Sheets или Notion. Без программирования.
Подробнее ->
Парсер CoinMarketCap
Извлекайте криптоданные — цену, рыночную капитализацию и 24-часовой объём — с CoinMarketCap всего за 2 клика. Откройте любую страницу, позвольте AI автоматически определить поля и экспортируйте данные напрямую в Excel, Google Sheets или Notion.
Подробнее ->
GoDaddy Scraper
Укажите на любой домен GoDaddy, статус доступности или цену — AI Thunderbit извлечёт данные за 2 клика и сразу экспортирует их в Excel, Google Sheets или Notion.
Подробнее ->Готов вывести извлечение данных на новый уровень?
Присоединяйся к более чем 200 000 профессионалов, которые уже используют Thunderbit для автоматизации веб-скрапинга.
Бесплатный пробный период дает безлимитные кредиты для 8 веб-страниц.



