
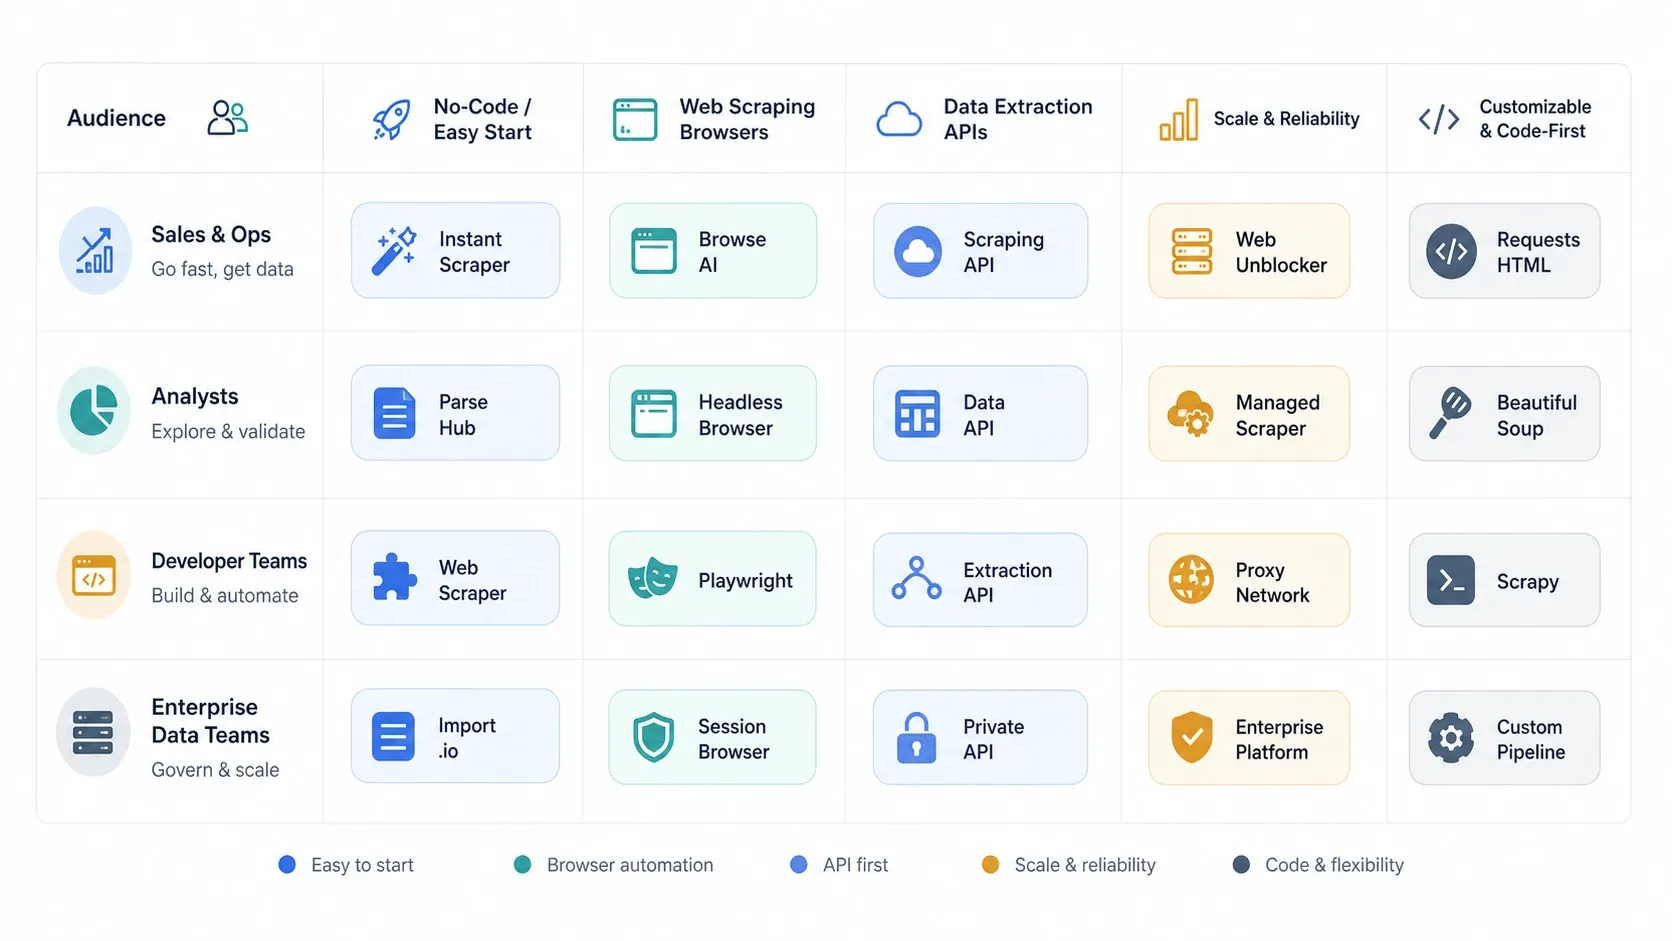
Если тебе нужны веб-данные в 2026 году, главный вопрос уже не в том, «можно ли это спарсить?», а в том, «какой уровень инструмента даст мне пригодные данные с минимальными затратами на настройку, поддержку и инфраструктуру?» Поэтому эта страница построена по принципу соответствия задачам: AI web scraper для скорости, no-code решения для повторяемых браузерных задач, API для масштаба и защиты от ботов, а Python-библиотеки — для команд, которым нужен полный контроль.
Краткий ответ
- Выбирай AI web scraper, если хочешь максимально быстро получить данные с страницы в таблицу при минимальной настройке.
- Выбирай no-code scraper, если тебе нужны явная пагинация, планирование запуска, работа с логином или повторяемый контроль процессов.
- Выбирай scraping API, если важнее всего рендеринг, защита от ботов, параллельные запросы и высокий процент успешных обходов блокировок.
- Выбирай Python-библиотеку, если твоей команде нужен полный контроль над запросами, парсингом, браузерной автоматизацией, повторными попытками и деплоем.
Для большинства бизнес-команд ошибка в том, что они слишком рано спускаются ниже по стеку. Начинай с самого лёгкого инструмента, который стабильно справляется с задачей, и переходи от AI к no-code, затем к API и к коду только тогда, когда этого требует твой процесс.
Быстрая сравнительная таблица: инструменты для парсинга сайтов с первого взгляда
Ниже приведены ценовые ориентиры, проверенные по официальным страницам продукта, тарифов или документации в августе 2026 года. Если у вендора используется индивидуальное или помесячное тарифицирование по объёму, я описываю модель оплаты вместо того, чтобы притягивать несуществующую «среднюю» ежемесячную цену.
| Инструмент | Категория | Лучше всего подходит для | Почему он попал в этот список 2026 года | Ценовой ориентир (проверено в мае 2026) |
|---|---|---|---|---|
| Thunderbit | AI web scraper | Продажи, операционные задачи, e-commerce, недвижимость | Самый быстрый путь от веб-страницы к структурированной таблице без технических навыков | Бесплатный план, платные тарифы, бизнес-цены |
| Bright Data Web Scraper | Enterprise scraping platform | Проекты с жёсткими требованиями к закупкам и комплаенсу | Самый широкий стек для сбора данных в этой подборке | Оплата по продукту и по использованию |
| Kadoa | AI extraction platform | Data-команды и крупные регулярные процессы | Хорошо подходит для самовосстанавливающихся, агентных сценариев извлечения | Бесплатная оценка, планы по использованию и enterprise |
| Octoparse | No-code scraper | Аналитики и повторяющиеся операционные задачи | Зрелый облачный парсинг и визуальный конструктор задач | Бесплатный план, Standard от $69/мес., более высокие тарифы |
| ParseHub | Low-code scraper | Технические пользователи без кода и исследователи | Гибкая логика навигации для сложных сайтов | Бесплатный план, платные тарифы от $189/мес. |
| Web Scraper | Browser no-code scraper | Новички и лёгкие повторяемые задачи | Понятная sitemap-модель с опциональным облачным слоем | Бесплатное расширение, Cloud от $50/мес. |
| Browse AI | No-code robot scraper | Мониторинг и команды, работающие через таблицы | Отлично подходит для регулярного отслеживания и алертов об изменениях | Бесплатный план, платные тарифы, управляемый уровень |
| Bardeen | AI browser automation | Автоматизация GTM и revops | Лучший вариант, когда парсинг — лишь один шаг в более крупном процессе | Бесплатный план, Basic от $10/мес., Premium и Enterprise |
| ScrapeStorm | AI-assisted visual scraper | Тем, кому нужна быстрая визуальная настройка | Полезный мост между ручными селекторами и AI-подсказками | Бесплатная пробная версия, платные планы, enterprise-цены |
| ScraperAPI | Scraping API | Разработчики, масштабирующие объём запросов | Простой API плюс прокси, CAPTCHA и рендеринг как услуга | 7-дневный trial, платно от $49/мес. |
| Zyte | API + anti-bot stack | Разработчики и data-команды | Сильные браузерные действия, JS-рендеринг и ротация IP | Кредит $5 на trial, тарифы по использованию |
| ZenRows | Scraping API | Стартапы и команды разработчиков | Чистый anti-bot API с менее сложным стартом | Бесплатный trial, Developer от $69/мес. |
| ScrapingBee | Scraping API | Команды, парсящие сайты с тяжёлым JS | Полезен, когда основная проблема — рендеринг | Бесплатный trial, платно от $49/мес. |
| Selenium | Open-source browser automation | QA-сценарии и парсинг с большим количеством взаимодействий | По-прежнему актуален там, где критична точность пользовательских действий | Бесплатно и open-source |
| Beautiful Soup | Python parsing library | Лёгкий Python-парсинг | Самый простой парсер в стекe для «грязного» HTML | Бесплатно и open-source |
| Playwright | Modern browser automation | Современные веб-приложения и команды разработчиков | Лучший современный выбор для скриптовой браузерной автоматизации | Бесплатно и open-source |
| urllib3 | Python HTTP library | Разработчики, которым нужен низкоуровневый контроль запросов | Удобная основа, если вы хотите самостоятельно управлять транспортным слоем | Бесплатно и open-source |
Как выбрать подходящий инструмент для парсинга сайта
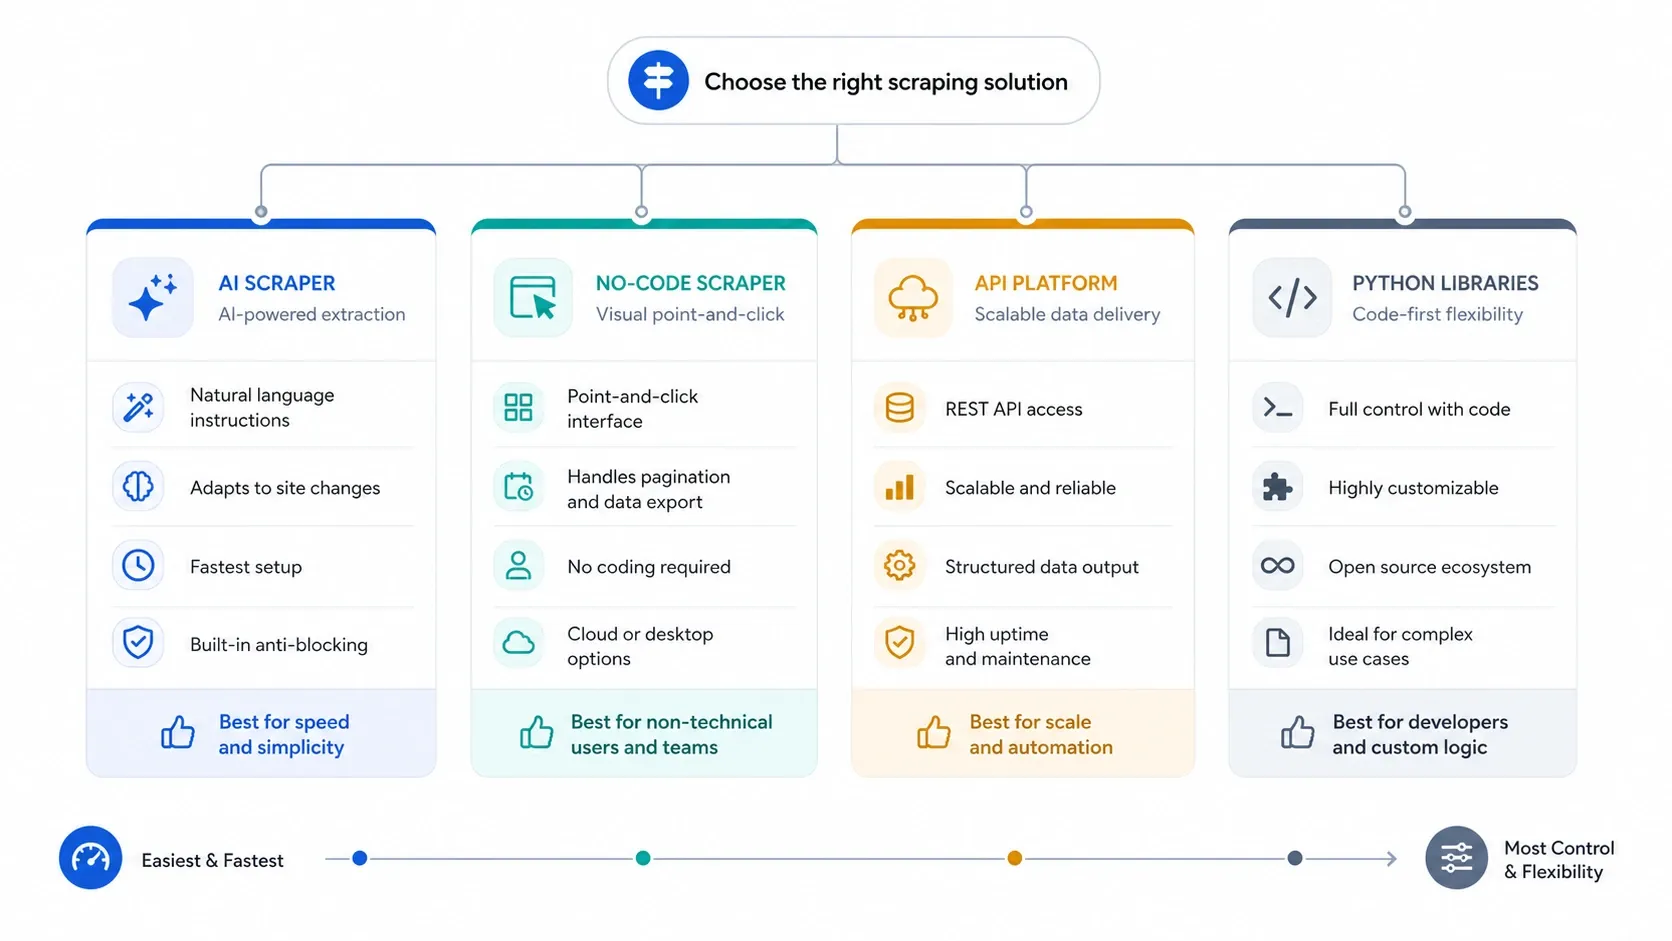
Перед сравнением брендов используй четыре фильтра:
- Скорость получения первого полезного результата
Если инструмент не может быстро выдать реальную таблицу, для большинства бизнес-сценариев он уже проиграл. - Нагрузка на поддержку
Дешёвый парсер, который ломается при каждом изменении макета, на самом деле совсем не дешёвый. - Потолок масштабирования
Расширение браузера может идеально подходить для 50 страниц в неделю и совершенно не подходить для 5 миллионов запросов в месяц. - Соответствие рабочему процессу
Лучший парсер для revops редко бывает лучшим вариантом для platform engineer.
Обычно логика выбора проще, чем её представляют команды:
- Если тебе нужно собирать лиды, карточки или страницы товаров без возни с селекторами, начинай с AI.
- Если нужны повторяемые задачи, запуск в облаке и более явный контроль, переходи к визуальным no-code конструкторам.
- Если реальная проблема — это anti-bot, рендеринг JavaScript и параллельная обработка, переходи к API.
- Если хочешь контролировать каждый уровень сам, используй Python-библиотеки и принимай нагрузку по поддержке.
Лучшие AI web scraper для быстрых бизнес-процессов
Это первая категория, которую я бы тестировал, если тебе нужны данные в формате, готовом для таблиц, и при этом хочется минимальной настройки.
1. Thunderbit
Thunderbit по-прежнему остаётся самым простым стартом для тех, кто не пишет код. Главное преимущество — не просто абстрактный «AI», а то, что продукт сокращает цикл настройки. Ты открываешь страницу, просишь AI предложить поля, при необходимости дополняешь данные со вложенных страниц и сразу отправляешь результат в инструменты, которыми уже пользуется твоя команда.
- Лучше всего подходит для: поиска лидов, мониторинга e-commerce, сбора данных по недвижимости и операционных команд, работающих прямо в браузере.
- Чем выделяется: самый быстрый путь от «грязной» страницы к структурированной таблице.
- На что обратить внимание: если тебе нужна логика уровня crawler или сильно кастомизированные инженерные сценарии, со временем придётся перейти к API или коду.
- Ценовой ориентир: бесплатный план, платные self-serve тарифы и бизнес-цены.
Этот обзор по-прежнему остаётся самым быстрым способом понять, достаточно ли AI-first парсинга для твоего процесса:
Попробовать Thunderbit AI Web Scraper бесплатно Собирай данные с любого сайта в 1 клик — без селекторов, без настройки, сразу выгрузка в Sheets или Excel. Get Started Free
2. Bright Data Web Scraper
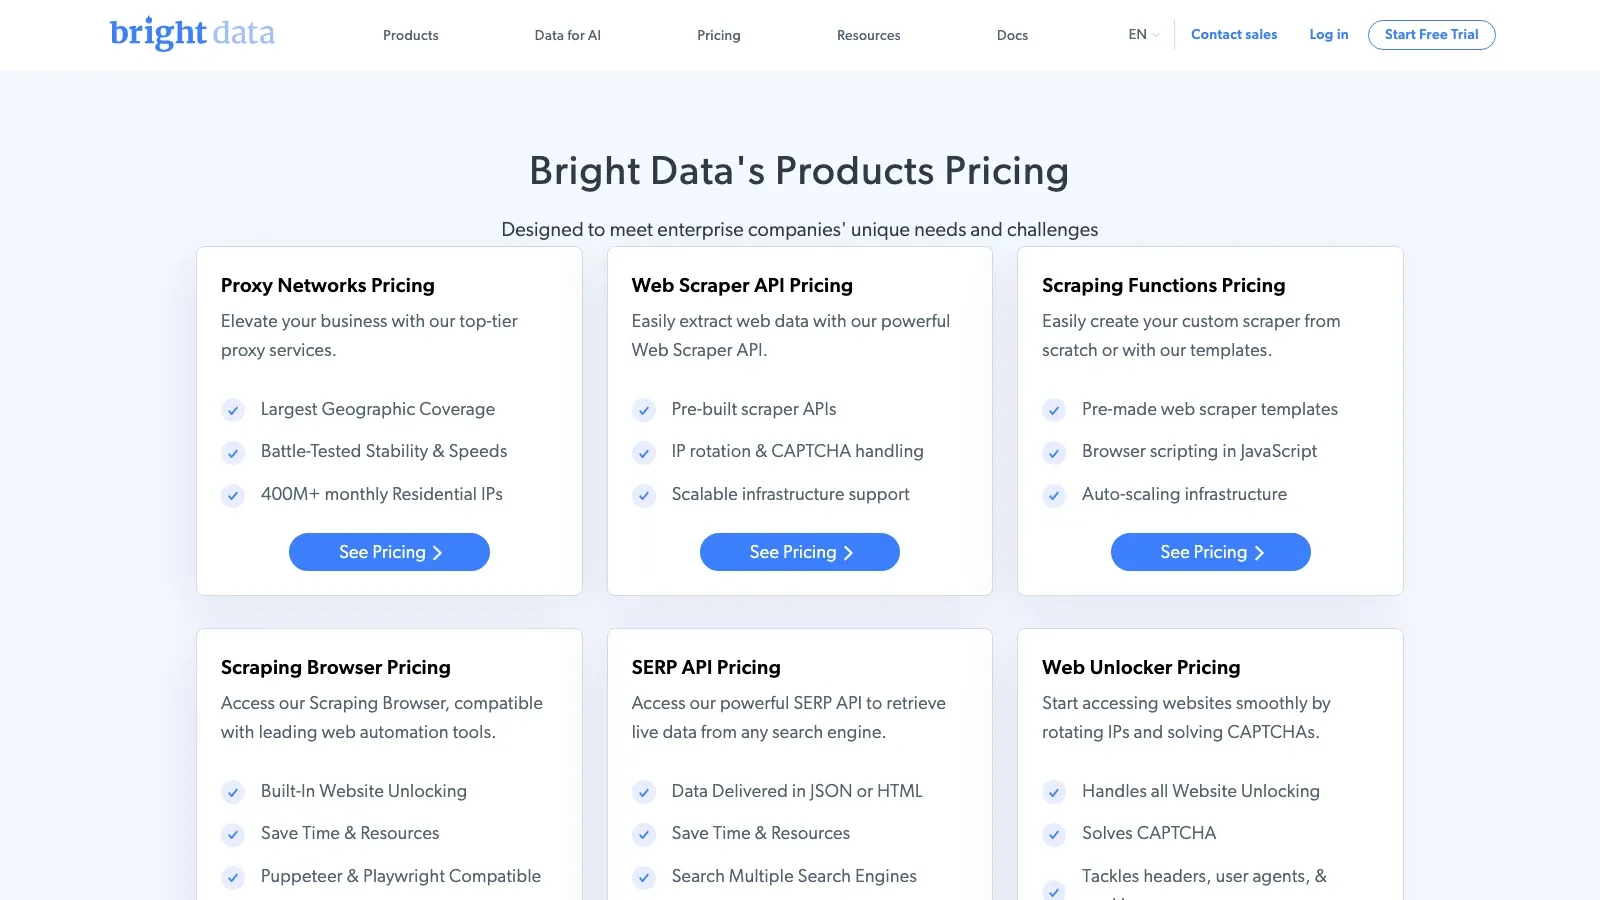
Bright Data — это тяжёлая артиллерия, когда важнее всего обход блокировок, парк прокси, комплаенс и managed-опции, а не простота интерфейса.
- Лучше всего подходит для: сбора данных на enterprise-уровне и проектов с высокими требованиями к соответствию.
- Чем выделяется: самый широкий стек в этом сравнении — от прокси до управляемых продуктов сбора данных.
- На что обратить внимание: легко переплатить, если у твоей команды пока довольно простой процесс.
- Ценовой ориентир: оплата по продукту и по использованию.
3. Kadoa
Kadoa — более инфраструктурный AI-вариант в этой группе. Он особенно уместен, когда тебе нужны самовосстанавливающееся извлечение данных и регулярные задачи в масштабе, к которому обычные браузерные расширения не готовы.
- Лучше всего подходит для: data-команд, внутренних аналитических программ и крупных повторяющихся объёмов извлечения.
- Чем выделяется: агентная orchestration-логика и сильный акцент на снижении затрат на поддержку.
- На что обратить внимание: он тяжелее, чем нужно большинству бизнес-пользователей для быстрых разовых задач.
- Ценовой ориентир: бесплатная оценка, тарифы по использованию и enterprise-планы.
Лучшие no-code инструменты для повторяемых задач парсинга сайтов
Когда задача становится регулярной, визуальные workflow-конструкторы и облачное выполнение начинают играть большую роль, чем скорость одного клика.
4. Octoparse
Octoparse по-прежнему остаётся одним из самых убедительных no-code инструментов, когда задача уже больше, чем браузерное расширение, но ещё не требует собственного инженерного проекта. Его ценность — в сочетании облачных запусков, шаблонов и зрелого визуального конструктора задач.
- Лучше всего подходит для: аналитиков, команд по ценообразованию и регулярных сборов данных, важных для операций.
- Чем выделяется: больше возможностей, чем у браузерных плагинов, без необходимости писать код.
- На что обратить внимание: за такую гибкость приходится платить более высокой кривой обучения, чем у AI-first инструментов.
- Ценовой ориентир: бесплатный план, Standard от $69/мес., более дорогие тарифы.
Если хочешь сначала оценить более традиционное no-code рабочее пространство, прежде чем переходить на AI-first инструменты, этот официальный обзор Octoparse всё ещё полезен:
5. ParseHub
ParseHub по-прежнему актуален, потому что многим командам нужна более пошаговая логика задач, чем может дать лёгкий AI-парсер. Это не самый «красивый» продукт в категории, но он остаётся гибким.
- Лучше всего подходит для: исследователей, журналистов и технических пользователей без кода, готовых к более долгой настройке.
- Чем выделяется: более сильная условная логика и контроль навигации, чем у многих инструментов для новичков.
- На что обратить внимание: учиться ему дольше, а выглядит он менее современно, чем новые продукты.
- Ценовой ориентир: бесплатный план, платные тарифы от $189/мес.
6. Web Scraper
Web Scraper — один из самых понятных вариантов для тех, кто хочет «выучить основы без покупки платформы». Если тебе нравится модель sitemap, это по-прежнему хороший старт.
- Лучше всего подходит для: новичков, хобби-проектов и небольших задач, основанных на браузере.
- Чем выделяется: простая настройка и лёгкий переход от локального расширения к облачным тарифам.
- На что обратить внимание: становится ограниченным, когда нужна более адаптивная логика или более сильная защита от блокировок.
- Ценовой ориентир: бесплатное расширение, Cloud от $50/мес.
7. Browse AI
Browse AI остаётся сильным выбором там, где одинаково важны и сбор данных, и мониторинг. Его модель «роботов» интуитивно понятна бизнес-пользователям, которые мыслят в духе: «следи за этой страницей и скажи, что изменилось».
- Лучше всего подходит для: мониторинга конкурентов, отслеживания цен и команд, работающих через таблицы.
- Чем выделяется: продуманный onboarding, регулярный мониторинг и удобные для автоматизации результаты.
- На что обратить внимание: сложные высоконагруженные задачи могут обходиться дороже, чем в API-first стеках.
- Ценовой ориентир: бесплатный план, платные тарифы, managed-уровень.
Если тебе важнее не разовое извлечение, а мониторинг страниц, этот короткий официальный обзор тоже даёт полезный сигнал:
8. Bardeen
Bardeen — это не столько про глубину парсинга, сколько про то, что происходит после него. Он особенно силён, когда веб-извлечение — лишь один шаг в более широкой браузерной автоматизации.
- Лучше всего подходит для: GTM-операций, маршрутизации лидов, передачи данных в CRM и автоматизации в браузере.
- Чем выделяется: сильная история workflow-автоматизации вокруг самого парсинга.
- На что обратить внимание: не лучший выбор, если важна только точность извлечения.
- Ценовой ориентир: бесплатный план, Basic от $10/мес., тарифы Premium и Enterprise.
9. ScrapeStorm
ScrapeStorm по-прежнему занимает полезную середину для пользователей, которым нужна AI-поддержка, но при этом они ожидают более традиционную визуальную среду для парсинга.
- Лучше всего подходит для: парсинга каталогов, сбора e-commerce-страниц и повторяемых задач с визуальной настройкой.
- Чем выделяется: стартовать с ним проще, чем со многими старыми визуальными инструментами.
- На что обратить внимание: он менее отполирован, чем лидеры категории, и на сложных сайтах может ощущаться более узко.
- Ценовой ориентир: бесплатная пробная версия, платные планы, enterprise-цены.
Лучшие scraping API, когда важны масштаб и обработка антибот-защиты
Это категория, в которую стоит переходить тогда, когда реальное ограничение уже не в том, «как выбрать данные?», а в том, «как сделать процесс надёжным под нагрузкой?»
10. ScraperAPI
ScraperAPI по-прежнему остаётся одним из самых доступных API-first продуктов для разработчиков, которые хотят перестать думать о прокси и процентах успешных запросов.
- Лучше всего подходит для: разработчиков, которым нужно быстро масштабироваться от прототипа к продакшену.
- Чем выделяется: простой API плюс поддержка прокси, CAPTCHA и рендеринга.
- На что обратить внимание: парсинг, повторные попытки и качество данных на выходе всё равно остаются вашей зоной ответственности.
- Ценовой ориентир: trial на 7 дней, платно от $49/мес.
11. Zyte
Zyte по-прежнему остаётся серьёзным вариантом для команд разработчиков, которым нужны браузерные действия, JS-рендеринг, ротация IP и антибот-защита в рамках одной платформы.
- Лучше всего подходит для: инженерно-ориентированных программ парсинга и повторяемых систем извлечения.
- Чем выделяется: сильный антидетект-стек и API-first workflow.
- На что обратить внимание: лучше подходит командам с инженерной ответственностью, чем бизнес-пользователям.
- Ценовой ориентир: кредит $5 на trial, тарифы по использованию.
12. ZenRows
ZenRows — один из наиболее удобных developer experience в категории API, если тебе нужна антибот-защита без сложного enterprise-процесса закупки.
- Лучше всего подходит для: стартапов, разработчиков и компактных внутренних команд.
- Чем выделяется: относительно низкий порог входа и сильный акцент на антибот-возможностях.
- На что обратить внимание: это всё же API-продукт, поэтому логика приложения и QA остаются за вами.
- Ценовой ориентир: бесплатный trial, Developer от $69/мес.
13. ScrapingBee
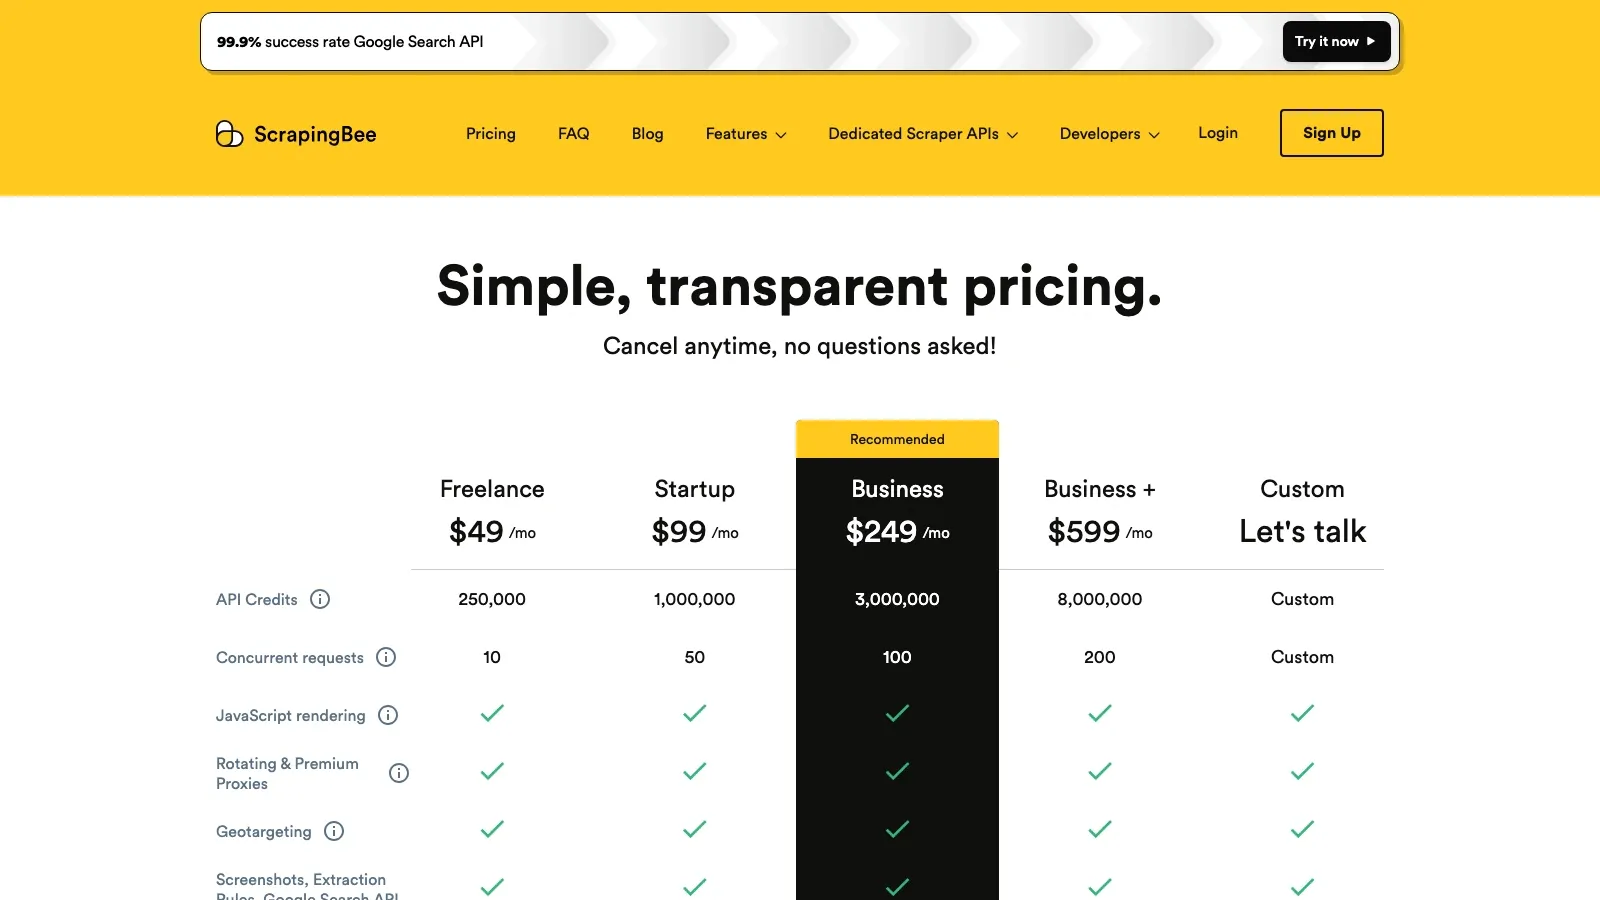
ScrapingBee особенно хорош там, где тебе нужна отрендеренная страница и меньше инфраструктурной работы, особенно для сайтов с тяжёлым JavaScript.
- Лучше всего подходит для: разработчиков, парсящих динамические сайты и желающих снять с себя нагрузку рендеринга.
- Чем выделяется: простой API вокруг headless-браузинга и прокси.
- На что обратить внимание: он убирает инфраструктурную сложность, но не необходимость в качественной логике парсинга.
- Ценовой ориентир: бесплатный trial, платно от $49/мес.
Лучшие Python-библиотеки для кастомных стеков парсинга
Этот набор по-прежнему остаётся правильным выбором, когда контроль важнее удобства, а твоя команда готова взять на себя поддержку.
14. Selenium
Selenium — не самый новый инструмент для браузера, но он по-прежнему актуален там, где точность пользовательского взаимодействия важнее общей скорости парсинга.
- Лучше всего подходит для: сценариев с большим количеством взаимодействий, пересечения с QA и сайтов, где ключевая сложность — поведение браузера.
- Чем выделяется: зрелая экосистема и широкая поддержка браузеров.
- На что обратить внимание: для многих задач парсинга он тяжелее и медленнее, чем новые стеки автоматизации.
- Ценовой ориентир: бесплатно и open-source.
15. Beautiful Soup
Beautiful Soup по-прежнему остаётся самым простым парсером в Python-стеке для веб-скрейпинга. Это не полноценная платформа для парсинга, но всё ещё самый простой способ превратить запутанный HTML в пригодную структуру.
- Лучше всего подходит для: лёгких Python-задач, статичных HTML-страниц и быстрых прототипов.
- Чем выделяется: низкая когнитивная нагрузка и «щадящий» парсинг.
- На что обратить внимание: используй вместе с
requests, браузерным слоем или crawler; сам по себе он только парсит. - Ценовой ориентир: бесплатно и open-source.
16. Playwright
Playwright — мой основной современный выбор для команд разработчиков, которым нужна надёжная браузерная автоматизация в современном интернете.
- Лучше всего подходит для: сайтов с тяжёлым JavaScript, современной браузерной автоматизации и команд, которым комфортно писать код.
- Чем выделяется: хорошее ожидание загрузки, поддержка нескольких браузеров и аккуратные API.
- На что обратить внимание: параллельная обработка, селекторы, браузерная инфраструктура и проверка данных всё ещё остаются вашей задачей.
- Ценовой ориентир: бесплатно и open-source.
17. urllib3
urllib3 заслуженно входит в список, потому что некоторым командам нужен прямой контроль над поведением транспортного слоя, а не более высокий уровень абстракции. Это не самый дружелюбный для новичков инструмент парсинга, но очень полезная базовая библиотека, если вы строите собственный стек.
- Лучше всего подходит для: разработчиков, которым нужен точный контроль над повторными попытками, прокси, сессиями и HTTP-поведением.
- Чем выделяется: лёгкий, надёжный и широко используемый как инфраструктурный компонент.
- На что обратить внимание: большую часть стека вы строите сами.
- Ценовой ориентир: бесплатно и open-source.
Бесплатные инструменты для парсинга сайтов, которые стоит протестировать в первую очередь
Если ты хочешь сначала протестировать, а уже потом покупать, лучшие бесплатные стартовые варианты из этого списка — Thunderbit, Octoparse, ParseHub, Web Scraper, Browse AI, Bardeen, Selenium, Beautiful Soup, Playwright и urllib3. Бесплатного опыта достаточно, чтобы понять, какой именно парсер тебе действительно нужен, а это обычно важнее, чем в первый день зацикливаться на идеальном чек-листе функций.
Мой шорт-лист по типам команд
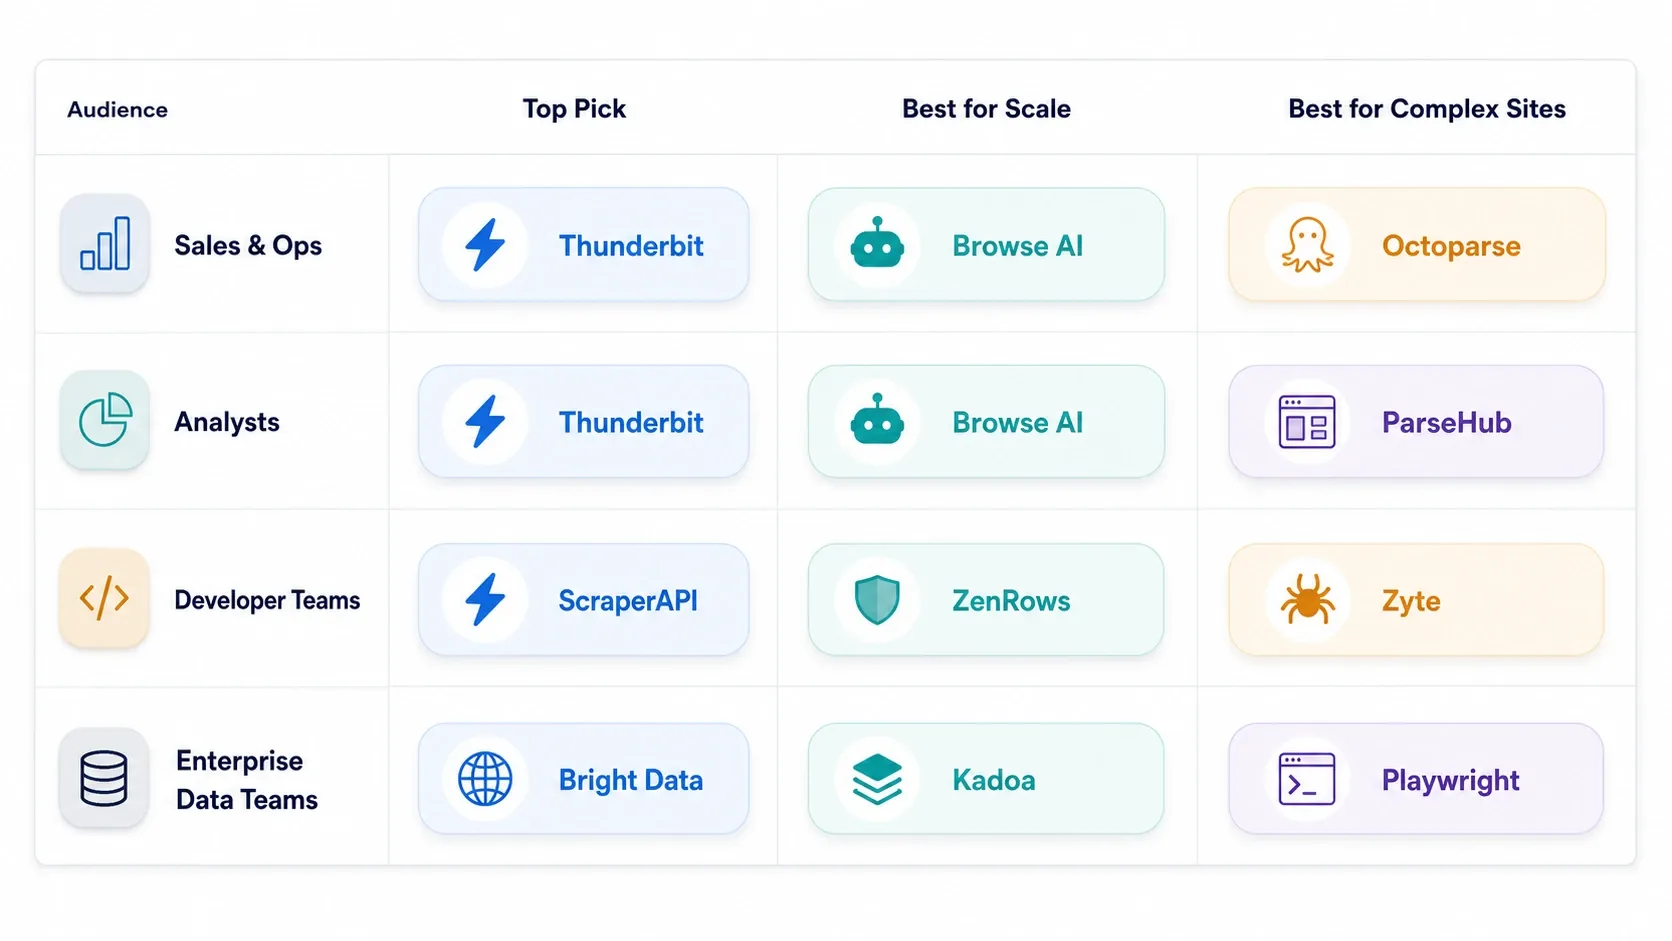
- Команды продаж, операций и e-commerce: начни с Thunderbit, а затем сравни с Browse AI, если мониторинг важнее, чем обогащение со вложенных страниц.
- Аналитики и специалисты по регулярным ручным процессам: сначала Octoparse, затем ParseHub, если нужна более гибкая логика задач.
- Команды GTM-автоматизации: Bardeen, если парсинг должен сразу уходить в CRM, Sheets или браузерные workflow.
- Команды разработчиков, создающие внутренние инструменты: ScraperAPI, ZenRows, Zyte или Playwright — в зависимости от того, сколько ответственности за стек вы готовы взять на себя.
- Enterprise data-программы: Bright Data и Zyte — наиболее серьёзные варианты по инфраструктуре, а Kadoa — AI-альтернатива, когда главная цель — снизить затраты на поддержку.
Когда стоит спускаться ниже по стеку
Используй такой путь перехода:
- Оставайся на AI web scraper, пока не упрёшься в ограничения повторяемости или edge-case.
- Переходи на no-code builders, когда планирование, пагинация и облачное выполнение важнее, чем простота в один клик.
- Переходи к API, когда bottleneck становится процент успешных обходов, рендеринг и параллельность.
- Переходи к Python-библиотекам, когда стоимость абстракции вендора выше, чем владение всей системой самостоятельно.
Большинство команд делает это в неправильном порядке. Сначала они строят слишком сложное решение, а уже потом понимают, что более лёгкий инструмент мог бы закрыть реальную задачу.
Итог
Лучший инструмент для парсинга сайтов в 2026 году — не тот, у которого самый длинный список функций. Это тот, который быстрее и с меньшими затратами на поддержку доставляет точные данные в следующий этап твоего процесса. Именно поэтому AI-first инструменты продолжают выигрывать у практиков, no-code решения остаются ценными для повторяемых браузерных задач, API доминируют там, где важны масштаб и блокировки, а Python-библиотеки по-прежнему занимают самый контролируемый слой стека.
Если твоя цель — получить полезные данные уже на этой неделе, начни с простого. Если твоя рабочая нагрузка уже показывает, что главные проблемы — это обход блокировок, браузерный рендеринг и инженерный контроль, тогда осознанно двигайся ниже по стеку, а не по привычке.
Начни с самого лёгкого парсера, который действительно справится с задачей Get Started Free
FAQ
1. Какой инструмент для парсинга сайтов лучше всего подходит нетехническим пользователям в 2026 году?
Для большинства нетехнических команд AI-first инструменты вроде Thunderbit и Browse AI по-прежнему дают самый быстрый результат, потому что сокращают время на настройку, работу с селекторами и поддержку.
2. Что выбрать для сайтов с тяжёлым JavaScript или защитой от ботов?
Обычно именно здесь ScraperAPI, Bright Data, Zyte, ZenRows, ScrapingBee, Playwright или Selenium начинают выглядеть логичнее, чем браузерные расширения.
3. Остаются ли no-code инструменты для парсинга актуальными, если AI-скрейперы уже лучше?
Да. Octoparse, ParseHub, Web Scraper и Browse AI всё ещё важны, когда тебе нужен более явный контроль задач, регулярные запуски или отладка прямо в браузере.
4. Какие инструменты лучше всего подходят командам разработчиков?
ScraperAPI, Zyte, ZenRows, ScrapingBee, Playwright, Selenium, Beautiful Soup и urllib3 — самые естественные варианты, когда рабочий процесс находится под ответственностью инженеров.
Похожие материалы




