
Введите в Google "Thunderbit vs Oxylabs" — и, скорее всего, ты ожидаешь увидеть аккуратную сравнительную таблицу, как в битве Coke и Pepsi. Но всё не так просто. Один из этих инструментов — браузерное решение, которое за секунды кликает по странице вместо тебя. Другой — прокси-сеть с таким IP-охватом, которому позавидовали бы многие телеком-операторы. И всё же люди продолжают сравнивать их между собой, потому что оба отвечают на один и тот же базовый вопрос: как получить данные из интернета, не убив на это целую неделю жизни?
Я провёл немалую часть карьеры, переходя между миром "строим инфраструктуру" и миром "просто дайте мне данные" — сначала в Automation Anywhere, потом в Jet.com, а теперь, управляя Thunderbit. Поэтому я понимаю, почему выбор вызывает путаницу. Это чем-то похоже на сравнение мувинговой компании и набора коробок для переезда — и то, и другое помогает переместить вещи из точки А в точку Б, но одно — это услуга, а другое — продукт, с помощью которого ты выстраиваешь свой собственный процесс. Давай разберёмся, что тебе действительно нужно, потому что обещаю: всё не так туманно, как кажется по маркетинговым страницам.
Короткий ответ
Если нужен короткий вывод до погружения в детали: Thunderbit — это агентный no-code веб-скрейпер. Ты открываешь страницу, нажимаешь One Click Extract, и инструмент сам определяет поля и вытаскивает структурированные данные. При этом доступны Web App, Open API, MCP Server и CLI для тех, кому нужна более гибкая работа. Oxylabs — это корпоративная инфраструктура для скрейпинга: прокси-сети, Web Scraper API и Web Unblocker, созданные для инженерных команд, которые строят собственные конвейеры данных в больших масштабах.
Иными словами, ни один из них не "лучше" вообще и всегда. Всё зависит от задачи — ты бизнес-пользователь, которому нужна таблица к пятнице, или дата-инженер, отвечающий за стабильность пайплайна на миллионы запросов в месяц.
Краткий обзор
Вот как я бы сопоставил эти два продукта, прежде чем переходить к отдельным функциям:
| Параметр | Thunderbit | Oxylabs |
|---|---|---|
| Основной пользователь | Продажи, операционные команды, исследования, нетехнические команды, а также разработчики через API/MCP | Дата-инженеры, backend-команды, enterprise |
| Настройка | Установить расширение браузера, открыть страницу | Зарегистрироваться, сгенерировать API-ключи, написать логику запросов |
| Слой извлечения | Агентный — AI читает страницу и определяет поля | Определяемый разработчиком — вы сами парсите и структурируете ответ |
| Антибот / рендеринг | Автоматически на поддерживаемых, разрешённых страницах | Через Web Unblocker или настройку прокси-слоя |
| Результат | Таблица/строки, экспорт в Sheets, Airtable, Notion | Сырой HTML или структурированный JSON для поддерживаемых целей |
| Модель масштабирования | Кредиты, привязанные к задачам | Объём трафика (GB) и число запросов |
| Обслуживание | Низкое — логика извлечения адаптируется к странице | Постоянное — вы сами отвечаете за повторы, ротацию, поддержку парсинга |
| Управление и соответствие | Разрешённые, совместимые страницы; соблюдение правил — на стороне пользователя | То же самое — законность и авторизованное использование лежат на клиенте |
Что такое Thunderbit?
Thunderbit — это то, что я бы назвал агентным веб-скрейпером. Здесь ключевое слово именно "агентный", потому что суть в том, что тебе не нужно вручную писать селекторы или собирать схему данных с нуля. Ты открываешь страницу, к которой у тебя есть разрешённый доступ, нажимаешь One Click Extract, и агент сам распознаёт, читает и анализирует её. Он предлагает поля, которые логично подходят именно для этой страницы, а затем появляется Run Now — но вот что многие упускают: нажимать его не обязательно. Если ничего не делать, извлечение запускается автоматически.
Это заметно отличается от многошаговых сценариев настройки, которые использовали ранние инструменты для скрейпинга и которые старые обзоры всё ещё могут описывать. Мы переработали процесс вокруг одного осознанного действия, потому что, честно говоря, никому не нужен пятишаговый ритуал, чтобы просто забрать таблицу цен со страницы.

Помимо извлечения в один клик, ты можешь уточнять результаты простым языком ("покажи только объявления за последние 30 дней"), обогащать подстраницы там, где структура сайта это позволяет, и экспортировать данные напрямую в Google Sheets, Airtable или Notion. А если ты разработчик и хочешь вообще не открывать браузер, у Thunderbit есть Open API для программного доступа, MCP Server для подключения извлечения к Claude, Cursor или другим AI-host-средам, а также пакет Thunderbit CLI и Skills для терминала или рабочих процессов с кодирующими агентами. Основа одна и та же — просто доступ к ней открыт через разные входы, в зависимости от задачи.
Если хочешь глубже понять саму категорию, я бы посоветовал наши материалы о AI web scraping и веб-скрейпинге без кода — там механика разобрана подробнее, чем здесь.
Что такое Oxylabs?
Oxylabs — это совсем другой зверь, и если быть справедливыми, они и не пытаются быть прямым аналогом Thunderbit в смысле "кликнул и извлёк". На их странице цен перечислено несколько отдельных продуктов: Web Scraper API, Web Unblocker и целая линейка proxy-сетей (residential, mobile, datacenter, ISP).
Web Scraper API — это ближайший вариант к "продукту для скрейпинга": стартует от $49 в месяц, поддерживает рендеринг JavaScript и возвращает уже разобранный или структурированный JSON для поддерживаемых типов целей, таких как поисковые системы, e-commerce и travel-платформы. Web Unblocker — это скорее слой доступа: он автоматически управляет browser fingerprint, cookies, выбором прокси и повторными попытками, и создан именно для обхода жёсткой антибот-защиты на защищённых ресурсах. Но в ответ ты получаешь page response, а не готовую таблицу. Парсер по-прежнему пишешь ты.
Есть ещё и чистые proxy-продукты — по сути, именно то, как они звучат: наборы residential, mobile или datacenter IP, которые ты арендуешь по гигабайтам и которые предполагают, что у тебя уже есть собственная связка browser automation, парсинга и хранения данных. Это инфраструктура в самом прямом смысле — ты покупаешь не готовый результат, а коммуникации и "трубы".
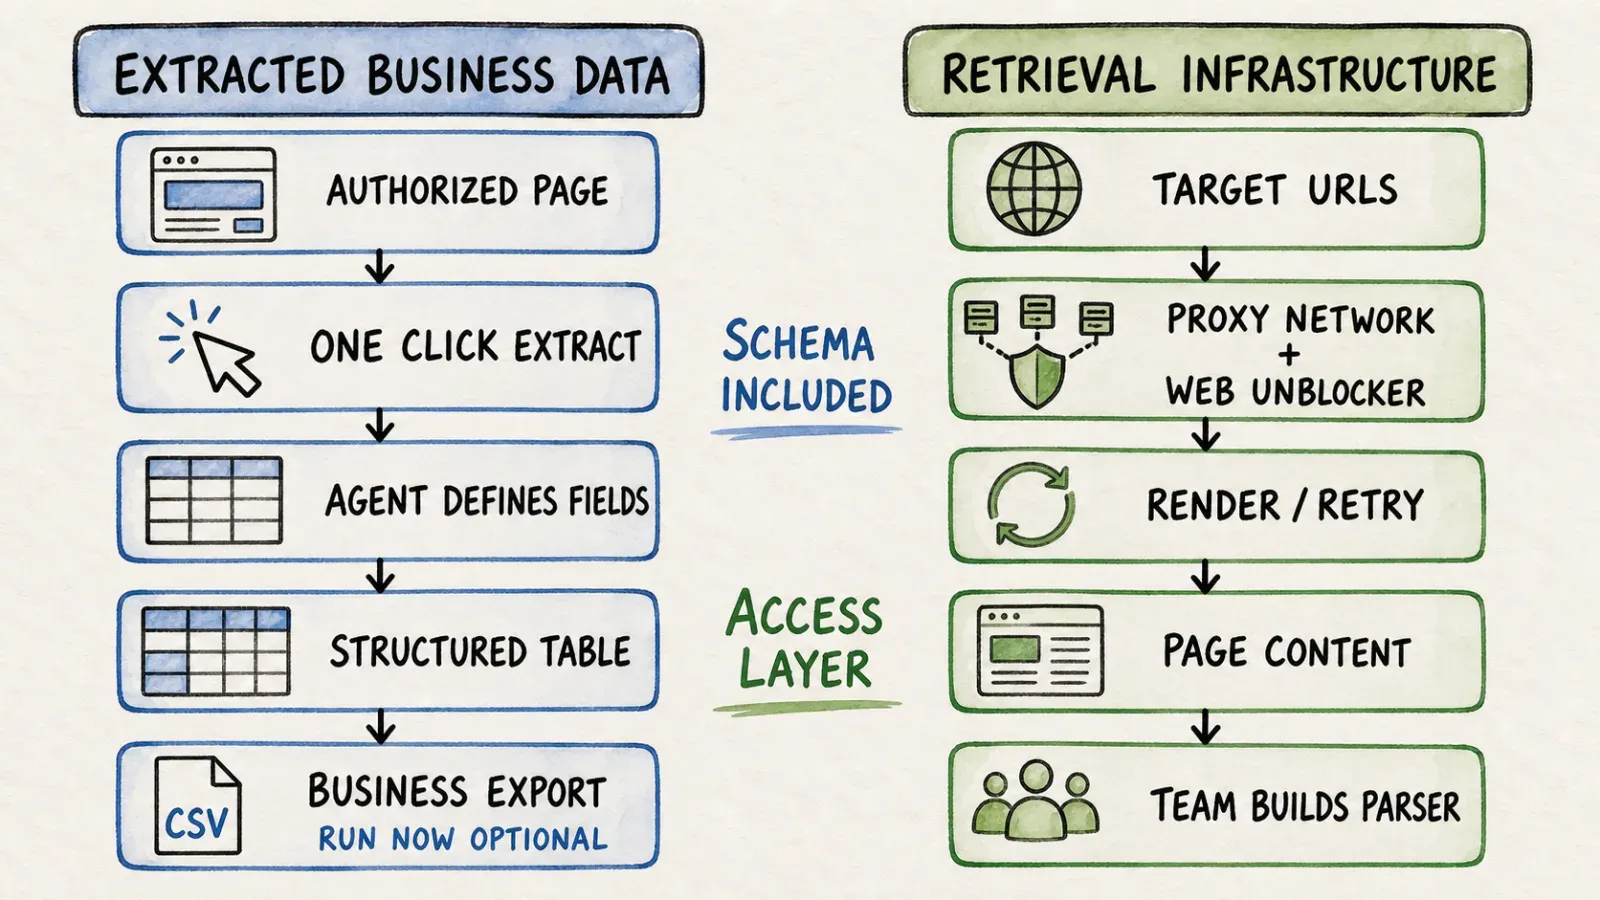
Главное различие: извлечённые бизнес-данные против инфраструктуры получения
Кто задаёт схему и поля?
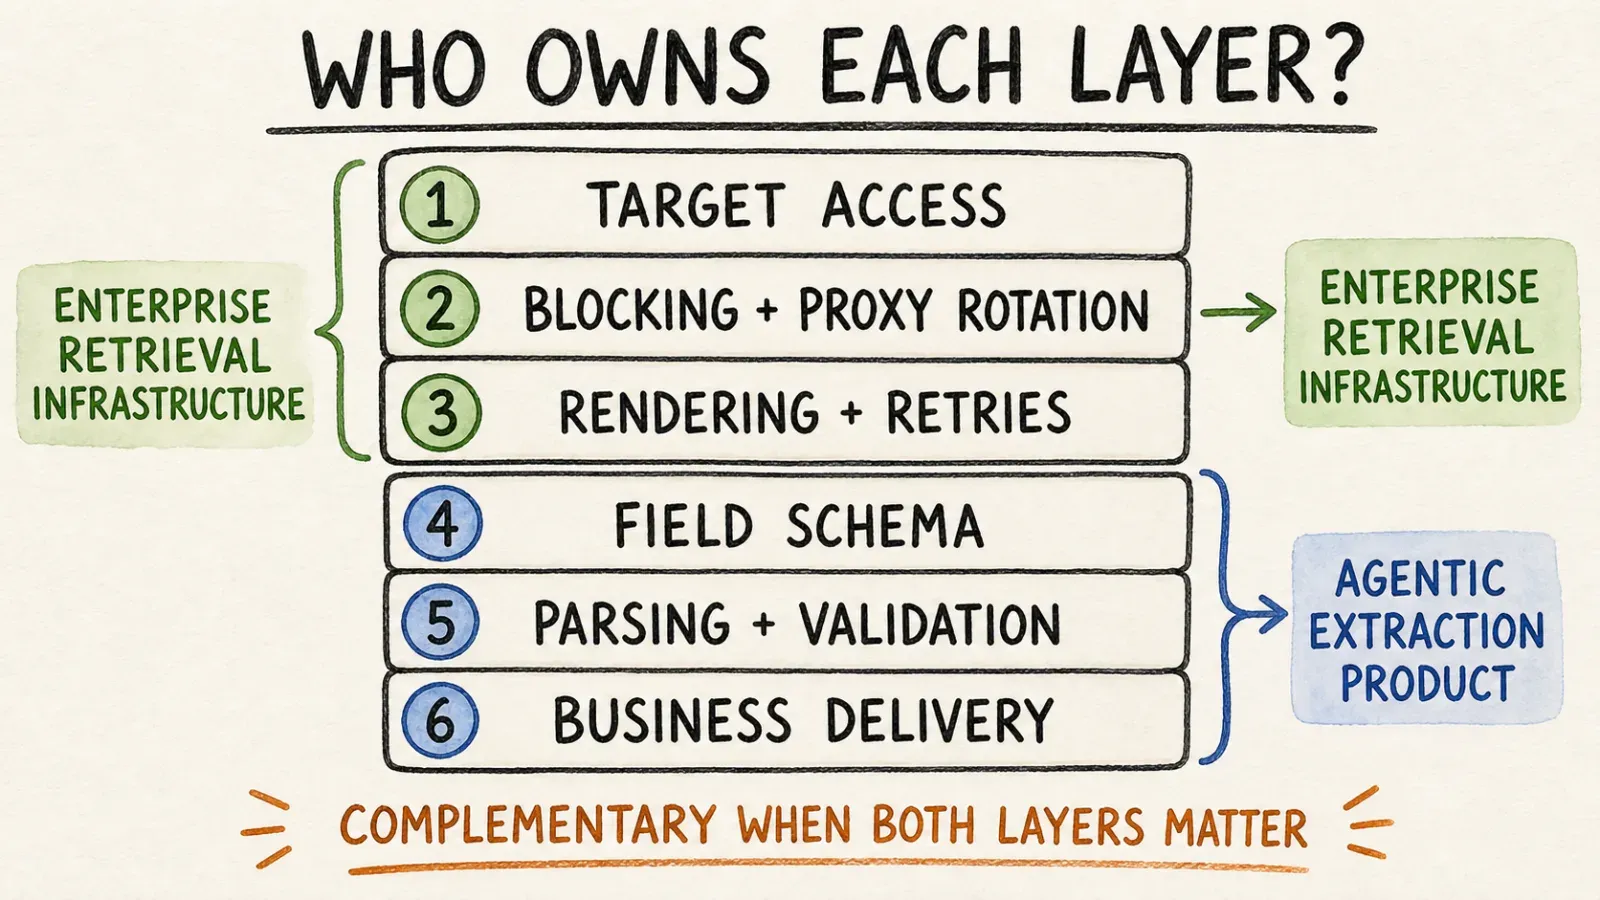
В Thunderbit агент смотрит на страницу и предлагает поля — названия товаров, цены, рейтинги и всё, что реально есть на странице — а ты дальше корректируешь это на естественном языке. В Oxylabs, если только ты не используешь target-specific parser внутри Web Scraper API, схему определяешь ты сам. Это не минус Oxylabs, а просто принципиально другое распределение ролей. Один инструмент предполагает, что ты вообще не хочешь думать о схеме. Другой — что у тебя есть собственное мнение и время команды, чтобы его реализовать.
Кто отвечает за блокировки, рендеринг и ротацию прокси?
Thunderbit автоматически обрабатывает рендеринг и доступ на поддерживаемых, разрешённых страницах в рамках самого процесса извлечения — отдельный proxy-продукт настраивать не нужно. Oxylabs выносит это в отдельный слой: Web Unblocker существует именно потому, что пробираться через сложные антибот-системы настолько трудно, что это заслуживает отдельного продукта, отдельной цены и отдельной документации. Если твои целевые сайты особенно агрессивно блокируют трафик, этот dedicated unblocking layer — действительно сильная сторона Oxylabs. Его создавали люди, которые весь день думают о fingerprinting и управлении сессиями.
Кто отвечает за мониторинг и последующий парсинг?
Вот где особенно заметна разница между "инфраструктурой" и "готовым результатом". В Oxylabs, как только ты получил ответ — будь то сырой HTML из Web Unblocker или структурированный JSON из поддерживаемой цели Web Scraper API — всё дальнейшее лежит на тебе или твоей команде: валидация, хранение, расписание, обработка ошибок, уведомления, если что-то ломается в 2 часа ночи. В Thunderbit этот операционный груз заметно меньше, потому что шаг извлечения и шаг структурирования происходят вместе, а экспорт идёт напрямую в инструменты, которыми команда уже пользуется.
Сравнение рабочих процессов
Числа не врут, так что давай действительно посчитаем шаги, а не просто скажем, что что-то "проще".
Разовая задача: со страницы в таблицу:
| Шаг | Thunderbit | Oxylabs |
|---|---|---|
| 1 | Установить Thunderbit Chrome Extension, открыть целевую страницу | Зарегистрироваться, сгенерировать API-ключи |
| 2 | Нажать One Click Extract | Настроить payload запроса (цель, рендеринг, геолокация) |
| 3 | Агент анализирует страницу и предлагает поля | Отправить запрос, обработать параметры прокси/рендеринга |
| 4 | Появляется Run Now — необязательно, извлечение запускается автоматически | Распарсить ответ, выстроить логику повторов и ротации |
| 5 | Экспортировать в Sheets/Airtable/Notion | Самостоятельно сохранить, проверить и структурировать результат |
Для бизнес-пользователя, которому нужна просто таблица цен конкурентов или список лидов, это примерно работа в один клик с Thunderbit против небольшой задачи для разработчика с Oxylabs. Это не критика Oxylabs — он и не создавался, чтобы убрать инженерный этап. Он создан, чтобы дать инженерам надёжную основу, на которой можно строить.
Большая система регулярного сбора данных/краулинга: здесь всё меняется. Если ты ежемесячно вытягиваешь миллионы страниц по десяткам географий и при этом должен выдерживать жёсткие SLA, глубина proxy-сети Oxylabs и enterprise-поддержка становятся важнее, чем удобство одного клика. Это действительно их территория.
Интеграция AI-агентов через API или MCP: если ты встраиваешь извлечение в workflow на базе Claude или Cursor, то для структурированного извлечения через агента логично использовать Thunderbit MCP Server, а если твоему агенту нужен прежде всего сырой доступ или обход блокировок, то подойдёт Scraper API от Oxylabs. Оба варианта правильны — всё зависит от того, что агент должен делать с данными после получения.
Кому что подходит
Мне больше нравятся персоны, чем расплывчатые рассуждения в духе "это для кого?" — потому что именно в расплывчатых формулировках маркетинговые страницы любят прятаться.
| Персона | Лучший выбор | Почему |
|---|---|---|
| Sales/marketing ops, бизнес-пользователь без кода | Thunderbit | Извлечение в пару кликов, прямой экспорт в Sheets/Airtable/Notion, не нужно поддерживать |
| Дата-инженер, строящий скрейпинг-пайплайн в больших масштабах | Oxylabs | Глубокие proxy-пулы, специализированная инфраструктура, масштабирование по трафику |
| Разработчик, строящий AI-agent workflow | Любой из двух, в зависимости от задачи | У Thunderbit — Open API/MCP для структурированного извлечения; у Oxylabs — Scraper API для сырого доступа и обхода блокировок |
| Enterprise, которому нужна огромная IP-географическая вариативность | Oxylabs | Residential proxy-охват — их ключевая сильная сторона |
Если свести всё к одной фразе: Thunderbit отвечает на вопрос "как получить пригодные данные прямо сейчас", а Oxylabs — на вопрос "как построить систему, которая будет добывать данные постоянно".
Точность, антибот-защита и обслуживание
Ни один инструмент не является магией, и было бы нечестно утверждать обратное. Агентное извлечение Thunderbit хорошо работает на совместимых и разрешённых страницах, для которых оно и создавалось, но это важная оговорка, а не маркетинговая сноска. Это не гарантия обхода любого CAPTCHA, логин-барьера или антиавтоматизационной защиты в интернете. Web Unblocker от Oxylabs специально создан для борьбы с более сложными целями через автоматическое управление fingerprint и сессиями, и это действительно сильная специализация, которую стоит уважать.
Но разница особенно заметна в вопросе обслуживания. Агентный подход Thunderbit адаптирует интерпретацию полей по мере изменения страниц, что снижает объём ручной поддержки, которую требуют традиционные скрейперы. Oxylabs же переносит эту ответственность на тебя: повторные запросы, ротация, обновление парсеров, когда сайт меняет HTML. В этом и есть компромисс владения инфраструктурой: больше контроля, больше ответственности.
И ещё один важный момент, с которым обе компании, вероятно, согласились бы: собирай только то, к чему у тебя есть разрешённый доступ, и соблюдай условия сайта и применимое законодательство. Ни AI-агент, ни proxy-сеть не превращают несанкционированный скрейпинг в санкционированный.
Цена и общая стоимость владения
Вот где, на мой взгляд, многие статьи о сравнении начинают лениться — просто переписывают цифры с прайс-листа и на этом заканчивают. Давай лучше разберём это на сценарии.
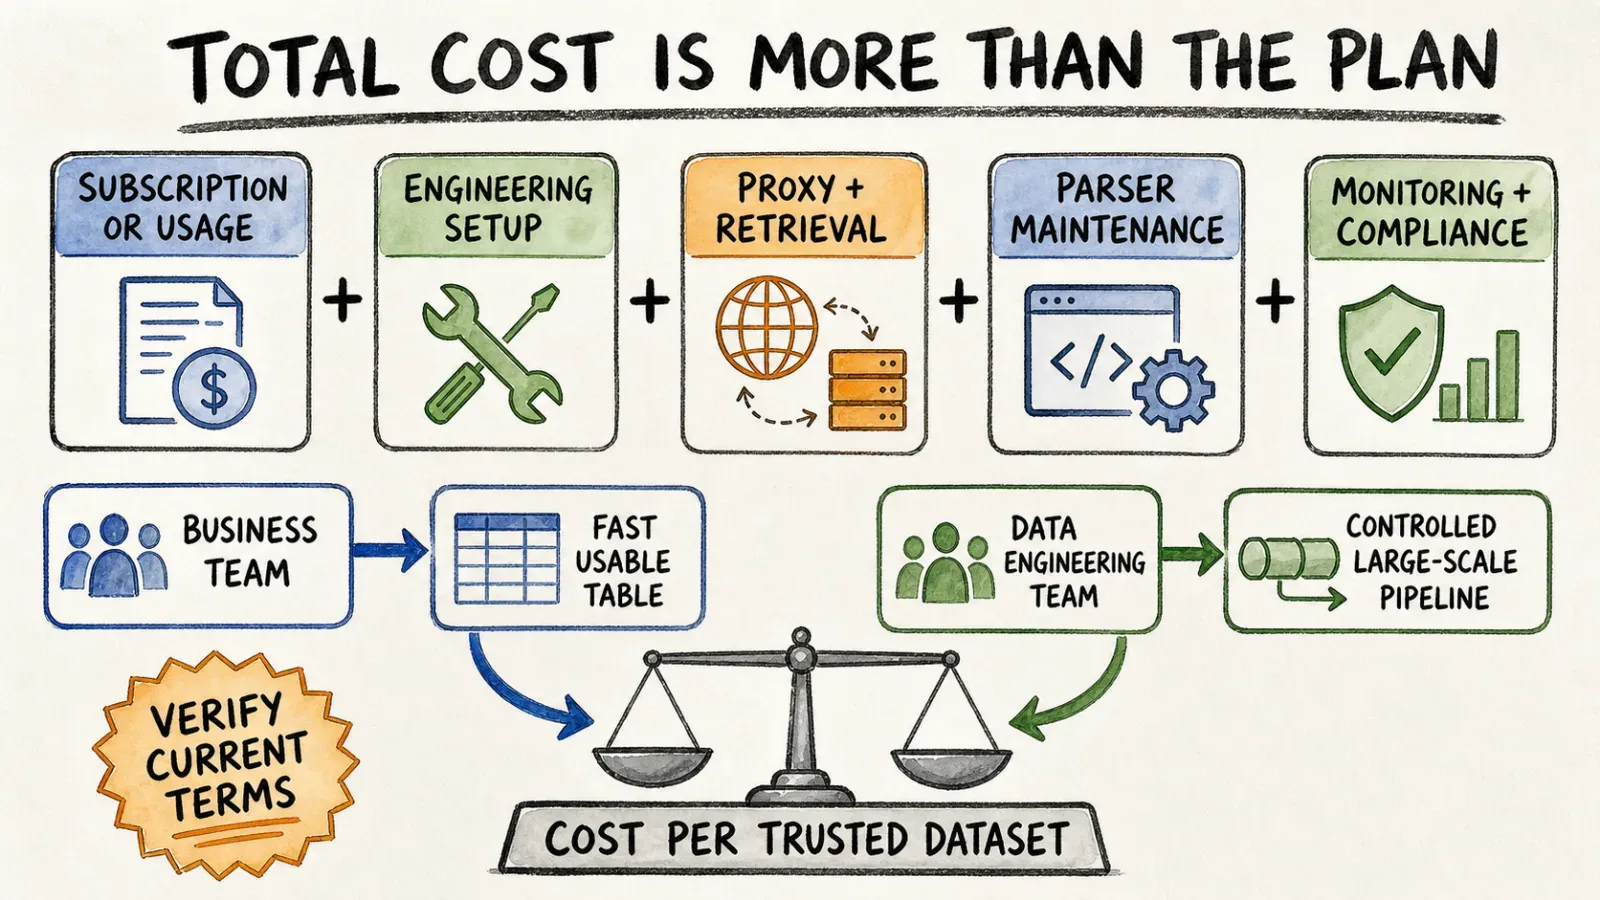
Допустим, тебе нужно собирать 5 000 карточек товаров в месяц со страницы категории e-commerce, с еженедельным обновлением. У Web Scraper API от Oxylabs старт примерно с $49 в месяц, и ты платишь за результаты и запросы. Если нужен более жёсткий слой доступа, тарифы Web Unblocker начинаются с Micro-плана за $75 в месяц за 8 ГБ и доходят до Advanced-плана за $660 в месяц за 88 ГБ (обычная цена, без временных купонов). Проблема в том, что расход гигабайтов трудно прогнозировать: страница с тяжёлым JavaScript может съедать трафик быстрее, чем лёгкая статическая страница, а в собственной документации по биллингу Oxylabs указано, что в счёт идут и request-, и response-трафик, а некоторые ответы 4xx тоже могут быть тарифицируемыми.
Thunderbit, напротив, работает по кредитной модели, привязанной к задачам извлечения, а не к сырым гигабайтам. Поэтому задача на 5 000 строк стоит примерно столько, сколько стоит задача на 5 000 строк, независимо от того, насколько тяжёлый JavaScript на странице. Это действительно другая логика: одно тарифицируется как коммунальный счёт, другое — как подписка на сервис.
Скажу очевидное, что должен сказать каждый честный обзор: цены меняются постоянно, купоны появляются и исчезают, названия тарифов перестраиваются. Перед планированием бюджета обязательно проверь актуальные цены Thunderbit и страницу цен Oxylabs, а также учитывай собственные инженерные затраты — "дешёвый" тариф за GB не такой уж дешёвый, если разработчик тратит два дня в месяц на поддержание пайплайна.
Что говорят отзывы
Я стараюсь не просто махать флагом своей команды, потому что это мало помогает тем, кто проводит реальное исследование. На платформах вроде G2 Oxylabs стабильно получает высокие оценки за поддержку аккаунтов и enterprise-надежность — и это логично, ведь именно такой формат отношений ожидается от компании, которая продаёт инфраструктуру инженерным командам с SLA на кону. Если твой бизнес зависит от того, чтобы scraping-пайплайн никогда не падал, быстрая поддержка стоит реальных денег.
С другой стороны, показатели по простоте использования и скорости получения ценности обычно лучше у инструментов, построенных вокруг шаблонов и задачного извлечения, а не вокруг сырой API-настройки — и именно в этой нише живёт Thunderbit. Разные продукты, разные критерии оценки, и, честно говоря, всё это может быть правдой одновременно, не противореча само себе.
Кому стоит выбрать Thunderbit?
Выбирай Thunderbit, если ты работаешь в sales, operations, research или marketing-команде и тебе нужны структурированные данные со страницы без ожидания инженерного спринта. Это также хороший вариант для разработчиков, которым нужно AI-agent-управляемое извлечение без самостоятельной сборки proxy- и parser-стека с нуля — у тебя есть Open API, MCP Server и CLI по мере необходимости, без отказа от браузерного режима в один клик для быстрых ручных задач. Если хочешь сравнить Thunderbit с другими решениями в этой категории, наш обзор лучших AI web scrapers — хороший следующий шаг.
Кому стоит выбрать Oxylabs?
Выбирай Oxylabs, если ты инженерная или data-команда и ведёшь крупные, защищённые, production-grade процессы получения данных — там, где нужны геотаргетинг, управление сессиями и такой глубокий proxy-пул, который выдержит агрессивные лимиты по запросам. Если твоя организация уже владеет слоями оркестрации, парсинга и хранения и тебе нужен только надёжный доступ в больших объёмах, инфраструктура Oxylabs создана именно для этой задачи.
Могут ли они работать вместе?
В теории — да. Enterprise может использовать Oxylabs для сырого доступа и обхода блокировок на уровне инфраструктуры, а отдельные команды — инструмент вроде Thunderbit для быстрого структурированного извлечения из разрешённых источников данных. Но здесь я хочу быть аккуратным: мне не известно об официальной интеграции между этими продуктами, и я не стал бы преувеличивать существующее партнёрство, которого нет. Корректнее думать не о том, что "эти два продукта встраиваются друг в друга", а о том, что "они могут сосуществовать на разных уровнях стека данных компании" — и это гораздо честнее.
Итог
Если твоя цель — самый короткий путь от "веб-страницы" до "готовой таблицы", Thunderbit построен вокруг одного осознанного клика на One Click Extract; агент анализирует страницу, задача запускается автоматически, а Run Now остаётся опциональной кнопкой. Такой подход Web Scraping Without Coding делает решение доступным для нетехнических команд. Если же твоя цель — надёжная, высоконагруженная операция по скрейпингу, которой полностью владеет и управляет инженерная команда, Oxylabs даёт для этого сырьё: глубину прокси, unblocking и enterprise-поддержку, которая это всё прикрывает.
Я не думаю, что здесь есть универсальный победитель, и любая статья, которая утверждает обратное, скорее всего, что-то продаёт. Выбирай по тому, кто будет ежедневно работать с инструментом — бизнес-пользователь, которому нужен результат, или инженер, которому нужна инфраструктура.
FAQ
Oxylabs — это no-code, как Thunderbit? Не совсем. Web Scraper API и Web Unblocker у Oxylabs — это продукты для разработчиков: ты отправляешь API-запросы и сам обрабатываешь ответ. Там нет браузерного сценария "кликнул и извлёк", сопоставимого с one-click workflow Thunderbit.
Есть ли у Thunderbit API и MCP для разработчиков? Да. Помимо браузерного расширения, Thunderbit предлагает Open API для программного доступа, MCP Server для AI-agent-хостов вроде Claude и Cursor, а также CLI для терминальных сценариев.
Что лучше справляется с целями с жёсткой антибот-защитой? Web Unblocker от Oxylabs специально создан для сложных защищённых целей с автоматическим управлением fingerprint и сессиями. Thunderbit обрабатывает рендеринг и доступ на совместимых, разрешённых страницах в рамках своего процесса извлечения, но не позиционируется как специализированный продукт для обхода антибот-защиты.
Что проще для нетехнических бизнес-пользователей? Thunderbit — и с большим отрывом. Не нужно настраивать API, проектировать схему или писать парсер: ты нажимаешь кнопку, агент предлагает поля, а результат экспортируется в Sheets, Airtable или Notion.
Как правильно сравнивать цены Thunderbit и Oxylabs? Не сравнивай только цифры в долларах — модели разные. Oxylabs в основном тарифицирует трафик (GB) и объём запросов, а это зависит от сложности страницы и рендеринга JavaScript. Thunderbit использует кредиты, привязанные к задачам извлечения, поэтому стоимость одного задания более предсказуема. Перед планированием бюджета всегда проверяй актуальную страницу цен Thunderbit и страницу цен Oxylabs.




