
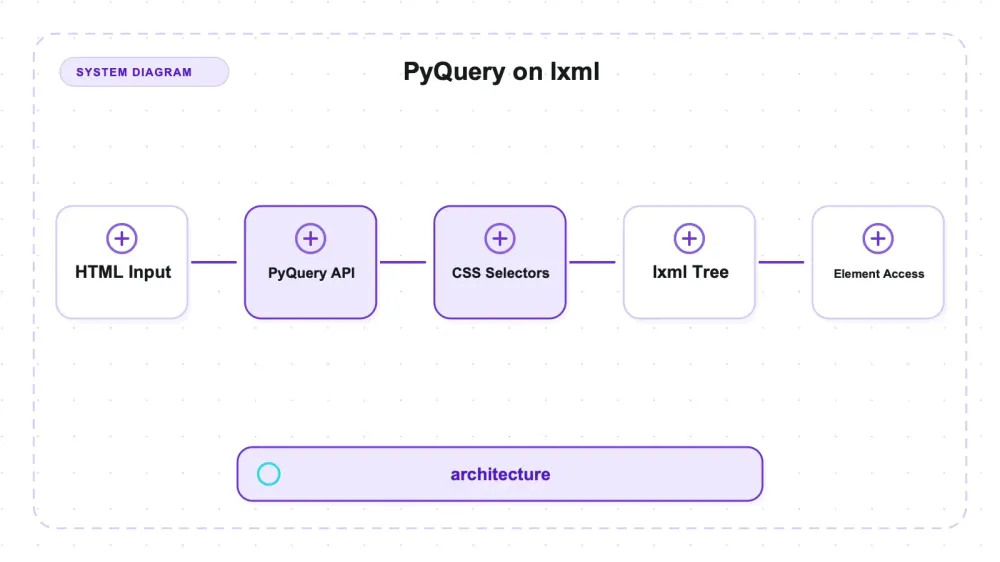
PyQuery накладывает jQuery-подобный API поверх lxml. На пяти размерах страниц — от 1 КБ до 10 МБ — все пять показанных медиан оказались ниже, чем у «чистого» lxml; на самом большом размере разница составила 1,5%. Этот бенчмарк не доказывает, что обёртка быстрее; он лишь показал, что разницы недостаточно, чтобы менять решение именно по этому критерию — выбор селектора и чтение данных.
Начиная с 10 КБ, в показанных медианах результат также оказался всего в пределах нескольких процентов от selectolax. Но без заранее заданного порога эквивалентности это скорее близкий результат, чем статистическая ничья.
Что такое PyQuery
PyQuery — это Python-библиотека, которая даёт вам jQuery-подобный API для выбора элементов и цепочек вызовов поверх дерева документов lxml. Проверенная версия: 2.1.0, лицензия BSD, 2 380 звёзд на GitHub, 59 открытых issues, последний push — 2026-07-27.
Официальная документация: PyQuery documentation.
from pyquery import PyQuery as pq
d = pq(html)
titles = [e.text_content() for e in d("h3.title")]
hrefs = [e.get("href") for e in d("a")]
Возвращаемые элементы — это элементы lxml, так что всё, что вы умеете делать с lxml, по-прежнему доступно. В этом и состоит идея: PyQuery — это слой для удобства, а не отдельный парсер. Команда pip install pyquery подтягивает 3 пакета — lxml, cssselect и сам PyQuery — и 20,1 МиБ, почти всё из которых приходится на скомпилированные расширения lxml.
Если вы работали с cheerio в Node, то здесь та же общая идея API, но в Python. Два проверенных в этом тесте селектора работали одинаково в обоих случаях; этот тест не доказывает полную эквивалентность языков селекторов между cssselect и cheerio.
Как проводилось измерение
В этой исследовательской базе уже был бенчмарк парсеров с особенностью, которой не хватает многим тестам: проверкой паритета через хэш извлечённого контента — отсортированные заголовки плюс отсортированные href — относительно эталонного парсера. Это значит, что библиотека не может просто «срезать углы» и получить искусственно быстрое время. Пять размеров страниц, 50 итераций, три независимых прогона.
Чтобы добавить PyQuery, потребовалось две вещи.
Перезапуск эталона. selectolax был запущен повторно в том же процессе. Его хэш контента совпал на 5 из 5 размеров, а p50 оказался в диапазоне от 0,989× до 1,079× от опубликованного значения — значит, это та же машина и та же тестовая среда.
Запуск lxml тоже в том же процессе. В опубликованном бенчмарке указаны машина и версия Python, но не версии библиотек, поэтому строка lxml там могла относиться к другому релизу lxml, чем тот, который PyQuery оборачивает здесь. Сравнение через такой разрыв означало бы сравнивать две версии lxml и выдавать это за «налог» обёртки. Совместный запуск lxml снимает этот вопрос — в данном venv обе библиотеки используют lxml 6.1.1.
| Размер страницы | selectolax | PyQuery | lxml | PyQuery vs lxml |
|---|---|---|---|---|
| 1 KB | 0.0286 ms | 0.0456 ms | 0.0508 ms | 0.90× |
| 10 KB | 0.1725 ms | 0.1728 ms | 0.1802 ms | 0.96× |
| 100 KB | 1.4855 ms | 1.4093 ms | 1.4145 ms | 1.00× |
| 1 MB | 14.97 ms | 14.96 ms | 15.03 ms | 1.00× |
| 10 MB | 158.10 ms | 162.86 ms | 165.25 ms | 0.99× |
p50 в миллисекундах, медиана из трёх прогонов, всё в одном процессе. parser-bench.json. Все три хэша контента совпали с эталоном на каждом размере.
Накладных расходов от обёртки здесь не видно
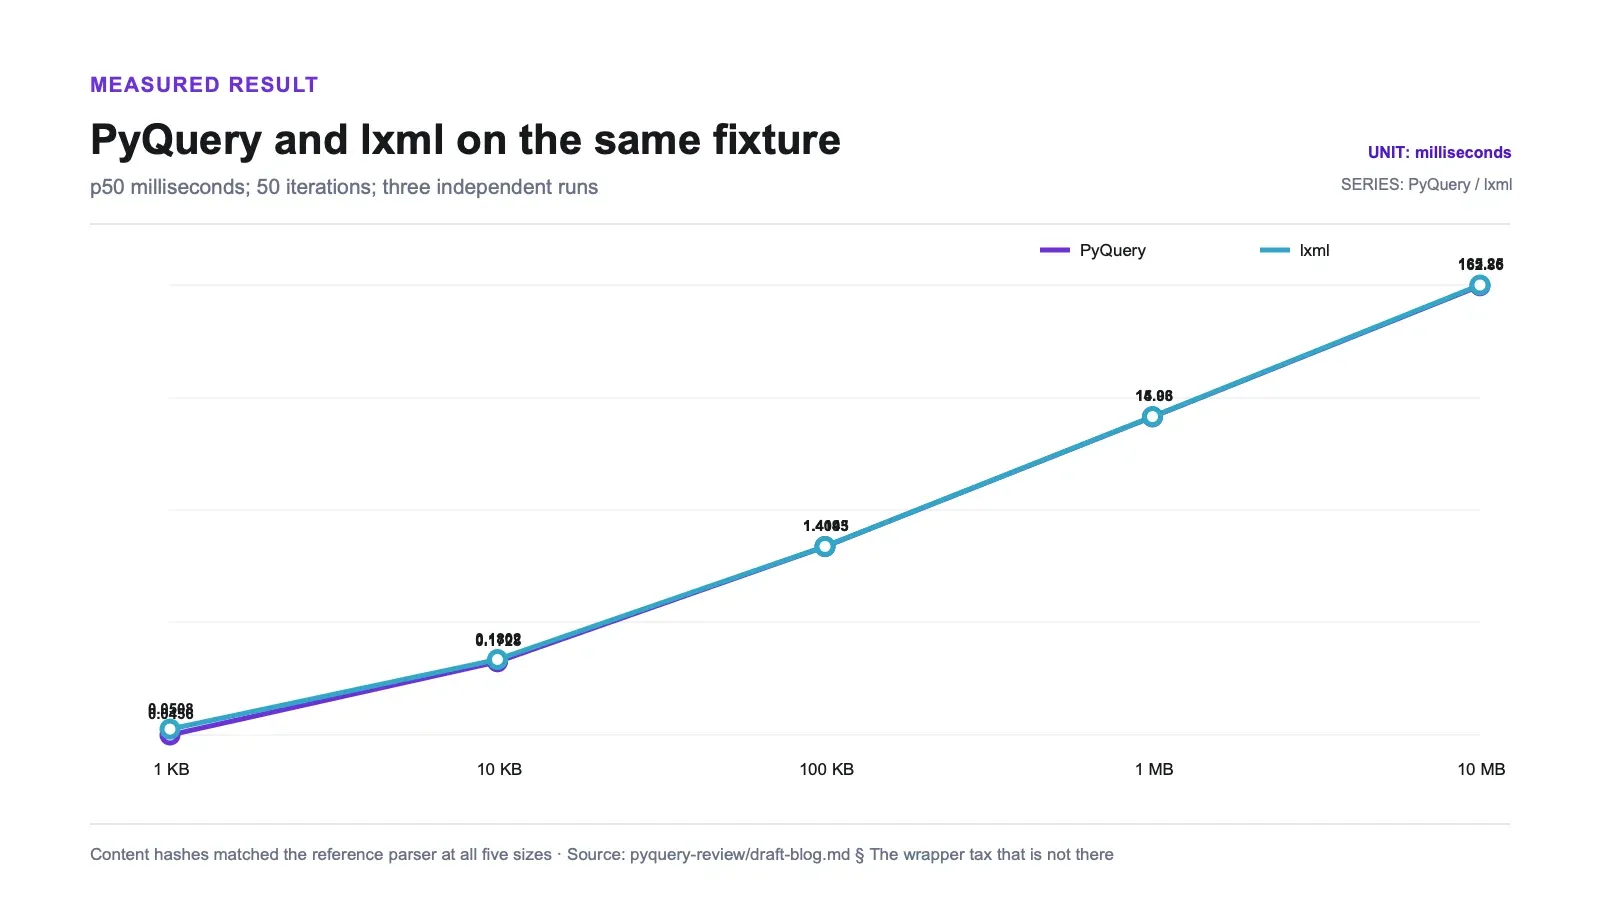
PyQuery оказался на уровне или ниже raw lxml на каждой показанной медиане. Это не означает, что обёртка вообще ускоряет парсинг. Медианы трёх прогонов и отсутствие заранее заданного порога эквивалентности позволяют сделать более узкий вывод: на этом наборе данных не было заметных накладных расходов селектора.
На 10 МБ три прогона PyQuery дали 162.86, 163.17 и 161.13 ms; у lxml — 169.46, 165.25 и 164.18. Диапазоны близки, но не пересекаются. На 1 МБ медианы различаются на 0,5%. Эти небольшие прогоны позволяют сделать практический вывод, но не утверждать статистическую эквивалентность.
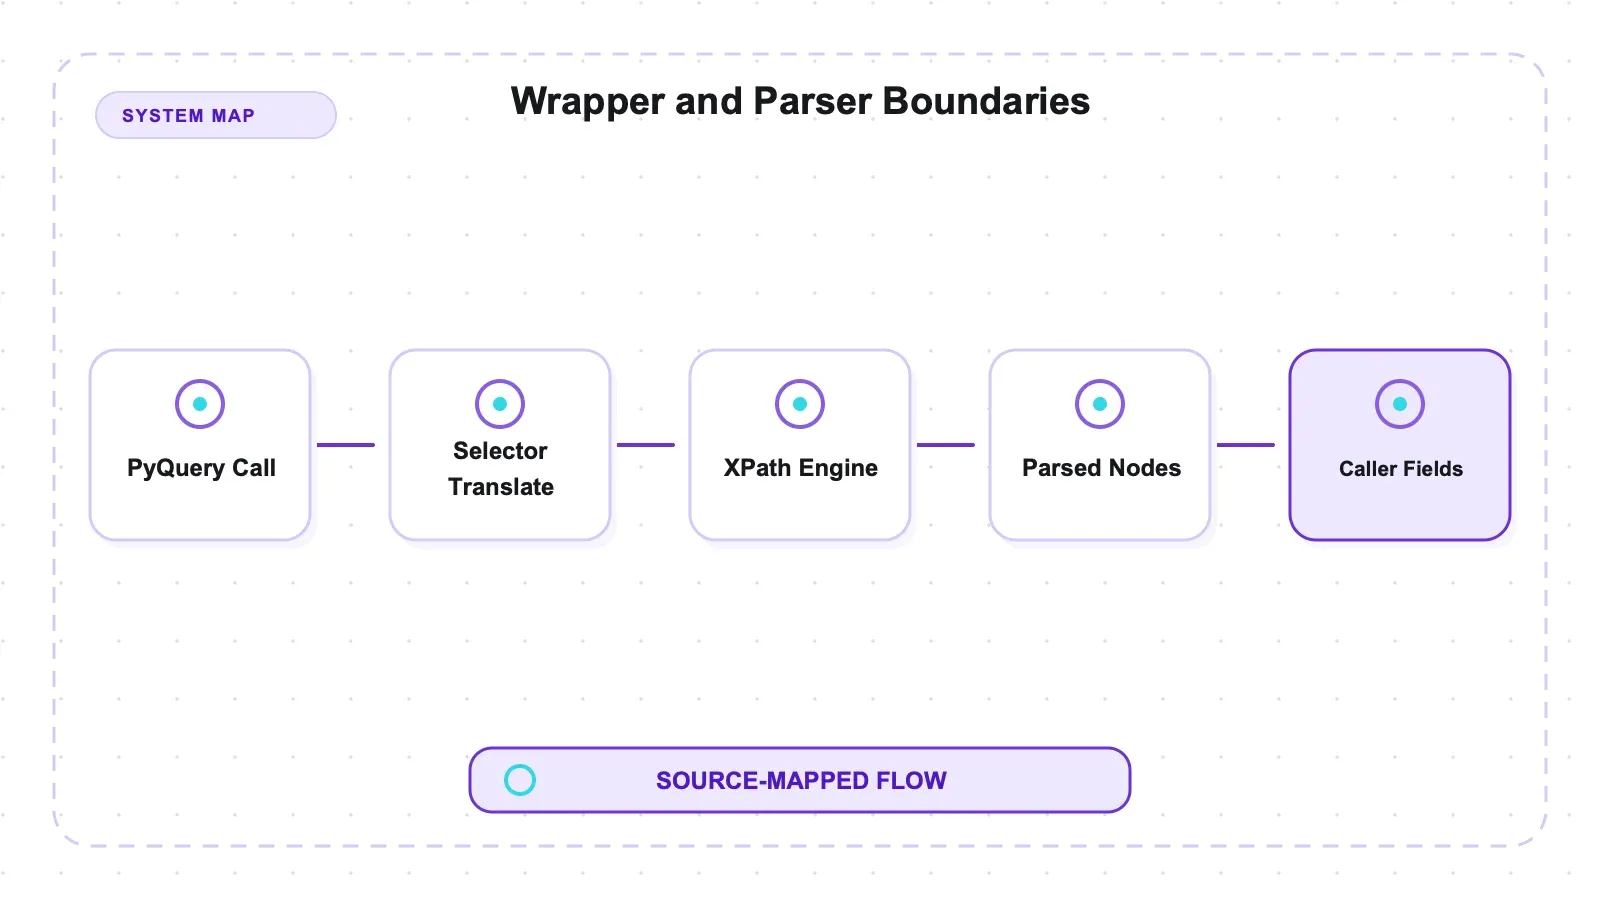
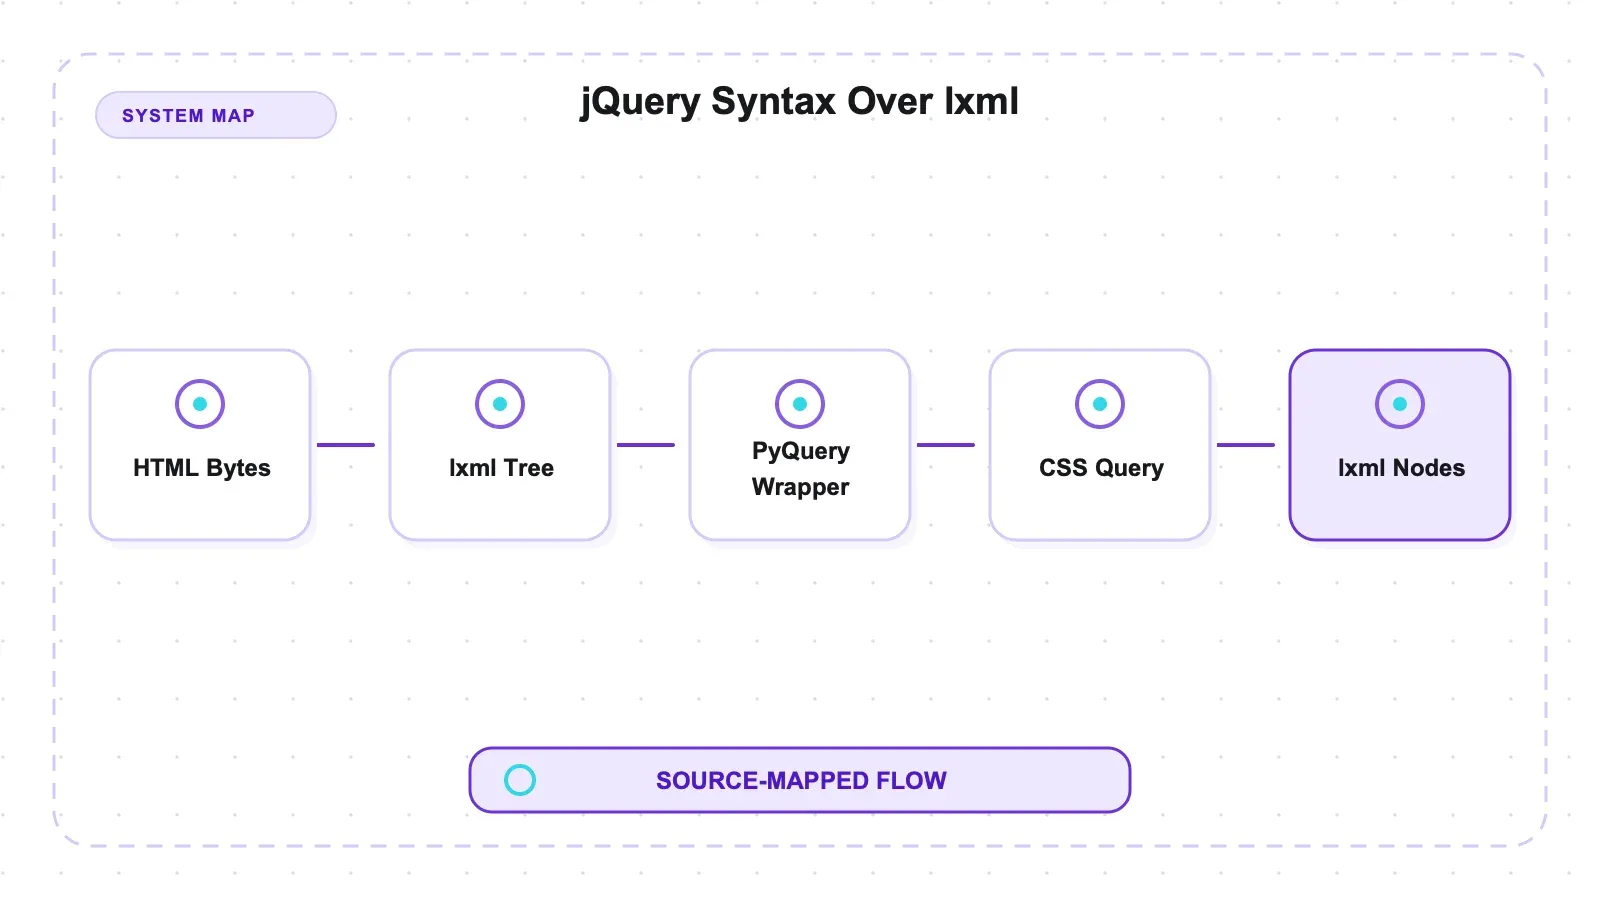
Механика довольно проста: pq(html) один раз строит дерево lxml, d("h3.title") компилирует CSS-селектор через cssselect так же, как это делает tree.cssselect(), а возвращаемые элементы — это элементы lxml. В измеряемом горячем пути PyQuery делает очень мало работы. Обход дерева, изменения, повторные запросы, импорт и потребление памяти в это утверждение про скорость селектора не входят.
Близкие результаты начиная с 10 КБ
Более полезный вывод — в первом столбце.
Начиная с 10 КБ, разброс между самым быстрым и самым медленным медианным значением среди selectolax, lxml и PyQuery составил 4,5% на 10 КБ, 5,4% на 100 КБ, 0,5% на 1 МБ и 4,5% на 10 МБ. Этот прогон не был тестом на эквивалентность; практический вывод здесь такой: эти различия вряд ли изменят выбор парсера для этой задачи у большинства пользователей.
selectolax действительно быстрее на 1 КБ — 0.0286 ms против 0.0456 и 0.0508 — но эту строку нельзя использовать. Среди трёх парсеров разброс на этом размере составляет 77,6%, а у самого selectolax три прогона дали диапазон от 0.0267 до 0.0404 ms. На уровне 28 микросекунд уже доминируют таймер и планировщик. Я бы не ранжировал ничего по этой строке.
Для такой нагрузки — выбор по селекторам и чтение данных — стоит выбирать между этими тремя по API и фактам о зависимостях, а не по предполагаемой иерархии скорости. PyQuery не показал заметного штрафа по сравнению с lxml. У selectolax другой стек парсинга, но в этой статье не измерялись его размер установки, покрытие wheel-пакетами или требования к сборке на той же основе.
Для сравнения: в опубликованном бенчмарке на том же файле 10 МБ были приведены ещё две Python-опции, и вот именно они действительно отличаются:
| Парсер (10 MB) | p50 |
|---|---|
| selectolax (lexbor) | 159.93 ms |
| lxml | 172.93 ms |
| parsel | 231.85 ms |
| selectolax (modest) | 247.95 ms |
| BeautifulSoup + lxml | 2,261.56 ms |
| BeautifulSoup + html.parser | 2,788.75 ms |
Опубликованные значения из bench_parse.json.
Исторические строки бенчмарка показывают, что BeautifulSoup на этом наборе данных более чем на порядок медленнее, чем быстрые парсеры. Эти строки не были повторно запущены вместе с текущей парой PyQuery/lxml в одном процессе, поэтому их стоит воспринимать как контекст, а не как контролируемый множитель для основного вывода.
Сохранённая строка cheerio — 2 927,89 ms (2927.8857 в parser-bench.json) — с совпадающими хэшами извлечённого контента. Этот кросс-рантайм результат тоже зависит от Node, версий пакетов и условий исторического прогона; его не стоит читать как изолированный множитель скорости одной библиотеки.
Реалии установки
| Библиотека | Пакеты | Размер на диске | Лицензия | Звёзды | Последний push |
|---|---|---|---|---|---|
| PyQuery | 3 | 20.1 MiB | BSD | 2,380 | 2026-07-27 |
| cheerio (Node) | 22 (npm) | 9.0 MiB | MIT | 30,449 | 2026-08-11 |
Официальная страница: PyQuery on PyPI.
Три пакета — это аккуратный набор зависимостей, и два из них — lxml и cssselect — уже есть во многих Python-проектах для парсинга. В таком случае дополнительная цена PyQuery — всего несколько десятков килобайт.
20,1 МиБ — это скомпилированные расширения lxml, а не PyQuery. Это те же 20 МиБ, которые вы платите и при прямом использовании lxml.
Лицензия пакета — BSD. На момент снимка у него было 59 открытых issues и push за три недели до теста; сами по себе эти факты не доказывают ни качество поддержки, ни будущую совместимость.
Память и то, что делает с ней битый HTML
Два пункта, которые в каждом обзоре этой серии были помечены как непроверенные, теперь измерены.
Более широкий контекст стресс-теста приведён в сравнении памяти и битого HTML для десяти библиотек.
Пиковое resident memory, через /usr/bin/time -l, отдельный свежий процесс на каждый кейс — нижняя граница импорта показывает, сколько библиотека стоит в загруженном и простаивающем состоянии; пики включают документ.
| Библиотека | Runtime | Нижняя граница импорта | Пик 226 KB | Пик 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Базовые показатели Python и Node нельзя напрямую сравнивать между собой; интерпретатор входит в обе метрики.
PyQuery легче, чем resiliparse на большом документе — 172,5 MiB против 225,1 — несмотря на более высокий порог импорта. Дерево lxml компактно, а большая часть 30,3 MiB нижней границы PyQuery связана именно с загрузкой lxml, а не с тем, что делает сам PyQuery.
Битый HTML. Двенадцать документов, в каждом из которых сломана ровно одна вещь — незакрытые теги, неправильно вложенные inline-элементы, атрибуты без кавычек со пробелами, лишние закрывающие теги, отсутствие <html> вообще, дублирующиеся атрибуты, документ, обрезанный посередине тега, битые сущности, незакрытый <script>, лживое объявление charset, комментарий с разметкой и 600 уровней вложенности — плюс два корректных контрольных документа одинакового размера, потому что «ничего не вернулось» говорит о битом HTML только если библиотека точно так же молчит и на чистом документе того же размера.
pyquery выдал исключение на 0 из 14 и вернул пустой результат на 1, восстановив 10/22 контрольных маркеров на сломанных примерах (malformed-results.json). Один пример не входит в этот подсчёт: по HTML5 всё, что идёт после незакрытого <script>, является содержимым скрипта, так что потеря данных там — это корректное поведение, а восстановление — отклонение. Без результатов альтернативных парсеров по тем же маркерам рядом число 10/22 — это наблюдение о надёжности, а не рейтинг выбора парсера.
Плюсы и минусы
В его пользу. Синтаксис jQuery, знакомый всем, кто писал фронтенд на JavaScript или пользовался cheerio. На этом наборе не проявилось заметных накладных расходов селектора по сравнению с raw lxml. Всего 3 пакета, причём 2 из них, вероятно, уже есть у вас в проекте. Возвращает элементы lxml, так что приёмы работы с lxml сохраняются. BSD. Хэши контента совпали с эталоном на всех пяти размерах.
Против него. 20,1 MiB, потому что lxml. 2 380 звёзд — это заметно меньше сообщества, чем у cheerio с 30 449 звёздами, а значит, меньше примеров на случай странных ошибок. Это слой удобства, так что всё, что не умеет lxml, PyQuery тоже не умеет. И если вы надеялись, что jQuery-API даст прирост скорости, этого не будет: он даёт удобство, а всю работу делает базовый парсер.
Кому он подойдёт, а кому — нет
Используйте PyQuery, если вам или вашей команде удобнее jQuery-стиль селекторов в Python. Измеренные создание дерева, две выборки и чтение данных не показали заметного штрафа по сравнению с lxml; другие операции PyQuery здесь не измерялись.
Используйте lxml напрямую, если вам больше нравится XPath или вы хотите одну зависимость меньше. Этот прогон не показал веской причины выбирать между ними по скорости селектора.
Оцените selectolax, если его API парсера и стек зависимостей подходят вашему проекту. Строка для 1 КБ явно не ранжировалась, и эта статья не даёт основания утверждать, что у него «самые лёгкие зависимости».
В Node аналогичную форму API даёт cheerio. Сохранённые кросс-рантайм значения здесь были медленнее, но различия в среде выполнения и в условиях исторических прогонов не позволяют делать чистый вывод только о библиотеке.
Где уместен управляемый API
PyQuery парсит уже имеющийся у вас HTML. Он не скачивает страницу, не рендерит JavaScript и не обходится с антибот-защитой — ни один парсер в этом сравнении этого не делает, а на многих реальных сайтах именно это и есть более сложная половина задачи.
Примечание автора: Thunderbit — это наш managed-вариант для получения, рендеринга и извлечения данных по URL. В этом обзоре он не сравнивался с PyQuery. Важная граница — это то, есть ли у вас уже HTML и нужны ли локальные селекторы, либо вам нужен сервис, который сам получает страницу и извлекает данные.
Честная формулировка такова: если HTML уже у вас и селекторы понятны, PyQuery бесплатен и удобен. Если селекторы постоянно ломаются или вы работаете с большим объёмом запросов, это уже совсем другая покупка.
Для более широкого обзора смотрите наш обзор web scraping API с hosted-решениями и гайд по open-source scraper по self-hosted-инструментам. Если результат парсинга идёт в модель, то преобразование HTML в Markdown на Python — это место, где чаще всего теряется точность.
Попробовать Thunderbit для извлечения веб-данных
Стоит ли использовать PyQuery?
Да, если вам нужен jQuery-подобный синтаксис в Python и измеренный путь «выборка + чтение» отражает вашу рабочую нагрузку.
Бенчмарк не выявил заметных накладных расходов селектора по сравнению с lxml при сохранении паритета по хэшам контента. При этом он не доказал, что сама библиотека вообще ничего не стоит.
На пяти размерах медианы трёх Python-парсеров были достаточно близкими, так что для этой задачи, скорее всего, важнее совместимость API, чем микроскопическая разница в скорости. Задайте порог эквивалентности и прогоните точные альтернативы ещё раз, прежде чем превращать этот вывод в общий рейтинг парсеров.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Замедляет ли PyQuery lxml?
В этом прогоне заметных накладных расходов селектора не обнаружено. На пяти размерах страниц его медианы были на уровне или ниже, чем у raw lxml, причём обе библиотеки использовали lxml 6.1.1 в одном процессе. На 10 МБ близкие диапазоны не пересекались: у PyQuery 161.13–163.17 ms, у lxml 164.18–169.46 ms. pq(html) строит дерево lxml, а проверенные селекторы компилируются через cssselect.
Быстрее ли selectolax, чем PyQuery? На 1 КБ медиана у него была ниже, но эта строка не ранжировалась, потому что на микросекундном масштабе разброс сильнее самого измерения. Начиная с 10 КБ, разница медиан составила 0,5%–5,4%. Для этой нагрузки это близкие результаты, а не доказательство эквивалентности или перекрытия диапазонов во всех случаях.
Зачем было запускать lxml заново, а не цитировать опубликованное значение? Потому что в опубликованном бенчмарке указаны машина и версия Python, но не версии библиотек. Строка lxml там могла относиться к другой версии lxml, чем та, которую оборачивает PyQuery сегодня, и такой разрыв выдал бы себя за «налог обёртки», которого на самом деле нет. Совместный запуск обоих в одном процессе на lxml 6.1.1 убирает эту неоднозначность.
Как это сравнивается с cheerio? Та же общая идея API, но другая экосистема. Два проверенных здесь селектора работали в обоих случаях, а хэши контента совпали на всех пяти размерах; это не доказывает полную совместимость всех селекторов. Сохранённые времена cheerio были медленнее, но различия между runtime и условиями исторического запуска не позволяют делать вывод только на уровне одной библиотеки.
Что здесь не тестировалось? Память измерялась как пиковый RSS для запуска только на импорт, для документа 226 КБ и для документа 10 МБ. Битый HTML проверялся на 12 сломанных документах плюс два контрольных. По-прежнему не протестированы производительность изменения и обхода дерева в PyQuery, кэширование повторных запросов, загрузка по URL, параллельность и реальные рабочие нагрузки с сайтов. Время для 1 КБ остаётся без ранжирования.




