
На одном размеченном наборе статей newspaper4k показал результат по всем 22 страницам, восстановил 98,65% оценённых единиц статьи и не включил ни одного помеченного токена служебного текста. По этим трём параметрам он выглядит очень сильным кандидатом именно в рамках этого бенчмарка, но это ещё не значит, что он универсальный лидер.
В этом наборе больше ни один инструмент не собрал все три наблюдаемых результата одновременно. Mozilla Readability восстановил все оценённые смысловые единицы, но захватил больше служебного текста; goose3 не захватил служебные токены, но дважды вернул пустую строку. При других правилах отбора победить может уже другая библиотека.
Один параметр загрузки перед внедрением точно заслуживает отдельного внимания.
Что такое newspaper4k
newspaper4k — это поддерживаемый форк newspaper3k, который, в свою очередь, стал Python-3 продолжением оригинального newspaper. Эта история важна, когда ты ищешь помощь: большая часть материалов в интернете относится к предшественнику, а часть API уже успела измениться.
Официальная справка: официальный репозиторий newspaper4k.
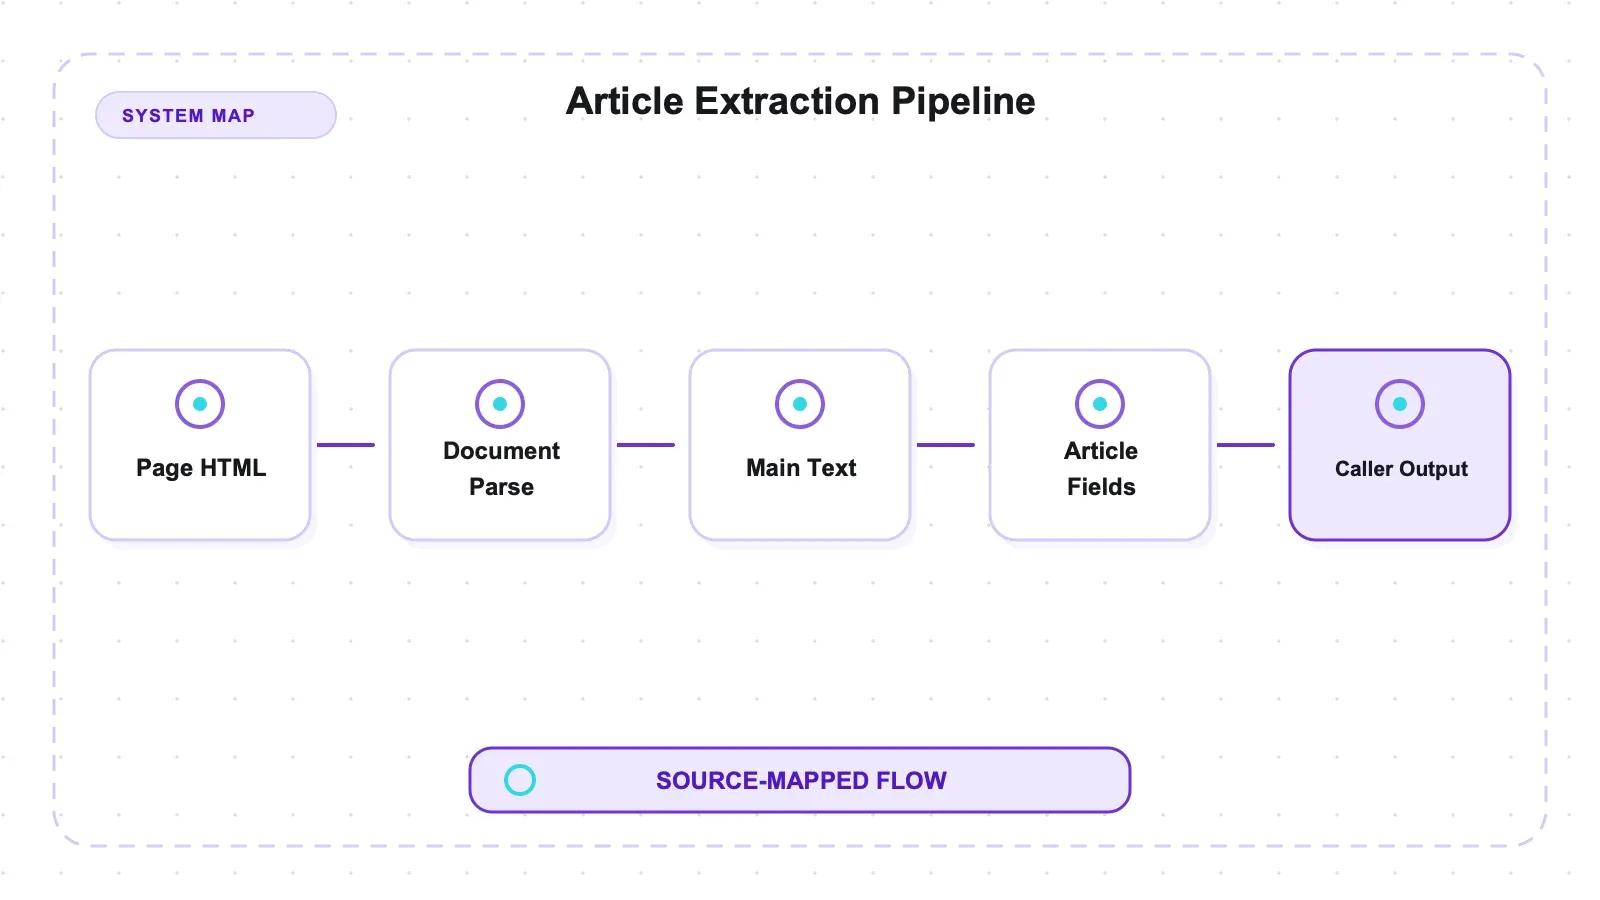
Самая частая ошибка при работе с этой библиотекой — попытаться вызвать set_html(). Такого метода нет. HTML передаётся через download():
from newspaper import Article
a = Article(url="https://example.com/story")
a.download(input_html=html)     # не set_html()
a.parse()
text = a.text
Я сам ошибся именно так на первом прогоне и сначала поставил библиотеке 0 из 22, прежде чем проверить, не в моём ли коде проблема. Проблема была именно в моём коде.
На выходе ты получаешь не только текст. Объект Article даёт поля text, title, authors, publish_date, top_image, images, movies, meta_description, meta_lang, tags и article_html. Поля keywords и summary требуют дополнительной установки NLP-компонентов и корпуса, как описано ниже. Набор полей был перечислен, но точность метаданных не оценивалась.
Проверенная версия: 0.9.6, MIT, 1 135 звёзд GitHub, дата последнего push в репозиторий — 2026-07-31. Эта дата — лишь снимок состояния, а не полноценная оценка здоровья проекта. Python 3.14.2.
Результат
| Библиотека | Полнота извлечения статьи (все 22) | Утечка служебного текста | Точность по токенам статьи | Загрязняющие токены | Выдача результата |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 | 22/22 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 | 22/22 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 | 22/22 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 | 22/22 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 | 19/22 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 | 20/22 |
sixway-scores.json. Каждая единица в каждом тестовом документе содержит уникальный сигнальный токен, поэтому «восстановлено» и «утекло» здесь — это точное вхождение подстроки, а не оценка похожести. Полнота считается по всем 22 страницам; утечка и точность — по 11 страницам, где есть и статья, и служебный текст.
Три столбца стоит читать отдельно.
Он ответил по каждой странице. goose3 и jusText — нет: 20 и 19 из 22. Это важнее, чем кажется, потому что точность и F1 в такой таблице условны относительно наличия результата: если библиотека возвращает пустую строку, она не участвует ни в числителе, ни в знаменателе, и её провал как будто «бесплатен». У goose3 точность 1.0000 была рассчитана на 10 из 11 тестов; у newspaper4k значение 0.9452 — на 11 из 11. Это не совсем одна и та же метрика.
Он не пропустил ни одного служебного блока. В наборах есть специально вредный boilerplate: промо-блоки с нейтральной классификацией, стоящие рядом со статьёй; ветки комментариев с безобидными именами классов; рекламные блоки, где нет слова "ad". У Readability эвристика с добавлением sibling-блоков затянула несколько таких элементов; newspaper4k не взял ни одного.
Он пропустил одну единицу из 74, и эта пропущенная единица встречается у нескольких библиотек.
Промах случился на странице без обычной прозы — это документ из таблиц, блока кода, коротких элементов и подписи к изображению вместо абзацев — и пропущенная единица здесь — подпись. Он не одинок в этом:
| Библиотека | Полнота на странице без обычной прозы | Потерянные единицы |
|---|---|---|
| Readability | 1.000 | — |
| jusText | 1.000 | — |
| trafilatura | 0.875 | подпись |
| resiliparse | 0.875 | подпись |
| newspaper4k | 0.875 | подпись |
| goose3 | 0.250 | обе таблицы, блок кода, оба коротких элемента, подпись |
Три библиотеки теряют одну и ту же подпись и ничего больше — это больше похоже не на три независимые ошибки, а на общее унаследованное представление о том, насколько важна подпись. Если твой контент — документация, рецепты или любой другой материал, где подпись несёт информацию, которой нет в абзаце, это стоит проверить до выбора инструмента. Readability и jusText эту подпись сохранили.
На той же странице goose3 разваливается полностью и теряет три четверти контента, так что «контент без обычной прозы» — это ось различий между этими шестью библиотеками куда более существенная, чем может показаться по первой таблице.
По скорости median extraction у newspaper4k по 22 страницам составил 2,69 мс — это самый медленный результат из шести, а худший случай — 199,81 мс. По сравнению с медианой resiliparse 0,06 мс это разница примерно в 45 раз в данном контролируемом запуске. В одиночном сценарии это может быть незаметно, но пропускная способность и хвостовая задержка под нагрузкой не тестировались. Отдельно ниже измерен cold import.
Параметр по умолчанию, который я бы изменил в первой же строке
Официальная справка: документация newspaper4k.
Если посмотреть на поставляемый объект Configuration, там найдётся двадцать два параметра. Один из них такой:
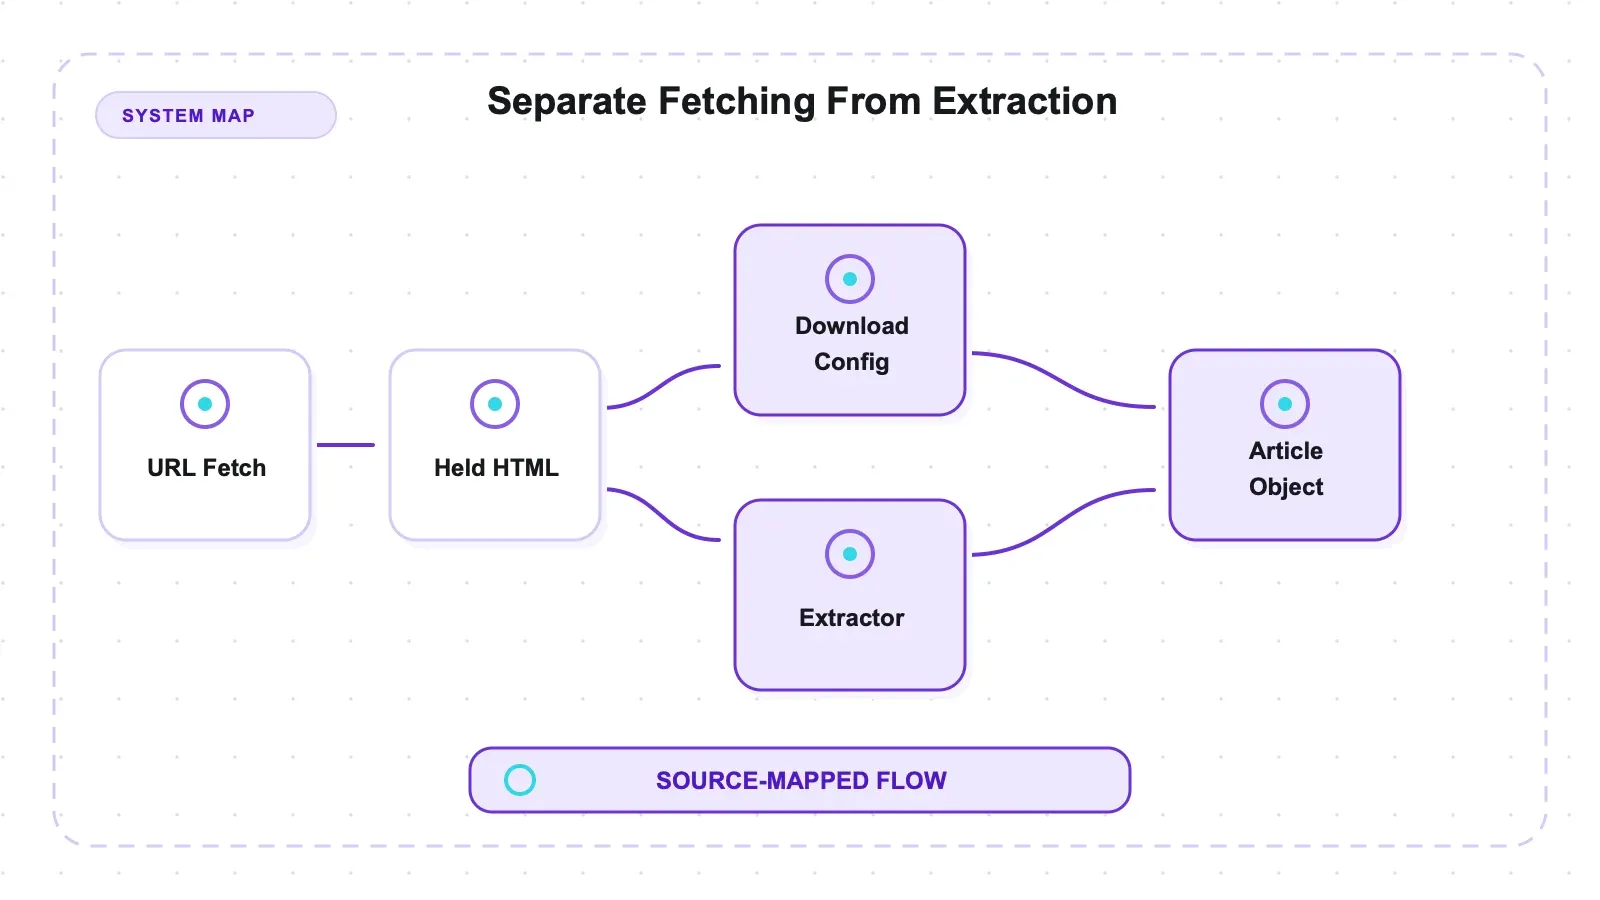
_honor_robotstxt = False
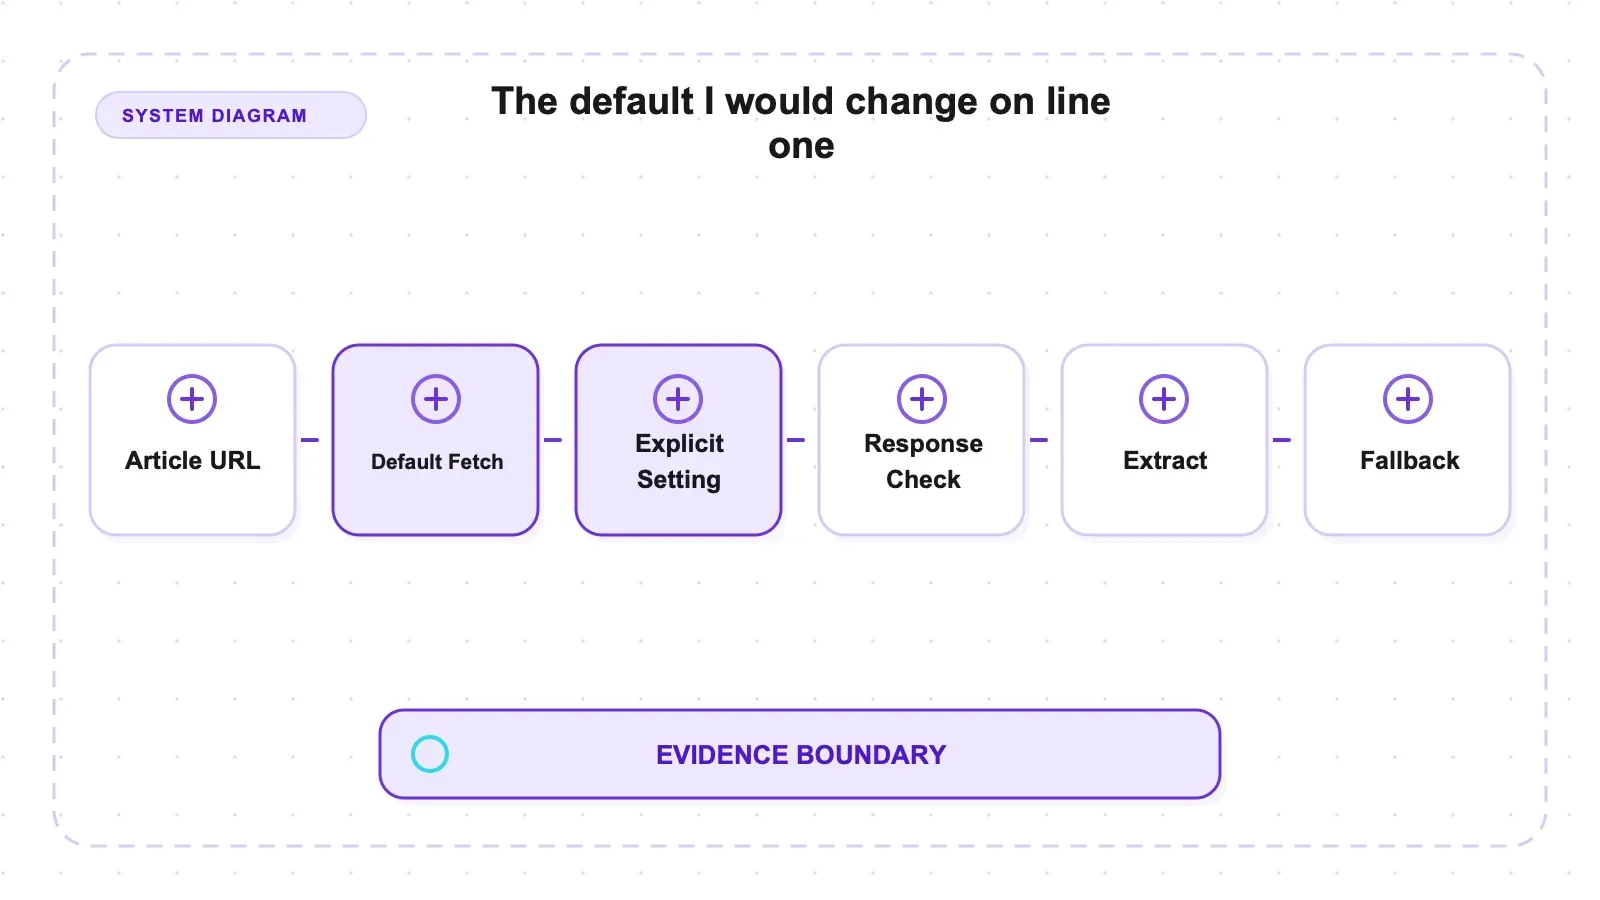
newspaper4k не соблюдает robots.txt, если ты явно этого не укажешь. Если библиотека сама загружает страницу — Article(url).download() без input_html — она запросит именно тот адрес, который ты ей дал, независимо от того, что написано в robots-файле сайта.
Для библиотеки, основной сценарий которой — разбор HTML, который у тебя уже есть, это вполне разумный инженерный дефолт. Но обнаружить такое в production после того, как ты отправил её на тысячу URL, — уже совсем другой разговор. Либо установи honor_robotstxt=True в Configuration, либо передавай input_html и бери загрузку на себя, как я делал в этом тесте.
Ещё два параметра, которые стоит знать:
number_threads = 10. По умолчанию вспомогательные функции для нескольких статей используют десять потоков. Это не то же самое, что число запросов в секунду, но при отсутствии явных лимитов на хост и планирования это может дать всплеск одновременных запросов.
fetch_images = True. Загрузка изображений включена по умолчанию, что поднимает вопрос об офлайн-использовании. При заблокированном socket.connect проверенный путь newspaper4k 0.9.6 — download(input_html=…) с последующим parse() на одном входном HTML — завершился успешно, вернул 1 292 символа и не попытался установить ни одного сетевого соединения. Это подтверждает именно этот путь, но не любую конфигурацию, плагин, тип контента или будущий релиз.
Остальные настройки выглядят разумно: min_word_count 300, min_sent_count 7, max_text 100000, http_success_only True, memorize_articles True, follow_meta_refresh False, allow_binary_content False.
Реальность установки
pip install newspaper4k тянет 22 пакета и 47,5 МиB примерно за шесть секунд. Cold import в новом subprocess: 2,812 с — самый медленный результат в сравнении.
| Библиотека | Пакеты | site-packages | Cold import | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Каждый инструмент запускался в отдельном пустом virtualenv, так что ни один не наследует зависимости соседа.
2,812 секунды на импорт — это в 187 раз медленнее, чем 15 миллисекунд у resiliparse. В долго живущем worker ты платишь за это один раз, и это почти неважно. В serverless-функции ты платишь за это при каждом cold start, и именно там newspaper4k — плохой выбор, как бы хорошо он ни извлекал текст.
Есть и один шероховатый момент при установке. При импорте выводится предупреждение:
UserWarning: nltk is not installed. Some NLP features will be unavailable. Install it with: pip install 'newspaper4k[nlp]'
В этом тесте эти функции не требовались, и извлечение работало нормально без них. Но базовая установка — это не полная установка, а newspaper4k[nlp] тянет заметно более тяжёлое дерево зависимостей плюс загрузку корпусов. Закладывай это в бюджет только если тебе действительно нужны ключевые слова и краткие сводки.
Память и то, как на неё влияет битый HTML
Два аспекта, которые во всех обзорах этой серии раньше отмечались как не протестированные, теперь измерены.
Более широкий контекст стресс-тестов см. в сравнении потребления памяти и работы с битым HTML для десяти библиотек.
Пиковое resident memory через /usr/bin/time -l, по одному свежему процессу на каждую ячейку — нижняя граница импорта показывает, сколько библиотека стоит в загруженном и простаивающем состоянии, а пики включают сам документ.
| Библиотека | Runtime | Нижняя граница импорта (MiB) | Пик на HTML 226 KB (MiB) | Пик на HTML 10 MB (MiB) |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Базовые показатели Python и Node напрямую не сопоставимы друг с другом; в обоих случаях внутри есть интерпретатор.
Нижняя граница у newspaper4k — 52,6 MiB, а пик на 10 MB HTML — 668,5 MiB, то есть второй по тяжести результат среди Python-библиотек. Для обычных страниц это не проблема, но при пакетной обработке больших документов в worker с жёстким лимитом памяти это уже важно.
Битый HTML. Двенадцать документов, каждый ломает ровно одну вещь — незакрытые теги, неправильно вложенные inline-элементы, атрибуты без кавычек и пробелами, лишние закрывающие теги, отсутствие <html> вообще, дублирующиеся атрибуты, документ, обрезанный посреди тега, плохие сущности, незакрытый <script>, ложное объявление кодировки, комментарий с разметкой и 600 уровней вложенности — плюс два корректных контроля одинакового размера, потому что фраза «он ничего не вернул» говорит о влиянии битости только тогда, когда библиотека не молчит и на чистом документе того же размера.
Контрольные и битые случаи хорошо разделяются в сырых результатах:
| Группа | Документов | Исключений | Пустой вывод | Восстановленные оцененные сигнальные токены |
|---|---|---|---|---|
| Корректные контрольные документы | 2 | 0 | 0 | не используется в оценке битого HTML |
| Битые документы | 12 | 0 | 10 | 5/33, без случая с незакрытым <script> |
Два контроля выдали 70 и 1 351 символ, тогда как десять из двенадцати битых входов вернули пустую строку. Это позволяет отнести молчание именно к поломке HTML в этой схеме теста, а не просто к короткому входу. Оценщик проверяет маркеры заголовка, абзаца и ссылки на одиннадцати допустимых битых документах. Случай с незакрытым script исключён, потому что при HTML5-парсинге следующий за ним markup остаётся содержимым script. См. malformed-results.json. Это серьёзное ограничение по восстановлению, которое нужно учитывать при выборе, а не просто успех в стиле «не упало с ошибкой».
Плюсы и минусы
В пользу библиотеки. В этой сравнительной проверке не было ни одного токена служебного текста, выход по всем 22 контролируемым статьям и 0,9865 полноты по оценённым единицам статьи. Библиотека извлекает текст статьи и метаданные, хотя точность метаданных не тестировалась. На проверенном пути с заранее переданным HTML при заблокированном socket.connect не было попыток сети. В репозитории на момент проверки был свежий датированный push; более широкое состояние поддержки не оценивалось.
Против библиотеки. Самый тяжёлый cold import в наборе — 2,812 с и 22 пакета / 47,5 MiB измеренных site-packages. honor_robotstxt по умолчанию False, а многостраничные помощники используют десять потоков. Базовая установка предупреждает об отсутствии NLTK, поэтому для ключевых слов и сводок нужна более тяжёлая опциональная установка. И, что особенно важно, десять из двенадцати битых документов вернули пустой вывод, хотя оба корректных контрольных документа дали текст.
Кому подойдёт и кому не подойдёт
Стоит рассмотреть newspaper4k, если твой приоритет такой: получить непустой текст на контролируемом корпусе статей, минимизировать служебный текст в этом корпусе и принять более медленный cold import. По этому явному правилу библиотека лидировала в сравнении. По другому правилу выбрать можно Readability за максимальное сохранение содержимого или resiliparse за скорость старта и медиану извлечения.
Лучше пропустить или тестировать особенно тщательно, если решающим фактором является cold start, если 47,5 MiB измеренных site-packages имеют значение или если важна работа с битым HTML. Здесь resiliparse импортировался в 187 раз быстрее, но при этом не сравнялся с trafilatura по всем качественным столбцам: у trafilatura была выше полнота извлечения статьи, а профили утечек и точности тоже отличались. newspaper4k ориентирован на статьи; товарные списки и дашборды не тестировались, поэтому о поведении на них ничего не утверждается.
Что бы ты ни делал, задай honor_robotstxt, если позволяешь библиотеке самой загружать страницы. Это не замечание о производительности.
Где уместен управляемый API
newspaper4k умеет разбирать HTML, который передаёт вызывающая сторона, и у него есть пути самостоятельной загрузки. Управляемый сервис извлечения выносит получение, рендеринг и работу со схемой за границу твоего стека. Мы создаём Thunderbit, но он не запускался на этом наборе тестов, поэтому этот обзор не даёт сравнения качества, рендеринга, антибот-защиты, задержек или стоимости. Для заранее полученного HTML статьи вывод здесь касается только newspaper4k; не-статейные цели требуют отдельной оценки.
Для тех же тестовых страниц во всех шести извлекателях см. сравнение шести библиотек для извлечения статей.
Для hosted-решений наш обзор web scraping API даёт более широкий взгляд; для self-hosted альтернатив — пиллар по open-source scraper. Если текст идёт в модель, конвертация HTML в Markdown на Python показывает, где теряется точность.
Попробовать Thunderbit для извлечения веб-данных
Стоит ли использовать newspaper4k?
Рассматривай newspaper4k как сильного кандидата для извлечения текста статьи, если HTML у тебя уже есть, а затем обязательно прогоняй его на реальных страницах из своего корпуса, прежде чем внедрять. Контролируемый набор подтверждает высокую полноту по оценённым единицам статьи, отсутствие служебного текста и непустой вывод на всех 22 article-oriented тестах. Но он не покрывает реальные страницы и точность метаданных, а десять из двенадцати битых документов вернули пустой вывод.
Если ты используешь путь загрузки самим инструментом, отдельно проверь honor_robotstxt=False, параллелизм в десять потоков и ограничения по скорости на каждый хост. Если важны cold start или объём зависимостей, измеряй локальный импорт 2,812 секунды и 47,5 MiB site-packages в своей инфраструктуре, а не считай это универсальной ценой контейнера.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Почему не работает set_html()?
Потому что в newspaper4k такого метода нет. HTML передаётся через download(input_html=html), затем вызывается parse(). В поиске легко наткнуться на примеры для newspaper3k, поэтому ошибиться просто; я так и сделал в первом прогоне и потом исправил тестовый harness до оценки.
Соблюдает ли newspaper4k robots.txt?
Не по умолчанию. honor_robotstxt поставляется как False. Поставь True в Configuration, если библиотека будет сама загружать страницы, или передавай input_html и загружай HTML самостоятельно. Для многопоточной работы также по умолчанию используется десять потоков. Это не фиксированная скорость запросов, а просто выбранный уровень параллелизма; для загрузки задавай явные лимиты на хост.
Делает ли parse() сетевые запросы?
В newspaper4k 0.9.6 проверенный путь download(input_html=…) + parse() не сделал ни одной попытки соединения для одного переданного HTML, пока socket.connect был заблокирован. Это не доказывает, что любая конфигурация, плагин, тип контента или будущая версия будут вести себя так же.
Что означает предупреждение NLTK при импорте?
Базовая установка не включает NLTK, поэтому извлечение ключевых слов и создание кратких сводок недоступны, и библиотека сообщает об этом при импорте. Само извлечение при этом не страдает — всё, что измерялось здесь, запускалось на базовой установке. pip install 'newspaper4k[nlp]' добавляет эти возможности вместе с более тяжёлым деревом зависимостей и загрузкой корпусов.
Что этот обзор не тестировал? Реальные страницы — здесь использовались только контролируемые тестовые документы с разметкой. Поля метаданных были перечислены, но не оценивались по точности title, author, date или image. Также не тестировались многоязычное извлечение, NLP-расширения, многопоточный обход источников и пропускная способность под нагрузкой. Пиковая память процесса измерялась на одном HTML объёмом 226 KB и одном HTML объёмом 10 MB, а не при параллельной или длительной нагрузке.




