
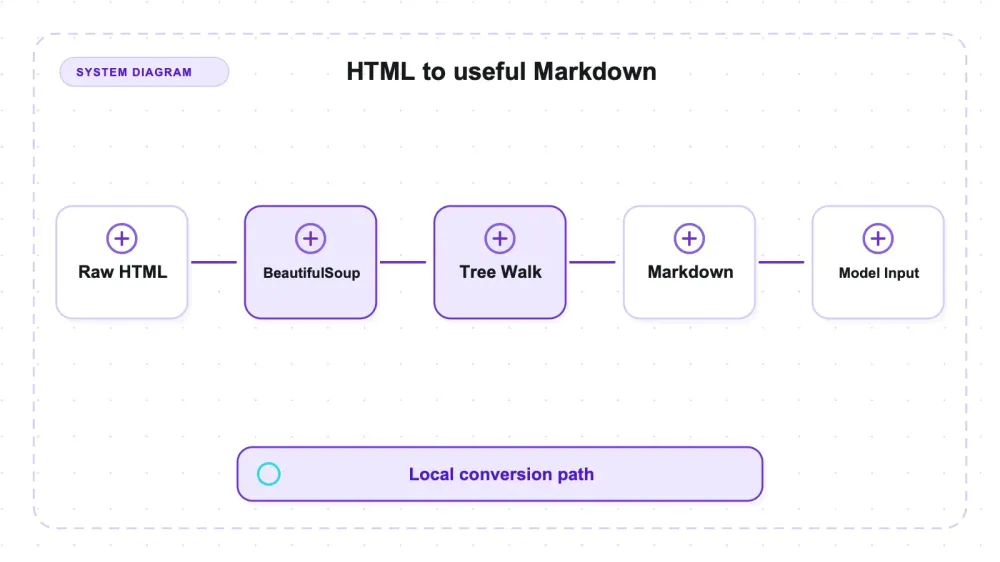
На четырёх HTML-образцах, общих с markitdown, markdownify выдал то же число строк Markdown-таблиц по нашему счётчику — 36 против 36 — и восстановил все 16 проверенных строк содержимого. Его результат в 21 062 токена формально оказался самым низким, хотя первые три конвертера отличались меньше чем на 1,3%. Установка занимает 1,8 МиБ, лицензия — MIT, а на момент снимка у проекта было 2 235 звёзд на GitHub.
Это наименее обсуждаемая библиотека в этой категории, и по этим цифрам именно её я бы выбрал.
Что такое markdownify
markdownify — это Python-конвертер HTML в Markdown, построенный на BeautifulSoup. Вся архитектура именно такая: парсинг через BeautifulSoup, обход дерева, вывод Markdown. Проверенная версия: 1.2.3, лицензия MIT, 2 235 звёзд, 42 открытых issue, последний релиз — 2026-06-30; проект активно поддерживается, всего 44 релиза.
Официальная справка: официальный репозиторий python-markdownify.
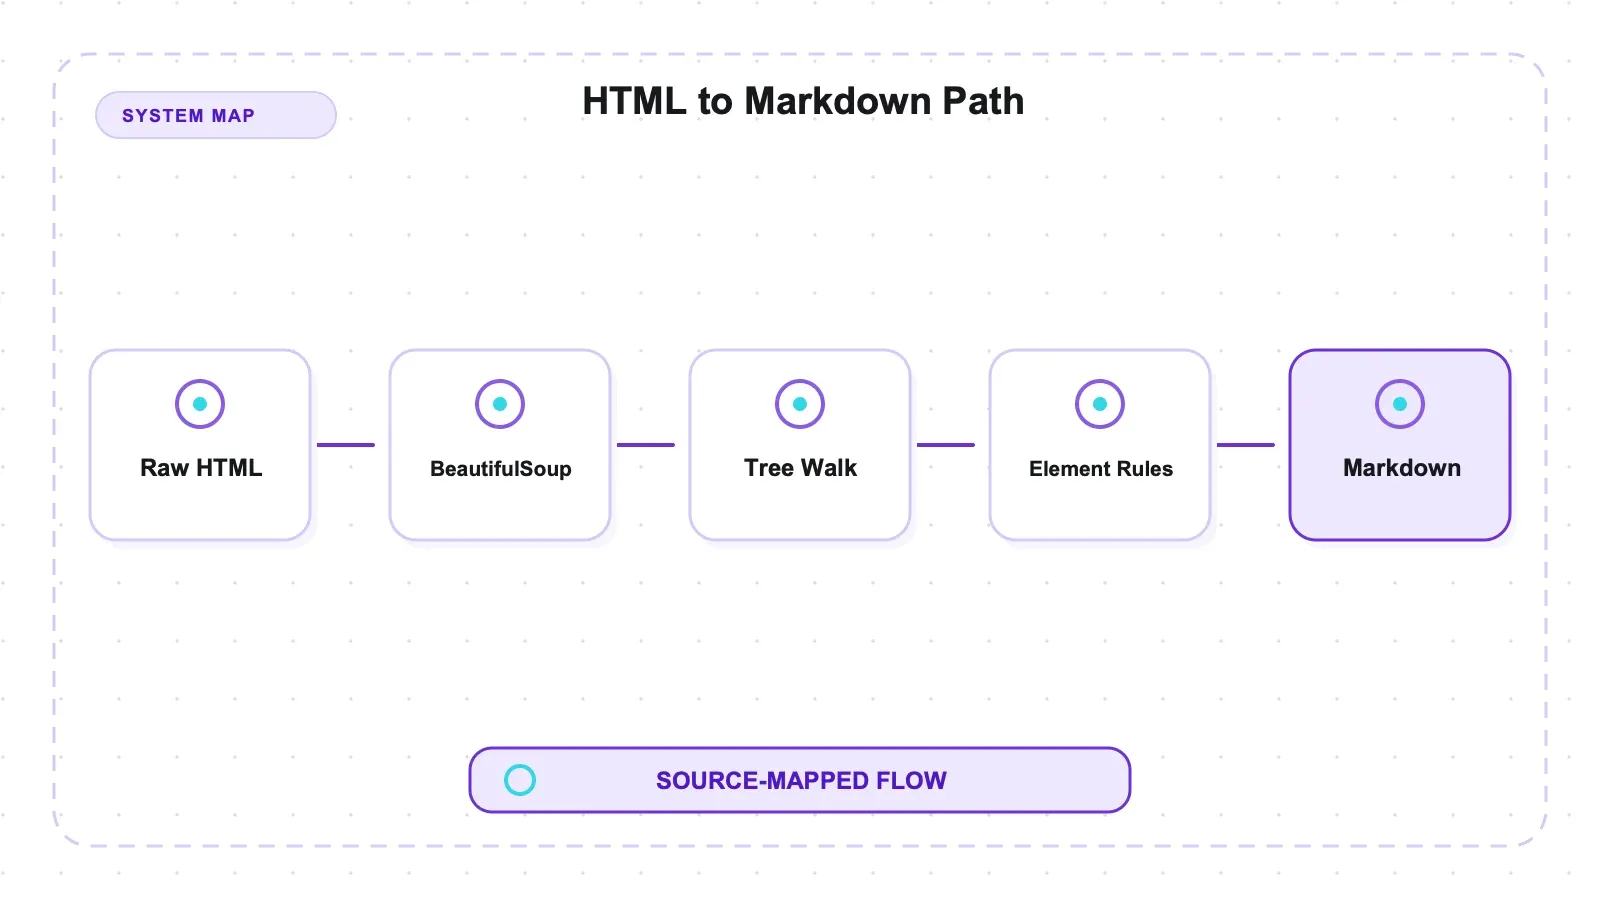
API сводится к одной функции:
from markdownify import markdownify
md = markdownify(html)
Есть и вариант в виде класса (MarkdownConverter), если нужно переопределять обработку элементов, а также хороший набор опций — стиль заголовков, маркеры списка, определение языка кода, исключение элементов. Но чаще всего используется именно однострочный вызов, и он работает.
pip install markdownify подтягивает 5 пакетов и занимает 1,8 МиБ, а при холодном импорте укладывается в 0,046 с — это самый быстрый результат среди трёх протестированных конвертеров. Зависимости — BeautifulSoup и его обычные спутники, которые уже есть во многих Python-проектах, поэтому дополнительная цена часто почти нулевая.
Методика измерения
Я запускал его на четырёх HTML-образцах, которые в этом наборе уже использовались для markitdown, вместе с предзаданными контрольными строками — 16 точных текстовых фрагментов внутри страницы, которые проверялись на сохранность, плюс проверки служебной разметки страницы. Пятый образец, Nothing but tables, — это отдельный тест с упором на таблицы; он не входит в сводный результат по четырём образцам ниже.
| Конвертер | Проверки текста | Длина вывода | Токены (o200k) | Строки Markdown-таблиц | Ссылки |
|---|---|---|---|---|---|
| markdownify | 16/16 | 76,868 | 21,062 | 36 | 599 |
| html2text | 16/16 | 76,452 | 21,176 | 32 | 545 |
| markitdown | 16/16 | 76,995 | 21,336 | 36 | 598 |
| turndown | 16/16 | 95,188 | 26,236 | 0 | 611 |
fourway-scores.json. Четыре образца, токены считались по o200k_base, строки таблиц — по одному и тому же правилу для всех четырёх, включая повторный подсчёт сохранённого вывода markitdown, который точно совпал с опубликованным значением.
Здесь бросаются в глаза три вещи.
По числу выведенных строк таблиц он сравнялся с markitdown. По 36 строк на четырёх общих образцах, посчитанных одной и той же эвристикой. Это не доказывает посимвольную идентичность ячеек; это лишь означает, что оба вывода показывали одинаковое число распознаваемых строк Markdown-таблиц по этому счётчику.
У него самый низкий token count. 21 062 — чуть ниже 21 176 у html2text и 21 336 у markitdown, и на 19,7% ниже 26 236 у turndown. Первые три отличаются друг от друга менее чем на 1,3%, так что я бы назвал это скорее ничьей, чем победой; важный разрыв — именно с turndown.
Все контрольные строки сохранились. Все 16. У остальных трёх — тоже, так что в сохранности текста эти библиотеки почти не различаются.
Таблица, где он показывает себя лучше
Образец со статистикой хоккея — место, где конвертеры расходятся. markdownify:
| Team Name | Year | Wins | Losses | OT Losses | Win % | ... |
| --- | --- | --- | --- | --- | --- | --- |
| Boston Bruins | 1990 | 44 | 24 |  | 0.55 | ... |
Обычный GFM-формат с ведущими и завершающими вертикальными чертами, строкой-разделителем и — обратите внимание на пустую ячейку между 24 и 0.55 — он сохраняет пустую ячейку вместо того, чтобы пропускать её. Звучит как мелочь, но это не так: конвертер, который выбрасывает пустые ячейки, сдвигает все последующие значения в неверный столбец, и при этом таблица по виду остаётся корректной.
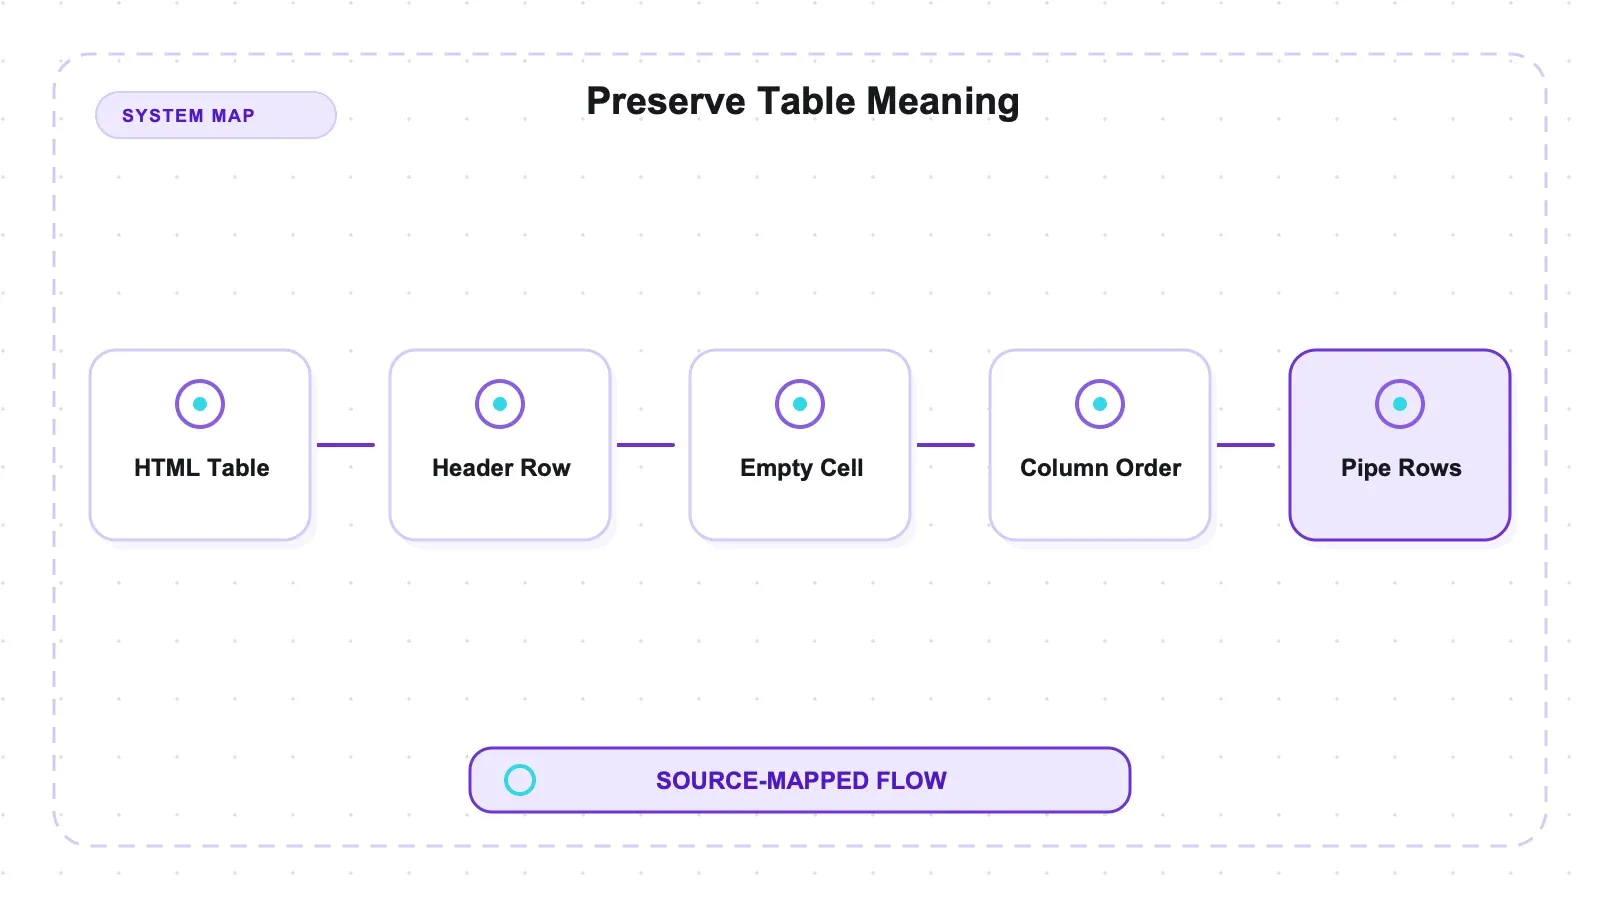
turndown на том же входе превращает все значения в отдельные абзацы без какой-либо структуры столбцов. html2text, в свою очередь, тоже строит корректную таблицу, но в другом стиле — без внешних вертикальных черт.
Если Markdown дальше пойдёт в модель, именно вертикальные черты и сохранённая пустая ячейка позволяют ответить на вопрос «сколько матчей Boston проиграли», а не гадать.
Две вещи, которые он удаляет, а turndown — нет
Сохранность таблиц — заметная разница. Но есть ещё более важная, и о ней почти никто не говорит.
markdownify удаляет содержимое <script> и <style>. turndown — нет. Если считать по маркерам, встречающимся только внутри этих элементов, то у markdownify по всем образцам нулевое число script-маркеров и нулевое число style-маркеров; у turndown — 10 и 84. На образце Wikipedia разница между 59 561 символом и 74 939 — и восемь строк встроенного JavaScript-конфига и CSS MediaWiki дают 14 644 символа, то есть 95% этого разрыва (script-style-stripping.json).
Для всего, что подаётся в модель, это самая дорогая часть сравнения: blob с JavaScript-конфигом расходует токены и вообще не несёт полезной информации. markdownify удаляет его без дополнительных указаний. html2text — тоже.
По каждому образцу markdownify и html2text совпадают там, где таблица простая, и расходятся там, где она нетривиальна:
| Образец | markdownify | html2text |
|---|---|---|
| Статистика хоккея | 27 строк | 27 строк |
| Wikipedia | 9 строк | 5 строк |
| Nothing but tables (отдельный тест) | 62 строки | 59 строк |
markdownify распознаёт больше строк в обоих сравнительных тестах. Особенно на Wikipedia он сохраняет девять строк там, где html2text по этому счётчику оставляет пять. Это полезный сигнал: перед выбором стоит проверить реальные вложенные и неровные таблицы, но это не доказательство того, что каждая выведенная ячейка семантически корректна.
Установка и лицензия рядом с альтернативами
| Библиотека | Пакеты | Объём на диске | Холодный импорт | Лицензия | Звёзды | Последний релиз |
|---|---|---|---|---|---|---|
| markdownify | 5 | 1,8 МиБ | 0,046 с | MIT | 2 235 | 2026-06-30 |
| html2text | 1 | 0,2 МиБ | 0,077 с | GPL-3.0-or-later | 2 168 | 2025-04-15 |
| turndown | 3 (npm) | 8,8 МиБ | 0,056 с | MIT | 11 386 | 2026-04-03 |
Официальная страница: markdownify на PyPI.
install-and-import.json и metadata-snapshot.json. Каждая библиотека ставилась в отдельное пустое окружение.
html2text почти в девять раз меньше на диске, но у него лицензия GPL-3.0-or-later. Для продукта, который вы распространяете, это вопрос для того, кто отвечает за лицензирование; статья не является юридической консультацией. У markdownify лицензия MIT, обычно более мягкая, но её всё равно нужно проверять в рамках стандартного compliance-review.
И 1,8 МиБ — это ещё и довольно условная величина, если ваш проект уже использует BeautifulSoup, а таких Python-проектов среди парсеров очень много; в таком случае markdownify почти бесплатен.
У markdownify самая здоровая динамика релизов из трёх: 44 релиза и обновление за шесть недель до теста, тогда как у html2text последний релиз был в апреле 2025 года.
Что на самом деле даёт одна строка Python
Вся библиотека — это markdownify(html), и полезно прямо сказать, что именно этот вызов решает за вас, потому что три из этих решений и определили результат сравнения.
Он парсит через BeautifulSoup, удаляет <script> и <style> без дополнительных просьб и выводит таблицы в стиле GFM — с внешними вертикальными чертами и сохранёнными пустыми ячейками. Но одна лишь репутация парсера не гарантирует поведение на битом HTML, поэтому этот вопрос отдельно измеряется ниже.
Ни один из этих пунктов не является опцией, которую вы настраиваете. Это поведение по умолчанию, и в категории, где стандартное поведение turndown оставляет JavaScript, а html2text по умолчанию жёстко переносит строки на 78 символах, библиотека, которой не нужно править результат после запуска, уже сама по себе чего-то стоит.
Если нужно, опции есть — heading_style, bullets, code_language, strip и convert для allowlist/denylist элементов, а также MarkdownConverter для переопределения логики поэлементно. Всё, что измерялось здесь, не использовало ничего из этого.
Память и то, что делает с ней битый HTML
Более широкий стресс-тест описан в сравнении памяти и битого HTML для десяти библиотек.
Два пункта, которые в этой серии обзоров были помечены как не протестированные, теперь измерены.
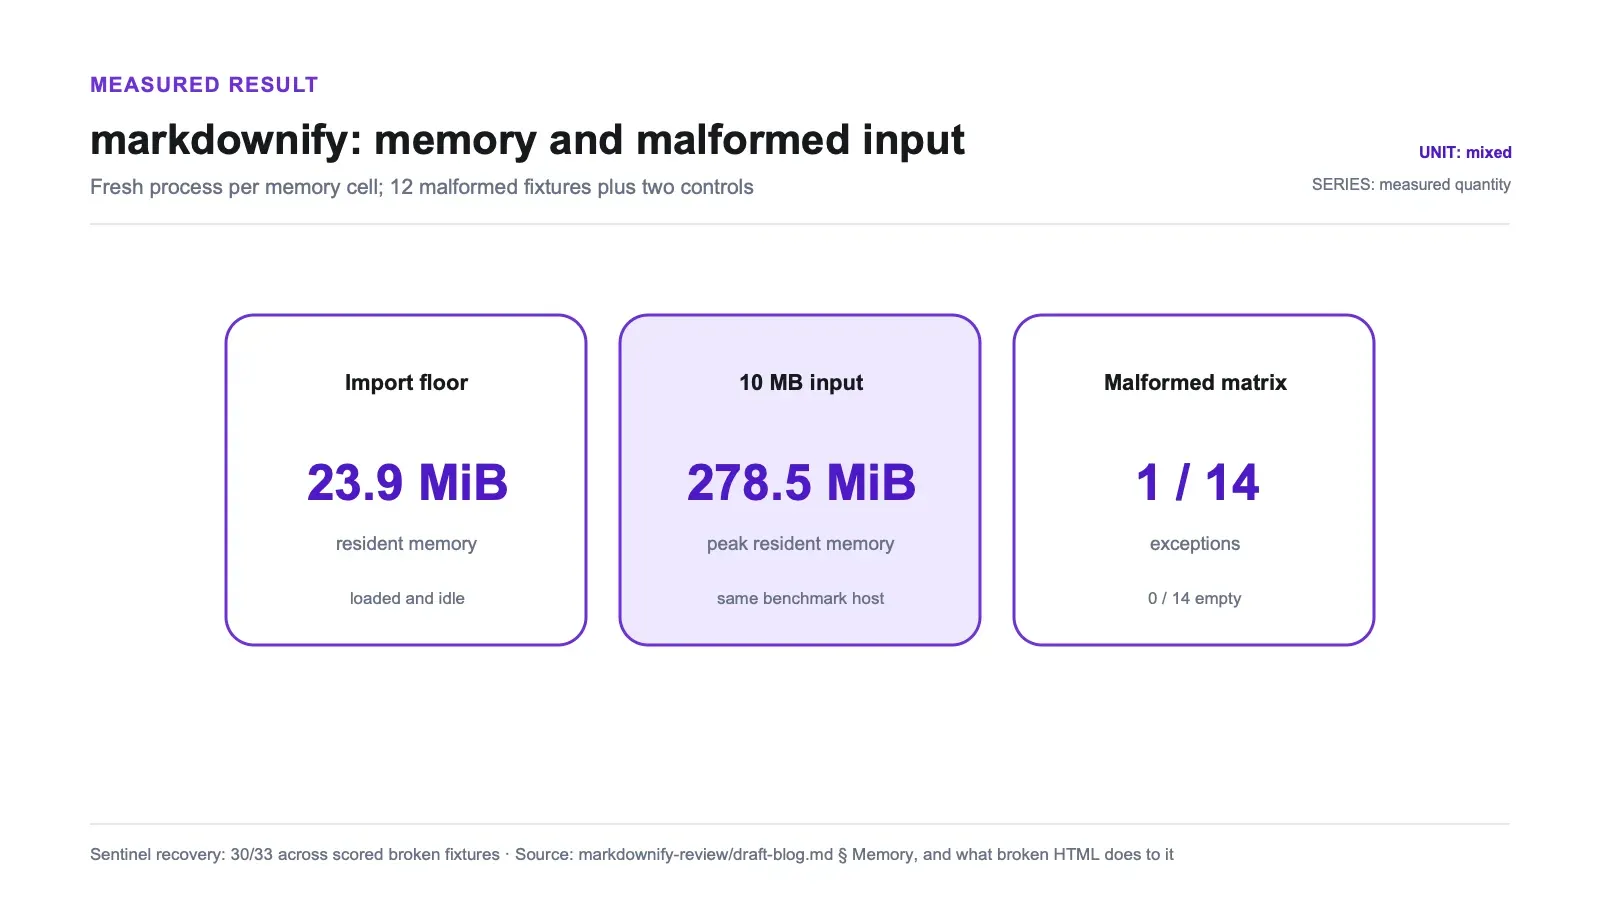
Пиковая resident memory, через /usr/bin/time -l, по одному новому процессу на каждую ячейку — нижняя граница импорта показывает, сколько библиотека стоит в загруженном и простаивающем состоянии, а пики включают сам документ.
| Библиотека | Runtime | Нижняя граница импорта | Пик при 226 KB | Пик при 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Базовые показатели Python и Node нельзя напрямую сравнивать между собой; интерпретатор входит в оба замера.
markdownify находится посередине: нижняя граница 23,9 МиБ и 278,5 МиБ на документе размером 10 MB. Это в 3,9 раза больше пика html2text и примерно в десять раз меньше, чем у turndown — плата за использование BeautifulSoup внутри.
Битый HTML. Двенадцать документов, каждый ломает ровно одну вещь — незакрытые теги, неправильная вложенность inline-элементов, атрибуты без кавычек и пробелами, лишние закрывающие теги, отсутствие <html> вообще, дубликаты атрибутов, обрыв документа посреди тега, плохие сущности, незакрытый <script>, «лживое» объявление кодировки, комментарий с разметкой и 600 уровней вложенности — плюс два корректных контрольных образца одинакового размера, потому что фраза «ничего не вернул» говорит о битости только если на чистом документе того же размера библиотека тоже молчит.
markdownify выбросил исключение на 1 из 14 и не вернул ничего на 0, восстановив 30/33 контрольных маркера на битых образцах (malformed-results.json). Один образец не входит в этот счёт: по HTML5 всё, что идёт после незакрытого <script>, действительно считается содержимым script, поэтому его потеря там корректна, а вот восстановление было бы отклонением.
Плюсы и минусы
Сильные стороны. Сохранность таблиц на уровне markitdown, посчитанная тем же правилом. Самый низкий token count из четырёх. MIT. 1,8 МиБ, а если BeautifulSoup уже есть в дереве зависимостей, то прирост почти нулевой. Самый быстрый холодный импорт — 0,046 с. Активно выпускаются новые версии. Сохраняет пустые ячейки таблиц. Переопределяемая поэлементная конвертация через MarkdownConverter. Простой однострочный вызов — именно тот, что нужен.
Слабые стороны. Завязан на BeautifulSoup, поэтому занимает в девять раз больше места на диске, чем html2text, если BeautifulSoup у вас ещё нет. 2 235 звёзд — это сообщество меньше, чем у turndown, значит, будет меньше готовых примеров, когда вы наткнётесь на нестандартный случай. Только Python, так что в Node-стеке он не поможет. И 42 открытых issue.
Кому он подходит, а кому — нет
Начните с markdownify для Python-задач, похожих на эти образцы. Он сравнялся с markitdown по числу выведенных строк таблиц в этом счётчике, попал в группу с самым низким потреблением токенов и имеет MIT-лицензию. Если BeautifulSoup у вас уже используется, дополнительный объём установки может быть совсем небольшим; проверьте реальную разницу зависимостей именно в своей среде.
Рассмотрите html2text, если бюджет зависимостей измеряется сотнями килобайт и форма его вывода подходит для ваших страниц. Перед распространением обязательно проверьте GPL-3.0-or-later с тем, кто отвечает за лицензирование.
Рассмотрите markitdown, если вы уже конвертируете PDF или Office-документы. В этом тесте по HTML у них совпало число выведенных строк таблиц, но более широкая полнота результата не была показана как эквивалентная.
Пропустите его в Node — там естественный выбор это turndown, причём вместе с turndown-plugin-gfm, потому что сам turndown таблицы вообще не выводит.
Где здесь уместен managed API
markdownify преобразует HTML, который у вас уже есть. Он не скачивает страницы, не рендерит JavaScript, не обходит anti-bot-защиту — ни один из четырёх конвертеров этого не делает, а на многих реальных сайтах именно это и есть самая сложная часть.
Для тех же образцов по всем пяти конвертерам смотрите сравнение HTML-to-Markdown в пяти вариантах.
Наш собственный developer stack в Thunderbit закрывает эту upstream-задачу: POST /distill получает URL и возвращает Markdown, а POST /extract возвращает JSON в виде схемы. Оба варианта доступны через MCP-сервер и CLI; цены указаны на странице тарифов Thunderbit. Эти хостed-endpoints не сравнивались с локальными конвертерами в этом бенчмарке, так что речь здесь о различии категорий, а не о сравнении производительности.
Честная формулировка такая: если HTML у вас уже есть и нужен Markdown, markdownify бесплатен и справляется не хуже остальных здесь. Если страницы ещё нужно получать, или вам нужны именно строки таблицы, а не связный текст, это уже другой продукт.
По более широкому рынку наш обзор API для web scraping покрывает hosted-варианты, а open-source scraper pillar — self-hosted решения. Практический разбор: Преобразование HTML в Markdown в Python.
Попробуйте Thunderbit для извлечения веб-данных
Стоит ли использовать markdownify?
Для Python — да, это сильный кандидат, если ваши входные данные похожи на эти образцы; проверьте его на собственных таблицах и битых страницах, прежде чем делать его значением по умолчанию.
Он сравнялся с markitdown по числу выведенных строк таблиц, попал в группу с самым низким потреблением токенов, в этом прогоне быстрее всех импортировался и имеет MIT-лицензию. С другой стороны, он использовал больше памяти, чем html2text, работает только в Python и дал исключение на одном из тестов с битым HTML. Объём на диске и лицензия — это дополнительные критерии выбора, а не единственные аргументы.
Меня особенно удивляет число звёзд. У turndown внимания в пять раз больше, но из коробки он корректно обрабатывает ноль таблиц из тех, с которыми markdownify справляется правильно. Популярность в этой категории не совпадает с измеренным поведением — и именно поэтому это сравнение стоило провести.
Попробуйте Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Действительно ли markdownify так же хорош, как markitdown, для HTML? На этих четырёх образцах они оба выдали по 36 распознанных строк Markdown-таблиц, восстановили все 16 проверенных строк и показали разницу в длине вывода менее 0,2%. Но это не тест на эквивалентность на уровне ячеек или визуального рендера. Кроме того, markitdown умеет работать с PDF и Office-форматами, так что это сравнение касается только измеренных HTML-выводов.
Ему нужен BeautifulSoup? Да — это его парсер, и на него приходится большая часть из 1,8 МиБ. Если BeautifulSoup уже используется в проекте, дополнительная цена markdownify невелика. Если нет и дисковое пространство действительно важно, html2text занимает 0,2 МиБ, ставится одним пакетом, но ценой лицензии GPL-3.0-or-later.
Как он обрабатывает пустые ячейки таблицы? Он их сохраняет. В образце с пропусками в данных вывод оставляет пустую ячейку на месте, поэтому все последующие значения остаются в правильных столбцах. Конвертер, который пропускает пустые ячейки, даёт таблицу, которая всё ещё выглядит корректной, но каждое значение сдвигается на один столбец влево — и это худший вариант, потому что визуально ошибка никак не заметна.
Что лучше — функция или класс?
markdownify() — для обычного сценария. MarkdownConverter — когда нужно переопределить преобразование конкретного элемента; всё измеренное здесь использовало обычную функцию с настройками по умолчанию.
Что здесь не тестировалось? Четыре общих образца плюс один тест только на таблицы — это не репрезентативный корпус. Отдельный набор с битым HTML покрывал 12 типовых поломок и два контрольных примера, но не все возможные формы некорректной разметки. Не сравнивались вложенные списки, списки определений, сноски, математика, round-trip Markdown→HTML, эквивалентность таблиц на уровне ячеек и варианты конфигурации. Скорость преобразования тоже не сравнивалась.




