
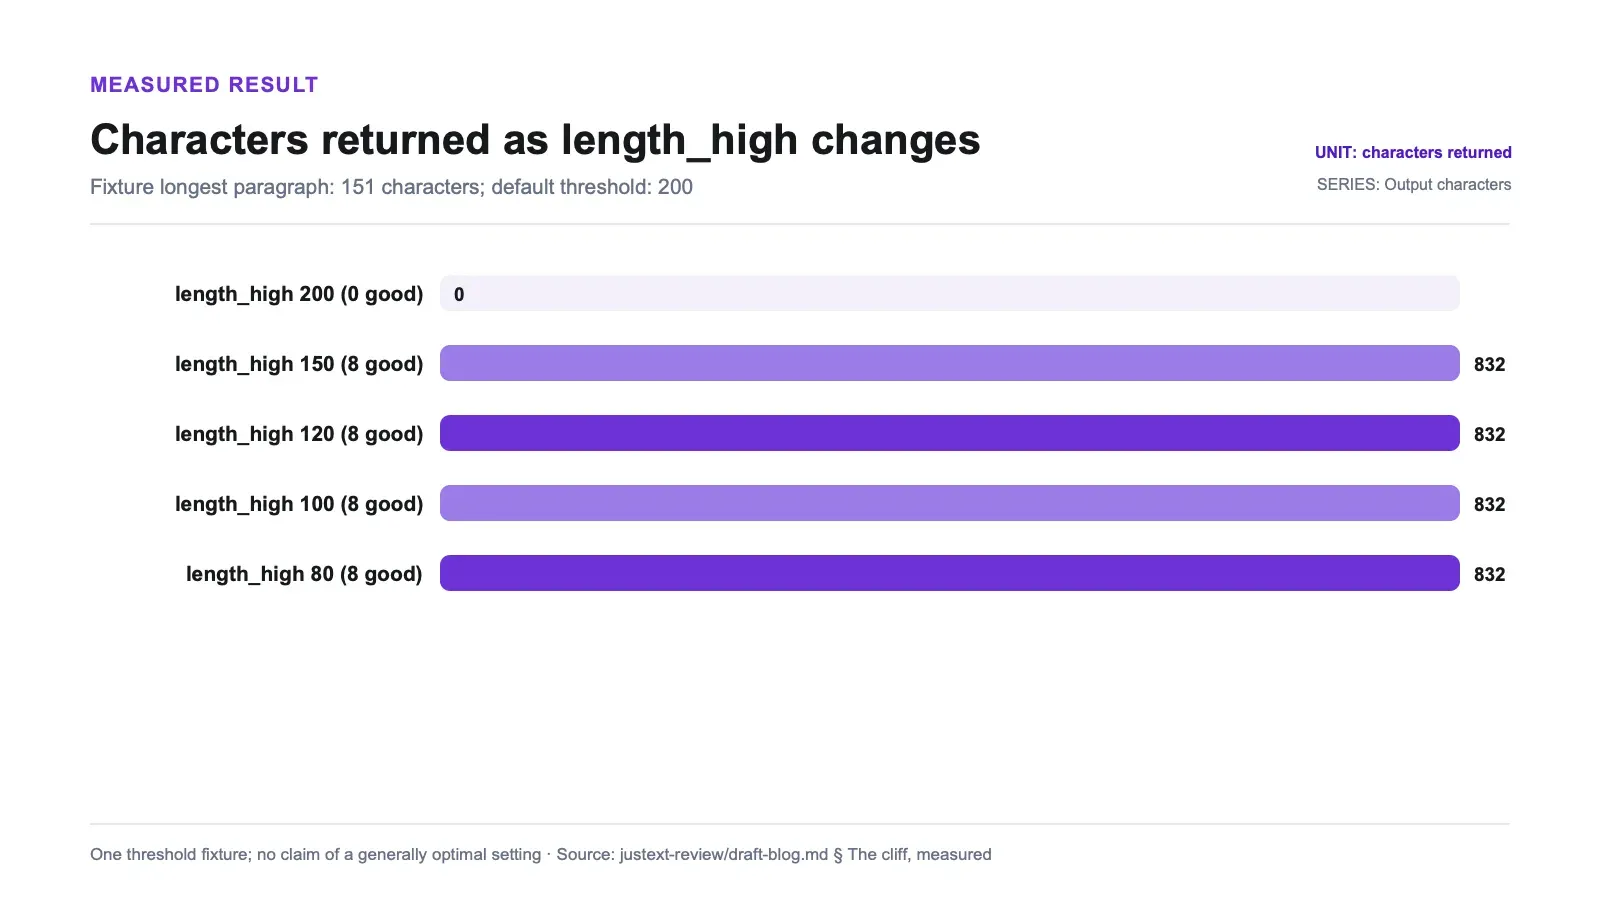
В документе, где самый длинный абзац — 151 символ, jusText с настройками по умолчанию возвращает ноль символов. Не частичный результат — а просто пустую строку. Стоит опустить один порог так, чтобы его пересёк ровно один абзац, и тот же документ уже выдаёт 832 символа. Опустите ещё ниже — и всё равно получите 832.
На этом наборе данных поведение похоже не на плавное снижение, а на резкий обрыв. Считать значение по умолчанию неудачным или нет, зависит от длины абзацев и доли шаблонного текста в вашем корпусе.
Что такое jusText и почему важна лексическая плотность
По сравнению с другими извлекателями в этом наборе тестов, jusText необычно сильно опирается на языковые списки стоп-слов. Фрагмент с высокой долей служебных слов — the, and, of, was — с большей вероятностью будет признан обычным текстом. Но этот лексический сигнал — не единственный фактор классификации: на результат также влияют длина абзаца, плотность ссылок, границы блоков, полученные из HTML, расстояние до заголовков, соседние классы и контекстный проход.
Официальный репозиторий: jusText's official repository.
Поскольку классификатор принимает языковой стоп-лист, в поставке jusText есть 100 таких списков. Именно такая явная языковая лексическая база и выделяет его в этом сравнении, хотя качество на нескольких языках здесь не тестировалось.
Проверенная версия: 3.0.2, BSD 2-Clause, 822 звезды GitHub. Python 3.14.2.
Измеренный обрыв
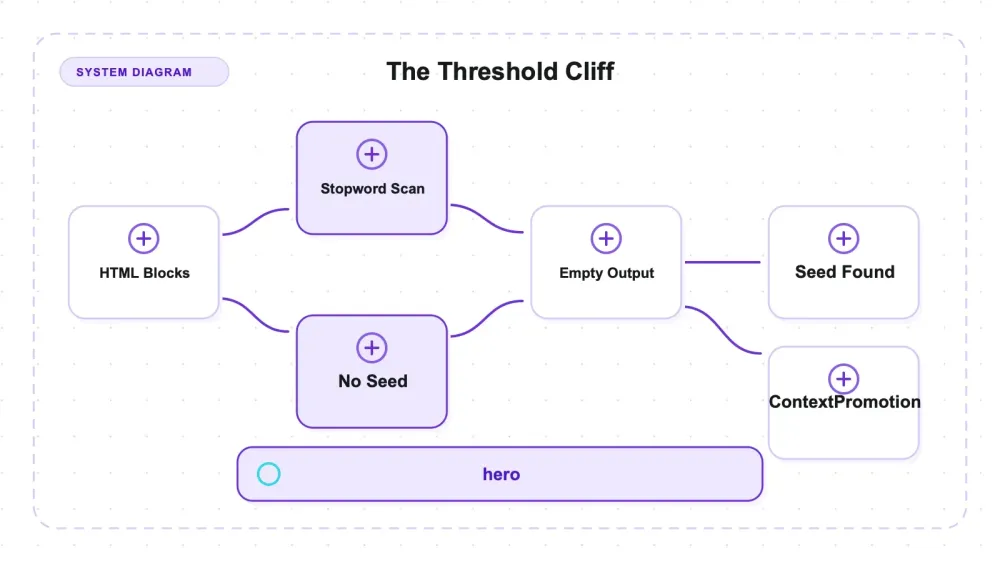
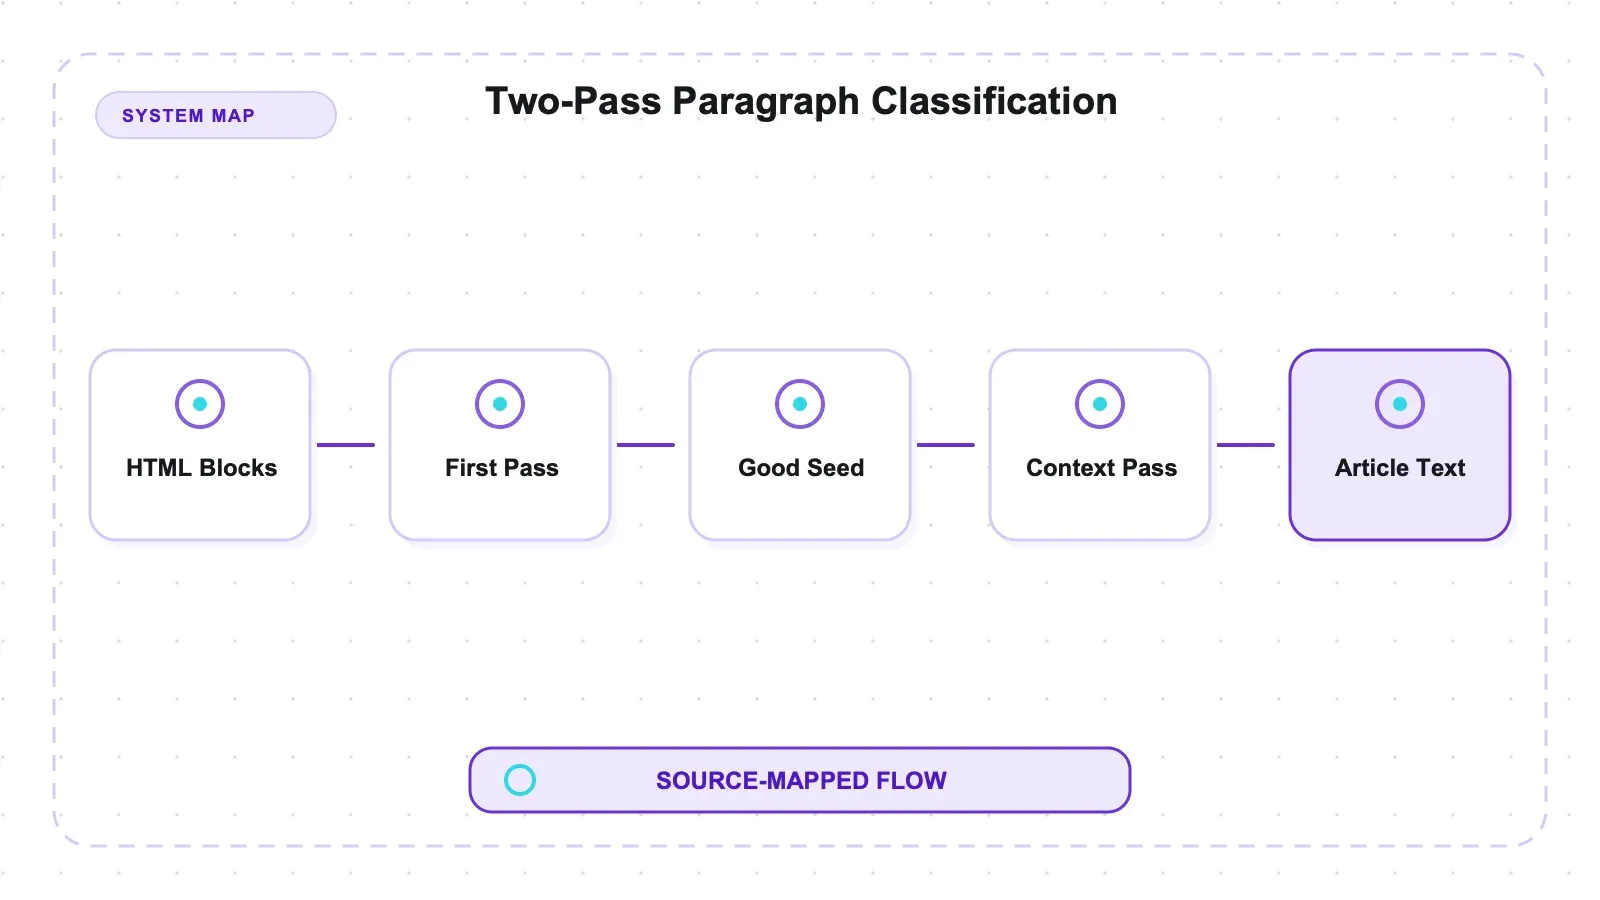
Классификатор jusText работает в два прохода. На первом, без учёта контекста, каждый абзац получает метку good, bad, short или neargood. Затем контекстный проход переводит neargood в good — но только если рядом уже есть блок с меткой good. А самостоятельную метку good абзац получает лишь тогда, когда он превышает length_high, который по умолчанию равен 200 символам.
Если в документе нет ни одного абзаца длиннее 200 символов, то нечему «запустить» продвижение, и все блоки neargood в итоге тоже уходят в шаблонный мусор. Страница возвращается пустой.
Я прогнал порог на тестовом файле, где самый длинный абзац — 151 символ:
length_high | Абзацев, отмеченных как good | Возвращено символов |
|---|---|---|
| 200 (по умолчанию) | 0 | 0 |
| 150 | 8 | 832 |
| 120 | 8 | 832 |
| 100 | 8 | 832 |
| 80 | 8 | 832 |
justext-length-threshold.json.
На этом тесте один абзац, перешагнувший порог, изменил вывод сразу для всех восьми целевых абзацев, а дальнейшее снижение уже ничего не дало. Трассировка совпадает со сценарием, где контекстный проход продвигает подходящие соседние neargood рядом с уже существующим good-блоком; это не означает, что на любой странице автоматически будет продвигаться каждый соседний блок.
Прежде чем связывать переключение именно с length_high, я перебрал length_low в четырёх значениях в сочетании с max_link_density в двух: восемь комбинаций, и все дали ноль. Изменение этих параметров не помогло извлечь текст на этом наборе.
По всему набору из 22 тестов картина такая: при length_high=200 вывод появился в 2 из 22 случаев, при 150 — в 9 из 22, при 120 — в 15 из 22.
И вот что это не означает. Это не значит, что jusText плохо извлекает текст: на реальной естественно написанной странице с настройками по умолчанию он вернул 1 190 символов чистого текста статьи, потому что обычный новостной абзац сразу проходит порог в 200 символов. И это не значит, что значение по умолчанию неправильное; это значит, что по умолчанию библиотека рассчитана на длинные абзацы, и стоит заранее понять, есть ли они в вашем корпусе.
Другая сторона этого набора: большее загрязнение при настройках по умолчанию
На этом размеченном наборе тестов при настройках по умолчанию у jusText зафиксирована самая высокая утечка шаблонного текста.
| Библиотека | Полнота извлечения статьи (все 22) | Утечка шаблонного текста | Точность по контентным токенам | Загрязняющих токенов |
|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 |
sixway-scores.json. Один набор тестов, один оценщик, и каждый блок помечен уникальным маркером, поэтому восстановление определяется точным вхождением подстроки.
47% утечки шаблонного текста и 74 загрязняющих токена — это вдвое выше уровня Readability по утечке и более чем вдвое выше по загрязнению на этом размеченном синтетическом наборе. Это диагностический результат для настроек по умолчанию, а не устойчивый рейтинг по всему продукту.
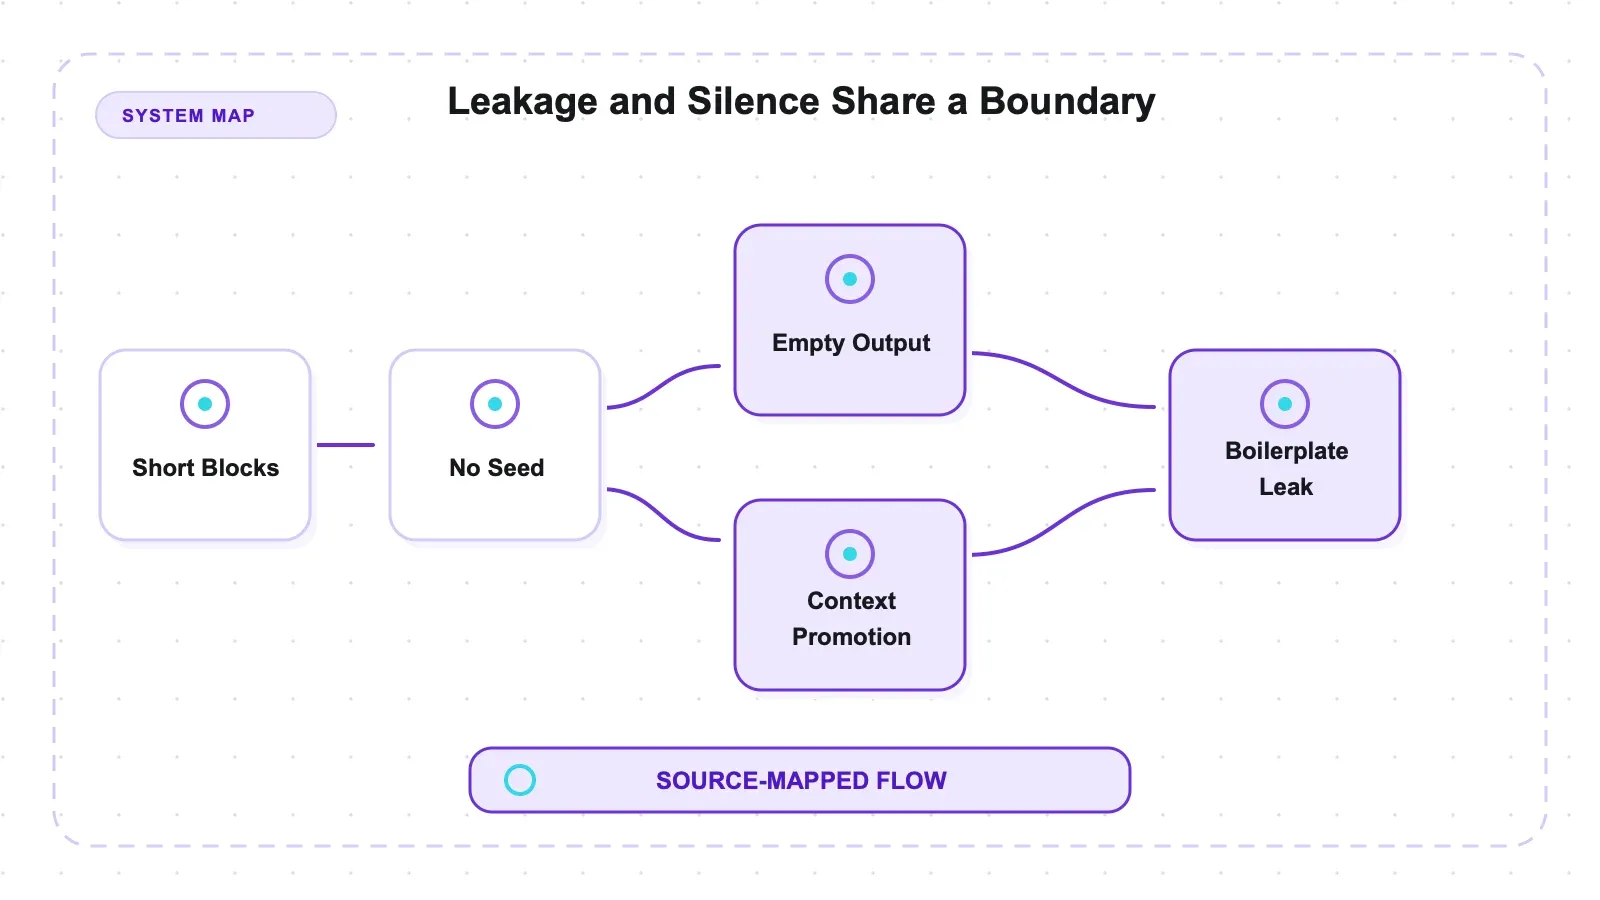
Наблюдаемая утечка согласуется с тем же контекстным проходом, который участвует и в «обрыве». Подходящие соседние блоки neargood могут быть продвинуты, если это позволяют правила по классу блока и расстоянию; поэтому текст, похожий на обычный текст, рядом со статьёй может перейти границу. Результат на этом тесте показывает, какие именно размеченные блоки утекли, а упрощённый механизм по-прежнему зависит от точных контекстных правил jusText.
Его полнота извлечения — 0.8378, третья с конца, и все потери связаны с порогом: библиотека не извлекла ничего из одной статьи длиной 129 символов, ничего со страницы из десяти коротких абзацев и ничего из почти пустого документа.
Инвентарь языковых стоп-листов
Девяносто девять других стоп-листов.
justext.get_stoplists() возвращает 100 языков. Классификатор изначально параметризован по языку, а не просто переводит английскую эвристику, и смена языка — это один аргумент:
import justext
paragraphs = justext.justext(html, justext.get_stoplist("Czech"))
text = "\n".join(p.text for p in paragraphs if not p.is_boilerplate)
trafilatura и goose3 тоже учитывают язык, но в этом обзоре ни один извлекатель не оценивался на эталонных данных не на английском. 100 встроенных стоп-листов делают jusText очевидным кандидатом для многоязычной оценки; сам по себе этот список не доказывает качество извлечения на этих языках и не показывает, что конкуренты справляются с ними хуже.
API состоит из двух функций и девяти настраиваемых констант — length_low 70, length_high 200, stopwords_low 0.30, stopwords_high 0.32, max_link_density 0.20, max_heading_distance 200, плюс обработка кодировок. Небольшой, понятный и полностью задокументированный в сигнатуре.
Установка и скорость
pip install justext подтягивает 3 пакета — меньше всех в сравнении — и занимает 22.4 MiB, меньше двух секунд.
Официальная страница: jusText on PyPI.
| Библиотека | Пакетов | site-packages | Холодный импорт | Извлечение p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Каждый пакет измерялся в отдельном пустом virtualenv.
Три пакета и 22.4 MiB — это лёгкая зависимость по меркам этого сравнения, а медиана извлечения 0.56 ms близка к 0.51 ms у trafilatura в этом стенде. Измерение окружения не раскладывает размер пакета по типам файлов, так что нельзя сказать, какая часть занимаемого места приходится на стоп-листы.
Вопрос поддержки, если говорить аккуратно
Для оценки «живости» здесь использованы два датированных показателя: дата последнего push в репозиторий и дата последнего релиза на PyPI — обе 2025-02-25. Это было за семнадцать месяцев до тестирования. Всего восемь релизов, 91 fork, 9 открытых issue, архивирования нет.
Классификаторы PyPI указывают поддержку Python вплоть до 3.9. Я запускал его на 3.14.2, и он установился, импортировался за 0.777 s и извлекал текст на 19 из 22 тестов без единого исключения.
Так что метаданные отстают от реальности на пять версий Python, а реальность такова, что библиотека работает. Вот и полезное различие: тихий репозиторий — это сигнал о поддержке, но не автоматически о работоспособности. Для библиотеки, чей алгоритм — это опубликованный метод 2011 года плюс набор словарей, состояние «всё уже сделано» вполне правдоподобно: менять там особенно нечего, а стоп-листы не «гниют» так, как антимошеннические обходы.
Что всё же означает тихий репозиторий: если вы столкнётесь с багом, чинить его придётся самостоятельно или через форк. И это стоит соотнести с девятью открытыми issue — это не профиль библиотеки, утопающей в нерешённых проблемах.
Память и то, что делает с ней сломанный HTML
Здесь отдельно измеряются два операционных вопроса.
Более широкий контекст стресс-теста — в сравнении потребления памяти и обработки битого HTML у десяти библиотек.
Пиковое резидентное потребление памяти, через /usr/bin/time -l, по одному свежему процессу на ячейку — нижняя граница импорта показывает, сколько библиотека стоит в загруженном и простаивающем виде, а пики включают документ.
| Библиотека | Среда | Нижняя граница импорта | Пик на 226 КБ | Пик на 10 МБ |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Базовые показатели Python и Node нельзя напрямую сравнивать; интерпретатор присутствует в обоих.
Нижняя граница jusText — 30.3 MiB, а пик на этом 10 МБ тесте — 431.2 MiB, то есть примерно в 14.2 раза выше нижней границы импорта и в 43.1 раза больше входа по абсолютному RSS. Один тест и один процесс не задают общую кривую масштабирования; базовые показатели Python и Node тоже остаются несопоставимыми.
Битый HTML. Двенадцать документов, в каждом из которых сломана ровно одна вещь — незакрытые теги, неправильно вложенные встроенные элементы, атрибуты со значениями без кавычек и пробелами, лишние закрывающие теги, полное отсутствие <html>, дублирующиеся атрибуты, обрезка документа посреди тега, некорректные сущности, незакрытый <script>, ложное объявление кодировки, комментарий с разметкой и 600 уровней вложенности — плюс два корректных контрольных файла сопоставимого размера, потому что фраза «ничего не вернул» говорит о проблеме с HTML только если библиотека молчит и на чистом документе того же размера.
justext выдал исключение в 0 из 14 случаев и вернул пустой результат в 13, восстановив 0/33 размеченных маркеров на битых файлах (malformed-results.json). Корректный короткий контроль тоже вернул 0 символов; корректный длинный контроль стал единственным ненулевым результатом — 1 333 символа. Все двенадцать битых тестов остались пустыми, а случай с незакрытым <script> исключён из оценки выживания маркеров. Этот набор показывает терпимость парсера — без исключения — но не позволяет приписать молчание именно битой разметке, а не уже измеренному порогу по размеру.
Плюсы и минусы
В его пользу. 100 языковых стоп-листов, и классификатор действительно построен вокруг них, а не просто переводит на них английскую эвристику. Самое маленькое число зависимостей в сравнении — 3 пакета. Медиана извлечения 0.56 ms. Девять задокументированных, понятных настраиваемых констант. BSD 2-Clause. Корректно работает на Python 3.14, несмотря на классификаторы, которые останавливаются на 3.9.
Против него. Самая высокая утечка шаблонного текста в этом синтетическом тесте при настройках по умолчанию: 47% и 74 загрязняющих токена. На коротком тесте с абзацами возвращается пустая строка, если ни один абзац не пересёк length_high. Полнота извлечения на этом наборе — 0.8378. Последний зафиксированный push в репозиторий и релиз были за семнадцать месяцев до тестирования, так что вопрос поддержки требует внимания.
Кому подойдёт и кому не подойдёт
Стоит оценить jusText, если у вас многоязычный корпус, потому что языковые стоп-листы здесь явно заданы и их много. В этом тесте было инвентаризировано 100 стоп-листов, но качество на нескольких языках не измерялось. Он также подходит, если вам важны всего три пакета в зависимостях и явные пороговые настройки.
Лучше пропустить его, если вы кормите модель данными по токенам, где 74 загрязняющих токена против нуля у goose3 и newspaper4k — это прямые издержки. Пропустите его и для страниц с короткими абзацами — карточек товаров, списков, changelog'ов, FAQ — если только вы не настроили length_high осознанно. И пропустите, если вам нужна активно сопровождаемая зависимость по требованиям комплаенса или закупок — даже если код работает, это реальное ограничение.
Если всё же используете, подбирайте length_high по размеченной валидационной выборке, а не копируйте значение по умолчанию или правило по процентилю. Переберите реалистичные пороги и измерьте и полноту извлечения статьи, и точность по шаблонному тексту; снижение порога может вернуть короткий текст, но при этом продвинуть лишние соседние блоки.
Где уместен managed API
jusText работает с HTML, который у вас уже есть, как и всё в этом сравнении. Ни одна из этих библиотек не загружает страницу, не рендерит JavaScript и не проходит антибот-защиту.
Для тех же наборов тестов по всем шести извлекателям смотрите сравнение библиотек для извлечения статьи.
Хостинг-сервис для загрузки, рендеринга и извлечения, включая наш Thunderbit, решает другой класс задач. Thunderbit здесь не бенчмаркировался. Разница здесь — между классификацией уже переданного HTML и сервисом, который сам получает URL и обрабатывает его; в статье нет сравнения качества по одной и той же метрике.
Честная формулировка такая: многоязычные стоп-листы jusText — это реальная и бесплатная возможность. Если ваша проблема — получать страницы на многих языках, а не классифицировать в них текст, вам нужен другой продукт.
Для более широкого обзора наш сводный материал по API для веб-скрапинга охватывает облачные решения, а основная статья про open-source scraper — self-hosted варианты. Если результат пойдёт в модель, преобразование HTML в Markdown в Python — это этап, на котором теряется больше всего точности.
Попробовать Thunderbit для извлечения веб-данных
Стоит ли использовать jusText?
Это хороший кандидат, если корпус многоязычный или если распределение длины абзацев выигрывает от явной настройки порогов. Перед внедрением проверьте оба фактора.
100 встроенных стоп-листов — это реальное преимущество архитектуры, но многоязычная точность здесь не проверялась. Пороговый обрыв настраивается; приемлемо ли более низкое значение, зависит от полноты и точности по шаблонному тексту, измеренных на размеченной выборке.
На этом синтетическом английском наборе при настройках по умолчанию newspaper4k не пропустил ни одной размеченной единицы шаблонного текста и восстановил 0.9865 единицы статьи. Это делает его кандидатом для сравнения на этой задаче, но не универсальной заменой.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
Почему jusText возвращает пустую строку, а не частичный результат?
У него двухпроходный классификатор. Абзац получает класс good самостоятельно только если он длиннее length_high (по умолчанию 200 символов); затем второй проход повышает соседние блоки neargood. Если ни один абзац не проходит порог, нет «запускающего» блока, и все кандидаты уходят в шаблонный мусор. Это изначально схема «всё или ничего», а не неудача частичного извлечения.
Заброшен ли jusText? Последний push в репозиторий и последний релиз на PyPI были 2025-02-25 — за семнадцать месяцев до тестирования — а в классификаторах PyPI поддержка заканчивается на Python 3.9. Но библиотека установилась и запустилась на Python 3.14.2 без исключений, а 9 открытых issue — это не огромный хвост. Смотрите на даты как на риск поддержки, а не как на доказательство поломки; практический риск в том, что баги, возможно, придётся чинить самим.
Почему он пропускает больше шаблонного текста, чем Readability? На этом наборе подходящие соседние блоки, похожие на обычный текст, пересекали границу вывода по стандартным контекстным правилам. Продвижение зависит от класса блока, расстояния и контекста, а не происходит автоматически для каждого соседа. Измеренный результат — 47% утечки шаблонных единиц и 74 загрязняющих токена при настройках по умолчанию.
Как использовать его для другого языка?
justext.justext(html, justext.get_stoplist("German")). get_stoplists() возвращает все 100 доступных списков. Стоп-лист — это языковой лексический вход для классификатора, который также использует длину абзаца, плотность ссылок, сегментацию по HTML, расстояние до заголовков и контекст соседних блоков. Это меняет языковой вход, но само по себе не доказывает качество извлечения на немецком.
Что здесь не тестировалось?
Реальные страницы — вообще не тестировались: это контролируемые наборы с разметкой единиц. Многоязычная способность, которая является главным преимуществом библиотеки, была инвентаризирована как 100 стоп-листов, но не оценивалась на неанглийском тексте. Пограничные случаи кодировок, хотя у jusText есть параметры encoding, default_encoding и enc_errors. А max_heading_distance и два порога по доле стоп-слов всё время оставались на значениях по умолчанию.




