
Когда меня спрашивают: «законно ли парсить Instagram», ответы обычно распадаются на три лагеря: «вообще можно», «точно нельзя» и «всё зависит». Полезен только третий вариант.
Путаница возникает не просто так: ответ зависит от какие данные вы собираете, где находитесь вы и люди, чьи данные обрабатываются, как вы к ним получаете доступ и зачем они вам нужны. В этой статье я разложу всё по полочкам: разберу ключевые судебные решения, объясню разницу между нарушением правил платформы и нарушением закона, сравню юрисдикции и дам практическую схему принятия решения, чтобы ты мог оценить свою ситуацию. Это не юридическая консультация — я техрайтер, а не юрист, — но после прочтения у тебя будет куда более чёткая карта местности.
Что вообще означает «парсить Instagram»?
Начнём с определения.
Парсинг Instagram — это использование программного обеспечения для автоматического сбора общедоступной информации с сайта или приложения Instagram: биографий профилей, подписей к постам, комментариев, хэштегов, числа подписчиков и метрик вовлечённости.
Это не то же самое, что использование официального Graph API Instagram, у которого есть собственные ограничения, правила доступа и сценарии использования. Парсинг не идёт через официальный API — он получает данные напрямую со страниц сайта или экранов приложения.
Типичные сценарии:
- Поиск лидов: нахождение потенциальных клиентов или инфлюенсеров по публичным профилям и паттернам вовлечённости.
- Мониторинг конкурентов: отслеживание частоты публикаций, уровня engagement и контент-стратегии конкурентов.
- Исследование рынка: анализ трендов хэштегов, тональности или географических паттернов в открытых постах.
- Академические исследования: изучение публичной дискуссии, визуальной культуры или динамики социальных сетей для диссертации или статьи.
Эта статья посвящена именно вопросу законности — а не тому, как это делать технически. Если ты хочешь понять, может ли твой конкретный сценарий привести к иску, блокировке или штрафу, читай дальше.
Законно ли парсить Instagram? Короткий ответ
Сбор общедоступных данных Instagram обычно не считается федеральным преступлением по действующей практике судов США — но «это не преступление» и «это полностью нормально» означают совершенно разные вещи.
Здесь работают три разных правовых слоя, и большая часть путаницы возникает потому, что их смешивают:
- Законы о доступе к компьютерным системам (например, американский Computer Fraud and Abuse Act, CFAA): был ли доступ к данным «несанкционированным»?
- Правила приватности (например, GDPR, CCPA): содержат ли данные персональную информацию и есть ли у вас законное основание на их обработку?
- Договор и Terms of Service: запрещают ли правила Instagram то, что вы делаете, и что будет, если вы их нарушите?
У каждого слоя свои последствия, механизмы применения и уровень риска. Один и тот же парсинг может быть допустимым по одному слою и проблемным по другому.
«Мой парсинг законен?» — схема принятия решения, которой реально можно пользоваться
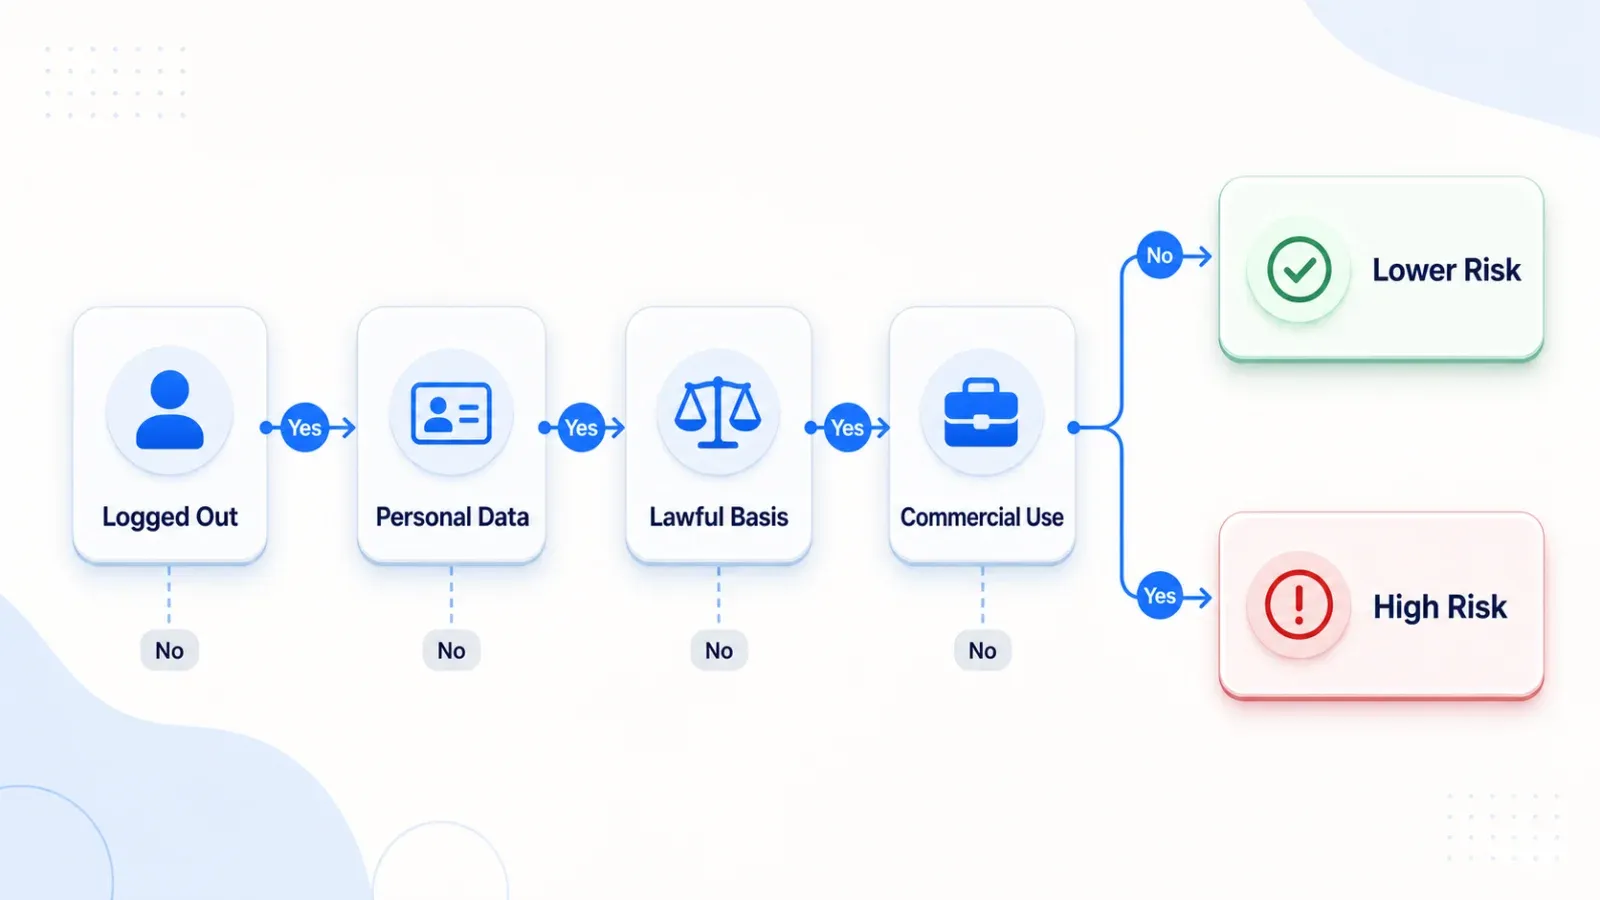
Я прочитал десятки материалов на эту тему. Везде перечисляют одни и те же юридические факторы в плотных абзацах — и почти нигде не дают способа быстро оценить свою ситуацию. Вот простое дерево решений:
| Шаг | Вопрос | Если ДА → | Если НЕТ → |
|---|---|---|---|
| 1 | Видны ли данные публично без входа в аккаунт? | Перейдите к шагу 2 | ⚠️ Высокий риск — вероятно, затрагиваются CFAA / защита доступа |
| 2 | Есть ли в данных персональная информация (имена, фото, биографии, email)? | Перейдите к шагу 3 (применяются GDPR/CCPA) | Ниже риск — переходите к шагу 4 |
| 3 | Есть ли у вас законное основание по GDPR/CCPA (legitimate interest, согласие и т. д.)? | Перейдите к шагу 4 | ⛔ Не продолжайте без консультации юриста |
| 4 | Использование коммерческое (перепродажа данных, лидогенерация, SaaS-продукт)? | Риск выше — проверьте риски по TOS и прецеденты с cease-and-desist | Риск ниже — особенно для личного или академического использования |
| 5 | Избегаете ли вы технических обходов и чрезмерного автоматизированного доступа? | Практический риск ниже | Риск для закона, платформы и аккаунта возрастает |
Это не индульгенция — это рамка для оценки рисков. Если на шаги 1, 3 и 5 ты ответил «да», а на шаг 4 — «нет», ты находишься в зоне более низкого риска. Если ты вошёл в аккаунт, собираешь персональные данные без законного основания, перепродаёшь их в коммерческих целях и игнорируешь ограничения платформы, ты просто накапливаешь риск за риском.
Для бизнес-процессов более безопасный путь — часто вообще не трогать Instagram и использовать разрешённые открытые источники: сайты компаний, лендинги авторов, страницы интернет-магазинов, каталоги или лицензированные наборы данных. Эта схема работает независимо от того, какой инструмент ты используешь.
Шаг 1: Видны ли данные публично?
Проверка через инкогнито: открой приватное окно браузера, не входя в Instagram, перейди на страницу и посмотри, что видно. Если данные доступны, значит, в практическом смысле они публичны. В американских делах вроде hiQ v. LinkedIn публично доступные данные, которые видны без входа, рассматриваются иначе, чем данные за средствами защиты доступа, если речь идёт о CFAA, — но это не универсальное разрешение.
Кроме того, Instagram со временем меняет, что видно без входа. Прежде чем считать данные общедоступными, проверь, что именно открыто сегодня.
Шаг 2: Есть ли там персональная информация?
Персональные данные по GDPR и CCPA понимаются широко: username, фото профиля, bio, email, геометки и даже выводы, сделанные на основе изображений или подписей. Если ты парсишь профили Instagram, ты почти наверняка собираешь персональные данные.
Публичная видимость не освобождает от законов о приватности — это одно из самых распространённых заблуждений в этой теме.
Шаг 3: Есть ли у вас законное основание?
Согласно статье 6 GDPR, перед обработкой персональных данных нужно иметь задокументированное законное основание. Самое часто упоминаемое основание для парсинга — «legitimate interest», но оно требует формальной проверки баланса: ваш интерес против прав субъекта данных. Согласие — ещё один вариант, но для масштабного парсинга он практически неудобен.
По CCPA у жителей Калифорнии есть права в отношении их персональных данных, включая право знать, удалять и отказаться от продажи/передачи данных. Если вы — бизнес, подпадающий под закон, и собираете данные жителей Калифорнии, эти обязанности на вас распространяются.
Нет законного основания + есть персональные данные = остановитесь и обратитесь к юристу.
Шаг 4: Использование коммерческое?
Коммерческое применение — перепродажа датасетов, создание лидогенерационного продукта, питание SaaS-инструмента — сильнее всего привлекает внимание Meta. Личные проекты и академические исследования обычно несут меньший практический риск, хотя нулевым он не становится.
Шаг 5: Уважаете ли вы rate limits и ограничения платформы?
Не обходите CAPTCHA, login walls, антибот-защиту и ограничения аккаунта. Даже если данные выглядят публичными, агрессивный автоматизированный доступ повышает риск санкций со стороны платформы, по договору, по приватности и на операционном уровне.
Публичные vs. частные данные: самая важная граница
Всё упирается в одно различие: публичные данные против закрытых.
| Обычно ниже риск при парсинге | Не парсить |
|---|---|
| Публичные биографии профилей, отображаемые имена | Посты и сторис закрытых аккаунтов |
| Публичные подписи к постам и комментарии | Прямые сообщения (DM) |
| Публичное использование хэштегов | Контент за login wall |
| Публичные метрики вовлечённости (лайки, число комментариев) | Данные из фейковых/купленных аккаунтов |
| Публичные фото профиля (с оговорками по приватности) | Списки подписчиков в больших объёмах (серая зона) |
Серых зон много. Списки подписчиков/подписок, геометки и аккаунты детей находятся в юридически неоднозначной зоне. Даже если технически они видимы, массовый сбор может вызвать вопросы по приватности или санкции со стороны платформы. Если сомневаешься, лучше не собирать.
Логика американского права о доступе к компьютерным системам здесь основана на делах вроде hiQ v. LinkedIn, но важно не расширять смысл слишком далеко: речь идёт об авторизации доступа по CFAA, а не о том, что любой публичный профиль в соцсети можно свободно собирать и переиспользовать. Законы о приватности вроде GDPR работают по другой модели.
Нарушение TOS vs. уголовная ответственность: главное заблуждение о парсинге Instagram
Скажу прямо:
Нарушение Terms of Service Instagram — это не преступление.
В Terms of Use Instagram сказано, что пользователи не могут создавать аккаунты или получать/собирать информацию неавторизованными способами, включая автоматический сбор без явного разрешения Instagram. В Automated Data Collection Terms Meta также требует явного письменного разрешения.
Это договорные правила — соглашение между вами и Instagram. Их нарушение может привести к бану аккаунта и, в крайних случаях, к гражданскому иску. Но это не уголовный закон.
Вот упрощённая иерархия права:
| Правовой слой | Что это | Последствие нарушения |
|---|---|---|
| Договорное право (TOS) | Соглашение между вами и Instagram | Бан аккаунта, гражданский иск за нарушение договора |
| Законодательное право (CFAA) | Федеральный закон о доступе к компьютерным системам | Потенциальная уголовная ответственность — но после Van Buren v. US (2021) она существенно сузилась |
| Регуляторное право (GDPR/CCPA) | Нормы о приватности | Штрафы до 4% мирового оборота (GDPR); различные санкции по CCPA |
Вот ключевое отличие: правило платформы может создать риск бана аккаунта и гражданско-правовой ответственности, но не превращается автоматически в статью об компьютерном преступлении.
Нюанс важен, потому что Meta v. Bright Data (январь 2024) закончился в пользу Bright Data по теории нарушения договора в части лог-аута и парсинга публичных данных Facebook и Instagram. Но это решение узкое: выход из аккаунта, публичные данные, конкретная фактура и один федеральный суд США. Оно не легализовало парсинг за логином, сбор через фейковые аккаунты, обработку приватных данных, нарушение законов о приватности или любое коммерческое переиспользование данных Instagram.
Что на самом деле происходит, если парсить Instagram: матрица рисков
Люди постоянно спрашивают: «Может ли Instagram подать на меня в суд?» и «Заблокируют ли мой аккаунт?». Вот честный разбор:
| Последствие | Что происходит | Тяжесть | Вероятность |
|---|---|---|---|
| Блокировка/заморозка аккаунта | Обычно сразу, как правило без апелляции | Низкая-средняя | ВЫСОКАЯ при агрессивном парсинге |
| Письмо cease & desist | Юридическое уведомление от юристов Meta | Средняя (нужны расходы на ответ) | СРЕДНЯЯ при коммерческом использовании |
| Гражданский иск (нарушение TOS) | Требование убытков, судебный запрет | Высокая | НИЗКАЯ (обычно для больших объёмов/коммерческих операций) |
| Уголовное преследование по CFAA | Уголовные обвинения | Очень высокая | ОЧЕНЬ НИЗКАЯ (после Van Buren существенно сузилась) |
| Штраф GDPR | До 4% мирового дохода | Очень высокая | НИЗКАЯ-СРЕДНЯЯ при сборе персональных данных граждан ЕС |
Наиболее вероятные последствия — ограничения аккаунта и письма cease and desist. Лучший контроль — не технический обход, а дисциплина по объёму: не собирать данные в залогиненном или защищённом режиме, минимизировать персональные данные, документировать цель и законное основание, а где возможно — использовать официальные или согласованные каналы.
Meta заявляет на своей странице о прогрессе в области приватности, что ежедневно блокирует миллиарды подозрительных несанкционированных попыток парсинга на Facebook, Instagram и WhatsApp. Это собственное утверждение Meta, и я не могу независимо проверить это число, но оно показывает, насколько серьёзно компания относится к enforcement.
По странам: где парсинг Instagram законен?
Законность зависит от юрисдикции, и две страны не подходят к этому одинаково. Вот сравнительная таблица, которой, насколько я вижу, больше нигде нет в удобном для сканирования виде:
| Юрисдикция | Основные законы | Парсинг публичных данных | Парсинг персональных данных | Риск только по TOS | Известное дело/решение |
|---|---|---|---|---|---|
| США | CFAA, региональные аналоги CFAA | Ниже риск по CFAA для публичных данных без логина в некоторых случаях, но всё зависит от фактов | Может применяться CCPA/CPRA для подходящих компаний и жителей Калифорнии | Договорная/аккаунтная/гражданская ответственность всё ещё возможна | hiQ v. LinkedIn (2022), Van Buren v. US (2021), Meta v. Bright Data (2024) |
| ЕС | GDPR, Database Directive | Ниже риск по приватности, если персональные данные не затрагиваются; другие права всё равно могут иметь значение | Требуется законное основание по ст. 6 | Договорное и платформенное enforcement всё ещё важны | Применение GDPR; риск по специальным категориям данных в изображениях/биографиях |
| Великобритания | UK GDPR, DPA 2018 | Похоже на ЕС | Требуется законное основание; руководство ICO обновлено в апреле 2026 | Договорное и платформенное enforcement всё ещё важны | Документы и рекомендации ICO |
| Канада | PIPEDA, провинциальные законы | Ниже риск, если персональная информация не затрагивается | Могут применяться согласие и другие privacy-обязанности | Договорное и платформенное enforcement всё ещё важны | Мало прецедентов именно по парсингу |
| Бразилия | LGPD | Ниже риск, если персональные данные не затрагиваются | Требуется правовое основание | Договорное и платформенное enforcement всё ещё важны | Развивающееся enforcement; крупных дел о парсинге пока нет |
| Австралия | Privacy Act 1988 | Ниже риск, если персональная информация не затрагивается | Могут применяться Australian Privacy Principles (APPs) | Договорное и платформенное enforcement всё ещё важны | Мало прецедентов именно по парсингу |
Во всех шести юрисдикциях прослеживается одна и та же закономерность. Самый низкий риск — парсить неперсональные публичные данные. Как только в дело входят персональные данные, включаются законы о приватности — и аргумент «это было видно публично» не является защитой по GDPR, UK GDPR или LGPD. Это фактор, но не самостоятельное законное основание.
Для тех, кто думает о residency данных и трансграничном сборе: место сбора, обработки и хранения данных может иметь значение. Если ты используешь сторонний инструмент или подрядчика для разрешённых открытых источников, проверь регион, сроки хранения и privacy-настройки, прежде чем собирать персональные данные.
Ключевые юридические вехи, повлиявшие на риск парсинга Instagram
Несколько правовых и продуктовых вех объясняют, почему ответ до сих пор остаётся неоднозначным:
- 2017: hiQ v. LinkedIn — окружной суд выносит предварительный запрет, не позволяя LinkedIn блокировать парсинг публичных профилей hiQ. Первое крупное американское решение в пользу парсинга публичных данных.
- 2018: GDPR вступает в силу в ЕС и задаёт самый полный в мире режим защиты персональных данных.
- 2020: CCPA начинает действовать в Калифорнии. Meta подаёт иск Meta v. BrandTotal, направленный против парсинга данных Facebook.
- 2021: Van Buren v. United States — Верховный суд США сужает трактовку CFAA в части «превышения авторизованного доступа». Это переломный момент для права о парсинге.
- 2022: hiQ v. LinkedIn — 9-й округ выносит финальное решение, подтверждающее, что парсинг публичных данных не нарушает CFAA.
- 2024: Meta v. Bright Data — Северный округ Калифорнии решает, что Terms Facebook/Instagram не запрещали Bright Data собирать публичные данные в режиме logged-off. Решение узкое, но важное.
- 2024 и далее: Meta продолжает публичное enforcement против парсинга. На странице о прогрессе в области приватности компания пишет, что ежедневно блокирует миллиарды подозрительных попыток несанкционированного парсинга на Facebook, Instagram и WhatsApp. Воспринимай это как заявление самой Meta, а не как независимо подтверждённый бенчмарк.
Как Van Buren v. US изменил подход к парсингу публичных данных
До Van Buren существовал реальный аргумент, что парсинг любого сайта вопреки его желанию может считаться федеральным преступлением по CFAA. Формулировка закона о «превышении авторизованного доступа» была достаточно широкой, и некоторые прокуроры и истцы пытались растянуть её до нарушения TOS.
Верховный суд это остановил. В Van Buren суд предложил рамку «gates up vs. gates down»: CFAA применяется, когда кто-то обходит технологический барьер доступа (например, login wall или пароль), а не когда он просто получает доступ к информации, которая и так свободно доступна, но не нравится владельцу сайта.
Для парсинга практическое значение очень велико. Если данные находятся за login wall или другим контролем доступа, риск по CFAA резко возрастает. Если данные находятся на публичной странице, которую любой может открыть в инкогнито-браузере, аргумент по CFAA обычно слабее, хотя риски по приватности, договору, IP и enforcement платформы никуда не исчезают.
Большинство конкурирующих материалов ссылаются на hiQ, но недостаточно объясняют Van Buren. Эти решения дополняют друг друга, и Van Buren в каком-то смысле даже важнее, потому что это решение Верховного суда с общенациональным авторитетом, а не решение окружного апелляционного суда.
Как Meta выстраивает enforcement
Meta не стоит на месте. По её собственным публичным заявлениям, инструменты enforcement включают:
- Ограничения по частоте и объёму данных для снижения автоматизированного сбора.
- Обнаружение паттернов необычного поведения при сборе данных.
- Ограничение или отключение аккаунтов, если Meta считает, что автоматизация нарушает её правила.
- Письма cease and desist, иски и запросы на удаление для высокообъёмного или коммерческого парсинга.
Даже если тебя волнует только юридический риск, enforcement платформы имеет значение. Публичная позиция Meta ясна: автоматизированный сбор данных с её платформ без разрешения нарушает правила, и компания вкладывает серьёзные ресурсы в борьбу с этим.
Парсинг Instagram для академических исследований: что нужно знать студентам и исследователям
Аспиранты и академические исследователи находятся в отдельной категории риска — обычно ниже, чем коммерческая перепродажа данных, но не на нуле.
Ниже риск, чем при коммерческом парсинге? Да. Автоматически освобождает от ответственности? Нет.
Анализ fair use для данных Instagram
В США доктрина fair use (17 U.S.C. § 107) учитывает четыре фактора:
- Цель и характер использования: некоммерческое, образовательное и трансформирующее использование обычно работает в пользу fair use. Академические исследования здесь, как правило, выглядят хорошо.
- Характер защищаемого произведения: фактические данные (число подписчиков, даты постов) защищены слабее, чем творческий контент (фото, подписи). Парсинг творческого контента рискованнее.
- Объём использования: собирать целый публичный профиль — это не то же самое, что взять несколько точек данных. Минимизируйте объём.
- Влияние на рынок: если ваше исследование не конкурирует с коммерческими продуктами Instagram, этот фактор работает в вашу пользу.
Обычно академические проекты попадают в более благоприятную часть этого анализа, но гарантий нет — особенно если ты парсишь большие объёмы творческого контента (изображения, видео, полные подписи).
Вопросы IRB
Если исследование затрагивает данные об идентифицируемых людях — а профили Instagram по определению идентифицируемы — вашему университетскому Institutional Review Board (IRB) может понадобиться проверить и одобрить план сбора данных. Это верно даже если данные общедоступны. Перед началом парсинга уточните требования у вашего IRB.
Специальные исследовательские программы платформы
Meta предлагает Content Library и API для одобренных исследователей, давая доступ к общедоступному контенту из Facebook, Instagram и Threads. Заявки рассматриваются независимо. Если ты подходишь по критериям, это более безопасный официальный путь для академических исследований Instagram.
(Примечание: инструмент Meta CrowdTangle, популярный среди исследователей, в основном уже закрыт. Content Library/API — его преемник.)
Минимизация данных для исследователей
Практические рекомендации:
- Собирай только те данные, которые нужны для твоего исследовательского вопроса. Не парси целые профили «на всякий случай».
- Как можно раньше анонимизируй датасеты — убирай usernames, размывай фото профилей, агрегируй данные вместо публикации индивидуальных записей.
- Заранее определи политику хранения: как долго ты будешь хранить данные и когда удалишь их?
- Документируй методологию и законное основание (если применим GDPR).
Для исследований вне Instagram применяй принцип data minimization: собирай только те поля, которые нужны для заявленной цели, избегай хранения лишнего сырого текста и фиксируй правила хранения и доступа.
Чек-лист с низким риском перед сбором данных Instagram
Теперь, когда правовая карта понятна, вот практический список для снижения риска:
- Собирайте только публично видимые данные. Используйте проверку через инкогнито. Если без входа вы этого не видите, не парсите.
- Никогда не обходите login walls и не используйте фейковые аккаунты. Именно здесь риск по CFAA, договору и enforcement платформы резко растёт.
- Относитесь к техническим и аккаунтным ограничениям как к знакам стоп. CAPTCHA, login walls, ограничения аккаунта и антибот-системы — это красные флаги.
- Минимизируйте сбор персональных данных. Собирайте только то, что действительно нужно. Если username не нужен, не собирайте его.
- Имейте политику хранения и удаления данных. Знайте, как долго вы храните информацию и когда удаляете её.
- Документируйте законное основание, если вы собираете персональные данные (особенно в контексте GDPR). «Legitimate interest» требует письменной оценки баланса, а не просто расплывчатого намерения.
- Используйте официальные, лицензированные, согласованные или не-Instagram-источники, если они подходят. Самый низкий риск — это часто тот сбор, который на Instagram делать вообще не нужно.
Примечание о инструментах и альтернативах
Thunderbit создан для разрешённых workflows в открытой сети вне продуктов Meta. Он не предоставляет сбор данных из Facebook, Instagram, Threads, Messenger, WhatsApp или Meta Ad Library, подключение аккаунтов или функции обхода ограничений.
Для многих бизнес-задач открытые сайты компаний, каталоги, страницы интернет-магазинов, лицензированные датасеты и другие не-Meta источники дают нужную информацию с более понятными условиями и обязанностями по приватности. Выбирайте источник, который прямо разрешает нужное использование, а затем минимизируйте объём хранимых данных.
Основные выводы
- Парсинг общедоступных данных Instagram не является автоматически незаконным по текущей практике судов США, но «не незаконно» и «безрисково» — это разные вещи.
- Важны три правовых слоя: законы о доступе к компьютерным системам (CFAA), нормы о приватности (GDPR/CCPA) и договор/Terms of Service. Не смешивайте их.
- Нарушение TOS — не преступление. Это может привести к бану аккаунта и гражданскому иску, но не к уголовному преследованию (после Van Buren).
- Законы о приватности применяются даже к публичным данным. Если ты собираешь персональную информацию, нужно законное основание — особенно по GDPR и CCPA.
- Юрисдикция имеет значение. Правовая картина заметно различается в США, ЕС, Великобритании, Канаде, Бразилии и Австралии.
- Схема принятия решения — твой лучший помощник. Прогоняй через неё каждый проект: публичный доступ → персональные данные → законное основание → сценарий использования → ограничения платформы.
- У академических исследователей риск ниже, но не нулевой. Если есть право доступа, используй Content Library/API Meta, минимизируй сбор, анонимизируй данные заранее и согласуй проект с IRB.
- Рассмотрите альтернативные источники данных. Для многих бизнес-задач открытые сайты, каталоги и страницы авторов дают всё нужное без рисков, связанных именно с Instagram. Выбирайте источник, который прямо разрешает нужное использование.
- Для высокорискового коммерческого использования консультируйтесь с юристом. Эта статья — карта, а не юридическое заключение.
Частые вопросы о законности парсинга Instagram
Может ли Instagram подать на меня в суд за парсинг публичных данных?
Meta может отправить письмо cease and desist или подать гражданский иск за нарушение Terms of Service. Однако суды США — включая решение в Meta v. Bright Data (2024) — постановили, что условия Instagram в конкретных обстоятельствах не запрещали сбор публичных данных в режиме logged-off, а Van Buren v. US (2021) существенно сузил ответственность по CFAA за доступ к общедоступной информации. Вероятность иска при небольшом, некоммерческом использовании низкая, но не нулевая — особенно если речь о коммерческих операциях.
Законно ли парсить Instagram в Европе?
Сбор общедоступных неперсональных данных обычно считается сценарием с меньшим риском для приватности, но данные Instagram часто содержат персональные данные. Если персональные данные есть, тебе нужно законное основание по статье 6 GDPR — например, legitimate interest с документированной проверкой баланса. Штрафы за несоблюдение могут достигать 4% мирового годового оборота. Руководство ICO (обновлено в апреле 2026) требует от организаций определить и зафиксировать законное основание до начала обработки.
Заблокируют ли мой Instagram-аккаунт за парсинг?
Ограничения аккаунта — одно из самых вероятных последствий агрессивного парсинга. В политике ограничений аккаунта Instagram несанкционированный парсинг описан как автоматизация для сбора информации в нарушение правил. Отказ от парсинга через личный аккаунт снижает риск бана, но не делает сбор данных законным или безопасным с точки зрения договора.
Законно ли парсить Instagram для академических исследований?
Обычно риск ниже, чем при коммерческой перепродаже, особенно если речь о некоммерческом исследовании публичных данных, но автоматического освобождения от ответственности нет. Fair use или fair dealing могут иметь значение, однако исследователям стоит проверить требования IRB, если используются данные об идентифицируемых людях, применять минимизацию данных и по возможности использовать Content Library и API Meta.
В чём разница между парсингом Instagram и использованием API Instagram?
Официальный Instagram Graph API даёт структурированный доступ для одобренных бизнес- и creator-сценариев, но у него есть лимиты, требования к проверке и ограничения по политике. Парсинг же собирает видимые на сайте данные вне официального API. У обоих подходов есть юридические нюансы: использование API регулируется условиями для разработчиков Meta, а публичный парсинг в режиме logged-off в некоторых узких американских делах получил благоприятную оценку, но всё равно может затрагивать условия использования, приватность, IP и enforcement платформы. Для большинства бизнес-задач более безопасны официальный API, данные с согласия, лицензированные данные или открытые не-Instagram источники.
Подробнее




