
Напишите стандартную защиту, которую пишут все:
try:
    r = requests.get(url, timeout=0.5)
except requests.exceptions.Timeout:
    retry()
Теперь направьте её на сервер, который сразу отправляет статусную строку и заголовки, а затем зависает до тела ответа. Тайм-аут чтения срабатывает. Но этот обработчик не вызывается. Вылетает ConnectionError, а ConnectionError не является подклассом Timeout.
При таком же зависании httpx выбрасывает ReadTimeout, а это уже TimeoutException, и аналогичный обработчик его перехватывает.
Я начал разбираться, чем httpx отличается от requests в тех местах, где это ломает скрейперы, ожидая написать про async. Но async оказался самым неинтересным пунктом во всём списке.
Что я тестировал и как
Восемь проверок на локальном тестовом сервере, потому что отчёт клиента о том, что он якобы сделал, не доказывает, что он это действительно сделал. Сервер считает TCP-соединения — увеличивает счётчик при каждом принятом сокете, ещё до разбора первой строки запроса — и реально запрошенные пути. Повторное использование соединений и переходы по редиректам — это утверждения про сетевой обмен, а проверять их нужно именно на проводе.
httpx 0.28.1 с extra http2, requests 2.34.2, Python 3.14.2, macOS arm64. Всё запускалось в одном свежем virtualenv, чтобы один клиент не унаследовал следы от другого. Сырые данные: httpx-probes.json.
Шесть прогнозов были внесены в harness ещё до первого прогона и остались там после. Три совпали, два оказались неверными, один был верен для того случая, который я придумал, но упустил тот, который был важен. Учёт ведётся в prediction-scorecard.json.
Дефолты, которые меняют поведение без предупреждения
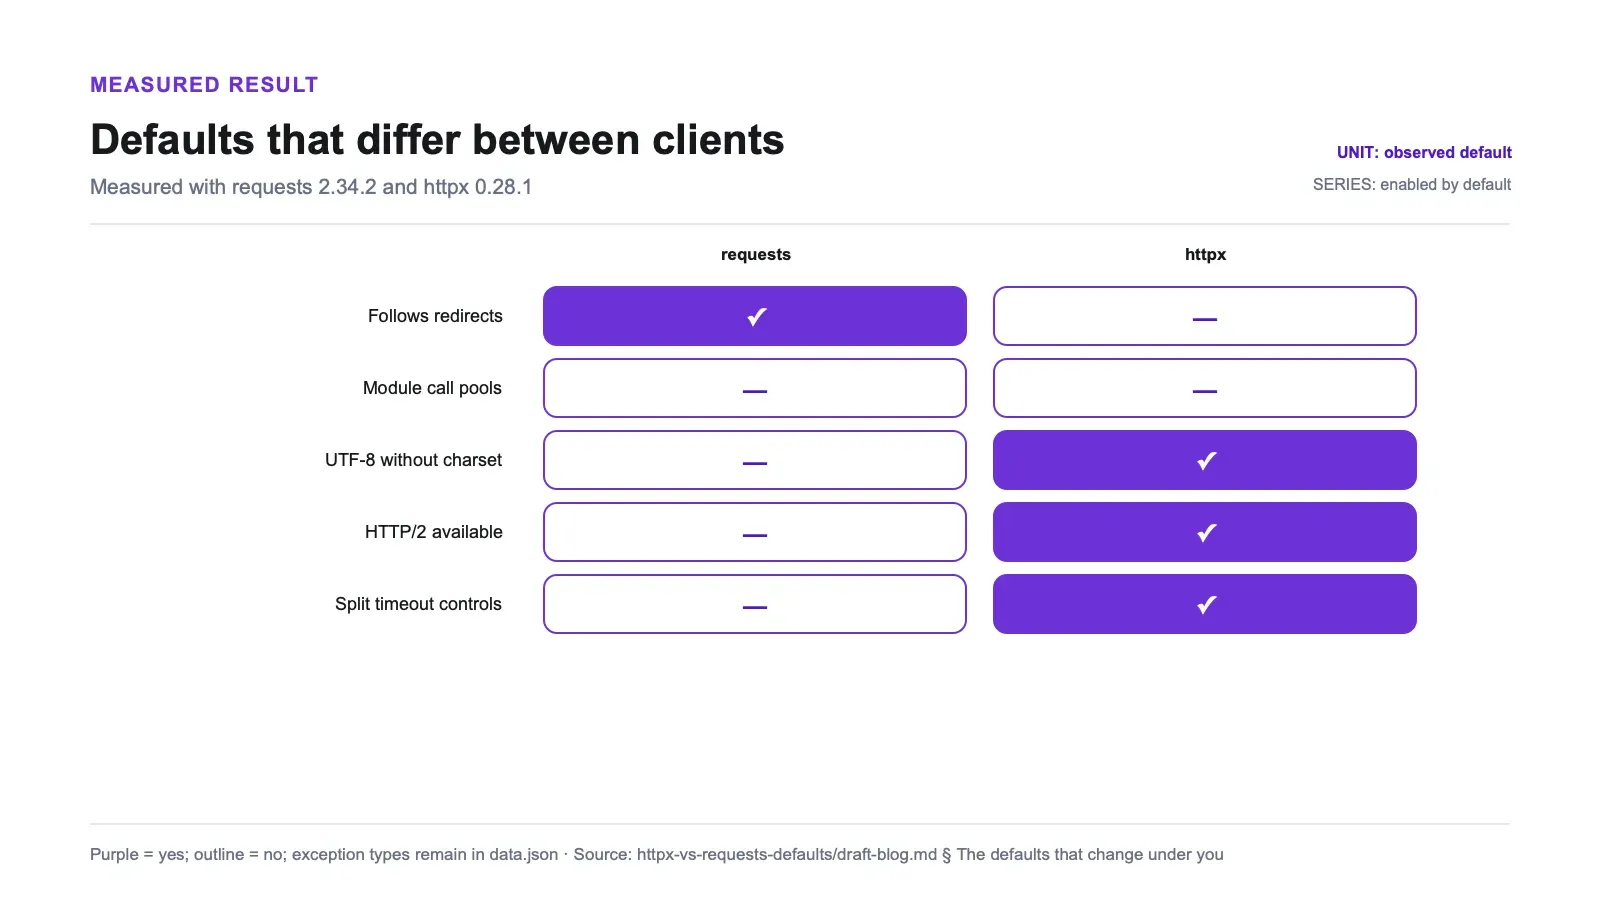
| Поведение | requests 2.34.2 | httpx 0.28.1 |
|---|---|---|
| Следует редиректам по умолчанию | да | нет |
| Вызов на уровне модуля переиспользует соединения | нет | нет |
| Зависание до заголовков | ReadTimeout | ReadTimeout |
| Зависание в середине тела | ConnectionError | ReadTimeout |
| Если charset не указан | ISO-8859-1 | utf-8 |
| HTTP/2 | недоступен | по явному включению, работает |
| Раздельные таймауты connect/read/write/pool | нет | да |
Редиректы, переиспользование сокетов, типы исключений, декодирование и согласование протокола были проверены на практике. Форма API таймаутов и отсутствие флага HTTP/2 у requests — это наблюдения по возможностям API. httpx-probes.json.
Три из этих строк изменят поведение вашего кода в момент перехода — и сделают это молча.
Редиректы: выключены по умолчанию, и сервер это доказывает
Цепочка из четырёх редиректов, заканчивающаяся на /ok:
| Клиент | Что увидел сервер | Какой статус вернулся |
|---|---|---|
| requests | 5 запросов | 200 |
| httpx | 1 запрос | 302 |
httpx, follow_redirects=True | 5 запросов | 200 |
Пятёрка — это четыре перехода плюс конечный адрес. В моём прогнозе стояла четвёрка, что было простой арифметической ошибкой; сама суть утверждения касалась направления, а количество исправлено здесь, а не тихо спрятано в тексте.
Такое поведение httpx задокументировано и вполне оправдано с точки зрения дизайна — редирект может быть важным для вызывающего кода. Но именно это чаще всего и ломает миграцию без каких-либо ошибок. Ваш код получает 302, response.text пустой, парсер не находит ни одной строки, а в логах якобы всё хорошо — 200 OK… хотя на самом деле там 302, и никто не следил за кодом ответа, потому что в requests за этим вообще не приходилось следить.
Таймаут, который я перепутал, — и это оказалось самым важным
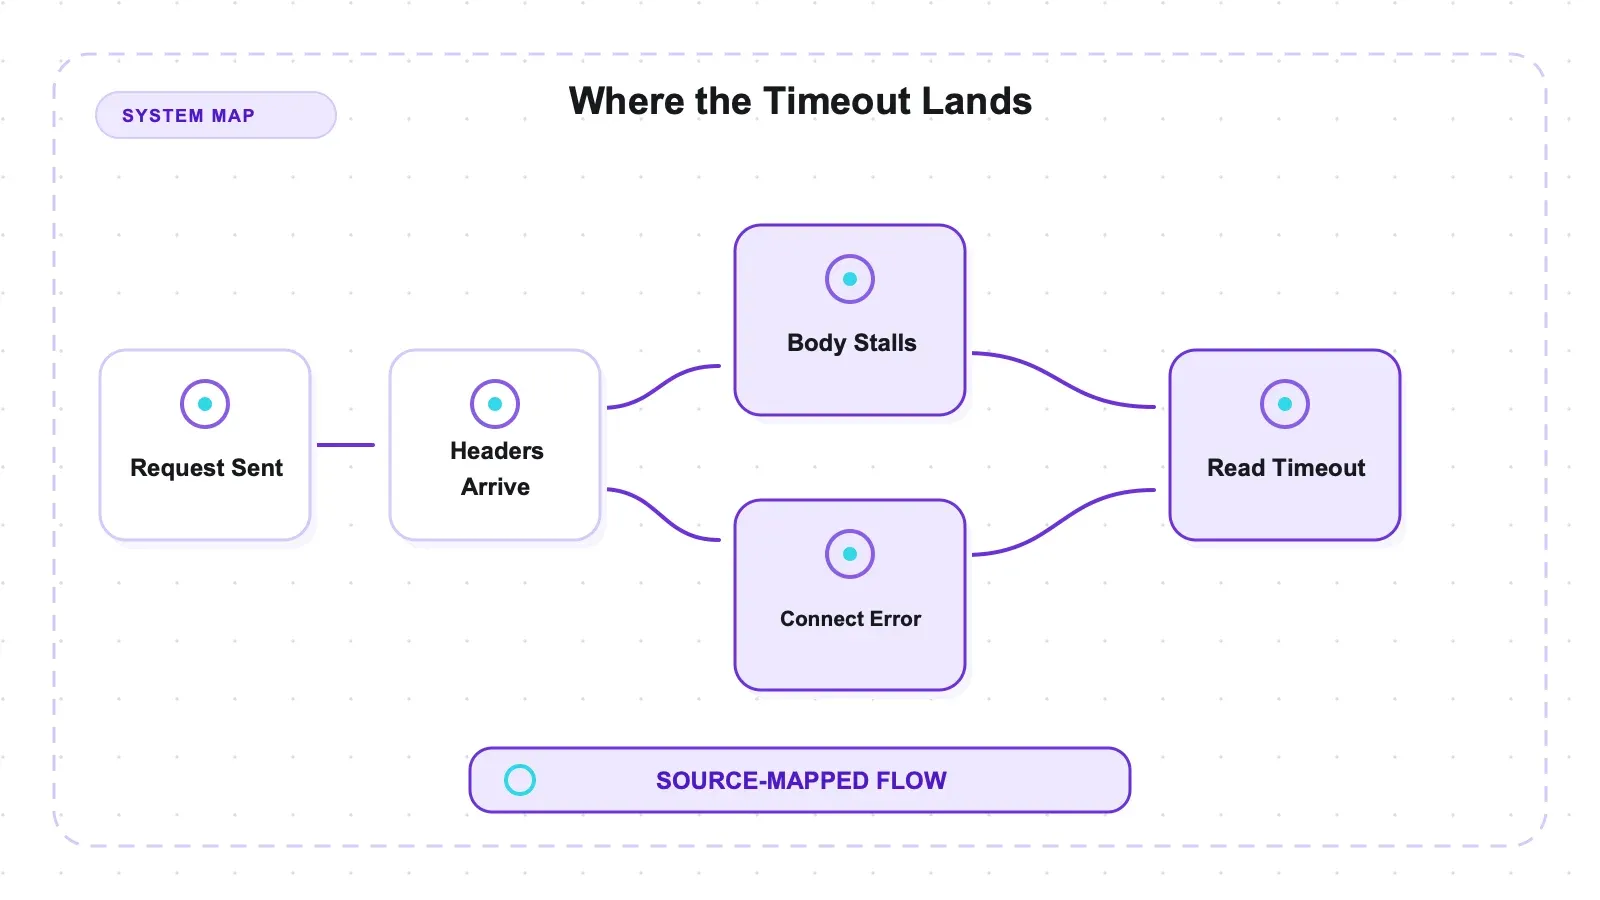
Я предполагал, что httpx назовёт фазу, на которой всё сломалось, а requests сгребёт оба случая в один класс. На деле всё наоборот.
Официальная справка: Requests timeout documentation.
Официальная справка: HTTPX timeout documentation.
| Зависание | requests | httpx |
|---|---|---|
| До статусной строки | ReadTimeout | ReadTimeout |
| В середине тела, после отправки заголовков | ConnectionError | ReadTimeout |
httpx называет обе ситуации одинаково и корректно. requests их разделяет — причём ровно по той границе, на которую опирается retry-код.
Последствие видно не по наследованию классов, а по реальному поведению. Я прогнал обработчик:
| Зависание | except requests.exceptions.Timeout | except httpx.TimeoutException |
|---|---|---|
| До статусной строки | перехватывается | перехватывается |
| В середине тела | уходит как ConnectionError | перехватывается |
timeout-retry-guard.json. requests.exceptions.ConnectionError не является подклассом requests.exceptions.Timeout; httpx.ReadTimeout является подклассом httpx.TimeoutException.
Сообщение об ошибке requests внутри ConnectionError говорит Read timed out.. Библиотека понимает, что произошло. Она просто не сообщает это через тип, а именно на тип смотрит ваш except.
Проверенный случай очень конкретный: заголовки уже пришли, а затем прогресс тела остановился достаточно надолго, чтобы превысить read timeout. Ответ, который продолжает отдавать чанки в пределах тайм-аута, включая намеренный стрим, может вести себя иначе — это здесь не тестировалось.
Пул соединений: вся разница — в клиентском API
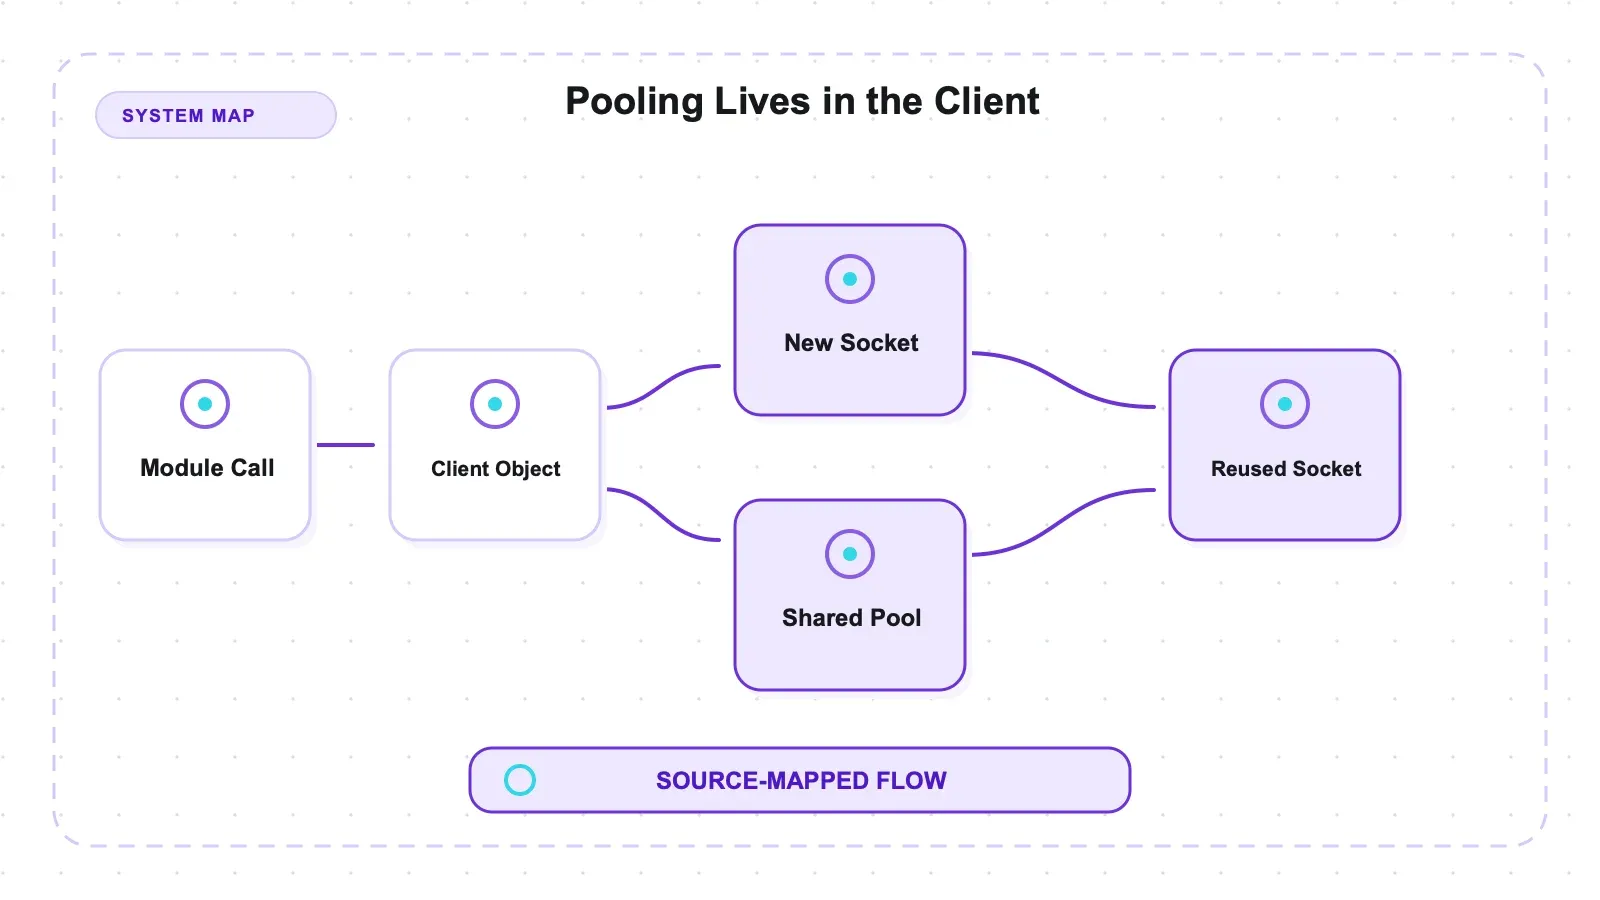
Десять GET-запросов, четыре варианта, сокеты считаются на стороне сервера:
| Как | Открыто сокетов |
|---|---|
httpx.get() × 10 | 10 |
requests.get() × 10 | 10 |
httpx.Client() | 1 |
requests.Session() | 1 |
Это одинаково, и это важно проговорить, потому что именно здесь чаще всего возникает бытовой миф: будто бы httpx пулит соединения, а requests — нет. На уровне модуля не пулит никто из них. Пул работает через объект клиента. Если вы сегодня вызываете requests.get() в цикле, то замена на httpx.get() в цикле ничего не изменит в количестве открываемых сокетов.
HTTP/2 включается явно и требует extra
На одном публичном HTTP/2-эндпоинте, зафиксированном в артефакте:
Официальная справка: RFC 9113: HTTP/2.
| Клиент | Что согласовано |
|---|---|
httpx.Client(http2=True) | HTTP/2 |
httpx.Client(http2=False) | HTTP/1.1 |
| requests | HTTP/1.1, флага нет |
Нужен extra httpx[http2]. Я предположил, что обычный pip install httpx даст клиент, который молча согласует 1.1, и пошёл проверять, прежде чем писать это в текст:
ImportError: Using http2=True, but the 'h2' package is not installed.
Make sure to install httpx using `pip install httpx[http2]`.
Исключение возникает при создании Client, ещё до первого запроса, и в сообщении прямо сказано, как это исправить. Это хороший вариант такой ошибки, и я поначалу думал наоборот (http2-extra-missing.json).
Эта проверка подтверждает успешное согласование протокола на данном эндпоинте. Она не доказывает прирост скорости для скрейпинга; сравнимой нагрузки HTTP/1.1 здесь не тестировалось.
Последовательная и конкурентная пропускная способность на тестовом стенде
Двадцать запросов к эндпоинту, который спит 0.3 с:
| Режим | Время | Сокеты |
|---|---|---|
Sync, один Client | 6.138 с | 1 |
Async, один AsyncClient | 0.357 с | 20 |
Конкурентный запуск завершился за 0.357 секунды против 6.138 секунды у последовательного. При этом он открыл двадцать соединений, тогда как синхронный клиент переиспользовал одно, так что эксперимент сравнивает не скорость самой библиотеки, а модель исполнения и фактическую параллельность.
Это честная интерпретация числа. Это замер конкуррентности на намеренно медленном эндпоинте, а не замер преимуществ httpx как такового. Любой клиент с рабочей async-историей окажется примерно в той же зоне, а на быстром эндпоинте разница почти исчезает.
Случай с charset, который я не догадался предсказать
Я предположил, что ответ с ложным заголовком — charset=iso-8859-1 при UTF-8-байтах — даст одинаковую «кашу» в обоих клиентах. Так и вышло. Оба возвращают Café Ubersetzung â naïve résumé, хотя источник содержит Café Ubersetzung — naïve résumé.
Но важнее оказался другой случай, который я не предсказал:
| Ответ | requests декодирует как | httpx декодирует как |
|---|---|---|
charset=utf-8, UTF-8 байты | корректно | корректно |
charset=iso-8859-1, UTF-8 байты | искажённый текст | искажённый текст |
| charset отсутствует | искажённый текст | корректно |
requests по умолчанию откатывается к ISO-8859-1, если в заголовке charset не указан, а httpx по умолчанию использует utf-8. В тестовом случае без charset клиенты поэтому по-разному декодировали .text; если использовать response.content, исходные байты остаются одинаковыми.
Память — раз уж её легко измерить
Пиковый RSS, /usr/bin/time -l, по одному свежему процессу на каждую ячейку:
| Ячейка | requests | httpx |
|---|---|---|
| Только импорт | 36.0 МиБ | 30.6 МиБ |
| Импорт плюс один GET | 35.8 МиБ | 40.7 МиБ |
Это снимки одного процесса, а то, что значение requests с одним GET чуть ниже, чем только при импорте, просто показывает шум измерений. По ним нельзя делать вывод о преимуществах по памяти; для этого нужны повторные замеры и диапазоны.
Что это значит на практике при выборе
Ищете баги в уже существующем коде на requests? Проверьте предположения о редиректах, обработчики, которые ловят только requests.exceptions.Timeout, но рассчитывают покрыть зависание в середине тела, и потребителей .text, которые получают ответы без charset.
Мигрируете механически на httpx? Поменяйте пространства исключений на httpx.TimeoutException или более узкие классы по фазам, решите, включать ли follow_redirects, и заново проверьте предположения о декодировании. Уже существующий обработчик requests и так не ловит показанный mid-body случай; миграция не создаёт именно эту проблему.
Пишете новое решение, которое ходит по множеству URL? httpx — хороший кандидат, если вам нужен AsyncClient и отдельные таймауты для connect, read, write и pool. Эти фазы подсказывают, где именно возникло ожидание — при установлении соединения, в прогрессе тела ответа, при загрузке запроса или при ожидании свободного соединения из пула, — но не объясняют, почему удалённый хост вёл себя именно так.
Пишете что-то небольшое и синхронное? requests вполне подходит и есть везде. Причина переходить — не в скорости.
Что бы вы ни выбрали, используйте объект клиента, а не функцию на уровне модуля. Это единственный пункт из списка, который даёт прямой выигрыш в обеих библиотеках.
Где здесь место управляемому API
Всё выше — это слой получения данных, а он как раз самый простой. Ни один из этих вариантов не рендерит JavaScript, не проходит антибот-защиту и не превращает HTML в нужные вам строки.
Примечание автора: Thunderbit — это наш управляемый вариант для рендеринга и извлечения данных по URL. В этом наборе HTTP-клиентских тестов он не участвовал. Рассматривайте его только тогда, когда проблема — это получение страницы или структурированное извлечение, а не семантика HTTP-клиента.
Если вы просто загружаете обычные страницы и парсите их сами, оба клиента остаются в зоне выбора. Управляемый сервис — это отдельное решение buy vs build, а не аргумент в пользу одной из этих библиотек.
Для более широкого обзора см. наш обзор API для веб-скрейпинга, а также материал про open-source скрейперы для self-hosted вариантов.
Попробовать Thunderbit для извлечения веб-данных
Итог
Для нового Python-слоя получения данных, которому нужны async-конкурентность, фазовые таймауты и UTF-8 как запасной вариант, httpx — мой выбор по умолчанию в рамках протестированных условий. Requests по-прежнему подходит для зрелого синхронного кода, где риск миграции важнее этих преимуществ. Прокси, политики retries, TLS fingerprinting, streaming, загрузка файлов и реальная сетевая вариативность не тестировались, так что это не универсальный рейтинг скрейпинг-клиентов.
Особенно осторожным стоит быть из-за дефолта редиректов, и это реальная опасность именно потому, что сам по себе это хороший дизайнерский выбор. Явное лучше неявного — до тех пор, пока неявное не оказалось несущей частью уже выпущенного кода.
Предварительно зарегистрированная таблица результатов закончилась тремя верными прогнозами, двумя неверными и одним неполным. Полезнее всего оказалось исправление класса исключения для mid-body case; остальное решение должно опираться на наблюдаемое поведение, а не на нарратив scorecard.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Правда ли, что httpx не следует редиректам?
По умолчанию — да, не следует. Сервер зафиксировал один запрос для цепочки из четырёх переходов, а ответ вернулся как 302. Передавайте follow_redirects=True для каждого вызова или задайте это один раз на Client. Это задокументировано и сделано намеренно; но именно это чаще всего ломает миграцию тихо, потому что ошибка выглядит как пустой парсинг, а не как исключение.
Достаточно ли except requests.exceptions.Timeout?
Нет, если сервер зависает уже после отправки заголовков. В таком случае возникает ConnectionError, а это не подкласс Timeout, поэтому обработчик его пропускает — это показано напрямую, а не выведено логически. Если хотите ловить и это тоже, используйте requests.exceptions.RequestException, но тогда вы поймаете и ошибки, которые вообще не являются таймаутами.
Действительно ли httpx быстрее requests? Не в заметной степени, если речь об одном запросе за раз — для этого он не предназначен. Ускорение в 17.2× в этом тесте — это результат двадцати одновременных запросов к эндпоинту с задержкой 0.3 с, то есть измерение конкуррентности. Если ваш сценарий последовательный, ускорения ждать не стоит; выбирайте по умолчаниям.
Нужен ли extra http2?
Только если вам нужен HTTP/2 — и если вы включите http2=True без него, httpx выбросит ImportError уже при создании Client, прямо подсказав установить httpx[http2]. Никакого тихого отката к HTTP/1.1 не будет. Я ожидал именно откат и решил перепроверить, а не писать предположение как факт.
Что здесь не тестировалось? Поведение прокси, а для скрейпинга это очень важно и требует отдельного harness. Retry-механика — у httpx встроенного retry нет, а у requests он приходит через urllib3, так что честное сравнение тут было бы сравнением двух retry-библиотек. TLS fingerprinting, то есть тот слой, на который реально смотрят антиbot-системы, и который ни одна из библиотек не решает. Streaming и загрузка файлов. И ещё: всё это запускалось на одной машине, в одной версии Python, а шесть из восьми проверок использовали localhost — задержки на тестовом сервере показывают дизайн, а не качество вашей сети.




