
html2text устанавливается как один пакет и занимает всего 0,2 МБ — это в девять раз меньше, чем ближайшая альтернатива на Python, и в сорок раз меньше, чем вариант на Node. В тестовом конвейере конвертации он успешно прошёл все четыре страницы и сохранил все 16 зарегистрированных body-probe. Эти проверки смотрят только на то, сохранились ли выбранные строки из тела документа; они не оценивают иерархию, вложенность списков, адреса ссылок, повторяющийся контент или полную точность таблиц.
Ещё у него лицензия GPL-3.0-or-later — и это как раз тот параметр в сравнении, который не отражается ни в одном бенчмарке, но способен сразу исключить библиотеку из рассмотрения.
Что такое html2text
html2text — это Python-библиотека, которая преобразует HTML в текст в стиле Markdown. Её история уходит к оригинальной версии Aaron Swartz, а текущая поддерживаемая ветка находится на версии 2025.4.15 — релиз с датой из апреля 2025 года, 2 168 звёздами на GitHub, 95 открытыми issues и последним push в октябре 2025 года.
Официальный источник: официальный репозиторий html2text.
import html2text
h = html2text.HTML2Text()
h.body_width = 0          # см. ниже; значение по умолчанию вас удивит
md = h.handle(html)
Команда pip install html2text подтягивает 1 пакет и 0,2 МБ, а холодный импорт занимает 0,077 с. Никаких зависимостей. В контейнере или Lambda layer это ощутимо отличается от markdownify с его 1,8 МБ и turndown с 8,8 МБ.
Настройка по умолчанию, которая меняет все цифры
Параметр body_width по умолчанию равен 78. html2text жёстко переносит каждую строку результата на 78 символах, если это не отключить.
Для библиотеки, чья исходная задача — выдавать читаемый plain text для терминала и почты, это вполне разумно. Но для сценариев, где текст идёт в модель или сравнивается diff’ом, такой дефолт неудачен: вставленные переводы строк меняют токенизацию, рвут длинные ссылки и делают сравнение вывода бессмысленным.
Ниже я везде выставляю body_width = 0 и специально это подчёркиваю, а не прячу: с включённым переносом все подсчёты символов и токенов в статье были бы другими. Если вы сами сравниваете конвертеры, именно эта настройка тихо сделает ваши цифры несопоставимыми.
Методика измерения
Я прогнал html2text на четырёхстраничном наборе конверсий, который также использовался в сравнении markitdown, с заранее зарегистрированными probe-строками — выбранными строками из body, которые должны сохраниться, и служебными строками, по наличию которых видно, что страница прошла целиком. Те же четыре файла, те же probes, один и тот же scorer для всех четырёх конвертеров. Сохранение probe показывает наличие строки, а не структурную корректность; именно поэтому для таблиц и ссылок используются отдельные колонки.
| Конвертер | Body probes | Символов в выводе | Токены (o200k) | Строк таблиц Markdown | Ссылки |
|---|---|---|---|---|---|
| html2text | 16/16 | 76,452 | 21,176 | 32 | 545 |
| markdownify | 16/16 | 76,868 | 21,062 | 36 | 599 |
| markitdown | 16/16 | 76,995 | 21,336 | 36 | 598 |
| turndown | 16/16 | 95,188 | 26,236 | 0 | 611 |
fourway-scores.json. Четыре fixture, токены посчитаны через o200k_base.
Самый компактный вывод из всех четырёх — 76 452 символа. По токенам он почти вровень с markdownify и markitdown: 21 176 против 21 062 и 21 336, разброс всего 1,3%, который я бы не стал называть разницей.
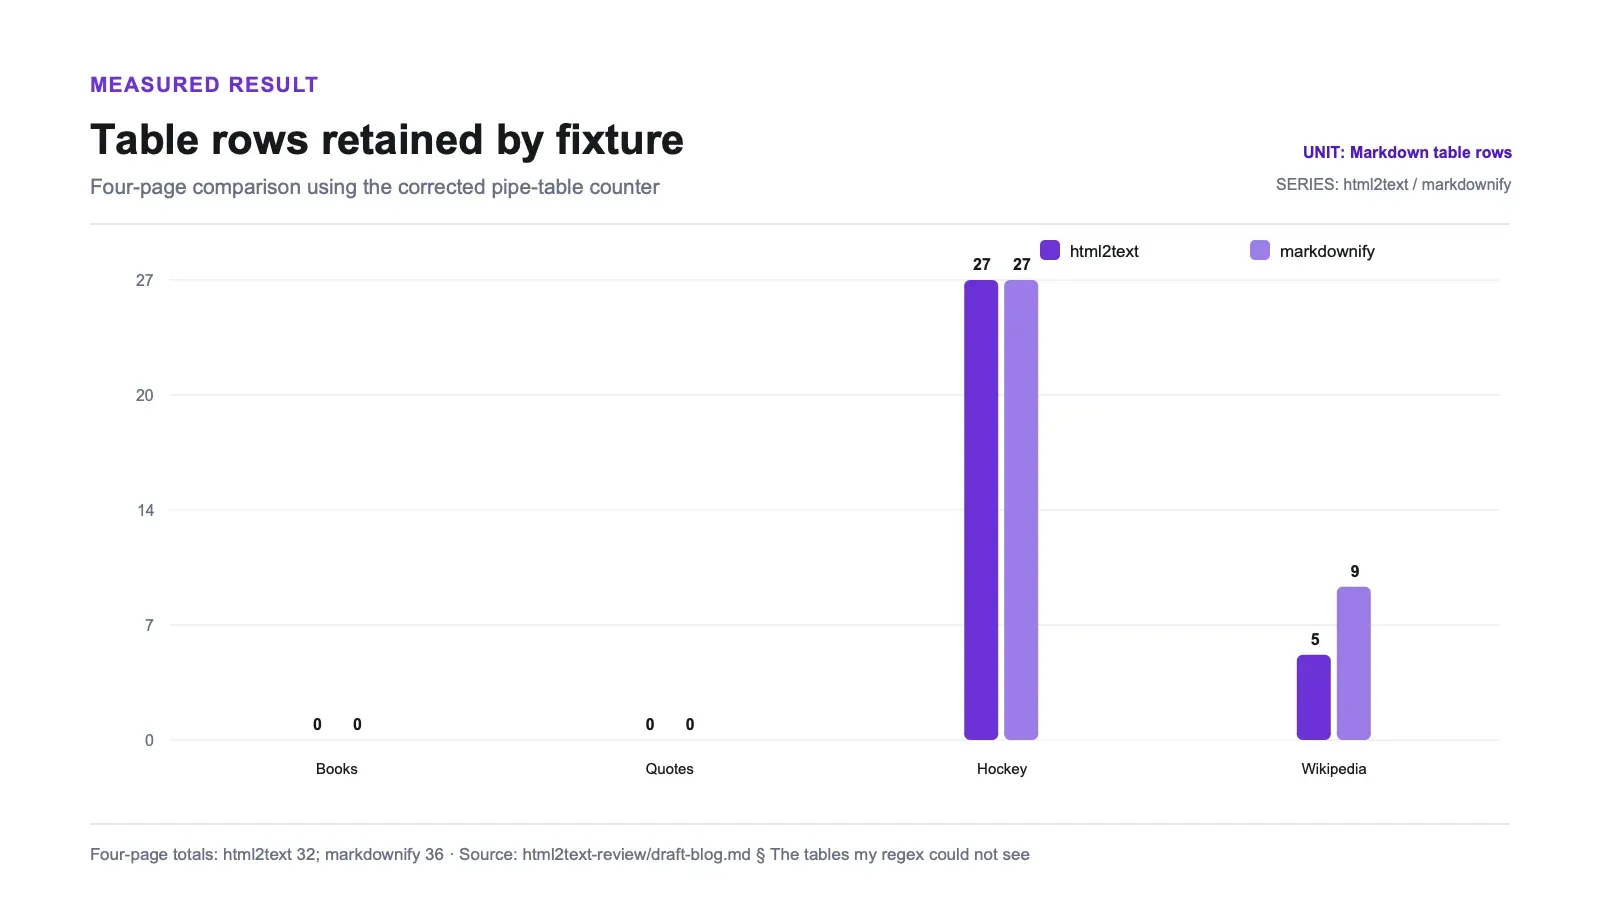
32 строки таблиц против 36 у markdownify и markitdown в четырёхстраничном наборе. Разница в четыре строки проявилась на неровном Wikipedia-fixture, а не в различии outer-pipe форматирования, о котором ниже.
Меньше всего ссылок — 545, тогда как у остальных 598–611. Это стоит проверить на своих страницах, если сохранение ссылок для вас важно: именно в этой колонке html2text заметно отстаёт от группы, а не идёт с ней вровень.
Таблицы, которых мой regex не увидел
Об этом важно рассказать, потому что я едва не опубликовал неверный вывод.
Мой первый счётчик строк таблиц требовал наличия и ведущих, и завершающих pipe-символов — ^\|.*\|$. По этому правилу html2text набрал бы 1 строку таблицы на пяти файлах: четыре страницы основного набора плюс отдельный синтетический fixture со сложной таблицей. Но такой счётчик измерял один стиль Markdown, а не сами таблицы.
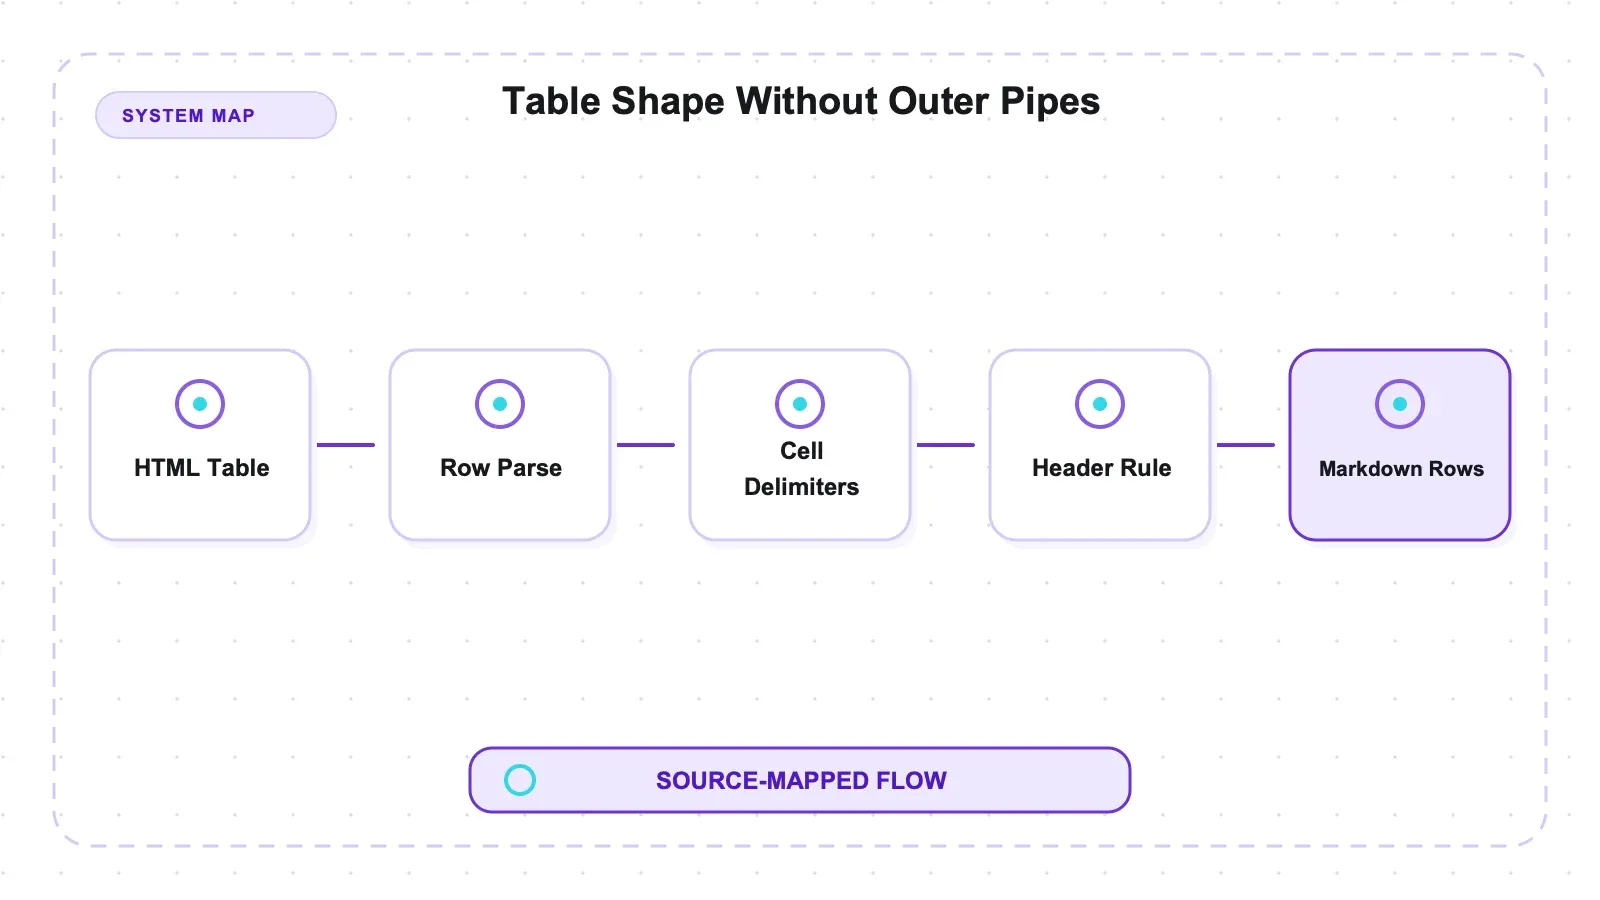
На самом деле он выводит таблицы вот так:
Team Name  |  Year  |  Wins  |  Losses  |  Win %
---|---|---|---|---
Boston Bruins  |  1990  |  44  |  24  |  0.55
Без внешних pipe по краям. Это вполне обычный pipe-table синтаксис, но наш harness не проверял его на совместимость с разными Markdown-рендерами. Для regex, который ждёт именно outer-pipe формат, такой вывод просто невидим. После того как я переписал счётчик так, чтобы он искал цепочку строк с pipe и разделительной строкой внутри, показатель html2text вырос с 1 строки до 32 в четырёхстраничном наборе и 91 по всем пяти файлам.
То есть вывод не в том, что у html2text нет таблиц. Вывод в другом: два из четырёх конвертеров используют outer pipes, а один — нет, и это важно, если вы потом прогоняете Markdown через собственный pattern matching. Это действительно полезно знать — и я бы упустил это, если бы доверился первой цифре.
Что он удаляет и где теряет строки
Здесь есть два наблюдения, которые тянут в разные стороны.
Он вырезает <script> и <style>. По маркерам, которые встречаются только внутри этих элементов, output html2text во всех fixture содержит ноль script-маркеров и ноль style-маркеров. У turndown, наоборот, 10 и 84 — на Wikipedia-fixture это восемь строк встроенной JavaScript-конфигурации MediaWiki и CSS на 14 644 символа (script-style-stripping.json). Для output, идущего в модель, это был крупнейший наблюдаемый источник лишнего текста на этом fixture. Downstream cost model не измерялся.
Он теряет строки таблиц на сложной странице. Четырёхстраничный набор сводится так:
| Fixture | html2text | markdownify |
|---|---|---|
| Books to Scrape | 0 строк | 0 строк |
| Quotes to Scrape | 0 строк | 0 строк |
| Hockey statistics | 27 строк | 27 строк |
| Wikipedia | 5 строк | 9 строк |
| Итого за 4 страницы | 32 строки | 36 строк |
Отдельный синтетический fixture со сложной таблицей добавляет 59 строк у html2text и 62 у markdownify, что даёт итоги 91 и 98 по пяти файлам. В главный четырёхстраничный headline-сравнительный блок он не входит. На чистой хоккейной таблице они совпадают. На Wikipedia, где таблицы вложенные и неровные, html2text выводит 5 строк, а markdownify — 9.
Итак, картина такая: простые таблицы — одинаково; сложные таблицы — у html2text сохранность хуже. Если у ваших страниц таблицы похожи на Wikipedia, это надо проверить до внедрения. Если же это таблицы как на странице со статистикой, то по этому параметру они взаимозаменяемы.
Лицензия
| Библиотека | Лицензия | Пакетов | Объём на диске |
|---|---|---|---|
| html2text | GPL-3.0-or-later | 1 | 0,2 МБ |
| markdownify | MIT | 5 | 1,8 МБ |
| turndown | MIT | 3 (npm) | 8,8 МБ |
Официальный источник: html2text на PyPI.
Подтверждение есть в трёх местах: в метаданных PyPI, в GitHub-репозитории и в собственном файле METADATA установленного пакета, где указано License-Expression: GPL-3.0-or-later.
Что это означает, зависит от того, как именно ПО используется, передаётся и распространяется. Внутреннее или сетевое использование и поставка софта с включённым пакетом — это обычно разные GPL-сценарии, но это не юридический анализ. Командам, которые распространяют ПО, стоит показать конкретную схему интеграции и распространения юристам.
Проблема в том, что здесь есть неприятная корреляция. Библиотека с самым маленьким footprint — та, которую вы выбрали именно ради компактного дистрибутива, — и оказывается той, чья лицензия сильнее всего ограничивает распространение. Обе альтернативы — MIT.
Я не юрист и это не совет — просто установленный факт, потому что это тот параметр, который чаще всего имеет значение и реже всего попадает в сравнительную таблицу.
Поддержка и развитие
Последний релиз — 2025.4.15, последний push в репозиторий — октябрь 2025 года, то есть примерно за десять месяцев до тестирования; позади ещё 41 релиз. requires_python >= 3.9, и на Python 3.14.2 всё установилось и работало без проблем.
Это спокойнее, чем markdownify (последний релиз за шесть недель до теста) и turndown (за четыре месяца), и уж точно активнее, чем отсутствие обновлений. Для библиотеки, которая превращает HTML в текст — задачи, которая не меняется так быстро, — пауза в десять месяцев выглядит скорее как стабильность, а не как заброшенность. 95 открытых issues — более заметный сигнал; перед внедрением стоит просмотреть их на предмет всего, что похоже на ваш кейс.
Память и то, что делает с ней битый HTML
Здесь отдельно измеряются два операционных вопроса.
Более широкий стресс-тест описан в сравнении памяти и malformed HTML для десяти библиотек.
Пиковое resident memory, через /usr/bin/time -l, один свежий процесс на каждую ячейку — нижняя планка импорта показывает, сколько библиотека стоит в загруженном и простаивающем состоянии, а пики уже включают документ.
| Библиотека | Runtime | Нижняя планка импорта | Пик на 226 КБ | Пик на 10 МБ |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Базовые показатели Python и Node между собой напрямую не сравниваются; интерпретатор включён в оба.
html2text — самый лёгкий вариант в этом списке по обоим измеренным осям. Его нижняя планка импорта 18,7 МБ и пик 71,2 МБ на fixture 10 МБ дают добавочный RSS 52,5 МБ: (71.2 - 18.7) / 10 = 5.25× размера fixture. Сравнивайте это с абсолютными и incremental-значениями в таблице, помня про указанную оговорку о базах Python и Node.
Битый HTML. Двенадцать документов, каждый из которых ломает ровно одну вещь — незакрытые теги, неправильную вложенность inline-элементов, атрибуты без кавычек со пробелами, лишние закрывающие теги, полное отсутствие <html>, дублирующиеся атрибуты, документ, оборванный посреди тега, плохие сущности, незакрытый <script>, ложное объявление charset, комментарий с разметкой и 600 уровней вложенности, — плюс два корректных control-документа сопоставимого размера, потому что «ничего не вернул» говорит о malformed только если библиотека не молчит и на чистом документе того же размера.
html2text не выбросил исключение на 0 из 14 и ничего не вернул тоже на 0, восстановив 33/33 sentinel’ов на повреждённых fixture (malformed-results.json). Один fixture исключён из этого счёта: по HTML5 всё, что идёт после незакрытого <script>, действительно считается содержимым script, так что потерять его там — правильно, а восстановить — уже отклонение.
Плюсы и минусы
Плюсы. Один пакет, 0,2 МБ, ноль зависимостей — безусловно самый компактный вариант в сравнении. Самый маленький вывод из четырёх и практически паритет по токенам с markdownify и markitdown. Выдаёт узнаваемый pipe-table синтаксис. Работает на Python 3.14. Долгая и стабильная история.
Минусы. GPL-3.0-or-later, тогда как у альтернатив этого нет. По умолчанию body_width=78, из-за чего вывод жёстко переносится и меняет измерения или diff’ы, если это не отключить. Больше всего потерянных ссылок — 545 против 598–611. Таблицы выводятся без outer pipes, что ломает наивный downstream regex. 95 открытых issues и более спокойный темп релизов, чем у markdownify.
Кому подойдёт, а кому нет
Используйте html2text, если бюджет на зависимости действительно жёстко ограничен и модель интеграции/распространения уже прошла лицензионную проверку. Один пакет без зависимостей — это реальное операционное преимущество: меньше поверхность для аудита и развёртывания.
Сразу ставьте body_width = 0 в первой строке, если вам не нужен именно wrapped plain text.
Пропустите его, если вы распространяете ПО и copyleft для вас проблемен — markdownify использует MIT, по токенам здесь он не хуже, а по таблицам совпадает с markitdown при запасе всего в 1,6 МБ диска. Пропустите его и тогда, когда для вас критично сохранение ссылок: он сохранил меньше всего. И пропустите, если ваш downstream-инструмент предполагает outer pipes в строках таблицы.
Где уместен managed API
html2text преобразует HTML, который у вас уже есть. Он не умеет загружать страницы, исполнять JavaScript или обходить антибот-защиту — ни один из четырёх конвертеров этого не делает, а на многих реальных целях это и есть самая сложная половина задачи.
Для тех же fixture во всех пяти конвертерах см. сравнение HTML-to-Markdown в пяти вариантах.
Облачный сервис для fetch/render/extraction, включая наш собственный Thunderbit, работает на другом уровне. Thunderbit в этом тесте не бенчмаркался. Важная граница здесь — преобразование уже полученного HTML против сервиса, который сам получает и обрабатывает URL; эта статья не даёт сравнения по качеству, задержке или стоимости на одной и той же шкале.
Корректная формулировка такая: если HTML у вас уже есть, нужен Markdown и GPL не мешает вашей модели поставки, html2text бесплатен и удивительно мал. Если же нужно сначала получить страницы или вам важнее строки, а не прозa, это уже другой продуктовый выбор.
Для более широкого обзора см. наш обзор API для web scraping и путеводитель по open-source scraper для self-hosted решений. Преобразование HTML в Markdown на Python — практический разбор.
Попробовать Thunderbit для извлечения веб-данных
Стоит ли использовать html2text?
Это сильный кандидат, когда важен минимальный footprint, переносы отключены осознанно, а схема распространения проходит лицензионную проверку.
По токенам он отличался от markdownify и markitdown меньше чем на 1,3% в четырёхстраничном наборе. Но это не означает равенство общей качества: html2text сохранил меньше ссылок и меньше строк на неровном Wikipedia-fixture. Два операционных момента важно учесть сразу: body_width = 0 и стиль таблиц без outer pipes.
Если GPL делает его неприемлемым, markdownify использует MIT, здесь показал сопоставимые размер вывода и число токенов, сохранил больше ссылок и строк в неровных таблицах, а на диске в этой среде занял на 1,6 МБ больше.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
Часто задаваемые вопросы
html2text умеет конвертировать таблицы?
Да. Мой первый счётчик сказал, что он выдал одну строку таблицы на пяти файлах, и это было неверно — он требовал ведущие и завершающие pipe, тогда как html2text выводит Team Name | Year | Wins без них. Это обычный Markdown pipe-table, хотя в этом harness не проводилась проверка совместимости с разными рендерами. После исправления счётчика html2text дал 32 строки против 36 у markdownify в четырёхстраничном наборе и 91 против 98, если добавить отдельный fixture со сложной таблицей.
Что делает body_width и зачем его менять?
По умолчанию он жёстко переносит строки на 78 символах — разумно для plain text в терминале и плохо почти для всего остального. Переносы вставляют новые строки посреди предложения, рвут длинные URL и меняют токенизацию. Во всех цифрах этого обзора использовался body_width = 0; со значением по умолчанию они были бы другими.
GPL — это реальное ограничение?
Это зависит от конкретной схемы интеграции и распространения. Внутреннее или сетевое использование и передача софта — разные сценарии проверки, но эта статья не определяет их юридический исход. Командам, которые поставляют ПО, стоит показать условия GPL-3.0-or-later юристам; markdownify и turndown используют MIT. Лицензионное выражение html2text подтверждено в метаданных PyPI, в GitHub и в файле METADATA установленного пакета.
Релиз из апреля 2025 года — это проблема? Скорее нет, сам по себе — нет. Конвертация HTML в текст — стабильная задача, библиотека установилась и работала без ошибок на Python 3.14.2, а позади у неё ещё 41 релиз. 95 открытых issues — вот число, которое я бы реально посмотрел: пробегитесь по ним в поисках всего, что похоже на ваш входной формат, прежде чем внедрять, потому что тихий репозиторий может означать, что чинить придётся вам.
Что здесь не тестировалось?
Четыре fixture для конверсии и ещё один отдельный fixture со сложной таблицей — это всё ещё небольшой набор. Тест действительно включал двенадцать синтетических malformed-документов и два control-документа: html2text не выбросил исключение в 0/14, не вернул пустой результат в 0/14 и восстановил все 33 scored sentinel’а. Но он не покрывал реальные повреждённые страницы, более широкий набор malformed-паттернов, вложенные списки, definition lists, сноски или математику. Полный набор опций — ignore_links, ignore_images, unicode_snob, single_line_break и остальные — оставался на значениях по умолчанию, кроме body_width. Расхождение по ссылкам зафиксировано, но не объяснено, а round-tripping Markdown не тестировался.




