
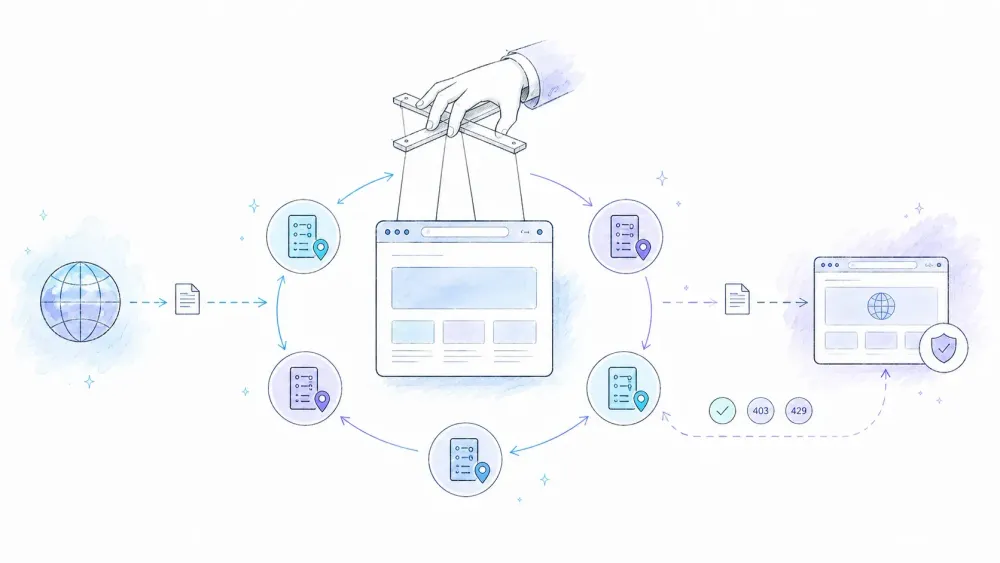
Хорошо знакомый сценарий сбоя в Puppeteer выглядит так: первые запросы проходят без проблем, а потом внезапно появляются 403 или 429, таймауты либо редирект на страницу с проверкой. Но во многих гайдах ротация прокси до сих пор подаётся как настройка буквально в две строки.
На деле всё не так просто. Разрыв между примером вроде «добавьте флаг --proxy-server» и устойчивой рабочей системой — огромный. В этом руководстве разобраны ротация на уровне браузера, авторизованные шлюзы, шардирование браузеров и внешние реле, стабильные профили браузера, обработка ошибок уровня production, а также честный ответ на вопрос, когда прокси лучше вообще не брать на себя.
Что такое rotating proxy и зачем он нужен Puppeteer?
Прокси — это посредник между вашим экземпляром Puppeteer и сайтом, к которому вы обращаетесь. Сайт видит выходной IP прокси, а не ваш реальный адрес. Rotating proxy переключает набор таких выходных IP — иногда на каждый запрос, иногда на каждую сессию — чтобы трафик не выглядел как один и тот же клиент, который без остановки отправляет тысячи запросов подряд.
Для Puppeteer это особенно важно, потому что headless Chrome, который делает сотни последовательных запросов с одного IP, — именно тот шаблон, на который нацелены антибот-системы. Документация Cloudflare прямо описывает несколько уровней обнаружения, работающих одновременно: эвристики, проверка JavaScript fingerprint, модели машинного обучения и поведенческое выявление аномалий. Ротация IP закрывает только один из этих уровней. Только один.
Стоит различать три типа прокси, и они не взаимозаменяемы:
- Datacenter proxies — дешёвые, быстрые и полученные у хостинг-провайдеров. Целевым сайтам их легко пометить, потому что ASN (сетевой блок) очевидно принадлежит дата-центру, а не домашнему провайдеру.
- Residential proxies — идут через реальных провайдеров домашнего интернета, поэтому выглядят как обычные домашние подключения. Они медленнее и дороже, но выглядят намного правдоподобнее.
- Mobile proxies — IP из сетей операторов, обычно самый дорогой вариант, который нужен, когда действительно требуется мобильная идентичность.
Residential-выходы могут быть менее заметны при простой классификации ASN, чем datacenter-выходы, но ни один из вариантов не защищён от блокировки полностью. Универсального процента детекта не существует: результат зависит от сайта, репутации IP, географии, истории сессии, профиля браузера и поведения запросов.
Есть ещё одно различие, которое часто путают: свой статический список, который вы ротируете сами (управляете пулом, выбираете следующий IP, обрабатываете ошибки), и backconnect/gateway proxy (вы подключаетесь к одной точке входа, а провайдер меняет выходные IP за кулисами). Оба подхода рабочие; просто сложность лежит в разных местах.
Зачем настраивать rotating proxy в Puppeteer? Типичные сценарии
Честно говоря, ротация вам, скорее всего, не нужна — пока она вдруг не становится критически необходимой.
| Сценарий | Почему важна ротация |
|---|---|
| Мониторинг цен в каталогах товаров | Повторные запросы к каталогу с одного IP накапливают rate limit и сигналы репутации |
| Обогащение лидов / сбор контактных данных | Частые заходы в профили с одного IP выглядят как скрапинг, а не обычный просмотр, и ловятся поведенческими системами |
| Сбор SERP | Поисковые системы особенно агрессивно ограничивают IP и отправляют на CAPTCHA |
| Сбор конкурентной аналитики | Многократный сбор одного домена в течение дней формирует отпечаток, связанный с вашим IP и историей cookies |
| Агрегация контента | Много страниц, мало ценности на каждую — именно такой трафик антиботы и учатся распознавать |
Не существует фиксированного и проверяемого числа вроде «Amazon блокирует на 51-м запросе». Сайты не публикуют универсальные пороги, а правила могут меняться в зависимости от endpoint, состояния аккаунта, репутации ASN и формы трафика. Начинайте с минимально допустимой частоты запросов, проверяйте не только статус-код, но и содержимое страницы, и включайте ротацию только тогда, когда измеряемое поведение и правила сайта действительно этого требуют.
Три стратегии ротации прокси в Puppeteer: какая вам нужна?
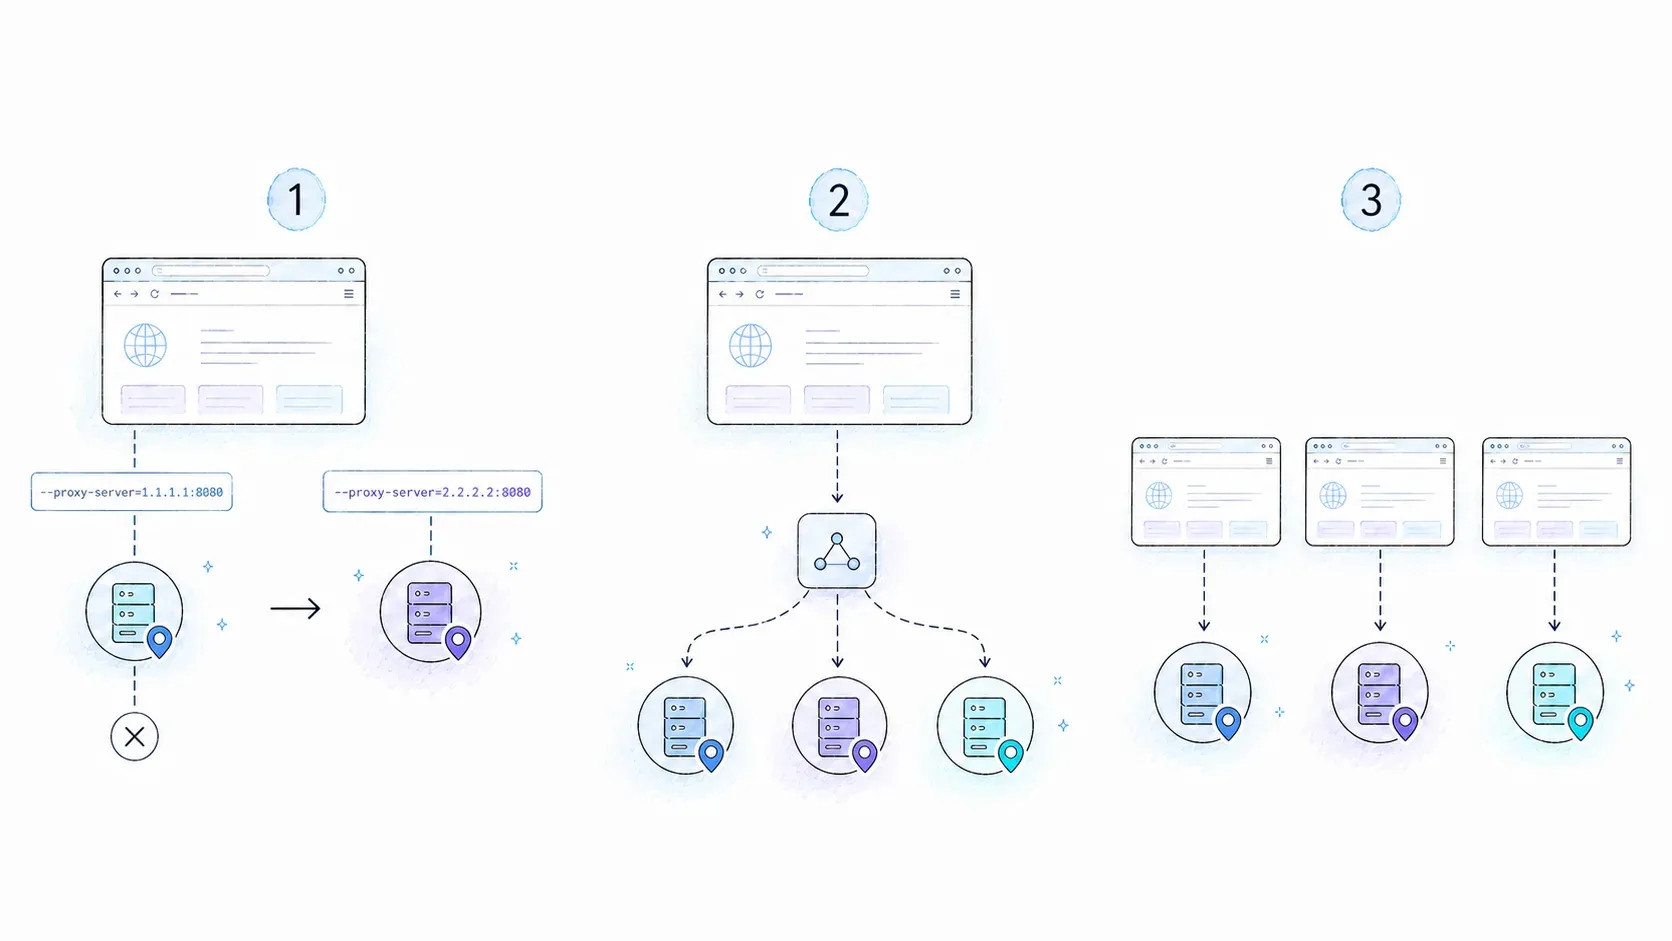
Это та часть, которую большинство инструкций либо пропускают, либо показывают только в самом грубом виде. Есть три уровня детализации, и если выбрать не тот, вы либо потеряете время, либо усложните простую задачу.
| Стратегия ротации | Уровень детализации | Нужен перезапуск браузера? | Сложность | Лучше всего подходит для |
|---|---|---|---|---|
На уровне браузера (--proxy-server) | 1 прокси на один экземпляр браузера | Да | Низкая | Простые скраперы с небольшим объёмом |
Через gateway (proxy-chain + backconnect endpoint) | Политика провайдера / сессии | Нет | Средняя | Авторизованные rotating-шлюзы |
| Шардирование браузера или внешнее реле | 1 прокси на один шард браузера или правило реле | Нет единой подмены в процессе | Высокая | Контролируемая конкуренция и точная маршрутизация |
Небольшое уточнение перед выбором: в документации Puppeteer по сетевой интерцепции прямо сказано, что setRequestInterception — это не аккуратный переключатель «сменить прокси на каждый запрос». Каждый перехваченный запрос останавливается, пока вы явно не продолжите, не ответите или не отмените его. Настоящая маршрутизация прокси на уровне каждого запроса обычно означает пропуск трафика через локальный программируемый gateway, например proxy-chain, а не попытку вручную тасовать прокси внутри обработчика interception. Имейте это в виду, прежде чем переходить к Методу 3 ниже.
Как настроить rotating proxy в Puppeteer: пошаговое руководство
Сложность: средняя
Время: примерно 30–45 минут для всех трёх методов
Что понадобится: Node.js 18+, npm, список прокси или аккаунт у провайдера (формат: protocol://user:pass@host:port), а также пакеты puppeteer, proxy-chain и puppeteer-extra
Подготовка: что нужно до старта
Установите основные пакеты:
npm install puppeteer proxy-chain puppeteer-extra puppeteer-extra-plugin-stealth
Получите список прокси у провайдера (для всего, что выходит за рамки теста, лучше брать residential) или хотя бы несколько тестовых прокси, чтобы проверить код до того, как вы начнёте расходовать на него реальный трафик. Храните учётные данные в переменных окружения — никогда не встраивайте их в код и не вставляйте в URL, который потом попадёт в лог-файл.
Метод 1: ротация прокси на уровне браузера через --proxy-server
Это базовый вариант, с которого все начинают, и не зря — он предсказуемый. В документации LaunchOptions Puppeteer указано, что args — это штатный способ передавать флаги командной строки Chrome, а --proxy-server — нативный флаг Chromium.
import puppeteer from 'puppeteer';

const proxyPool = [
  'http://proxy1.example:8080',
  'http://proxy2.example:8080',
  'http://proxy3.example:8080',
];

let proxyIndex = 0;

async function scrapeWithRotation(url) {
  const proxy = proxyPool[proxyIndex % proxyPool.length];
  proxyIndex++;

  const browser = await puppeteer.launch({
    headless: true,
    args: [`--proxy-server=${proxy}`],
  });

  const page = await browser.newPage();

  // Если прокси требует авторизацию, это должно выполниться до любой навигации
  await page.authenticate({
    username: process.env.PROXY_USER,
    password: process.env.PROXY_PASS,
  });

  await page.goto(url, { waitUntil: 'domcontentloaded', timeout: 30_000 });
  const content = await page.content();

  await browser.close(); // закрыть перед переключением прокси
  return content;
}
Обратите внимание: page.authenticate() незаметно включает request interception внутри, как указано в документации Puppeteer. Это небольшой, но реальный оверхед, о котором полезно знать, если вы потом будете разбираться, почему всё работает медленнее ожидаемого.
Ожидаемый результат: каждый вызов запускает новый браузер, привязанный к другому прокси. Чтобы сменить прокси, вы закрываете браузер и запускаете его заново — этого не избежать. Для скрапа на 50 страниц такой способ почти наверняка будет заметно медленнее двух остальных просто из-за времени запуска браузера.
Когда использовать: скрипты с низкой конкуренцией, разовые задачи, случаи, когда важнее простота отладки, чем скорость.
Метод 2: авторизованный rotating gateway с proxy-chain
Chrome не умеет принимать учётные данные в формате user:pass@host, встроенные прямо в URL прокси. Пакет proxy-chain, который поддерживает Apify, решает проблему авторизации, поднимая локальный анонимный прокси, который проксирует трафик дальше в ваш upstream с авторизацией. Если upstream — это rotating/backconnect gateway провайдера, то провайдер уже сам меняет выходные IP за этой единственной точкой входа согласно своей политике сессий. Сам proxy-chain не назначает отдельный прокси каждому существующему Puppeteer-окну.
import puppeteer from 'puppeteer';
import { anonymizeProxy, closeAnonymizedProxy } from 'proxy-chain';

async function scrapeThroughGateway(upstreamProxyUrl, targetUrl) {
  const localProxy = await anonymizeProxy(upstreamProxyUrl);
  let browser;

  try {
    browser = await puppeteer.launch({
      headless: true,
      args: [`--proxy-server=${localProxy}`],
    });
    const page = await browser.newPage();
    await page.goto(targetUrl, { waitUntil: 'domcontentloaded' });
    return await page.content();
  } finally {
    if (browser) await browser.close();
    await closeAnonymizedProxy(localProxy, true); // всегда очищайте ресурсы
  }
}
Этот блок finally не декоративный — оставленные без присмотра локальные proxy-серверы занимают порты, а у меня были скраперы, которые ночью тихо съедали доступные file descriptor'ы просто потому, что анонимизированный прокси не был закрыт. proxy-chain также отдаёт конкретные коды ошибок (593 — проблемы DNS, 594 — connection refused, 597 — ошибка авторизации), которые действительно помогают классифицировать сбои — к этому ещё вернёмся.
Когда использовать: авторизованные residential/datacenter gateway, где ротацией управляет endpoint или session-параметры провайдера. Если вам нужно несколько фиксированных идентичностей прокси одновременно, используйте отдельные процессы браузера (browser sharding) или специально построенное внешнее реле; в нативном Puppeteer нет поддерживаемой per-page-настройки прокси.
Метод 3: маршрутизация на каждый запрос требует внешнего реле
Это вариант с самой высокой гранулярностью — теоретически каждый image, script и API-вызов страницы мог бы идти через отдельный выход. На практике это самый хрупкий и наименее документированный путь, потому что Puppeteer request interception создавался для фильтрации и модификации запросов, а не для переключения сетевого транспорта для каждого запроса.
import puppeteer from 'puppeteer';

async function inspectRequests(url) {
  const browser = await puppeteer.launch({ headless: true });
  const page = await browser.newPage();

  await page.setRequestInterception(true);

  page.on('request', async (request) => {
    // На практике настоящее переключение прокси на каждый запрос требует
    // маршрутизации через локальное реле (proxy-chain), а не подмены
    // транспорта браузера на лету — Chrome этого не поддерживает.
    // В большинстве production-сценариев этот обработчик используют для
    // фильтрации/отмены типов ресурсов, а затем комбинируют это с
    // browser sharding или gateway.
    if (['image', 'font', 'stylesheet'].includes(request.resourceType())) {
      request.abort();
    } else {
      request.continue();
    }
  });

  await page.goto(url, { waitUntil: 'networkidle2' });
  await browser.close();
}
Честно: настоящая смена IP на уровне каждого запроса внутри Puppeteer не реализуется через setRequestInterception(). Если вам действительно нужна такая детализация, пропускайте Chrome через программируемое внешнее реле или используйте scraping framework, построенный вокруг proxy-сессий. Для большинства проектов один прокси на один browser shard или gateway с ротацией от провайдера проще в эксплуатации и аудите.
Полная антидетект-стратегия: одной ротации прокси недостаточно, чтобы не получить бан
Частая жалоба звучит так: «Я использую прокси, но меня всё равно блокируют». IP — лишь один из нескольких сигналов, которые анализирует современная антибот-система, и его ротация без изменений остальных признаков может даже усилить аномалию. Например, браузер, который утверждает, что это Windows Chrome, но client hints, часовой пояс или locale говорят обратное, выглядит подозрительно.
Уровень 1: rotating residential proxies
Об этом уже говорили выше — residential-выходы часто выглядят правдоподобнее, чем datacenter-выходы, но универсального минимального размера пула не существует. Подбирайте размер пула исходя из реального объёма запросов, длины сессии, пауз между ними и того, как провайдер переиспользует IP, а не исходя из произвольного количества адресов.
Уровень 2: stealth-plugin, скрывающий признаки headless Chrome
puppeteer-extra-plugin-stealth исправляет набор известных признаков headless: navigator.webdriver, строки WebGL vendor, отсутствующие объекты Chrome runtime и ещё несколько утечек через CDP. Это действительно полезный слой совместимости, но сам README проекта честно признаёт: это игра в кошки-мышки, и полностью предотвратить детект, скорее всего, невозможно. Рассматривайте его как базу, а не как гарантию.
Уровень 3: стабильные профили браузера и аккуратный темп запросов
Строки user-agent должны быть согласованы со всем остальным, что сообщает браузер. В Chrome User-Agent Client Hints отдают структурированные данные о платформе, поэтому вручную заданный user-agent может противоречить реальной платформе. Лучше использовать user agent, который поставляется вместе с bundled Chrome, сохранять стабильные viewport/locale/timezone внутри одной сессии и делать запросы с осторожной паузой, а не придумывать новый fingerprint для каждой страницы.
Ниже — все три уровня, собранные в один launch config:
import puppeteer from 'puppeteer-extra';
import StealthPlugin from 'puppeteer-extra-plugin-stealth';
import { anonymizeProxy, closeAnonymizedProxy } from 'proxy-chain';

puppeteer.use(StealthPlugin());

function boundedDelay(minMs = 800, maxMs = 1800) {
  return new Promise((r) => setTimeout(r, minMs + Math.random() * (maxMs - minMs)));
}

async function stableProfileScrape(targetUrl, upstreamProxy) {
  const localProxy = await anonymizeProxy(upstreamProxy);
  let browser;

  try {
    browser = await puppeteer.launch({
      headless: true,
      args: [`--proxy-server=${localProxy}`, '--lang=en-US'],
    });
    const page = await browser.newPage();
    await page.setViewport({ width: 1366, height: 768 });
    await boundedDelay();
    await page.goto(targetUrl, { waitUntil: 'domcontentloaded' });
    return await page.content();
  } finally {
    if (browser) await browser.close();
    await closeAnonymizedProxy(localProxy, true);
  }
}
Это именно тот блок, который конкурирующие гайды чаще всего не показывают: прокси, stealth и рандомизация fingerprint собраны в одном месте, готовые для копирования и адаптации.
Обработка ошибок и health-check'и прокси уровня production
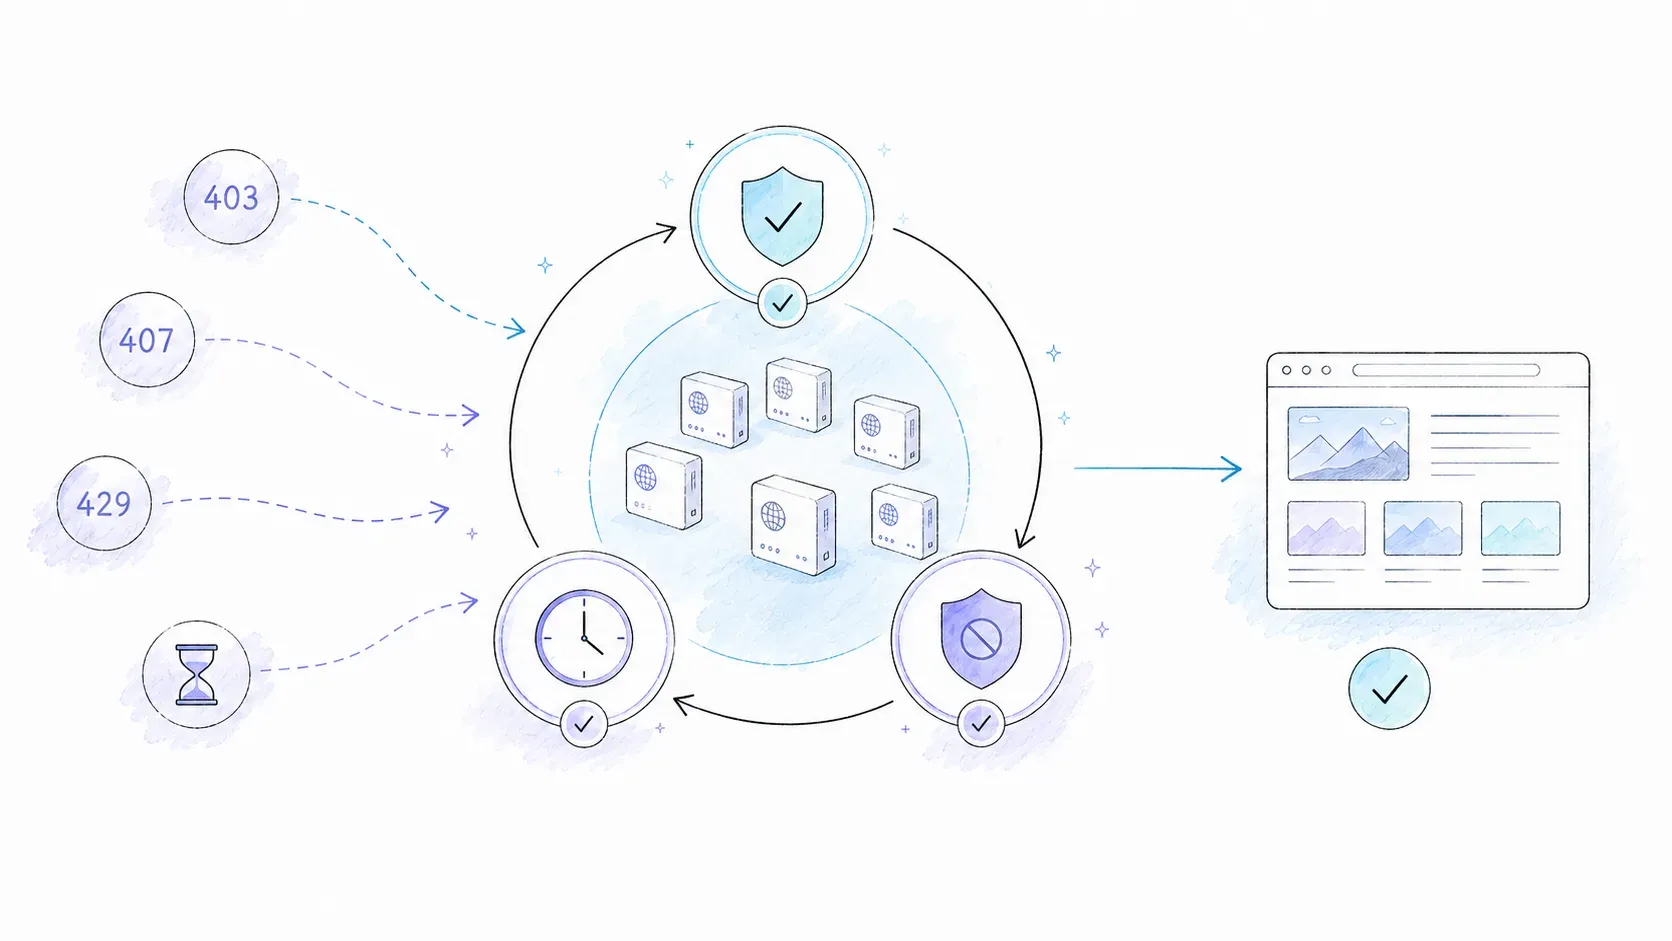
Большинство инструкций заканчиваются в тот момент, когда happy path начинает работать. В реальности скрапинг ломается постоянно — прокси умирают, у credentials истекает срок действия, сайт начинает ограничивать вас посреди процесса — и ничего из этого не лечится надеждой на лучшее.
Retry-логика с экспоненциальной задержкой и jitter
function backoffMs(attempt, base = 1000, cap = 30_000) {
  const exponential = Math.min(cap, base * 2 ** attempt);
  return Math.floor(exponential * (0.5 + Math.random() * 0.5)); // jitter помогает избежать одновременных повторов
}

async function withRetry(fn, maxRetries = 4) {
  for (let attempt = 0; attempt <= maxRetries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === maxRetries) throw err;
      const delay = backoffMs(attempt);
      console.warn(`Попытка ${attempt + 1} не удалась: ${err.message}. Повтор через ${delay} мс`);
      await new Promise((r) => setTimeout(r, delay));
    }
  }
}
Автоматическая блокировка прокси с ошибками
const proxyStats = new Map(); // proxyUrl -> { success, failure }

function recordResult(proxyUrl, success) {
  const stats = proxyStats.get(proxyUrl) || { success: 0, failure: 0 };
  success ? stats.success++ : stats.failure++;
  proxyStats.set(proxyUrl, stats);
}

function isHealthy(proxyUrl) {
  const stats = proxyStats.get(proxyUrl);
  if (!stats) return true;
  const total = stats.success + stats.failure;
  if (total < 5) return true; // данных пока недостаточно
  return stats.failure / total < 0.5; // blacklist, если доля ошибок выше 50%
}

function getHealthyProxy(pool) {
  const healthy = pool.filter(isHealthy);
  if (healthy.length === 0) throw new Error('В пуле не осталось здоровых прокси');
  return healthy[Math.floor(Math.random() * healthy.length)];
}
Отслеживайте не просто факт успеха или провала, а тип ошибки — 407 (неверные credentials) и 429 (ограничение по частоте) требуют совершенно разных действий. Если прокси падает на авторизации, бессмысленно молотить его частыми повторными попытками: вы просто тратите время. Решение — проверить credentials, а не ускорять ротацию.
Как устранить распространённые ошибки rotating proxy в Puppeteer
| Ошибка | Вероятная причина | Что делать |
|---|---|---|
ERR_PROXY_CONNECTION_FAILED | Прокси недоступен или не отвечает | Уберите его из пула и повторите с другим |
407 Proxy Authentication Required | Неверные credentials или неподдерживаемая схема авторизации | Проверьте данные для page.authenticate(); для авторизации в URL используйте proxy-chain |
TimeoutError | Медленный прокси или блокировка со стороны сайта | Увеличьте таймаут; переключитесь на residential proxy |
403 Forbidden | IP или fingerprint помечен как подозрительный | Ротация прокси + stealth + рандомизация UA |
ERR_TUNNEL_CONNECTION_FAILED | Проблема с HTTPS-туннелем | Проверьте поддержку метода CONNECT; попробуйте локальный туннель через proxy-chain |
Есть и несколько важных нюансов, которые не помещаются в таблицу: код 200 не означает, что всё прошло успешно. Мягкие блокировки часто возвращают полностью сформированную HTML-страницу — страницу входа или challenge screen — с обычным статус-кодом, поэтому проверяйте реальное содержимое, а не только статус ответа. А если вы застряли, руководство Puppeteer по отладке советует запускать браузер с headless: false, добавить slowMo и включить NODE_DEBUG="puppeteer:*", чтобы получить подробные protocol-логи — но помните, что эти логи могут содержать чувствительные данные запросов, так что не оставляйте их включёнными рядом с production-credentials.
Самостоятельная ротация прокси vs gateway vs AI Extraction API
| Критерий | Самостоятельная ротация списка | Backconnect Gateway (Bright Data, Oxylabs, Decodo) | AI Extraction API (Thunderbit) |
|---|---|---|---|
| Стоимость при небольшом объёме | Низкая–средняя | Средняя–высокая за GB | Низкая (есть free tier, затем оплата за единицу) |
| Надёжность | Зависит от ваших health-check'ов | Высокая (управляется провайдером) | Высокая (управляемая инфраструктура) |
| Антидетект | DIY — вы строите сами | Частично (только ротация IP) | Встроено |
| Структурированный вывод | Нет (сырой HTML) | Нет (сырой HTML) | Да (JSON по schema) |
| Время на запуск | Часы | Минуты | Минуты |
| Контроль | Полный | Ограничен API провайдера | Ограничен моделью schema |
Актуальные цены у провайдеров (проверено 2026-08-07) помогают понять стоимость gateway-подхода: Bright Data предлагает residential pricing по модели pay-as-you-go и объёмные планы, а акции могут меняться; Oxylabs показывает $6/GB при 5 GB и $2.50/GB при 1 TB; Decodo (ранее Smartproxy) указывает $3.75/GB при 3 GB, $2.75/GB при 100 GB и pay-as-you-go за $4/GB. Decodo также заявляет пул более чем из 115M IP и success rate 99.92% — это заявления провайдера, а не независимо подтверждённые бенчмарки.
Мой реальный decision tree такой: вам нужно взаимодействовать со страницей — кликать, скроллить, заполнять формы, хранить логин-сессию? Тогда стройте решение на Puppeteer и прокси. Вам нужны только данные, уже находящиеся на странице? Сначала посмотрите на extraction API, прежде чем собирать инфраструктуру прокси, которую потом придётся обслуживать вечно.
Когда Puppeteer + прокси — это перебор: лучше извлекать структурированные данные через API
Где-то после третьего раза, когда мне пришлось заново собирать систему health-check'ов для проекта, которому в таблице нужны были просто цены товаров, до меня дошло: большая часть этой инфраструктуры существует ради решения задачи, которой на самом деле не является целью разработчика — получения сырого HTML со страницы. Настоящая цель — структурированные данные. HTML — это просто неудобный промежуточный формат.
Thunderbit Open API рассматривает извлечение как основную операцию, а не как побочный эффект браузерной автоматизации. POST /extract принимает URL и JSON Schema и возвращает структурированные данные по совпадениям — при этом рендеринг JS, антибот-механизмы и CAPTCHA обрабатываются на backend, а не остаются на вашей стороне вместе с настройкой stealth-плагинов и пулов прокси:
curl -X POST https://openapi.thunderbit.com/openapi/v1/extract \
  -H "Authorization: Bearer $THUNDERBIT_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://example.com/product",
    "schema": {
      "type": "object",
      "properties": {
        "name": {"type": "string"},
        "price": {"type": "number"}
      },
      "required": ["name", "price"]
    }
  }'
Есть и endpoint POST /distill для случаев, когда вам нужен просто чистый Markdown вместо строгой схемы, а также пакетное извлечение, чтобы прогонять одну и ту же schema по нескольким URL за один запрос. Согласно текущему прайсу Thunderbit API, Distill стоит 1 unit за страницу, а Extract — 20 units за страницу; в free tier включено 600 разовых units, этого достаточно, чтобы проверить рабочий процесс до принятия решения о внедрении.
Для разработчиков, работающих в Claude, Cursor или другом MCP-совместимом клиенте, Thunderbit также предоставляет инструменты thunderbit_extract и thunderbit_distill как MCP tools, позволяя агенту на ходу решать, когда нужно забрать данные со страницы, а не запускать отдельный шаг скрапинга. Я бы всё же проверил актуальную API reference перед подключением MCP, потому что названия инструментов и параметры могут меняться между версиями документации.
| Критерий | Puppeteer + rotating proxies | Thunderbit API |
|---|---|---|
| Сложность настройки | Высокая — пул прокси, логика ротации, stealth, retries | Низкая — один API-запрос с JSON Schema |
| Обработка антибота | Вручную | Встроена |
| Вывод | Сырой HTML (нужен парсинг) | Структурированный JSON по вашей схеме |
| Поддержка | Высокая — ломаются селекторы, умирают прокси | Низкая |
| Лучше всего для | Кастомная автоматизация, логин-флоу, нишевые сценарии | Извлечение данных в масштабе |
Будем справедливы к DIY-пути: если вам нужно логиниться в аккаунт, проходить многошаговый сценарий или сохранять состояние между шагами, extraction API обычно не заменит такой процесс — FAQ Thunderbit прямо говорит, что интерактивные login flow через API сейчас не поддерживаются. В таких задачах Puppeteer с прокси всё ещё выигрывает. Но если задача звучит как «забрать данные с нескольких публичных страниц в схему, которую я сам задаю», то собственная прокси-ротация решает проблему сложнее, чем она есть на самом деле. Для команд, которые хотят вообще обойтись без кода, расширение Thunderbit для Chrome предлагает то же AI-извлечение через интерфейс point-and-click — стоит посмотреть, если вы выбираете между no-code web scraping и полноценной developer-архитектурой.
Выводы и ключевые тезисы
Ротация прокси в Puppeteer — это не одна техника. Ротация на уровне браузера проста и изолирована. Авторизованный backconnect gateway может менять выходные IP за одним браузерным endpoint. Для тонкой маршрутизации на уровне запросов или одновременных идентичностей нужны browser sharding или внешнее реле; сам по себе request interception не меняет сетевой маршрут Chrome.
Но без остального стека всё это мало что даёт. Прокси решают проблему репутации IP; stealth-плагины и согласованный fingerprint — проблему браузерных сигналов; jitter и корректный темп — проблему поведения. Уберите любой слой, и вас всё равно могут заблокировать, просто по другой причине.
Если вы собираете это сами, начните с репозитория proxy-chain и кода выше — они помогут продвинуться дальше, чем большинство платных курсов. Если же вы хотите вообще не управлять прокси и просто получать структурированные данные, документацию Thunderbit API стоит прочитать за десять минут, прежде чем вы потратите выходные на инфраструктуру health-check'ов, которую потом придётся обслуживать годами. Оба пути легитимны — главное, чтобы вы решали ту задачу, которая у вас действительно есть, а не ту, которую предполагает каждый туториал. Для более широкого взгляда на то, как AI меняет эту сферу, посмотрите наш разбор AI web scraping и то, чем он отличается от традиционных подходов.
Частые вопросы
Как часто нужно ротировать прокси в Puppeteer?
Это зависит от того, насколько жёстко целевой сайт ограничивает частоту. Для сайтов со строгим антиботом ротируйте на каждую страницу или на каждую сессию. Для более мягких сайтов может хватить ротации на сессию или даже одного sticky IP на весь прогон. Универсального числа нет — используйте 403, 429 и таймауты как сигнал, что ротировать нужно агрессивнее, а не как фиксированный счётчик запросов.
Можно ли использовать бесплатные прокси для скрапинга в Puppeteer?
Технически да, но я бы не советовал это ни для чего, кроме быстрых тестов. Бесплатные списки прокси обычно медленные, ненадёжные и часто уже заблокированы сайтами, которые вы хотите скрапить. Для production-задач residential-прокси у платного провайдера или управляемый gateway почти всегда оправдывают стоимость.
Работает ли puppeteer-extra-plugin-stealth против всех антибот-систем?
Нет, и документация самого плагина говорит об этом прямо. Он уменьшает часть типичных признаков headless Chrome, но сайт всё равно может анализировать репутацию сети, TLS-характеристики, cookies, client hints и поведение. Воспринимайте плагин как один из слоёв совместимости, а не как гарантию.
В чём разница между proxy-chain и --proxy-server в Puppeteer?
--proxy-server — это нативный флаг запуска Chromium, который назначает один endpoint прокси всему экземпляру браузера, и Chrome не принимает там встроенные credentials. proxy-chain создаёт локальный анонимный туннель к авторизованному upstream. Ротация затем происходит через запуск с другим upstream, provider-managed backconnect gateway или отдельное внешнее реле — но не через то, что proxy-chain назначает прокси отдельным страницам Puppeteer.
Достаточно ли ротации прокси, чтобы полностью избежать блокировок?
Нет — и это самое распространённое заблуждение. Современные антибот-системы, такие как bot management Cloudflare, сопоставляют репутацию IP с fingerprint браузера, поведенческими паттернами и историей сессии. Прокси решают только часть, связанную с репутацией IP; чтобы не попасть под другие сигналы, вам всё ещё нужны stealth-настройки, согласованный fingerprint и реалистичный темп.
Узнать больше



