
На панели OpenRouter я увидел, что к обеду вторника уже потратил $47. За это время я успел выполнить, может быть, с десяток задач по коду — ничего экстремального, просто немного рефакторинга и несколько исправлений багов. Именно тогда я понял, что настройки OpenClaw по умолчанию тихо прогоняют через Claude Opus по $15+ за миллион токенов вообще каждое взаимодействие, включая фоновые heartbeat-пинги.
Если вы сталкивались с похожими сюрпризами — а судя по форумам, таких людей немало («Я уже потратил 40 долларов и почти не пользовался», — написал один пользователь) — этот гайд проведёт вас через полный подход к аудиту и оптимизации, который помог мне сократить ежемесячные расходы примерно на 90%. И речь не просто о том, чтобы «переключиться на более дешёвую модель», а о системном разборе того, куда реально уходят токены, как за ними следить, какие бюджетные модели действительно годятся для агентной работы и какие три готовых конфига можно вставить уже сегодня. На всё ушёл один день.
Что такое расход токенов в OpenClaw и почему он такой высокий по умолчанию?
Токены — это единица тарификации для любого AI-взаимодействия в OpenClaw. Проще говоря, это небольшие фрагменты текста — примерно 4 английских символа на токен. Каждое отправленное вами сообщение, каждый полученный ответ, каждый фоновый процесс — всё считается в токенах.
Проблема в том, что настройки OpenClaw по умолчанию заточены под максимальные возможности, а не под минимальную стоимость. Сразу после установки основная модель выставлена как anthropic/claude-opus-4-5 — самый дорогой доступный вариант. Heartbeat-пинги? Тоже идут через Opus. Суб-агенты, которые поднимаются для побочных задач? Тоже Opus. Использовать Opus для heartbeat-пинга — это как нанимать нейрохирурга, чтобы приклеить пластырь. Формально работает, но стоит катастрофически дорого.
Большинство пользователей не понимают, что платят премиум-тариф за тривиальные фоновые задачи. Конфигурация по умолчанию по сути предполагает, что вам нужна лучшая модель для всего и всегда — и выставляет счёт соответственно.
Почему снижение расхода токенов в OpenClaw экономит не только деньги
Очевидная выгода — это экономия бюджета. Но есть и вторичные плюсы, которые со временем только усиливаются.
Более дешёвые модели часто ещё и быстрее. Gemini 2.5 Flash-Lite работает примерно со скоростью 214 токенов в секунду против примерно 51 у Opus — то есть в 4 раза быстрее на каждом запросе. GPT-OSS-120B на Cerebras выдаёт 1,917 токенов в секунду — это примерно в 35 раз быстрее, чем Opus. В агентном цикле с 50+ раундами вызовов инструментов такая разница означает завершение работы за минуты, а не ожидание мучительных 13.6 секунды до первого токена у Opus при каждом обмене.
Ещё вы получаете больший запас до упора в rate limit, меньше зависших сессий и больше пространства для масштабирования без роста тревоги из-за счёта.
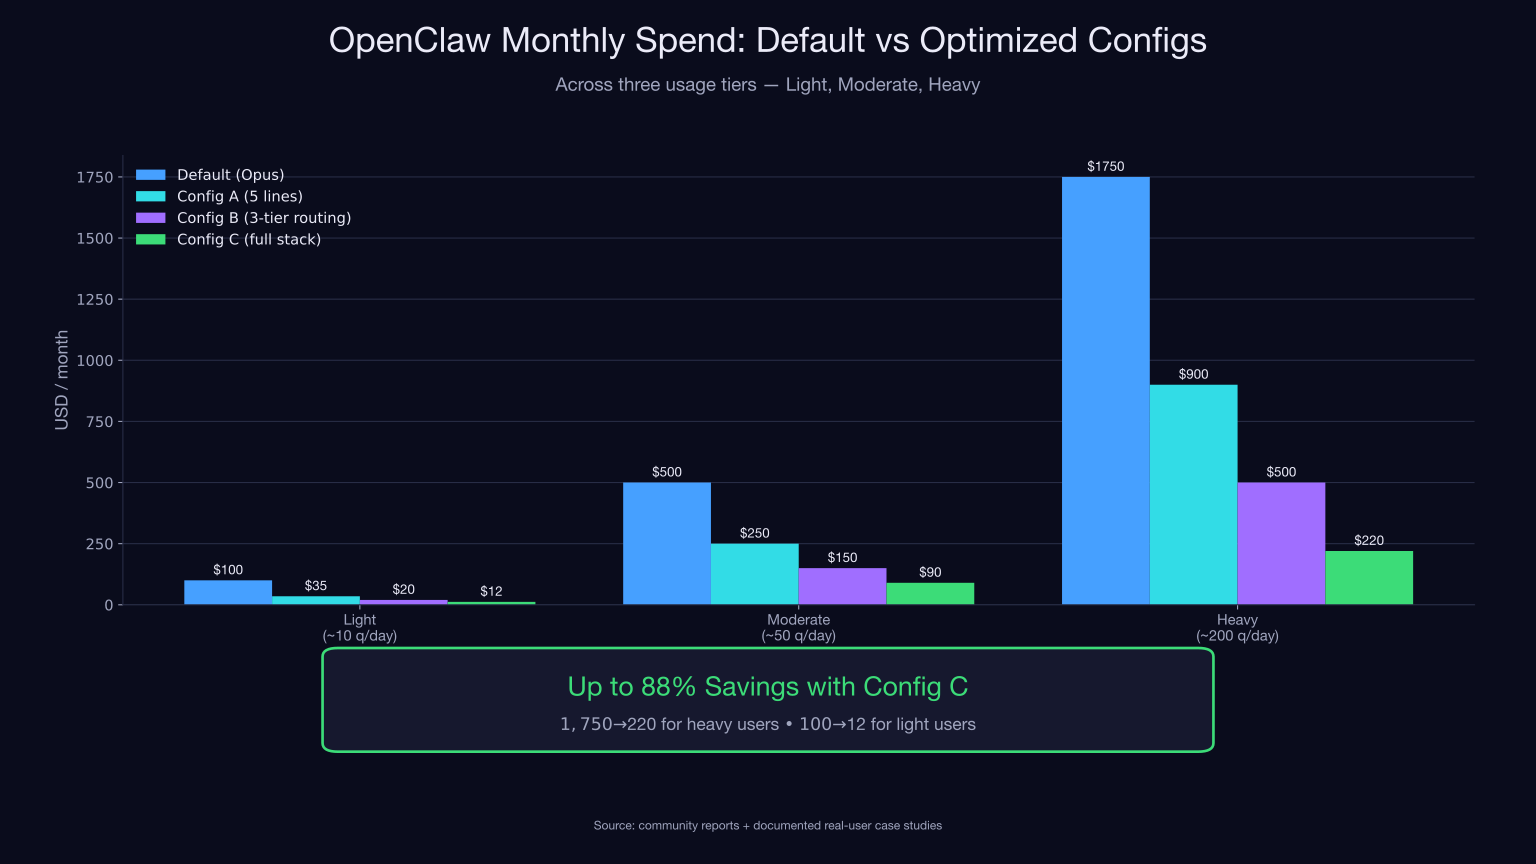
Прогноз экономии по разным профилям использования:
| Профиль пользователя | Оценочные месячные расходы (по умолчанию) | После полной оптимизации | Ежемесячная экономия |
|---|---|---|---|
| Лёгкий (~10 запросов/день) | ~$100 | ~$12 | ~88% |
| Средний (~50 запросов/день) | ~$500 | ~$90 | ~82% |
| Активный (~200+ запросов/день) | ~$1,750 | ~$220 | ~87% |
Это не гипотетика. Один разработчик задокументировал, как он снизил расходы с $600–750 в месяц до $3–4 в день — реальное сокращение на 90% — благодаря сочетанию маршрутизации моделей и исправлению скрытых утечек, о которых я расскажу ниже.
Из чего складывается расход токенов в OpenClaw: куда на самом деле уходит каждый токен
Это тот раздел, который большинство гайдов пропускает, хотя он самый важный. Нельзя исправить то, чего не видно.
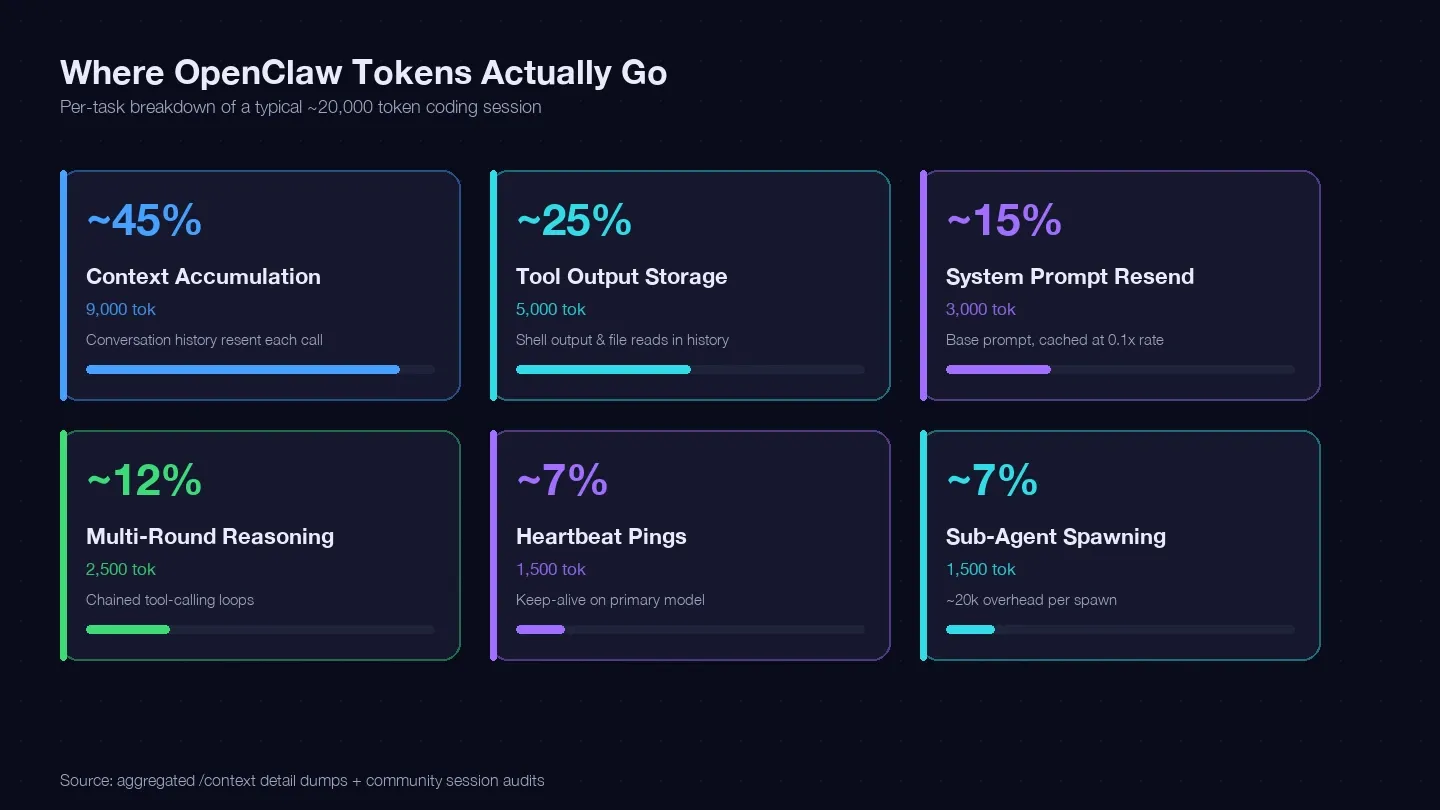
Я провёл аудит нескольких сессий и сопоставил результаты с гайдом по оптимизации затрат LaoZhang и дампами /context из сообщества, чтобы собрать токенный баланс для типичной одной задачи по коду. Вот куда примерно ушло 20,000 токенов:
| Категория токенов | Типичная доля от общего объёма | Пример (1 задача по коду) | Можно ли контролировать? |
|---|---|---|---|
| Накопление контекста (история переписывается заново при каждом вызове) | ~40–50% | ~9,000 токенов | Да — /clear, /compact, более короткие сессии |
| Хранение вывода инструментов (вывод shell, чтение файлов, которое остаётся в истории) | ~20–30% | ~5,000 токенов | Да — более короткие чтения, более узкий scope инструментов |
| Повторная отправка системного промпта (~15K базово) | ~10–15% | ~3,000 токенов | Частично — cache reads по ставке 0.1x |
| Многошаговое рассуждение (цепочки вызовов инструментов) | ~10–15% | ~2,500 токенов | Выбор модели + более удачные промпты |
| Heartbeat / keep-alive пинги | ~5–10% | ~1,500 токенов | Да — изменение конфига |
| Вызовы суб-агентов | ~5–10% | ~1,500 токенов | Да — маршрутизация моделей |
Самая большая статья — накопление контекста — это ваша история диалога, которая пересылается заново при каждом API-вызове. Один реальный дамп сессии показал 185,400 токенов только в bucket Messages — при том, что модель ещё даже не начала отвечать. Системный промпт и инструменты добавили сверху ещё примерно 35,800 токенов фиксированных накладных расходов.
Вывод: если вы не очищаете сессии между несвязанными задачами, вы платите за повторную передачу всей истории переписки на каждом шаге.
Как отслеживать расход токенов в OpenClaw (сократить можно только то, что видно)
Прежде чем что-то менять, нужно понять, куда уходят токены. Переходить сразу к «более дешёвой модели» без мониторинга — это как пытаться похудеть, ни разу не встав на весы.
Проверьте панель OpenRouter
Если вы маршрутизируете запросы через OpenRouter, страница Activity — самый простой дашборд без настройки. Там можно фильтровать по модели, провайдеру, API-ключу и периоду времени. В разделе Usage Accounting есть разбивка по prompt, completion, reasoning и cached tokens для каждого запроса. Также есть кнопка Export (CSV или PDF) для более длинного анализа.
На что смотреть: какая модель съела больше всего токенов и не появляются ли heartbeat или sub-agent запросы как неожиданно крупные статьи расходов.
Проверьте локальные API-логи
OpenClaw хранит данные сессий в ~/.openclaw/agents.main/sessions/sessions.json, где есть totalTokens по каждой сессии. Ещё можно запустить openclaw logs --follow --json для live-логирования по каждому запросу.
Есть важный нюанс: sessions.json totalTokens не обновляется после compaction, поэтому в дашборде могут отображаться устаревшие значения до compaction. В таких случаях доверяйте /status и /context detail, а не сохранённым итогам.
Используйте сторонний трекинг (для средних и активных пользователей)
LiteLLM proxy даёт OpenAI-совместимую точку входа перед 100+ провайдерами и автоматически логирует расходы по виртуальному ключу, модели, пользователю и команде. Главная фишка — жёсткие бюджеты на ключ, которые переживают /clear: вышедший из-под контроля sub-agent не сможет пробить установленный лимит.
Helicone ещё проще — замена base URL в одну строку, которая даёт представление Sessions, группирующее связанные запросы. Один промпт «исправь этот баг», распадающийся на 8+ вызовов sub-agent, отображается как одна строка сессии с реальной итоговой стоимостью. Бесплатный тариф: 10,000 запросов в месяц.
Быстрые проверки прямо в OpenClaw
Для повседневного контроля достаточно четырёх команд внутри сессии:
/status— показывает использование контекста, последние токены input/output и оценку стоимости/usage full— футер с usage для каждого ответа/context detail— разбивка токенов по файлам, навыкам и инструментам/compact [guidance]— принудительный compaction с необязательной строкой фокуса
Запускайте /context detail до и после изменения конфигурации. Так вы поймёте, действительно ли оптимизация сработала.
Битва за самую дешёвую модель OpenClaw: какие бюджетные LLM реально тянут агентную работу
Большинство гайдов ошибаются именно здесь. Они показывают таблицу цен, указывают на самую дешёвую строку и считают, что вопрос закрыт. Но бенчмарки плохо предсказывают реальную агентную работу — и сообщество говорит об этом громко и регулярно. Как выразился один пользователь: «бенчмарки вообще не помогают понять, что лучше работает для agentic AI».
Ключевая мысль: самая дешёвая модель не всегда даёт самую дешёвую итоговую стоимость. Модель, которая падает и делает четыре повторных попытки, обходится дороже, чем модель среднего уровня, которая успешно справляется с первого раза. В production-агентах нужно закладывать 5–10% retry rate — а если пять LLM-вызовов связаны цепочкой и ломается шаг четыре, наивный retry заново прогонит все пять шагов.
Ниже — моя матрица возможностей, где указан «Real Agentic Score» на основе реальных отзывов пользователей, а не синтетических бенчмарков:
| Модель | Input $/1M | Output $/1M | Надёжность tool-calling | Многошаговое рассуждение | Real Agentic Score (1–5) | Лучше всего подходит для |
|---|---|---|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | Смешанная — иногда зацикливается | Базовый уровень | ⭐2.5 | Heartbeat, простые запросы |
| GPT-OSS-120B | $0.04 | $0.19 | Достаточная | Достаточная | ⭐3.0 | Бюджетные эксперименты, задачи, где важна скорость |
| DeepSeek V3.2 | $0.26 | $0.38 | Нестабильная (6 открытых issue) | Хорошая | ⭐3.0 | Сильное рассуждение, минимум tool calling |
| Kimi K2.5 | $0.38 | $1.72 | Хорошая (через :exacto) | Достаточная | ⭐3.5 | Простое и среднее кодирование |
| MiniMax M2.5 / M2.7 | $0.28 | $1.10 | Хорошая | Хорошая | ⭐4.0 | Ежедневная рабочая лошадка для кода |
| Claude Haiku 4.5 | $1.00 | $5.00 | Отличная | Хорошая | ⭐4.5 | Надёжный запасной вариант среднего уровня |
| Claude Sonnet 4.6 | $3.00 | $15.00 | Отличная | Отличная | ⭐5.0 | Сложные многошаговые задачи |
| Claude Opus 4.5/4.6 | $5.00 | $15.00 | Отличная | Отличная | ⭐5.0 | Только для самых сложных проблем |
Предупреждение о DeepSeek и Gemini Flash для tool calling
На бумаге DeepSeek V3.2 выглядит отлично — 72–74% на SWE-Bench, в 11–36 раз дешевле Sonnet. Но на практике шесть отдельных GitHub issue в Cline, Roo Code, Continue и NVIDIA NIM документируют сломанное поведение при вызове инструментов. Итог Composio в сравнении лоб-в-лоб: «DeepSeek V3.2 собрал части приложения, но споткнулся на выполнении, скорости и надёжности». А короткая оценка Zvi Mowshowitz звучит так: «okay and cheap, but».
У Gemini 2.5 Flash похожая проблема. В треде на Google AI Developers Forum под названием «Very frustrating experience with Gemini 2.5 function calling performance» уже в первом сообщении говорится: «поведение function calling у моделей Gemini стало совершенно ненадёжным и непредсказуемым».
OpenRouter отдельно указал на важную деталь: «склонность модели вызывать инструменты и точность этих вызовов могут резко меняться у разных хостов с одинаковыми весами». Если вы гоняете дешёвые модели через OpenRouter, ищите тег :exacto — незаметная смена провайдера может за ночь превратить надёжную дешёвую модель в дорогой цикл повторных попыток.
Когда использовать каждую модель
- Gemini Flash-Lite: heartbeat, keep-alive пинги, простые вопросы и ответы. Не для многошагового tool calling.
- MiniMax M2.5/M2.7: ваша ежедневная модель для обычных задач по коду. SWE-Pro 56.22, Terminal-Bench 2 57.0% при цене в разы ниже Sonnet.
- Claude Haiku 4.5: надёжный запасной вариант, когда дешёвые модели не справляются с вызовами инструментов. Отличная надёжность tool calling примерно в 3 раза дешевле Sonnet.
- Claude Sonnet 4.6: сложная многошаговая агентная работа. Здесь он окупает себя.
- Claude Opus: только для самых тяжёлых задач. Не делайте его моделью по умолчанию ни для чего.
(Цены на модели меняются часто — перед настройкой обязательно проверьте актуальные тарифы на OpenRouter или на страницах провайдеров.)
Скрытые утечки токенов, которые большинство гайдов пропускают
Пользователи на форумах пишут, что отключение отдельных функций заметно снижает расходы, но я не нашёл ни одного гайда с единым чеклистом всех скрытых утечек и их реальным влиянием на токены. Полный разбор:
| Скрытая утечка | Стоимость в токенах за один случай | Как исправить | Ключ конфигурации |
|---|---|---|---|
| Heartbeat по умолчанию через Opus | ~100,000 токенов за запуск без изоляции | переопределение на Haiku + isolatedSession | heartbeat.model, heartbeat.isolatedSession: true |
| Запуск sub-agent | ~20,000 токенов на запуск ещё до начала работы | направить sub-agent на Haiku | subagents.model |
| Загрузка полного контекста кодовой базы | ~3,000–15,000 токенов на авто-обход | .clawignore для node_modules, dist, lock-файлов | .clawrules + .clawignore |
| Автосуммаризация памяти | ~500–2,000 токенов за сессию | отключить или уменьшить частоту | memory: false или memory.max_context_tokens |
| Накопление истории диалога | ~500+ токенов за ход (накопительно) | начинать новые сессии между несвязанными задачами | дисциплина /clear |
| Накладные расходы MCP server | ~7,000 токенов для 4 серверов; 50,000+ для 5+ | держать MCP по минимуму | убрать неиспользуемые MCP |
| Инициализация skills/plugins | 200–1,000 токенов на загруженный skill | отключить неиспользуемые навыки | skills.entries.<name>.enabled: false |
| Agent Teams (режим plan) | ~7x стандартной стоимости сессии | использовать только для реально параллельной работы | по возможности последовательный режим |
Отдельно стоит сказать про heartbeat-утечку. По умолчанию heartbeat запускается на основной модели (Opus) каждые 30 минут. Если поставить isolatedSession: true, это снижает расход примерно со 100,000 токенов за запуск до 2,000–5,000 токенов — то есть сокращение на 95–98% только в одной категории.
Три быстрых улучшения, которые экономят больше всего токенов менее чем за две минуты
Все три почти безрисковые и занимают меньше двух минут:
-
/clearмежду несвязанными задачами (5 секунд). Это самый мощный способ экономии токенов. По общему мнению на форумах, одно только очищение истории перед новой работой даёт 50–70% сокращения. Помните bucket Messages на 185k токенов из /context dump?/clearстирает его. -
/model haiku-4.5для рутинной работы (10 секунд). Тактическое переключение моделей даёт 60–80% экономии на повседневных задачах. Haiku отлично справляется с простым кодом, поиском по файлам и сообщениями для коммита. -
Сократите
.clawrulesдо <200 строк и добавьте.clawignore(90 секунд). Файл правил загружается при каждом сообщении. На 200 строк это примерно 1,500–2,000 токенов за ход; на 1,000 строк — уже 8,000–10,000 токенов постоянной нагрузки на каждый запрос. В сочетании с.clawignore, где исключеныnode_modules/,dist/, lock-файлы и сгенерированный код, один разработчик заявил о 92% сокращении расхода токенов только за счёт такой дисциплины.
Пошагово: три готовых к копированию конфига, чтобы резко снизить расход токенов OpenClaw
Ниже — три полностью готовые, снабжённые комментариями конфигурации openclaw.json, от варианта «просто начать экономить» до «полный стек оптимизации». У каждой есть inline-комментарии и оценка месячной стоимости.
Перед началом:
- Уровень сложности: новичок (Config A) → средний (Config B) → продвинутый (Config C)
- Время: около 5 минут для Config A, около 15 минут для Config C
- Что понадобится: установленный OpenClaw, текстовый редактор, доступ к
~/.openclaw/openclaw.json
Config A: новичок — просто сэкономить деньги
Пять строк. Никакой сложности. Меняет модель по умолчанию с Opus на Sonnet, отключает накладные расходы памяти и изолирует heartbeat через Haiku.
// ~/.openclaw/openclaw.json
{
  "agents": {
    "defaults": {
      "model": { "primary": "anthropic/claude-sonnet-4-6" },  // был Opus — мгновенная экономия 3–5x
      "heartbeat": {
        "every": "55m",                // подгонка под TTL кэша 1h для максимума cache hit
        "model": "anthropic/claude-haiku-4-5",  // Haiku для пингов, не Opus
        "isolatedSession": true        // ~100k → 2–5k токенов за запуск
      }
    }
  },
  "memory": { "enabled": false }       // экономит ~500–2k токенов/сессию
}
Что должно измениться после применения: запустите /status до и после. Стоимость каждого запроса должна заметно снизиться, а heartbeat-записи в OpenRouter Activity должны показывать Haiku вместо Opus.
| Уровень использования | По умолчанию (Opus) | Config A (Sonnet + Haiku heartbeat) | Экономия |
|---|---|---|---|
| Лёгкий (~10 запросов/день) | ~$100 | ~$35 | 65% |
| Средний (~50 запросов/день) | ~$500 | ~$250 | 50% |
| Активный (~200 запросов/день) | ~$1,750 | ~$900 | 49% |
Config B: средний уровень — умная маршрутизация по трём уровням
Основная Sonnet для реальной работы. Haiku для sub-agent и compaction. Gemini Flash-Lite как бюджетный fallback, если Claude перегружен. Цепочки fallback автоматически обрабатывают сбои провайдера.
{
  "agents": {
    "defaults": {
      "model": {
        "primary": "anthropic/claude-sonnet-4-6",
        "fallbacks": [
          "anthropic/claude-haiku-4-5",       // если Sonnet перегружен
          "google/gemini-2.5-flash-lite"      // ультрадешёвый последний резерв
        ]
      },
      "models": {
        "anthropic/claude-sonnet-4-6": {
          "params": { "cacheControlTtl": "1h", "maxTokens": 8192 }
        }
      },
      "heartbeat": {
        "every": "55m",                       // 55 мин < TTL кэша 1h = cache hits
        "model": "google/gemini-2.5-flash-lite",  // копейки за пинг
        "isolatedSession": true,
        "lightContext": true                   // минимальный контекст в heartbeat-вызовах
      },
      "subagents": {
        "maxConcurrent": 4,                   // вместо стандартных 8
        "model": "anthropic/claude-haiku-4-5" // sub-agent не нужен Sonnet
      },
      "compaction": {
        "mode": "safeguard",
        "model": "anthropic/claude-haiku-4-5", // суммаризация compaction через Haiku
        "memoryFlush": { "enabled": true }
      }
    }
  }
}
Ожидаемый результат: в логах sub-agent теперь должны отображаться по цене Haiku. Heartbeat практически ничего не стоит. Цепочка fallback позволяет не останавливать сессию при сбое Claude — она мягко переходит на Gemini.
| Уровень использования | По умолчанию | Config B | Экономия |
|---|---|---|---|
| Лёгкий | ~$100 | ~$20 | 80% |
| Средний | ~$500 | ~$150 | 70% |
| Активный | ~$1,750 | ~$500 | 71% |
Config C: power user — полный стек оптимизации
Отдельная модель для каждого sub-agent, compaction контекста закреплена за Haiku, маршрутизация vision-задач на Gemini Flash, жёсткий .clawrules + .clawignore, отключение неиспользуемых skills. Это конфиг, который выводит вас в диапазон 85–90% экономии.
{
  "agents": {
    "defaults": {
      "workspace": "~/clawd",
      "model": {
        "primary": "anthropic/claude-sonnet-4-6",
        "fallbacks": [
          "openrouter/anthropic/claude-sonnet-4-6",  // другой провайдер как резерв
          "minimax/minimax-m2-7",                     // дешёвая ежедневная запасная модель
          "anthropic/claude-haiku-4-5"                // последний резерв
        ]
      },
      "models": {
        "anthropic/claude-sonnet-4-6": {
          "params": { "cacheControlTtl": "1h", "maxTokens": 8192 }
        },
        "minimax/minimax-m2-7": {
          "params": { "maxTokens": 8192 }
        }
      },
      "heartbeat": {
        "every": "55m",
        "model": "google/gemini-2.5-flash-lite",
        "isolatedSession": true,
        "lightContext": true,
        "activeHours": "09:00-19:00"           // ночью без heartbeat
      },
      "subagents": {
        "maxConcurrent": 4,
        "model": "anthropic/claude-haiku-4-5"
      },
      "contextPruning": { "mode": "cache-ttl", "ttl": "1h" },
      "compaction": {
        "mode": "safeguard",
        "model": "anthropic/claude-haiku-4-5",
        "identifierPolicy": "strict",
        "memoryFlush": { "enabled": true }
      },
      "bootstrapMaxChars": 12000,              // вместо стандартных 20000
      "imageModel": "google/gemini-3-flash"    // vision-задачи через дешёвую модель
    }
  },
  "memory": { "enabled": true, "max_context_tokens": 800 },  // минимальная память
  "skills": {
    "entries": {
      "web-search":       { "enabled": false },
      "image-generation": { "enabled": false },
      "audio-transcribe": { "enabled": false }
    }
  }
}
Пример переопределения для конкретного sub-agent — вставьте в ~/.openclaw/agents/lint-runner/SOUL.md:
---
name: lint-runner
description: Выполняет lint/format проверки и вносит тривиальные исправления
tools: [Bash, Read, Edit]
model: anthropic/claude-haiku-4-5
---
Минимально достаточный .clawignore — уже он один сокращает типичный bootstrap с 150k символов примерно до 30–50k:
node_modules/
dist/
build/
.next/
coverage/
.venv/
vendor/
*.lock
package-lock.json
yarn.lock
pnpm-lock.yaml
*.min.js
*.min.css
**/__snapshots__/
**/*.snap
| Уровень использования | По умолчанию | Config C | Экономия |
|---|---|---|---|
| Лёгкий | ~$100 | ~$12 | 88% |
| Средний | ~$500 | ~$90 | 82% |
| Активный | ~$1,750 | ~$220 | 87% |
Эти цифры совпадают с двумя независимыми отчётами реальных пользователей: у Praney Behl зафиксировано снижение с $600–750/мес до $3–4/день (на 90%), а кейсы LaoZhang показывают $943 → $347 (63%), $1,750 → $1,000 (64%), $200 → $70 (65%) при частичной оптимизации.
Как использовать команду /model, чтобы управлять расходом токенов OpenClaw на лету
Команда /model переключает активную модель для следующего хода, при этом сохраняется весь контекст разговора — без сброса и без потери истории. Это ежедневная привычка, которая накапливает экономию со временем.
Практический workflow:
- Делаете тяжёлый многофайловый рефакторинг? Оставайтесь на Sonnet.
- Нужно быстро спросить «что делает вот эта regex»?
/model haiku, задайте вопрос, потом/model sonnetи вернитесь обратно. - Нужен комментарий к коммиту или полировка документации?
/model flash-lite, и готово.
В openclaw.json можно настроить алиасы в commands.aliases, чтобы короткие имена (haiku, sonnet, opus, flash) сопоставлялись с полными строками провайдера. Экономит несколько нажатий клавиш при каждом переключении.
Математика простая: 50 запросов в день на Sonnet — это примерно $3 в день. Те же 50 запросов, распределённые в пропорции 70/20/10 между Haiku/Sonnet/Opus, — это около $1.10 в день. За месяц это $90 → $33 — на 63% дешевле без смены инструментов, только за счёт привычек.
Бонус: как отслеживать цены моделей OpenClaw у разных провайдеров с помощью Thunderbit
Отслеживайте цены моделей у разных провайдеров с помощью AI Get Started Free
Когда моделей и провайдеров так много — OpenRouter, прямой API Anthropic, Google AI Studio, DeepSeek, MiniMax — цены постоянно меняются. Anthropic за ночь урезал цену на output у Opus примерно на 67%. Google в декабре 2025 сократил лимиты free-tier у Gemini на 50–80%. Поддерживать вручную статическую таблицу цен — заведомо проигрышная стратегия.
Thunderbit решает эту задачу без кода для парсинга. Это расширение Chrome, AI web scraper, созданный именно для такого рода структурированного извлечения данных.
Мой рабочий процесс такой:
- Открываю страницу моделей OpenRouter в Chrome и нажимаю Thunderbit "AI Suggest Fields". Он читает страницу и предлагает столбцы — имя модели, цена input, цена output, размер контекста, провайдер.
- Нажимаю Scrape, затем сразу экспортирую в Google Sheets.
- Настраиваю scheduled scrape простыми словами — «каждый понедельник в 9 утра заново парсить список моделей OpenRouter» — и всё автоматически запускается в облаке.
После этого ваша личная таблица цен обновляется сама. Любая модель, которая внезапно подешевеет на 30%, или любой провайдер, которому добавили тег Exacto, появится в понедельничной таблице без вашего участия. Мы подробнее писали о AI data extraction для бизнеса в нашем блоге.
Сравниваете цены на страницах прямых провайдеров (Anthropic, Google, DeepSeek)? Subpage scraping в Thunderbit переходит по ссылкам каждой модели на её страницу с деталями и собирает ставки по провайдерам — это полезно, когда нужно понять, дешевле ли маршрутизировать Kimi K2.5 через OpenRouter или идти напрямую через NVIDIA Build. Смотрите цены Thunderbit для информации о free tier и тарифах.
Главные выводы о том, как сократить расход токенов OpenClaw
Фреймворк: Понять → Измерить → Маршрутизировать → Оптимизировать.
Самые важные действия по приоритету:
- Не ставьте Opus по умолчанию. Поменяйте основную модель на Sonnet или MiniMax M2.7. Это само по себе даёт сокращение расходов в 3–5 раз.
- Изолируйте heartbeat. Включите
isolatedSession: trueи отправляйте heartbeat через Gemini Flash-Lite. Так вы превращаете утечку примерно в 100k токенов в расход около 2–5k. - Перенаправьте sub-agent на Haiku. Каждый запуск поднимает около 20k токенов контекста ещё до начала работы. Не допускайте, чтобы это происходило на Opus.
- Используйте
/clearпостоянно. Это бесплатно, занимает 5 секунд, и по мнению сообщества даёт больше экономии, чем любое другое отдельное действие. - Добавьте
.clawignore. Исключениеnode_modules, lock-файлов и артефактов сборки резко сокращает bootstrap-контекст. - Сравнивайте
/context detailдо и после изменений. Если вы не можете измерить эффект, вы не сможете его улучшить.
Самая дешёвая модель зависит от задачи. Gemini Flash-Lite — для heartbeat. MiniMax M2.7 — для ежедневного кодинга. Haiku — для надёжного tool calling. Sonnet — для сложной многошаговой работы. Opus — только для действительно самых тяжёлых задач и больше ни для чего.
Большинство читателей могут увидеть экономию 50–70% уже за один день с Config A или B. Полные 85–90% достигаются за счёт комбинирования всего сразу — маршрутизации моделей, исправления скрытых утечек, .clawignore, дисциплины сессий — но это реально, и это работает долго.
FAQ
1. Сколько в месяц стоит OpenClaw?
Это полностью зависит от конфигурации, объёма использования и выбора моделей. Лёгкие пользователи (~10 запросов в день) обычно тратят $5–30 в месяц при оптимизации, или $100+ на настройках по умолчанию. Средние пользователи (~50 запросов в день) — примерно $90–400 в месяц. Активные пользователи могут выходить на $600–2,000+/месяц на дефолтных настройках — один задокументированный экстремальный случай составил $5,623 за один месяц. По внутренней телеметрии Anthropic медиана — около $13 на разработчика в активный день.
2. Какая самая дешёвая модель OpenClaw всё ещё хорошо подходит для кода?
MiniMax M2.5/M2.7 — лучший универсальный вариант на каждый день: хорошая надёжность tool calling, SWE-Pro 56.22, при цене примерно $0.28/$1.10 за миллион токенов. Для heartbeat и простых запросов трудно найти что-то дешевле, чем Gemini 2.5 Flash-Lite за $0.10/$0.40. Claude Haiku 4.5 за $1/$5 — надёжный средний вариант, когда нужна отличная работа с инструментами без ценника Sonnet.
3. Можно ли использовать модели бесплатного тарифа с OpenClaw?
Технически да. GPT-OSS-120B бесплатна через тег :free в OpenRouter и в NVIDIA Build. У Gemini Flash-Lite есть free tier (15 RPM, 1,000 запросов в день). DeepSeek даёт 5 млн бесплатных токенов при регистрации. Но у бесплатных тарифов жёсткие лимиты, более низкая скорость и нестабильная доступность. Дешёвые платные модели — буквально за копейки на миллион токенов — куда надёжнее для регулярной работы.
4. Теряется ли контекст, если переключать модели командой /model посреди разговора?
Нет. /model сохраняет полный контекст сессии — следующий ход уходит в новую модель с полной историей без потерь. Это подтверждается документацией OpenClaw по концепциям и работает так же, как в Claude Code. Можно спокойно переключаться между Haiku для быстрых вопросов и Sonnet для сложной работы, ничего не теряя.
5. Какой самый быстрый способ уменьшить счёт OpenClaw прямо сегодня?
Используйте /clear между несвязанными задачами. Это бесплатно, занимает пять секунд и стирает историю переписки, которая пересылается заново при каждом API-вызове. В одной реальной сессии было 185,000 токенов накопленной истории сообщений — и всё это повторно передавалось и снова тарифицировалось на каждом шаге. Очищать историю перед новой работой — это привычка с самым высоким ROI.
Попробуйте Thunderbit для AI web scraping Get Started Free




