
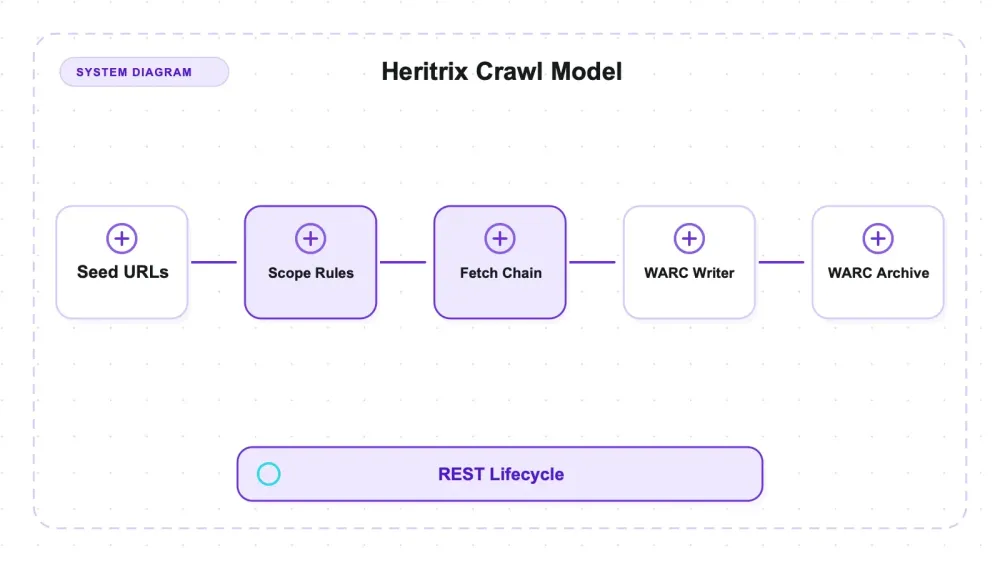
Heritrix — это open-source архивный краулер Internet Archive, то есть программная основа Wayback Machine, которая уже двадцать лет используется в продакшене. Его задача — максимально точно сохранить то, что сайт реально отдавал, в WARC-файлы, которые можно воспроизвести спустя годы. По сути это Java-движок, где каждый краул представляет собой Spring-граф бинов, описанный в XML, а весь жизненный цикл задания управляется через REST API. Это не парсер и не скрейпер: здесь нет синтаксиса селекторов, сопоставления полей и готовых строк на выходе.
Я протестировал версию 3.16.0 на контролируемом локальном стенде и посчитал, что именно она записывает, запись за записью. Больше всего впечатляет полнота: двадцать запрошенных URI дали шестьдесят одну WARC-запись, при этом у каждого ответа был payload digest и IP-адрес захвата, а каждый запрос был связан с тем ответом, к которому он относится; и всё это — без единой правки в настройках. А вот эксплуатация оставляет совсем другое впечатление: 41 МБ, 114 jar-файлов (lib/ содержит 142 файла; оставшиеся 28 — это LICENSE и NOTICE), и примерно 750 строк конфигурации задания ещё до первого запроса — хотя в этом тесте каждый краул запускался полностью без GUI, только через curl.
Результат по хранилищу показал неочевидное поведение по умолчанию. Два URL на стенде возвращали побайтно идентичный контент, и стандартный профиль выгрузил и заархивировал оба полностью: две response-записи и ни одной revisit-записи, хотя у обоих ответов был один и тот же payload digest. Дедупликация по content-digest начинает работать только после добавления history-процессоров; в стандартном профиле она не включена и экономит место в хранилище, а не трафик.
Что такое Heritrix на самом деле
Архивация — это не скрейпинг, и именно здесь важно развести категории. Heritrix не выдаёт вам строки таблицы. В конце не появляется CSV. Его результат — сама HTTP-разговорная сессия: заголовки, тела и метаданные захвата, сохранённые в формате, рассчитанном на долговременное хранение; это эталонная реализация для всего этого класса задач. Просить его дать прайс-лист — всё равно что просить судебного стенографиста сделать краткое резюме.
Актуальные цифры на 27 июля 2026 года: в репозитории 3 285 звёзд и 36 открытых issues, а 3.16.0 — последний релиз, опубликованный 2026-07-03. Именно эту сборку я и тестировал, так что здесь нет претензий к устаревшей версии. С лицензированием есть нюанс: файл LICENSE — обычный Apache-2.0, но собственный детектор GitHub показывает статус “Other”, потому что часть сторонних файлов в комплекте имеет свои условия. Если Heritrix будет встроен в коммерческий продукт, на это стоит потратить пять минут внимания юриста, а не полагаться на бейдж в боковой панели.
Один архитектурный факт определяет всё остальное: Heritrix не управляет браузером. Он работает по HTTP и извлекает ссылки из полученных байт. Его современный “родственник” в архивировании, Browsertrix Crawler, делает обратное — запускает настоящий Chromium и записывает то, что сделал браузер. Оба пишут WARC, но в этом обзоре я измерял только небраузерный путь Heritrix; я не сравнивал масштабируемость или throughput обеих систем.
Цепочки, бины и SURT: как на самом деле собирается краул
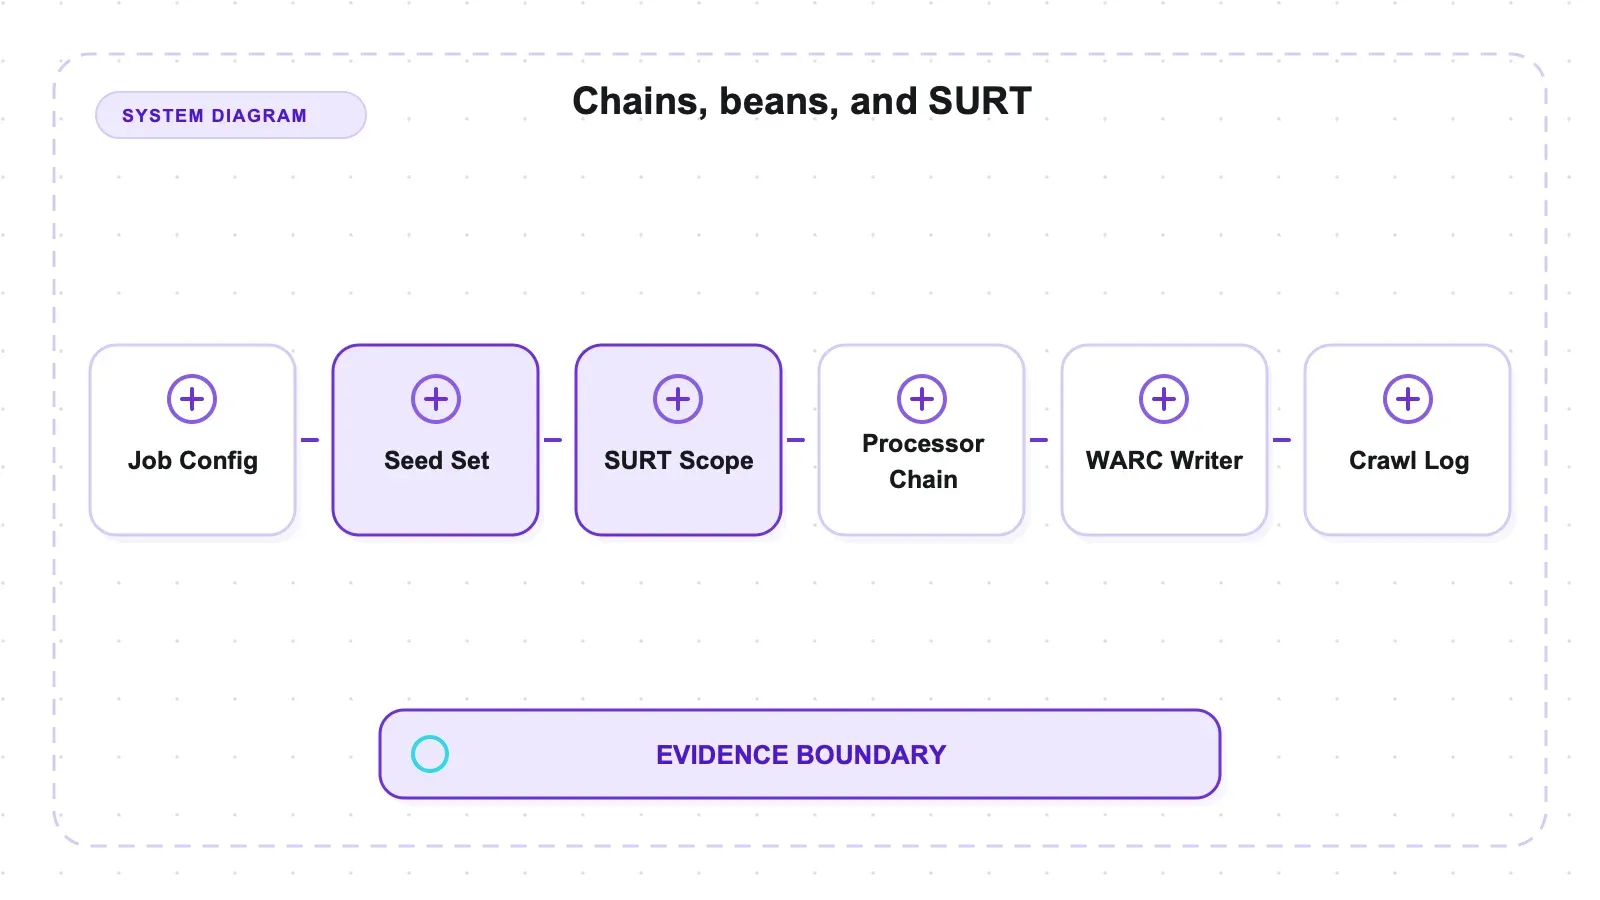
Внутри Heritrix-задача — это Spring application context. Не “настроен через Spring”, а именно Spring-граф бинов, описанный в XML, где любой элемент краула можно заменить другим бином.
Frontier хранит очередь URI, разбитую по хостам. Именно поэтому ограничение вежливости работает так, как работает, и это важно дальше.
Цепочки процессоров выполняют работу в три этапа: candidate chain (нужно ли планировать обнаруженный URI?), fetch chain (DNS, robots, HTTP-запрос, извлечение ссылок), и disposition chain (запись в WARC, обновление состояния). Добавить новую возможность в Heritrix обычно означает вставить processor bean в нужное место нужной цепочки — именно так я включил дедупликацию.
Scope — это стек DecideRules, работающих с SURT — Sort-friendly URI Reordering Transform, который переписывает http://www.example.com/a в http://(com,example,www,)/a, чтобы префиксы хостов сортировались по иерархии. Default scope строится из SURT-префиксов ваших seed-URL. Правила последовательно принимают или отклоняют, а приоритет имеет последнее совпадение.
WARC writer находится в disposition chain, а politeness живёт во frontier и задаётся тремя числами: delayFactor, minDelayMs, maxDelayMs. Соблюдение robots задаётся строкой политики в fetcher'е.
И всё это можно запускать через REST API, и это оказалось куда важнее, чем я ожидал.
Самая тяжёлая часть — это установка
Что нужно развернуть ещё до первого запроса:
| Параметр установки | Heritrix 3.16.0 |
|---|---|
| Дистрибутивный tarball | примерно 41 МБ |
Файлов в lib/ после распаковки | 142 всего: 114 файлов .jar и 28 текстов LICENSE/NOTICE |
| Что запускается при старте | Java-движок плюс встроенный Jetty web UI на https://localhost:8443 с самоподписанным сертификатом |
| Время до готовности REST на моей машине | около десяти секунд |
Стандартный конфиг задания (crawler-beans.cxml) | примерно 750 строк Spring bean XML |
Большую часть этого конфига вы, скорее всего, никогда не тронете. Но пропустить его нельзя, и до начала краулинга обязательны два поля: ваш seed и metadata.operatorContactUrl. Значение по умолчанию — заглушка, и краулер не начнёт работу, пока вы не замените его на реальный URL с идентификацией того, кто запускает краул.
Это требование создаёт точку ответственности: оператор обязан указать контактный URL до запуска краулера. Оно не доказывает, что личность подтверждена, что у краула есть разрешение или что он соответствует применимым правилам, но делает контактные данные частью задания, а не необязательной рекомендацией.
Два вывода по установке реально удивили.
Он запустился на более новом JDK, чем указано в минимальных требованиях. В Getting Started docs указано Java 17 или новее. Heritrix 3.16.0 стартовал, поднял REST API и завершил все краулы на этом стенде на OpenJDK 26.0.1 без --add-opens, --enable-preview и обходных решений для Security Manager. Это результат для одного macOS arm64, а не полная матрица совместимости, но он подтверждает, что протестированная сборка на этой машине не ограничена JDK 17.
Вам вообще не нужно трогать web UI. Весь жизненный цикл задания работает через REST, и я автоматизировал всё через curl: создать задание, PUT-нуть beans-файл, собрать, запустить, снять паузу, опрашивать состояние до FINISHED, завершить и удалить. Вот и ответ на вопрос, можно ли использовать Heritrix в пайплайне: да, полностью без браузера и без кликов по UI. Большинство обзоров скриншотят Jetty-интерфейс и создают впечатление, будто это обязательная часть. На самом деле это лишь удобство, а не требование.
Один нюанс, связанный именно с этой машиной: на Mac был системный HTTP proxy через Surge. Java-клиент Heritrix унаследовал этот proxy и отправлял через него даже трафик к 127.0.0.1, из-за чего вместо нужных ответов получались 503, несмотря на исключения в ОС и NO_PROXY. Запуск JVM с -Djava.net.useSystemProxies=false изменил результат с 2×503 на 18×200. Это было взаимодействие с окружением, а не дефект Heritrix; этот флаг важен только тогда, когда наследовать системные proxy-настройки не нужно.
Что реально попадает в архив
Я прогнал стандартный профиль по контролируемому стенду — локальному серверу с известным набором endpoint’ов, включая HTML-страницы, цепочку глубиной три уровня, robots.txt и sitemap, а также специально сделанные маршруты 404 и 500 — а затем разобрал получившийся WARC запись за записью, а не доверился итоговой строке.
Двадцать запрошенных URI дали шестьдесят одну запись:
| Тип WARC-записи | Количество | Что содержит |
|---|---|---|
warcinfo | 1 | служебные данные о крауле, записываются один раз на файл |
response | 20 | полный HTTP-ответ: заголовки и тело |
request | 20 | точный запрос, который отправил Heritrix |
metadata | 20 | собственные аннотации захвата Heritrix |
То есть из коробки получилось чистое соотношение 1:1:1 между response, request и metadata на каждый URI — без каких-либо правок с моей стороны. И полнота по каждой записи выдержала проверку:
| Проверка по записи | Количество | Почему это важно |
|---|---|---|
payload digest с префиксом sha1: в response-записях | 20/20 | — |
WARC-IP-Address в response-записях | 20/20 | это IP, с которого реально пришёл контент, и такие данные особенно ценны спустя годы, когда домен уже мог сменить владельца |
Request-записи, связанные со своим response через WARC-Concurrent-To | 20/20 | Не “почти все связаны”. Все. |
И HTTP-статусы сохранялись дословно, включая неприятные: 200 OK, 404 Not Found и 500 Internal Server Error отображаются в сохранённых ответах как реальные статус-строки, а не отбрасываются как ошибки.
Именно этот момент лучше всего отличает архивацию от скрейпинга. Скрейпер считает 500 ошибкой, которую надо повторить или пропустить. Архиватор воспринимает это как то, что сервер сказал в тот момент, а это факт, который стоит сохранить. Heritrix Output описывает такую структуру записей; чего я нигде не видел, так это измеренной кратности и связки 20/20 на заранее известном наборе endpoint’ов. Это подтверждается.
Результат по дедупликации, измеренный в обе стороны
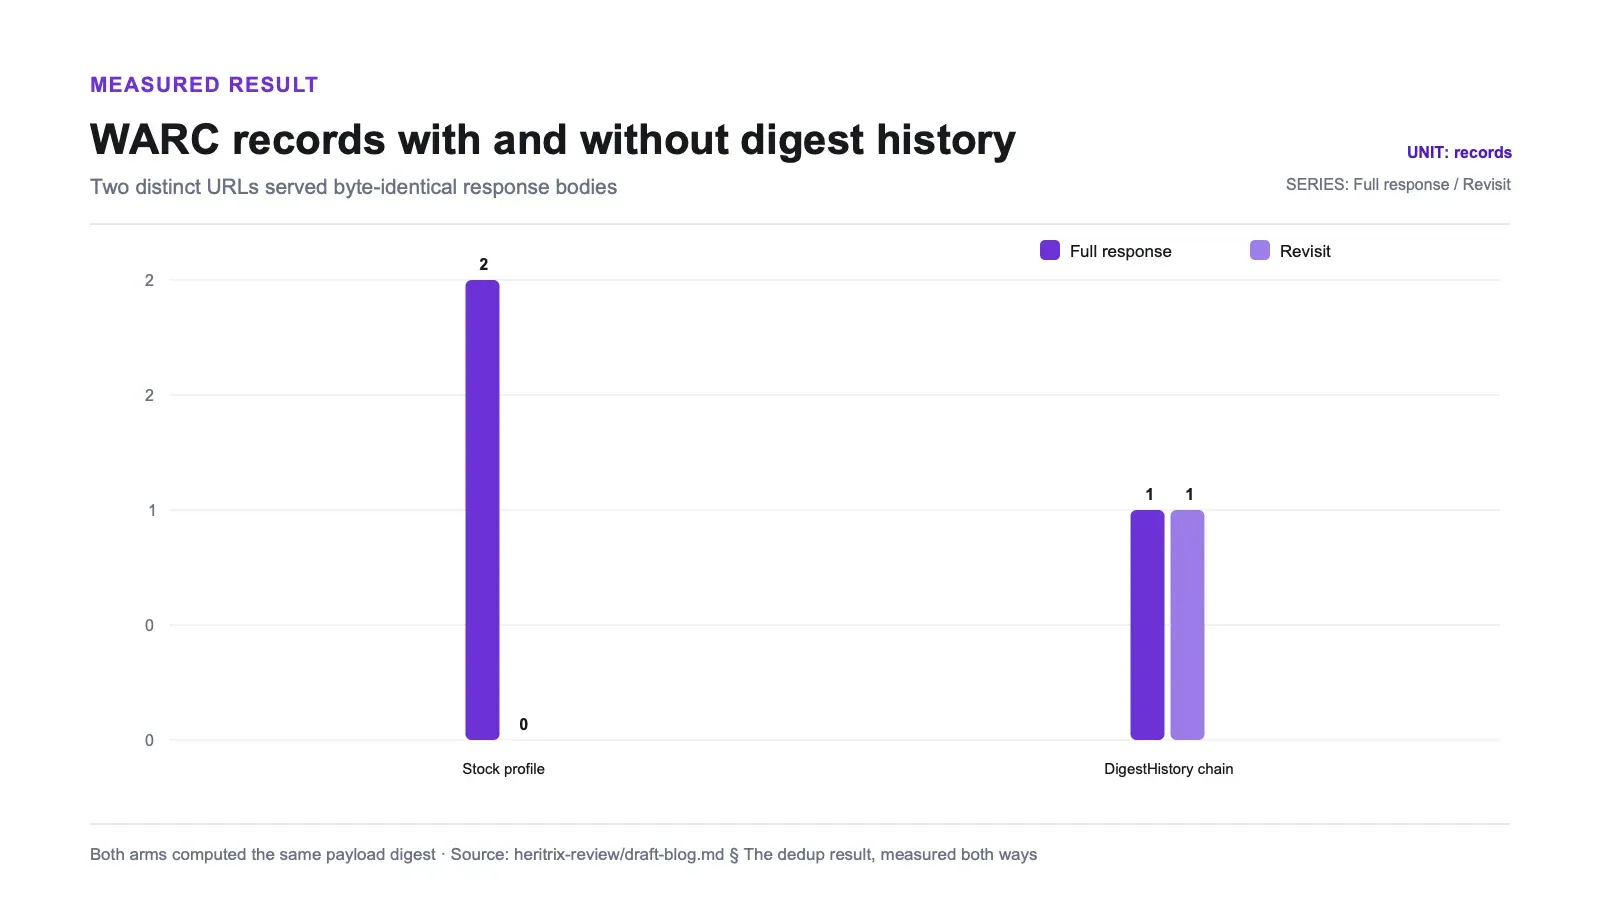
Мой стенд отдавал /dup/one и /dup/two с идентичным побайтовым телом. Разные URL, одинаковый контент — ровно тот случай, для которого и существует content-digest dedup. Я прогнал это дважды: один раз на стандартном профиле, второй — после добавления цепочки digest-history (BdbContentDigestHistory плюс ContentDigestHistoryLoader в fetch chain и ContentDigestHistoryStorer после WARC writer).
| Стандартный профиль | С цепочкой ContentDigestHistory | |
|---|---|---|
Полных response-записей | 2 | 1 |
Записей revisit | 0 | 1 |
| Общий payload digest | да (оба) | да |
| Revisit-профиль | — | identical-payload-digest |
Из коробки оба ответа получили одинаковый digest, но history-процессоры его не обработали, поэтому оба payload’а были записаны полностью. Добавление цепочки превратило второе сохранение в WARC revisit, указывающий на идентичный payload digest — именно так revisits и определены в спецификации WARC 1.1.
Ничего секретного здесь нет. На странице Duplication Reduction Processors прямо сказано, что skipIdenticalDigests по умолчанию выключен, а дедупликация без привязки к URL требует именно этих loader и storer-бинов. Это не скрытое поведение, которое я “раскопал”; почти всё измеренное здесь — документированное поведение Heritrix с добавленной практической цифрой. Разрыв — между документацией и тем, во что люди верят. И обычно эта вера звучит так: “Heritrix дедуплицирует, точка”, без звёздочки про конфигурацию.
Два вывода, которые стоит запомнить:
Дедупликация работает на этапе записи, а не экономит трафик. Я не мерил это отдельно как сетевую метрику, но логика content digest проста: сравнить digest можно только после того, как байты уже пришли, значит второй URL всё равно будет загружен с источника. Включение цепочки уменьшает то, что вы сохраняете, а не то, что передаёте, и не то, что должен отдать сервер. Если кто-то закладывает дедуп как способ снизить трафик или “вежливость”, это перевёрнутое понимание.
Оценки объёма на основе “оно же дедуплицируется” могут сильно ошибаться. Если вы архивируете сайт с большим количеством шаблонных дублей — зеркалированные PDF, одинаковые лендинги, print-view-версии тех же статей — и рассчитываете диски, исходя из того, что одинаковые тела схлопнутся, стандартный профиль может занять заметно больше места, чем ожидалось. Двух-URL стенд показывает поведение по умолчанию, а не эффект на масштабе в миллион URI; там всё зависит от доли дублей, размера payload и схемы повторного обхода.
Scope и robots сделали ровно то, что обещают
Собственному отчёту краулера о том, что он “не ходил”, доверять мало смысла, поэтому оба случая я проверял через серверный счётчик — сам target-сервер считал запросы независимо от логов Heritrix.
| Контроль | Условие | Серверных хитов на target | Что показал лог краула |
|---|---|---|---|
| Scope | Default scope; я засеял страницу, которая ведёт на второй хост с другим SURT authority | 0 | out-of-scope хост вообще не появился — значит, его отклонили на этапе обнаружения, а не поставили в очередь и потом неудачно сходили |
| Robots | Политика по умолчанию: obey; домашняя страница вела на /robots-denied/secret, который robots.txt на стенде запрещал | 0 | записано как blocked (сам robots.txt был загружен) |
| Robots | Контроль: robotsPolicyName переключён на ignore, повторный прогон | 1 | — |
Scope. При этом хост внутри scope краулился нормально, так что ограничение работало именно как дисциплина, а не как поломка краула. Небольшая оговорка: здесь я проверял только стандартный arm на default-scope, а не положительный контроль с расширенным scope, так что это подтверждение документированной логики, а не двустороннее доказательство.
Robots. Ссылка всегда была доступна; её блокировала только политика robots. Соблюдение правил реально работает, и реальный “аварийный выход” тоже есть — и это правильная схема: некоторые архивные задачи действительно требуют обойти robots, но для этого надо осознанно прописать ignore в конфиге.
Вежливость: 57,7 секунды на двадцать локальных страниц
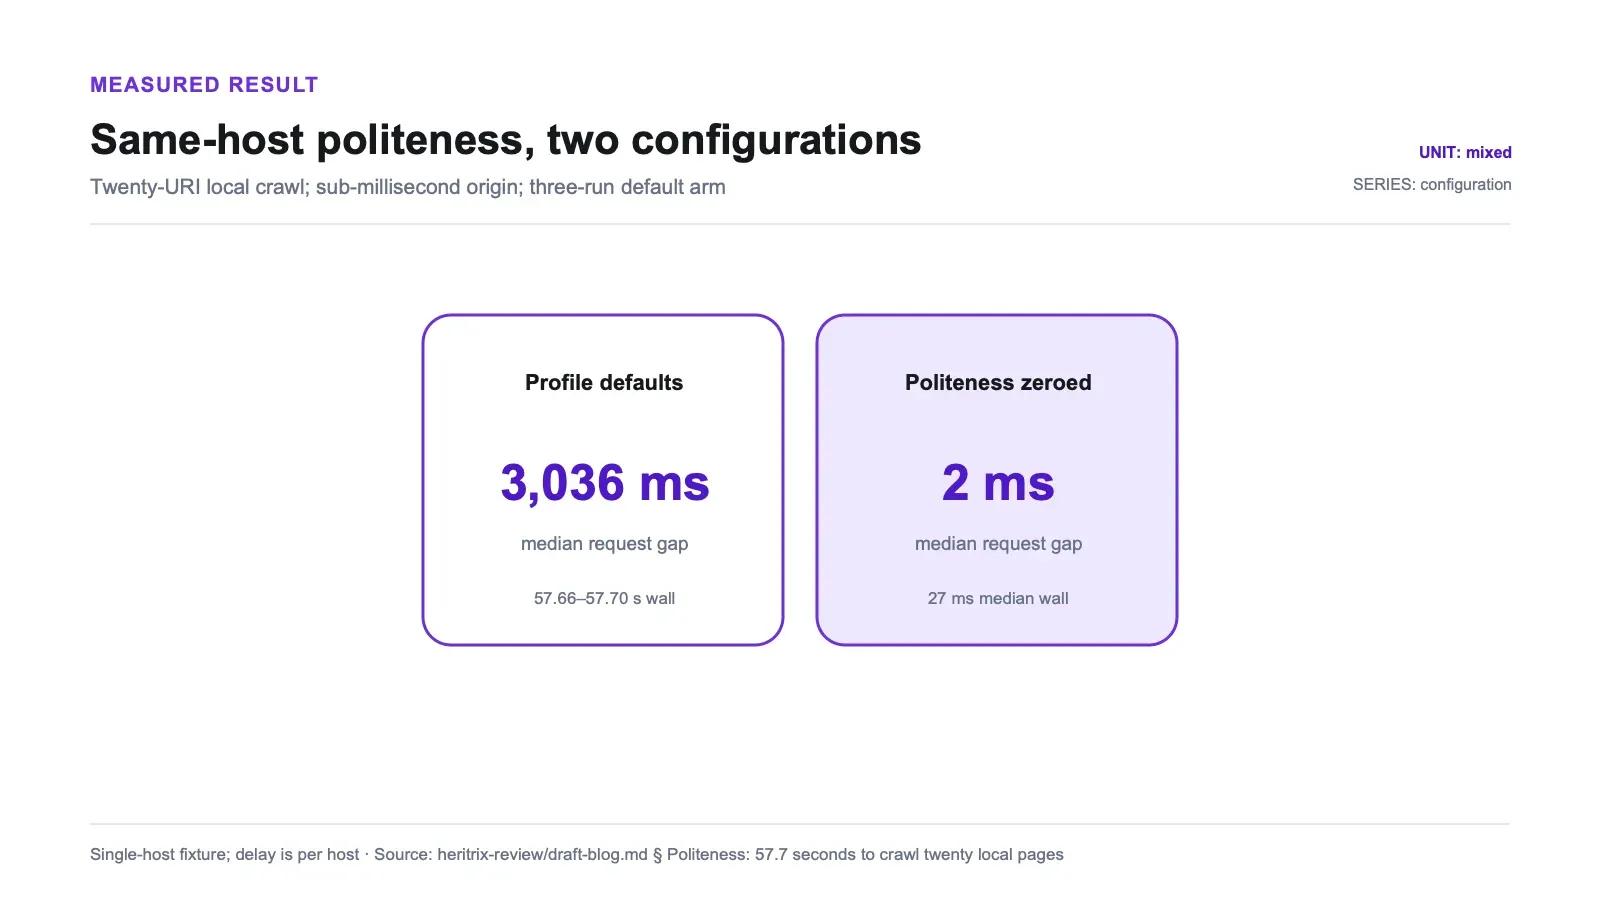
Один показатель решает, подойдёт ли вам Heritrix для проекта.
Один и тот же стенд, тот же трёхкратный прогон, один локальный хост с задержкой меньше миллисекунды:
| Настройка вежливости | Медианный интервал между запросами к одному хосту | Общее время полного краула на 20 URI |
|---|---|---|
Профиль по умолчанию (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3036 мс (мин. 3021, макс. 9107, по 48 измеренным интервалам) | 57.66 с / 57.66 с / 57.70 с (три прогона) |
| Вежливость обнулена | 2 мс | 27 мс (медиана) |
Фактическая задержка ложится почти ровно на нижнюю границу minDelayMs: при источнике с задержкой меньше миллисекунды произведение delayFactor × fetch-time пренебрежимо мало, и минимум начинает доминировать по конструкции. Соотношение между двумя строками не слишком полезно, потому что знаменатель при нулевой вежливости — это десятки миллисекунд, и он колеблется от прогона к прогону. Стабильный вывод — абсолютный минимум: стандартный Heritrix ждал около трёх секунд между запросами к одному и тому же хосту на этом стенде, превращая краул из двадцати страниц примерно в минуту wall time.
Чтобы почувствовать масштаб, представьте: университетской библиотеке нужно заархивировать 50-тысячностраничный сайт госоргана до его вывода из эксплуатации, и всё это находится на одном хосте. При нижней границе 3 секунды на хост это 150 000 секунд принудительного ожидания — примерно 42 часа, то есть около суток и ещё трети, ещё до учёта времени на сами запросы. Это арифметика из моего измеренного порога 3036 мс: 50 000 × 3.036 с = 151 800 с = 42.2 ч; даже при настроенном минимуме 3000 мс это 41.7 ч, то есть округляется до 42, а не 41. Это не измеренный краул, но именно такая математика нужна в проектном плане.
Справедливости ради, politeness в Heritrix действует на уровне хоста, потому что frontier очереди строит по хостам. Широкий краул по тысячам доменов параллелизуется между этими очередями и не наследует этот потолок глобально. Мой стенд был одним хостом — то есть худшим случаем для этого конкретного числа. Если ваш архивируемый объект — один большой сайт, то этот худший случай и есть ваш случай.
И это именно фича. Эта задержка делает архивный краулер тем инструментом, который владелец сайта готов терпеть, а не блокировать. Снижать её — это решение, которое принимается относительно чужого сервера, и инструмент делает это решение явным, а не агрессивным по умолчанию.
Что я не тестировал
Эти измерения касаются только дисциплины краула на контролируемом стенде и ничего шире. За их пределами осталось следующее:
- Дедупликация между краулами и повторные обходы. Я измерял только внутрикraульную content-digest deduplication. Постоянное хранение базы истории URI между отдельными краулами (
FetchHistoryProcessor+PersistLog) — это другой механизм, и я его не проверял. - Масштаб и долгосрочная стабильность. Здесь не было фронтира на миллион URI, checkpoint-and-restore и многодневного прогона. Мой стенд показывает дисциплину, а не выносливость.
- Захват JavaScript-рендеринга. По умолчанию Heritrix работает без браузера, и именно это я измерял. Опциональные браузерные режимы здесь не тестировались.
- Politeness на высоколатентном источнике. Локальная задержка меньше миллисекунды, поэтому
minDelayMsдоминировал по конструкции. КакdelayFactorведёт себя на медленном реальном сервере, из моих данных не видно. - Полнота по sitemap. robots.txt был запрошен, и директива sitemap была учтена, но я отдельно не подтверждал извлечение каждого
<loc>.
Что нужно явно решить до первого боевого краула
Стандартный профиль длинный, но решения, которые действительно меняют смысл архива, довольно компактны. Начните со scope. Seed’ы создают default SURT prefixes, а DecideRules могут по очереди расширять или сужать их. Проверьте финальный порядок правил на примерах URL, которые должны попадать в scope и не должны попадать, а затем сверяйте это с серверным трафиком или другим независимым логом запросов. Один только crawl report не доказывает, что исключённый хост никогда не был запрошен.
Затем решите, что для вашей коллекции означает robots policy и идентификация оператора. На тесте политика по умолчанию уважала disallow-правило на стенде, а смена robotsPolicyName на ignore приводила к загрузке запрещённого пути. Этот переключатель технически простой, но организационно значимый. Зафиксируйте, кто и почему это одобрил, а также укажите рабочий operatorContactUrl; обязательный URL даёт владельцу сайта путь обратно к оператору, но не объясняет, на каком основании была получена авторизация.
Планирование хранилища требует отдельного явного решения. Если идентичные тела должны превращаться в revisit-записи, добавьте и проверьте content-digest history processors ещё до расчёта объёма архива. В протестированной цепочке изменение происходило после fetch, поэтому трафик к источнику всё равно нужно планировать для обоих URL. Дедупликация между краулами — это отдельный механизм, и по этому двух-URL однопроходному результату делать выводы о ней нельзя. Небольшой валидационный краул с известными дублями — это недорогой способ проверить, что развернутый bean-граф действительно выдаёт нужные типы записей.
И наконец, относитесь к politeness как к входному параметру планирования, а не к последней ручке для настройки. На локальном стенде с одним хостом именно minDelayMs определял общее время. Для реального проекта нужно соотнести настроенный нижний предел на хост с числом целевых хостов и дедлайном сбора, а затем протестировать это на репрезентативной задержке. Широкие и односайтовые краулы по-разному нагружают frontier, разделённый по хостам; в этом обзоре измерялся только второй случай. Не забывайте и про REST-жизненный цикл в runbook: build, launch, unpause, poll, terminate и teardown — это отдельные состояния, за которыми полезно следить в автоматизации.
Плюсы и минусы
Плюсы
- Отличная полнота архивации по умолчанию: 20/20 ответов с payload digest, capture IP и полной связкой request↔response без дополнительной настройки.
- Сохраняет ошибки как факты — статус-строки 200, 404 и 500 записываются дословно.
- Дисциплина scope подтверждена серверным счётчиком: ноль fetch’ей вне scope при нормальном крауле внутри scope.
- Robots-ограничения действительно блокируют загрузку, а для случаев, когда архивирование обязано их обойти, есть осознанный
ignore. - Полностью headless через REST — создать, собрать, запустить, опросить и удалить можно через
curl, без кликов в UI. - Корректно работает на OpenJDK 26.0.1 без JVM-флагов, что для двадцатилетнего кода — редкая аккуратность по меркам современного Java.
- Обязательный
operatorContactUrlне позволяет запускать краул анонимно. - Любая часть краула — это сменяемый bean, поэтому включение дедупликации потребовало трёх вставок в конфиг, а не форка проекта.
Минусы
- Content-digest dedup выключена по умолчанию и записывает идентичные payload’ы целиком — реальная ловушка для планирования объёма.
- Развёртывание тяжёлое: дистрибутив 41 МБ, 114 jar-файлов, Java-движок плюс Jetty и около 750 строк Spring-конфига задания.
- Политика вежливости по умолчанию даёт около 3 секунд на хост; однопоточный краул на 20 URI занял 57,7 секунды.
- В стандартном пути нет JavaScript-rendering, поэтому контент, который появляется только на клиенте, не будет захвачен.
- Конфигурационная поверхность рассчитана на опытного пользователя и плохо прощает случайный запуск; пути “первый краул за пять минут” здесь нет.
- В выходе нет структурированных данных. Извлечение полей из WARC — это отдельный проект.
Кому это подходит, а кому лучше пройти мимо
Heritrix нужен институтам и командам, для которых результатом является сам архив. Библиотеки, национальные архивы, legal- и compliance-preservation, исследовательские группы, собирающие веб как первоисточник, — всем, кому через пять лет нужно доказать, что именно отдавал URL в конкретный день. Если слова “WARC”, “replay” и “provenance” уже есть в вашем словаре, это тот инструмент, вокруг которого и строилась остальная экосистема; его тяжесть — это цена за такую совместимость.
Его frontier с разделением по хостам и многолетняя история в веб-архивации делают его правдоподобным кандидатом для широких краулов по множеству доменов. Это архитектурный и исторический аргумент, а не результат масштабного теста на этом стенде; долгосрочный throughput, восстановление из checkpoint и поведение на миллион URI здесь не проверялись.
Не стоит выбирать его, если вам нужны данные, а не архив. Если ваша цель — таблица товаров, листингов или контактов, Heritrix великолепно сохранит страницы, после чего вам всё равно придётся писать отдельный пайплайн для их разбора — и всё это ради Java-движка, Spring-конфига и трёхсекундного порога вежливости. Не подходит он и для client-rendered single-page apps, где небраузерный fetcher сохраняет только shell, а не контент; там нужен browser-based архиватор. И не подходит, если первый результат нужен уже сегодня: кривая установки здесь вполне реальная.
Альтернативы и место managed API
Внутри архивирования ближайший современный аналог — Browsertrix Crawler, браузерный архиватор, который управляет Chromium и фиксирует то, что сделал браузер. Он способен захватывать JavaScript-контент, которого нет в стандартных HTTP-ответах Heritrix, но за это приходится платить браузерной инфраструктурой и runtime-overhead. В этом обзоре прямого head-to-head теста не было, поэтому выбор начинается с требований к захвату: если состояние создаётся браузером, нужен browser archiver; если речь о обычных HTTP-ресурсах, Heritrix остаётся нативным вариантом.
Связанный обзор: Browsertrix Crawler review.
Для совсем другого типа задачи — вам не нужен архив, вам нужны структурированные данные со страниц — сравнивайте Heritrix с системами извлечения по результату, а не пытайтесь считать их одинаковыми краулерами. Heritrix бесплатен и self-hosted: вы запускаете JVM, владеете beans-файлом, сами считаете диски и настраиваете politeness. Этот подход хорош там, где deliverable — сохранение.
Раскрытие: Thunderbit — продукт издателя, и в этом стенде Heritrix не тестировался. Он относится к managed extraction-категории: его результат — контент страниц или структурированные записи, а не WARC-файлы уровня preservation. Выбирайте архиватор, если нужны воспроизводимый захват и provenance; выбирайте сервис извлечения, если результатом должны быть строки или текст документов и вас устраивает managed-формат работы.
Архивация поднимает и свой вопрос разрешений, и он не совпадает с вопросом скрейпинга. Heritrix по умолчанию соблюдает robots.txt и требует, чтобы вы указали себя до получения хотя бы одного байта — это хороший базовый уровень. Но соблюдение robots не делает краул автоматически разрешённым. Авторское право, условия использования, персональные данные и мандат вашей организации — всё это лежит поверх него, а политика ignore предназначена для организаций с законным основанием её использовать, а не как удобный переключатель. Если вы разворачиваете программу веб-архивации, сначала определите границы авторизации, а уже потом заполняйте диски; и если тема новая, почитайте о правовых аспектах web scraping и архивации.
Попробуйте Thunderbit для извлечения веб-данных
Итог
Стоит ли использовать Heritrix? Да — если ваш результат это архив и у вас есть человек, готовый разбираться в Spring beans.
Стенд даёт понятный вывод: стандартный профиль последовательно сохранял response, request и capture metadata; scope и robots влияли на серверные fetch’и ровно так, как настроено; а весь жизненный цикл задания работал через REST. Это полезные свойства для архивного пайплайна в рамках того небольшого single-host-объёма, который здесь тестировался.
Но операционные издержки тоже очевидны: Java-дистрибутив и большой Spring-конфиг, заданная по хосту задержка, которая доминировала в локальном крауле, и content-digest deduplication, требующая дополнительных history-процессоров. Команды, которым нужна WARC-верность, могут принять такие издержки; команды, которым нужны извлечённые поля, должны начинать в другой категории.
Перед production-краулом проверьте цепочку дедупликации, настройки politeness, scope, robots policy, идентификацию оператора и допущения по хранилищу на реальном конфиге задания. Стандартный профиль — это стартовая точка, а не неявное утверждение этих эксплуатационных решений.
Попробуйте Thunderbit для извлечения веб-данных Get Started Free
FAQ
Делает ли operatorContactUrl краул авторизованным?
Нет. Он лишь заставляет добавить контактный URL в задание, чтобы у владельца сайта был путь для связи и разбирательства, но это не устанавливает разрешение, корректность личности, статус авторского права или соответствие требованиям регуляторов. Всё это остаётся решением на уровне развёртывания, а не самого краулера.
Снижает ли content-digest deduplication число запросов к источнику? Не в тестируемой здесь конфигурации. Оба URL были загружены до того, как можно было сравнить их payload digest. History-цепочка изменила только то, как второй payload представлен в WARC-хранилище; она не превратила второй URL в пропущенный сетевой запрос.
Можно ли запускать Heritrix без web UI?
Да. Протестированный жизненный цикл — создать, загрузить конфиг, собрать, запустить, снять паузу, опрашивать, завершить и удалить — выполнялся через REST API с помощью curl. Встроенный Jetty UI не требовался.
Дедуплицирует ли стандартный профиль Heritrix идентичные payload’ы? Не в той конфигурации, что была в тесте. Стандартный профиль сохранил оба идентичных ответа как полные response-записи. Добавление content-digest history chain изменило второе сохранение на revisit-запись, так что дедупликация — это настраиваемая часть пайплайна, а не автоматическое поведение по умолчанию.
Как выбрать задержку politeness? Воспринимайте измерения локального теста как проверку механики, а не как рекомендацию для продакшена. Задавайте задержку исходя из правил target-сайта, договорённости с оператором, ёмкости сервера, цели краула и своей политики retry/concurrency, а затем подтверждайте фактические интервалы между запросами к одному хосту по логам.




