
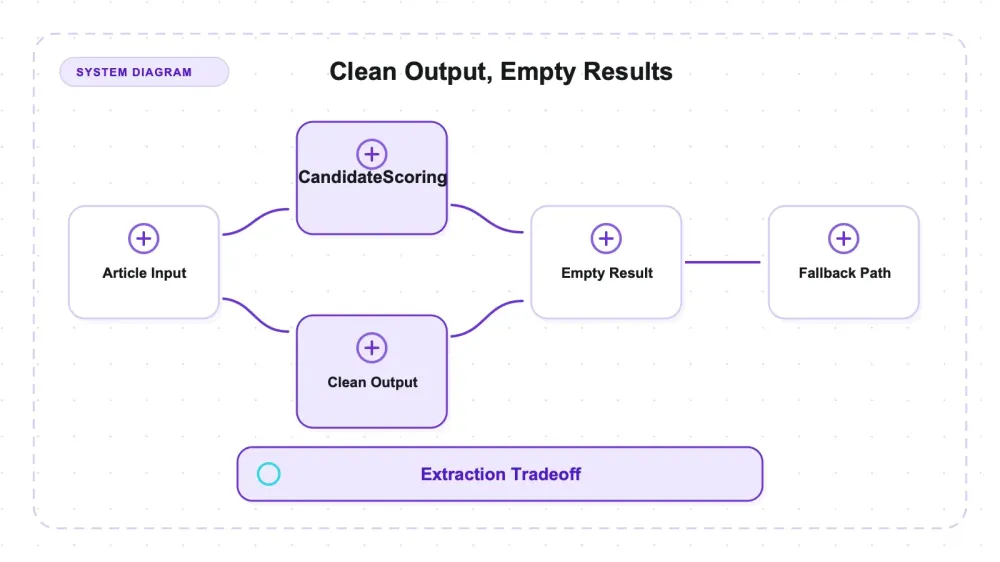
На тех наборах, где утечку вообще можно было корректно измерить, goose3 показал 100% точность по content-token и нулевое число посторонних токенов. Ни одного слова из навигации, рекламы, сайдбара, комментариев или промо в его вывод не попало. Ни один другой инструмент в сравнении шести библиотек такого результата не показал.
При этом у него худший recall по статьям в выборке — 0.8243 по всем 22 тестовым страницам против 1.0000 у Mozilla Readability — потому что на двух из них он вернул пустую строку.
Эти метрики связаны правилом подсчёта: пустой результат не вносит вклад в условную точность, а recall фиксирует пропуск.
Что такое goose3
goose3 — это продолжение на Python 3 линии, которая начинается с Goose от Gravity Labs на Scala и проходит через python-goose. Это извлекатель статей с метаданными, а не простой дампер текста: создаёте Goose, вызываете extract(), и получаете объект Article примерно с двадцатью восемью доступными полями — очищенный текст, заголовок, авторов, дату публикации, главное изображение, meta description, теги, ссылки, твиты и многое другое.
Официальная справка: официальный репозиторий goose3.
Проверенная версия: 3.1.22, лицензия Apache, 912 звёзд на GitHub, последняя отправка 2026-07-23 — на момент тестирования проект активно поддерживался. Python 3.14.2.
API сводится к двум вызовам и одной обязанности:
from goose3 import Goose
g = Goose()
try:
    article = g.extract(raw_html=html)
    text = article.cleaned_text
finally:
    g.close()          # закрывайте явно после использования
На close() стоит обратить внимание, потому что его легко забыть, а предупреждения не будет. В этом обзоре не запускался цикл проверок, чтобы измерить, остаются ли сессии, соединения или память при пропуске закрытия, так что говорить об «утечке ресурсов» было бы сильнее, чем позволяют данные. Корректнее считать явное закрытие частью жизненного цикла, которую требует показанный здесь API.
Измеренный компромисс
Шесть экстракторов, один размеченный набор тестов, один оценщик. Каждый блок каждой страницы помечен как article или boilerplate и содержит уникальный сигнальный токен, так что вопрос «удалось ли извлечь именно этот фрагмент» проверяется точным вхождением подстроки, а не сходством.
| Библиотека | Recall статьи (все 22) | Утечка boilerplate | Точность по content-token | Посторонние токены | Вывод получен |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 35 | 22/22 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 4 | 22/22 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 0 | 22/22 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 7 | 22/22 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 74 | 19/22 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 0 | 20/22 |
sixway-scores.json. Recall рассчитан по всем 22 страницам, а показатель утечки и точность — по 11, где одновременно есть и article, и boilerplate.
Колонку точности всегда нужно читать вместе с последней колонкой. Здесь точность зависит от того, был ли вообще вывод — библиотека, которая на странице возвращает пустую строку, не попадает ни в числитель, ни в знаменатель, поэтому «ничего не вернуть» в таком среднем случае бесплатно. Числитель — это пересечение мультимножества извлечённых не-stopword токенов и размеченных article-токенов; знаменатель — все извлечённые не-stopword токены. «Посторонние токены» — более узкий показатель: это только пересечение с размеченными boilerplate-токенами. Дополнительный токен, который не совпал ни с article, ни с boilerplate, снижает точность, не увеличивая этот счётчик; то же самое могут делать повторяющиеся токены сверх article-мультимножества. Поэтому newspaper4k может показывать 0 посторонних токенов при точности ниже 1.0000. У goose3 значение 1.0000 было посчитано на 10 из 11 страниц; у Readability, trafilatura, newspaper4k и resiliparse — на 11 из 11.
При этом 1.0000 остаётся полезной метрикой внутри этого синтетического набора. На десяти страницах, где оценка была возможна, goose3 не выдал ни одного размеченного boilerplate-токена; Readability на тех же страницах выдал 35. Если результат потребляет модель, это значит, что в этих десяти случаях на boilerplate не ушло ни одного токена. Но это не доказывает нулевые потери на реальных страницах, и пустой ответ может добавить стоимость fallback-ветки или повтора запроса в другой части пайплайна.
Два молчаливых провала и что они означают
goose3 вернул ничего ровно на двух страницах. Одна из них — спорная, вторая — настоящий предел.
Почти пустой документ. Страница с одним article-блоком длиной 32 символа. goose3 отказывается его брать. То же делает jusText. В этом наборе Readability отработал на всех 22 страницах, так что его результат не подтверждает молчание goose3 в этом случае. Насколько оправдано отбрасывать такой крошечный документ, зависит от того, какой минимум контента требует вызывающая сторона.
Статья, целиком состоящая из элементов <li>. Шесть article-блоков, и ни один из них не находится внутри тега <p>. goose3 возвращает пустую строку.
Этот второй случай меня озадачил, потому что в конфигурации goose3 по умолчанию стоит parse_lists=True. Поэтому я проверил это отдельно — три конфигурации на работающем контрольном примере, потому что один неудачный запуск ещё не говорит о поведении библиотеки:
| Конфигурация | Страница только со списком | Контроль с <p> |
|---|---|---|
| по умолчанию | 0 chars | 937 chars |
strict=False | 0 chars | 937 chars |
parse_lists=True (явно) | 0 chars | 937 chars |
Во всех трёх случаях — ноль, а контроль во всех трёх даёт 937 символов. Значит, parse_lists=True определяет, будут ли списки сохранены внутри уже найденной статьи — но не позволяет кандидату-счётчику считать список самой статьёй. Для поиска тела статьи goose3 нужен каркас из абзацев, а на странице, где тело собрано как список, такого каркаса нет.
Подтверждённый вывод уже уже: в синтетическом тесте с телом из шести article-элементов, все из которых были <li> и без абзацного кандидата, библиотека вернула пустую строку. Changelog-страницы, API-справки, рецепты, FAQ и сравнительные статьи — разумные кандидаты для реальных повторных тестов, потому что там много списков, но один этот пример не доказывает, что все такие страницы будут падать.
Пустую строку машина распознаёт только если вызывающий код проверяет, что вывод не пустой. Такую ошибку легче поймать, чем правдоподобный текст без самого статьи, но в мониторинге, который реагирует только на исключения, это всё равно молчаливый сбой. В продакшене нужен минимум по длине результата и fallback либо явная запись о неуспешной странице.
Реальность установки
pip install goose3 подтягивает 16 пакетов и 44.3 MiB примерно за 6–9 секунд. Холодный импорт, измеренный в новом subprocess: 2.181 s.
Официальная справка: goose3 на PyPI.
| Библиотека | Пакеты | site-packages | Холодный импорт | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
install-and-import.json. Каждая библиотека запускалась в отдельном пустом virtualenv, так что наследования следов от соседних пакетов не было.
По весу — середина, по скорости — тоже середина. На Python 3.14.2 всё установилось и импортировалось без проблем, а это в этой категории встречается не у всех.
Три настройки, которые стоит знать до запуска в продакшене
Если смотреть не на документацию, а на объект Configuration, который поставляется вместе с библиотекой, там видно девятнадцать параметров. Три из них могут неприятно удивить.
Он сам себя называет. browser_user_agent по умолчанию равен Goose/3.1.22. Если дать goose3 самому ходить за страницами, каждый сервер будет видеть название библиотеки и точную версию. Это честно, но это же и отпечаток. Лучше задать User-Agent вручную или получать HTML самому и передавать raw_html.
Он указывает на бинарники MacPorts. imagemagick_convert_path по умолчанию — /opt/local/bin/convert, а imagemagick_identify_path — /opt/local/bin/identify. На моей машине таких файлов нет: /opt/local — это MacPorts, который есть далеко не у всех; Homebrew кладёт бинарники в /opt/homebrew. Этот дефолт не мешает, пока не включён fetch изображений (enable_image_fetching по умолчанию False, и это разумно), но если включить его в расчёте на извлечение главного изображения, здесь всё тихо и не сработает.
Он предполагает английский. target_language по умолчанию равен en, а use_meta_language=True, так что библиотека будет следовать языку, если он указан на странице, и возвращаться к английскому, если не указан. Для английского контента это удобно; для всего остального лучше задавать явно.
Остальные параметры выглядят разумно: parser_class — lxml, http_timeout — 30 секунд, strict включён, log_level — ERROR, parse_headers и keep_footnotes включены, images_min_bytes — 4,000.
Память и то, что с ней делает битый HTML
Две вещи, которые в каждом обзоре этой серии были помечены как не протестированные, теперь измерены.
Общий контекст стресс-теста — в сравнении памяти и обработки битого HTML для десяти библиотек.
Пиковое потребление resident memory, через /usr/bin/time -l, один новый процесс на ячейку — нижняя полка импорта показывает стоимость уже загруженной и простаивающей библиотеки, а пики включают и сам документ.
| Библиотека | Runtime | Базовый импорт | Пик 226 KB | Пик 10 MB |
|---|---|---|---|---|
| html2text | python3.14 | 18.7 | 19.9 | 71.2 |
| pyquery | python3.14 | 30.3 | 33.9 | 172.5 |
| resiliparse | python3.14 | 20.5 | 25.1 | 225.1 |
| markdownify | python3.14 | 23.9 | 28.9 | 278.5 |
| goose3 | python3.14 | 44.1 | 52.4 | 398.5 |
| cheerio | node22 | 66.8 | 76.5 | 398.5 |
| justext | python3.14 | 30.3 | 36.6 | 431.2 |
| newspaper4k | python3.14 | 52.6 | 61.8 | 668.5 |
| trafilatura | python3.14 | 52.5 | 64.8 | 927.1 |
| turndown | node22 | 47.8 | 68.4 | 2947.1 |
memory-results.json. Базовые линии Python и Node между собой не сравниваются; интерпретатор присутствует в обеих цифрах.
goose3 держит базовую полку на уровне 44.1 MiB и поднимается до 398.5 MiB на документе размером 10 MB. Среди показанных Python-библиотек это третий по величине импортный базис — это важно, если у вас чувствительный к cold start сценарий.
Битый HTML. Двенадцать документов, в каждом сломан ровно один аспект — незакрытые теги, неправильная вложенность inline-элементов, атрибуты без кавычек со пробелами, лишние закрывающие теги, отсутствие <html> вообще, дублирующиеся атрибуты, документ, обрезанный посередине тега, битые сущности, незакрытый <script>, ложная декларация charset, комментарий, содержащий разметку, и 600 уровней вложенности — плюс два корректных контрольных документа сопоставимого размера, потому что «ничего не вернул» говорит о поломанности только если на чистом документе того же размера библиотека не молчит так же.
goose3 не выбросил исключений в 0 из 14 случаев и вернул ничего в 10, восстановив 2/33 сигнальных токенов на битых страницах (malformed-results.json). Один тест из этого счёта исключён: по HTML5 всё, что идёт после незакрытого <script>, действительно считается содержимым скрипта, так что потеря этого фрагмента — это корректное поведение, а его восстановление было бы отклонением.
Плюсы и минусы
В плюс. Ноль размеченных boilerplate-токенов на десяти тестах, где библиотека что-то вернула. Доступно около двадцати восьми полей статьи, хотя их точность здесь была инвентаризирована, а не оценена. Разумный дефолт для загрузки изображений — выключено. Чистая установка на Python 3.14. Активная поддержка. Apache-2.0. Пустой результат легко отсеять, если вызывающий код явно проверяет его.
В минус. Самый низкий recall по статьям в наборе — 0.8243, и это произошло не из-за неправильного текста, а из-за полного отсутствия ответа. Страница, где статья представлена списком, вернёт пустую строку независимо от настроек. 44.3 MiB и холодный импорт в 2.2 секунды — тяжеловато на фоне 21.0 MiB и 15 мс у resiliparse. Требует close(). Два дефолта указывают на вещи, которые на большинстве машин неверны.
Кому стоит использовать, а кому нет
Используйте goose3 как кандидата, если извлечённый текст пойдёт в модель или базу, где размеченный boilerplate дорог, а страницы — обычные статьи с абзацами. На этом наборе тестов он не выдал ни одного размеченного boilerplate-токена, когда всё же отвечал. Поверхность метаданных доступна, но здесь не валидировалась; точность заголовка, автора, даты и изображения нужно проверять отдельными эталонными тестами, прежде чем считать это преимуществом выбора.
Пропустите его, если у вас корпус со множеством списков — вы получите пустые строки и никаких объяснений. Пропустите его, если важен cold-start: resiliparse импортируется в 145 раз быстрее. И пропустите, если вам нужен ответ на каждой странице, потому что «ответа нет» здесь — реальный исход: две страницы из 22, и обе тихо, в смысле без исключения и без предупреждения в виде пустой строки.
Связка, которую стоит проверить: goose3 как основной инструмент и fallback, если cleaned_text пустой или ниже вашего минимального порога. Readability восстановил все article-блоки в этом наборе из 22 страниц, включая оба пустых случая goose3. Этот синтетический результат подтверждает архитектурный паттерн, а не обещание, что fallback никогда не промахнётся на реальных страницах.
Где уместен управляемый API
В этом бенчмарке проверялся путь извлечения goose3 через raw_html: HTML уже был получен до того, как его увидел goose3. У goose3 есть и собственный путь сетевой загрузки, о чём говорит настройка User-Agent, но он здесь не тестировался. JavaScript-рендеринг и антибот-защита тоже не проверялись.
Для тех же тестовых страниц по всем шести экстракторам смотрите сравнение библиотек для извлечения статей.
Управляемый сервис для fetch/render/extraction, включая наш собственный Thunderbit, решает другую задачу. Thunderbit в этом тесте не бенчмаркался. Важное различие — извлечение статьи из уже полученного HTML против hosted-сервиса, который сам забирает и обрабатывает URL; в этой статье нет сравнения по одинаковым метрикам качества или скорости.
Честное сравнение такое: набор полей goose3 фиксирован и заточен под статьи — это идеально, когда у вас именно статьи, и не подходит для карточек товаров. Если HTML у вас уже есть и страницы действительно являются статьями, goose3 — бесплатный и очень аккуратный вариант.
Для hosted-сценария пригодится наш обзор API для веб-скрапинга; для self-hosted-альтернатив — путеводитель по open-source scraper. Если текст дальше пойдёт в модель, конвертация HTML в Markdown на Python показывает, где именно теряется точность.
Попробовать Thunderbit для извлечения веб-данных
Стоит ли использовать goose3?
Да — если статьи имеют абзацную структуру, а вызывающий код считает пустой вывод не успехом, а провалом извлечения.
На этом наборе goose3 не вывел ни одного размеченного boilerplate-токена, когда всё же отвечал, и вернул две пустые строки. Одна пришлась на почти пустую страницу, вторая — на синтетическое тело из одних списков. Это компромисс между точностью и покрытием, а не доказательство какого-то общего «характера» продукта.
Если важнее recall, тестируйте fallback с явной проверкой минимального объёма вывода. Readability восстановил каждый article-блок в этих 22 тестах; newspaper4k показал нулевую утечку размеченного boilerplate и recall 0.9865, при этом выдавая результат на всех 22 страницах. Эти цифры ранжируют только этот синтетический набор, а не неизвестную продакшен-выборку.
goose3 заслуживает место там, где цена лишнего слова выше, чем цена пропущенной страницы.
Попробовать Thunderbit для извлечения веб-данных Get Started Free
FAQ
Это у goose3 действительно идеальная точность или просто эффект от того, что он иногда отказывается? И то и другое, и это можно разделить. Для точности он был посчитан по 10 из 11 страниц, где есть boilerplate, так что одна страница выпала из среднего — это и есть эффект отказа. Но на этих десяти страницах он вернул ноль посторонних токенов на фоне специально «враждебного» boilerplate, тогда как Readability пропустил 35. Точность действительно хороша на страницах, где он отвечает; в колонке recall и видно, где проявляется отказ.
Почему goose3 ничего не возвращает на странице, где статья состоит из списка?
Для поиска тела статьи его механизм оценки кандидатов опирается на блоки, похожие на абзацы, а на странице, построенной из <li>, таких блоков нет. Дефолт parse_lists=True этого не меняет — я проверил его отдельно, плюс strict=False, и во всех трёх конфигурациях получил ноль символов, тогда как контроль на базе <p> дал 937 символов во всех трёх случаях. parse_lists лишь решает, сохранять ли список внутри уже найденной статьи.
Нужно ли вызывать close()?
Да, закрывайте явно через try/finally, как показано выше. В этом обзоре не измерялось, что накапливается при пропуске закрытия, поэтому здесь не утверждается количественная утечка в цикле; но жизненный цикл объекта Goose явно есть, и его нужно контролировать вызывающей стороне.
Какой User-Agent отправляет goose3?
По умолчанию — Goose/3.1.22, то есть название библиотеки и точная версия. Это работает только если вы позволяете ему самому загружать страницы; при передаче raw_html это вообще не имеет значения. Если загрузка всё же встроенная, User-Agent лучше задавать вручную: дефолт прямо сообщает каждому серверу, что именно к нему обращается.
Что этот обзор не тестировал?
Реальные страницы — вообще нет, это контролируемые тестовые наборы. Многоязычное извлечение, несмотря на то что target_language — параметр первого класса. Поля метаданных (заголовок, авторы, дата, главное изображение) были инвентаризированы, но не проверялись на точность. Извлечение изображений, которое выключено по умолчанию и использует пути ImageMagick, указывающие на пакетный менеджер, которого на большинстве машин нет. Параллельное или длительное поведение памяти, а также пропускная способность под нагрузкой; таблица памяти измеряла один новый процесс, обрабатывающий один документ.




