Если вы ищете инструменты для веб-скрейпинга на базе ИИ, вы наверняка уже сталкивались с Crawl4AI. Это популярный open-source-проект, который привлёк внимание разработчиков своей скоростью и гибкостью. Но что делать, если вы не программист — или просто хотите быстро получить данные, не возясь со скриптами на Python? Неважно, рассматриваете ли вы Crawl4AI для следующего проекта или ищете более удобную альтернативу, особенно если вы работаете в продажах, маркетинге, e-commerce или недвижимости, — вы по адресу. В этом обзоре я разберу, что предлагает Crawl4AI, где он силён и где ему может не хватать возможностей. Заодно покажу, как Thunderbit выглядит на его фоне как современное no-code-решение для бизнес-пользователей, которым нужно извлекать данные с веба буквально в пару кликов.
Что такое Crawl4AI?
Crawl4AI — это open-source Python-библиотека для веб-краулинга и извлечения данных, созданная с особым упором на сценарии с ИИ и большими языковыми моделями (LLM). Проект набрал популярность на GitHub благодаря высокой скорости, параллельному обходу страниц и возможности выдавать данные в удобных для ИИ форматах, таких как JSON и Markdown. Проще говоря, это инструмент для разработчиков, который подходит для масштабного скрейпинга сайтов с последующей передачей данных в ИИ-модели, аналитические панели или собственные базы данных.
Основные возможности и функции:
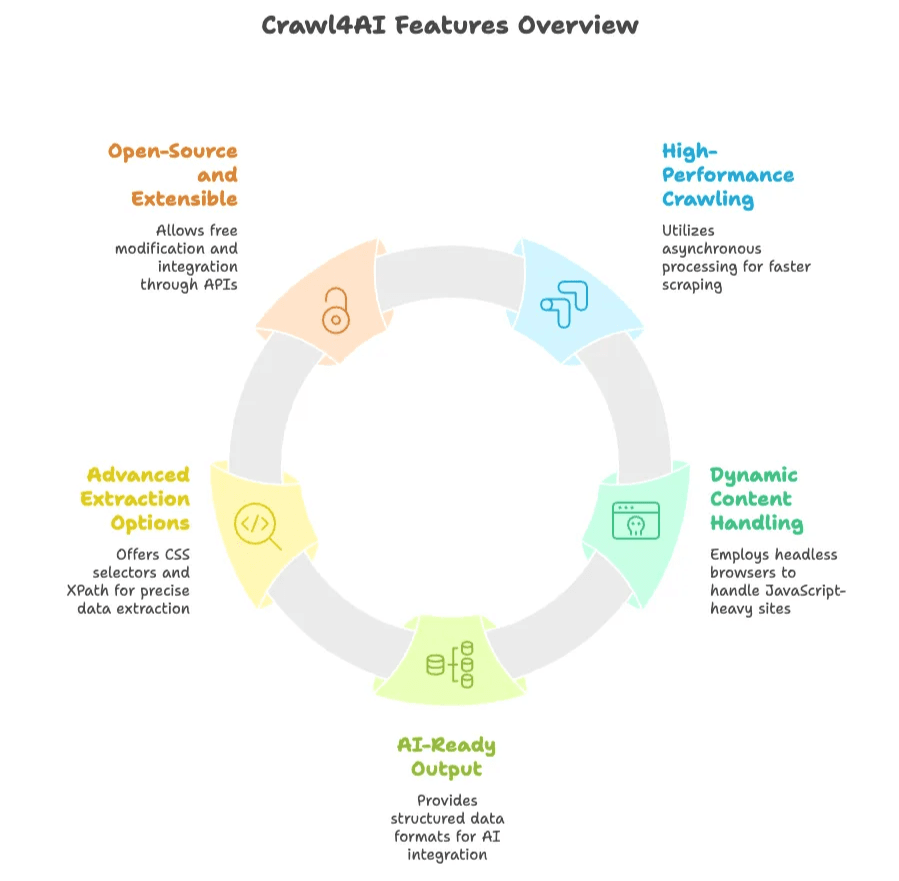
- Высокопроизводительный краулинг: использует асинхронную параллельную обработку, чтобы обходить сразу несколько страниц, поэтому работает заметно быстрее многих традиционных скрейперов.
- Работа с динамическим контентом: управляет headless-браузером (например, Chromium через Playwright), чтобы выполнять JavaScript и извлекать данные с современных динамических сайтов.
- Формат, готовый для ИИ: выводит данные в виде структурированного текста (JSON, Markdown или очищенный HTML), который сразу можно использовать в ИИ или аналитике.
- Продвинутые варианты извлечения: позволяет задавать правила извлечения через CSS-селекторы или XPath, а также подключать LLM для суммаризации или извлечения контента.
- Open-source и расширяемость: бесплатно используется, модифицируется и дорабатывается. Есть Python API, командная строка и REST API для гибкой интеграции.
Философия Crawl4AI — «демократизировать данные», предоставив разработчикам быстрый скрейпер на коде без платных стен и ограничений коммерческих инструментов. Если вы уверенно чувствуете себя в Python, это мощный способ быстро собирать большие объёмы веб-данных.
Для кого подходит Crawl4AI?
Crawl4AI в первую очередь создан для технических пользователей — разработчиков, data scientists, исследователей ИИ и всех, кто комфортно пишет на Python. Типичные сценарии использования:
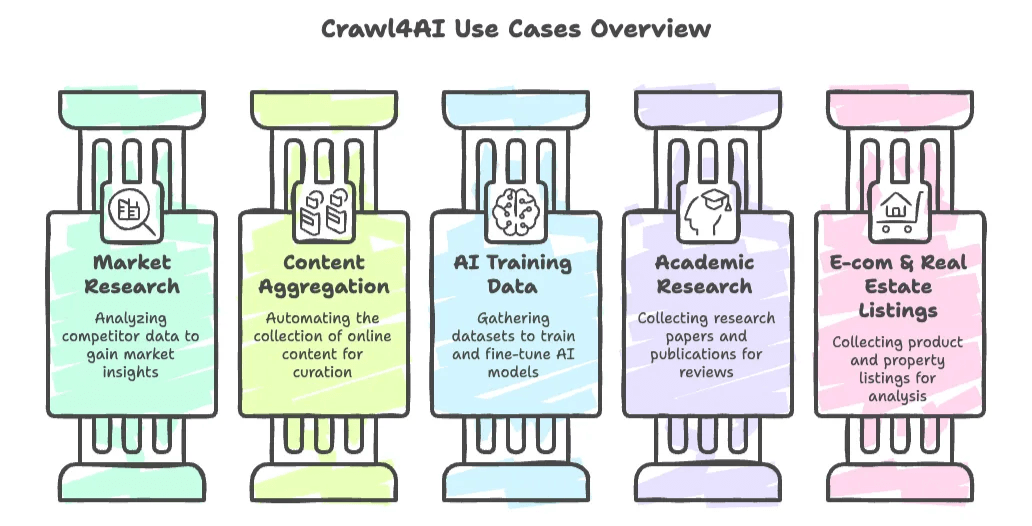
- Исследование рынка и анализ конкурентов: собирать данные с сайтов конкурентов, новостных ресурсов или соцсетей для анализа.
- Агрегация контента: автоматизировать сбор новостей, блогов или постов на форумах для кураторства или отслеживания трендов.
- Сбор обучающих данных для ИИ: собирать большие датасеты — например, документацию, вопросы и ответы или статьи — для обучения и дообучения языковых моделей.
- Академические исследования: автоматически собирать научные статьи, судебные решения или онлайн-публикации для обзоров литературы.
- Списки в e-commerce и недвижимости: разработчики могут строить собственные краулеры для сбора карточек товаров или объектов недвижимости для анализа.
Но есть и важный нюанс: Crawl4AI не рассчитан на нетехнических пользователей. Если вы менеджер по продажам, маркетолог или риелтор без опыта программирования, настройка и использование, скорее всего, покажутся вам сложными. Инструмент предполагает, что вы хорошо знаете Python и умеете настраивать правила извлечения и разбираться с ошибками.
Тарифный план Crawl4AI
Один из главных плюсов Crawl4AI — цена: он полностью бесплатный. Поскольку это open-source-проект, здесь нет лицензий, подписок и платных ограничений. Его можно установить через pip и сразу начать использовать.
Но у «бесплатно» есть свои оговорки:
- Настройка и поддержка: придётся вложить время в подготовку окружения, написание скриптов и поддержку рабочих процессов скрейпинга.
- Косвенные затраты: если вы запускаете большие объёмы краулинга, могут понадобиться прокси, серверы или облачные ресурсы.
- Поддержка: официальной службы поддержки нет — только форумы сообщества и GitHub Issues.
Для компаний со своей технической командой это может быть экономически выгодным решением. Но для нетехнических команд время и усилия, нужные для запуска, быстро перевесят нулевую стоимость лицензии.
Отзывы пользователей о Crawl4AI
Чтобы понять, как Crawl4AI работает на практике, я изучил отзывы на техноблогах, в каталогах ИИ-инструментов и на форумах сообщества. Вот что выяснилось:
Что пользователям нравится
- Скорость и экономичность: разработчики хвалят Crawl4AI за то, как быстро он может скрейпить большие сайты, часто опережая платные инструменты. Бесплатность — огромный плюс.
- Гибкость open-source: людям нравится полный контроль над кодом без привязки к вендору и без ограничений по функциям.
- Формат, готовый для ИИ: структурированный и чистый вывод данных, особенно в JSON или Markdown, экономит время тем, кто передаёт данные в ИИ-модели или аналитические инструменты.
Где у пользователей возникают трудности
Но похвала сопровождается и серьёзными оговорками — особенно для новичков и тех, кто не пишет код.
1. Высокий порог входа
Одна из самых частых мыслей — Crawl4AI не дружелюбен к новичкам. Если вы только начинаете заниматься веб-скрейпингом или не уверены в Python, вам придётся преодолеть довольно высокий порог входа. Здесь нет интерфейса «нажал и готово»: всё делается через скрипты и конфигурационные файлы. Настройка окружения, написание правил извлечения и работа с асинхронным краулингом требуют технической подготовки. Один из обозревателей сказал прямо: «Если вы не кодите, вы просто потеряетесь».
2. Не подходит для совсем начинающих
Даже тем, у кого есть некоторый технический бэкграунд, Crawl4AI может показаться непростым. Документация улучшается, но сообщество всё ещё небольшое, поэтому помощь можно искать долго. Пользователи сообщают об ошибках и сбоях на сложных сайтах, а устранение неполадок часто сводится к поиску решений в GitHub Issues или Stack Overflow. Не хватает и встроенных функций для типичных бизнес-задач — например, входа на сайты, обхода CAPTCHA или планирования регулярных запусков. Если вам нужно собирать данные по расписанию или работать с авторизацией, эти возможности придётся делать самостоятельно.
Пример из практики:
- Менеджер по маркетингу в компании среднего размера из сферы e-commerce попытался использовать Crawl4AI для отслеживания цен конкурентов. После нескольких дней борьбы со скриптами Python и драйверами браузера он сдался и перешёл на no-code-инструмент. Технические барьеры и отсутствие поддержки сделали решение непрактичным для команды.
- Риелтор хотел собрать объявления о недвижимости с нескольких сайтов. Настройка Crawl4AI показалась ему слишком сложной, и он не смог пройти даже начальную конфигурацию. Без разработчика под рукой проект застопорился.
Итог простой: хотя Crawl4AI — мощный инструмент для разработчиков, для бизнес-пользователей, которые просто хотят получать данные без головной боли, это далеко не лучший вариант.
Ключевые выводы из обзора Crawl4AI
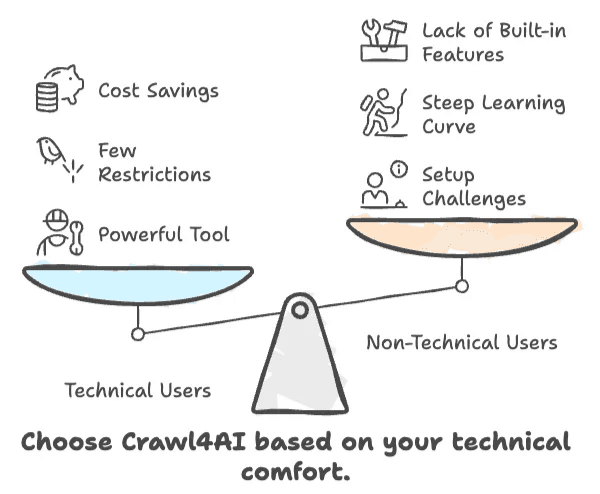
- Crawl4AI быстрый, гибкий и бесплатный — но только если вы уверенно работаете с кодом.
- Нетехническим пользователям будет сложно из-за настройки, порога входа и отсутствия встроенных бизнес-функций.
- Если вам нужно решение «нажал и работает» без кода, Crawl4AI, скорее всего, не для вас.
- Для разработчиков и практиков ИИ это мощный инструмент с минимальными ограничениями.
- Для бизнес-пользователей затраты времени и усилий могут перевесить экономию.
Знакомьтесь: Thunderbit — no-code AI Web Scraper для бизнес-пользователей
Теперь, когда стало понятно, где Crawl4AI не дотягивает для нетехнических пользователей, поговорим о более удачной альтернативе: Thunderbit.
Thunderbit — это расширение Chrome с AI web scraper, созданное специально для бизнес-пользователей: продаж, маркетинга, e-commerce и недвижимости, которым нужно быстро извлекать данные с любых сайтов без единой строчки кода. Я протестировал много инструментов для скрейпинга, и Thunderbit выделяется простотой и мощностью.
Чем Thunderbit отличается?
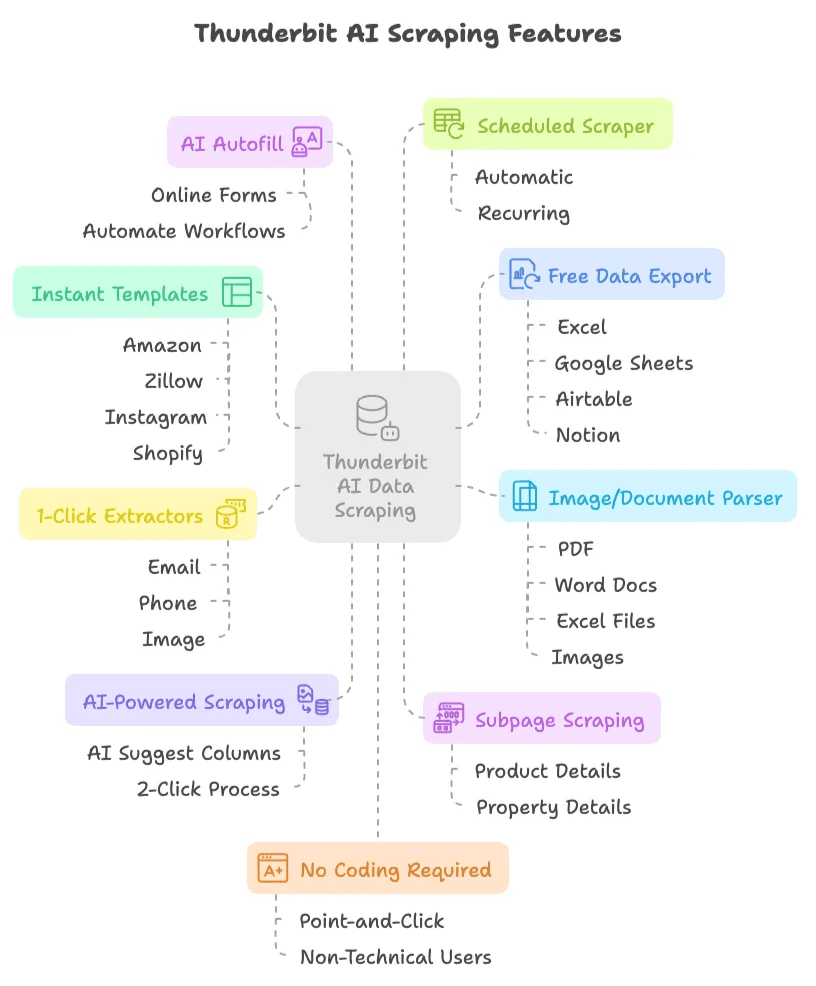
- Скрейпинг на базе ИИ в 2 клика: просто нажмите «AI Suggest Columns», дайте ИИ подсказать, что извлечь, а затем нажмите «Scrape». И всё. Никаких скриптов, селекторов и нервов.
- Скрейпинг подстраниц: ИИ Thunderbit может автоматически заходить на подстраницы — например, страницы товаров или объектов недвижимости — и дополнять вашу таблицу данными без ручной настройки.
- Готовые шаблоны скрейпинга: для популярных сайтов вроде Amazon, Zillow, Instagram и Shopify можно экспортировать данные в один клик с помощью заранее подготовленных шаблонов.
- Бесплатный экспорт данных: экспортируйте собранные данные в Excel, Google Sheets, Airtable или Notion без доплат.
- AI Autofill — полностью бесплатно: используйте ИИ для заполнения онлайн-форм и автоматизации рабочих процессов. Просто выделите контекст, а Thunderbit сделает остальное.
- Scheduled Scraper: настройте автоматический повторяющийся скрейпинг по простому расписанию — без cron-задач и настройки серверов.
- Извлечение email, телефонов и изображений в 1 клик: мгновенно находите email-адреса, номера телефонов и изображения на любом сайте.
- Парсер изображений/документов: извлекайте таблицы из PDF, Word-документов, Excel-файлов или изображений. Просто загрузите файл, дайте ИИ структурировать данные и нажмите «Scrape».
- Код не нужен: всё работает по принципу point-and-click и рассчитано на нетехнических пользователей.
Извлекайте данные с любого сайта с помощью ИИ Get Started Free
Thunderbit создан для того, чтобы сделать веб-данные доступными каждому, а не только разработчикам. Если хотите посмотреть, как это работает, загляните на страницу загрузки расширения Thunderbit для Chrome или посмотрите блог Thunderbit с реальными кейсами.
Попробуйте AI Web Scraper Thunderbit бесплатно
Тарифы Thunderbit
Thunderbit использует простую систему кредитов: 1 кредит = 1 строка результата. Вот как выглядят тарифы:
| Тариф | Месячная цена | Годовая цена (в месяц) | Кредиты в месяц |
|---|---|---|---|
| Free | Free | Free | 6 страниц |
| Starter | $15 | $9 | 500 |
| Pro 1 | $38 | $16.5 | 3 000 |
| Pro 2 | $75 | $33.8 | 6 000 |
| Pro 3 | $125 | $68.4 | 10 000 |
| Pro 4 | $249 | $137.5 | 20 000 |
Начать можно бесплатно и скрейпить до 6 страниц (или 10 по бесплатному пробному периоду). Платные тарифы дают больше кредитов и расширенные функции, но даже бесплатный план щедрый для тех, кто пользуется инструментом нечасто. Подробности — на странице цен Thunderbit.
Thunderbit vs Crawl4AI: сравнение бок о бок
Давайте сведём Thunderbit и Crawl4AI в прямом сравнении, чтобы было видно, где каждый инструмент силён — и где Thunderbit делает жизнь бизнес-пользователей проще.
| Функция / Критерий | Thunderbit | Crawl4AI |
|---|---|---|
| No-code, интерфейс point-and-click | ✅ | ❌ |
| AI Suggest Columns (автоопределение) | ✅ | ❌ |
| Скрейпинг подстраниц (автоматически) | ✅ | ❌ |
| Мгновенные шаблоны (Amazon и др.) | ✅ | ❌ |
| Бесплатный экспорт данных (Excel, Sheets) | ✅ | ❌ |
| AI Autofill (заполнение форм) | ✅ | ❌ |
| Плановый скрейпинг без кода | ✅ | ❌ |
| Извлечение email/телефонов/изображений в 1 клик | ✅ | ❌ |
| Извлечение таблиц из изображений и документов | ✅ | ❌ |
| Работает с динамическим контентом | ✅ | ✅ |
| Open-source | ❌ | ✅ |
| Требуется код | ❌ | ✅ |
| Есть бесплатный тариф | ✅ | ✅ |
| Поддержка сообщества | ✅ | ⚠️ (ограниченная) |
| Создан для бизнес-пользователей | ✅ | ❌ |
| Создан для разработчиков | ⚠️ | ✅ |
| Цена | $ (есть бесплатные и платные планы) | Бесплатно |
| Поддержка клиентов | ✅ | ❌ |
Легенда:
✅ = Да
❌ = Нет
⚠️ = Ограниченно / частично
$ = есть платные планы
Вывод
Если вы разработчик, любите работать с кодом и хотите полного контроля, Crawl4AI — мощный и бесплатный инструмент для масштабного веб-скрейпинга. Но если вы бизнес-пользователь — особенно в продажах, маркетинге, e-commerce или недвижимости — и просто хотите получать данные без лишней возни, Thunderbit — очевидный победитель. Он создан для нетехнических пользователей и сочетает автоматизацию на базе ИИ, готовые шаблоны и удобный интерфейс, который позволяет пройти путь от сайта до таблицы за секунды.
Скрейпьте любой сайт с Thunderbit
FAQ
1. Чем Thunderbit отличается от других AI web scraper, таких как Crawl4AI?
Thunderbit рассчитан на нетехнических пользователей и предлагает no-code-интерфейс в формате point-and-click, тогда как Crawl4AI — это open-source Python-библиотека, ориентированная на разработчиков. Thunderbit автоматизирует сложные задачи с помощью ИИ, делая веб-скрейпинг доступным каждому.
2. Какие уникальные функции Thunderbit предлагает для бизнес-пользователей?
Thunderbit предлагает рекомендации по колонкам на базе ИИ, скрейпинг подстраниц, готовые шаблоны для популярных сайтов и бесплатный экспорт данных в Excel или Google Sheets — всё без кода. Также есть плановый скрейпинг и инструменты извлечения email, телефонов и изображений в 1 клик.
3. Может ли Thunderbit обрабатывать сложные источники данных, например PDF или изображения?
Абсолютно! ИИ Thunderbit может извлекать таблицы из PDF, Word-документов, Excel-файлов и изображений. Просто загрузите файл, дайте ИИ структурировать данные и нажмите «Scrape» для мгновенного результата. Подробнее — в блоге Thunderbit.
Узнать больше
- Что такое data scraping и как сделать это в 2025 году — блог Thunderbit
- Лучшие инструменты и софт для веб-скрейпинга в 2025 году — блог Thunderbit
- Лучшие инструменты ИИ для сбора данных и готовых к обучению датасетов — Medium
- Как AI web scraper могут помочь с извлечением и анализом данных — Forbes
Попробуйте AI Web Scraper Get Started Free




