
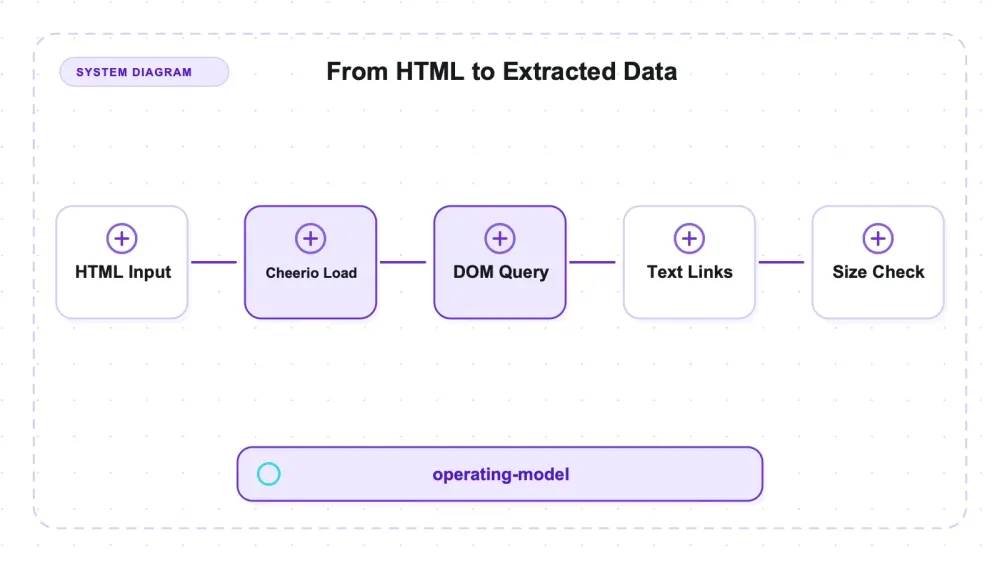
На одной машине cheerio в Node разобрал и извлёк заголовки и href из синтетического HTML-документа объёмом 10 МБ за 2 927,89 мс. selectolax, запущенный через CPython с C-backed парсером, выполнил ту же выборку полей за 158 мс. Отсортированные тексты заголовков и хэши href совпали. Это сравнение end-to-end по разным runtime, а не изолированная оценка самого алгоритма парсера.
На странице размером 10 КБ разница — всего 2×, и никто бы этого не заметил. Вопрос в том, где именно ваши страницы находятся на этой кривой.
Что такое cheerio
cheerio — это HTML-парсер для Node с синтаксисом jQuery, и в своей экосистеме он считается стандартным выбором не просто так: 30 449 звёзд на GitHub, лицензия MIT и push в репозиторий накануне моего теста. Проверенная версия: 1.2.0.
Официальная справка: официальное введение в Cheerio.
import * as cheerio from "cheerio";
const $ = cheerio.load(html);
const titles = $("h3.title").map((_, e) => $(e).text()).get();
const hrefs = $("a").map((_, e) => $(e).attr("href")).get();
Если вы когда-либо писали на jQuery, API уже вам знаком. Именно эта привычность во многом и помогла ему выиграть в своей экосистеме.
Под капотом это не один парсер, а целый стек: htmlparser2 и parse5 для парсинга, domhandler и domutils для дерева, cheerio-select для селекторов, а также undici, encoding-sniffer и другие — 11 прямых зависимостей, которые после разрешения превращаются в 22 пакета верхнего уровня и 9,0 МиБ на диске. Эти пакеты дают возможности парсинга и определения кодировок, но одновременно увеличивают и зависимостный след. В этом обзоре проверялась работа на битом HTML, но не точность обработки кодировок и не сравнивались отдельно оба backend парсинга.
Как проводилось измерение и почему ему можно доверять
В этой базе уже был бенчмарк парсеров: пять размеров страниц от 1 КБ до 10 МБ, 50 итераций, три независимых прогона и — самое важное — контроль паритета, который хэширует извлечённый контент: отсортированные заголовки плюс отсортированные href сравниваются с эталонным парсером. Парсер, который молча пропускает часть работы, не может показать честно быстрый результат.
Чтобы добавить туда cheerio, перед любым числом пришлось сделать две проверки.
Эталон оказался там же, где и раньше? selectolax был заново запущен в той же сессии на тех же фикстурах. Его content hash совпал на 5 из 5 размеров, а p50 оказался в пределах 0,989×–1,079× от опубликованной цифры. Значит, это та же машина, что и у исходной таблицы.
cheerio выдал те же оценочные поля? Его content hash — рассчитанный в Node по тому же правилу, SHA-256 от отсортированного текста заголовков и отсортированных href — совпадал с эталоном на 5 из 5 размеров. Это подтверждает паритет именно для этих отсортированных полей на данных фикстурах, но не форму DOM, не порядок документа, не атрибуты, не нормализацию текста и не обработку ошибок.
Только после этого timing-цифры вообще имеют смысл.
| Размер страницы | selectolax | lxml | PyQuery | cheerio (Node) | cheerio vs selectolax |
|---|---|---|---|---|---|
| 1 КБ | 0,0286 мс | 0,0508 | 0,0456 | 0,1147 мс | 4,0× |
| 10 КБ | 0,1725 мс | 0,1802 | 0,1728 | 0,3490 мс | 2,0× |
| 100 КБ | 1,4855 мс | 1,4145 | 1,4093 | 3,8399 мс | 2,6× |
| 1 МБ | 14,97 мс | 15,03 | 14,96 | 59,37 мс | 4,0× |
| 10 МБ | 158,10 мс | 165,25 | 162,86 | 2 927,89 мс | 18,5× |
p50 в миллисекундах, медиана из трёх прогонов. parser-bench.json. Три Python-парсера запускались в одном процессе; cheerio работал в Node 22, а это уже граница runtime, а не только библиотеки — см. ниже.
Как читать эту таблицу честно
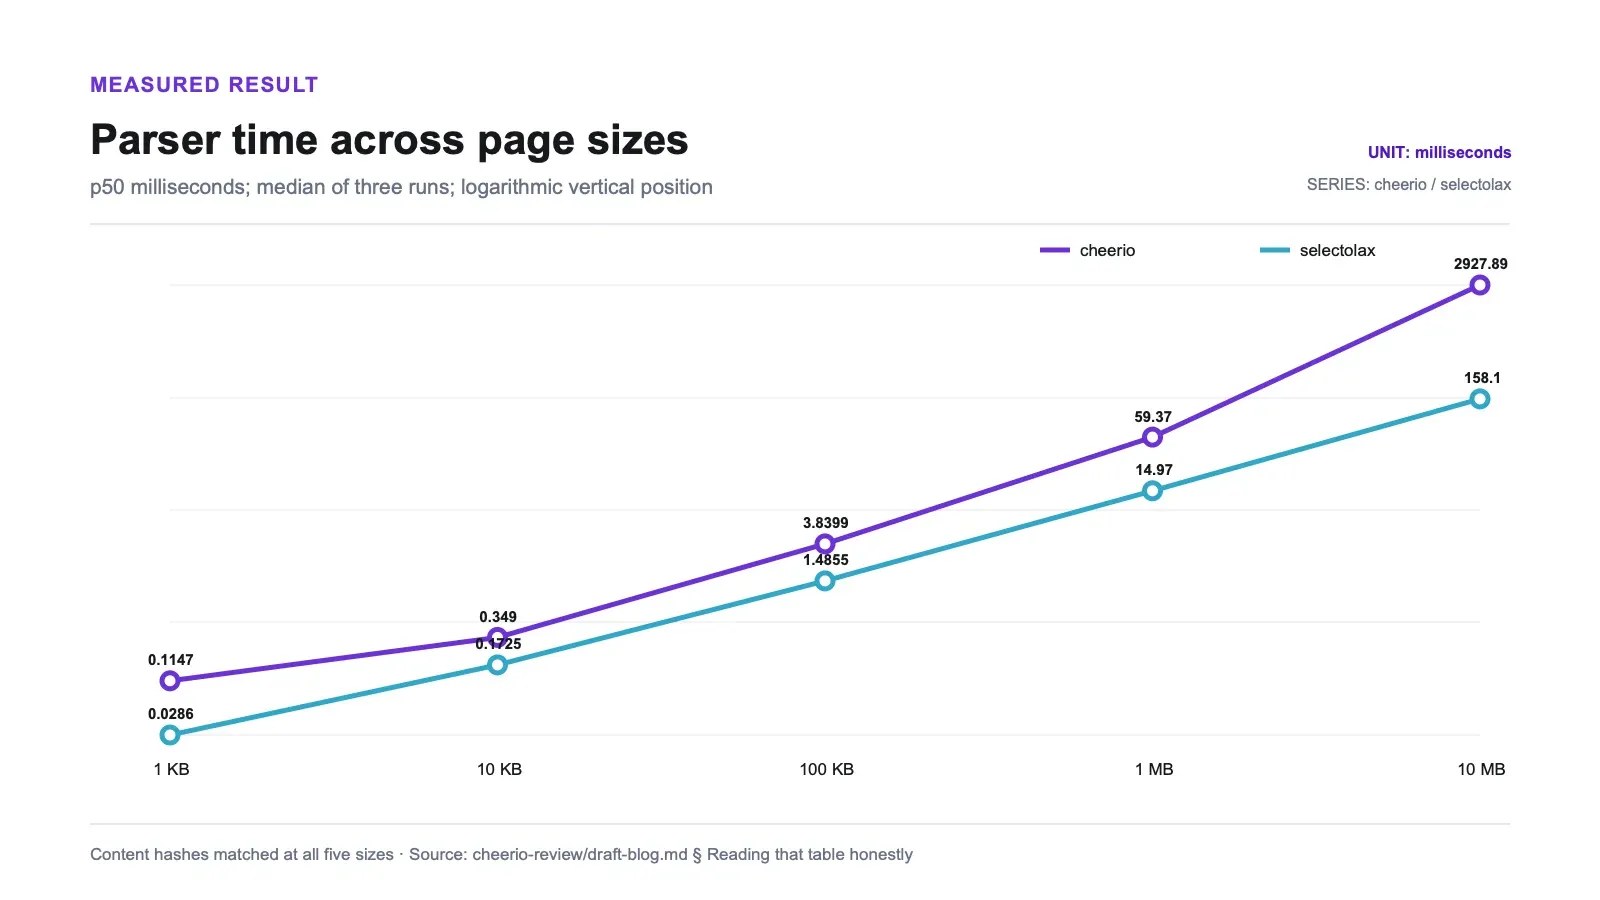
Строка 1 КБ — это шум. Среди трёх Python-парсеров разброс на этом размере составил 77,6%, а отдельные прогоны сильно пересекались — например, selectolax на трёх прогонах показал от 0,0267 до 0,0404 мс. При 28 микросекундах доминируют точность таймера и планирование задач. Я бы не ранжировал ничего на 1 КБ, включая cheerio.
Середина таблицы ничем не выделяется. От 10 КБ до 1 МБ разница составляет 2×–4×. Для парсера, который обрабатывает несколько сотен страниц, это 45 мс на страницу вместо 15, и вы этого никогда не увидите.
Строка 10 МБ — не шум. Три прогона cheerio дали 2 839, 2 928 и 2 954 мс — стабильно и далеко от соседних значений. Конечный результат на 10 МБ резко выбивается из общей картины для меньших размеров. Пяти точек недостаточно, чтобы установить асимптотическую сложность или понять, какой именно слой — runtime, парсер, селектор, выделение памяти или GC — дал скачок.
Он попадает в диапазон BeautifulSoup. В опубликованном бенчмарке на той же 10 МБ фикстуре измерили ещё четыре парсера, и именно сравнение cheerio с их результатами даёт самый полезный вывод в этой статье:
| Парсер (10 МБ) | p50 |
|---|---|
| selectolax (lexbor) | 159,93 мс |
| lxml | 172,93 мс |
| parsel | 231,85 мс |
| selectolax (modest) | 247,95 мс |
| BeautifulSoup + lxml | 2 261,56 мс |
| BeautifulSoup + html.parser | 2 788,75 мс |
| cheerio | 2 927,89 мс |
Четыре строки на Python — это опубликованные значения из bench_parse.json; значение cheerio — из этого прогона. Эталонный парсер воспроизвёлся в пределах 0,989×–1,079× между двумя запусками, так что различия меньше примерно 8% стоит считать укладывающимися в эту погрешность — cheerio против html.parser у BeautifulSoup (разница 5%) попадает туда, а cheerio против selectolax (18×) — нет.
BeautifulSoup — это библиотека, к которой обращаются ради удобства, сознательно принимая её медлительность; именно её обычно советуют заменить в любом обсуждении производительности Python. На документе в 10 МБ cheerio находится внизу того же диапазона, а не рядом с C-backed парсерами, с которыми его обычно ставят в один ряд.
Вопрос о замене на стороне Node в этой статье остаётся открытым. Более новые альтернативы для Node не тестировались, поэтому этот результат не доказывает, что переход на другую библиотеку невозможен, и не объявляет их менее зрелыми. Он лишь показывает измеренный путь cheerio по сравнению с перечисленными Python-стеками.
Это сравнение не только библиотек, но и runtime. Миллисекунды cheerio — это Node с его JIT и сборщиком мусора; у остальных — CPython, вызывающий C-backed парсеры. Content hash доказывает, что выполнена одна и та же работа, а оба числа — это именно то, что ощущает разработчик, выбирая стек. Но никто не должен читать это как «алгоритм cheerio в 18× хуже, чем у selectolax». Это то, что произошло на этой машине в нативном runtime каждой библиотеки.
Что с окружением и настройкой
| Библиотека | Пакеты | Диск | Лицензия | Звёзды | Последний push |
|---|---|---|---|---|---|
| cheerio | 22 (npm) | 9,0 МиБ | MIT | 30 449 | 2026-08-11 |
| PyQuery | 3 (pip) | 20,1 МиБ | BSD | 2 380 | 2026-07-27 |
Официальная справка: документация по настройке Cheerio.
metadata-snapshot.json, полученный в день написания.
npm install cheerio занял меньше двух секунд и подтянул 9,0 МиБ. Холодный импорт в отдельном прогоне-конвертере на той же машине занял 0,056 с.
11 прямых зависимостей — это много для парсера, и об этом стоит помнить, если вы проверяете дерево зависимостей: htmlparser2, parse5, parse5-htmlparser2-tree-adapter, parse5-parser-stream, domhandler, domutils, dom-serializer, cheerio-select, encoding-sniffer, undici и whatwg-mimetype. Там поставляются сразу две полноценные реализации парсера, потому что cheerio может использовать любую из них в зависимости от запроса.
Тридцать тысяч звёзд и свежий push накануне тестирования — это очень хороший сигнал о живой поддержке в этой категории.
Память и то, что делает с ней битый HTML
Потребление памяти и поведение на некорректном HTML влияют на развёртывание и обработку ошибок, поэтому здесь они измеряются отдельно.
Более широкий контекст стресс-теста есть в сравнении памяти и обработки битого HTML у десяти библиотек.
Пиковая resident memory, через /usr/bin/time -l, по одному новому процессу на каждую ячейку — нижняя граница импорта показывает, сколько библиотека стоит уже загруженная и простаивающая, а пики включают документ.
| Библиотека | Runtime | Нижняя граница импорта | Пик на 226 КБ | Пик на 10 МБ |
|---|---|---|---|---|
| html2text | python3.14 | 18,7 | 19,9 | 71,2 |
| pyquery | python3.14 | 30,3 | 33,9 | 172,5 |
| resiliparse | python3.14 | 20,5 | 25,1 | 225,1 |
| markdownify | python3.14 | 23,9 | 28,9 | 278,5 |
| goose3 | python3.14 | 44,1 | 52,4 | 398,5 |
| cheerio | node22 | 66,8 | 76,5 | 398,5 |
| justext | python3.14 | 30,3 | 36,6 | 431,2 |
| newspaper4k | python3.14 | 52,6 | 61,8 | 668,5 |
| trafilatura | python3.14 | 52,5 | 64,8 | 927,1 |
| turndown | node22 | 47,8 | 68,4 | 2947,1 |
memory-results.json. Базовые показатели Python и Node нельзя напрямую сравнивать между собой; интерпретатор присутствует в обоих случаях.
У cheerio самая высокая нижняя граница импорта в этой смешанной таблице — 66,8 МиБ, включая runtime Node и зависимости. Процесс достигал пика 398,5 МиБ на 10 МБ фикстуре. Остальные строки включают парсеры, конвертеры и извлекатели статей, выполняющие другую основную работу, так что используйте их как контекст по footprint процесса, а не как рейтинг производительности между равными. Строка turndown в том же runtime достигла куда более высокого пика, но она выполняет конвертацию, а не измеренный для cheerio контракт выбора заголовков и ссылок.
Битый HTML. Двенадцать документов, каждый из которых ломает ровно одну вещь — незакрытые теги, неправильная вложенность inline-элементов, атрибуты без кавычек и пробелами, лишние закрывающие теги, отсутствие <html> вообще, дублирующиеся атрибуты, обрыв документа посреди тега, битые сущности, незакрытый <script>, ложное объявление charset, комментарий с разметкой и 600 уровней вложенности — плюс два корректных control-документа сопоставимого размера, потому что «ничего не вернул» говорит о некорректности только если библиотека не молчит и на чистом документе того же размера.
cheerio выбросил исключение в 0 из 14 случаев и ни разу не вернул пустой результат, восстановив 11/22 оцениваемых маркеров на битых фикстурах (malformed-results.json). Для парсеров scorer проверяет контрольные маркеры заголовков и ссылок на одиннадцати оцениваемых malformed-документах; он не оценивает paragraph sentinel, а фикстура с незакрытым <script> исключена. Без baseline с тем же контрактом в этом разделе показатель 11/22 не является рейтингом качества. Корректный вывод такой: cheerio вернул непустой результат без исключений на всех 14 входах с битым HTML и control-документах, восстановив при этом половину оцениваемых маркеров.
Плюсы и минусы
Плюсы. Знакомый синтаксис jQuery. MIT. Живой сигнал поддержки: 30 449 звёзд и активность репозитория накануне теста. Два backend-парсера и пакеты, связанные с кодировками, присутствуют, хотя восстановление backend'ов и точность кодировок здесь не изолировались. Отсортированный hash по заголовкам и href совпал с эталоном на всех размерах фикстур.
Минусы. На документе 10 МБ в 18,5× медленнее selectolax и в 4× медленнее на 1 МБ. 11 прямых зависимостей, включая две полноценные реализации парсера. Только Node. И в документации нет намёка на размер, после которого он перестаёт быть очевидным выбором.
Кому он подойдёт, а кому нет
Используйте cheerio, если вы в Node, API в стиле jQuery для вас важен, а типичные страницы похожи на тестовые размеры вплоть до 1 МБ. Один мегабайт — это максимальная протестированная точка перед резким скачком на 10 МБ; статья не устанавливает границу между ними и не утверждает, какая доля веба находится ниже неё.
Протестируйте перед использованием, если речь о очень больших HTML-документах — например, сгенерированных отчётах, выгрузках каталога или длинных списках. Поведение XML sitemap не тестировалось. На 10 МБ HTML-файле 2,9 секунды на документ — это уже ощутимая стоимость, которая будет накапливаться.
Если вы в Python, этот тест говорит другое: selectolax, lxml и PyQuery по скорости практически равны начиная с 10 КБ (разница в пределах 0,5%–5,4%, а диапазоны прогонов пересекаются), так что выбирать стоит по API, а не по скорости. Интересное число здесь — именно отрыв cheerio от всех трёх, а не различия между ними.
Где здесь место managed API
cheerio парсит HTML, который у вас уже есть. Он не скачивает страницы, не рендерит JavaScript и не решает антибот-защиту — а на многих реальных ресурсах именно это и есть самая трудная часть.
Managed-сервис для получения, рендеринга и извлечения данных, включая наш собственный Thunderbit, находится на другой границе ответственности. Thunderbit в этом тесте не бенчмаркался. Важное различие здесь такое: парсинг уже переданного HTML с селекторами против аутсорса получения, рендеринга и извлечения. Эта статья не даёт сравнения по одной и той же метрике качества, задержки или стоимости.
Честная формулировка такая: если HTML у вас уже есть и вы знаете свои селекторы, cheerio бесплатен и приятен в использовании. Если же вы собираете страницы в масштабе или предпочитаете описывать данные, а не DOM, это уже совсем другая покупка.
Для более широкого обзора смотрите наш обзор API для web scraping, а также пул open-source scraper'ов для self-hosted решений. Если результат парсинга пойдёт в модель, статья о преобразовании HTML в Markdown в Python показывает, где теряется точность.
Попробуйте Thunderbit для извлечения веб-данных
Стоит ли использовать cheerio?
Да, в Node — когда важен удобный API и типичные документы остаются в диапазоне от небольших до 1 МБ.
Знакомство с API и текущие сигналы поддержки — вполне нормальные критерии выбора. Но бенчмарк не доказывает, что для вас существует конкретный ответ службы поддержки, и не подтверждает, что распределение размеров страниц в тесте совпадает с продакшен-корпусом.
Главное число, которое стоит запомнить, — это 10 МБ. Где-то между 1 МБ и 10 МБ стоимость cheerio перестаёт следовать за другими и начинает множиться — 4× превращается в 18,5×. Если в вашем корпусе есть такие документы, обязательно сделайте собственный бенчмарк до внедрения, потому что сама библиотека вас об этом не предупредит.
Попробуйте Thunderbit для извлечения веб-данных Get Started Free
Частые вопросы
Справедливо ли сравнивать cheerio с Python-парсерами? Это сравнение стеков, а не алгоритмов. Все четыре варианта выдали одинаковые отсортированные тексты заголовков и href по правилу хэширования на 5 из 5 размеров страниц. Это не доказывает полную эквивалентность парсеров. В timing cheerio входит поведение Node runtime, а в остальные — вызовы CPython к C-backed парсерам; сравнение описывает именно эти end-to-end решения.
Почему строка 1 КБ не ранжируется? Потому что при 28 микросекундах измерение почти полностью определяется шумом. На трёх прогонах Python-парсеры разошлись на 77,6%, а отдельные результаты перекрывались. Любое упорядочивание на таком размере было бы артефактом. Начиная с 10 КБ данные уже достаточно стабильны для чтения.
Что вызывает скачок на 10 МБ? Этот тест этого не говорит. Он лишь показывает, что скачок реален и это не шум: три прогона cheerio дали 2 839, 2 928 и 2 954 мс, и эти значения заметно отделены от остальных, тогда как разница на 1 МБ составляла 4×. Чтобы выделить причину, пришлось бы профилировать backend-парсеры cheerio отдельно, а это выходило за рамки исследования.
Сколько у него на самом деле зависимостей?
11 прямых, 22 пакета верхнего уровня после разрешения, 9,0 МиБ на диске. Две из них — полноценные реализации парсера: htmlparser2 и parse5, потому что cheerio может использовать любую. Это цена за поддержку и forgiving, и spec-compliant parsing, и об этом полезно помнить при аудите дерева зависимостей.
Что здесь не тестировалось?
Тесты покрывали пиковую память процесса на одном документе 226 КБ и одном документе 10 МБ, а также набор из 14 входов с битым HTML и control-документами, где cheerio нигде не выбросил исключение, везде вернул непустой результат и восстановил 11/22 оцениваемых маркеров. Не тестировались потоковая обработка через parse5-parser-stream, корректность кодировок, восстановление, зависящее от backend'а, точка скачка производительности между 1 и 10 МБ, XML-парсинг и более новые альтернативы для Node.




