
На Trustpilot размещено 361 миллион активных отзывов о 1,27 миллиона компаний — и большинство скраперов, созданных для извлечения этих данных, сломались ещё несколько месяцев назад. Если ты недавно пытался выгрузить отзывы, то наверняка уже упирался в печально известный логин-барьер на 10-й странице и видел в ответ лишь ошибку.
Последние несколько недель я тестировал, изучал и сравнивал инструменты, которые по-прежнему способны стабильно собирать данные отзывов Trustpilot в 2026 году. Ситуация сильно изменилась: антибот-защита Trustpilot стала жёстче, фронтенд на Next.js генерирует классы, которые меняются почти при каждом деплое, и — что самое важное — без авторизации доступ теперь обрывается уже после 10 страниц отзывов. В посте на Reddit конца 2025 года это разочарование сформулировали предельно точно: «ни один из акторов в магазине не работает».
Так какие же инструменты реально справляются? Я оценил пять решений по тому, как они обходят логин-барьер, справляются с антибот-мерами, сколько требуют поддержки и насколько удобны как для маркетологов, так и для разработчиков.
Почему собирать отзывы Trustpilot в 2026 году сложнее, чем кажется
Trustpilot — это не простая статическая страница, которую можно запросить обычным HTTP-вызовом и распарсить через BeautifulSoup. Это современная динамическая платформа на Next.js, а её защита за последний год заметно усилилась.
С чем на самом деле приходится бороться:
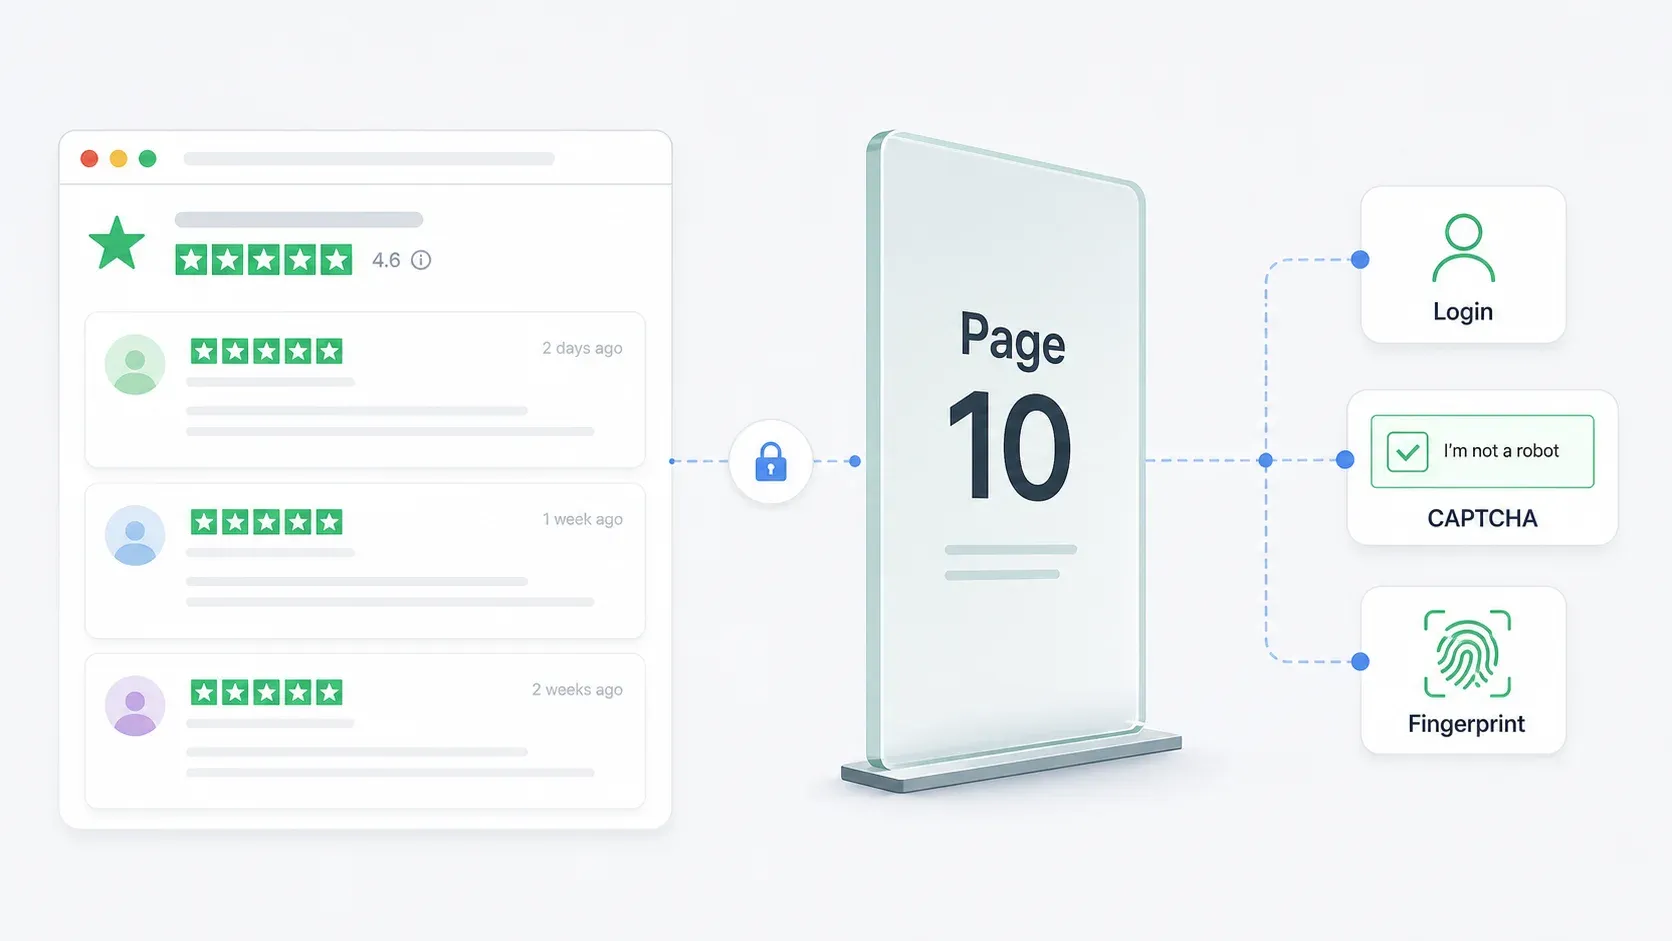
Логин-барьер на 10-й странице. Это главная проблема. В руководстве Web Scraper от марта 2026 года подтверждается, что Trustpilot показывает только первые 10 страниц отзывов, а затем выводит запрос на вход в систему. Если у компании 2000 отзывов (это примерно 100 страниц по 20 отзывов на страницу), ты теряешь доступ к 90% данных, если у тебя нет авторизованной сессии.
Антибот-защита. Trustpilot использует reCAPTCHA, блокировки на уровне сессии, фильтрацию запросов на уровне CDN и браузерный фингерпринтинг. На его странице About прямо сказано, что сайт «защищён reCAPTCHA» и собирает сигналы устройства и взаимодействия.
Динамические CSS-классы. Поскольку Trustpilot использует Next.js с CSS modules, классы вроде styles_reviewCardInner__EwDq2 генерируются во время сборки и меняются при каждом обновлении сайта. Собственный туториал ScraperAPI опирается именно на такие селекторы — а значит, любой код по этому гайду сломается при следующем изменении фронтенда Trustpilot.
Изменения структуры DOM. И не только классы: может меняться и сама HTML-иерархия. Элементы начинают вкладываться друг в друга иначе, появляются новые обёртки, перестраиваются компоненты пагинации.
Скраперы, завязанные на CSS-селекторы — будь то Apify Actors, workflows в Octoparse или собственные Python-скрипты — на Trustpilot очень хрупкие. Они работают... пока не перестают. И «пока не перестают» здесь часто означает недели, а не месяцы.
Что я учитывал при выборе лучших скраперов для Trustpilot Reviews
Я не оценивал эти инструменты по общему принципу «может ли он собрать данные со страницы». Каждый инструмент из списка способен вытащить данные из простой HTML-страницы.
Настоящий вопрос такой: умеет ли он работать именно с Trustpilot — со всеми его особенностями — в 2026 году?
Вот что было важно больше всего:
| Критерий | Почему это важно для Trustpilot |
|---|---|
| Работа с логин-барьером (страница 10+) | У большинства компаний намного больше 200 отзывов. Лимит в 10 страниц означает, что ты теряешь большую часть исторических данных. |
| Подход к обходу антибот-защиты | reCAPTCHA, блокировка сессий и фильтрация CDN легко остановят наивный скрапер. |
| Устойчивость селекторов / сопровождение | Сгенерированные CSS-классы регулярно ломают инструменты, завязанные на селекторы. Есть ли автоисправление? |
| Поддержка пагинации | Отзывы растянуты на сотни страниц. Ручной сбор постранично здесь не подходит. |
| No-code или нужен код | Маркетологам нужен клик-а-клику, разработчикам — полный контроль. |
| Цена / бесплатный тариф | Командам с ограниченным бюджетом важно понимать стоимость заранее. |
| Варианты экспорта | Бизнес-пользователям нужны Google Sheets, Airtable, Notion — а не только сырой JSON. |
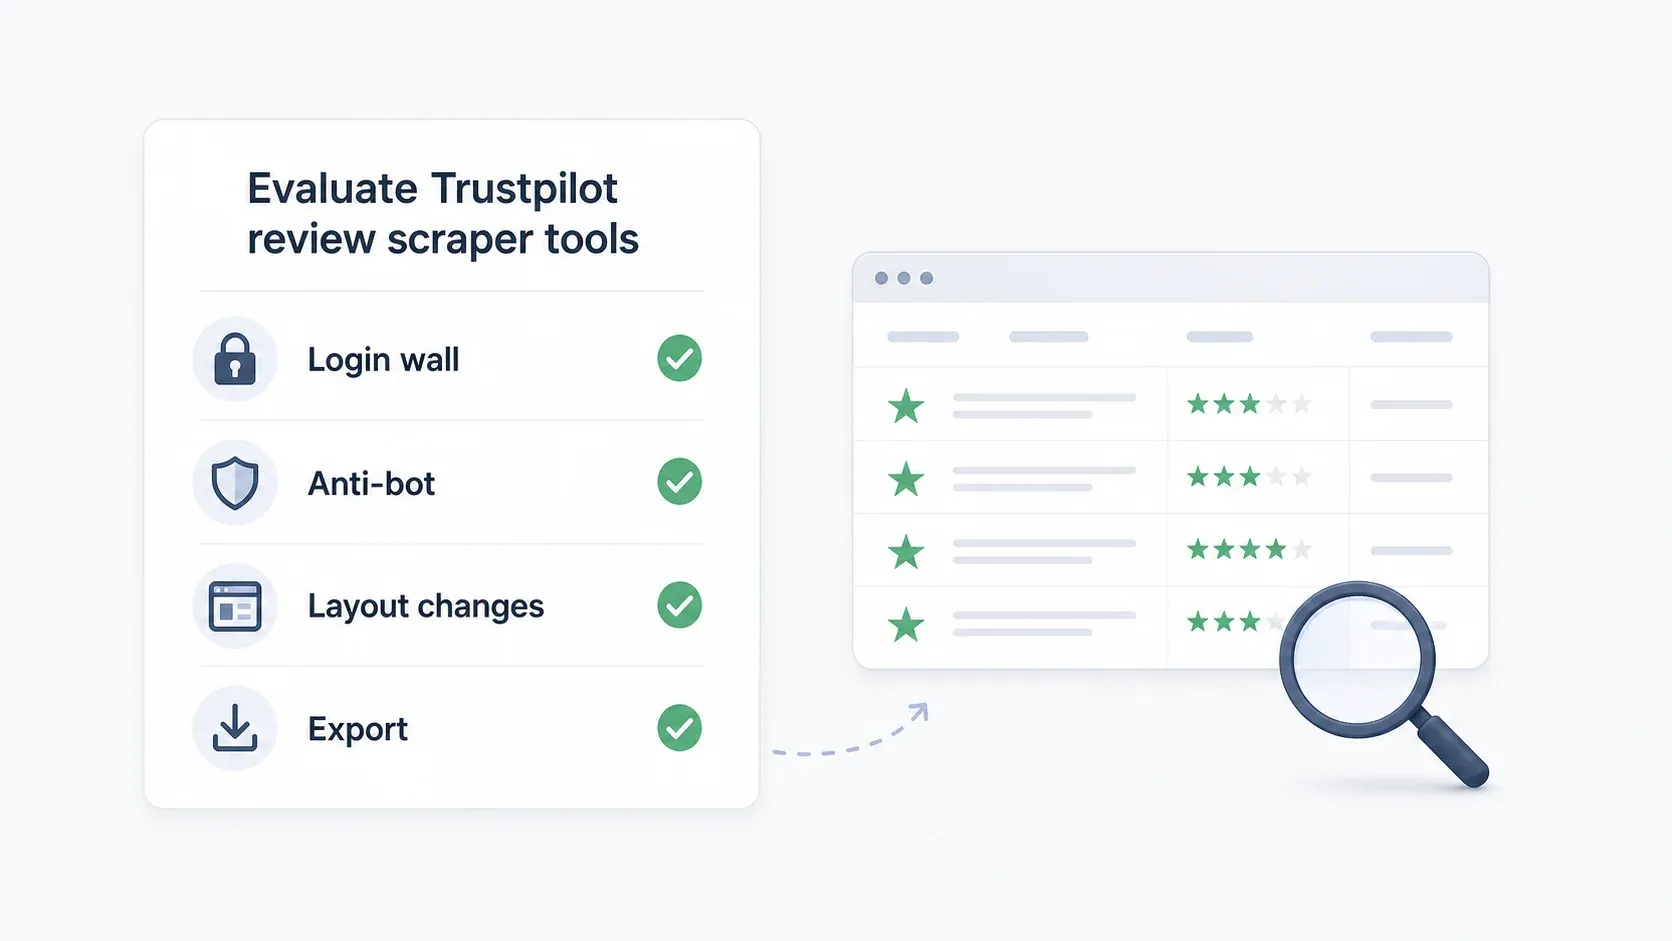
Логин-барьер — это решающий фактор.
Если инструмент не может пройти дальше 10-й страницы — или хотя бы не даёт понятного способа работать через авторизованный доступ — в 2026 году он не подходит как скрапер Trustpilot.
Лучшие скраперы Trustpilot Reviews в сравнении
Полная таблица сравнения:
| Инструмент | Уровень навыков | Работа с логин-барьером | Подход к антибот-защите | Пагинация | Бесплатный тариф | Варианты экспорта |
|---|---|---|---|---|---|---|
| Thunderbit | No-code | Режим браузера (использует твою уже авторизованную сессию Chrome) | AI-семантическое извлечение адаптируется к изменениям макета | Автоопределение, многостраничный режим | 6 страниц бесплатно в месяц | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Apify | Low-code | Зависит от Actor; для страниц 10+ некоторые требуют настройки cookies | Встроенная ротация прокси, логика зависит от Actor | Настраивается в каждом Actor | $5/мес в бесплатных кредитах платформы | JSON, CSV, Excel, XML, RSS |
| Octoparse | No-code (визуальный) | Ручная настройка cookies / сессии | Ротация IP, residential proxies, обход CAPTCHA (платно) | Workflow по кликам и скроллу | Бесплатный план + 14-дневный пробный доступ к premium | CSV, Excel, JSON, HTML, XML, базы данных |
| Web Scraper | No-code (sitemap) | Ограничено — в их же гайде зафиксирован лимит в 10 страниц отзывов | Cloud + proxy на платных планах | Настраивается; рекомендуется JS-клик | Бесплатное расширение Chrome | CSV, XLSX |
| ScraperAPI | Для разработчиков (Python) | Управление сессией / cookies на уровне кода | Более 40 млн residential proxies, рендеринг JS, обработка CAPTCHA | Через код | 7-дневный trial, 5000 API-кредитов | Определяется разработчиком (CSV, JSON и т. д.) |
1. Thunderbit

Thunderbit — это AI-расширение для Chrome, созданное для бизнес-команд, которым нужны структурированные данные с сайтов без написания кода. Для Trustpilot у него есть специальный шаблон для сбора отзывов, который одним кликом извлекает имя автора, рейтинг, заголовок отзыва, текст, дату и ответ компании.
Я здесь не совсем беспристрастен — я работаю в Thunderbit, — но причина, по которой мы сделали продукт именно так, напрямую связана со сложностью сбора данных с Trustpilot. Наш AI читает страницы семантически, а не опирается на CSS-селекторы. Когда Trustpilot меняет названия классов или перестраивает DOM, Thunderbit адаптируется, потому что ищет не конкретные HTML-адреса, а смысл элементов страницы.
Попробовать Thunderbit для сбора отзывов Trustpilot
Как Thunderbit работает с логин-барьером на 10-й странице
Именно здесь важен режим браузера. Thunderbit работает внутри твоего браузера Chrome — того самого, где ты уже вошёл в Trustpilot. Когда ты переключаешься в режим browser scraping, расширение читает страницы, которые видны в твоей авторизованной сессии. Никаких плясок с прокси. Никакой инъекции cookies. Никаких Playwright session pools.
Практический сценарий такой: войди в Trustpilot в Chrome, открой нужную страницу с отзывами, запусти расширение. Один клик — и AI сам определяет, какие поля отзывов есть на странице, и извлекает их. Нужен другой набор данных? Просто опиши его, и AI подстроится. Дальше пагинация проходит автоматически — Thunderbit обходит все страницы, доступные твоей браузерной сессии.
Почему Thunderbit не ломается при изменениях Trustpilot
Наша страница шаблона Trustpilot прямо сравнивает этот подход с традиционными скраперами: они ломаются при изменении макета, когда нужно обновлять CSS-селекторы. Thunderbit использует семантический AI, который понимает контент без привязки к конкретным CSS, работает с динамическим содержимым и автоматически обрабатывает пагинацию.
Сравни это с кодом из туториала ScraperAPI, где парсинг идёт по классам вроде styles_reviewCardInner__EwDq2. Такой селектор сломается при следующем деплое Trustpilot. AI в Thunderbit спрашивает не «что находится внутри этого конкретного div-класса?», а «где на этой странице текст отзыва?»
Ключевые возможности для сбора данных Trustpilot
- AI сам находит поля: расширение самостоятельно определяет поля отзыва (имя, рейтинг, дата, заголовок, текст, ответ компании) без ручной настройки — или использует нужный тебе набор, если ты его задашь
- Работа в один клик: один клик → готовая таблица. И всё.
- Режим браузера для страниц с авторизацией: работает в твоей авторизованной сессии Chrome и даёт доступ к 10-й странице и дальше
- Авто-пагинация: обрабатывает многостраничные наборы отзывов без ручного вмешательства
- Сбор подстраниц: может переходить в профили отдельных авторов для дополнительного обогащения данных
- Плановый сбор: еженедельный или ежемесячный мониторинг отзывов для репутационного анализа
- Экспорт: Google Sheets, Airtable, Notion, CSV, JSON — всё включено бесплатно
Цена
- Бесплатный план: 6 страниц в месяц, без кредитной карты
- Система на кредитах: 1 кредит = 1 строка результата
- Платные планы: $15/мес или около $9/мес при годовой оплате (страница цен)
Лучше всего подходит для: маркетинговых и операционных команд, а также бизнес-пользователей, которым нужны отзывы Trustpilot без кода — и которые не хотят поддерживать скрапер, ломающийся каждые несколько недель.
2. Apify
Apify — это облачная платформа для скрапинга с маркетплейсом готовых "Actors" — шаблонов сбора данных, созданных другими пользователями и командой Apify. Для Trustpilot в магазине есть несколько Actors от сообщества, но их надёжность заметно отличается.
Компромисс у Apify такой: мощно, но фрагментировано. Одни Actors работают. Другие устарели. Третьи требуют cookies для страниц 10+. И жалобы на Reddit в духе «ни один из акторов в магазине не работает» вполне реальны — они показывают, как быстро изменения Trustpilot ломают логику конкретных Actors.
Trustpilot Actors и известные ограничения
В Apify Store есть несколько Trustpilot Actors. По крайней мере один из них (от разработчика "burbn") прямо указывает, что для страниц дальше 10 требуется ввод cookie. У других — рейтинг 0.0, очень мало пользователей или совсем свежие даты обновления, что говорит о текущем сопровождении и разной надёжности.
Стоит упомянуть и устаревшие Actors. Один старый Actor читал встроенный JSON __NEXT_DATA__ Trustpilot напрямую — умный и быстрый подход по сравнению с DOM-парсингом, но он всё равно сломался, когда Trustpilot изменил структуру данных.
Работа с логин-барьером и антибот-защитой
- Логин-барьер: полностью зависит от выбранного Actor. Некоторые поддерживают подстановку cookies для страниц 10+, другие — нет.
- Антибот-защита: платформа Apify включает ротацию прокси и инфраструктуру на основе compute units. Residential proxies доступны по цене от $8/GB на Free/Starter-планах.
- Сопровождение: если Actor ломается, ты либо ждёшь, пока автор его исправит, либо переключаешься на другой Actor, либо заказываешь кастомный private Actor.
Цена
- Бесплатный план: $5/мес в предоплаченных кредитах, без кредитной карты
- Starter: $9/мес + оплата по мере использования
- Scale: $99/мес + оплата по мере использования
- Экспорт: JSON, CSV, Excel, XML, RSS (зависит от Actor)
Лучше всего подходит для: технически уверенных пользователей, которые могут оценивать разные Actors, настраивать cookies и устранять неполадки, когда что-то ломается. Не лучший вариант для команд, которым нужно решение «настроил и забыл».
3. Octoparse
Octoparse — это десктопный no-code скрапер с визуальным конструктором workflow в стиле point-and-click. Он находится между простотой Thunderbit в один клик и полным контролем разработчика в ScraperAPI — ты получаешь визуальную настройку без кода, но всё же строишь и поддерживаешь рабочий процесс сам.
Как настроить сбор Trustpilot в Octoparse
Рабочий процесс довольно прямолинейный, но ручной:
- Вставь URL страницы отзывов компании на Trustpilot
- Визуально выдели элементы отзыва (заголовок, текст, рейтинг, дату, имя автора)
- Настрой цикл пагинации через кнопку следующей страницы
- Установи задержки ожидания (обычно рекомендуется 2–5 секунд, чтобы не провоцировать reCAPTCHA)
- Запускай локально для небольших выборок или в облаке для более крупных задач
Настройка занимает 10–15 минут, если ты уже знаком с инструментом. Но есть нюанс: поскольку Octoparse использует визуальные селекторы, привязанные к элементам DOM, workflow придётся обновлять каждый раз, когда Trustpilot меняет структуру страницы.
Работа с логин-барьером и антибот-защитой
- Логин-барьер: требует ручной настройки логина / cookies / сессии. Автоматически не решается.
- Антибот-защита: платные планы включают ротацию IP, residential proxies ($3/GB) и автоматическое решение CAPTCHA ($1–1.5 за тысячу).
- Сопровождение: среднее. Готовься перестраивать или подправлять workflow, когда Trustpilot обновляет фронтенд.
Цена
- Бесплатный план: навсегда бесплатно, 10 задач, 1 устройство, локальное извлечение, до 50 000 строк/мес
- Standard: $69/мес (при годовой оплате)
- Professional: $149/мес
- 14-дневный premium trial: включает облачное извлечение, расписание, API и шаблоны
- Экспорт: Excel, CSV, JSON, HTML, XML; базы данных и Google Sheets на старших тарифах
Лучше всего подходит для: пользователей, которым нужен визуальный контроль workflow, кто не против начальной настройки и готов поддерживать процессы при изменении страниц. Хороший вариант для команд, которым нужна большая гибкость, чем у инструмента в один клик, но меньше сложностей, чем при написании Python-кода.
4. Web Scraper
Web Scraper — это расширение для Chrome и облачная платформа со sitemap-подходом к скрапингу. Его сильная сторона для Trustpilot — готовый шаблон для бизнес-страниц, который собирает данные уровня компании: название, категория, адрес, рейтинг, количество отзывов, TrustScore и URL сайта.
Но именно для сбора отзывов у Web Scraper есть важное ограничение.
Готовый шаблон против кастомной настройки
Шаблон из маркетплейса хорошо подходит для поиска компаний — то есть для скрапинга бизнес-профилей по категориям Trustpilot. Для кастомного извлечения отзывов Sitemap Wizard позволяет визуально построить скрапер прямо в расширении Chrome.
Собственное руководство Web Scraper от марта 2026 года рекомендует использовать JavaScript-клик для пагинации вместо перехода по URL, потому что Trustpilot может динамически перестраивать контент между страницами, из-за чего результаты смещаются.
Работа с логин-барьером и антибот-защитой
Здесь важно говорить честно: в официальном гайде Web Scraper прямо сказано, что Trustpilot показывает только первые 10 страниц отзывов, а затем выводит запрос на вход в систему. Это описано как известное ограничение, а не как проблема, у которой есть встроенное решение.
- Логин-барьер: ограниченная поддержка. В их собственном руководстве зафиксирован лимит в 10 страниц отзывов.
- Антибот-защита: облачные планы включают поддержку прокси; в руководстве рекомендуются задержки 2–5 секунд и снижение параллельности.
- Пагинация: настраиваемая, но на практике ограничена первыми 10 страницами отзывов для неавторизованного доступа.
Цена
- Бесплатное расширение Chrome: локальный сбор, ограниченная функциональность
- Project: $50/мес (5000 URL-кредитов)
- Professional: $100/мес (20 000 URL-кредитов)
- Scale: от $200/мес (неограниченные URL-кредиты при определённых условиях)
- 7-дневный бесплатный trial на платных облачных планах
- Экспорт: CSV, XLSX
Лучше всего подходит для: пользователей, которым нужен готовый шаблон для сбора профилей компаний Trustpilot, либо тем, кому нужны только отзывы с первых 10 страниц. Не лучший выбор, если тебе нужна полная история отзывов у компаний с большим количеством оценок.
5. ScraperAPI
ScraperAPI — это инфраструктура для скрапинга, ориентированная на разработчиков. Это не инструмент point-and-click, а прокси/рендеринг-слой, который берёт на себя антибот-защиту, пока ты пишешь логику парсинга. На его странице решения для Trustpilot заявлены JS-рендеринг, обработка CAPTCHA и более 40 млн прокси.
Если ты Python-разработчик и хочешь полный контроль над логикой извлечения, ScraperAPI даёт тебе всю инфраструктуру.
Но и всю поддержку ты берёшь на себя.
Как собрать кастомный скрапер Trustpilot с ScraperAPI
Туториал ScraperAPI от января 2026 года показывает рабочий процесс на Python + BeautifulSoup:
import requests
from bs4 import BeautifulSoup

payload = {
    "api_key": "YOUR_API_KEY",
    "url": "https://www.trustpilot.com/review/example.com",
    "render": "true",
    "keep_headers": "true",
}

html = requests.get("https://api.scraperapi.com", params=payload).text
soup = BeautifulSoup(html, "html.parser")
В готовом коде из туториала указано pages_to_scrape = 10 — это косвенно подтверждает публичный лимит. Для страницы 10+ разработчикам нужно самостоятельно управлять авторизованными сессиями, cookies и токенами.
Работа с логин-барьером и антибот-защитой
- Логин-барьер: требуется управление сессией/cookies на уровне кода. ScraperAPI берёт на себя прокси и рендеринг; авторизацию реализуешь ты.
- Антибот-защита: пул residential proxies с автоматической ротацией IP, JS-рендеринг через
render=true, обработка CAPTCHA через умную ротацию прокси. Доступно на всех планах. - Сопровождение: когда Trustpilot меняет классы (а делает он это регулярно), ты обязан обновлять парсинг-код. Селектор
styles_reviewCardInner__EwDq2из туториала уже фактически срабатывает по таймеру.
Цена
- 7-дневный trial: 5000 бесплатных API-кредитов, без кредитной карты
- Hobby: $49/мес (100 000 API-кредитов)
- Startup: $149/мес (1 000 000 кредитов)
- Business: $299/мес (3 000 000 кредитов)
- Экспорт: всё, что выдаст твой код (обычно CSV, JSON, записи в базу данных)
Лучше всего подходит для: разработчиков, которым нужна полная кастомизация, которые умеют поддерживать собственные парсеры и которым нужен программируемый контроль над сессиями, логикой пагинации и структурой данных. Не для нетехнических пользователей.
Почему скраперы Trustpilot постоянно ломаются и как выбрать тот, который не подведёт
Это один из самых недооценённых факторов при выборе скрапера Trustpilot. Вопрос не в том, «работает ли этот инструмент сегодня?». Вопрос в том, «будет ли он работать через три недели?»
Скраперы ломаются на Trustpilot по четырём основным причинам:
-
Изменение сгенерированных CSS-классов. CSS modules в Next.js создают классы вроде
styles_reviewCardInner__EwDq2. Они меняются при каждом деплое фронтенда. Любой скрапер, который целится в эти классы, ломается. -
Изменения структуры DOM. Trustpilot может перестраивать HTML-иерархию — по-другому вкладывать карточки отзывов, менять обёртки, переносить метаданные в другие места.
-
Изменения в срабатывании антибот-защиты. Порог reCAPTCHA меняется. Ротация токенов сессии становится жёстче. Правила фильтрации CDN обновляются.
-
Изменения в авторизации / сессии. Логин-барьер на 10-й странице был введён (или стал жёстче) в конце 2025 года. В будущем ограничения на доступ могут появиться в любой момент.
Ключевое архитектурное различие — между селекторным и семантическим извлечением:
-
Инструменты на селекторах (Apify Actors, workflows Octoparse, скрипты ScraperAPI, sitemap’ы Web Scraper) спрашивают: «Найди элемент по этому точному CSS-пути». Когда путь меняется, они тихо ломаются или возвращают пустые данные.
-
Семантические / AI-инструменты (Thunderbit) спрашивают: «Найди на этой странице текст отзыва, рейтинг и дату». AI понимает содержимое по смыслу, а не по адресу. Изменение макета его не ломает, потому что смысл остаётся тем же.
Моя рекомендация:
- Вообще не хочешь сопровождать? → AI-решение (Thunderbit)
- Небольшое сопровождение допустимо, нужен облачный автоматизированный сбор? → Apify (с выбором Actor и мониторингом)
- Нужен визуальный контроль и умеренное сопровождение? → Octoparse
- Подход на шаблонах и ограниченный сценарий? → Web Scraper
- Нужен полный контроль, и ты готов владеть всем процессом? → ScraperAPI
Что делать с собранными отзывами Trustpilot
Извлечь отзывы — это только первый шаг. В форумах я постоянно вижу один и тот же вопрос: «Данные у меня есть — и что дальше?»
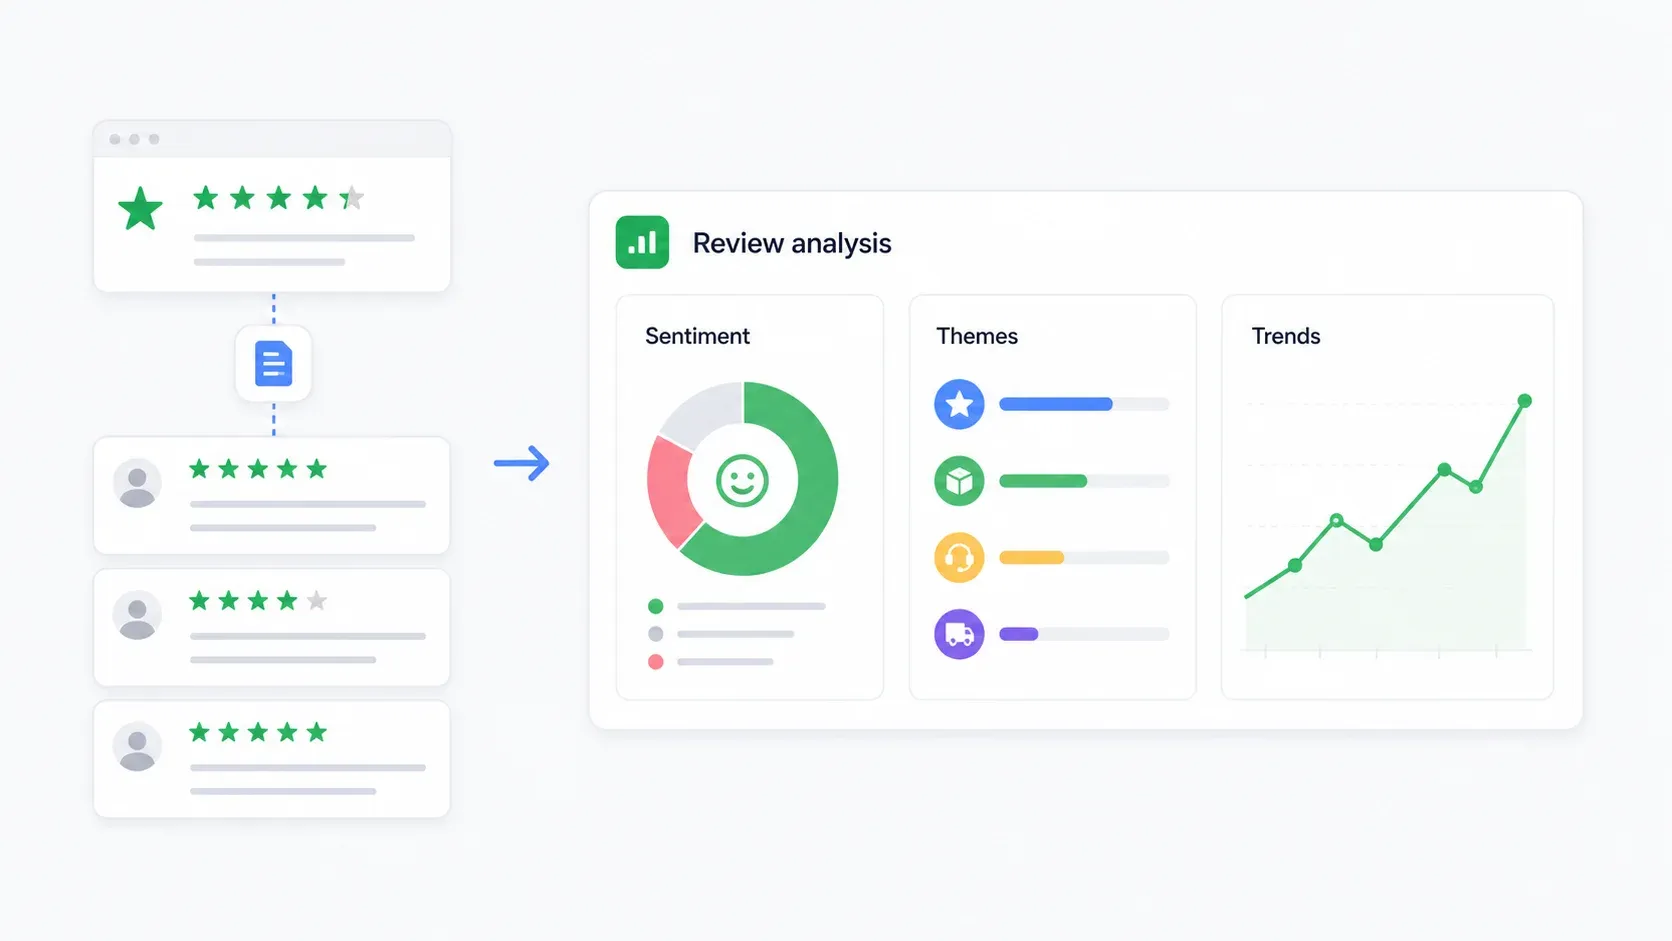
Анализ тональности
Самый простой сценарий: экспортируй отзывы в Google Sheets, а затем используй AI-инструмент (ChatGPT, Claude или AI-функцию в Sheets), чтобы классифицировать каждый отзыв как положительный, нейтральный или отрицательный. Добавь колонки с типом проблемы, срочностью и приоритетом рекомендуемого действия.
Для больших наборов данных загрузи CSV в ChatGPT и попроси сделать сводку: «Классифицируй эти отзывы по тональности и выдели 5 главных тем жалоб с цитатами-примерами».
Мониторинг конкурентов
Используй плановый сбор в Thunderbit, чтобы еженедельно или ежемесячно подтягивать отзывы конкурентов. Отслеживай:
- Динамику средней оценки во времени
- Долю 1- и 2-звёздочных отзывов
- Изменение объёма отзывов (их становится больше или меньше?)
- Самые частые темы жалоб
- Процент и скорость ответов компании
Простой дашборд в Google Sheets с pivot-таблицами по рейтингу и дате превращает это в автоматически обновляемый поток конкурентной аналитики.
Выделение тем
Группируй отзывы по типовым категориям: доставка/сроки, поддержка клиентов, возвраты, качество продукта, биллинг, удобство приложения, цена/ценность и риски мошенничества. На выходе должна быть таблица с колонками: тема, количество, средний рейтинг, цитаты-примеры и рекомендуемое действие для бизнеса.
Это полезнее, чем облако слов. Такой формат показывает, что именно реально влияет на удовлетворённость или недовольство.
Массовый анализ по нескольким компаниям
Для исследований на уровне категории собирай отзывы по нескольким компаниям внутри одной категории Trustpilot. Сравнивай объёмы отзывов, рейтинги, распределение звёзд и распространённость тем по всему сегменту рынка. Шаблон Web Scraper для списков компаний помогает находить бизнесы; Thunderbit или ScraperAPI могут затем собирать отзывы по каждой компании.
Юридические и этические аспекты скрапинга Trustpilot
Я не юрист, и это не юридическая консультация. Но вопрос соответствия правилам здесь очень важен.
Условия использования Trustpilot сформулированы жёстко. Они запрещают доступ или сбор контента «любым способом, кроме предусмотренного или специально одобренного Trustpilot», и отдельно указывают text mining, data mining и web scraping без явного разрешения.
Риски распределяются так:
- Низкий риск: выгрузка отзывов о собственной компании для внутреннего анализа, особенно через официальные бизнес-инструменты Trustpilot или API.
- Средний риск: сбор публичных страниц конкурентов в небольшом объёме для маркетингового исследования. Всё равно остаются требования ToS и защиты данных.
- Высокий риск: сбор контента со страниц за авторизационным барьером, обход технических ограничений, распространение данных авторов отзывов или использование собранных отзывов для обучения AI-моделей.
С точки зрения GDPR: имена авторов, ссылки на профили, текст отзывов и данные о локации могут считаться персональными данными по европейскому законодательству о защите данных. Практические меры защиты включают сбор только необходимых полей, хеширование имён для внутренней аналитики, установление сроков хранения данных и отказ от массовой перепубликации сырого текста отзывов.
Публичные данные vs. авторизованные данные: есть важное юридическое и этическое различие между сбором страниц, которые видны всем (первые 10 страниц отзывов), и сбором данных за логин-барьером. Инструменты, работающие только с публичными данными, несут меньший риск по комплаенсу, чем те, которым нужны учётные данные.
Это нужно учитывать при выборе инструмента. Browser mode в Thunderbit работает со страницами, видимыми в твоей собственной сессии, — он не обходит авторизацию самостоятельно. ScraperAPI даёт разработчику полный контроль, но и полную ответственность за законность управления сессиями.
Как выбрать подходящий скрапер отзывов Trustpilot
Фреймворк выбора по типу пользователя:
- Нетехнический маркетолог, которому нужны отзывы без кода? → Thunderbit. Один клик, дальше всё делает AI, экспорт в Sheets/Notion/Airtable.
- Пользователь low-code, комфортно работающий с настройками и отладкой? → Apify. Выбирай Actor, настраивай cookies для страницы 10+, следи за поломками.
- Визуальный конструктор, которому нужен контроль workflow? → Octoparse. Настройка через клики, но готовься к сопровождению, когда Trustpilot изменится.
- Нужны данные уровня компании или только первые 10 страниц отзывов? → Web Scraper. Сильные готовые шаблоны для бизнес-профилей.
- Разработчик, которому нужна полная кастомизация? → ScraperAPI. Полный контроль над парсингом, сессиями и пайплайном данных.
Если главный критерий — минимальное сопровождение, то спектр выглядит так: Thunderbit почти не требует поддержки, ScraperAPI — всё поддерживаешь ты сам. С точки зрения бюджета у каждого инструмента из этого списка есть бесплатная точка входа — начни с неё, прежде чем принимать решение.
Заключение
Данные отзывов Trustpilot действительно ценны для конкурентной разведки, контроля репутации и понимания клиентов.
Но в 2026 году их надёжный сбор требует инструмента, который умеет проходить логин-барьер на 10-й странице, адаптироваться к изменениям DOM и справляться с антибот-защитой без постоянного ручного вмешательства.
Для большинства бизнес-пользователей Thunderbit — это путь с наименьшим сопротивлением: один клик, AI-определение полей, browser mode для авторизованных страниц и отсутствие необходимости что-то поддерживать, когда Trustpilot меняет фронтенд. Ты можешь попробовать бесплатно — 6 страниц в месяц и без кредитной карты.
Для разработчиков, которым нужен полный контроль, инфраструктуру даёт ScraperAPI. Для всех остальных между ними находятся Apify, Octoparse и Web Scraper — каждый закрывает свою нишу. Главное — выбрать инструмент под твой уровень технической подготовки, терпимость к сопровождению и требования комплаенса.
Если хочешь посмотреть, как Thunderbit работает именно с Trustpilot, у нас есть подробный разбор на YouTube-канале. А для более широкого контекста — web scraping без кода или что такое web scraping на самом деле — эти материалы помогут разобраться в базовых принципах.
FAQ
1. Можно ли собирать отзывы Trustpilot после 10-й страницы?
Да, но только через авторизованный доступ. Trustpilot блокирует неавторизованный доступ после первых 10 страниц отзывов. Browser mode в Thunderbit работает в твоей вошедшей сессии Chrome, поэтому может открывать доступ к тем страницам, которые видны тебе. ScraperAPI требует управления сессией и cookies на уровне кода. В Apify нужно настраивать cookies для Actor. В Octoparse — вручную задавать логин/cookies. В собственной документации Web Scraper также признают ограничение в 10 страниц, не предлагая встроенного обхода.
2. Законно ли собирать отзывы Trustpilot?
Условия использования Trustpilot запрещают автоматический сбор данных без явного разрешения. Юридический риск зависит от метода и сценария: сбор собственных публичных отзывов несёт меньший риск, чем обход авторизационных барьеров ради данных конкурентов. На данные европейских пользователей распространяется GDPR. Это не юридическая консультация — для крупных или коммерческих проектов по сбору данных обязательно проконсультируйся с юристом.
3. Какие данные можно извлечь из Trustpilot?
Обычно доступны следующие поля: имя автора отзыва, звёздный рейтинг, заголовок отзыва, текст отзыва, дата публикации, дата опыта, статус verified purchase, локация автора, текст ответа компании, название компании, TrustScore, общее количество отзывов, распределение по звёздам и URL отзыва.
4. Как часто ломаются скраперы Trustpilot?
Инструменты на селекторах (Apify Actors, workflows Octoparse, собственные Python-скрипты) могут ломаться каждый раз, когда Trustpilot меняет CSS-классы или структуру DOM — а это может происходить несколько раз в месяц. AI-семантические инструменты вроде Thunderbit автоматически адаптируются, потому что интерпретируют смысл страницы, а не привязываются к конкретным селекторам. Однако ни один инструмент не защищён от крупных изменений в доступе, например от логин-барьера на 10-й странице.
5. Можно ли бесплатно собирать отзывы Trustpilot?
У каждого инструмента из списка есть бесплатная точка входа: Thunderbit даёт 6 страниц бесплатно в месяц, ScraperAPI — 5000 trial-кредитов на 7 дней, Web Scraper предлагает бесплатное расширение Chrome для локального использования, у Octoparse есть бессрочный бесплатный план (10 задач, 50 000 строк в месяц), а в Apify включено $5/мес бесплатных кредитов платформы. Для небольших выборок и тестов этого достаточно без оплаты.
Попробовать Thunderbit для сбора отзывов Trustpilot Get Started Free
Узнать больше



