
На TripAdvisor — более миллиарда отзывов по миллионам объектов: от отелей и ресторанов до достопримечательностей и туров, и почти каждая компания в сфере гостеприимства, с которой я общаюсь, хочет получить доступ к этим данным. Проблема в том, что защита DataDome делает TripAdvisor одним из самых неудобных сайтов для парсинга.
Я много лет создаю в Thunderbit инструменты, которые помогают нетехническим командам извлекать данные из веба без кода, и TripAdvisor — один из тех сайтов, о которых наши пользователи спрашивают чаще всего. Жалобы всегда одинаковые: CAPTCHA после пары страниц, скрипты, которые ломаются за ночь, прокси, съедающие бюджет.
Поэтому я собрал сравнение 8 парсеров TripAdvisor, которые реально дают результат в 2026 году — с оценкой по простоте использования, работе с антибот-защитой, цене, форматам экспорта и типам данных, которые они поддерживают. Неважно, собираете ли вы список лидов для отелей или анализируете тональность 10 000 отзывов — здесь найдётся подходящий инструмент.
Попробовать Thunderbit для парсинга TripAdvisor
Зачем парсить данные TripAdvisor в 2026 году?
TripAdvisor — это не просто сайт с отзывами. Это структурированная база данных мировой индустрии гостеприимства, и данные, которые он показывает, ценны для бизнеса во множестве сценариев.
У отелей есть цены, рейтинг, удобства, типы номеров и подоценки по категориям: чистота, сервис, цена/качество, качество сна. У ресторанов — тип кухни, ценовой диапазон, пункты меню, часы работы и теги по типу приёма пищи. У достопримечательностей — стоимость билетов, советы посетителей, длительность посещения и, в последнее время, ИИ-резюме отзывов, которые группируют мнения по аспектам.
В собственном исследовании TripAdvisor среди тех, кто бронирует отели 76% участников сказали, что предпочитают длинные отзывы при выборе жилья, а самым важным элементом отзыва оказался его текст — 40%. Это значит, что именно в описательной части, а не только в звёздном рейтинге, скрыта самая ценная информация.
Вот что обычно нужно разным командам от TripAdvisor:
| Сценарий использования | Какие данные нужны |
|---|---|
| Мониторинг цен конкурентов | Цены отелей, рейтинг, удобства |
| Отслеживание репутации бренда | Текст отзывов, тональность, подоценки |
| Генерация лидов (продажи в hospitality) | Название компании, email, телефон, адрес |
| Исследование рынка ресторанов | Кухня, ценовой диапазон, пункты меню, отзывы |
| Академические/туристические исследования | Рейтинги достопримечательностей, советы посетителей, цены билетов |
| Исследование маркетинговых текстов | Реальный язык клиентов из отзывов |
Но не все парсеры одинаково хорошо справляются с TripAdvisor. Защита сайта настолько жёсткая, что многие инструменты тихо проваливаются: возвращают неполные данные, блокируются через несколько страниц или требуют такой настройки прокси, что обещание «no-code» просто исчезает.
Проблема DataDome: почему TripAdvisor — один из самых сложных сайтов для парсинга
Если вы когда-нибудь пытались парсить TripAdvisor и после двух страниц ловили скользящую CAPTCHA-головоломку, вы столкнулись с DataDome — сервисом антибот-защиты, который TripAdvisor использует для обнаружения и блокировки автоматического доступа. И он действительно хорошо делает свою работу. Он проверяет не только IP-адрес: он анализирует отпечатки браузера (версия браузера, размер экрана, установленные шрифты), аппаратные признаки (характеристики GPU и CPU), то, как вы решаете JavaScript-задания, и поведение (как быстро вы прокручиваете страницу, двигается ли мышь «по-человечески»), а сверху ещё и ограничивает частоту запросов. Простой Python-скрипт на requests — или даже headless-браузер — блокируется почти сразу.
Каждый раз, когда нас спрашивают о TripAdvisor, всплывают два вопроса: почему блокировка приходит так быстро и есть ли способ обойти её без расходов на прокси и решатель CAPTCHA.
Честный ответ зависит от масштаба. Для нескольких страниц Chrome-расширение, работающее в вашей реальной сессии браузера, может обойти большую часть детектирования, потому что выглядит как обычный пользователь. Для тысяч страниц уже нужна инфраструктура — ротация прокси, CAPTCHA-решатели или инструмент, который всё это скрывает под капотом.
Вот как 8 инструментов в этой статье сравниваются по работе с антибот-защитой, а для ориентира я добавил и DIY Python-скрипт:
| Подход к антибот-защите | Инструменты | Сложность настройки | Постоянные затраты |
|---|---|---|---|
| Встроенная защита (инструмент всё делает сам) | Thunderbit (Cloud), Apify, Bright Data, ScrapFly, ScrapeHero, WebAutomation.io | Низкая | Включено в план |
| Встроенная, но с тарификацией по объёму | Octoparse | Средняя | Standard включает прокси и решение CAPTCHA; после исчерпания бонусного лимита доплаты составляют $3/ГБ и $1–1.5 за 1 000 решённых CAPTCHA |
| Без встроенной защиты | Instant Data Scraper, DIY Python | Для Instant Data Scraper — нет, для DIY — высокая | $0, пока не получите блокировку; в DIY ещё добавляются прокси и CAPTCHA-решатели |
У Thunderbit для этого есть два режима. Cloud Scraping работает на серверах Thunderbit со встроенной антибот-защитой для общедоступных страниц. Browser Scraping запускается внутри вашей собственной сессии Chrome — поскольку это реальный браузер с вашими cookie и авторизацией, он может обходить часть проверок, на которых ломаются headless-боты. Для большинства сценариев с TripAdvisor Cloud-режим — самый быстрый путь.
На что смотреть при выборе лучшего парсера TripAdvisor
Прежде чем переходить к инструментам, вот критерии, по которым я их оценивал. Именно они важны, когда вы выбираете парсер TripAdvisor — не маркетинговые обещания, а то, получите ли вы пригодные данные или просто потеряете полдня.
- Простота использования — no-code, low-code или нужен полноценный код? Если вы в продажах и вам нужно получить данные в Google Sheets уже завтра, на 4 часа настройки времени нет.
- Работа с антибот-защитой TripAdvisor — умеет ли инструмент нативно обходить DataDome/CAPTCHA или вам нужно приносить свои прокси и решатели?
- Поддерживаемые типы данных — только отели или ещё рестораны, достопримечательности и туры? Многие инструменты работают лишь со страницами отелей.
- Цена и бесплатный тариф — во что реально обойдутся, скажем, 10 000 отзывов? Есть ли бесплатные кредиты или бесплатный план?
- Форматы экспорта — CSV, JSON, Excel, Google Sheets, Airtable, Notion? Чем меньше шагов между парсингом и таблицей, тем лучше.
- Масштабирование — максимальное число отзывов или страниц за один запуск, поддержка пагинации и умеет ли инструмент работать с офсетами страниц отзывов вроде
or10в TripAdvisor. - Обогащение подстраницами — может ли он перейти по ссылкам со страницы результатов в карточки отдельных отелей/ресторанов и собрать более глубокие данные?
- Для кого лучше всего подходит — какой тип пользователя реально выигрывает от этого инструмента?
Если вы разработчик и строите собственный пайплайн, вам важнее API-гибкость и инфраструктура антибот-защиты. Если вы обычный бизнес-пользователь и вам нужна просто таблица, важнее всего форматы экспорта и простота.
8 лучших парсеров TripAdvisor в одном сравнении
Ниже все 8 инструментов рядом. Колонка с суммой — это сколько реально стоит месяц на 10 000 отзывов: самый дешёвый план с ежемесячной оплатой, уже с учётом бесплатного лимита у каждого вендора; расчёт по каждому числу ниже в статье.
| Инструмент | Простота использования | Антибот-защита | Типы данных | Месячный платёж (10K отзывов) | Форматы экспорта | Масштаб | Обогащение подстраницами | Лучше всего для |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code (1 клик) | ✅ Встроенная (Cloud + Browser) | Отели, рестораны, достопримечательности, туры | $288 разово (30K кредитов); Business — если ежемесячно | Excel, CSV, Sheets, Airtable, Notion | 200 страниц с пагинацией и 2 000 URL за запуск (Pro) | ✅ 1 клик | Нетехнические команды, продажи, операционные задачи |
| Apify | Low-code (через интерфейс платформы) | ✅ Встроенная | Отели, отзывы, рестораны, достопримечательности | $29/мес (Starter, любой actor) | JSON, CSV, Excel, XML, API | Высокий (cloud actors) | ⚠️ Зависит от actor | Команды по данным, разработчики |
| Octoparse | No-code (визуальный конструктор) | ✅ Прокси + решение CAPTCHA включены в план | Отели, отзывы | $83/мес (Standard; оплата за задачи, а не за строки) | CSV, Excel, JSON, DB | Cloud + локальное выполнение | ⚠️ Нужна настройка workflow | Любители визуальных парсеров |
| ScrapFly | Код (Python SDK/API) | ✅ Встроенный API | Любая страница TripAdvisor | $30/мес (Discovery, 200K кредитов) | Raw HTML/JSON (парсинг на вашей стороне) | Высокий | Ручное кодирование | Python-разработчики |
| Bright Data | Low-code to code | ✅ Встроенная (400M+ прокси) | Отели, отзывы, датасеты | $7.50 pay-as-you-go (после 5K бесплатных записей) | CSV, JSON, API | Enterprise-уровень | ✅ Scraper IDE | Корпоративные команды |
| ScrapeHero | Без настройки (managed) | ✅ Полностью управляемо | Отели, отзывы, рестораны | Индивидуальный расчёт (за сайт, не за строку) | CSV, JSON, Excel, API | Управляемая поставка | ✅ Управляется сервисом | Покупатели данных без желания возиться с инструментом |
| WebAutomation.io | No-code (готовые шаблоны) | ✅ Включено во все планы | Отели (с фокусом на контакты) | От $1 (1 000 кредитов, без подписки) | CSV, JSON, XML | Умеренный | ⚠️ Ограничено | Лидогенерация (email, телефоны) |
| Instant Data Scraper | No-code (1 клик) | ❌ Нет | Любая видимая таблица | $0 (блокируется после нескольких страниц) | CSV, Excel | Небольшой (несколько страниц) | ❌ Нет | Быстрые разовые выгрузки |
Краткий вердикт: самый быстрый путь для нетехнических команд — Thunderbit. Лучший вариант для массового извлечения отзывов — Apify. Лучший бесплатный инструмент для небольших задач — Instant Data Scraper. Лучший выбор для разработчиков — ScrapFly. Лучший для enterprise — Bright Data. Лучший для полностью управляемой поставки — ScrapeHero.
Теперь подробнее.
1. Thunderbit — лучший парсер TripAdvisor для нетехнических команд
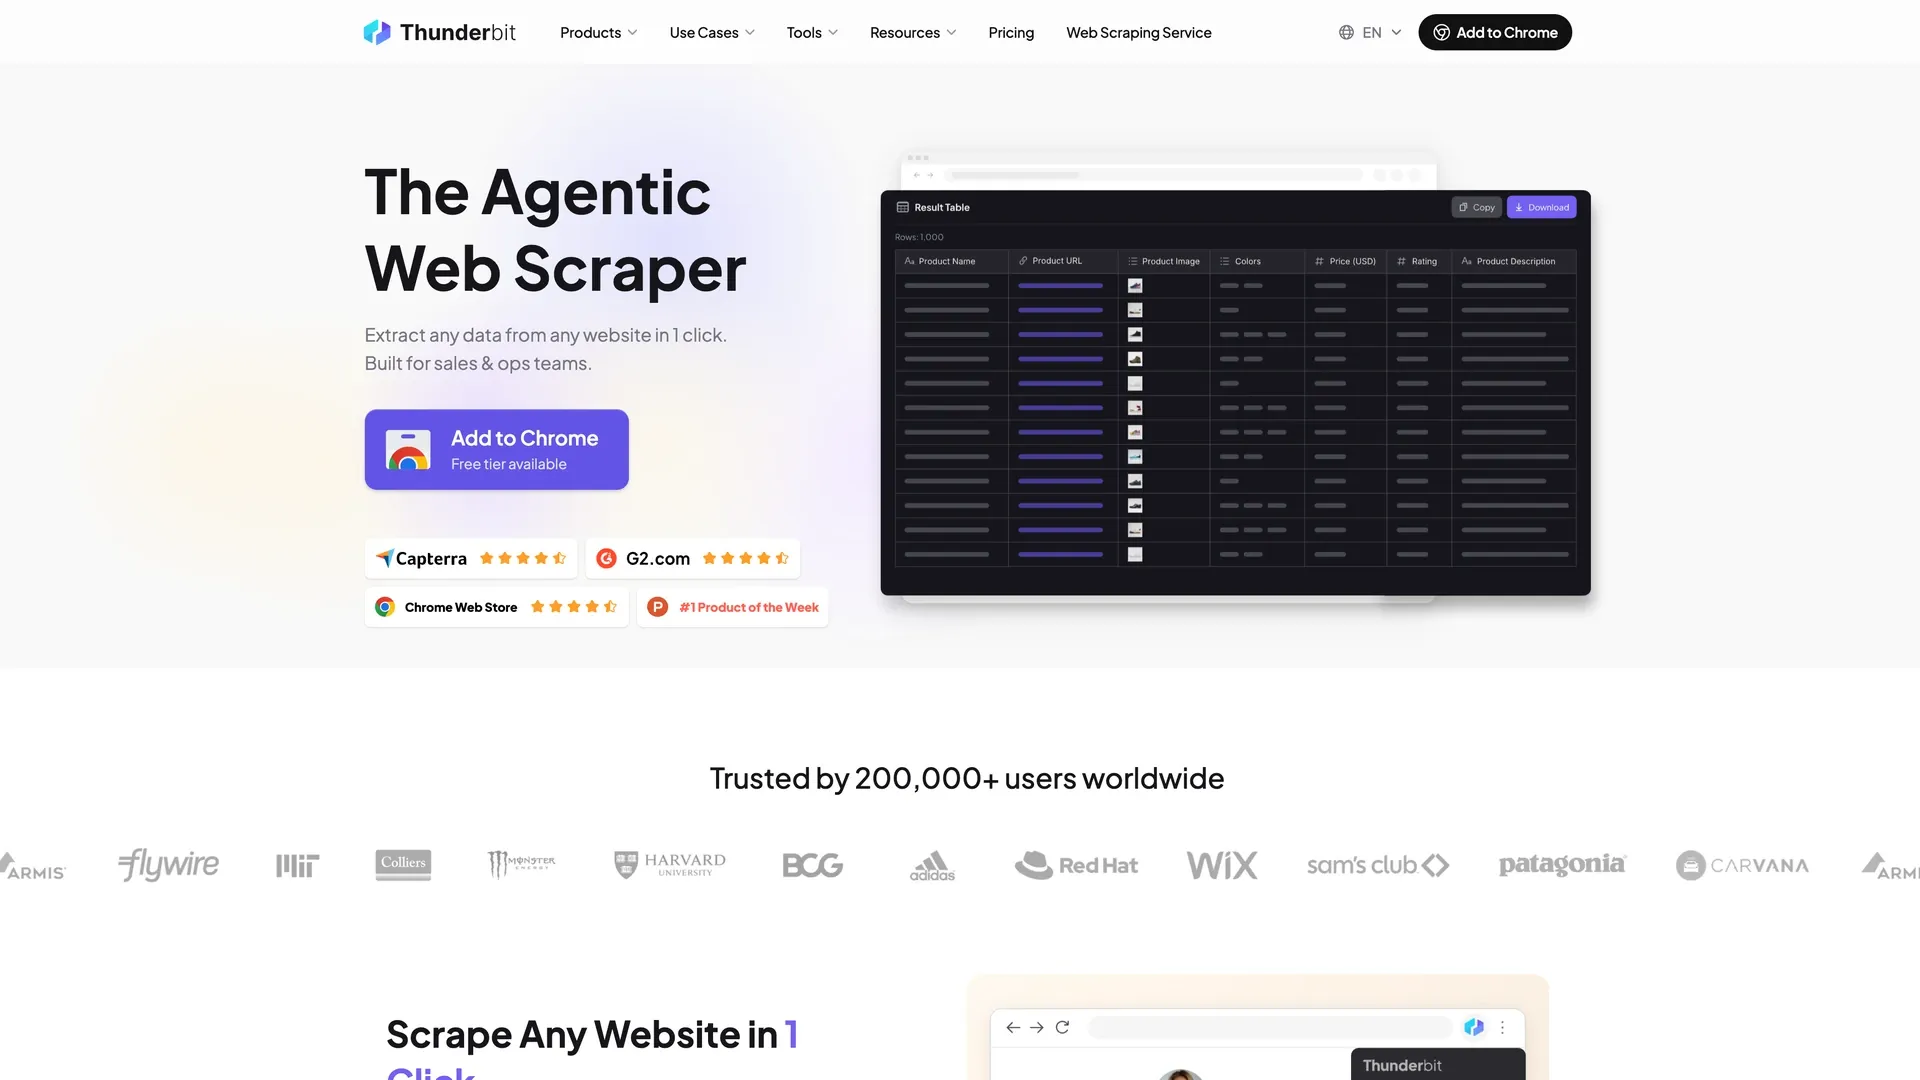 Thunderbit — это Chrome-расширение на базе ИИ, которое мы с командой создали специально для того, чтобы сделать веб-парсинг доступным людям без кода. В TripAdvisor сценарий действительно сводится к одному клику: открываете страницу отеля, ресторана или достопримечательности и запускаете расширение. ИИ читает страницу, сам определяет, какие поля извлечь — название отеля, рейтинг, цену, число отзывов, удобства и всё, что показано на странице — и начинает сбор. Если нужно что-то другое, просто скажите это обычным языком, и он подстроится. В любом случае вы получаете таблицу, которую можно сразу отправить в Google Sheets, Excel, Airtable или Notion.
Сильнее всего Thunderbit раскрывается на TripAdvisor в обогащении подстраницами. Допустим, у вас страница результатов с 30 отелями. Thunderbit может сначала собрать список, а затем автоматически перейти по каждой ссылке на отель и забрать данные из карточки — полный текст отзывов, список удобств, контактные данные, диапазоны цен, подоценки по категориям — без дополнительной настройки. Вы нажимаете одну кнопку и получаете обогащённые данные по каждому объекту.
Тот же принцип работает и для других типов страниц. На странице ресторана вы получаете кухню, ценовую категорию, часы работы и пункты меню вместо отельных удобств; на странице достопримечательности — стоимость билетов, длительность и советы посетителей.
Не нужно поддерживать отдельные шаблоны под каждую категорию — ИИ читает любую страницу, которая у вас открыта. Но есть и ограничения, о которых стоит знать заранее: в Pro один запуск ограничен 200 страницами с пагинацией и 2 000 URL, каждая строка стоит кредит (два, если включено обогащение подстраницами), а Cloud-режим работает только на открытых страницах — всё, что за логином, нужно запускать в Browser mode, и он медленнее.
Нужны данные на регулярной основе? Scheduled Scraper в Thunderbit запускается еженедельно или ежемесячно — именно то, что нужно небольшому бизнесу в hospitality для мониторинга цен конкурентов или репутации.
Парсите данные TripAdvisor с помощью ИИ Get Started Free
Ключевые возможности
- Парсинг в 1 клик — ИИ сам называет столбцы, либо вы описываете нужные поля одной строкой (подходит для любого типа страниц TripAdvisor)
- Обогащение подстраницами в один клик — соберите список, затем дополните каждую карточку данными со страницы объекта
- Cloud Scraping (быстро, со встроенной антибот-защитой) и Browser Scraping (использует вашу реальную сессию Chrome)
- Плановый парсинг для автоматического еженедельного/ежемесячного мониторинга
- Бесплатный экспорт в Excel, Google Sheets, Airtable, Notion, CSV, JSON
- Бесплатные экстракторы email и телефонов для генерации лидов
- Поддержка 34 языков
Цена
- Бесплатный тариф: 6 страниц в месяц (до 30 кредитов на страницу)
- Платные планы на основе кредитов: 1 кредит за каждую итоговую строку, 2 кредита — если строка получена с подстраницы. Starter — $15/мес за 500 кредитов; Pro — $38/мес за 3 000 кредитов. При годовой оплате все кредиты выдаются сразу: $108/год за 5 000 кредитов на Starter, $288/год ($24/мес) за 30 000 кредитов на Pro. Плана выше Pro для самостоятельной покупки нет; большие объёмы рассчитываются как Business. Актуальные детали — на странице цены Thunderbit.
Лучше всего для
- Команд продаж и операционных отделов, которым нужны данные TripAdvisor в таблице без кода
- Небольших компаний, которые еженедельно отслеживают отзывы конкурентов
- Маркетинговых команд, которым нужны реальные формулировки клиентов из отзывов для рекламы и лендингов
Попробуйте расширение Thunderbit для Chrome бесплатно и посмотрите, как работает сценарий в 1 клик на ваших страницах TripAdvisor.
2. Apify TripAdvisor Scraper — лучший вариант для массового извлечения отзывов
 Apify — это облачная платформа для парсинга с маркетплейсом готовых «Actors», и среди них есть несколько специализированных акторов для TripAdvisor. Самые популярные позволяют вставить URL или поисковый запрос TripAdvisor, настроить параметры (локация, тип объекта, число отзывов), запустить actor и скачать результат в формате JSON, CSV или Excel.
Сильнейшая сторона Apify — объём. Если вам нужно 10 000+ отзывов для проекта по анализу тональности, actors Apify созданы именно для этого. TripAdvisor actor от API Ninja работает примерно по цене $0.50 за 1 000 результатов для данных об отелях, а actor от Crawler Bros стоит $2.00 за 1 000 результатов, но включает ответы владельцев, полезные голоса и метаданные объекта. Оба умеют обходить антибот-защиту и пагинацию.
Компромисс — Apify требует некоторого знакомства с платформой. Это не Chrome-расширение: вы работаете в веб-панели, настраиваете входные параметры actor и ждёте завершения облачного запуска.
На первый запуск закладывайте около десяти минут: создать аккаунт, выбрать actor, вставить URL и дождаться результата.
Ключевые возможности
- Специализированные Actors для TripAdvisor с уже встроенной логикой извлечения
- Поддержка пагинации и антибот-механизмов
- Масштабируемость для больших наборов данных (10K+ отзывов)
- Доступ к API для автоматизации и интеграций
- Поддержка отелей, отзывов, ресторанов и достопримечательностей (зависит от actor)
Цена
- Бесплатный план: $5 в месяц на использование платформы , без pay-as-you-go сверх этого и без скидки Apify Store
- Цена за результат: примерно от $0.50 за 1 000 результатов (API Ninja) до около $2.00 за 1 000 результатов (Crawler Bros) — для обеих ставок нужен платный план: у API Ninja цена $0.50 действует на любом платном плане, а у Crawler Bros на Starter — $2.67 за 1 000 и только на верхних планах опускается до $2.00
- Планы платформы начинаются с $29/мес (Starter) — это предоплаченный баланс на использование, а не доплата сверху; вместе с ним даётся скидка Store
Лучше всего для
- Команд по данным, которым нужны большие массивы отзывов
- Разработчиков, которым нужна API-ориентированная выгрузка
- Проектов по анализу тональности и NLP
3. Octoparse — лучший no-code desktop-парсер для TripAdvisor
 Octoparse — это визуальный no-code инструмент для парсинга с конструктором сценариев по принципу point-and-click. Для TripAdvisor Octoparse предлагает готовые шаблоны — вы вставляете URL, запускаете автоопределение, проверяете предложенные поля и экспортируете данные. Шаблон TripAdvisor Hotel Reviews стоит $0.8 за 1 000 строк.
Визуальный конструктор хорошо подходит, если вам нужен больший контроль, чем даёт Chrome-расширение, но вы не хотите писать код. Можно настроить условную логику, обработку пагинации и расписание облачных запусков. Но есть два важных нюанса. Во-первых, шаблоны TripAdvisor в Octoparse могут ломаться, когда TripAdvisor меняет верстку — а делает он это часто. Во-вторых, инструменты антиблокировки уже включены, но использование тарифицируется: план Standard включает ротацию IP, residential-прокси и автоматическое решение CAPTCHA, так что ничего дополнительно подключать перед стартом не нужно — но тяжёлый по DataDome проект будет расходовать прокси-трафик и решения CAPTCHA, а сверх включённого лимита это оплачивается по $3/ГБ и $1–1.5 за 1 000.
Ключевые возможности
- Визуальный конструктор workflow по принципу point-and-click
- Готовые шаблоны для TripAdvisor
- Облачное и локальное выполнение
- Плановый парсинг
Цена
- Бесплатный план: 10 задач, локальное извлечение, 50 000 строк экспорта в месяц
- План Standard: $83/мес при ежемесячной оплате или $69/мес при годовой — именно он нужен для шаблона TripAdvisor. На странице цен Octoparse показывает более высокую цену Standard — $119/мес — если вы укажете, что покрываете несколько сайтов с частым расписанием; для одного сайта цена остаётся $83/$69, независимо от частоты обновления
- Использование шаблона: $0.8 за 1 000 строк для отзывов об отелях TripAdvisor
- В Standard включены: ротация IP, residential-прокси, автоматическое решение CAPTCHA и ежемесячный дополнительный кредит, из которого списываются premium-шаблоны, прокси и CAPTCHA-решения — Octoparse не публикует размер этого кредита. Сверх включённого объёма доплаты составляют $3/ГБ и $1–1.5 за 1 000 решённых CAPTCHA
Лучше всего для
- Пользователей, которым нужен визуальный парсер с большим контролем, чем у Chrome-расширения
- Команд, которые парсят не только TripAdvisor, но и несколько туристических сайтов
4. ScrapFly — лучший парсер TripAdvisor для Python-разработчиков
 ScrapFly — это API и SDK для веб-парсинга, созданные для разработчиков. Вы отправляете HTTP-запросы через инфраструктуру ScrapFly, а он на своей стороне обходит антибот-защиту, рендерит JavaScript и ротирует прокси. У ScrapFly есть подробные материалы и примеры кода именно для TripAdvisor — это приятный бонус.
Рабочий процесс для разработчика простой: используете Python SDK ScrapFly (или обычный httpx/requests) для загрузки страниц TripAdvisor, а бэкенд ScrapFly сам справляется с DataDome, CAPTCHA и рендерингом. На выходе вы получаете raw HTML или JSON, а затем сами пишете логику парсинга нужных полей.
Если вам нужен тонкий контроль — кастомное извлечение полей, сложная логика пагинации, интеграция со своим пайплайном данных — ScrapFly отлично подойдёт. Но для нетехнических пользователей это не вариант.
Здесь нет визуального интерфейса и нет готового экспорта в таблицу, а 1 000 бесплатных кредитов при регистрации покрывают примерно 200 страниц TripAdvisor с включённым обходом защиты — этого хватит на прототип, но не на полноценную задачу.
Ключевые возможности
- API для обхода антибот-защиты (DataDome, CAPTCHA)
- Рендеринг JavaScript
- Встроенная ротация прокси
- Руководства и примеры кода по TripAdvisor
Цена
- Бесплатный тариф: 1 000 кредитов при регистрации, без карты и без срока действия
- Кредиты списываются за запрос: 1 — обычный запрос через datacenter, 5 — с рендерингом JavaScript или обходом антибот-защиты, 25 — с residential-прокси
- Discovery — $30/мес за 200 000 предоплаченных кредитов; Pro — $100/мес за 1 000 000
Лучше всего для
- Python-разработчиков, строящих собственные парсеры TripAdvisor
- Команд, которым нужен детальный контроль над логикой извлечения
5. Bright Data — лучший парсер TripAdvisor для enterprise-масштаба
 Bright Data — это решение «всё в одном». Оно предлагает Web Scraper IDE для создания кастомных парсеров, готовые датасеты TripAdvisor и крупнейшую в отрасли сеть прокси — 400M+ IP в residential, datacenter и mobile категориях. Встроенное решение CAPTCHA включено.
Гайд Bright Data по парсингу TripAdvisor показывает, как использовать Selenium с их управляемой браузерной инфраструктурой, обращаясь к поисковым URL TripAdvisor с параметрами q, geo, ssrc и offset. В гайде также разбираются типичные проблемы блокировки: JavaScript-челленджи, browser fingerprinting и динамический контент.
Компромисс здесь — сложность, а не цена. Web Scraper API от Bright Data стоит $1.5 за 1 000 записей по модели pay-as-you-go без обязательной покупки плана, что даёт $15 за 10 000 отзывов — на практике $7.50, потому что новые аккаунты получают 5 000 бесплатных записей в месяц, и они списываются первыми. Но дорогая часть — вся работа вокруг: вы либо берёте готовый датасет, либо настраиваете Scraper IDE, а не просто нажимаете кнопку. И план Scale за $499/мес (включает 384 000 записей) окупается только примерно после 338 000 записей в месяц — это уже enterprise-уровень, где тот же пайплайн обычно ещё и тянет Booking.com и Google Maps.
Ключевые возможности
- Web Scraper IDE (визуально + код)
- 400M+ residential и datacenter прокси
- Готовые датасеты TripAdvisor
- Встроенная CAPTCHA и антибот-защита
- Соответствие enterprise-уровню
Цена
- Бесплатный тариф: 5 000 записей в месяц, обновляется ежемесячно и списывается до любой платной тарификации
- Web Scraper API: $1.5 за 1 000 записей по модели PAYG
- План Scale: $499/мес за 384 000 записей
- Индивидуальная enterprise-цена
Лучше всего для
- Корпоративных команд, которым нужны данные TripAdvisor в огромном объёме
- Компаний, которым требуется сбор данных с учётом compliance
- Кроссплатформенной агрегации (TripAdvisor + Booking.com + Google Maps)
6. ScrapeHero — лучший управляемый сервис для парсинга TripAdvisor
 ScrapeHero — это полностью управляемый сервис парсинга. Вы описываете, какие данные TripAdvisor вам нужны — отели в регионе, отзывы по набору объектов, списки ресторанов в городе — а ScrapeHero сам строит, запускает и поддерживает парсер. На выходе вы получаете чистые, структурированные данные по вашему расписанию.
Это вариант «я вообще не хочу трогать инструмент». ScrapeHero берёт на себя антибот-защиту, прокси, поддержку и форматирование данных — вы получаете CSV, JSON, Excel или API-выгрузку.
Минус — цена. Управляемые сервисы заметно дороже self-service решений, а сроки выполнения кастомных запросов могут быть узким местом.
Ключевые возможности
- Полностью управляемый парсинг (без настройки со стороны клиента)
- Индивидуальные графики поставки данных
- Антибот-защита, прокси и поддержка на стороне сервиса
- Структурированный вывод данных (CSV, JSON, Excel, API)
Цена
- Индивидуальная цена в зависимости от объёма и сложности данных — страница цен называет опубликованные цифры базовыми, а не окончательной офертой
- On Demand — от $550 за сайт за один refresh, настройка включена, без подписки
- Business — от $199/мес за сайт, плюс разовый платёж за настройку; оба уровня рассчитаны на 1–5K страниц на сайт в месяц
Лучше всего для
- Бизнес-команд, которые хотят получать данные TripAdvisor, не обслуживая инструмент самостоятельно
- Компаний, которым нужны стабильные регулярные потоки данных для аналитики hospitality
7. WebAutomation.io — лучший инструмент для извлечения контактов из TripAdvisor
 WebAutomation.io — это no-code платформа для парсинга с готовыми экстракторами TripAdvisor, ориентированными на контактные данные: названия отелей, адреса, удобства, email, телефоны, цены, отзывы и рейтинги. Рабочий процесс простой — выбираете TripAdvisor extractor, вставляете URL, запускаете парсинг, скачиваете данные.
Сильная сторона WebAutomation.io — фокус на полях для лидогенерации. Если вы работаете в sales hospitality и ваша главная цель — собрать список контактов (имена, email, телефоны, адреса), этот инструмент сделан именно для этого. Он менее гибкий, чем Thunderbit или Octoparse, для общего парсинга, но для конкретной задачи извлечения контактной информации из списков TripAdvisor он справляется отлично.
Ключевые возможности
- Готовый экстрактор TripAdvisor
- Извлекает контактные данные (email, телефон, адрес)
- Без кода
- Доступен плановый парсинг
Цена
- Есть пробный период для теста — на карточке плана указано 10M кредитов, а в FAQ на той же странице сказано 500, так что воспринимайте это как trial, а не как тарифный уровень по объёму
- Project — $99/мес за 400 000 кредитов, затем Start-Up $249, Business $449, Corporate $999; один кредит равен одной успешной странице, а пополнения без подписки начинаются от $1 за 1 000 кредитов
Лучше всего для
- Команд продаж, которым нужны контактные данные отелей/ресторанов для outreach
- Генерации лидов из списков TripAdvisor
8. Instant Data Scraper — лучший бесплатный парсер TripAdvisor для быстрых задач
 Instant Data Scraper — это бесплатное Chrome-расширение, которое автоматически находит таблицы данных на любой веб-странице и позволяет экспортировать их в один клик. Вы открываете страницу TripAdvisor, нажимаете на иконку расширения, оно находит таблицу данных, и вы экспортируете её в CSV или Excel. Без аккаунта, без настройки, без оплаты.
Мне нравится Instant Data Scraper именно за то, чем он является: быстрым и бесплатным способом забрать небольшой образец данных. Если вам нужны топ-10 отелей на странице результатов или несколько отзывов для быстрой аналитики — он подойдёт. Но у него нет вообще никакой антибот-защиты. Через несколько страниц DataDome TripAdvisor просто блокирует вас. Нет обогащения подстраницами, нет расписания, нет ИИ-адаптации под изменение страницы и нет способа масштабироваться дальше того, что видно на одной загрузке страницы.
Ключевые возможности
- Бесплатное Chrome-расширение
- Автоматически распознаёт таблицы данных
- Экспорт в CSV/Excel в один клик
- Не требует аккаунта или настройки
Цена
- Полностью бесплатно
Лучше всего для
- Быстрых разовых выгрузок данных (несколько страниц со списками отелей)
- Академических исследователей и студентов без бюджета
- Пользователей, которым нужен лишь небольшой срез данных TripAdvisor
Не только отели: парсинг ресторанов, достопримечательностей и туров TripAdvisor
Большинство гайдов по парсингу TripAdvisor заканчиваются на отелях.
Но рестораны и достопримечательности составляют большую долю списков TripAdvisor. Данные на этих страницах не менее ценны — а для некоторых задач даже важнее.
Страницы ресторанов показывают тип кухни, ценовой диапазон, пункты меню, типы приёмов пищи, особенности, часы работы, адрес, телефон, сайт и подоценки по полезности, сервису, еде и атмосфере. Страницы достопримечательностей показывают цены билетов, часы работы, длительность, советы посетителей и новые ИИ-резюме отзывов с метками аспектов вроде «Атмосфера», «Длительность», «Лучшее время» и «Цена/качество». Страницы туров идут ещё дальше: маршрут, размер группы, языки гида, включённые услуги и коды продукта.
Шаблонные парсеры часто поддерживают только URL отелей. Если вставить URL ресторана или достопримечательности в инструмент, который заточен под структуру отельной страницы, результат будет сломанным или неполным.
Именно здесь у ИИ-инструментов есть преимущество. Thunderbit работает с любой открытой страницей, поэтому одно и то же расширение подходит и для страницы ресторана, и для страницы достопримечательности. Вам не нужно ждать, пока вендор выпустит шаблон под каждую категорию.
Это важно и для исследования маркетинговых текстов. Отзывы ресторанов и достопримечательностей полны тех самых формулировок, которыми люди описывают ужин в ресторане или поход в музей. Если вы в hospitality-маркетинге, именно такой язык нужен для рекламы, лендингов и email-кампаний.
Сколько на самом деле стоит парсинг TripAdvisor?
Чаще всего мне задают вопрос о цене: можно ли сделать это без оплаты прокси и CAPTCHA-решателей? Вот реалистичная разбивка для парсинга 10 000 отзывов об отелях — это распространённый ориентир.
Сначала важное уточнение по нормализации: сейчас TripAdvisor показывает 10 отзывов на страницу на карточках отелей, так что 10 000 отзывов ≈ 1 000 страниц отзывов. Инструменты, которые считают по страницам, а не по строкам, имеют совсем разную структуру расходов, поэтому во второй колонке ниже указан именно тот платёж, который реально спишут в месяц при таком объёме: уже с учётом бесплатных лимитов и по самому дешёвому месячному тарифу у вендора. У некоторых из них выгоднее оплатить год сразу, но годовая предоплата — это не ежемесячный платёж, поэтому я не включал её в колонку. Дополнения — прокси, решатели, время разработчика — тоже вынесены отдельно в пояснение.
| Инструмент | Фактический ежемесячный платёж (10K отзывов) | Как считается, что вычитается | Настройка и поддержка |
|---|---|---|---|
| Thunderbit | $288 разово (Business — если ежемесячно) | Отзывы, забранные со страниц самих объектов, считаются строками подстраниц, поэтому стоят 2 кредита за штуку — 10 000 отзывов = 20 000 кредитов. Годовой Pro сразу выдаёт 30 000 кредитов за $288, чего хватает на разовый сбор такого объёма. Если делать это каждый месяц, вы выходите за пределы self-serve планов (у Pro — 3 000 кредитов в месяц), и это уже Business-расчёт. Бесплатный тариф — 6 страниц в месяц — не складывается с платным. Один запуск ограничен 200 страницами с пагинацией, так что это пять запусков на те же кредиты. | 5 мин; низкая — ИИ перечитывает страницу при каждом запуске |
| Apify (actor API Ninja) | $29/мес | Store-скидка Apify начинается со Starter, поэтому ставка $0.50 за 1 000 результатов — это ставка для платного плана; на бесплатном плане тот же actor стоит в десять раз дороже, а бесплатные $5 покрывают примерно тысячу результатов и не дают механизма pay-as-you-go, чтобы идти дальше. В отличие от Crawler Bros ниже, этот actor берёт те же $0.50 на любом платном плане, так что Starter платит по заявленной ставке: 10 000 результатов = $5.00 из уже предоплаченных $29, значит итоговый платёж — $29. | 10 мин; низкая |
| Apify (actor Crawler Bros) | $29/мес | Тот же план за $29, но тратится больше. Этот actor тарифицируется по уровню плана: Starter платит $2.67 за 1 000, так что 10 000 результатов = $26.70 — всё ещё укладывается в предоплаченные $29. Заявленные $2.00 за 1 000 — это ставка верхних планов. | 10 мин; низкая |
| Instant Data Scraper | $0 | Бесплатное расширение, без аккаунта и без лимита, который можно было бы списать — и без способа завершить задачу: DataDome блокирует его после нескольких страниц. | 2 мин; поддерживать нечего |
| Octoparse | $83/мес | Оплата идёт за задачи и облачную одновременность, а не за строки, так что объём не двигает тариф — его определяет шаблон, а ему нужен Standard: $83/мес или $69/мес при годовой оплате. Один сайт остаётся на этой цене, как часто бы вы ни обновляли данные. Строки шаблона по $0.8/1 000, residential-прокси по $3/ГБ и CAPTCHA-решения списываются из ежемесячного add-on-кредита, размер которого Octoparse не публикует. | 30 мин; средняя — шаблоны ломаются, когда TripAdvisor меняет страницу |
| ScrapFly | $30/мес | Для TripAdvisor нужно включать обход антибот-защиты, что стоит 5 кредитов за запрос, значит 1 000 страниц отзывов = 5 000 кредитов. 1 000 кредитов при регистрации — разовая выдача и покрывают около 200 страниц, поэтому задача идёт на Discovery: $30/мес за 200 000 предоплаченных кредитов. Лимит здесь не является узким местом — по сути, весь платёж и есть стоимость плана. | 1–2 часа кода; средняя — парсер на вашей стороне |
| Bright Data | $7.50 | Одна запись — это одна строка, значит 10 000 отзывов = 10 000 записей = $15 по ставке $1.50 за 1 000 по модели pay-as-you-go . Новый аккаунт получает 5 000 бесплатных записей в месяц, которые списываются первыми, и это уменьшает сумму вдвое. Никакого обязательного плана и минимального коммита нет. | 30 мин; средняя |
| ScrapeHero | Индивидуальная цена | Цена считается за сайт и за refresh, а не за строку, и страница цен прямо называет опубликованные суммы базовым ориентиром, а не финальной ценой. Нижняя граница — $550 за сайт за один refresh (On Demand) или $199/мес за сайт плюс разовая настройка (Business) — оба уровня рассчитаны на 1–5K страниц на сайт, что соответствует диапазону в 1 000 страниц отзывов. | Никакой — они всё строят и запускают сами |
| WebAutomation.io | От $1 | Один кредит — это одна успешная страница, значит 1 000 страниц отзывов = примерно 1 000 кредитов, а ещё больше — если страница требует нескольких запросов или JavaScript-рендеринга. Пополнения не требуют подписки и начинаются от $1 за 1 000 кредитов; самый дешёвый план Project за $99/мес даёт 400 000 кредитов, которые здесь вы бы не использовали. Бесплатный план на странице противоречит сам себе — на карточке 10M кредитов, в FAQ 500, так что ничего не списывается. | No-code, готовый экстрактор; низкая — поддерживает вендор |
| DIY Python + proxies | По трафику и по решённым CAPTCHA | Плата — это residential bandwidth, примерно $3/ГБ — как у Octoparse за тот же add-on — плюс $1–1.5 за 1 000 решённых CAPTCHA. Перевести это в помесячную сумму без точной оценки мегабайт на страницу я не могу, поэтому честную единую цифру здесь не поставить. Плюс сверху идёт время разработчика. | 4–8 часов; высокая — код ломается |
То, что многие недооценивают, — это поддержка. DIY Python-парсеры ломаются, когда TripAdvisor меняет GraphQL query IDs, обновляет DataDome или переставляет блоки страницы. Я видел команды, которые тратили больше времени на отладку сломанных парсеров, чем на их первоначальную разработку. ИИ-инструменты вроде Thunderbit перечитывают страницу при каждом запуске, поэтому изменение макета обычно не превращается в вашу проблему — это не делает вас невидимыми для блокировки, но и переписывать селекторы каждый раз, когда TripAdvisor что-то двигает, не придётся.
Бесплатные пути есть, но у каждого есть предел. Email- и phone-экстракторы Thunderbit бесплатны, но бесплатный тариф ограничен 6 страницами в месяц. Бесплатный план Apify даёт $5 на использование платформы. Instant Data Scraper бесплатный и работает, пока DataDome вас не заметит.
Какой парсер TripAdvisor подходит под ваш сценарий?
Для разных рабочих процессов нужны разные инструменты. Вот матрица решений, основанная на сценариях, о которых наши пользователи спрашивают чаще всего:
| Сценарий использования | Лучший инструмент(ы) | Почему |
|---|---|---|
| Быстрый экспорт отзывов по одному отелю | Thunderbit, Instant Data Scraper | 1 клик, без настройки |
| Анализ тональности в масштабе (10K+ отзывов) | Apify, Bright Data | Сделаны для больших объёмов + API-вывод |
| Еженедельный мониторинг конкурентов | Thunderbit (Scheduled Scraper), Apify | Автоматическое расписание |
| Академическое исследование (маленькая выборка, без бюджета) | Instant Data Scraper, бесплатный тариф Thunderbit | Бесплатно — и небольшой объём: 6 страниц в месяц на бесплатном тарифе, а Instant Data Scraper останавливается, когда его замечает DataDome |
| Агрегация с нескольких платформ (TripAdvisor + Booking + Google) | Thunderbit, Bright Data | Поддержка мультисайтов |
| Генерация лидов в hospitality (email, телефоны) | Thunderbit, WebAutomation.io | Извлечение контактных данных |
| Кастомный пайплайн данных (для разработчика) | ScrapFly, Apify | API-first, глубокая кастомизация |
| Полностью управляемая поставка данных | ScrapeHero | Полностью managed |
Часто на форумах задают вопрос: можно ли использовать AI-ассистентов для кода, вроде ChatGPT или Claude, чтобы написать парсер TripAdvisor? Теоретически ИИ может сгенерировать Python-скрипт. На практике такие скрипты почти сразу ломаются на TripAdvisor, потому что DataDome легко ломает типичную браузерную автоматизацию. AI-инструмент для парсинга вроде Thunderbit принципиально отличается от AI-ассистента для кода: Thunderbit работает в реальной браузерной среде со встроенной антибот-защитой, тогда как скрипт, сгенерированный ChatGPT, запускается в «голом» headless-браузере, который DataDome блокирует сразу.
Если две опции выглядят одинаково хорошо в этой матрице, ориентируйтесь на цель: таблица, которую кто-то откроет завтра, или пайплайн, который должен работать без постоянного контроля.
No-code против кода: преимущество Chrome-расширения в 1 клик
Разница между Chrome-расширением и Python-скриптом для нетехнического пользователя огромна. Вот как три основных подхода выглядят при первой задаче по парсингу TripAdvisor:
| Фактор | Chrome-расширение (Thunderbit) | No-code платформа (Octoparse) | Python DIY |
|---|---|---|---|
| Время до первого результата | ~2 минуты | ~15–30 минут | ~2–4 часа |
| Нужен ли код | Нет | Нет | Python среднего уровня |
| Работа с изменением макета | ✅ ИИ перечитывает страницу при каждом запуске | ⚠️ Сохранённый шаблон перестаёт совпадать со страницей | ❌ Нужна ручная правка |
| Обогащение подстраницами | ✅ 1 клик | ⚠️ Нужна настройка workflow | Ручное кодирование |
| Антибот-защита | Встроенная (Cloud mode) | Включена в план Standard | Самостоятельно: прокси + CAPTCHA |
Вот мини-урок по Thunderbit для TripAdvisor:
- Откройте любую страницу TripAdvisor в Chrome (отель, ресторан, достопримечательность)
- Один раз нажмите на иконку расширения Thunderbit
- Thunderbit разметит страницу по столбцам (название отеля, рейтинг, цена, число отзывов и т. д.)
- Он сам начнёт извлекать данные — если столбец не тот, что нужен, измените его и запустите снова
- Для более глубоких данных перейдите на уровень ниже — Thunderbit откроет ссылку каждого объекта и соберёт данные со страницы карточки (удобства, полные отзывы, контакты)
- Экспортируйте прямо в Google Sheets, Excel, Airtable или Notion
Весь процесс занимает около двух минут для страницы со списком, а ИИ автоматически обрабатывает пагинацию. Никаких селекторов, XPath и ротации прокси.
Советы по ответственному парсингу TripAdvisor
Несколько базовых правил, чтобы делать это аккуратно:
- Собирайте только общедоступные данные. Не входите в аккаунт, чтобы парсить закрытый или приватный контент.
- Соблюдайте rate limits. Если используете кодовые инструменты, добавляйте задержки между запросами. Инструменты вроде Thunderbit и Apify делают это автоматически.
- Не храните лишние персональные данные. Имена авторов публичных отзывов — это одно; сбор и хранение email-адресов из отзывов — уже другое.
- Используйте данные для законных бизнес-целей — конкурентный анализ, исследование рынка, генерация лидов, академические исследования.
- Следите за условиями использования TripAdvisor в части автоматизированного доступа. Правовое поле в области веб-парсинга постоянно меняется (GDPR, CCPA, политики платформ), поэтому важно быть в курсе.
Подробнее о юридической стороне — в нашей статье о правовых аспектах веб-парсинга.
Как выбрать лучший парсер TripAdvisor под ваши задачи
Коротко:
- Thunderbit — самый быстрый путь от страницы TripAdvisor к рабочей таблице. Один клик, без кода, ИИ, который адаптируется к отелям, ресторанам, достопримечательностям и турам. Лучший выбор для продаж, операционных и маркетинговых команд, которым нужны данные прямо сейчас.
- Apify — лучшее соотношение цены и возможностей для массового извлечения отзывов, если вам комфортно работать с облачной платформой. Отлично подходит для аналитики тональности и data science-проектов.
- Instant Data Scraper — лучший бесплатный вариант для маленькой выборки; просто не ждите масштабирования дальше нескольких страниц.
- Octoparse — хороший выбор для тех, кому нужен визуальный конструктор workflow с большим контролем; прокси и решение CAPTCHA уже входят в план, так что закладывать нужно поддержку шаблонов и пополнения, если объём превысит лимит.
- ScrapFly — выбор разработчика: глубокая кастомизация, сильный API для обхода антибот-защиты, но писать и поддерживать код парсинга придётся самим.
- Bright Data — для enterprise-масштаба и кроссплатформенного сбора данных с крупнейшей сетью прокси в индустрии. Для маленьких команд это избыточно.
- ScrapeHero — вариант без головной боли: отправляете требования и получаете готовые данные.
- WebAutomation.io — нишевый инструмент для лидогенерации в hospitality, сфокусированный на извлечении контактов из списков TripAdvisor.
Если хотите увидеть, как выглядит современный парсинг TripAdvisor без написания ни одной строки кода, начните с бесплатного тарифа Thunderbit и протестируйте его на своей странице TripAdvisor. Думаю, вас удивит, как быстро вы переходите от «мне нужны эти данные» к «они уже в моей таблице».
Что бы вы ни выбрали, сначала протестируйте это на одной странице до покупки плана — за две минуты вы поймёте, проходит ли инструмент DataDome именно на тех страницах, которые вам действительно важны.
Попробуйте AI-парсинг TripAdvisor с Thunderbit Get Started Free
FAQ
Законно ли парсить TripAdvisor?
Парсинг общедоступных данных во многих юрисдикциях обычно считается законным, но нужно соблюдать условия использования TripAdvisor, не собирать закрытый или приватный контент и соответствовать требованиям по защите данных, таким как GDPR и CCPA. Правовая среда меняется, поэтому полезно следить за обновлениями. Для контекста см. наш материал о правовых аспектах веб-парсинга.
Почему TripAdvisor так быстро блокирует мой парсер?
Потому что DataDome анализирует не только IP, но и браузер, и поведение — поэтому замедление скрипта или смена адреса мало помогает, если ваше окружение уже получило fingerprint. Помогают две вещи: запуск в реальной сессии Chrome, которой вы уже пользуетесь, чтобы это выглядело как обычный пользователь, или инфраструктура, которая сама берёт на себя fingerprinting и CAPTCHA — Apify, Bright Data и ScrapFly включают прокси и решение CAPTCHA, а Cloud-режим Thunderbit делает это на своих серверах.
Можно ли парсить рестораны и достопримечательности TripAdvisor, а не только отели?
Да, но не все инструменты поддерживают страницы не из категории отелей. Шаблонные парсеры могут работать только с URL отелей. ИИ-инструменты вроде Thunderbit адаптируются к любому типу страницы TripAdvisor — ресторанам, достопримечательностям, турам — потому что читают структуру страницы динамически, а не полагаются на жёсткие шаблоны. Рестораны, достопримечательности и туры занимают большую часть TripAdvisor, так что данных здесь много и помимо отелей.
Есть ли полностью бесплатный парсер TripAdvisor?
Instant Data Scraper на 100% бесплатен и подходит для маленьких, быстрых задач (несколько страниц со списками). У Thunderbit есть бесплатный тариф на 6 страниц, а бесплатный план Apify включает $5 в месяц на использование платформы. Для чего-то большего, чем маленькая выборка, вам, скорее всего, понадобится платный инструмент — но стартовать с $0 и проверить, подходит ли он под ваш workflow, вполне реально.
Можно ли парсить отзывы TripAdvisor вообще без кода?
Да, абсолютно. В Thunderbit нужен всего 1 клик — откройте страницу TripAdvisor, запустите расширение, и ИИ всё сделает сам: выберет столбцы, выполнит извлечение и оставит готовую таблицу для экспорта. Нужны конкретные поля? Просто скажи, и он соберёт таблицу под это. У Octoparse и WebAutomation.io тоже есть no-code интерфейсы, но там настройка занимает больше времени. Пошаговый пример см. в нашем шаблоне парсера TripAdvisor или в видео на YouTube-канале Thunderbit. Узнать больше




