Raspador da Wikipédia para Infoboxes, Citações e Seções













Organize artigos da Wikipédia para pesquisa
Mantenha fatos do artigo, valores da infobox, citações e contexto das seções em campos separados.
Extraia dados da Wikipédia em um clique
Ele sugere colunas para a página aberta e conclui a captura em uma única execução. Se quiser, ajuste ou renomeie os campos em linguagem natural e rode novamente.
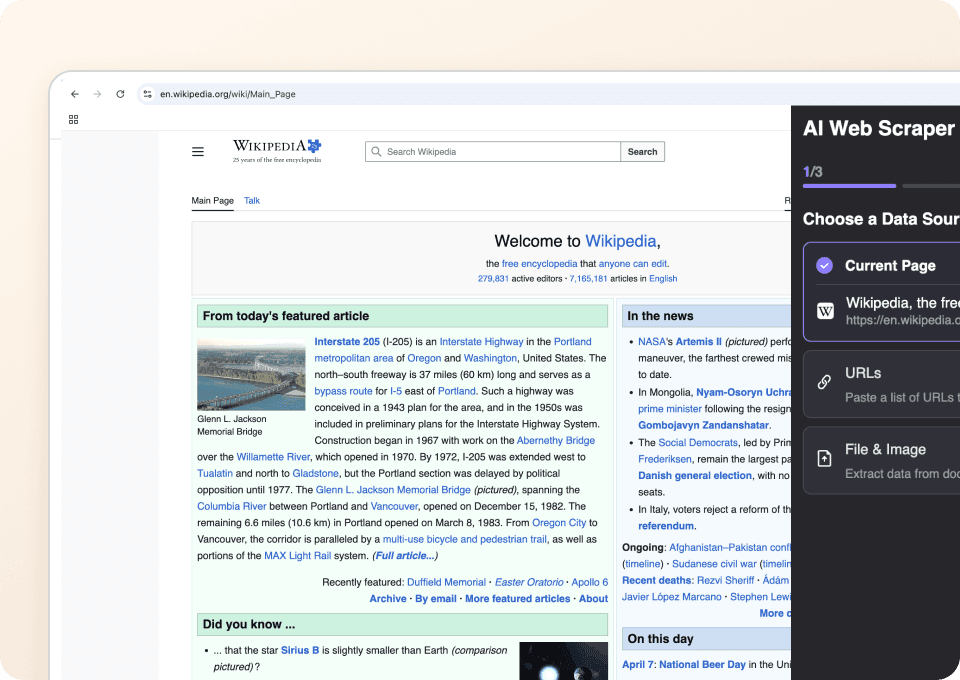
Funciona em diferentes tipos de páginas da Wikipédia
O agente lê rótulos, cabeçalhos e títulos de seções visíveis para mapear os valores na página que você pode acessar. Se um campo não estiver presente, a coluna fica em branco.
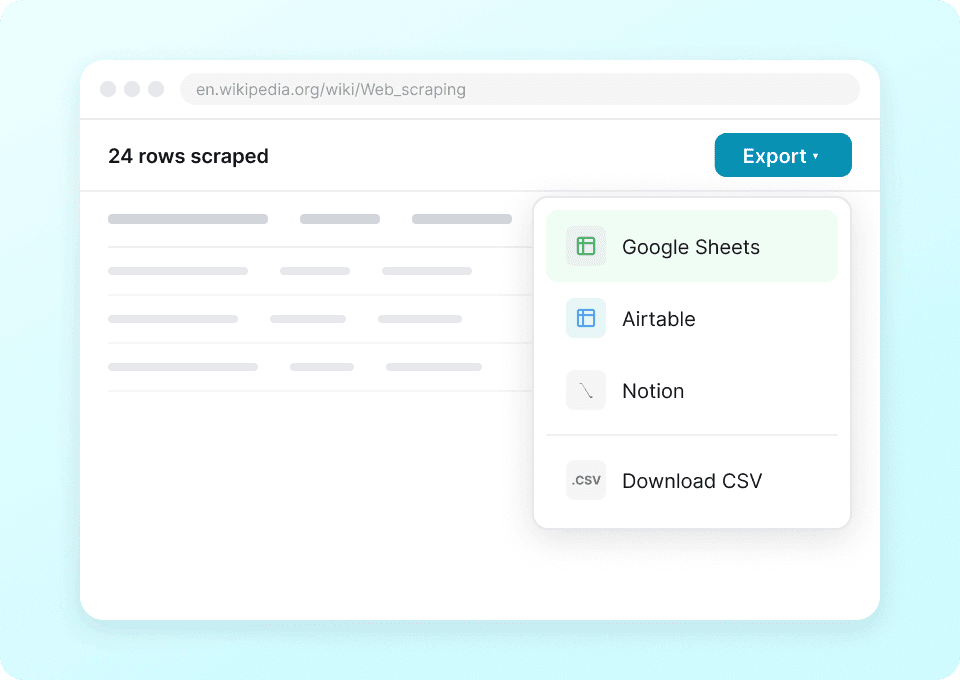
Exporte os dados da Wikipédia diretamente
Continue a pesquisa no Google Sheets, Excel, Airtable, Notion ou em um CSV baixado.
Colete dados de pesquisa da Wikipédia sem criar um raspador
Reduza a manutenção de seletores para pesquisas na Wikipédia.
Configuração manual ou baseada em seletores
Tempo gasto mantendo regrasAgente de IA da Thunderbit
Sugestões de campos e uma única execuçãoColunas para fatos do artigo, infobox, citações e seções
As colunas aparecem apenas quando estiverem visíveis na página que você pode acessar.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.




Dúvidas sobre execuções de pesquisa na Wikipédia
Respostas rápidas sobre o Agent Mode na Wikipédia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Raspador Flixster
O Raspador Flixster da Thunderbit permite extrair informações das listas de bilheteria e dos cinemas próximos do Flixster. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de filmes, receitas de bilheteria, avaliações, datas de lançamento, nomes e localizações de cinemas, além dos filmes em cartaz, facilitando análises e pesquisas.
Saiba mais ->
Raspador olympustaff.com
O Raspador Web olympustaff.com da Thunderbit permite extrair dados de listas de quadrinhos e comentários no olympustaff.com. Utilize sugestões inteligentes de campos com IA para coletar rapidamente títulos de quadrinhos, autores, datas de lançamento e feedback dos leitores para análise ou pesquisa. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que buscam dados estruturados do olympustaff.com.
Saiba mais ->
Raspador Hatena
O Raspador Hatena da Thunderbit permite extrair dados de blogs e listas de tópicos do Hatena com sugestões inteligentes de campos baseadas em IA. Colete títulos de blogs, nomes de autores, datas de publicação, resumos de conteúdo e tópicos em destaque para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Hatena.
Saiba mais ->
Raspador namu.wiki
O Raspador Web namu.wiki da Thunderbit permite extrair dados do namu.wiki, incluindo páginas necessárias e discussões recentes. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente títulos de páginas, URLs, datas da última edição, tópicos de discussão e nomes de participantes — ideal para pesquisas, criação de conteúdo ou análise de comunidades.
Saiba mais ->
Raspador de Música NetEase
O Raspador Web NetEase Music da Thunderbit permite extrair dados dos resultados de busca e páginas de artistas do NetEase Music. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, durações e URLs das faixas para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do NetEase Music.
Saiba mais ->
Raspador de QQ Music
O Raspador Web QQ Music da Thunderbit permite coletar dados dos resultados de busca e listas de músicas de artistas no QQ Music. Com sugestões inteligentes de campos via IA, você reúne rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, datas de lançamento e muito mais para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do QQ Music.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.


