Raspador do Product Hunt













Obtenha dados do Product Hunt em dois cliques
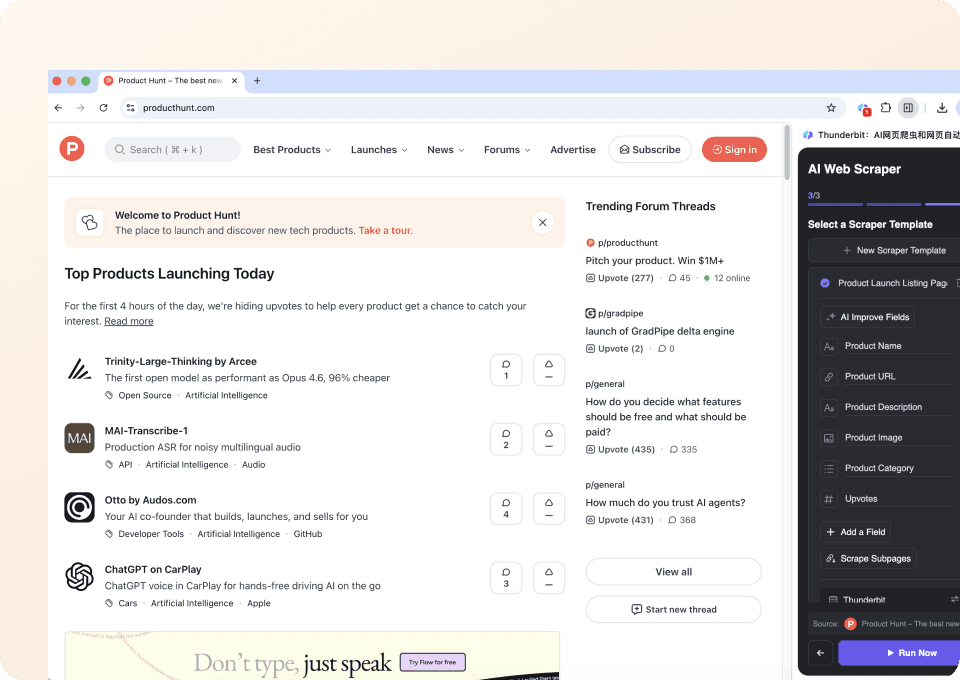
Dois cliques para extrair dados de produtos
Cansado de copiar manualmente nomes de produtos, slogans, upvotes ou informações dos makers do Product Hunt? Com o Thunderbit, não há necessidade de configuração complicada nem de programação. Basta apontar para os dados que você quer e nossa IA identifica automaticamente os campos relevantes. Mais um clique e seus dados são extraídos instantaneamente.
Extraia do Product Hunt e muito mais com facilidade
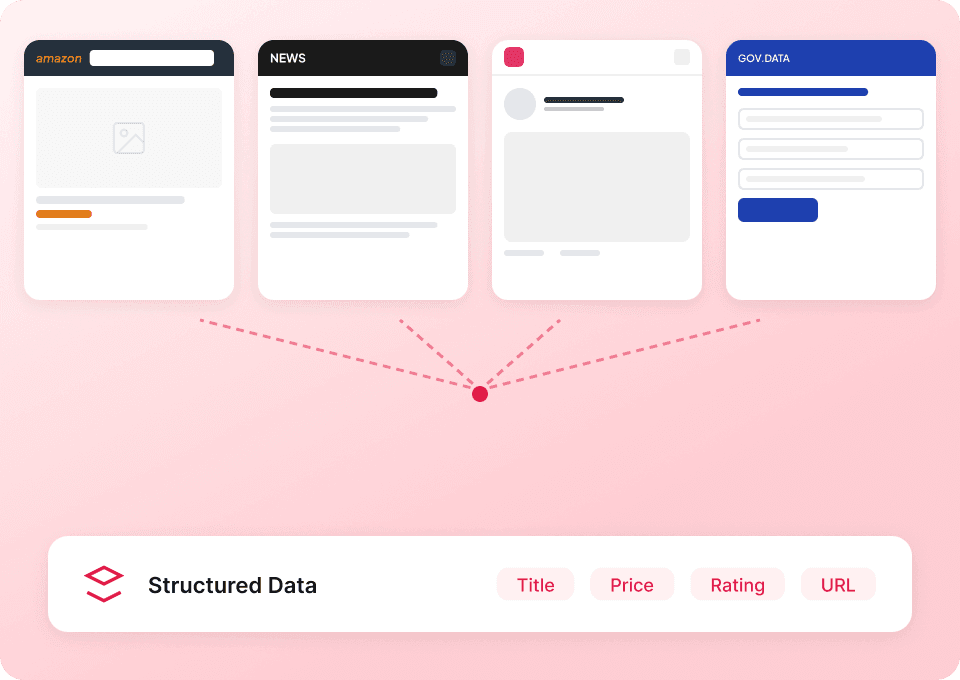
Pare de alternar entre ferramentas diferentes para cada site. O Thunderbit funciona no Product Hunt nativamente e ainda oferece mais de 50 modelos prontos para plataformas populares. Colete detalhes de produtos, contagem de comentários ou informações de categorias em qualquer site com uma única ferramenta versátil — sem necessidade de conhecimento técnico especializado.
Automatize a coleta de dados do Product Hunt
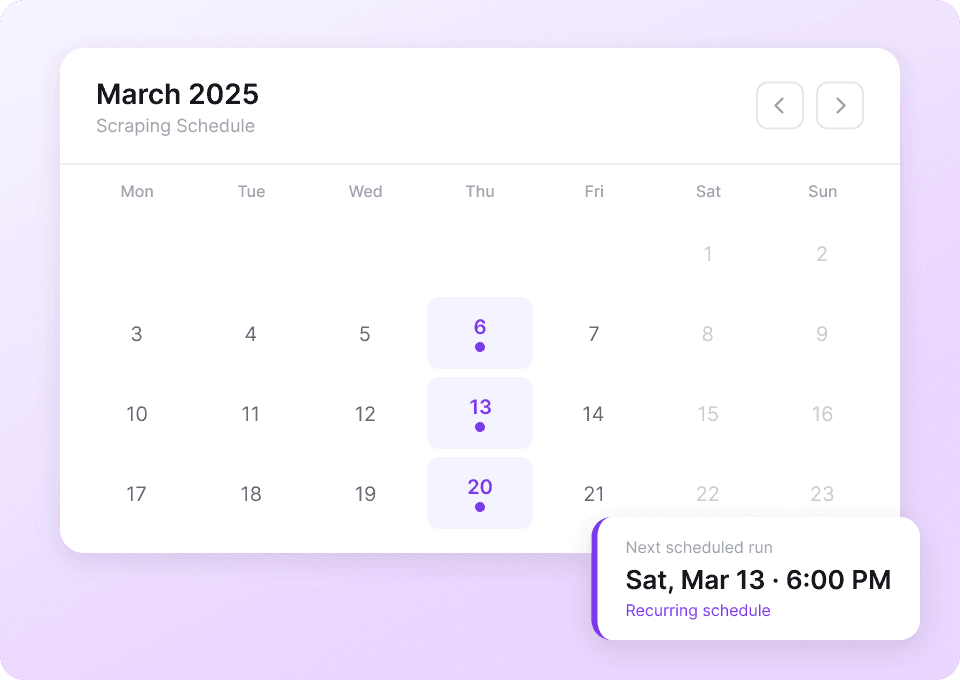
Os lançamentos e as contagens de upvotes no Product Hunt mudam o tempo todo. Verificar tudo manualmente consome tempo. Configure extrações agendadas com o Thunderbit para capturar automaticamente as informações mais recentes dos produtos diariamente ou semanalmente. Os dados atualizados vão direto para Google Sheets, Notion ou Airtable — sem esforço manual.
Com dificuldade para extrair dados do Product Hunt de forma eficiente?
Veja por que o Thunderbit é a forma mais inteligente de extrair dados do Quora.
Scrapers tradicionais
O jeito antigo de fazer as coisasThunderbit
A abordagem mais inteligente




Perguntas frequentes
Relacionados casos de uso
Explore mais casos de uso do web scraper da Thunderbit.
Raspador Flixster
O Raspador Flixster da Thunderbit permite extrair informações das listas de bilheteria e dos cinemas próximos do Flixster. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de filmes, receitas de bilheteria, avaliações, datas de lançamento, nomes e localizações de cinemas, além dos filmes em cartaz, facilitando análises e pesquisas.
Saiba mais ->
Raspador olympustaff.com
O Raspador Web olympustaff.com da Thunderbit permite extrair dados de listas de quadrinhos e comentários no olympustaff.com. Utilize sugestões inteligentes de campos com IA para coletar rapidamente títulos de quadrinhos, autores, datas de lançamento e feedback dos leitores para análise ou pesquisa. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que buscam dados estruturados do olympustaff.com.
Saiba mais ->
Raspador Hatena
O Raspador Hatena da Thunderbit permite extrair dados de blogs e listas de tópicos do Hatena com sugestões inteligentes de campos baseadas em IA. Colete títulos de blogs, nomes de autores, datas de publicação, resumos de conteúdo e tópicos em destaque para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Hatena.
Saiba mais ->
Raspador namu.wiki
O Raspador Web namu.wiki da Thunderbit permite extrair dados do namu.wiki, incluindo páginas necessárias e discussões recentes. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente títulos de páginas, URLs, datas da última edição, tópicos de discussão e nomes de participantes — ideal para pesquisas, criação de conteúdo ou análise de comunidades.
Saiba mais ->
Raspador de Música NetEase
O Raspador Web NetEase Music da Thunderbit permite extrair dados dos resultados de busca e páginas de artistas do NetEase Music. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, durações e URLs das faixas para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do NetEase Music.
Saiba mais ->
Raspador de QQ Music
O Raspador Web QQ Music da Thunderbit permite coletar dados dos resultados de busca e listas de músicas de artistas no QQ Music. Com sugestões inteligentes de campos via IA, você reúne rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, datas de lançamento e muito mais para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do QQ Music.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



