Flickr爬虫













Extraia dados do Flickr em dois cliques
A Thunderbit simplifica a extração de dados do Flickr, sem necessidade de programação.
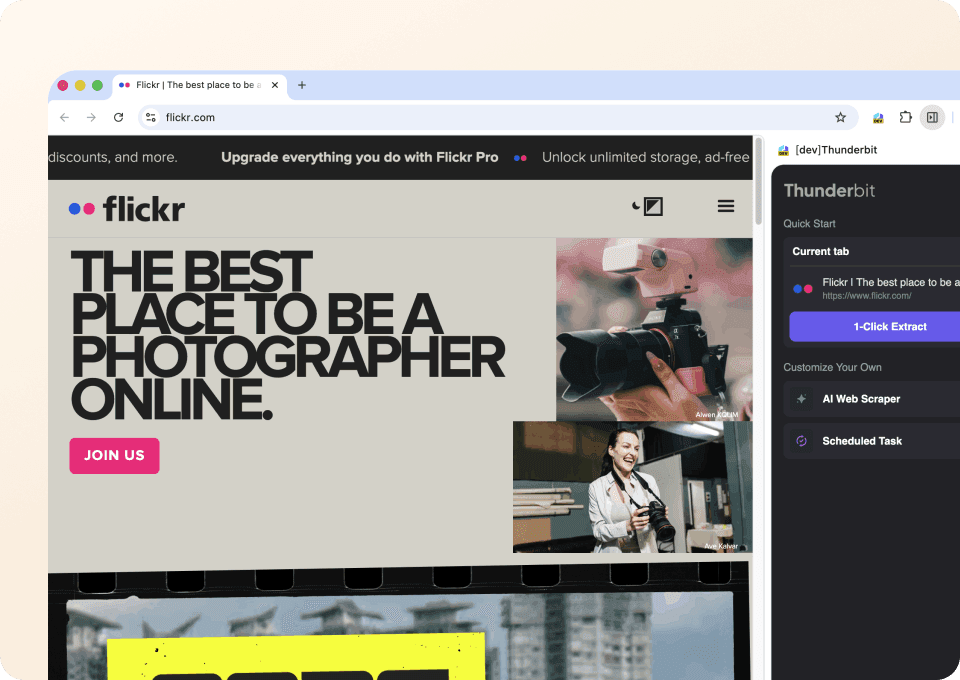
Dois cliques para obter dados do Flickr
Copiar manualmente títulos de fotos, nomes de usuário dos autores ou datas de upload do Flickr é trabalhoso. Com a Thunderbit, você pula a parte de copiar e colar. Basta apontar para os dados que quer — como a descrição da foto ou o tipo de licença — e a IA faz o resto. Em dois cliques, você extrai os dados sem escrever uma única linha de código.
Obtenha os detalhes completos das fotos do Flickr
As páginas de busca e galerias do Flickr mostram apenas informações básicas. Para ter a visão completa, você precisa dos detalhes de cada página individual da foto. A Thunderbit visita automaticamente cada subpágina vinculada, coleta a descrição, as tags e outros detalhes, e adiciona tudo como novas colunas na exportação. Chega de clicar manualmente em cada página de foto.
Extração em massa de dados do Flickr
Extrair fotos do Flickr uma por uma é lento e pouco prático. Em vez de navegar manualmente por páginas individuais, a Thunderbit permite inserir várias URLs do Flickr de uma vez. Ela visita cada página, extrai o título da foto, o nome de usuário do autor e outros dados, e consolida tudo em um conjunto de dados único e organizado.
Por que a Thunderbit é diferente dos scrapers tradicionais para Flickr?
Extraia dados do Flickr sem a dor de cabeça da raspagem tradicional.
Scrapers tradicionais
O jeito antigo de fazer as coisasIA da Thunderbit
A abordagem mais inteligente



Perguntas frequentes
Relacionados casos de uso
Explore mais casos de uso do web scraper da Thunderbit.
Raspador Minds
O Raspador Minds da Thunderbit permite extrair dados de newsfeeds e membros de grupos do Minds com sugestões inteligentes de campos via IA. Colete títulos de posts, nomes de autores, curtidas, comentários e informações de membros de grupos para pesquisas, marketing ou análise de comunidades. Exporte dados estruturados do Minds de forma rápida e eficiente.
Saiba mais ->
Raspador MeWe
O Raspador MeWe da Thunderbit permite extrair dados de perfis de usuários e publicações em grupos do MeWe, com sugestões inteligentes de campos baseadas em IA. Colete nomes de perfil, biografias, datas de ingresso, conteúdos de postagens, curtidas e comentários para pesquisas, marketing ou análises. Perfeito para profissionais de marketing, pesquisadores e empresas que buscam dados estruturados do MeWe.
Saiba mais ->
Raspador Parler
O Raspador Parler da Thunderbit permite extrair dados dos resultados de busca e listas de hashtags do Parler, contando com sugestões inteligentes de campos via IA. Colete termos pesquisados, postagens de usuários, hashtags, índices de popularidade e muito mais para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e empresas que precisam de dados estruturados do Parler.
Saiba mais ->
Raspador de Elementos
O Raspador Web Element da Thunderbit permite extrair dados da Sala de Administradores Synapse do Element com sugestões inteligentes de campos baseadas em IA. Colete IDs de mensagens, nomes dos remetentes, horários, conteúdo das mensagens e anexos para análise ou monitoramento. Perfeito para desenvolvedores, gestores de comunidades e pesquisadores que precisam de dados estruturados do Element.
Saiba mais ->
Raspador Odnoklassniki
O Raspador Odnoklassniki da Thunderbit permite extrair dados de grupos e listas de jogos do Odnoklassniki com sugestões inteligentes de campos baseadas em IA. Colete nomes de grupos, descrições, quantidade de membros, detalhes de jogos, avaliações e muito mais para pesquisas, marketing ou análise. Perfeito para profissionais de marketing, pesquisadores e empresas que precisam de dados estruturados do Odnoklassniki.
Saiba mais ->
Raspador Triller
O Raspador Triller da Thunderbit permite extrair dados de páginas de blog e perfis de coletivos de criadores no Triller. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente títulos de posts, datas de publicação, nomes de autores, bios de criadores e quantidade de seguidores para pesquisas, marketing ou análises.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



