Raspador Craigslist para anúncios locais













Transforme anúncios visíveis do Craigslist em uma tabela
Capture os detalhes exibidos nas páginas que você escolher, lembrando que cada anúncio pode ser diferente.
Colete anúncios do Craigslist com um clique
Abra uma página de resultados ou de anúncio. O One Click Extract pode sugerir campos como título, texto, preço anunciado, local, data e URL. Você pode alterar as colunas sem precisar programar.
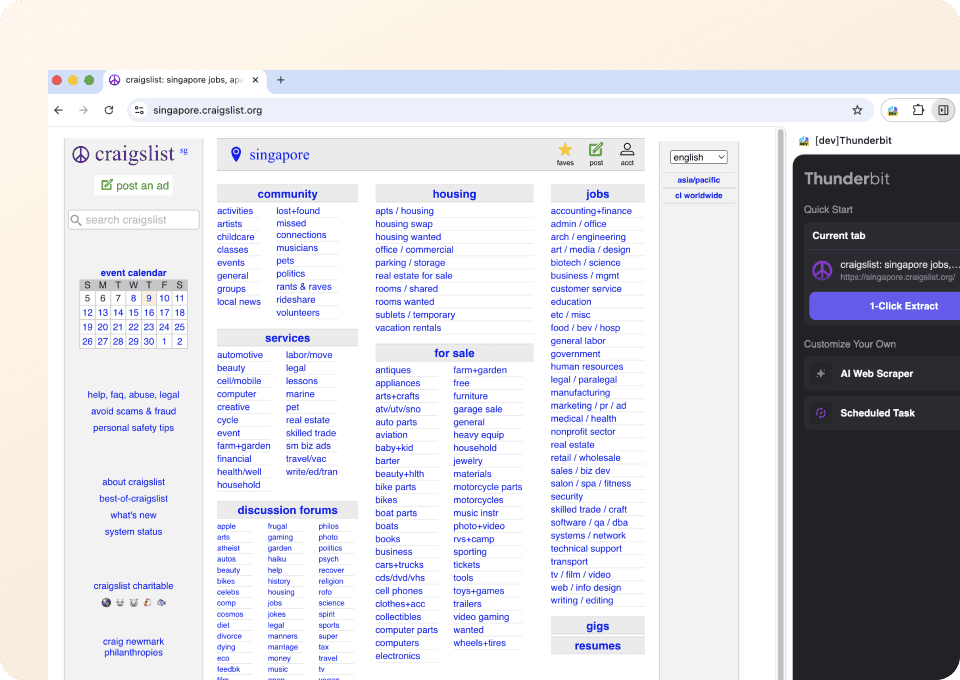
Leia campos em diferentes layouts de anúncio
As seções do Craigslist e os sites regionais exibem campos diferentes. O Thunderbit lê os detalhes visíveis pelo significado, em vez de depender de posições fixas. Informações ausentes ou ocultas permanecem em branco.

Exporte os detalhes visíveis do anúncio diretamente
Leve cada linha para uma planilha local de análise de anúncios. Preços informados, datas, áreas e detalhes de categoria ficam vinculados ao anúncio certo de imóveis, vagas ou revenda.

Mantenha cada detalhe do Craigslist junto ao anúncio correto
A cópia manual pode separar preços, datas e locais dos anúncios que eles descrevem.
Anúncios copiados manualmente
O contexto útil se perdeLinhas estruturadas de anúncios
Os detalhes visíveis permanecem com cada publicaçãoQuais dados você pode extrair do Craigslist?
Escolha entre esses campos públicos de anúncios. O que aparece depende da seção, da área, da categoria e dos detalhes mostrados pelo anunciante.
- Título da publicação
- Corpo da publicação
- Tipo de anúncio
- Categoria
- Área do Craigslist
- Subárea
- Bairro
- Preço anunciado
- Status do preço
- Data da publicação
- URL do anúncio
- URLs das imagens
- Modo de privacidade do e-mail de resposta
- Informações de contato alternativas
- Cidade
- Estado
- CEP
- Latitude
- Longitude
- Nome do contato
- Telefone de contato
- Entrega disponível
- Criptomoeda aceita
- Idioma
- Condição
- Fabricante
- Modelo
- Quartos
- Banheiros
- Área útil
See how people build local listing shortlists
Watch short user videos about housing, job, and resale lists built from public Craigslist pages.





Dúvidas sobre a coleta de anúncios do Craigslist
Os campos do Craigslist variam conforme a área, a seção, a categoria e o que o anunciante torna público.
Explore more ways to research public listings
Try other marketplace, housing, or local listing scrapers when your work goes beyond one Craigslist section or area.
Raspador Flixster
O Raspador Flixster da Thunderbit permite extrair informações das listas de bilheteria e dos cinemas próximos do Flixster. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de filmes, receitas de bilheteria, avaliações, datas de lançamento, nomes e localizações de cinemas, além dos filmes em cartaz, facilitando análises e pesquisas.
Saiba mais ->
Raspador olympustaff.com
O Raspador Web olympustaff.com da Thunderbit permite extrair dados de listas de quadrinhos e comentários no olympustaff.com. Utilize sugestões inteligentes de campos com IA para coletar rapidamente títulos de quadrinhos, autores, datas de lançamento e feedback dos leitores para análise ou pesquisa. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que buscam dados estruturados do olympustaff.com.
Saiba mais ->
Raspador Hatena
O Raspador Hatena da Thunderbit permite extrair dados de blogs e listas de tópicos do Hatena com sugestões inteligentes de campos baseadas em IA. Colete títulos de blogs, nomes de autores, datas de publicação, resumos de conteúdo e tópicos em destaque para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Hatena.
Saiba mais ->
Raspador namu.wiki
O Raspador Web namu.wiki da Thunderbit permite extrair dados do namu.wiki, incluindo páginas necessárias e discussões recentes. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente títulos de páginas, URLs, datas da última edição, tópicos de discussão e nomes de participantes — ideal para pesquisas, criação de conteúdo ou análise de comunidades.
Saiba mais ->
Raspador de Música NetEase
O Raspador Web NetEase Music da Thunderbit permite extrair dados dos resultados de busca e páginas de artistas do NetEase Music. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, durações e URLs das faixas para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do NetEase Music.
Saiba mais ->
Raspador de QQ Music
O Raspador Web QQ Music da Thunderbit permite coletar dados dos resultados de busca e listas de músicas de artistas no QQ Music. Com sugestões inteligentes de campos via IA, você reúne rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, datas de lançamento e muito mais para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do QQ Music.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.


