Capterra scraper













Extraia dados do Capterra com facilidade usando a Thunderbit
Adapta-se às mudanças de layout do Capterra
Cansado de ver scrapers quebrarem toda vez que o Capterra atualiza o design? A Thunderbit entende a estrutura da página, não seletores CSS fixos. Quando o Capterra move um campo ou redesenha uma listagem, a Thunderbit se adapta automaticamente — assim você continua extraindo nomes de softwares, avaliações e descrições sem precisar mexer na configuração.
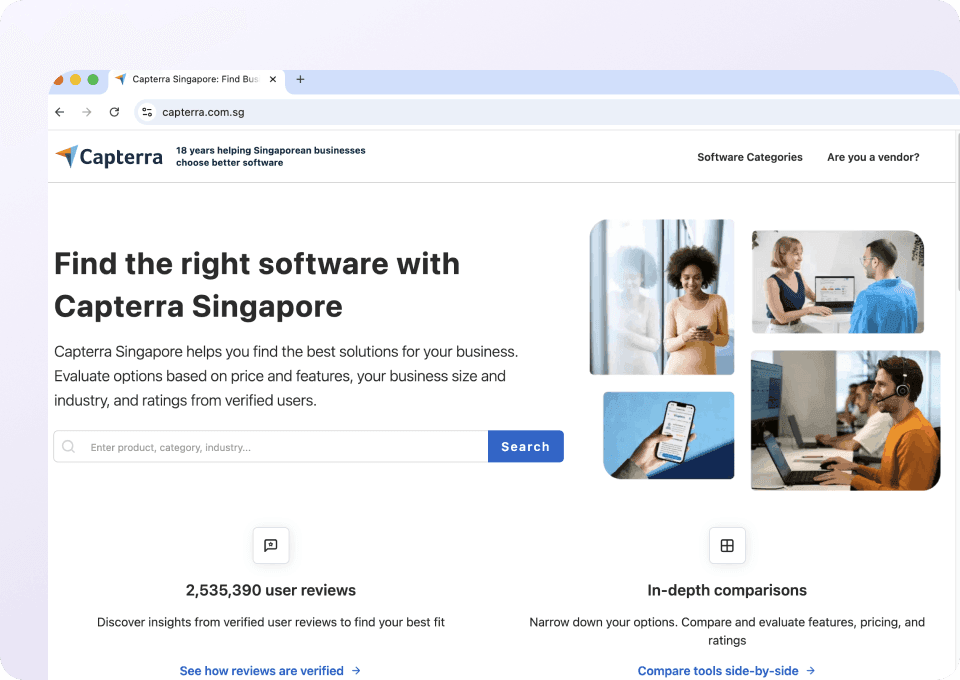
Uma única ferramenta para qualquer fonte de dados
Pare de gerenciar um scraper diferente para cada site que importa para você. A Thunderbit funciona no Capterra de imediato e ainda vem com mais de 50 modelos prontos para outras plataformas populares — sites de avaliações, diretórios, marketplaces e muito mais. Uma só ferramenta cobre tudo.
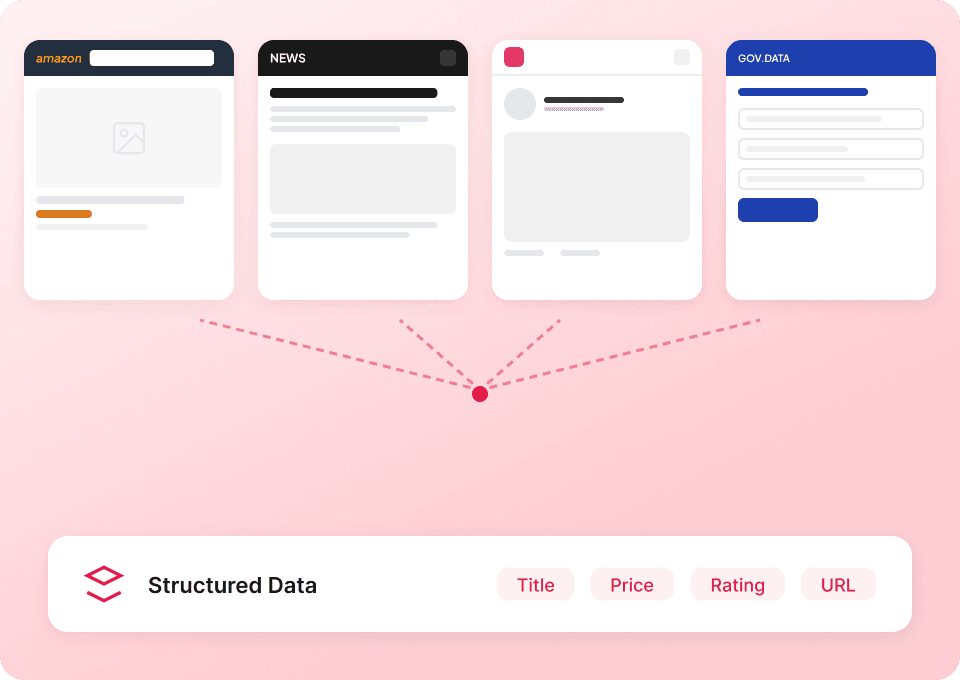
Tenha a visão completa do Capterra
Não pare nos dados da página de listagem. A Thunderbit pode visitar automaticamente a página de detalhes de cada software no Capterra e coletar descrições completas, preços iniciais, principais recursos e muito mais — tudo adicionado como novas colunas na sua planilha ou banco de dados preferido.

Está difícil extrair dados do Capterra com eficiência?
Veja como a Thunderbit simplifica a extração de dados do Capterra, mesmo em layouts complexos.
Scrapers tradicionais
O jeito antigo de fazer as coisasThunderbit
A abordagem mais inteligente




Perguntas frequentes
Relacionados casos de uso
Explore mais casos de uso do web scraper da Thunderbit.
Raspador Flixster
O Raspador Flixster da Thunderbit permite extrair informações das listas de bilheteria e dos cinemas próximos do Flixster. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de filmes, receitas de bilheteria, avaliações, datas de lançamento, nomes e localizações de cinemas, além dos filmes em cartaz, facilitando análises e pesquisas.
Saiba mais ->
Raspador olympustaff.com
O Raspador Web olympustaff.com da Thunderbit permite extrair dados de listas de quadrinhos e comentários no olympustaff.com. Utilize sugestões inteligentes de campos com IA para coletar rapidamente títulos de quadrinhos, autores, datas de lançamento e feedback dos leitores para análise ou pesquisa. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que buscam dados estruturados do olympustaff.com.
Saiba mais ->
Raspador Hatena
O Raspador Hatena da Thunderbit permite extrair dados de blogs e listas de tópicos do Hatena com sugestões inteligentes de campos baseadas em IA. Colete títulos de blogs, nomes de autores, datas de publicação, resumos de conteúdo e tópicos em destaque para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Hatena.
Saiba mais ->
Raspador namu.wiki
O Raspador Web namu.wiki da Thunderbit permite extrair dados do namu.wiki, incluindo páginas necessárias e discussões recentes. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente títulos de páginas, URLs, datas da última edição, tópicos de discussão e nomes de participantes — ideal para pesquisas, criação de conteúdo ou análise de comunidades.
Saiba mais ->
Raspador de Música NetEase
O Raspador Web NetEase Music da Thunderbit permite extrair dados dos resultados de busca e páginas de artistas do NetEase Music. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, durações e URLs das faixas para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do NetEase Music.
Saiba mais ->
Raspador de QQ Music
O Raspador Web QQ Music da Thunderbit permite coletar dados dos resultados de busca e listas de músicas de artistas no QQ Music. Com sugestões inteligentes de campos via IA, você reúne rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, datas de lançamento e muito mais para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do QQ Music.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



