Raspador Baidu para resultados de pesquisa e artigos













Transforme os resultados do Baidu em dados limpos e úteis
Mantenha os resultados de pesquisa e os detalhes dos artigos disponíveis em uma única tabela clara.
Limpe os dados do Baidu enquanto coleta
O Thunderbit organiza títulos, URLs, snippets, datas e fontes visíveis em colunas claras. Se um resultado não exibir determinado campo, a célula permanece em branco.

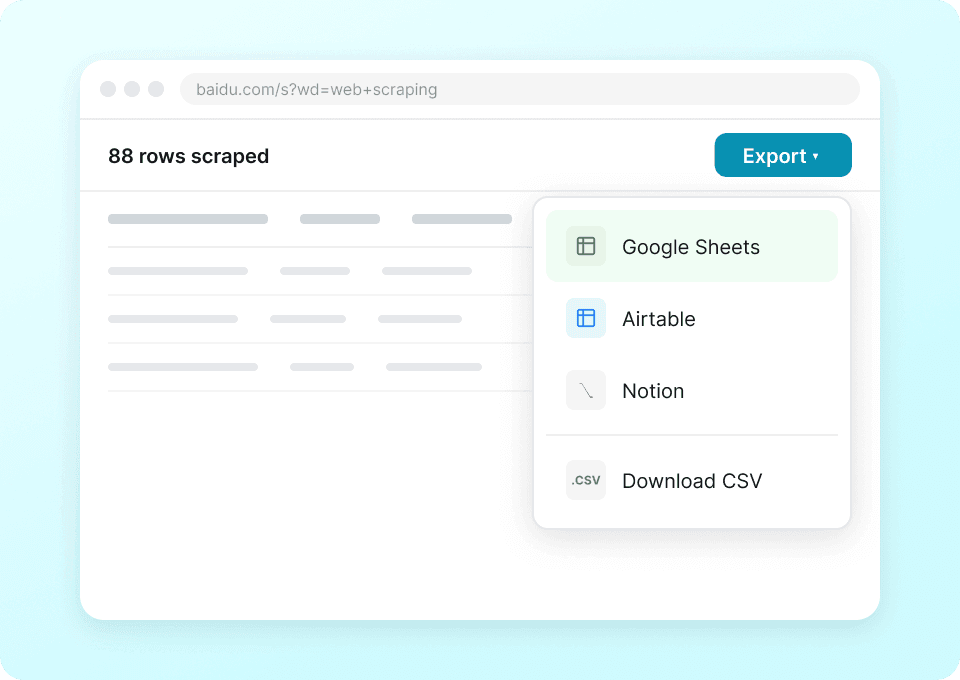
Exporte sua pesquisa no Baidu com um clique
Envie cada execução para uma planilha de revisão de resultados de pesquisa. Posições, fontes, datas e detalhes da página vinculada ficam ao lado do resultado correspondente no Baidu.
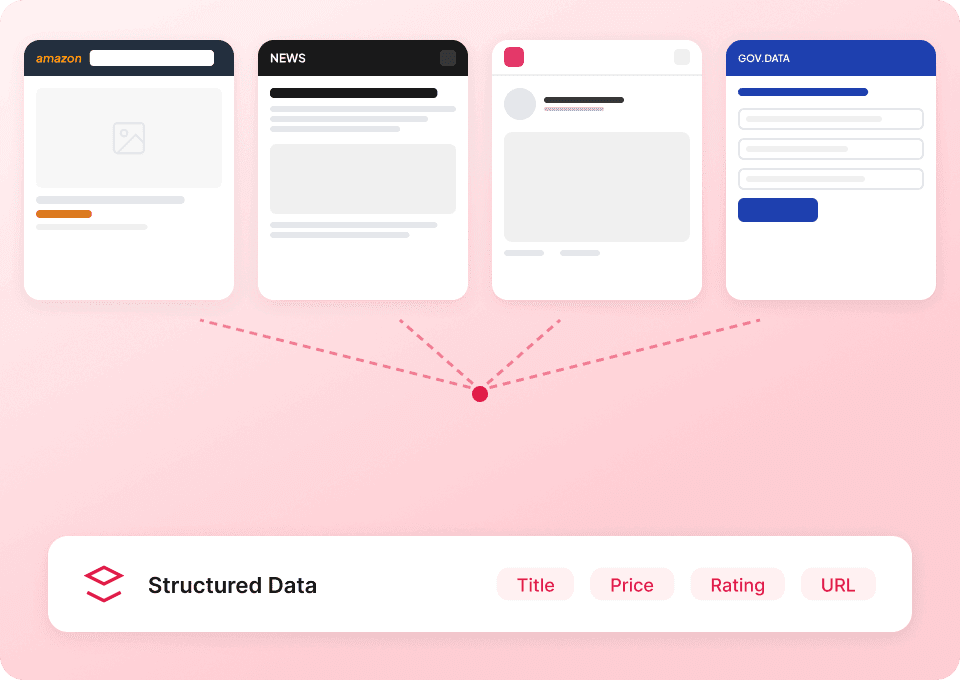
Use o mesmo fluxo de trabalho em qualquer site
O Thunderbit lê os campos pelo significado, e não pelo layout específico do Baidu. Use a mesma abordagem em qualquer site público acessível quando sua pesquisa avançar para uma nova fonte.
Mantenha o contexto de cada resultado do Baidu
Uma lista de links perde contexto. O Thunderbit mantém os detalhes visíveis ao lado de cada resultado.
Links copiados e anotações soltas
Os detalhes do resultado acabam separadosPesquisa estruturada no Baidu
O contexto visível fica com cada resultadoQuais dados você pode extrair do Baidu?
Escolha entre estes campos públicos e visíveis. Os módulos de resultado e as páginas vinculadas não exibem todos os campos em todas as consultas.
- Consulta de pesquisa
- Posição do resultado
- Título do resultado
- URL do resultado
- URL exibida
- Snippet do resultado
- Data do resultado
- Ícone do site do resultado
- Frase de pesquisa relacionada
- Sugestão de correção ortográfica
- Sugestão de pinyin
- Número da página de resultados
- Site de origem
- Domínio de origem
- Autor do artigo
- Data de publicação do artigo
- Resumo do artigo
- Nome do documento
- Descrição do documento
- Breadcrumb do documento
- Gênero do documento
- Formato do arquivo do documento
- Número de páginas do documento
- Horário de envio do documento
- URL do documento
- Tipo de conteúdo do resultado
- Miniatura da imagem
- Miniatura do vídeo
- Endereço de localização
- Módulo de recursos do Baidu
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.




Dúvidas sobre a coleta de dados de pesquisa do Baidu
Os campos disponíveis variam conforme a consulta, o tipo de resultado e as informações exibidas nas páginas vinculadas.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Raspador Flixster
O Raspador Flixster da Thunderbit permite extrair informações das listas de bilheteria e dos cinemas próximos do Flixster. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de filmes, receitas de bilheteria, avaliações, datas de lançamento, nomes e localizações de cinemas, além dos filmes em cartaz, facilitando análises e pesquisas.
Saiba mais ->
Raspador olympustaff.com
O Raspador Web olympustaff.com da Thunderbit permite extrair dados de listas de quadrinhos e comentários no olympustaff.com. Utilize sugestões inteligentes de campos com IA para coletar rapidamente títulos de quadrinhos, autores, datas de lançamento e feedback dos leitores para análise ou pesquisa. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que buscam dados estruturados do olympustaff.com.
Saiba mais ->
Raspador Hatena
O Raspador Hatena da Thunderbit permite extrair dados de blogs e listas de tópicos do Hatena com sugestões inteligentes de campos baseadas em IA. Colete títulos de blogs, nomes de autores, datas de publicação, resumos de conteúdo e tópicos em destaque para pesquisas, marketing ou análise de conteúdo. Perfeito para profissionais de marketing, pesquisadores e criadores de conteúdo que precisam de dados estruturados do Hatena.
Saiba mais ->
Raspador namu.wiki
O Raspador Web namu.wiki da Thunderbit permite extrair dados do namu.wiki, incluindo páginas necessárias e discussões recentes. Aproveite sugestões inteligentes de campos com IA para coletar rapidamente títulos de páginas, URLs, datas da última edição, tópicos de discussão e nomes de participantes — ideal para pesquisas, criação de conteúdo ou análise de comunidades.
Saiba mais ->
Raspador de Música NetEase
O Raspador Web NetEase Music da Thunderbit permite extrair dados dos resultados de busca e páginas de artistas do NetEase Music. Com sugestões inteligentes de campos via IA, você coleta rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, durações e URLs das faixas para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do NetEase Music.
Saiba mais ->
Raspador de QQ Music
O Raspador Web QQ Music da Thunderbit permite coletar dados dos resultados de busca e listas de músicas de artistas no QQ Music. Com sugestões inteligentes de campos via IA, você reúne rapidamente títulos de músicas, nomes de artistas, detalhes de álbuns, datas de lançamento e muito mais para análise ou pesquisa. Perfeito para analistas musicais, profissionais de marketing e entusiastas que buscam dados estruturados do QQ Music.
Saiba mais ->Pronto para turbinar sua extração de dados?
Junte-se a mais de 200.000 profissionais que já usam a Thunderbit para automatizar seus fluxos de web scraping.
O teste grátis oferece créditos ilimitados para 8 páginas web.



