Tumblr爬虫













Odblokuj dane z Tumblr dzięki Thunderbit
Bez wysiłku wyodrębniaj dane z Tumblr, takie jak treść postów i liczba polubień.
Poznaj pełną historię z Tumblr
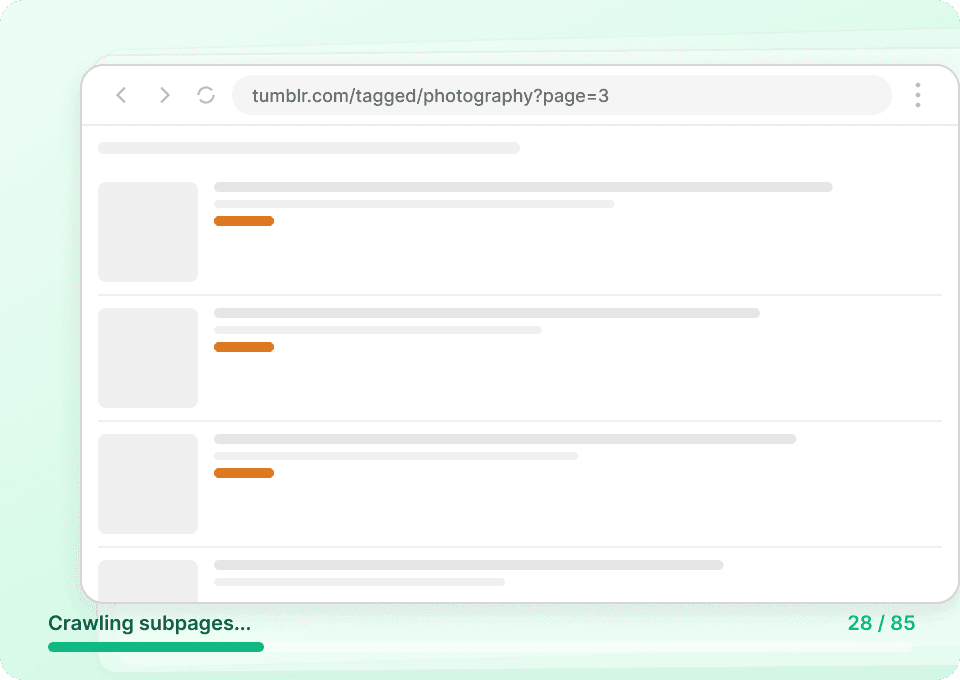
Strony z listą wpisów na Tumblr pokazują tylko fragmenty treści. Aby zobaczyć pełny obraz, potrzebujesz całej treści posta, informacji o autorze i wszystkich powiązanych metadanych. Thunderbit automatycznie odwiedza każdą podstronę wpisu, pobiera pełne szczegóły i dodaje je jako nowe kolumny — dzięki czemu możesz zebrać ID posta, daty publikacji i wiele więcej bez ręcznego klikania.
Zautomatyzuj zbieranie danych z Tumblr
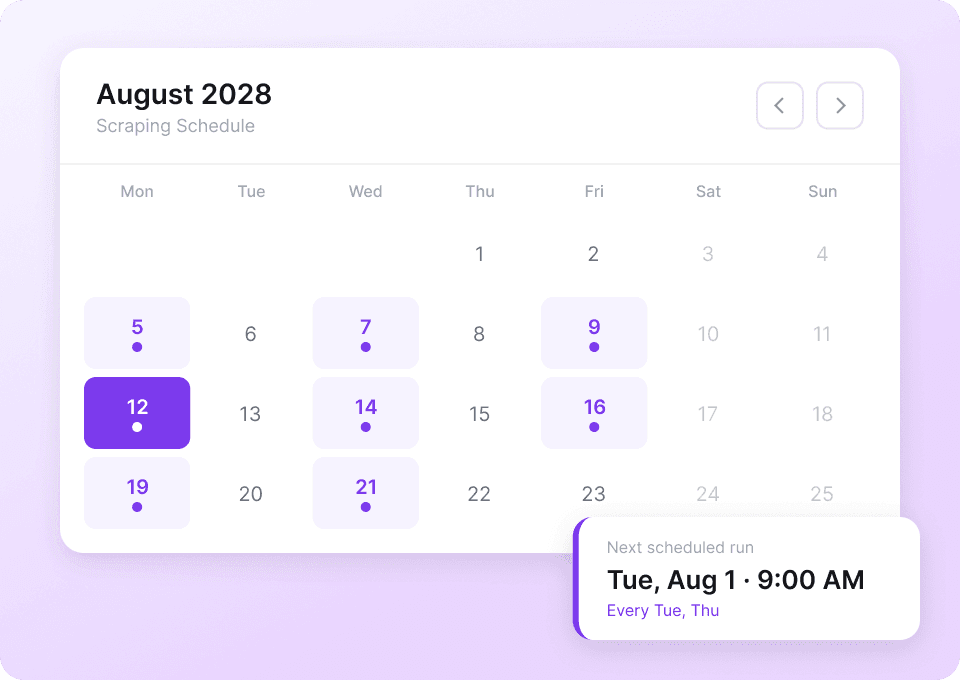
Dane na Tumblr stale się zmieniają. Ręczne wracanie do tych samych blogów i ponowne scrapowanie jest czasochłonne i podatne na błędy. Dzięki zaplanowanemu scrapowaniu w Thunderbit możesz ustawić cykliczne pobieranie danych w pełni automatycznie. Otrzymuj świeżą liczbę polubień i treść postów bezpośrednio w Google Sheets — bez żadnej ręcznej pracy.
Pobieraj posty z Tumblr w dwa kliknięcia
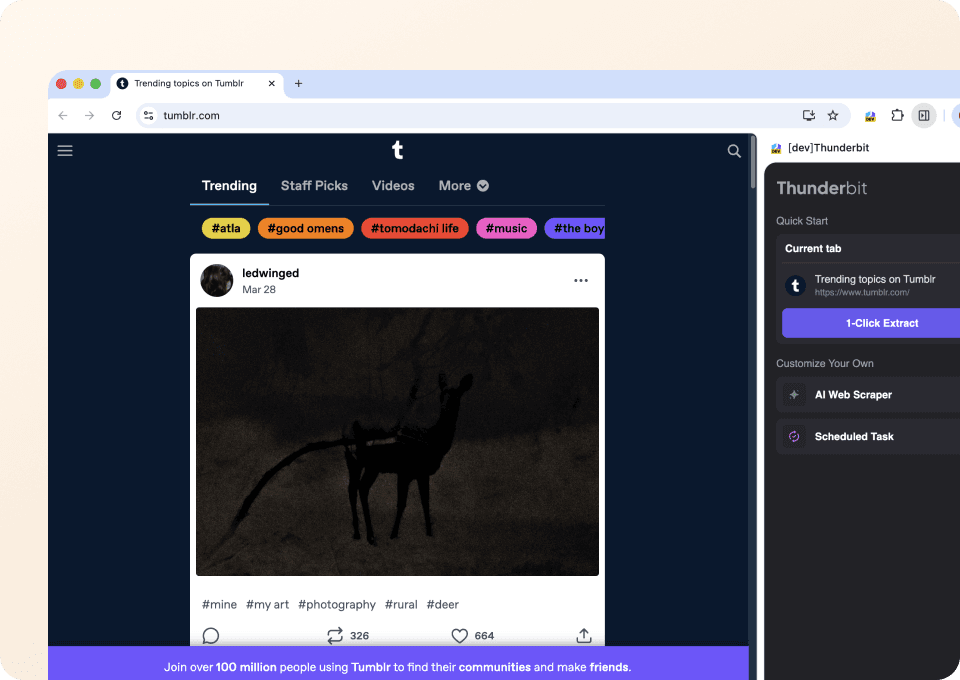
Bez kodu i bez selektorów CSS. Thunderbit pozwala wyodrębniać dane z Tumblr w zaledwie dwa kliknięcia. Wystarczy wskazać, co chcesz pobrać — typ posta, autora, treść, liczbę polubień — a semantyczna AI Thunderbit wykryje odpowiednie pola i automatycznie wyciągnie wszystko za Ciebie.
Czym Thunderbit różni się od tradycyjnych scraperów Tumblr?
Wyodrębniaj dane z Tumblr bez wysiłku, nawet gdy układ strony się zmienia lub niespodziewanie modyfikuje.
Tradycyjne scrapery
Stare podejścieThunderbit AI
Inteligentniejsze podejście
Najczęściej zadawane pytania
Powiązane przypadki użycia
Poznaj więcej zastosowań web scrapera Thunderbit.
Scraper hashtagów
Scraper hashtagów Thunderbit pomaga zbierać listy postów z hashtagów oraz kluczowe metryki do monitorowania trendów w social media. Wykorzystaj AI, aby wyciągnąć URL-e postów, opisy, twórców, daty publikacji i zaangażowanie, a następnie wyeksportuj dane do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Video Scraper
Video Scraper od Thunderbit pozwala w kilka kliknięć wyciągać z TikToka dane o filmach i twórcach z pomocą AI. Zbieraj listy filmów, metryki wyników i szczegóły profili, a następnie eksportuj do Excel, Google Sheets, Airtable lub Notion, aby prowadzić monitoring i research influencerów.
Dowiedz się więcej ->
9GAG Scraper
Thunderbit 9GAG Scraper pozwala pobierać dane z sekcji Trending i WTF w serwisie 9GAG. Dzięki sugestiom pól opartym na AI szybko wyciągniesz tytuły postów, adresy URL, liczbę polubień, komentarze, obrazy i inne informacje do analizy lub researchu treści. To idealne rozwiązanie dla marketerów, badaczy i twórców treści, którzy potrzebują uporządkowanych danych z 9GAG.
Dowiedz się więcej ->
Prosty scraper Discorda
Wyodrębniaj treść wiadomości z Discorda, nazwy użytkowników autorów i znaczniki czasu z dowolnego kanału w 2 kliknięcia — a następnie eksportuj dane do Excela, Google Sheets lub Notion i pozwól AI wykonać ciężką pracę.
Dowiedz się więcej ->
Flickr 爬虫
Wyciągaj tytuły zdjęć, nazwy użytkowników autorów, daty dodania, tagi i więcej z stron Flickr w 2 kliknięcia — bez pisania kodu. Eksportuj wyniki bezpośrednio do Excela, Google Sheets lub Notion dzięki opartemu na AI scraperowi Thunderbit.
Dowiedz się więcej ->
LinkTree Scraper
Wyodrębnij tytuły linków, adresy URL i opisy z dowolnego profilu Linktree w 2 kliknięcia, a następnie od razu wyeksportuj dane do Excel, Google Sheets lub Notion — bez kodowania.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.



