Pixiv Scraper













Proste scrapowanie danych z Pixiv
Wyciągaj dane z Pixiv, takie jak tytuły prac, nazwy autorów i tagi, bez ręcznego kopiowania i wklejania.
Masowe scrapowanie danych z Pixiv na dużą skalę
Ręczne zbieranie danych z Pixiv strona po stronie bardzo szybko staje się czasochłonne, zwłaszcza gdy potrzebujesz dziesiątek lub setek tytułów prac, nazw autorów, tagów, liczby wyświetleń, liczby zakładek i dat publikacji. Thunderbit pozwala zeskrobać listę adresów URL za jednym razem, dzięki czemu możesz przejść od kilku stron do dużego zestawu rekordów z Pixiv bez marnowania czasu na powtarzalną pracę.
Zbieraj pełne szczegóły z podstron Pixiv
Strony list w Pixiv często pokazują tylko podstawowe informacje, a prawdziwe szczegóły znajdują się dopiero na podstronie konkretnej pracy lub autora. Thunderbit odwiedza każdą powiązaną podstronę i pobiera pełny obraz — opisy prac, listy tagów, informacje o serii, liczbę wyświetleń i łączną liczbę zakładek — dostarczając bogatsze i lepiej uporządkowane dane.
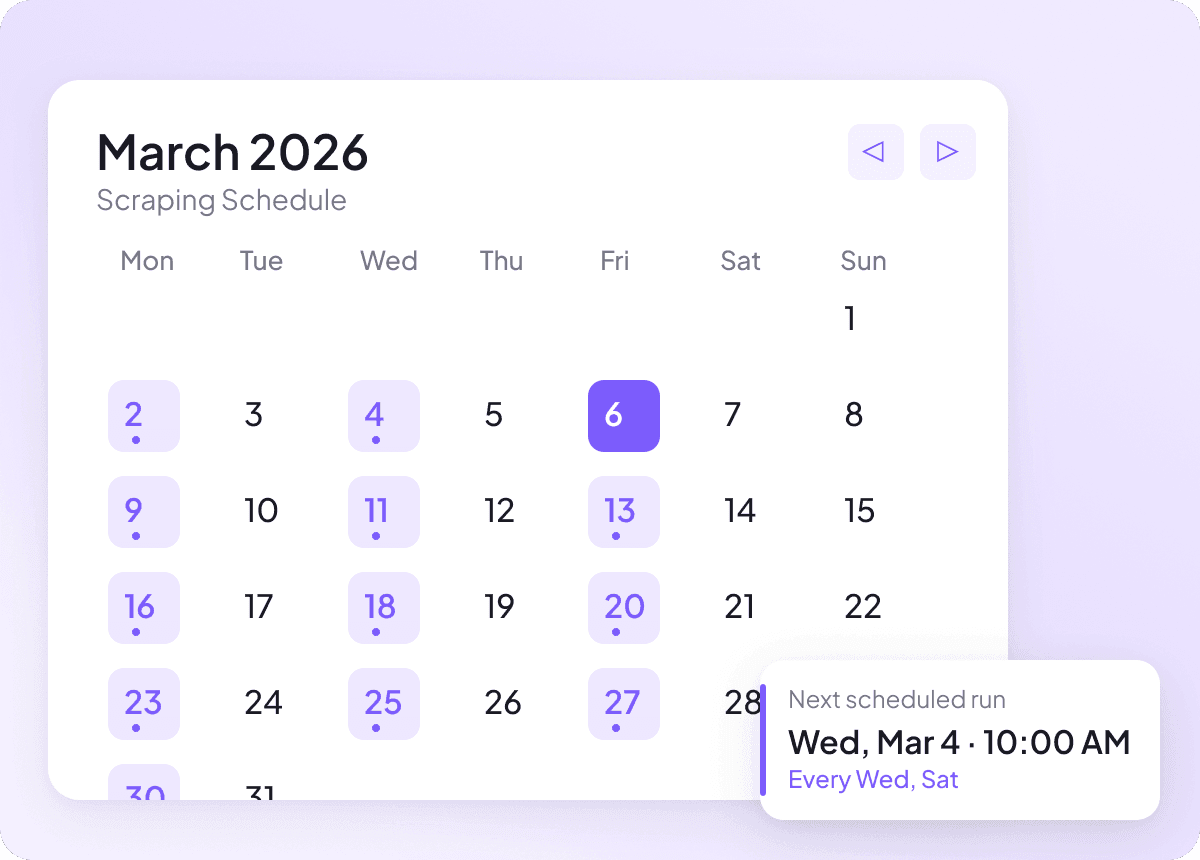
Aktualizuj dane z Pixiv automatycznie
Treści na Pixiv zmieniają się cały czas, a ręczne śledzenie oznacza ciągłe sprawdzanie tych samych stron. Dzięki harmonogramom scrapowania Thunderbit działa automatycznie i regularnie dostarcza świeże dane z Pixiv prosto do arkusza, więc monitoring prac, autorów i tagów pozostaje zawsze aktualny bez Twojego udziału.
Dlaczego Thunderbit różni się od tradycyjnych scraperów Pixiv?
Prostszy sposób na scrapowanie Pixiv bez zawodnych selektorów i ręcznego porządkowania danych.
Tradycyjne scrapery
Stary sposób pracyThunderbit AI
Inteligentniejsze podejście
Najczęściej zadawane pytania
Powiązane przypadki użycia
Poznaj więcej zastosowań web scrapera Thunderbit.
Teams Scraper
Teams Scraper od Thunderbit umożliwia wyodrębnianie wiadomości z czatów oraz danych o członkach społeczności z Microsoft Teams. Dzięki sugestiom pól opartym na AI szybko zbierzesz treść wiadomości, informacje o nadawcy, znaczniki czasu i profile członków do analizy lub raportowania. Idealne rozwiązanie dla kierowników projektów, działów HR i badaczy, którzy potrzebują uporządkowanych danych z Teams.
Dowiedz się więcej ->
Framer Scraper
Framer Scraper od Thunderbit pomaga z pomocą AI wyciągać listy szablonów i przykłady z Framer Showcase. Możesz zbierać dane z kategorii (np. szablony Portfolio), a następnie odwiedzać podstrony każdego szablonu lub realizacji, aby przechwycić szczegóły takie jak tytuł, tagi, linki do podglądu i metadane. Wyniki wyeksportujesz do Excel, Google Sheets, Airtable lub Notion dosłownie w kilka kliknięć.
Dowiedz się więcej ->
Scraper WordPress.org
Scraper WordPress.org od Thunderbit pomaga z użyciem AI wyciągać uporządkowane dane z katalogu wtyczek WordPress oraz biblioteki wzorców bloków. Zbieraj dane z list, wzbogacaj je o szczegóły z podstron (statystyki wtyczek, wersje, oceny, metadane wzorców), a następnie eksportuj do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Capterra scraper
Wyodrębniaj nazwy programów, oceny i modele cenowe z Capterra w 2 kliknięcia — a następnie eksportuj dane bezpośrednio do Excel, Google Sheets lub Notion. Bez kodowania.
Dowiedz się więcej ->
CoinMarketCap scraper
Wyodrębnij dane o kryptowalutach — cenę, kapitalizację rynkową i 24-godzinny wolumen — z CoinMarketCap w 2 kliknięciach. Otwórz dowolną stronę, pozwól AI automatycznie rozpoznać pola i eksportuj dane bezpośrednio do Excela, Google Sheets lub Notion.
Dowiedz się więcej ->
GoDaddy Scraper
Wskaż dowolną nazwę domeny GoDaddy, status dostępności lub cenę — AI Thunderbit wyciąga dane w 2 kliknięcia i błyskawicznie eksportuje je do Excel, Google Sheets lub Notion.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.



