Baidu Scraper do wyników wyszukiwania i artykułów













Zamień wyniki Baidu w czyste, użyteczne dane
Przechowuj wyniki wyszukiwania i dostępne szczegóły artykułów w jednej przejrzystej tabeli.
Czyść dane Baidu w trakcie zbierania
Thunderbit umieszcza widoczne tytuły, adresy URL, fragmenty, daty i źródła w przejrzystych kolumnach. Jeśli wynik nie pokazuje danego pola, komórka pozostaje pusta.

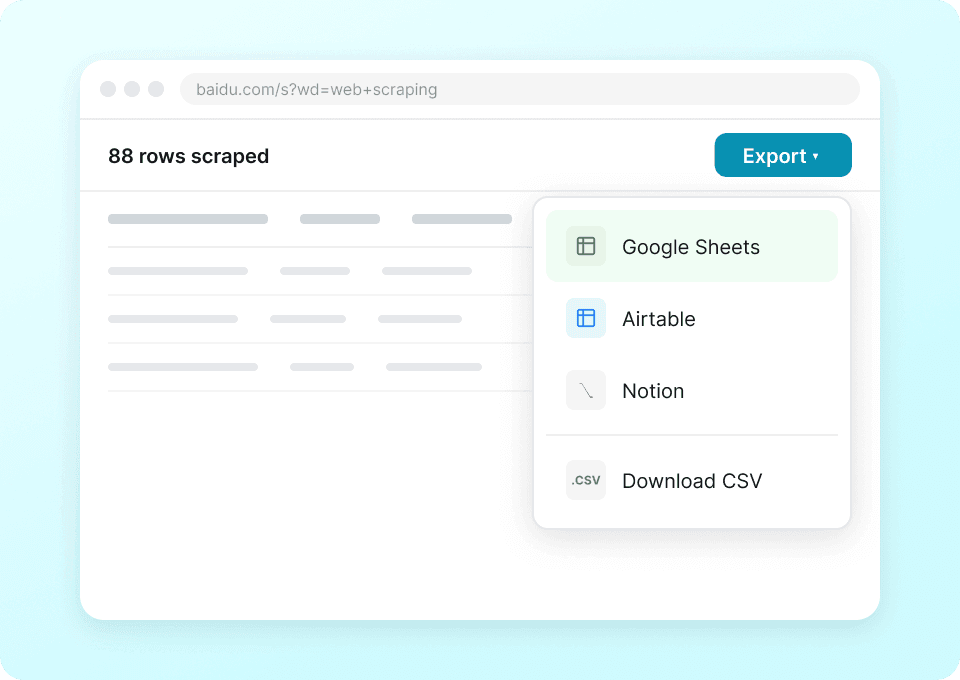
Eksportuj badanie Baidu jednym kliknięciem
Wyślij każdy przebieg do arkusza do analizy wyników wyszukiwania. Pozycje, źródła, daty i szczegóły z podlinkowanych stron pozostają obok pasującego wyniku Baidu.
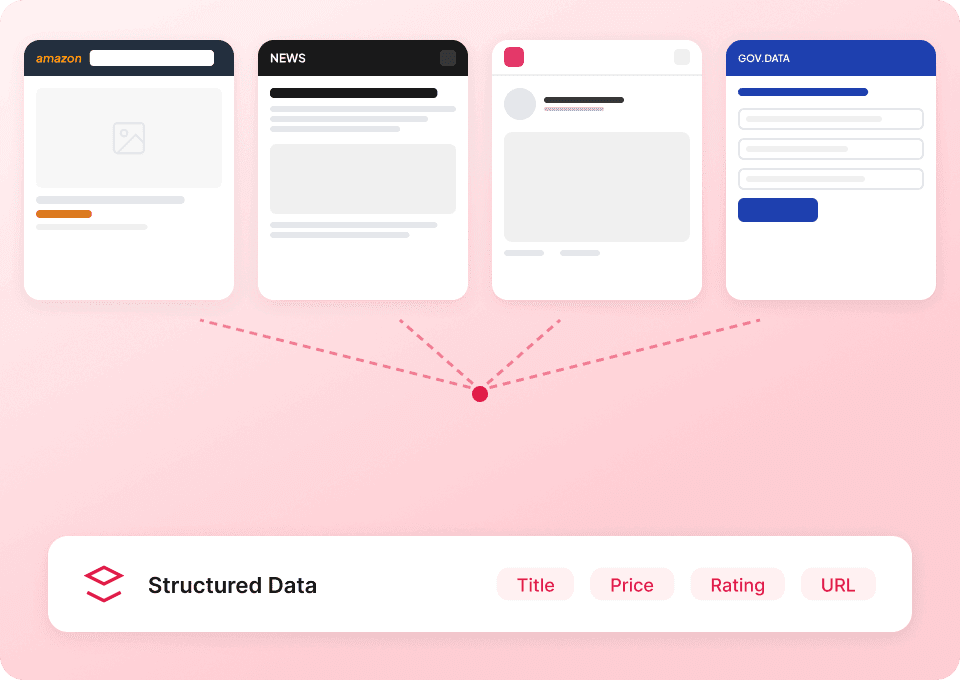
Używaj tego samego workflow na dowolnej stronie
Thunderbit odczytuje pola po znaczeniu, a nie po konkretnym układzie Baidu. Skorzystaj z tego samego podejścia na każdej dostępnej publicznej stronie, gdy Twoje badanie przechodzi do nowego źródła.
Zachowaj kontekst przy każdym wyniku Baidu
Lista linków gubi kontekst. Thunderbit trzyma widoczne dane obok każdego wyniku.
Skopiowane linki i luźne notatki
Szczegóły wyników rozdzielają sięUstrukturyzowane badanie Baidu
Widoczny kontekst pozostaje przy każdym wynikuJakie dane możesz wyciągnąć z Baidu?
Wybierz spośród tych publicznie widocznych pól. Moduły wyników i powiązane strony nie pokazują wszystkich pól dla każdego zapytania.
- Zapytanie wyszukiwania
- Pozycja wyniku
- Tytuł wyniku
- URL wyniku
- Wyświetlany URL
- Fragment wyniku
- Data wyniku
- Ikona witryny wyniku
- Powiązana fraza wyszukiwania
- Sugestia pisowni
- Sugestia pinyin
- Numer strony wyników wyszukiwania
- Witryna źródłowa
- Domena źródłowa
- Autor artykułu
- Data publikacji artykułu
- Opis artykułu
- Nazwa dokumentu
- Opis dokumentu
- Okruszki nawigacyjne dokumentu
- Rodzaj dokumentu
- Format pliku dokumentu
- Liczba stron dokumentu
- Czas przesłania dokumentu
- URL dokumentu
- Typ treści wyniku
- Miniatura obrazu
- Miniatura wideo
- Adres lokalizacji
- Moduł funkcji Baidu
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.

Pytania o zbieranie danych wyszukiwania z Baidu
Dostępne pola różnią się w zależności od zapytania, typu wyniku i informacji widocznych na powiązanych stronach.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Teams Scraper
Teams Scraper od Thunderbit umożliwia wyodrębnianie wiadomości z czatów oraz danych o członkach społeczności z Microsoft Teams. Dzięki sugestiom pól opartym na AI szybko zbierzesz treść wiadomości, informacje o nadawcy, znaczniki czasu i profile członków do analizy lub raportowania. Idealne rozwiązanie dla kierowników projektów, działów HR i badaczy, którzy potrzebują uporządkowanych danych z Teams.
Dowiedz się więcej ->
Framer Scraper
Framer Scraper od Thunderbit pomaga z pomocą AI wyciągać listy szablonów i przykłady z Framer Showcase. Możesz zbierać dane z kategorii (np. szablony Portfolio), a następnie odwiedzać podstrony każdego szablonu lub realizacji, aby przechwycić szczegóły takie jak tytuł, tagi, linki do podglądu i metadane. Wyniki wyeksportujesz do Excel, Google Sheets, Airtable lub Notion dosłownie w kilka kliknięć.
Dowiedz się więcej ->
Scraper WordPress.org
Scraper WordPress.org od Thunderbit pomaga z użyciem AI wyciągać uporządkowane dane z katalogu wtyczek WordPress oraz biblioteki wzorców bloków. Zbieraj dane z list, wzbogacaj je o szczegóły z podstron (statystyki wtyczek, wersje, oceny, metadane wzorców), a następnie eksportuj do Excel, Google Sheets, Airtable lub Notion.
Dowiedz się więcej ->
Capterra scraper
Wyodrębniaj nazwy programów, oceny i modele cenowe z Capterra w 2 kliknięcia — a następnie eksportuj dane bezpośrednio do Excel, Google Sheets lub Notion. Bez kodowania.
Dowiedz się więcej ->
CoinMarketCap scraper
Wyodrębnij dane o kryptowalutach — cenę, kapitalizację rynkową i 24-godzinny wolumen — z CoinMarketCap w 2 kliknięciach. Otwórz dowolną stronę, pozwól AI automatycznie rozpoznać pola i eksportuj dane bezpośrednio do Excela, Google Sheets lub Notion.
Dowiedz się więcej ->
GoDaddy Scraper
Wskaż dowolną nazwę domeny GoDaddy, status dostępności lub cenę — AI Thunderbit wyciąga dane w 2 kliknięcia i błyskawicznie eksportuje je do Excel, Google Sheets lub Notion.
Dowiedz się więcej ->Gotowy, by przyspieszyć ekstrakcję danych?
Dołącz do ponad 200 000 profesjonalistów, którzy już używają Thunderbit do automatyzacji procesów web scrapingu.
Darmowy okres próbny zapewnia nielimitowane kredyty na 8 stron.



