
Częściej, niż się spodziewałem, od momentu startu Thunderbit słyszałem pytanie: „Thunderbit czy ParseHub?”. I trudno się dziwić — ParseHub jest na rynku od lat i zdobył wierne grono użytkowników wśród analityków, którzy chcą dokładnie widzieć, jak działa ich scraper. Zamiast więc pisać kolejny niejasny ranking „7 najlepszych scraperów”, usiadłem i rozpisałem, jak te dwa narzędzia radzą sobie z tymi samymi zadaniami — obok siebie, w jednym miejscu.
To zresztą najbardziej zabawne — zanim zacząłem pisać, szukałem prawdziwego porównania tych dwóch narzędzi i nie znalazłem żadnego. Każdy artykuł, na który trafiałem, albo wrzucał oba narzędzia do jednego punktu w ogromnym zestawieniu, albo był recenzją ParseHub, która w połowie tekstu dyskretnie zmieniała się w materiał promocyjny czegoś innego. Więc oto moja wersja „na serio”: bez zmiany tematu w trakcie, bez sprzedażowej narracji przebranej za obiektywizm — po prostu uczciwe spojrzenie na to, gdzie każde z tych narzędzi wygrywa, a gdzie nie.
Krótka odpowiedź: agentic web scraper jednym kliknięciem vs wizualna kontrola workflow
Jeśli chcesz najkrótszej odpowiedzi, zanim poświęcisz ponad 2000 słów na czytanie o scraperach (szanuję za zapał), to proszę bardzo: Thunderbit zostało stworzone dla użytkowników biznesowych, którzy chcą jak najszybciej przejść od „oto strona” do „oto mój arkusz”. Otwierasz stronę, klikasz jeden przycisk i agent robi resztę. ParseHub jest dla osób, które chcą widzieć i kontrolować każdy etap — selektory, logikę nawigacji, warunki, cały graf workflow — i nie przeszkadza im poświęcić więcej czasu na początku, żeby uzyskać dokładnie taki proces ekstrakcji, jaki sami zaprojektowali.
Nie chodzi tu o „wersję dla początkujących” jednego narzędzia względem drugiego. ParseHub nie jest prymitywny tylko dlatego, że powstał przed falą AI, a Thunderbit nie jest okrojoną kopią ParseHub z doklejonym chatbotem. Oba narzędzia opierają się na zupełnie różnych modelach działania, a to, które z nich będzie dla Ciebie lepsze, zależy mniej od pytania „które jest lepsze?”, a bardziej od tego, ile kontroli chcesz mieć nad procesem i jak szybko chcesz zobaczyć efekt.
Na pierwszy rzut oka
Oto tabela porównawcza, którą sam chciałem znaleźć, kiedy zacząłem szukać:
| Wymiar | Thunderbit | ParseHub |
|---|---|---|
| Typ platformy | Rozszerzenie do przeglądarki (Chrome/Edge), aplikacja webowa, Open API | Aplikacja desktopowa do pobrania + uruchamianie projektów w chmurze |
| Sposób konfiguracji | Agentowe One Click Extract — strona analizowana automatycznie, pola proponowane samoczynnie | Nauka selektorów metodą point-and-click, selektory względne, komendy nawigacyjne |
| Krzywa uczenia się | Niska — ekstrakcja startuje jednym kliknięciem, dopracowanie jest opcjonalne | Średnia do stromej — wymaga projektowania, testowania i debugowania |
| Strony dynamiczne / AJAX | Obsługiwane na kompatybilnych, autoryzowanych stronach | Udokumentowana moc dzięki jawnej logice interakcji |
| Paginacja i wzbogacanie podstron | Obsługiwane na kompatybilnych stronach | Obsługiwane przez komendy nawigacyjne i pętle |
| Treści za loginem | Działa w autoryzowanej sesji zalogowanej, jeśli jest wspierane | Obsługiwane przez logikę projektu dla stron logowania |
| Automatyzacja | Wykonanie w chmurze / w przeglądarce, harmonogramy tam, gdzie są wspierane | Wykonanie w chmurze, harmonogramy, rotacja IP w kwalifikujących się planach |
| Dostęp dla deweloperów | Open API, MCP Server, CLI | REST API, webhooki |
| Miejsca eksportu | Excel, Google Sheets, Airtable, Notion i pobieranie plików | CSV/Excel/JSON, Google Sheets, Dropbox, S3 zależnie od planu |
| Prywatność darmowego planu | Sprawdź aktualne warunki na stronie cennika Thunderbit | Darmowe projekty są publiczne zgodnie z oficjalnym cennikiem ParseHub |
| Model cenowy | Sprawdź aktualne plany na cenniku Thunderbit | Free, 189 USD/mies. Standard, 599 USD/mies. Professional, indywidualny Plus |
Celowo nie uwzględniłem w tej tabeli szybkości ani „dokładności”. Nie widziałem kontrolowanego, niezależnego benchmarku porównującego te dwa narzędzia, a deklarowanych przez producentów liczb po żadnej ze stron nie uznałbym za podstawę do rekomendacji. Jeśli ktoś mówi Ci, że jego scraper jest „3x szybszy”, zapytaj: w jakich warunkach, na jakiej stronie i przy jakim łączu internetowym. Zwykle odpowiedź brzmi: „zaufaj mi”.
Czym jest Thunderbit?
Thunderbit to agentic web scraper, który mój zespół zbudował z myślą o osobach, które nie chcą zastanawiać się nad selektorami CSS, XPath ani „projektowaniem workflow” — po prostu chcą danych. Główna idea, i szczerze mówiąc rzecz, z której jestem najbardziej dumny, polega na tym, że rozszerzenie Thunderbit do Chrome wymaga dokładnie jednego świadomego kliknięcia na wspieranej, autoryzowanej stronie: One Click Extract.

Gdy klikniesz, agent odczytuje i analizuje stronę, rozpoznaje, jakie dane strukturalne warto pobrać (listing produktów, oferty pracy, katalog firm — cokolwiek), i samodzielnie przygotowuje pola. Następnie pokazuje przycisk Run Now — ale to opcjonalne, bo ekstrakcja i tak startuje automatycznie. Możesz po prostu patrzeć, jak działa, albo doprecyzować instrukcję naturalnym językiem, jeśli chcesz, by dane były inaczej sformatowane, przetłumaczone lub skategoryzowane. O to właśnie chodzi: chcieliśmy całkowicie wyeliminować etap „teraz zbuduj szablon”.
Poza rozszerzeniem jest jeszcze Thunderbit Web App do uruchomień w chmurze, a dla deweloperów i zespołów, które chcą wpiąć to w większe systemy, dostępne są Thunderbit Open API, Thunderbit MCP Server do workflow opartych na agentach AI oraz Thunderbit CLI i Skills do pracy w terminalu i z agentami kodującymi. Narzędzie obsługuje też wzbogacanie podstron (pobranie strony listy, a potem przejście do każdego linku po dodatkowe szczegóły) oraz paginację na kompatybilnych stronach, a następnie eksportuje dane do Excel, Google Sheets, Airtable lub Notion.
Czym jest ParseHub?
ParseHub przyjmuje odwrotną filozofię projektową: daje użytkownikowi wizualny, niemal przeglądarkowy interfejs, w którym „uczy” się scraper dokładnie, co ma zrobić — klik po kliku. To aplikacja desktopowa do pobrania, a po wejściu do projektu tak naprawdę budujesz mały program za pomocą komend point-and-click zamiast kodu.

Zgodnie z oficjalną stroną funkcji ParseHub, narzędzie obsługuje selekcje względne, przechodzenie między stronami, wysyłanie formularzy, zakładki, okienka pop-up, listy rozwijane, warunki i wyrażenia, a także XPath, RegEx i selektory CSS dla osób, które potrzebują takiej precyzji. Jest naprawdę stworzone z myślą o stronach opartych na AJAX i JavaScript, stronach z logowaniem, nieskończonym scrollowaniu i crawlowaniu wielu URL-i. Projekty możesz uruchamiać lokalnie albo wysyłać do chmury ParseHub, planować cykliczne wykonania i pobierać dane przez REST API lub webhooki.
Chcę być tu uczciwy: ParseHub to nie jest jakiś przestarzały relikt. To dojrzałe narzędzie z realną głębią — i jeśli Twoja praca wymaga klikania przez wieloetapowy formularz, obsługi pięciu różnych stanów dropdownów albo przejścia przez labirynt logiki warunkowej, ParseHub daje Ci wizualne rusztowanie, żeby zbudować to krok po kroku i faktycznie widzieć, jak działa. Taki jawny poziom kontroli ma swoją wartość — po prostu jest to inny rodzaj wartości niż „kliknij raz i idź dalej”.
Kluczowa różnica: delegowanie zadania vs projektowanie workflow
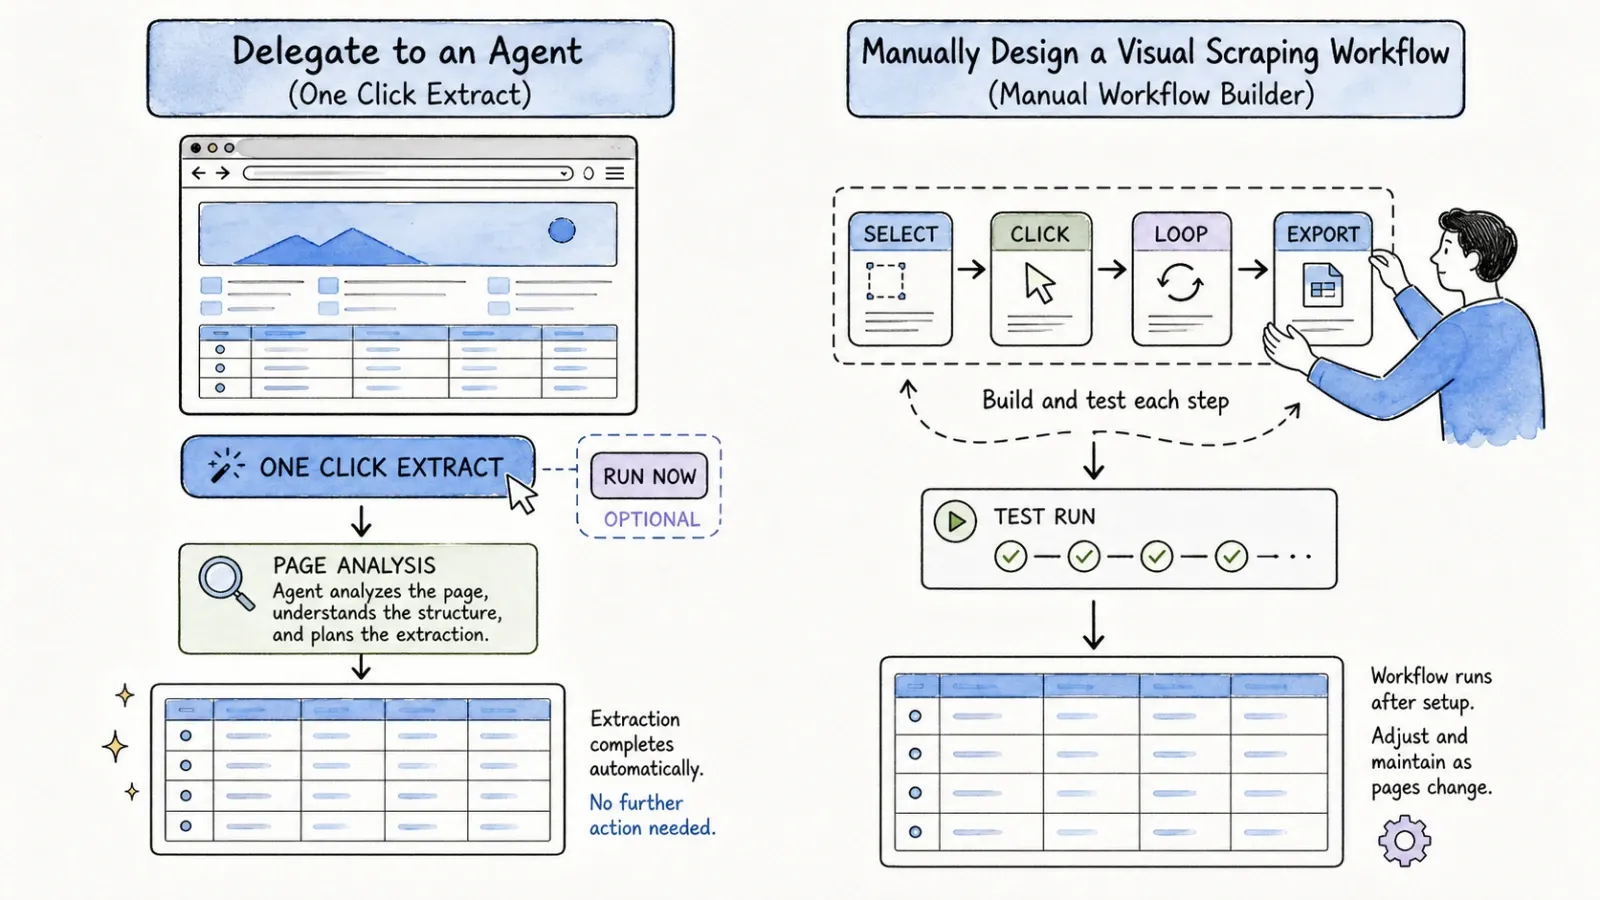
Najlepiej ująć to tak: w Thunderbit delegujesz zadanie ekstrakcji agentowi. W ParseHub projektujesz workflow samodzielnie, po jednej komendzie na raz. Oba narzędzia dostarczą Ci dane. Po prostu wymagają zupełnie innego nakładu czasu i uwagi.
Agentowy workflow Thunderbit jednym kliknięciem
Wchodzisz na stronę — na przykład katalog lokalnych restauracji albo listę ofert pracy. Klikasz One Click Extract. Agent odczytuje strukturę strony, ocenia, co warto pobrać, proponuje kolumny i uruchamia się. Jeśli chcesz dodać pole, zmienić format albo poprosić, by pobierał tylko oferty z tego tygodnia, wpisujesz to prostym językiem. Bez budowania selektorów, bez etapu „ucz mnie, klikając”.
Wizualny workflow projektu w ParseHub
Ta sama lista restauracji w ParseHub wygląda inaczej. Otwierasz aplikację, tworzysz nowy projekt, wskazujesz URL i zaczynasz klikać elementy, które chcesz pobrać — nazwę, adres, ocenę. Dodajesz „relative select”, żeby zebrać powiązane dane blisko każdego elementu, a może komendę „click”, jeśli paginacja wymaga naciśnięcia przycisku „Next”, zamiast zwykłego scrollowania. Testujesz uruchomienie na małej próbce, sprawdzasz wynik, poprawiasz wszystko, co złapało zły element, a potem skalujesz proces albo planujesz jego cykliczne uruchamianie.
Dlaczego architektura zmienia krzywą uczenia się
Żadne z tych narzędzi nie jest obiektywnie „trudniejsze” w oderwaniu od kontekstu — wszystko zależy od tego, co chcesz zoptymalizować. Thunderbit oddaje część kontroli w zamian za szybkość: agent sam odczytuje strukturę i w większości przypadków właśnie tego chcesz przy standardowych stronach listowych i szczegółowych. ParseHub oddaje szybkość w zamian za precyzję: widzisz i możesz poprawić każdy krok, co ma ogromne znaczenie, gdy struktura strony jest nietypowa albo logika naprawdę skomplikowana. Zbudowałem już wystarczająco dużo narzędzi automatyzacyjnych, żeby wiedzieć, że nie ma darmowego obiadu — zawsze gdzieś w pipeline wymieniasz czas konfiguracji na kontrolę.
Porównanie praktycznego workflow
Prosta strona listy
W przypadku czegoś takiego jak prosty katalog produktów albo lista firm Thunderbit działa niemal tak szybko, jak to możliwe — kliknij, poczekaj, wyeksportuj. ParseHub też oczywiście to zrobi, ale najpierw uczysz go selektorów, co przy tak prostej stronie trwa dłużej. To scenariusz, w którym argument „najkrótszej drogi” najmocniej przemawia za Thunderbit.
Strony listowe plus wzbogacanie o strony szczegółowe
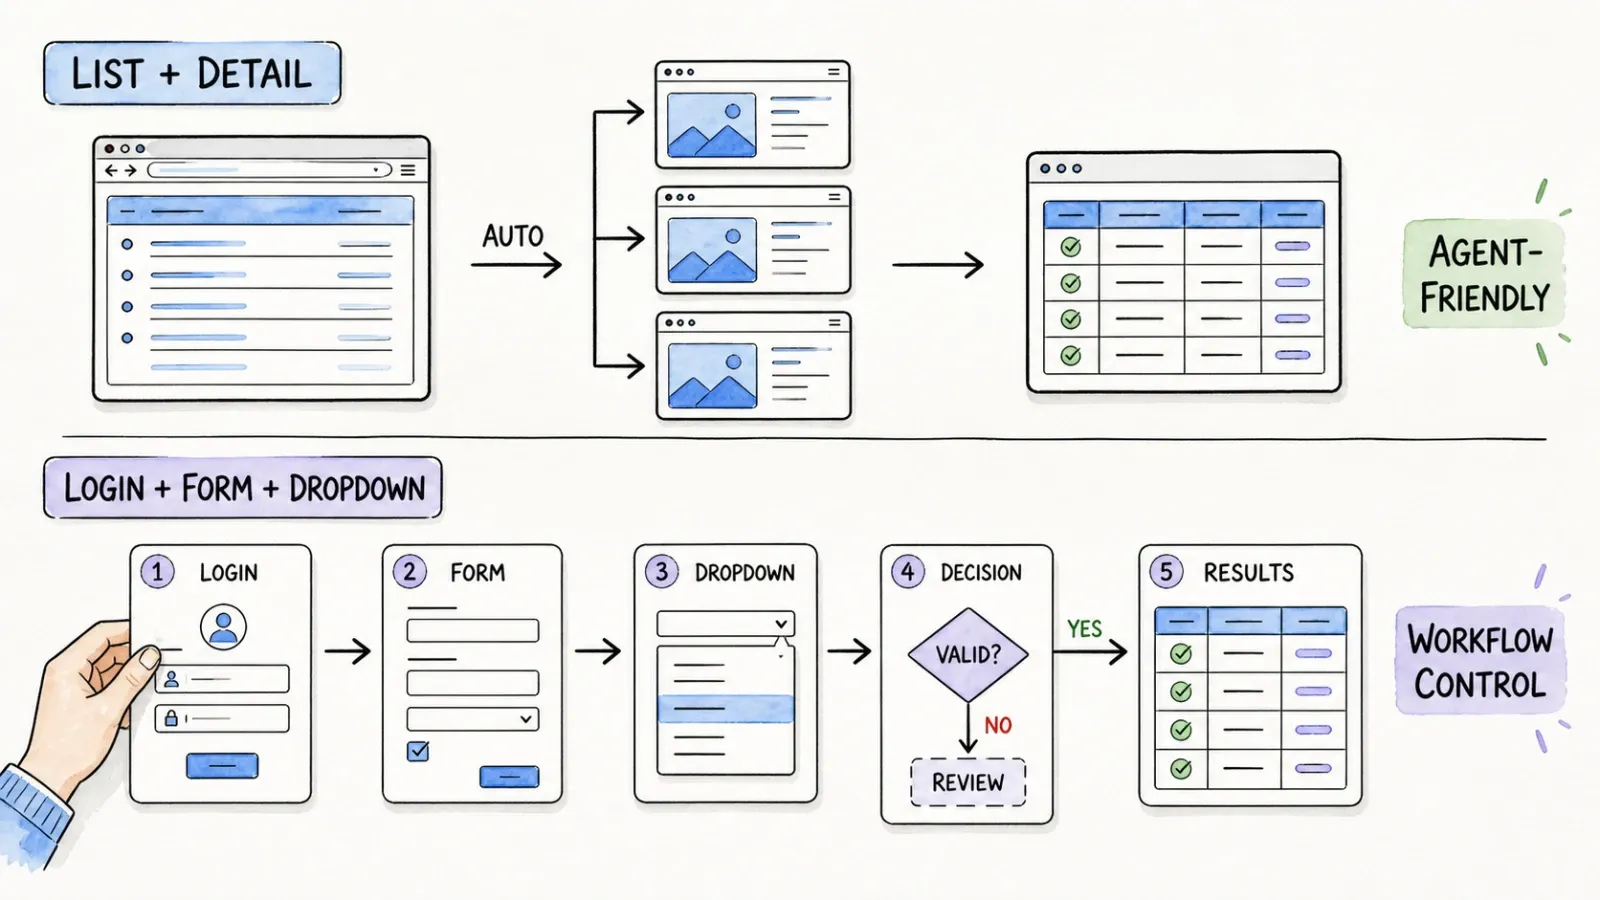
Tu robi się ciekawiej. Załóżmy, że masz listę firm i chcesz wejść na stronę każdej z nich, by pobrać dodatkowe dane — liczbę pracowników, siedzibę, rok założenia. Thunderbit obsługuje to poprzez wzbogacanie podstron na kompatybilnych stronach: automatycznie przechodzi po linkach i łączy dodatkowe pola z Twoimi wierszami. ParseHub też potrafi to zrobić, wykorzystując selekcje względne i komendy nawigacyjne, ale tę logikę ustawiasz ręcznie. Oba rozwiązania działają; jedno każe Ci narysować mapę, drugie rysuje ją za Ciebie.
Workflow z logowaniem lub dużą liczbą interakcji
Oto uczciwy kompromis. ParseHub ma realną, udokumentowaną przewagę w obsłudze logowania, formularzy, dropdownów i wieloetapowych interakcji, bo jego cały model opiera się na jawnych sekwencjach komend — mówisz mu dokładnie, który przycisk kliknąć i kiedy. Thunderbit może działać w autoryzowanej, zalogowanej sesji przeglądarki tam, gdzie jest to wspierane, ale nie jest zaprojektowany jako uniwersalny automat do wypełniania formularzy w takim stopniu jak system komend ParseHub. Jeśli Twoja praca polega głównie na wieloetapowej interakcji (np. logowanie, wybór filtra, wysłanie formularza, a potem ekstrakcja), jawny model ParseHub ma przewagę.
Regularne, zaplanowane pobieranie danych
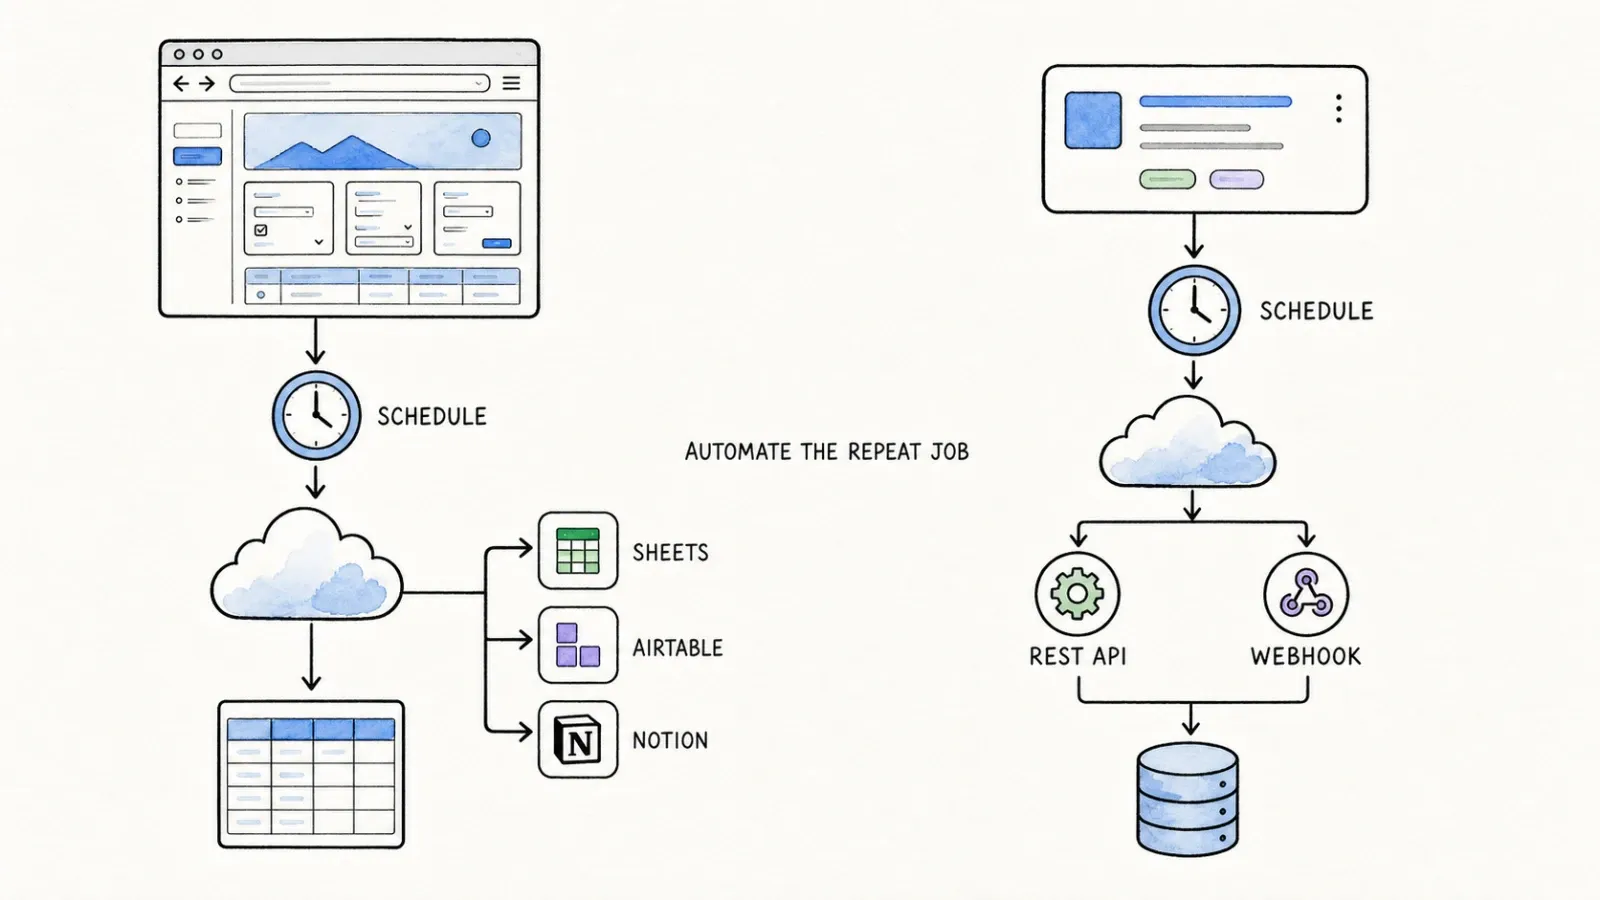
Oba narzędzia obsługują uruchomienia według harmonogramu, choć dostępność zależy od planu. Harmonogramy w ParseHub są powiązane z systemem projektów w chmurze i rotacją IP w kwalifikujących się poziomach. Thunderbit wspiera zaplanowaną ekstrakcję tam, gdzie pozwala na to aktualny plan i warstwa produktu, a dla zespołów budujących większy pipeline Open API lub MCP Server pozwalają agentowi AI albo systemowi backendowemu uruchamiać ekstrakcje według własnego harmonogramu, bez polegania wyłącznie na schedulerze w interfejsie.
Strony dynamiczne, paginacja i złożona nawigacja
Chcę tu zachować ostrożność, bo to dokładnie ten rodzaj twierdzenia, który w marketingu scraperów jest notorycznie wyolbrzymiany — „obsługuje każdą stronę!”. Nie, nie obsługuje. Nic nie obsługuje.
Udokumentowaną mocą ParseHub jest granularna logika interakcji: warunki, wyrażenia, XPath/RegEx/selektory CSS oraz jawne komendy nawigacyjne sprawiają, że wprawny użytkownik często może zbudować obejście dla naprawdę dziwnej strony opartej na AJAX, jeśli ma wystarczająco dużo czasu. To realna, wypracowana przewaga, zbudowana przez lata rozwoju funkcji, jak pokazuje strona funkcji ParseHub.
Siłą Thunderbit jest inferowanie struktury przez agenta na kompatybilnych stronach — narzędzie dobrze radzi sobie z „normalną” stroną listy i szczegółów, rozpoznając wzorzec bez ręcznego wskazywania go, oraz obsługuje typową paginację i wzbogacanie podstron na stronach zaprojektowanych pod taki układ. Ale systemy anty-botowe, nietypowe przepływy uwierzytelniania i mocno zaciemnione strony dynamiczne to realna granica dla każdego narzędzia do scrapingu, niezależnie od tego, czy działa agentowo, czy ręcznie. Moja szczera rada: jeśli dana strona jest na tyle ważna, by budować wokół niej powtarzalny workflow, przetestuj ją w narzędziu, które rozważasz, zanim poświęcisz na to wiele godzin.
Automatyzacja i dostęp dla deweloperów
Historia automatyzacji ParseHub opiera się na uruchamianiu projektów w chmurze, harmonogramach oraz REST API z webhookami — to solidna, dobrze opisana infrastruktura dla osób, które chcą uruchamiać zadania programowo albo przekazywać wyniki do innych systemów.
Historia Thunderbit została zbudowana tak, by spotkać deweloperów i workflow agentów AI tam, gdzie już pracują. Open API daje aplikacjom dostęp HTTP/JSON do zadań ekstrakcji. MCP Server to element, który osobiście najbardziej mnie ekscytuje, bo udostępnia narzędzia ekstrakcji Thunderbit bezpośrednio kompatybilnym hostom AI, takim jak Claude czy Cursor — czyli agent AI może wywołać Thunderbit jako narzędzie w trakcie rozmowy, zamiast ręcznie uruchamiać osobny scraper i wklejać wyniki z powrotem. Z kolei pakiet CLI i Skills obsługuje workflow terminalowe i pracy z agentami kodującymi. MCP nie jest u nas checkboxem na liście funkcji — to zakład, że w ciągu najbliższych kilku lat coraz większa część „scrapingu” nie będzie polegać na człowieku klikającym w UI, tylko na agencie AI, który uzna, że potrzebuje danych i sięgnie po narzędzie.
Eksport i współpraca
Oba narzędzia eksportują podstawowe formaty: CSV, Excel, JSON. ParseHub dodaje Google Sheets, Dropbox i S3, zależnie od planu. Thunderbit eksportuje do Excel, Google Sheets, Airtable i Notion, a także umożliwia pobieranie plików — bardziej z myślą o zespołach biznesowych, które żyją w arkuszach i lekkich bazach danych, niż o inżynierach przesyłających dane do bucketów w chmurze.
Jedna ważna kwestia związana ze współpracą, o której warto powiedzieć wprost: darmowe projekty ParseHub są publiczne, zgodnie z jego oficjalnym cennikiem, więc mogą być przeglądane lub udostępniane przez innych. To w porządku do nauki lub nieprywatnych projektów testowych, ale jeśli pobierasz cokolwiek choć trochę wrażliwego, potrzebujesz płatnego planu z projektami prywatnymi. Zanim zbudujesz coś poufnego w darmowym planie któregokolwiek z narzędzi, sprawdź aktualne warunki.
Cennik i całkowity koszt użytkowania
Widziałem mnóstwo narzekań na ceny scraperów w miejscach takich jak r/webscraping i r/datasets, i większość z nich sprowadza się do jednego: ludzie porównują cenę na etykiecie, nie biorąc pod uwagę godzin, które spędzą na konfiguracji albo naprawianiu zepsutych uruchomień. Zacznijmy więc od samej ceny, a potem porozmawiajmy o tym, czego ona nie mówi.
Na moment mojego ostatniego sprawdzenia, oficjalny cennik ParseHub wyglądał tak:
| Plan | Cena | Stron na uruchomienie | Projekty | Retencja |
|---|---|---|---|---|
| Free | 0 USD | 200 | 5 publicznych projektów | 14 dni |
| Standard | 189 USD/mies. | 10 000 | 20 prywatnych projektów | 14 dni |
| Professional | 599 USD/mies. | Bez limitu | 120 prywatnych projektów | 30 dni |
| Plus | Indywidualna | Usługa zarządzana | Indywidualnie | Indywidualnie |
Przy rozliczeniu kwartalnym podobno można zaoszczędzić 15%, a wyższe poziomy dodają harmonogramy i rotację IP. Deklaracje dotyczące szybkości (na przykład „200 stron w mniej niż dwie minuty” w planie Professional) pochodzą od producenta i nie były niezależnie benchmarkowane, więc traktuj je jako orientacyjne, a nie jako ewangelię.
W przypadku Thunderbit wolałbym odesłać Cię do aktualnej strony cennika niż wpisywać tutaj liczby, które mogą się zdezaktualizować zanim skończysz czytać ten tekst — plany i system kredytowy potrafią się zmieniać, a ja wolę, żebyś widział aktualną wersję, zamiast ufać liczbie, którą wpisałem pewnego wtorkowego popołudnia w sierpniu.
Najważniejsza lekcja z budowania firmy SaaS: całkowity koszt użytkowania to nie tylko abonament. To także czas konfiguracji, utrzymanie, gdy strona zmieni układ, i ilość ręcznego czyszczenia danych po uruchomieniu. Tańsze narzędzie, które zjada Ci cztery godziny tygodniowo na przebudowę uszkodzonych selektorów, wcale nie jest tańsze. Weź to pod uwagę, zanim wybierzesz coś wyłącznie na podstawie faktury.
Które narzędzie wybrać?
Wybierz Thunderbit, jeśli...
Jesteś marketerem, osobą pracującą w e-commerce, rekruterem albo badaczem, który chce szybko dostać uporządkowane dane i nie ma ochoty spędzać popołudnia na budowaniu szablonu scrapingu. Odpowiada Ci workflow w przeglądarce lub w aplikacji webowej, a strony docelowe są „zwykłego” typu — listy, katalogi, katalogi produktów — zamiast mocno interaktywnych formularzy wieloetapowych. Chcesz też, by Twoje workflow ekstrakcji dało się z czasem podłączyć do agentów AI lub systemów backendowych przez API albo MCP.
Wybierz ParseHub, jeśli...
Jesteś analitykiem danych albo technicznym operatorem i potrzebujesz precyzyjnej, widocznej kontroli nad niewielką liczbą złożonych, mocno JavaScriptowych stron, a nie przeszkadza Ci zainwestowanie czasu w konfigurację, żeby uzyskać dokładnie taką logikę workflow, jakiej potrzebujesz. Cenisz możliwość widzenia i debugowania każdego kliknięcia, warunku i selektora, a Twój budżet pozwala na plan Standard lub Professional przy pracy cyklicznej i dużej skali.
Użyj obu, jeśli...
Szczerze? Wiele zespołów tak właśnie robi — Thunderbit do szybkich, codziennych zadań ekstrakcji, które nie wymagają głębokiego zastanowienia, a ParseHub zostaje na kilka naprawdę trudnych stron, które potrzebują jawnej logiki interakcji. Nie ma żadnej zasady mówiącej, że musisz wybrać jedno narzędzie do każdego zadania scrapingu w całym swoim życiu.
Ostateczny werdykt
Żadne z tych narzędzi nie jest „lepsze” w uniwersalnym sensie — oba opierają się na innych założeniach dotyczących tego, czego chcą użytkownicy. ParseHub zakłada, że ludzie chcą widocznej, jawnej kontroli nad każdym etapem ekstrakcji, nawet jeśli kosztuje to czas konfiguracji. Thunderbit zakłada, że większość osób po prostu chce danych i woli zlecić „jak” agentowi.
Moja szczera rada: wybierz jedną autoryzowaną stronę, na której naprawdę Ci zależy, i przetestuj ją w obu narzędziach. Zmierz czas konfiguracji, policz liczbę użytecznych wierszy, sprawdź, ile pracy wymaga ponowne uruchomienie po tygodniu, a potem porównaj miesięczny koszt z wartością Twojego czasu. Ten test powie Ci więcej niż jakikolwiek artykuł porównawczy — również ten.
Jeśli chcesz wypróbować drogę jednego kliknięcia, pobierz rozszerzenie Thunderbit do Chrome i wskaż mu stronę, którą wolno Ci scrapować — zobacz, jak daleko zaprowadzi Cię jedno kliknięcie. A jeśli chcesz więcej kontekstu o tym, jak scraping oparty na AI wypada na tle całej branży, sprawdź też nasze artykuły o AI web scrapingu, najlepszych AI web scraperach i scrapingu bez kodowania.
FAQ
Czy Thunderbit jest łatwiejszy niż ParseHub?
W większości standardowych stron typu lista + szczegóły — tak. Workflow Thunderbit oparty na jednym kliknięciu nie wymaga budowania selektorów, podczas gdy ParseHub najpierw wymaga nauczenia go wzorca ekstrakcji. Ale „łatwiejszy” zależy od zadania; w przypadku bardzo interaktywnych stron ze złożonymi formularzami i warunkami jawna kontrola ParseHub może być po prostu bardziej przejrzysta, gdy już wiesz, jak z niego korzystać.
Czy ParseHub potrafi scrapować strony oparte na JavaScript i chronione logowaniem?
Tak — według oficjalnej strony funkcji ParseHub narzędzie zostało stworzone właśnie do obsługi stron AJAX/JavaScript, stron logowania, formularzy, dropdownów i nieskończonego scrollowania poprzez system workflow oparty na komendach.
Czy Thunderbit wymaga selektorów CSS albo kodowania?
Nie. Domyślny workflow w rozszerzeniu przeglądarkowym polega na kliknięciu One Click Extract; agent wykrywa i analizuje stronę oraz automatycznie przygotowuje pola. Opcjonalne dopracowanie odbywa się zwykłym językiem, nie kodem ani selektorami.
Czy oba produkty oferują dostęp do API?
Tak. ParseHub udostępnia REST API i webhooki. Thunderbit oferuje Open API, a także MCP Server do workflow agentów AI oraz CLI do pracy w terminalu.
Czy ParseHub jest darmowy?
ParseHub oferuje darmowy plan z limitem 200 stron na uruchomienie i pięcioma publicznymi projektami — według oficjalnego cennika. Pamiętaj, że projekty w darmowym planie są publiczne, więc do pracy prywatnej i wrażliwej potrzebny jest płatny plan.



