
Wpisz w Google „Thunderbit vs Oxylabs”, a pewnie spodziewasz się prostego porównania obok siebie, trochę jak Coca-Cola kontra Pepsi. W praktyce to nie jest aż tak czarno-białe. Jedno z tych narzędzi działa w przeglądarce i w kilka sekund przechodzi przez stronę za Ciebie. Drugie to sieć proxy z taką infrastrukturą IP, jakiej pozazdrościłby niejeden operator telekomunikacyjny. A jednak ludzie nadal szukają tych dwóch produktów razem, bo oba próbują odpowiedzieć na to samo pytanie: jak ściągać dane z internetu, nie tracąc na to całego tygodnia życia?
Przez sporą część kariery przechodziłem między światem „budowania infrastruktury” a światem „dajcie mi po prostu dane” — najpierw w Automation Anywhere, potem w Jet.com, a dziś w Thunderbit. Dlatego dobrze rozumiem, skąd bierze się to zamieszanie. To trochę jak porównywanie firmy przeprowadzkowej z zestawem kartonów do przeprowadzki — jedno i drugie pomaga przenieść rzeczy z punktu A do punktu B, ale jedno jest usługą, a drugie produktem, którego używasz do zbudowania własnego procesu. Ustalmy więc, czego naprawdę potrzebujesz, bo obiecuję, że nie jest to tak mgliste, jak sugerują strony marketingowe.
Krótka odpowiedź
Jeśli chcesz najkrótszej wersji, zanim wejdziemy w szczegóły: Thunderbit to agentowy web scraper bez kodowania — otwierasz stronę, klikasz One Click Extract, a narzędzie samo rozpoznaje pola i pobiera uporządkowane dane. Do tego dochodzą Web App, Open API, MCP Server i CLI dla osób, które chcą wejść głębiej. Oxylabs to infrastruktura do scrapingu dla enterprise — sieci proxy, Web Scraper API i produkt Web Unblocker stworzony dla zespołów inżynieryjnych budujących własne pipeline’y danych na dużą skalę.
Żadne z nich nie jest „lepsze” poza kontekstem. Wszystko zależy od tego, czyje to jest zadanie: pracownika biznesowego, który potrzebuje arkusza Excela na piątek, czy inżyniera danych odpowiedzialnego za utrzymanie pipeline’u scrapującego milion żądań miesięcznie.
Na szybko
Tak wyglądałoby moje zestawienie tych dwóch produktów, zanim wejdziemy w pojedyncze funkcje:
| Wymiar | Thunderbit | Oxylabs |
|---|---|---|
| Główny użytkownik | Sprzedaż, operacje, badania, zespoły nietechniczne, a także deweloperzy przez API/MCP | Inżynierowie danych, zespoły backendowe, przedsiębiorstwa |
| Konfiguracja | Instalacja rozszerzenia przeglądarki, otwarcie strony | Rejestracja, wygenerowanie danych API, napisanie logiki zapytań |
| Warstwa ekstrakcji | Agentowa — AI czyta stronę i wyciąga pola | Definiowana przez dewelopera — sam parsujesz i strukturyzujesz odpowiedź |
| Anty-bot/renderowanie | Obsługiwane automatycznie na wspieranych, autoryzowanych stronach | Obsługiwane przez Web Unblocker lub konfigurację warstwy proxy |
| Wynik | Tabela/wiersze, eksport do Sheets, Airtable, Notion | Surowy HTML albo uporządkowany JSON dla wspieranych celów |
| Model skalowania | Oparty na kredytach, zorientowany na zadania | Oparty na przepustowości (GB) i liczbie żądań |
| Utrzymanie | Niskie — logika ekstrakcji dopasowuje się do strony | Ciągłe — to Ty odpowiadasz za retry, rotację i utrzymanie parsera |
| Ład i zgodność | Autoryzowane, kompatybilne strony; zgodność po stronie użytkownika | Tak samo — zgodne z prawem, autoryzowane użycie jest odpowiedzialnością klienta |
Czym jest Thunderbit?
Thunderbit to to, co nazwałbym agentowym web scraperem — nacisk kładę na „agentowy”, bo sedno polega na tym, że nie musisz sam pisać selektorów ani ręcznie tworzyć schematu. Otwierasz stronę, do której masz autoryzowany dostęp, klikasz One Click Extract, a agent sam wykrywa, czyta i analizuje stronę. Proponuje pola, które mają sens dla tej konkretnej strony, a potem pojawia się Run Now — ale jest tu ważny szczegół, którego wiele osób nie zauważa: nie musisz nawet tego klikać. Jeśli nic nie zrobisz, ekstrakcja i tak uruchamia się automatycznie.
To naprawdę inny sposób pracy niż wieloetapowe konfiguracje, z których korzystały niektóre pierwsze narzędzia do scrapingu i które starsze recenzje wciąż czasem opisują. Przebudowaliśmy to wokół jednego świadomego działania, bo szczerze mówiąc, nikt nie chce pięcioetapowego rytuału tylko po to, żeby zaciągnąć tabelę cen ze strony.

Poza ekstrakcją jednym kliknięciem możesz doprecyzować wyniki zwykłym językiem („pokaż mi tylko oferty z ostatnich 30 dni”), wzbogacać dane z podstron tam, gdzie struktura serwisu na to pozwala, i eksportować je bezpośrednio do Google Sheets, Airtable lub Notion. A jeśli jesteś deweloperem i chcesz pominąć przeglądarkę, masz do dyspozycji Thunderbit Open API do dostępu programistycznego, Thunderbit MCP Server do podpięcia ekstrakcji pod Claude, Cursor lub inne środowiska agentowe AI oraz pakiet Thunderbit CLI i Skills do pracy z terminala albo w workflow opartym na agentach kodujących. To ta sama inteligencja ekstrakcji, tylko wystawiona przez różne „drzwi” w zależności od tego, co pasuje do Twojej pracy.
Jeśli chcesz szerszego obrazu tego, jak działa ta kategoria, warto zajrzeć do naszych materiałów o AI web scraping i web scrapingu bez kodowania — oba teksty wchodzą w mechanikę głębiej, niż mam tu miejsce opisać.
Czym jest Oxylabs?
Oxylabs to zupełnie inny gatunek narzędzia i uczciwie mówiąc, oni nie próbują być konkurencją dla Thunderbit w sensie „kliknij i wyciągnij”. Ich aktualna strona z cenami wymienia kilka odrębnych produktów: Web Scraper API, Web Unblocker i rodzinę sieci proxy (residential, mobile, datacenter, ISP).
Web Scraper API to najbliższy odpowiednik „produktu do scrapingu” — zaczyna się od 49 USD miesięcznie, obsługuje renderowanie JavaScript i zwraca przeanalizowany albo uporządkowany JSON dla wspieranych typów stron, takich jak wyszukiwarki, e-commerce czy serwisy turystyczne. Web Unblocker to raczej warstwa dostępu: automatycznie zarządza fingerprintami przeglądarki, cookies, wyborem proxy i ponawianiem prób, a jego zadaniem jest przechodzenie przez trudne zabezpieczenia anty-botowe na chronionych celach — ale odsyła Ci odpowiedź strony, a nie gotową tabelę. Parser nadal musisz napisać sam.
Są też surowe produkty proxy, dokładnie tym, na co wskazuje nazwa: pule adresów IP residential, mobile lub datacenter, wynajmowane na gigabajty, zakładające, że masz już własną automatyzację przeglądarki, parsowanie i pipeline do przechowywania danych. To infrastruktura w najczystszej postaci — nie kupujesz gotowego wyniku, kupujesz instalację.
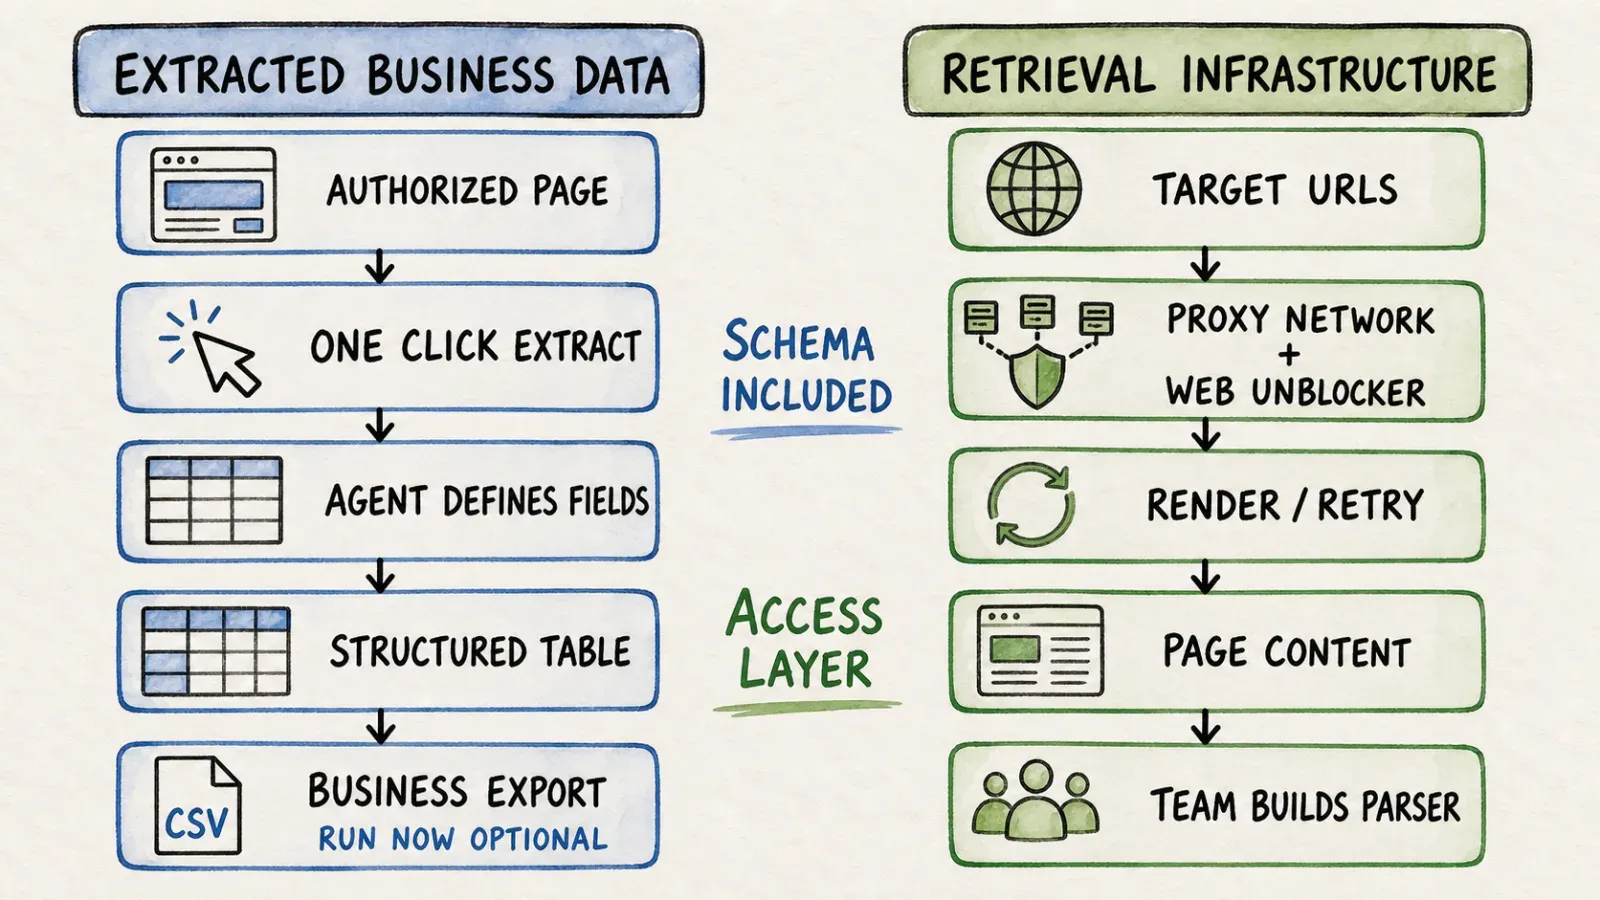
Kluczowa różnica: wyekstrahowane dane biznesowe vs infrastruktura pobierania
Kto definiuje schemat i pola?
W Thunderbit agent patrzy na stronę i proponuje pola — nazwy produktów, ceny, oceny, wszystko, co faktycznie znajduje się na stronie — a Ty dopracowujesz to później prostym językiem. W Oxylabs, o ile nie korzystasz z parsera specyficznego dla danego celu w ramach Web Scraper API, schemat definiujesz samodzielnie. To nie jest zarzut wobec Oxylabs; to po prostu zupełnie inny podział pracy. Jedno narzędzie zakłada, że nie chcesz w ogóle myśleć o schemacie. Drugie zakłada, że masz na niego własny pomysł i czas inżynieryjny, żeby go egzekwować.
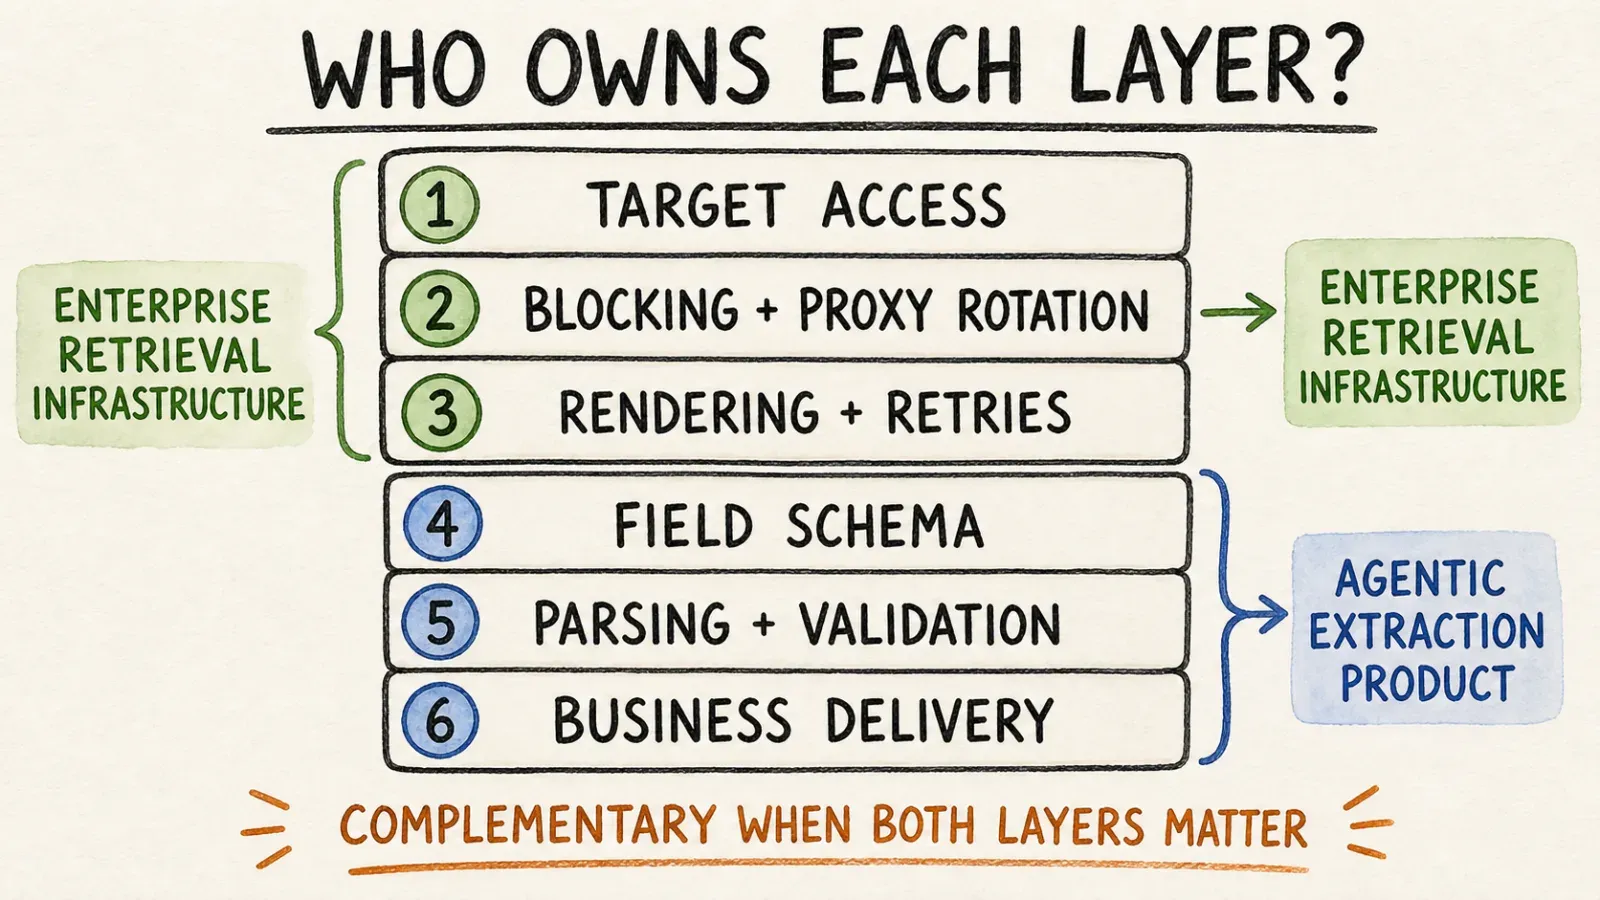
Kto obsługuje blokady, renderowanie i rotację proxy?
Thunderbit automatycznie obsługuje renderowanie i dostęp na wspieranych, autoryzowanych stronach w ramach procesu ekstrakcji — nie trzeba konfigurować osobnego produktu proxy. Oxylabs rozdziela to na osobną warstwę: Web Unblocker istnieje właśnie dlatego, że przebicie się przez zaawansowane systemy anty-botowe jest na tyle trudne, że samo w sobie stało się produktem, z własnym cennikiem i dokumentacją. Jeśli Twoje strony docelowe agresywnie blokują ruch, ta wyspecjalizowana warstwa odblokowująca jest jedną z realnych mocnych stron Oxylabs — to rozwiązanie stworzone przez ludzi, którzy cały dzień myślą o fingerprintingu i zarządzaniu sesjami.
Kto odpowiada za monitoring i dalsze parsowanie?
Tu naprawdę widać różnicę między „infrastrukturą” a „gotowym wynikiem”. W Oxylabs, gdy tylko dostaniesz odpowiedź — czy to surowy HTML z Web Unblocker, czy uporządkowany JSON z obsługiwanego celu w Web Scraper API — to Ty albo Twój zespół odpowiadacie za wszystko dalej: walidację, zapis, harmonogramowanie, obsługę błędów i alerty, gdy coś padnie o 2 w nocy. W Thunderbit obciążenie monitoringiem jest dużo mniejsze, bo etap ekstrakcji i strukturyzacji dzieją się razem, a eksport trafia bezpośrednio do narzędzi, z których Twój zespół już korzysta.
Workflow krok po kroku
Liczby nie kłamią, więc policzmy faktyczne kroki zamiast tylko twierdzić, że jedno narzędzie jest „łatwiejsze”.
Jednorazowe zadanie od strony do tabeli:
| Krok | Thunderbit | Oxylabs |
|---|---|---|
| 1 | Zainstaluj Thunderbit Chrome Extension, otwórz stronę docelową | Zarejestruj się, wygeneruj dane API |
| 2 | Kliknij One Click Extract | Skonfiguruj payload zapytania (cel, renderowanie, geolokalizacja) |
| 3 | Agent analizuje stronę i proponuje pola | Wyślij żądanie, obsłuż parametry proxy/renderowania |
| 4 | Pojawia się Run Now — opcjonalnie, ekstrakcja i tak uruchamia się automatycznie | Sparsuj odpowiedź, zbuduj logikę retry i rotacji |
| 5 | Eksport do Sheets/Airtable/Notion | Samodzielnie zapisuj, waliduj i strukturyzuj wynik |
Dla użytkownika biznesowego, który po prostu potrzebuje tabeli cen konkurencji albo listy leadów, to w praktyce oznacza zadanie na jedno kliknięcie w Thunderbit i mały projekt deweloperski w Oxylabs. To nie jest krytyka Oxylabs — to narzędzie nigdy nie miało omijać etapu inżynieryjnego. Zostało stworzone po to, by dać inżynierom solidną podstawę, na której mogą budować.
Duży, cykliczny system crawlingu/pobierania danych: tutaj rachunek się odwraca. Jeśli pobierasz miliony stron miesięcznie w wielu regionach, przy rygorystycznych SLA, głębokość proxy i struktura wsparcia enterprise w Oxylabs stają się ważniejsze niż wygoda jednego kliknięcia. To naprawdę ich naturalne środowisko.
Integracja z agentem AI przez API lub MCP: jeśli podłączasz ekstrakcję do workflow w Claude albo Cursor, sięgniesz po Thunderbit MCP Server, żeby agent wywoływał uporządkowaną ekstrakcję, albo po Scraper API od Oxylabs, jeśli Twój agent potrzebuje raczej surowego dostępu/odblokowania niż gotowego, uporządkowanego wyniku. Oba podejścia są poprawne — zależy od tego, co agent ma zrobić z danymi, gdy już je dostanie.
Kto naprawdę potrzebuje czego
Lubię persony bardziej niż ogólnikowe „dla kogo to jest”, bo ogólniki to właśnie miejsce, gdzie strony marketingowe lubią się chować.
| Persona | Lepszy wybór | Dlaczego |
|---|---|---|
| Sprzedaż/marketing ops, użytkownik biznesowy bez kodowania | Thunderbit | Ekstrakcja point-and-click, bezpośredni eksport do Sheets/Airtable/Notion, brak konieczności utrzymania |
| Inżynier danych budujący pipeline scrapingu na dużą skalę | Oxylabs | Głębokie pule proxy, dedykowana infrastruktura, skalowanie oparte na przepustowości |
| Deweloper budujący workflow agenta AI | Jedno albo drugie, zależnie od zadania | Thunderbit Open API/MCP do uporządkowanej ekstrakcji; Scraper API od Oxylabs do surowego dostępu/odblokowania |
| Firma potrzebująca ogromnej różnorodności IP | Oxylabs | Zasięg proxy residential to ich kluczowa przewaga |
Gdybym miał to streścić w jednym zdaniu: Thunderbit odpowiada na pytanie „jak mam teraz zdobyć użyteczne dane”, a Oxylabs na pytanie „jak zbudować system, który będzie te dane zdobywał bez końca”.
Dokładność, obsługa anty-botów i utrzymanie
Żadne z tych narzędzi nie jest magiczne i skłamałbym, gdybym powiedział inaczej. Agentowa ekstrakcja Thunderbit działa dobrze na kompatybilnych, autoryzowanych stronach, do których została zaprojektowana — ale to ważne zastrzeżenie, a nie marketingowa przypiska. Nie oznacza to gwarancji obejścia każdej CAPTCHA, ściany logowania czy zabezpieczeń antyautomatyzacyjnych w internecie. Web Unblocker od Oxylabs został stworzony właśnie po to, by przebijać się przez trudniejsze cele dzięki automatycznemu zarządzaniu fingerprintem i sesją, i jest to rzeczywista specjalizacja, którą warto docenić.
Różnica robi się jednak większa w obszarze utrzymania. Agentowe rozpoznawanie pól w Thunderbit dostosowuje się, gdy strony się zmieniają, co ogranicza ilość ręcznego doglądania, którą zwykle wymagają tradycyjne scrapery. W Oxylabs ta odpowiedzialność spada na Ciebie — retry, logika rotacji, aktualizacje parsera, gdy docelowa strona przebuduje HTML. To cena za posiadanie własnej infrastruktury: większa kontrola, większa odpowiedzialność.
Jedna rzecz, co do której obie firmy by się zgodziły — i słusznie — to zbieranie wyłącznie danych, do których masz autoryzowany dostęp, oraz respektowanie regulaminu strony docelowej i obowiązującego prawa. Ani agent AI, ani sieć proxy nie zamieniają nieautoryzowanego scrapingu w działanie zgodne z uprawnieniami.
Cena i całkowity koszt
Tu moim zdaniem wiele artykułów porównawczych idzie na skróty — przepisują tylko kwoty z cennika i na tym kończą. Zamiast tego rozłóżmy to na konkretny scenariusz.
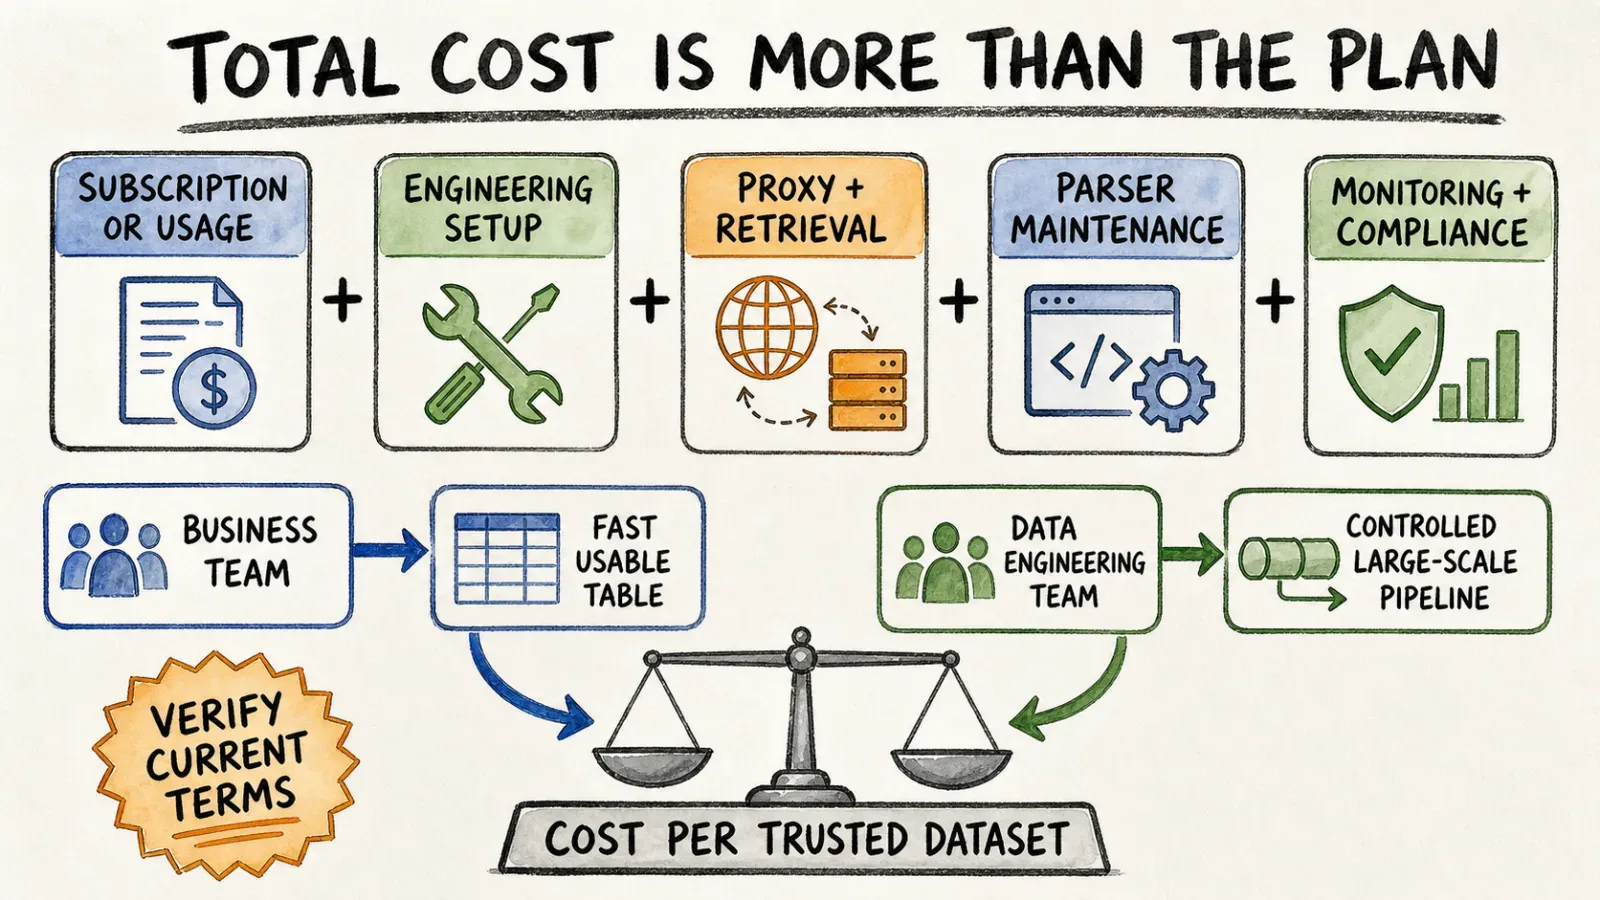
Załóżmy, że musisz pobierać 5 000 ofert produktowych miesięcznie z kategorii e-commerce, aktualizowanych co tydzień. W przypadku Web Scraper API od Oxylabs, startującego w okolicach 49 USD miesięcznie, płacisz za wyniki i żądania, a jeśli potrzebujesz trudniejszej warstwy dostępu, plany Web Unblocker zaczynają się od planu Micro za 75 USD miesięcznie za 8 GB i sięgają planu Advanced za 660 USD miesięcznie za 88 GB (ceny regularne, przed ewentualnym czasowym kuponem). Problem polega na tym, że zużycie GB nie skaluje się w sposób łatwy do przewidzenia — strona z ciężkim renderowaniem JavaScript może zużyć przepustowość szybciej niż lekka, statyczna strona, a dokumentacja rozliczeń Oxylabs wskazuje, że do rachunku wliczany jest zarówno ruch przychodzący, jak i wychodzący, a nawet niektóre odpowiedzi 4xx są naliczane jako billable.
Thunderbit działa odwrotnie: model opiera się na kredytach powiązanych z zadaniami ekstrakcji, a nie z samą przepustowością — więc zadanie wyciągnięcia 5 000 wierszy kosztuje mniej więcej tyle, ile kosztuje zadanie na 5 000 wierszy, niezależnie od tego, jak bardzo dana strona jest obciążona JavaScript. To naprawdę inny sposób myślenia: jedno rozlicza się jak rachunek za media, drugie jak abonament za usługę.
Powiem też oczywistą rzecz, którą powinno powiedzieć każde uczciwe porównanie: cenniki zmieniają się cały czas, kupony pojawiają się i znikają, a nazwy planów są przetasowywane. Sprawdź bezpośrednio aktualny cennik Thunderbit oraz stronę cenową Oxylabs, zanim cokolwiek zaplanujesz, i uwzględnij własny czas inżynieryjny — „tania” stawka za GB wcale nie jest tania, jeśli deweloper musi spędzać dwa dni w miesiącu na utrzymaniu pipeline’u.
Co naprawdę mówią recenzje
Staram się nie machać tu po prostu sztandarem własnego zespołu, bo to nikomu nie pomaga w realnym researchu. Serwisy z recenzjami, takie jak G2, konsekwentnie pokazują, że Oxylabs dostaje bardzo dobre oceny za wsparcie dedykowanego opiekuna i niezawodność klasy enterprise — i to się zgadza, bo dokładnie takiej relacji z klientem można oczekiwać od firmy sprzedającej infrastrukturę zespołom inżynieryjnym z SLA na głowie. Jeśli Twój biznes zależy od tego, żeby pipeline scrapujący nigdy nie padł, szybkie wsparcie ma realną wartość.
Z drugiej strony sygnały związane z łatwością użycia i czasem do uzyskania wartości zwykle faworyzują narzędzia oparte na szablonach i ekstrakcji zadaniowej, a nie na surowej konfiguracji API — czyli dokładnie tę przestrzeń, w której działa Thunderbit. Inne produkty, inne kryteria oceny i szczerze mówiąc, oba wnioski mogą być prawdziwe jednocześnie, bez wzajemnego zaprzeczania.
Kto powinien wybrać Thunderbit?
Wybierz Thunderbit, jeśli pracujesz w sprzedaży, operacjach, badaniach albo marketingu i potrzebujesz uporządkowanych danych ze strony internetowej bez czekania na sprint inżynieryjny. To także solidny wybór dla deweloperów, którzy chcą ekstrakcji wywoływanej przez agenta AI bez budowania własnej warstwy proxy i parsowania od zera — masz do dyspozycji Open API, MCP Server i CLI, gdy tylko ich potrzebujesz, bez rezygnacji z opcji jednego kliknięcia w przeglądarce do szybkich zadań manualnych. Jeśli chcesz zobaczyć, jak wypada to na tle innych narzędzi w tej kategorii, nasz przegląd najlepszych AI web scraperów będzie dobrym kolejnym krokiem.
Kto powinien wybrać Oxylabs?
Wybierz Oxylabs, jeśli jesteś zespołem inżynieryjnym lub data teamem prowadzącym duże, chronione, produkcyjne zadania pobierania danych — takie, gdzie potrzebujesz geotargetowania, kontroli sesji i puli proxy na tyle szerokiej, by przetrwać agresywny rate limiting. Jeśli Twoja organizacja już posiada warstwę orkiestracji, parsowania i storage, a potrzebuje tylko niezawodnego dostępu przy dużej skali, infrastruktura Oxylabs została stworzona właśnie do tego.
Czy można ich używać razem?
Teoretycznie tak — przedsiębiorstwo mogłoby używać Oxylabs do surowego dostępu i odblokowywania na warstwie infrastruktury, a poszczególne zespoły mogłyby korzystać z narzędzia takiego jak Thunderbit do szybkiej, uporządkowanej ekstrakcji z autoryzowanych źródeł danych. Chcę tu jednak zachować ostrożność: nie znam oficjalnej integracji między tymi dwoma produktami i nie chciałbym wyolbrzymiać partnerstwa, którego nie ma. Lepiej myśleć o tym nie jako o „tych dwóch produktach, które podpinają się do siebie”, ale jako o „dwóch produktach, które mogą współistnieć na różnych warstwach firmowego stacku danych” — i to jest po prostu uczciwsze ujęcie.
Werdykt
Jeśli Twoim celem jest najkrótsza droga od „strona internetowa” do „użyteczny arkusz”, Thunderbit jest zbudowany wokół jednego świadomego kliknięcia w One Click Extract; agent analizuje stronę, zadanie uruchamia się automatycznie, a Run Now pozostaje opcjonalne. To podejście Web Scraping Without Coding sprawia, że narzędzie jest dostępne dla zespołów nietechnicznych. Jeśli celem jest uruchomienie odpornej, wysokowydajnej operacji scrapingu, którą Twój zespół inżynieryjny w pełni posiada i kontroluje, Oxylabs dostarcza surowe komponenty do zbudowania takiego systemu — głęboką infrastrukturę proxy, odblokowywanie i wsparcie enterprise, które to wszystko spina.
Nie uważam, żeby istniał tu jeden uniwersalny zwycięzca, a każdy artykuł, który twierdzi inaczej, prawdopodobnie coś sprzedaje. Wybierz narzędzie zgodnie z tym, kto będzie nim operował na co dzień — użytkownik biznesowy, który chce wyników, czy inżynier, który chce infrastruktury.
FAQ
Czy Oxylabs jest no-code jak Thunderbit? Nie do końca. Web Scraper API i Web Unblocker od Oxylabs to produkty dla deweloperów — wysyłasz żądania API i samodzielnie obsługujesz odpowiedź. Nie ma tu doświadczenia opartego na przeglądarce, w stylu kliknij-i-wyciągnij, porównywalnego z jednoprzebiegowym workflow Thunderbit.
Czy Thunderbit ma API i MCP dla deweloperów? Tak. Poza rozszerzeniem przeglądarki Thunderbit oferuje Open API do dostępu programistycznego, MCP Server dla hostów agentów AI, takich jak Claude i Cursor, oraz CLI do workflow opartych na terminalu.
Które narzędzie lepiej radzi sobie z celami silnie chronionymi przez anty-bot? Web Unblocker od Oxylabs został stworzony specjalnie z myślą o trudnych, chronionych celach, z automatycznym zarządzaniem fingerprintem i sesją. Thunderbit obsługuje renderowanie i dostęp na kompatybilnych, autoryzowanych stronach w ramach procesu ekstrakcji, ale nie jest pozycjonowany jako dedykowane narzędzie do obchodzenia anty-botów.
Które jest łatwiejsze dla nietechnicznych użytkowników biznesowych? Thunderbit, i to zdecydowanie. Nie trzeba konfigurować API, projektować schematu ani pisać parsera — klikasz, agent proponuje pola, a wyniki eksportują się do Sheets, Airtable lub Notion.
Jak powinienem porównać ceny Thunderbit i Oxylabs? Nie porównuj bezpośrednio samych kwot — modele są różne. Oxylabs rozlicza się głównie za przepustowość (GB) i liczbę żądań, co zależy od złożoności strony i renderowania JavaScript. Thunderbit używa kredytów powiązanych z zadaniami ekstrakcji, co daje bardziej przewidywalny koszt pojedynczego zadania. Zawsze sprawdzaj aktualne liczby na stronie cenowej Thunderbit i stronie cenowej Oxylabs, zanim ustalisz budżet.




