
Kilka tygodni temu ktoś z naszego zespołu wrzucił na Slacka wiadomość: „czy powinniśmy się martwić Crawl4AI?”. Zaśmiałem się, bo porównywanie Thunderbit do Crawl4AI jest trochę jak porównywanie aplikacji do zamawiania jedzenia z w pełni wyposażoną kuchnią gastronomiczną. Oba pomagają ci dostać obiad. Tyle że jedno z nich zakłada, że potrafisz gotować.
Większość kariery spędziłem wokół automatyzacji — najpierw w Automation Anywhere, obserwując, jak firmy próbują doklejać boty do przestarzałych systemów, a potem w Jet.com, gdzie każda dodatkowa godzina inżynierska poświęcona na „rurę” danych oznaczała godzinę mniej na rozwijanie samego produktu. Dlatego gdy ktoś prosi mnie o porównanie Thunderbit z crawlerem w Pythonie typu open source, nie patrzę na to przez pryzmat „nasze narzędzie jest lepsze”. Patrzę na to z perspektywy: kto faktycznie będzie z tego korzystał i ile ma na to czasu. Przyjrzyjmy się więc temu uczciwie, bo odpowiedź brzmi: to zależy od tego, czy wolisz kliknąć przycisk, czy pisać skrypt.
Krótka odpowiedź
Jeśli chcesz skrót przed wejściem w szczegóły: Thunderbit to zarządzany, agentowy web scraper dla użytkowników biznesowych — otwierasz stronę, klikasz One Click Extract i dostajesz uporządkowaną tabelę. Ma też Open API, MCP Server i CLI dla developerów, którzy chcą podpiąć go do swoich pipeline’ów bez pisania logiki scrapowania od zera.
Crawl4AI to open-source’owy framework w Pythonie dla developerów budujących pipeline’y danych do AI i RAG. To naprawdę mocne narzędzie — głębokie crawlowanie, adaptacyjne crawlowanie, generowanie Markdown, strategie ekstrakcji z LLM — ale piszesz kod, zarządzasz własną infrastrukturą przeglądarki i płacisz za cały compute oraz tokeny LLM po drodze.
Prawdziwy kompromis nie brzmi „dobry vs zły”. To raczej szybkość uzyskania efektu kontra kontrola na poziomie kodu. Żadne z tych narzędzi nie jest „lepsze” z definicji. Po prostu są zbudowane dla różnych osób na różnych etapach stosu technologicznego.
W skrócie
Zanim przejdę punkt po punkcie, oto tabela, którą chciałbym zobaczyć, gdy pierwszy raz porównywałem te dwa rozwiązania. Większość artykułów „X vs Crawl4AI” krążących dziś po sieci dotyczy w rzeczywistości Firecrawl, a nie Thunderbit, więc tę tabelę przygotowałem od podstaw.
| Wymiar | Thunderbit | Crawl4AI |
|---|---|---|
| Model wdrożenia | Rozszerzenie przeglądarki / aplikacja webowa, One Click Extract | Biblioteka Python (pip install), własnoręcznie pisane skrypty |
| Wymaga kodowania | Nie (agentowe wykrywanie pól) | Tak (Python + opcjonalnie klucze LLM do strukturalnej ekstrakcji) |
| Renderowanie JS / dynamicznych stron | Obsługiwane na wspieranych, autoryzowanych stronach | Chromium przez Playwright, konfiguracja ręczna |
| Format wyjściowy | Uporządkowane tabele, eksport do Excel/Sheets/Airtable/Notion | Markdown, JSON (przez własny schemat lub ekstrakcję LLM) |
| PDF / obrazy / dokumenty | Wspierane typy wejściowe (sprawdź aktualną listę w oficjalnej dokumentacji) | Nie jest to główny obszar — najpierw HTML/Markdown |
| Model hostingu | Chmura (Web App) / sesja przeglądarki | Self-hosted (Docker, własna infrastruktura) |
| Idealny użytkownik | Nietechniczne zespoły operacyjne, sprzedaż, badania | Developerzy budujący pipeline’y RAG/LLM |
| Licencja | Komercyjna, subskrypcja / model kredytowy (aktualny cennik) | Apache 2.0 z klauzulą atrybucji |
Mała uwaga, bo inaczej zrobiłbym ci niedźwiedzią przysługę: plany cenowe, limity kredytów i obsługiwane typy wejściowe dość często się zmieniają po obu stronach. Traktuj tę tabelę jak mapę, a nie umowę — przed decyzją zakupową sprawdź aktualną dokumentację.
Czym jest Thunderbit?
Thunderbit powstał u nas z frustracji tym, że osoby nietechniczne — handlowcy, menedżerowie operacyjni, badacze — za każdym razem blokowały się w momencie, gdy potrzebowały danych ze strony internetowej, a odpowiedzią było: „poproś inżyniera”. Obecny proces jest celowo prosty, i to w najlepszym sensie: otwierasz stronę, z której chcesz pobrać dane, klikasz One Click Extract, a agent odczytuje stronę, rozpoznaje sensowne pola i zaczyna pobierać dane. Zobaczysz przycisk Run Now, ale jest opcjonalny — jeśli nic nie klikniesz, ekstrakcja i tak uruchomi się automatycznie.

Na tym właśnie polega idea. Bez selektorów, bez plików ze schematami, bez kroku „zdefiniuj reguły ekstrakcji” jeszcze zanim zobaczysz podgląd. Potem możesz dopracować wynik zwykłym językiem — zmienić nazwę kolumny, poprosić o przetłumaczenie pola, kazać pominąć wiersze bez ceny — a na wspieranych stronach narzędzie przejdzie przez paginację albo otworzy podstrony, żeby wzbogacić zbiór danych.
Thunderbit to nie tylko rozszerzenie do przeglądarki. Jest też Web App do zadań w chmurze, Open API dla developerów, którzy chcą dostępu programowego bez budowania własnego scrapera, MCP Server do podłączenia z Claude, Cursor lub innymi środowiskami agentowymi AI oraz CLI do pracy w terminalu i z agentami kodującymi. Eksport trafia bezpośrednio do Excel, Google Sheets, Airtable lub Notion. To dokładnie taki typ narzędzia, jaki chciałem mieć jeszcze w Jet.com, gdy patrzyłem, jak analitycy co tydzień ręcznie kopiują ceny konkurencji do arkuszy.
Czym jest Crawl4AI?
Crawl4AI to zupełnie inna kategoria narzędzia i chcę uczciwie oddać mu sprawiedliwość, bo to naprawdę dobrze zbudowany open-source’owy projekt — nie tylko scraper, który wrzuca HTML do Markdown. To asynchroniczny crawler w Pythonie, domyślnie oparty na Chromium, a od wydania v0.9.0 z 18 czerwca 2026 projekt wprowadził ważne zmiany bezpieczeństwa w swoim self-hosted Docker API, w tym domyślnie włączone uwierzytelnianie i wiązanie tylko z loopbackiem, chyba że skonfigurujesz inaczej.
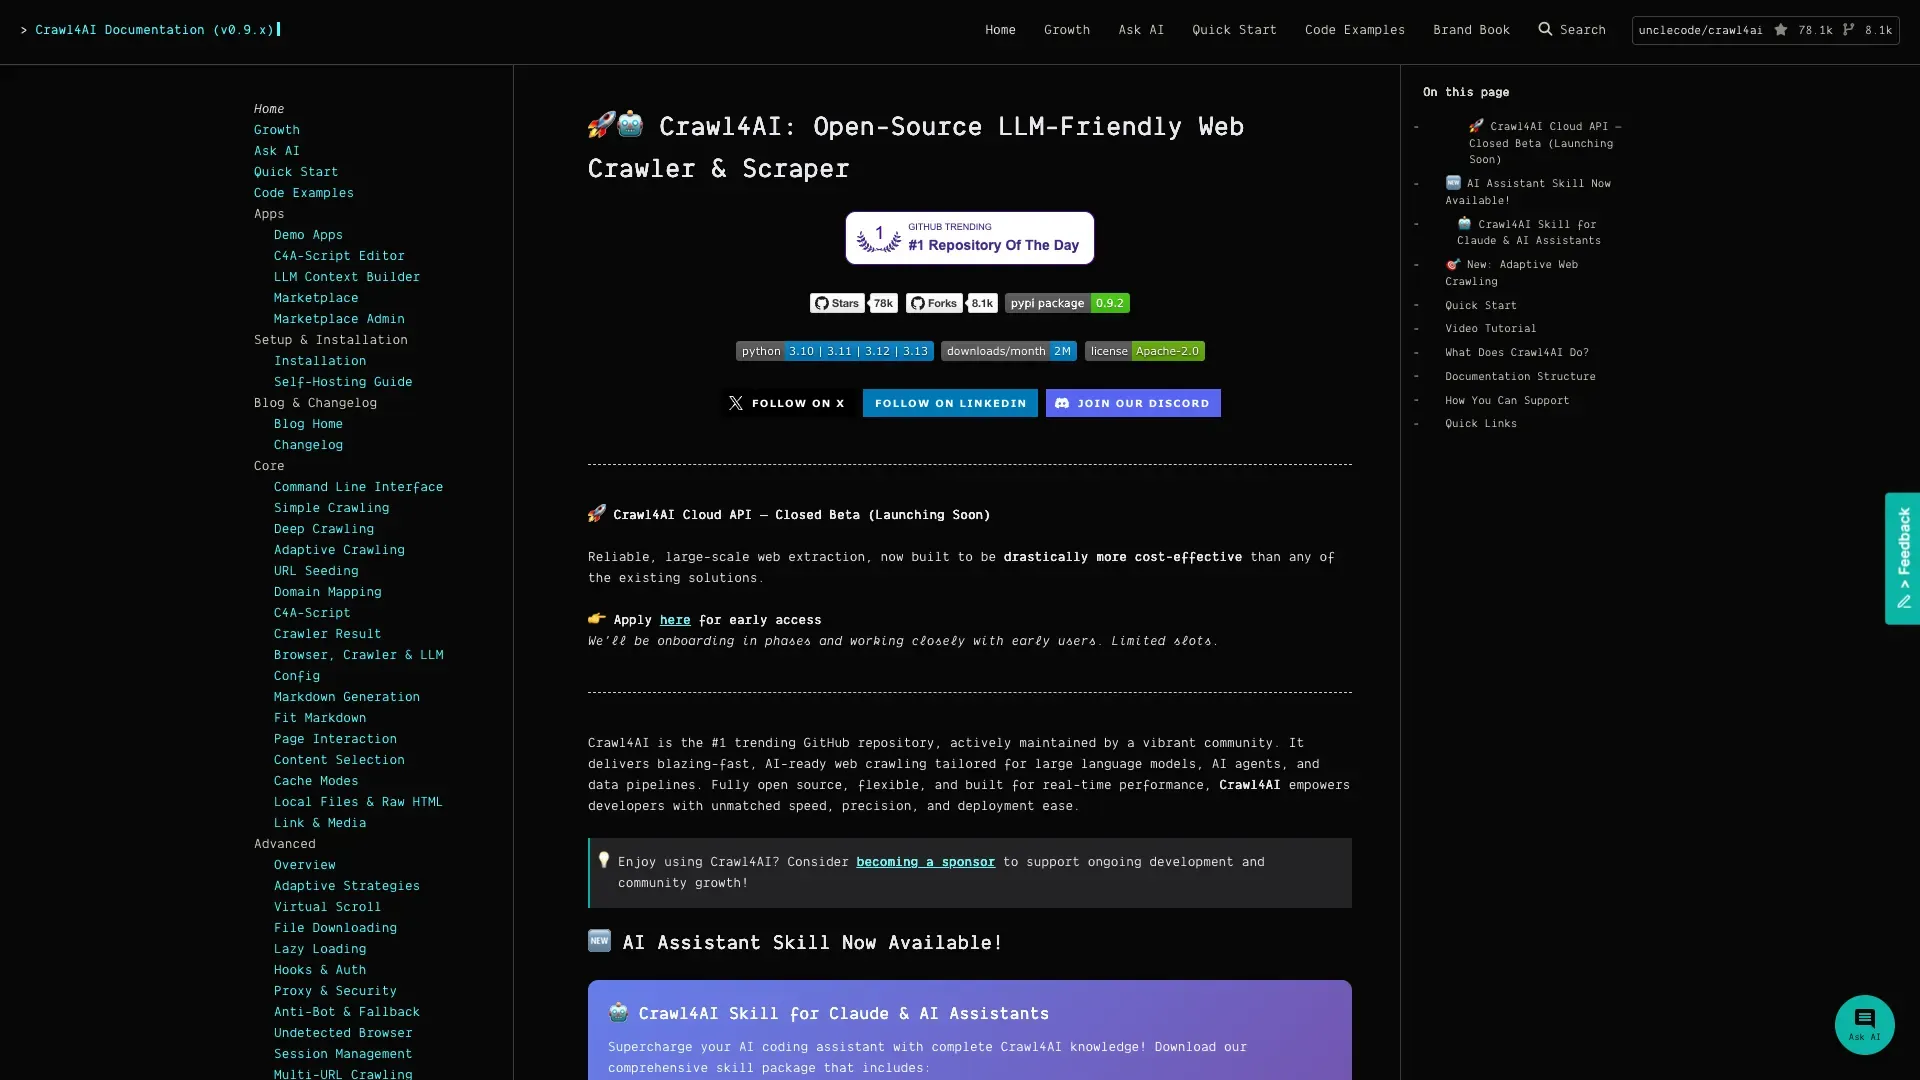
Dokumentacja quickstart pokazuje podstawowy schemat: uruchamiasz AsyncWebCrawler, odpalasz go na URL-u i dostajesz czysty Markdown, albo definiujesz schemat CSS/XPath, albo przekazujesz wszystko do LLMExtractionStrategy, jeśli chcesz, by AI samo rozpoznało strukturę przy użyciu modelu, który sam skonfigurujesz i za który sam zapłacisz.
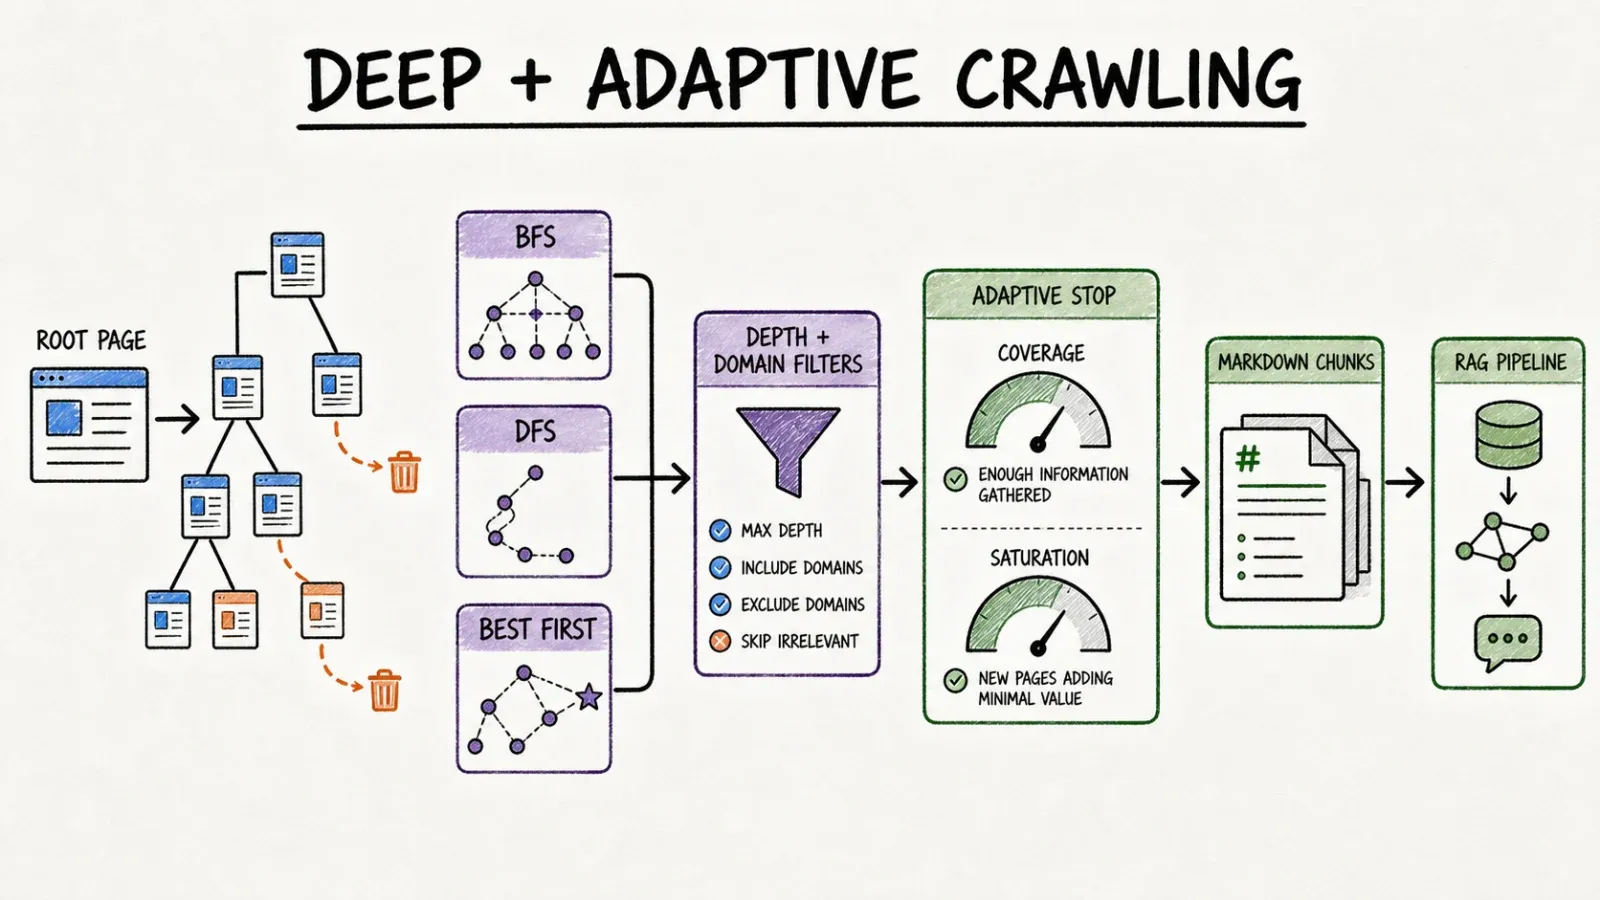
Najbardziej zrobiła na mnie wrażenie logika crawlowania. Jest deep crawling z strategiami BFS, DFS i BestFirst, z limitami głębokości, filtrowaniem domen i scoringiem — naprawdę przydatne, jeśli chcesz zmapować stronę dokumentacji albo duże archiwum treści. Jest też adaptive crawling, sprytna koncepcja: narzędzie samo wybiera, które linki odwiedzić następne, i zatrzymuje się, gdy uzna, że zebrało „wystarczająco” informacji, zamiast crawlowania bez końca. Po stronie kontroli przeglądarki obsługuje ciasteczka, nagłówki, geolokalizację, wirtualny scroll, stan pamięci i nawet przechwytywanie PDF-ów / zrzutów ekranu.
Licencja to Apache 2.0, ale — i to warto naprawdę przeczytać, jeśli jesteś użytkownikiem komercyjnym — w pliku licencji wspomniano o projekto-specyficznej klauzuli atrybucji. „Darmowe i open source” nie zawsze znaczy „bez żadnych haczyków”, więc wolę zaznaczyć to teraz, niż żebyś odkrył to później.
Kluczowa różnica: gotowy produkt agentowy vs framework dla developerów
Czas do pierwszej tabeli
Nie będę udawał, że odpaliłem tu stoper i zrobiłem benchmark, bo wymyślanie konkretnej liczby minut byłoby nieuczciwe, a poza tym trochę bez sensu — prędkość internetu, złożoność strony i tempo twojego wpisywania i tak zniekształcą wynik. Ale różnica w liczbie kroków jest realna i warto ją uczciwie omówić.
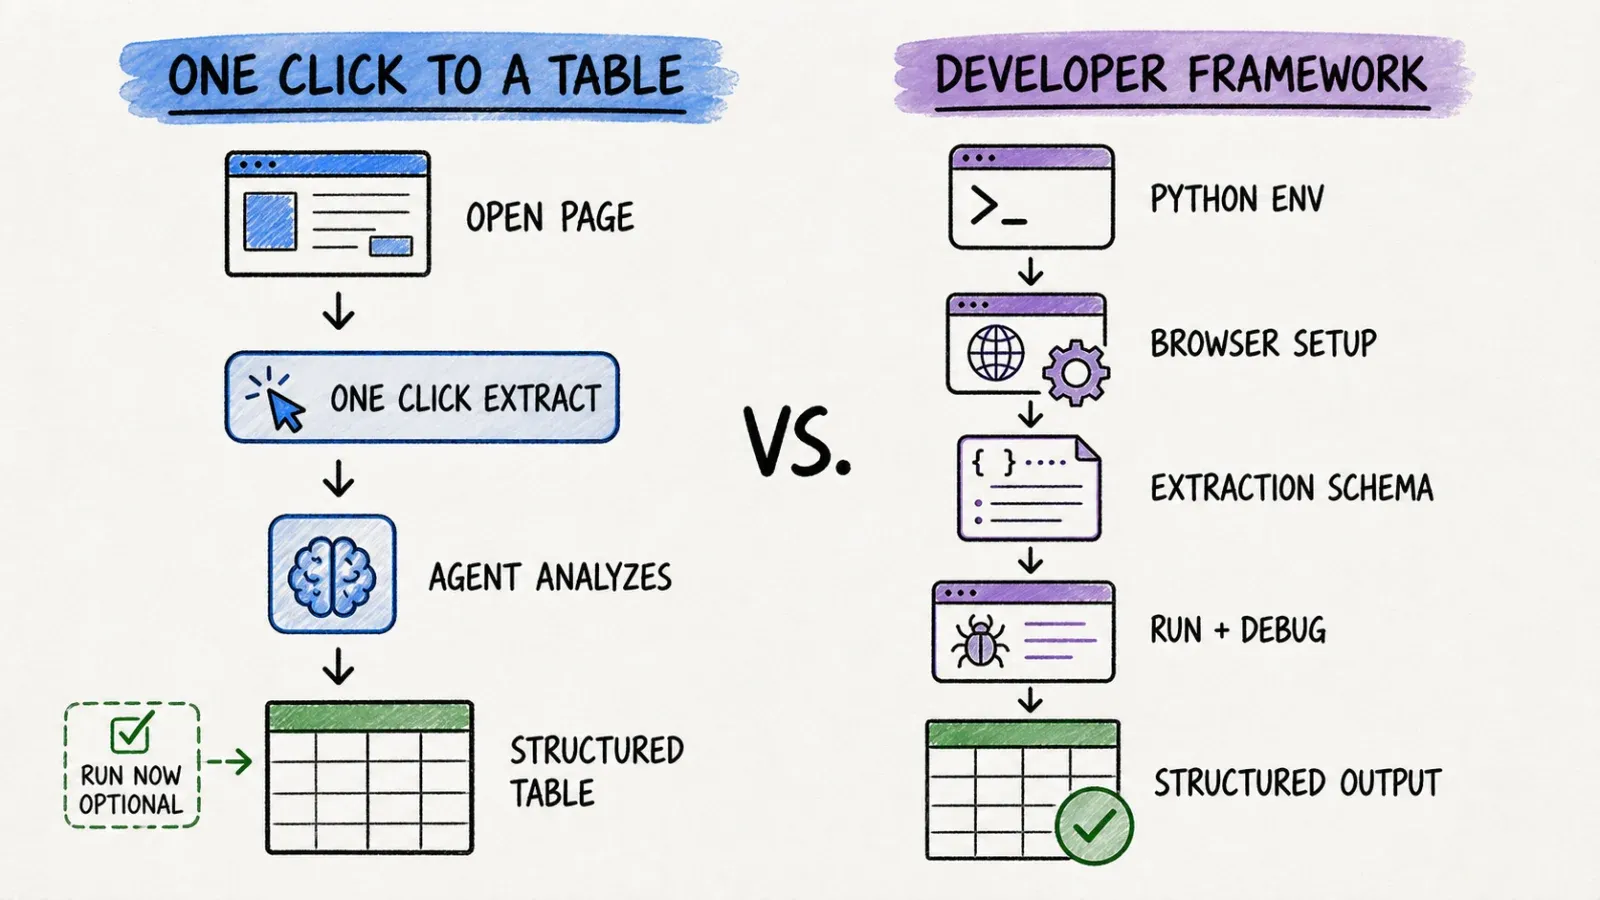
W przypadku Crawl4AI ścieżka wygląda mniej więcej tak: konfigurujesz środowisko Python, instalujesz pip install crawl4ai, uruchamiasz check setup / doctor, konfigurujesz przeglądarkę i zależności Playwright, piszesz schemat ekstrakcji albo podłączasz klucz LLM, uruchamiasz skrypt, a potem debugujesz wynik, gdy coś nie zparsuje się poprawnie (a coś zawsze nie zparsuje się poprawnie za pierwszym razem — takie już jest oprogramowanie).
W przypadku Thunderbit ścieżka wygląda tak: instalujesz rozszerzenie do przeglądarki, otwierasz stronę, klikasz One Click Extract i albo wciskasz Run Now, albo po prostu czekasz, bo startuje automatycznie. Koniec. Jeden świadomy klik, bez kodu.
Jeśli jesteś developerem i już żyjesz w terminalu, ścieżka Crawl4AI nie jest straszna — to zwykły wtorek. Jeśli jesteś kierownikiem sprzedaży i chcesz po prostu listę leadów do lunchu, to jest to ściana.
Kontrola nad logiką crawlowania i ekstrakcji
To właśnie tutaj Crawl4AI naprawdę wychodzi na prowadzenie dla konkretnej grupy użytkowników. Masz pełną kontrolę nad głębokością crawlowania, współbieżnością, logiką retry, cache’em i nad tym, jak dokładnie treść jest dzielona na fragmenty, zanim trafi do LLM albo do wektorowej bazy danych. Jeśli budujesz pipeline RAG i potrzebujesz precyzyjnej kontroli nad segmentacją dokumentów pod embeddingi, taka szczegółowość ma znaczenie — i Thunderbit nie próbuje rywalizować na tym polu.
Płaszczyzna kontroli w Thunderbit jest inna — chodzi o dopracowanie tego, co ma zostać wyciągnięte (jakie pola, w jakim formacie, w jakim języku), a nie o to, jak crawler przechodzi przez sieć na poziomie kodu. Dla ustrukturyzowanych danych biznesowych ten kompromis zwykle działa na twoją korzyść. Dla niestandardowej architektury RAG chcesz już kontroli na poziomie kodu.
Hosting, obserwowalność i odpowiedzialność za utrzymanie
W Crawl4AI to ty odpowiadasz za infrastrukturę. To znaczy, że na tobie spoczywa wdrożenie Dockera, zależności przeglądarki, rotacja proxy, jeśli strony blokują ruch, monitorowanie sytuacji, gdy crawl po cichu wywali się o 2:00 w nocy, oraz aktualizacja skryptów, gdy strona docelowa zmieni układ HTML. W Thunderbit ten ciężar operacyjny leży po naszej stronie — przeglądarka i wykonanie w chmurze, logika czytania strony, utrzymanie silnika ekstrakcji.
Żadne podejście nie jest pozbawione kompromisów. Self-hosting daje audytowalność, możliwość modyfikacji i pełną kontrolę, ale oznacza też, że każda awaria o 2:00 w nocy staje się twoim problemem.
Scenariusze z praktyki
Abstrakcyjne porównania są w porządku, ale łatwiej myśleć o tym przez konkretne przypadki.
Użytkownik biznesowy wyciągający dane z bieżącej strony. Załóżmy, że jesteś badaczem rynku i musisz zebrać dane cenowe z 40 stron produktowych konkurencji do końca dnia. Nie znasz Pythona i dziś nie chcesz się go uczyć. Rozszerzenie Thunderbit daje ci uporządkowaną tabelę bez opuszczania zakładki przeglądarki, w której już jesteś.
Developer budujący pipeline do ingestii RAG. Indeksujesz stronę z dokumentacją techniczną dla wewnętrznego chatbota i potrzebujesz czystych fragmentów Markdown o spójnym formatowaniu do embeddingu. To dokładnie terytorium Crawl4AI — generowanie Markdown i kontrola chunkingu zostały stworzone właśnie do tego.
Głębokie crawlowanie strony dokumentacji. Chcesz zmapować całą bazę wiedzy, setki stron w głąb, z ograniczeniami domeny i scoringiem, żeby nie marnować compute na nieistotne strony. Deep crawling w Crawl4AI jest do tego zbudowane; to nie jest typowy przypadek użycia Thunderbit.
Wywoływanie scrapowania z agenta AI. Masz Claude albo Cursor ustawiony jako agent, który w trakcie pracy musi pobrać ustrukturyzowane dane bez ręcznego klikania. MCP Server Thunderbit podpina się bezpośrednio do takiego środowiska agentowego, a Open API działa też w automatyzacji backendowej.
Dokładność, dynamiczne strony i utrzymanie
Warto rozdzielić dwie rzeczy, które ludzie często wrzucają do jednego worka: inferencję pól (czyli rozpoznanie, które dane na stronie są istotne) oraz kontrolę przeglądarki / crawla (czyli faktyczne renderowanie i nawigację po stronie).
Thunderbit automatyzuje jedno i drugie na wspieranych, autoryzowanych stronach — agent czyta stronę, odgaduje strukturę i ogarnia renderowanie w tle. Crawl4AI automatyzuje renderowanie (przez Chromium/Playwright), ale decyzję o rozpoznaniu struktury zostawia tobie, niezależnie od tego, czy jest to ręcznie napisany selektor CSS, czy wywołanie ekstrakcji LLM, które sam konfigurujesz i za które płacisz.
Żadne narzędzie nie gwarantuje uniwersalnego dostępu. Strony z logowaniem, agresywne systemy anty-botowe i stale zmieniający się markup to trudne problemy dla każdego scrapera — zarządzanego albo self-hosted. Kłamałbym, gdybym powiedział, że Thunderbit działa na dosłownie każdej stronie internetowej — działa dobrze na wspieranych, autoryzowanych stronach i to jest uczciwa deklaracja, a nie marketing. Crawl4AI ma to samo ograniczenie; po prostu zrzuca ciężar radzenia sobie z nim na twój czas inżynierski, a nie na dostawcę.
Cena, licencja i całkowity koszt
To jest sekcja, którą większość artykułów porównawczych pomija, i zawsze mnie to irytuje, bo „darmowe” i „bez kosztu” to nie to samo.
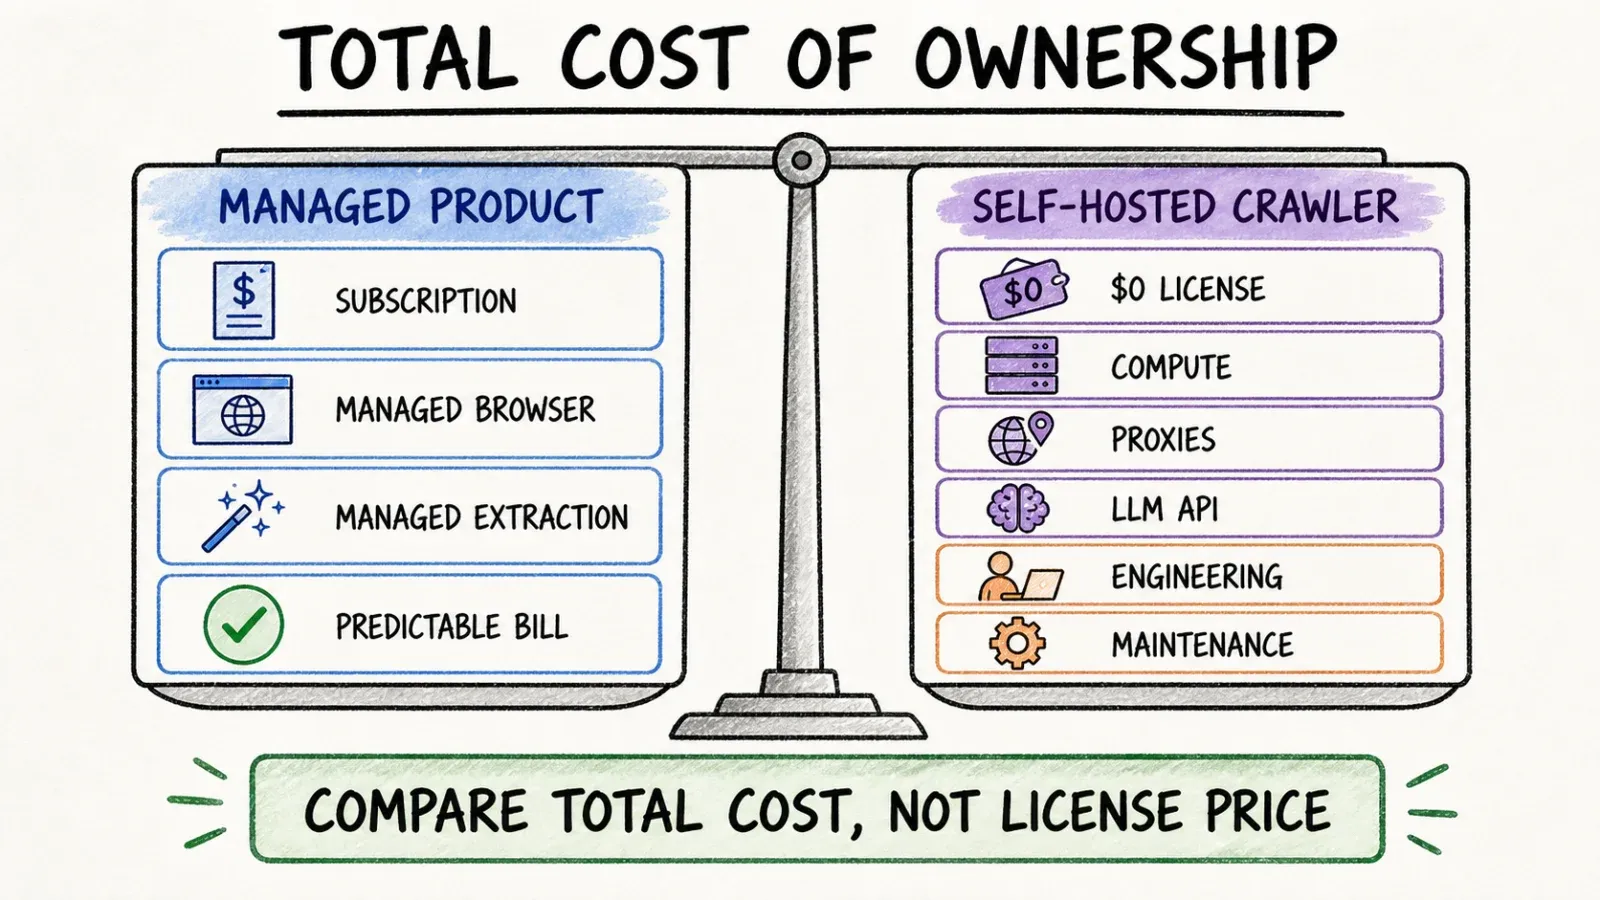
Weźmy realny scenariusz: musisz wyciągać około 3 000 wierszy miesięcznie — leady, ogłoszenia, cokolwiek — i robić to regularnie.
W Crawl4AI sama licencja nic nie kosztuje. Ale nadal płacisz za:
- compute i hosting przeglądarki (serwer lub kontener uruchamiający Chromium)
- koszty proxy, jeśli strony docelowe wymagają rotacji IP
- tokeny API LLM, jeśli używasz
LLMExtractionStrategyz modelem klasy GPT-4o do strukturalnej ekstrakcji - czas inżynierski na napisanie, przetestowanie, wdrożenie i utrzymanie skryptów — oraz naprawianie ich, gdy strona przebuduje layout
Nic z tego nie pojawia się na etykiecie „0 $”, ale wszystko to trafia do twojego realnego miesięcznego wydatku, zwykle ukrytego w rachunku za chmurę, fakturze z API i kalendarzu czyjegoś zespołu.
W Thunderbit płacisz stałą, przewidywalną subskrypcję albo pakiet kredytów — sprawdź aktualną stronę z cennikiem, bo progi faktycznie się zmieniają — i nie musisz osobno zarządzać kluczem LLM, umową na proxy ani wdrożeniem Dockera.
Uczciwe ujęcie nie brzmi „darmowe vs płatne”. Brzmi raczej „ukryty koszt inżynierski vs przewidywalna subskrypcja”. Widziałem wystarczająco dużo zespołów inżynierskich, które po cichu wchłaniają koszty infrastruktury do budżetu na etaty, żeby wiedzieć, że „darmowe oprogramowanie” i „darmowa eksploatacja” to dwa zupełnie różne zdania.
Kto powinien wybrać Thunderbit?
Jeśli jesteś użytkownikiem nietechnicznym albo po prostu masz mało czasu i potrzebujesz szybko danych w uporządkowanej formie — tabel, leadów, ogłoszeń — a potem chcesz je wyeksportować bezpośrednio do Excel, Sheets, Airtable lub Notion, bez dotykania infrastruktury, proxy czy kluczy LLM, Thunderbit jest prostszą drogą. Dotyczy to też zespołów, które chcą realizować workflow pod AI lead generation albo doraźne badania bez angażowania inżynierów za każdym razem.
Kto powinien wybrać Crawl4AI?
Jeśli jesteś developerem budującym pipeline danych do RAG lub LLM, potrzebujesz pełnej kontroli nad logiką crawlowania — crawlowanie równoległe, własne chunkowanie, niestandardowe schematy ekstrakcji — i nie przeszkadza ci self-hosting oraz utrzymanie kodu w Pythonie, Crawl4AI daje ci tę kontrolę w sposób, do którego zarządzany produkt po prostu nie jest projektowany.
Czy zespoły mogą używać obu narzędzi?
Tak, i mówię to zupełnie serio, a nie po to, by nie opowiedzieć się po żadnej stronie. Widziałem ten model w większych firmach: zespół inżynieryjny buduje wyspecjalizowanego crawlera opartego na Crawl4AI do pipeline’u RAG, bo potrzebuje takiego poziomu kontroli nad chunkingiem i przygotowaniem embeddingów, a zespoły sprzedaży, marketingu i badań używają Thunderbit do codziennych próśb typu „potrzebuję tej listy firm do 15:00”, które nie uzasadniają pisania skryptu. Między tymi produktami nie ma oficjalnej integracji i nie będę udawał, że jest — ale taki podział ról ma praktyczny sens sam w sobie.
Werdykt
Moje szczere wrażenie, po latach spędzonych zarówno po stronie „budowania automatyzacji”, jak i „obserwowania ludzi, którzy bez automatyzacji się męczą”, jest takie: wybierz narzędzie według tego, kto będzie wykonywał pracę i jak głęboki jest workload. Jeśli masz inżynierów z czasem na utrzymanie infrastruktury i potrzebujesz głębokiego, adaptacyjnego crawlowania do pipeline’u AI, Crawl4AI jest naprawdę mocną, dobrze utrzymywaną opcją open source. Jeśli potrzebujesz danych ze stron bez uruchamiania środowiska Python — a większość osób pytających „czy powinienem użyć scrapera” należy właśnie do tej grupy — Thunderbit doprowadzi cię do celu szybciej i z mniejszą ilością rzeczy do utrzymania później. Nie ma tu uniwersalnego zwycięzcy, jest tylko lepsze dopasowanie do tego, po której stronie klawiatury siedzisz.
Jeśli chcesz zobaczyć, jak wygląda no-code od tej strony, warto zajrzeć do web scraping bez kodowania albo przejrzeć nasze zestawienie najlepszych AI web scraperów, żeby lepiej zrozumieć, jak te narzędzia wypadają względem siebie.
FAQ
Czy Crawl4AI jest naprawdę darmowy i open source?
Główna biblioteka jest objęta licencją Apache 2.0 z projekto-specyficzną klauzulą atrybucji, a korzystanie z niej nie wiąże się z opłatą subskrypcyjną u dostawcy. Ale „darmowy” dotyczy tylko licencji — nadal zapłacisz za hosting, proxy i ewentualne wywołania API LLM, które skonfigurujesz do ekstrakcji, a także za czas inżynierów potrzebny na zbudowanie i utrzymanie rozwiązania.
Czy Thunderbit wymaga kodu?
Nie. Główny workflow — instalujesz rozszerzenie Chrome, klikasz One Click Extract, sprawdzasz wyniki — nie wymaga programowania. Developerzy, którzy chcą dostępu programowego, mogą korzystać z Open API, MCP Server lub CLI, ale są to opcje dodatkowe, a nie wymagania.
Co jest lepsze do pipeline’ów RAG/LLM?
Crawl4AI zostało stworzone dokładnie pod to — generowanie Markdown, głębokie i adaptacyjne crawlowanie oraz kontrola chunkingu są projektowane z myślą o przygotowaniu danych do RAG. Thunderbit jest budowany pod ustrukturyzowane, eksportowalne dane biznesowe (tabele, leady, ogłoszenia), a nie pod pipeline’y „markdown-first”, więc w dedykowanej architekturze RAG Crawl4AI będzie naturalniejszym wyborem.
Co jest szybsze przy jednorazowej ekstrakcji?
Dla pojedynczej strony albo kilku stron flow Thunderbit z jednym kliknięciem ma mniej kroków między „potrzebuję tych danych” a „mam te dane” — bez konfiguracji środowiska i bez pisania skryptu. Narzut startowy Crawl4AI zwraca się bardziej przy powtarzalnych, dużych albo mocno spersonalizowanych zadaniach crawlowania niż przy szybkich jednorazowych pobraniach.
Czy Thunderbit ma dostęp przez MCP i API?
Tak. Thunderbit oferuje MCP Server dla środowisk agentowych AI, takich jak Claude i Cursor, oraz Open API do backendu i automatyzacji programistycznej, a do tego no-code’owe rozszerzenie przeglądarki i Web App. Jeśli porównujesz także inne alternatywy, narzędzia takie jak Firecrawl, Apify i Bright Data często pojawiają się w tej samej rozmowie, a szerszy obraz znajdziesz w naszym materiale o AI web scraping.




