
Streszczenie wykonawcze
Poprzedni raport stawiał pytanie polityczne: ile z najczęściej odwiedzanych stron na świecie mówi botom AI, co mogą, a czego nie mogą robić?
Ta kontynuacja zadaje związane z tym pytanie operacyjne: jak niezawodny jest robots.txt jako infrastruktura, która ma dziś nieść tę politykę?
Odpowiedź jest niewygodna. robots.txt wciąż działa, bo jest publiczny, tani, czytelny maszynowo i już rozumiany przez crawlery. Jednocześnie oczekuje się od niego znacznie więcej, niż był projektowany do udźwignięcia. W 2026 roku ten sam prosty plik tekstowy może zawierać kontrolę crawl budgetu dla SEO, mapy witryn, starsze rozszerzenia dla wyszukiwarek, rezygnację z trenowania modeli AI, słownictwo polityk wstrzykiwane przez Cloudflare, zastrzeżenia praw autorskich i język prawny na wypadek przyszłych sporów.
To dług techniczny konfiguracji.
Zbiór danych stojący za tym raportem to ten sam crawl Tranco Top 10,000, który wykorzystano w pierwotnym badaniu dotyczącym botów AI. Spośród 10 000 domen 6 638 zwróciło czytelny robots.txt; kolejne 610 zwróciło 404, które zgodnie z protokołem traktuje się jako domyślne zezwolenie. Daje to 7 248 witryn możliwych do analizy pod kątem decyzji o dostępie dla botów oraz 6 638 konkretnych plików do analizy złożoności konfiguracji.
Wyróżnia się sześć wniosków:
-
Większość plików
robots.txtjest mała, ale długi ogon jest ekstremalnie złożony. Mediana pliku to tylko 834 bajty i 31 linii. Ale 1 005 plików ma co najmniej 5 KB, 273 ma co najmniej 20 KB, a 28 ma co najmniej 100 KB. Największy plik w próbie ma 248 KB. -
Setki czołowych witryn prowadzą pliki bliższe produkcyjnej konfiguracji niż notatkom o polityce. Mediana pliku ma 9 dyrektyw
Disallow. Ale 707 witryn ma co najmniej 100 regułDisallow, 13 ma ich co najmniej 1 000, 240 wymienia co najmniej 50 agentów użytkownika, a 110 wymienia co najmniej 100 agentów użytkownika. -
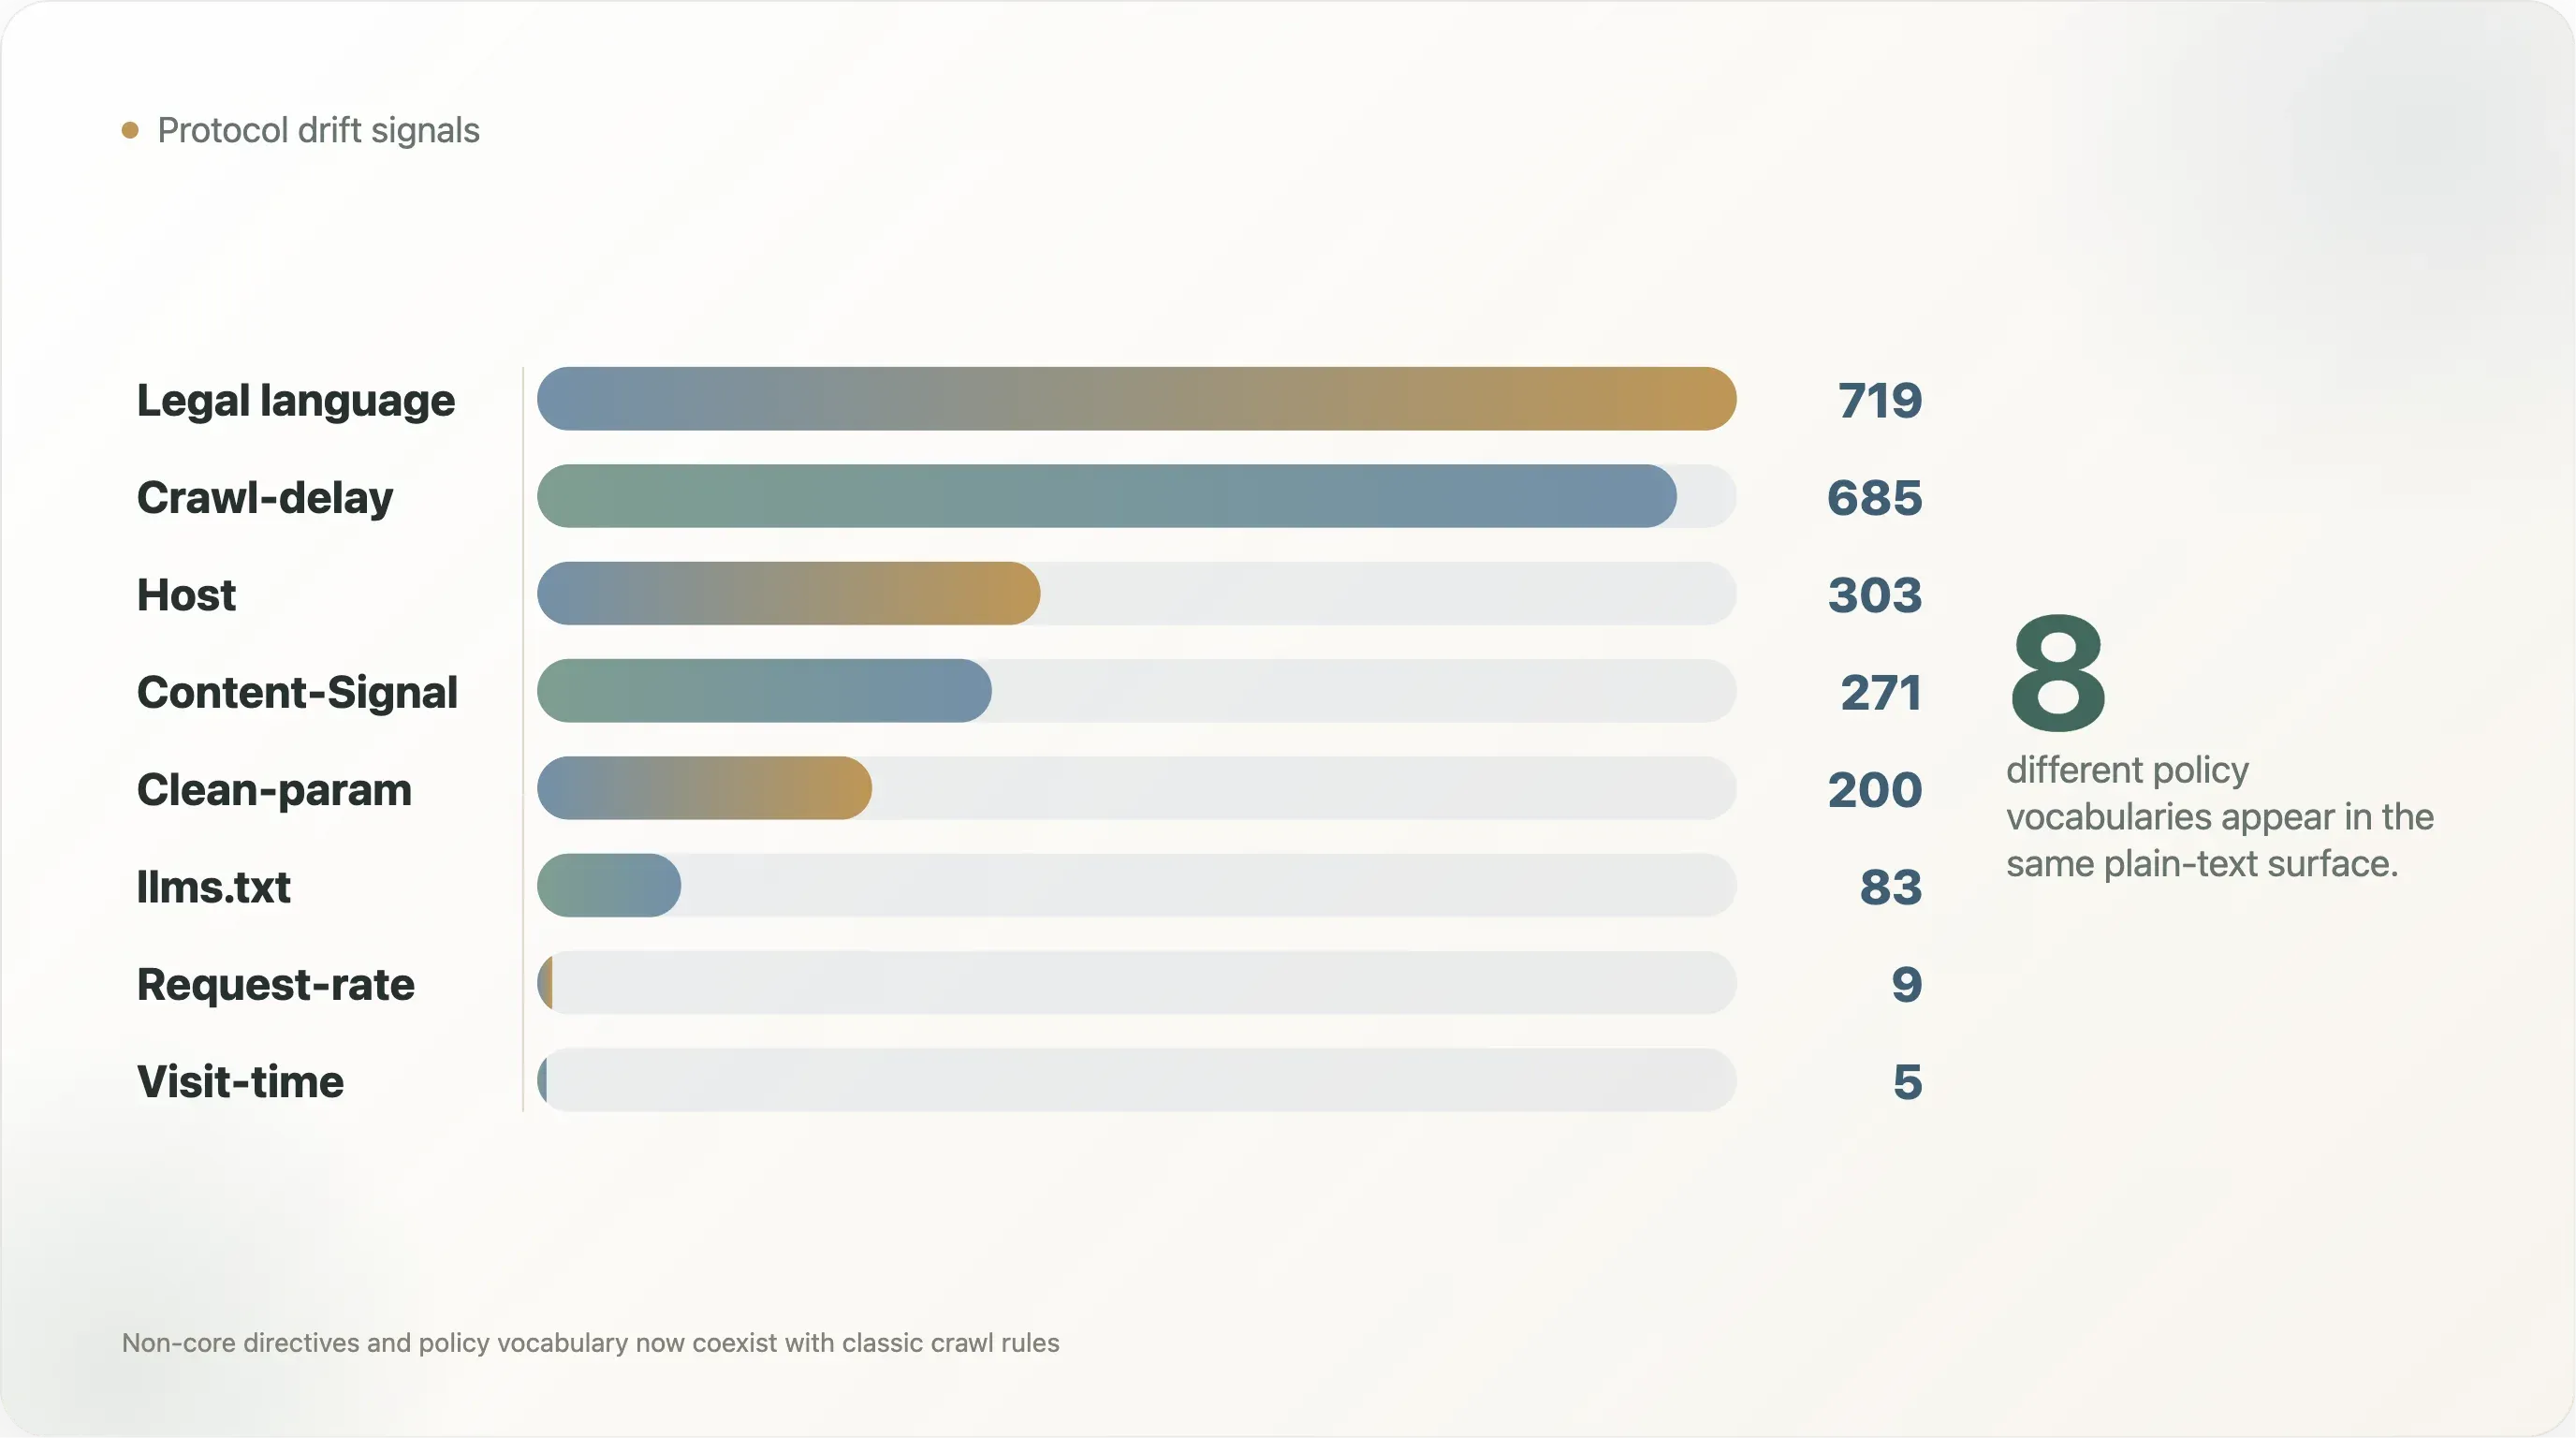
Dryf protokołu nie jest teoretyczny. Wśród 6 638 czytelnych plików 685 zawiera
Crawl-delay, 303 zawieraHost, 200 zawieraClean-param, 9 zawieraRequest-rate, 5 zawieraVisit-time, a 271 zawiera język typuContent-Signalw stylu Cloudflare. Nie wszystko należy do jednego czystego standardu. To nagromadzony folklor crawlerów. -
Googlebot jest traktowany jak obywatel specjalnej kategorii. 562 analizowane domeny blokują co najmniej jednego tradycyjnego crawlera wyszukiwarki. W 404 z tych przypadków Googlebot jest dozwolony, podczas gdy co najmniej jeden inny crawler wyszukiwarki jest zablokowany. Dyskryminacja botów AI nie pojawiła się w neutralnym ekosystemie;
robots.txtjuż wcześniej kodował hierarchię wyszukiwarek. -
Polityka AI uwidacznia ten dług. 1 377 czytelnych plików zawiera język polityki AI; 719 zawiera język dotyczący praw autorskich, warunków, licencji lub zezwoleń; a 501 zawiera oba. Plik stał się jednocześnie interfejsem maszynowym i artefaktem prawnym. To użyteczne, ale kruche.
-
Najbardziej ryzykowne pliki nie zawsze są najbardziej anty-AI. E-commerce, podróże, social media, finanse, akademia i newsy tworzą złożone pliki z różnych powodów: kontrola crawl budgetu, stare ścieżki, treści tworzone przez użytkowników, zastrzeżenia praw i wyjątki dla konkretnych botów. Reguły AI są dokładane do już chaotycznej bazy.
Główny wniosek: robots.txt pozostaje najważniejszą publiczną powierzchnią polityki crawlerów w sieci, ale jest słabym fundamentem dla wysokostawkowego governance AI, chyba że ekosystem ustandaryzuje tożsamość crawlerów, słownictwo użycia AI i audytowalność polityk.
Metodologia
Raport korzysta ponownie ze zbioru danych z oryginalnej analizy Thunderbit dotyczącej polityki botów AI na domenach Tranco Top 10,000.
Materiały wejściowe obejmowały:
tranco_top10k.csv— oryginalna lista 10 tys. domen Tranco.out/fetch_meta.csv— status pobrania, liczba bajtów, schemat, wynik przekierowania i metadane błędów.out/sites.csv— domena, pozycja w rankingu, kategoria, język i statusrobots.txt.out/site_meta.csv— jeden wiersz analityczny na witrynę, w tym klasa szablonu, flagi blokowania AI, rozmiar pliku i pola podsumowania polityki botów.out/bot_status.csv— jeden wiersz na domenę i crawlera, w tym informacja, czy dany bot jest blokowany i czy istnieje konkretna reguła.raw_robots/— buforowane treścirobots.txtdla 6 638 witryn, które zwróciły status200.
Na potrzeby tej kontynuacji każdy czytelny plik robots.txt został przeanalizowany pod kątem:
- rozmiaru pliku i liczby linii;
- aktywnych linii niebędących komentarzami;
- liczby dyrektyw
User-agent,Disallow,AllowiSitemap; - starszych lub niepodstawowych dyrektyw, takich jak
Crawl-delay,Host,Clean-param,Request-rateiVisit-time; - słownictwa epoki AI, w tym
Content-Signal,llms.txt, AI, LLM, machine learning, TDM oraz2019/790; - słownictwa prawnego, takiego jak copyright, terms of service, licensing, permission oraz język zastrzegający prawa;
- traktowania crawlerów wyszukiwarkowych: Googlebot, Bingbot, DuckDuckBot, Slurp, Baiduspider i YandexBot.
Raport definiuje też prosty wskaźnik długu konfiguracji do triage. Łączy on rozmiar pliku, liczbę agentów użytkownika, liczbę Disallow, liczbę Allow, liczbę niestandardowych dyrektyw oraz mieszankę języka polityk AI i języka prawnego. Wskaźnik nie ma być uniwersalną miarą poprawności. Ma wskazywać pliki, które prawdopodobnie będą trudne do utrzymania, przeglądu lub interpretacji.
Wszystkie tabele i wykresy pochodne znajdują się w folderze dostawy.
Wniosek 1: Mediana jest prosta; ogon już nie
Typowy plik robots.txt w czołowej części sieci nadal jest niewielki.
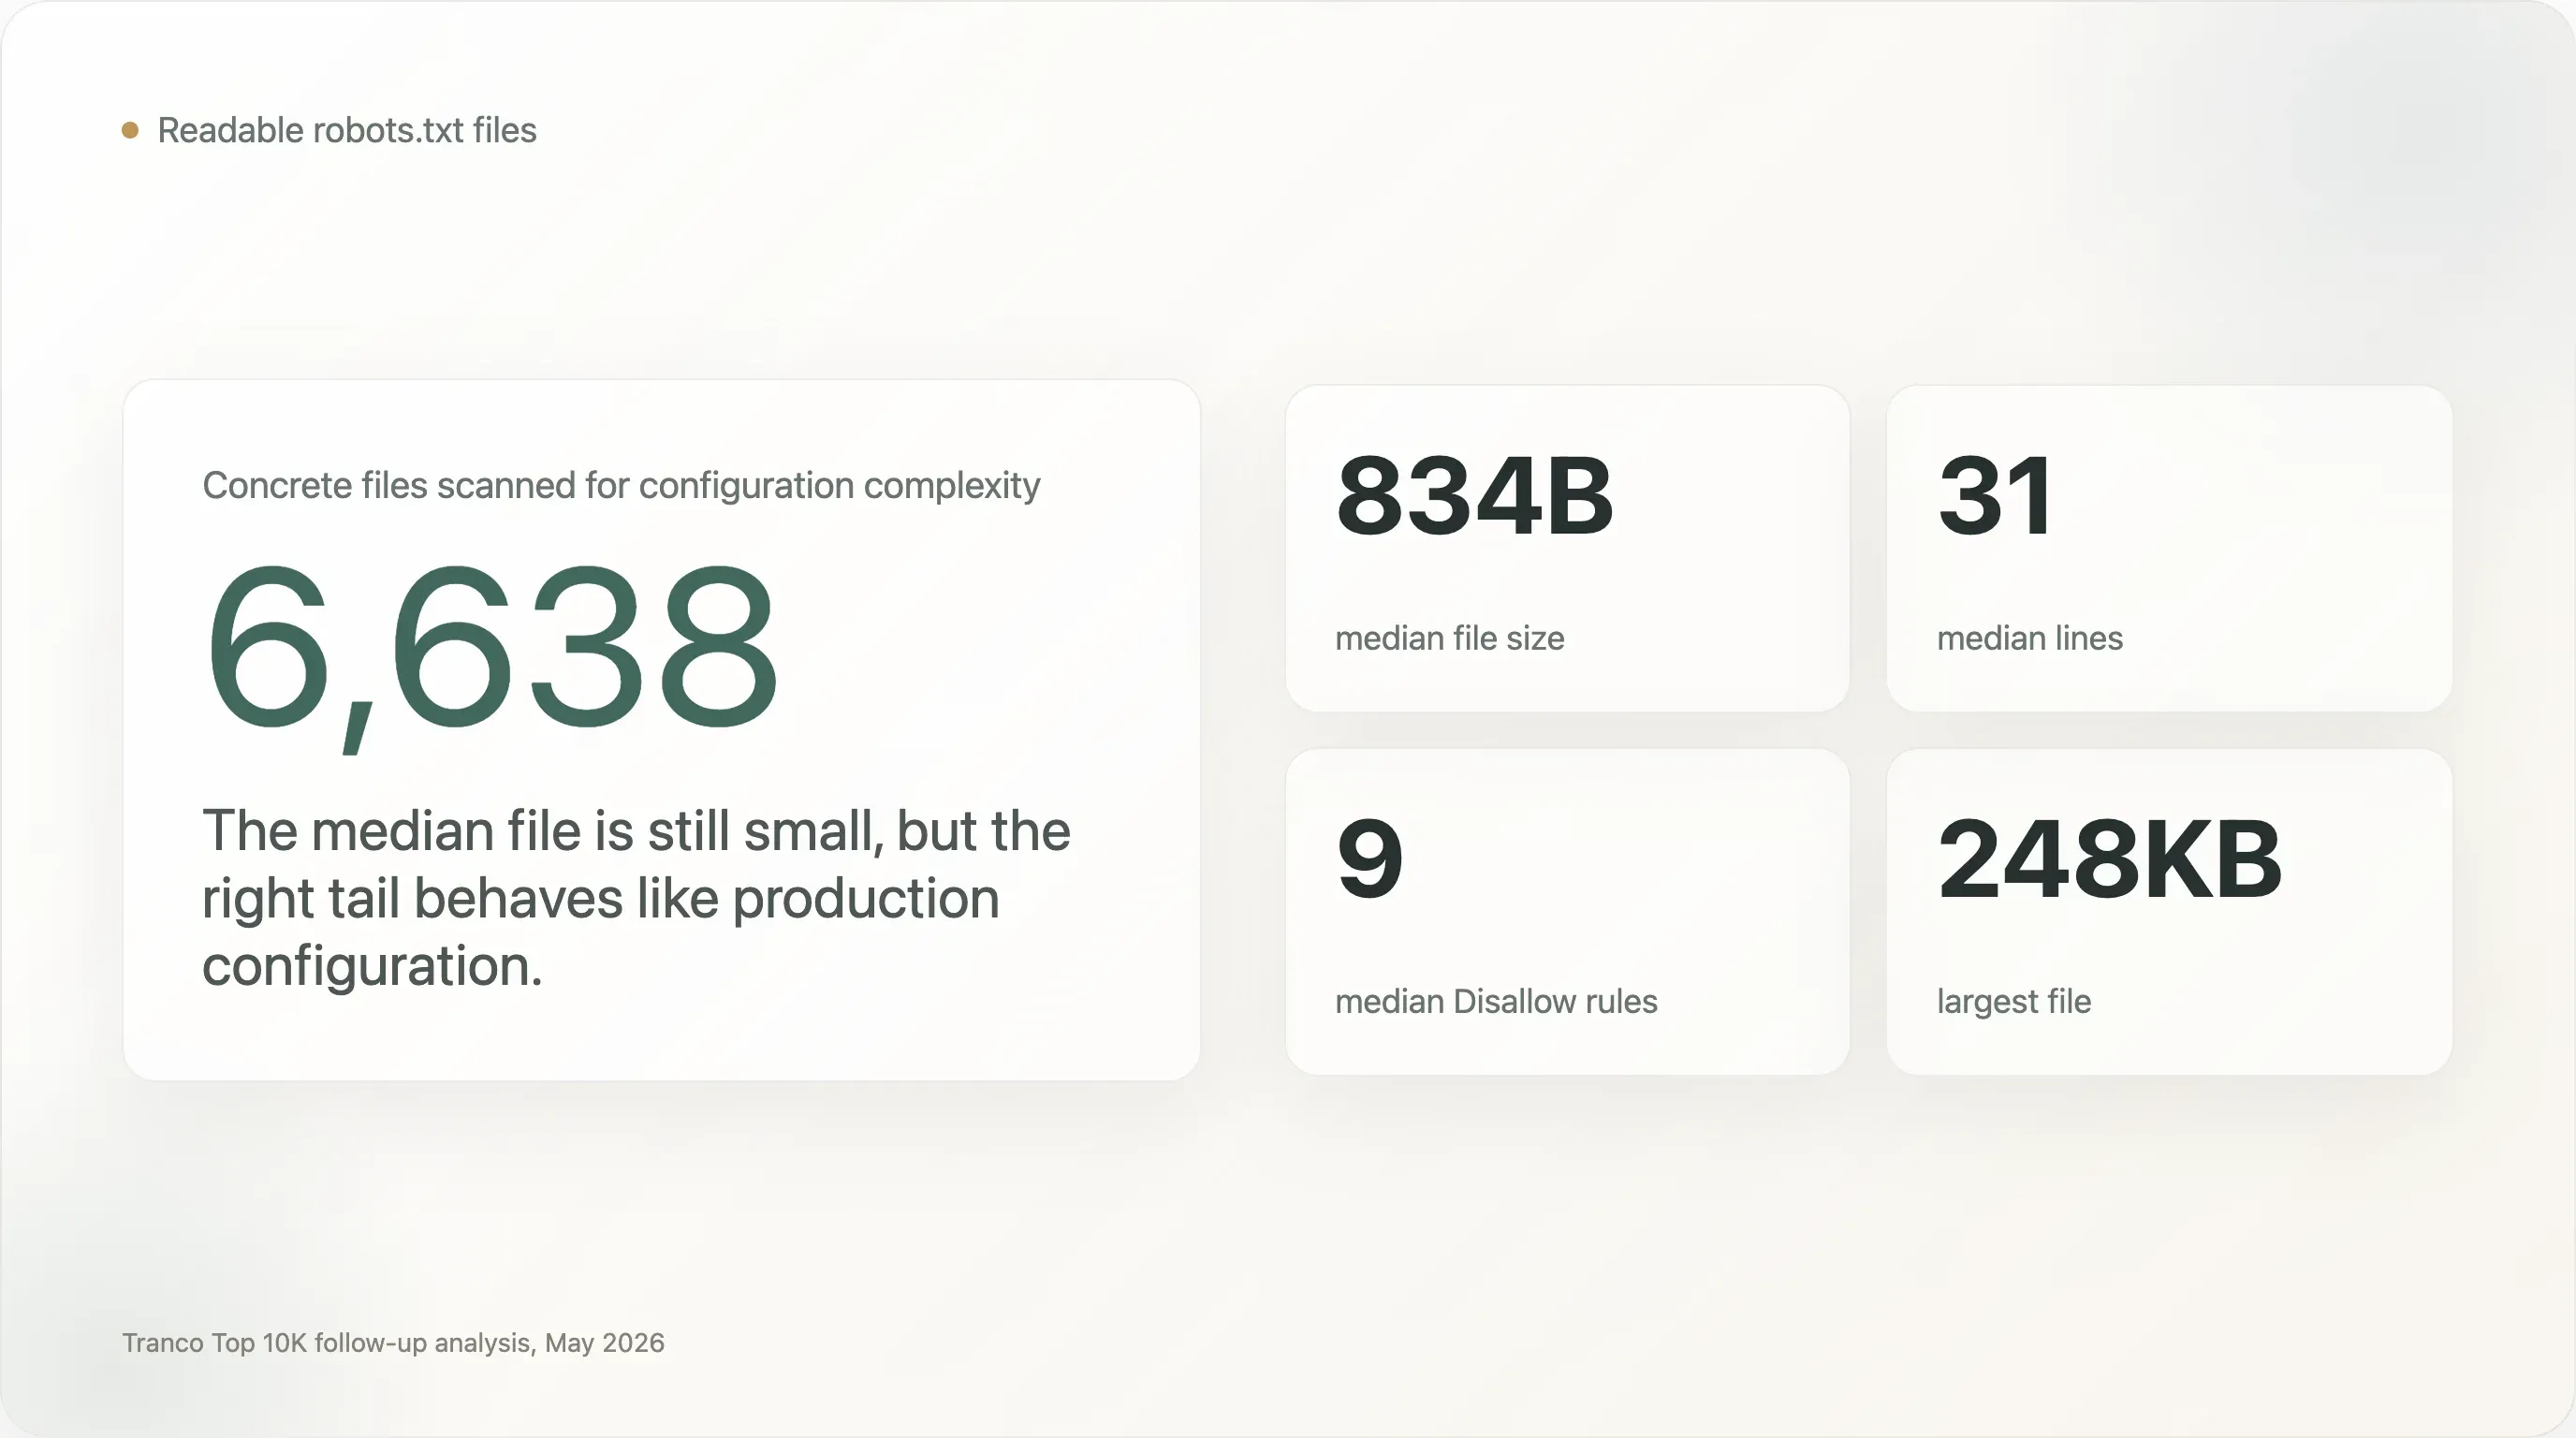
Wśród 6 638 czytelnych plików:
| Metryka | Mediana | P90 | P95 | P99 | Maks. |
|---|---|---|---|---|---|
| Rozmiar pliku | 834 bajty | 6,7 KB | 15,8 KB | 76,0 KB | 248,3 KB |
| Linie | 31 | 238 | 332 | 1 008 | 4 998 |
| Aktywne linie | 23 | 198 | 282 | 837 | 4 998 |
Dyrektywy User-agent | 1 | 21 | 39 | 137 | 823 |
Dyrektywy Disallow | 9 | 103 | 176 | 422 | 4 997 |
Dyrektywy Allow | 1 | 17 | 33 | 69 | 890 |
To rozkład istotny, bo o robots.txt często mówi się tak, jakby był krótkim oświadczeniem:
User-agent: *
Disallow: /private/
Ten sposób myślenia jest błędny w przypadku znaczącej mniejszości ruchliwych witryn.
W tym zbiorze danych:
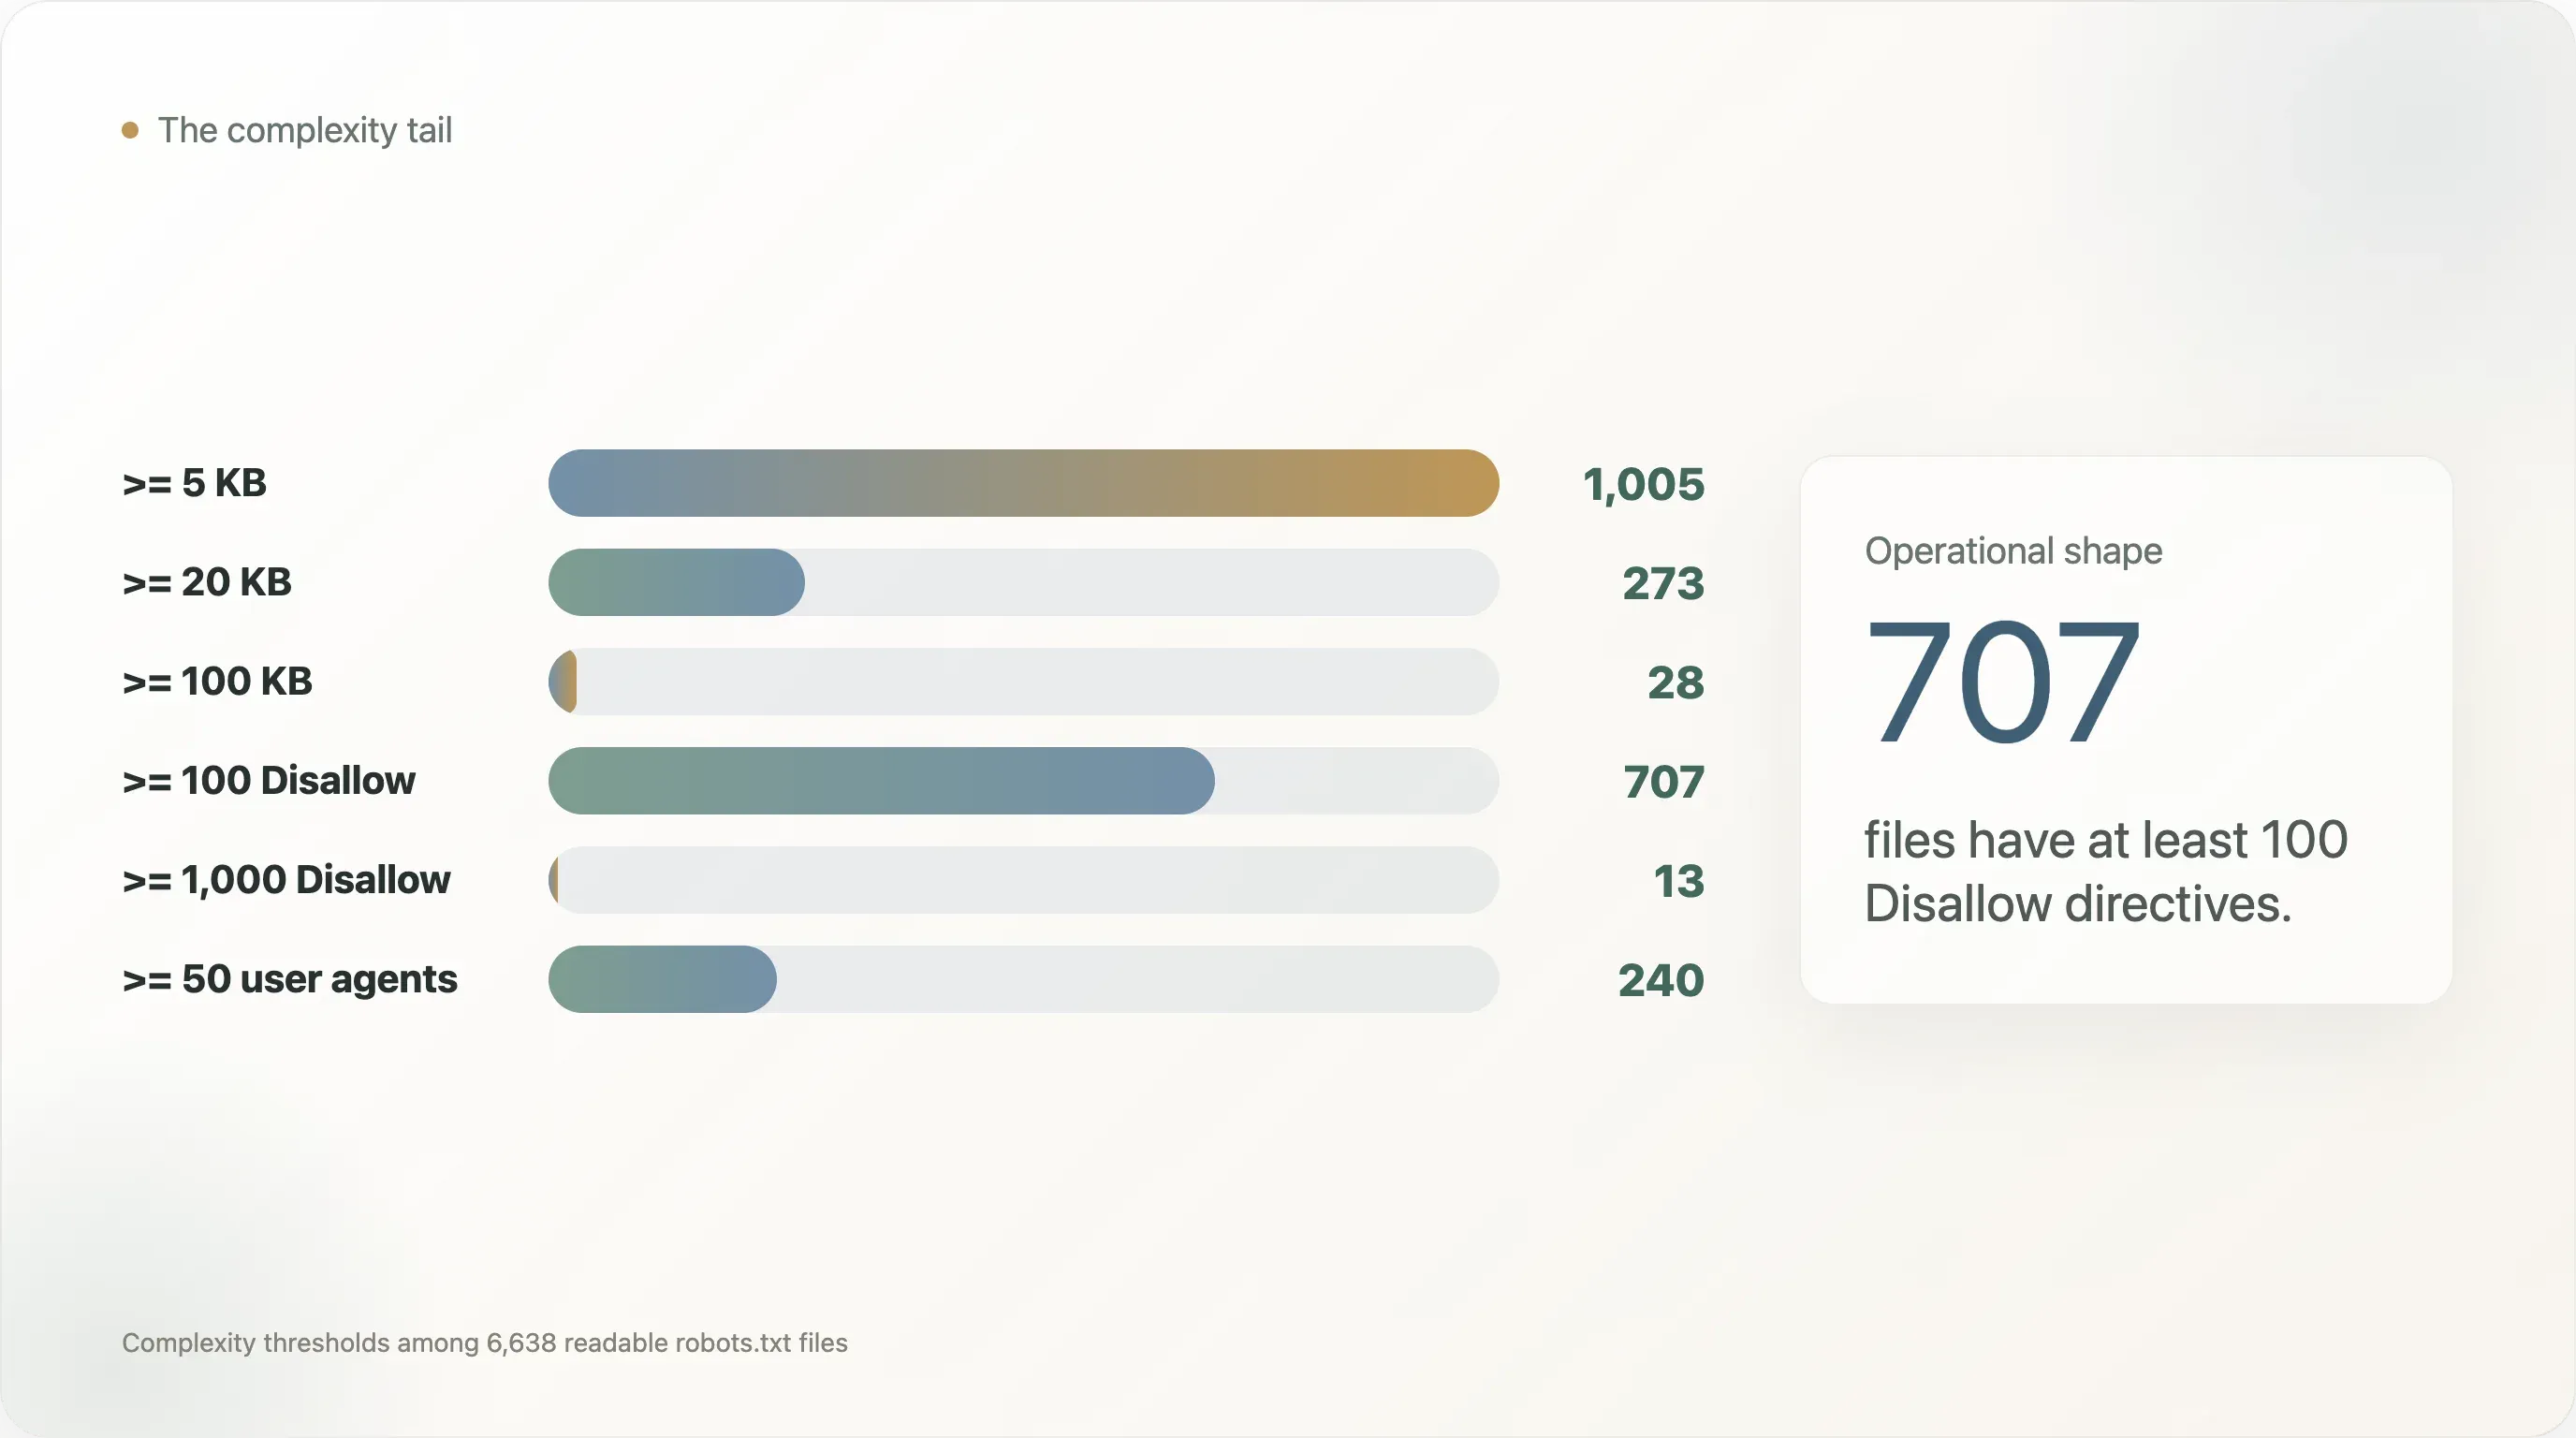
| Próg złożoności | Witryny |
|---|---|
robots.txt większy lub równy 5 KB | 1 005 |
| Większy lub równy 20 KB | 273 |
| Większy lub równy 100 KB | 28 |
Co najmniej 50 dyrektyw User-agent | 240 |
Co najmniej 100 dyrektyw User-agent | 110 |
Co najmniej 100 dyrektyw Disallow | 707 |
Co najmniej 1 000 dyrektyw Disallow | 13 |
Co najmniej 100 dyrektyw Allow | 40 |
Największe i najbardziej złożone pliki nie są akademicką ciekawostką. Należą do realnych, wysoko ruchliwych serwisów:
| Domena | Pozycja | Kategoria | Bajty | User-agent | Disallow | Allow |
|---|---|---|---|---|---|---|
linkedin.com | 17 | social | 114 341 | 76 | 4 184 | 281 |
runescape.com | 5 226 | unknown | 113 393 | 1 | 4 997 | 0 |
academia.edu | 832 | academia | 57 384 | 63 | 2 044 | 227 |
etsy.com | 286 | ecommerce | 51 320 | 3 | 1 621 | 120 |
thepaper.cn | 9 395 | news | 56 867 | 1 | 1 496 | 0 |
opentable.com | 4 137 | unknown | 70 494 | 32 | 1 683 | 176 |
alfabank.ru | 2 625 | finance | 73 158 | 2 | 1 566 | 133 |
Te pliki są bliższe produkcyjnym tabelom routingu niż hasłom politycznym. Kodują lata premier produktów, stare ścieżki, zablokowane wzorce parametrów, wyjątki dla crawlerów, eksperymenty SEO, decyzje CDN i teraz także reguły dla botów AI.
Ogon nie jest wyłącznie historią AI. Spośród 273 plików o rozmiarze co najmniej 20 KB, 131 zawiera język polityki AI, a 142 nie. Spośród 707 plików z co najmniej 100 dyrektywami Disallow tylko 207 zawiera język polityki AI. Innymi słowy: AI nie stworzyła problemu dużych plików. Pojawiła się po latach zwykłych operacji webowych, które już wcześniej wypełniły plik regułami ścieżek, odwołaniami do map witryn i wyjątkami dla crawlerów.
To ważne, bo łatwość utrzymania zależy od kształtu, a nie tylko od intencji. Mały plik z prostym blokiem dla AI może być łatwy do audytu. Plik e-commerce lub travel o rozmiarze 70 KB może być trudny do audytu nawet wtedy, gdy nie wspomina o AI. Ryzyko nie polega na tym, że każdy duży plik jest zły. Ryzyko polega na tym, że rzeczywista polityka staje się zbyt trudna do zweryfikowania przez osoby za nią odpowiedzialne.
Ryzyko operacyjne jest proste: im większy robots.txt, tym trudniej wydawcy, inżynierowi platformy, prawnikowi czy liderowi SEO odpowiedzieć na podstawowe pytanie: na co ten plik właściwie pozwala?
To pytanie nie jest już trywialne. Przy parsowaniu w stylu RFC crawler może dopasować bardziej szczegółową grupę User-agent zamiast User-agent: *; dłuższe dopasowania ścieżek mogą nadpisywać krótsze; dyrektywy Allow i Disallow działają według priorytetów; a ogólne reguły odmowy mogą przypadkowo objąć nowe crawlery, które nie istniały, gdy plik był tworzony.
W pliku o 30 liniach człowiek może to ogarnąć. W pliku o 4 000 liniach z dziesiątkami nazwanych botów — nikt nie powinien.
Wniosek 2: robots.txt niesie więcej niż reguły crawl
Debata o botach AI uczyniła robots.txt politycznie widocznym, ale sam plik już wcześniej gromadził niepowiązane obowiązki.
Nowoczesny robots.txt na czołowej witrynie może zawierać:
- kontrolę ścieżek dla crawlerów;
- wykrywanie map witryn;
- rozszerzenia specyficzne dla wyszukiwarek;
- wskazówki dotyczące tempa crawl;
- wskazówki dotyczące kanoniczności hosta;
- wskazówki dotyczące czyszczenia parametrów URL;
- słownictwo polityk wstrzykiwane przez CDN;
- tekst zastrzeżenia praw autorskich;
- rezygnację z trenowania modeli AI;
- komentarze prawne czytelne dla ludzi.
Zbiór danych pokazuje to warstwowanie bardzo wyraźnie.
| Sygnał | Pliki | Udział czytelnych plików |
|---|---|---|
Crawl-delay | 685 | 10,3% |
Host | 303 | 4,6% |
Clean-param | 200 | 3,0% |
Content-Signal | 271 | 4,1% |
Request-rate | 9 | 0,1% |
Visit-time | 5 | 0,1% |
Wzmianka o llms.txt | 83 | 1,3% |
| Język o prawach autorskich, warunkach, licencjonowaniu lub zezwoleniach | 719 | 10,8% |
| Język polityki AI | 1 377 | 20,7% |
Niektóre z tych dyrektyw są dobrze rozpoznawane przez konkretne crawlery. Niektóre to starsze konwencje. Niektóre są specyficzne dla dostawcy. Niektóre w ogóle nie są dyrektywami crawlera, lecz komentarzami prawnymi lub produktowymi osadzonymi w komentarzach.
Tak wygląda dryf protokołu.
Crawl-delay to dobry przykład. Wielu operatorów stron zna tę dyrektywę, ale obsługa po stronie głównych crawlerów jest nierówna. Host i Clean-param były historycznie kojarzone z zachowaniem Yandexa. Content-Signal jest częścią słownictwa polityki Cloudflare z epoki AI. llms.txt to proponowany sąsiedni format odkrywania, a nie powszechnie respektowany standard. Mimo to wszystko to pojawia się w tym samym typie pliku, często obok klasycznych reguł User-agent i Disallow.
Liczby pokazują też, jak stare i nowe konwencje współistnieją. Crawl-delay pojawia się w 685 plikach, czyli ponad dwa razy częściej niż Content-Signal, który występuje w 271. Host pojawia się w 303 plikach, a Clean-param w 200, głównie odzwierciedlając konwencje z ery wyszukiwarek. llms.txt, mimo intensywnej dyskusji w środowisku AI search, jest wzmiankowany tylko w 83 czytelnych plikach. Żywa sieć nie zbiega się ku jednemu słownictwu. Ona je nakłada.
Problem nie polega na tym, że każde rozszerzenie jest błędne. Problem polega na tym, że plik stał się nieversionowanym kontenerem dla kilku nakładających się systemów zarządzania.
To tworzy trzy rodzaje długu:
- Dług semantyczny. Różne crawlery mogą interpretować ten sam plik inaczej.
- Dług własności. Zespoły SEO, prawne, infrastrukturalne, bezpieczeństwa i produktowe mogą mieć powody, by edytować plik, ale żaden pojedynczy zespół może nie być właścicielem całej polityki.
- Dług audytowy. Witryna może publikować politykę wyglądającą na zamierzoną, podczas gdy tylko parser potrafi ustalić jej faktyczne działanie.
AI sprawia, że to jest ważniejsze, bo zmieniła się stawka. Gdy starsza wskazówka dotycząca tempa crawl jest ignorowana, skutkiem może być dodatkowy ruch. Gdy rezygnacja z trenowania modeli AI jest niejednoznaczna, skutkiem może być dowód w sporze o prawa autorskie lub licencję.
Wniosek 3: Plik stał się jednocześnie interfejsem maszynowym i artefaktem prawnym
Oryginalny raport o botach AI pokazał, że 17,0% analizowanych witryn miało zapisane wyraźne reguły specyficzne dla AI. Ta kontynuacja patrzy na obciążenie tekstowe, jakie te polityki dodają.
Wśród 6 638 czytelnych plików robots.txt:
- 1 377 zawiera język polityki AI;
- 719 zawiera język związany z prawami autorskimi, warunkami, licencją, prawami lub zezwoleniem;
- 271 zawiera
Content-Signal; - 83 wspomina
llms.txt.
Najciekawsza jest nakładka:
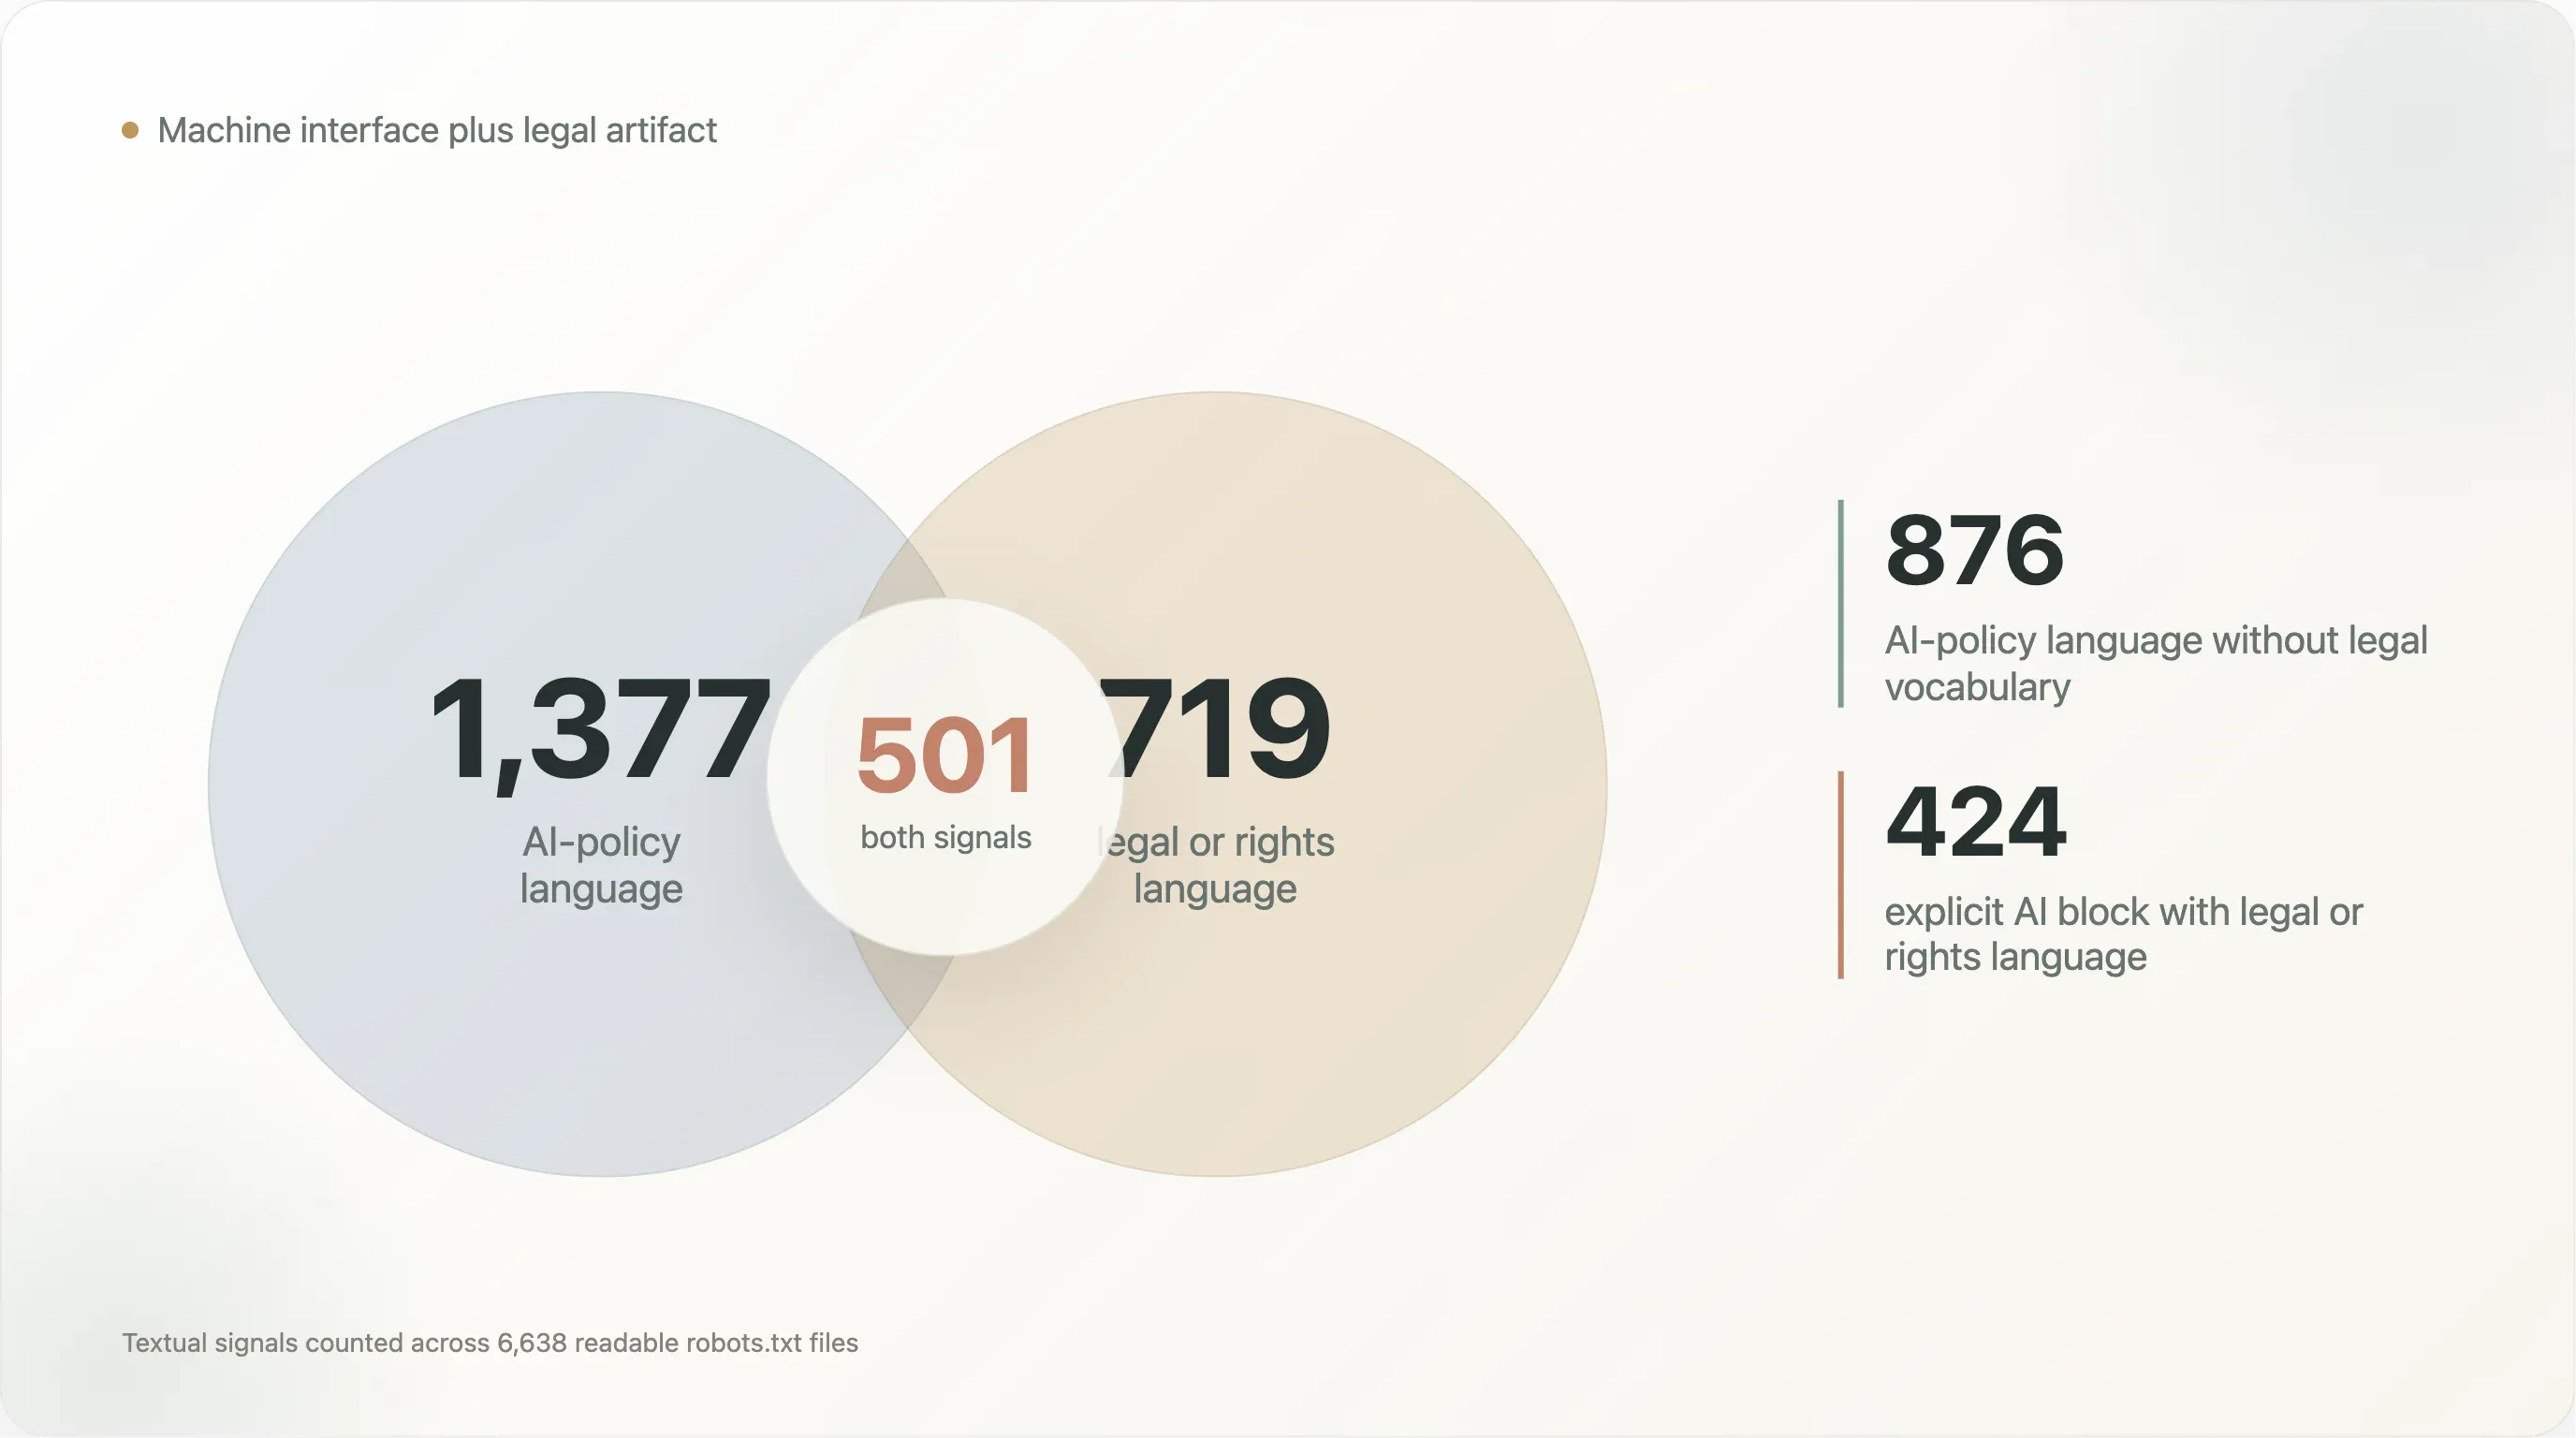
| Wzorzec tekstowy | Pliki |
|---|---|
| Język polityki AI i język prawny/roszczeniowy | 501 |
| Język polityki AI bez języka prawnego/roszczeniowego | 876 |
| Język prawny/roszczeniowy bez języka AI | 218 |
Content-Signal z językiem prawnym/roszczeniowym | 242 |
| Jawny blok AI z językiem prawnym/roszczeniowym | 424 |
To nowy rodzaj pliku.
Tradycyjny robots.txt jest adresowany do crawlerów. robots.txt z preambułą prawną jest adresowany przynajmniej do czterech odbiorców jednocześnie:
- operatorów crawlerów, którzy potrzebują dyrektyw czytelnych maszynowo;
- dostawców wyszukiwania i AI, którzy potrzebują sygnałów polityki;
- prawników, którzy chcą wyraźnego zastrzeżenia praw;
- przyszłych audytorów, sądów lub dziennikarzy, którzy mogą czytać komentarze jako dowód intencji.
Ten projekt dla wielu odbiorców wyjaśnia, dlaczego niektóre pliki brzmią dziś jak dokumenty polityk. Ale jednocześnie osłabia czysty podział między tym, co crawler może sparsować, a tym, co chce zadeklarować prawnik.
876 plików z językiem polityki AI, ale bez języka prawnego, to głównie pliki polityki maszynowej: nazwy botów, bloki Disallow i język szablonowy. 501 plików z oboma rodzajami języka jest czymś innym. Próbują jednocześnie być instrukcją dla crawlera i zastrzeżeniem praw. 218 plików z językiem prawnym, ale bez słownictwa AI, pokazuje, że ten wzorzec nie zaczął się od LLM-ów; robots.txt już wcześniej był używany do określania warunków, granic zezwoleń i roszczeń do praw.
Na przykład komentarz może mówić, że uczenie maszynowe jest zabronione, podczas gdy właściwy blok dyrektyw jedynie wyłącza część znanych agentów użytkownika. Witryna może globalnie zastrzegać prawa, ale wymieniać tylko kilka crawlerów. Szablon CDN może wstrzyknąć słownictwo związane z AI do pliku, którego operator nigdy ręcznie nie napisał w tym języku prawnym. Witryna może zapisać szeroką regułę User-agent: *, która nieumyślnie zablokuje przyszłe crawlery.
Z perspektywy governance robots.txt stał się atrakcyjny właśnie dlatego, że jest publiczny i czytelny maszynowo. Ale im więcej polityki niesie, tym bardziej widać jego ograniczenia:
- nie ma warstwy uwierzytelnienia, która potwierdzałaby, że konkretna polityka została przejrzana przez posiadacza praw, a nie odziedziczona z infrastruktury;
- nie ma natywnej historii wersji;
- nie ma ustrukturyzowanego pola dla zamierzonego użycia, takiego jak trening, retrieval, indeksowanie, streszczanie, cache czy ocena modelu;
- nie ma uniwersalnego rejestru tożsamości crawlerów AI;
- nie ma mechanizmu egzekwowania.
To nie oznacza, że plik jest bezużyteczny. Oznacza, że jest kruchy.
Lepsza interpretacja jest taka, że robots.txt staje się warstwą powiadomienia: publiczną, możliwą do sprawdzenia deklaracją preferencji i intencji. Sam w sobie nie jest kompletnym systemem zarządzania prawami.
Wniosek 4: Wyszukiwanie było nierówne jeszcze zanim pojawiła się AI
Jednym z najmocniejszych wniosków w oryginalnym raporcie było to, że wielu wydawców rozróżnia między crawlerami treningowymi AI a crawlerami wyszukiwarek. Blokują CCBot, GPTBot lub Google-Extended, a jednocześnie zachowują widoczność w Google Search.
Ta kontynuacja dodaje inny punkt: tradycyjne crawlery wyszukiwarek również nie są traktowane równo.
Sprawdziliśmy sześć crawlerów wyszukiwarek:
- Googlebot;
- Bingbot;
- DuckDuckBot;
- Slurp;
- Baiduspider;
- YandexBot.
W całym zbiorze 7 248 analizowalnych witryn:
| Traktowanie crawlerów wyszukiwarek | Witryny |
|---|---|
| Blokuje co najmniej jednego crawlera wyszukiwarki | 562 |
| Pozwala Googlebotowi, ale blokuje co najmniej jednego innego crawlera wyszukiwarki | 404 |
| Blokuje wszystkie sześć sprawdzonych crawlerów wyszukiwarek | 152 |
Liczba blokowanych botów nie rozkłada się równomiernie:
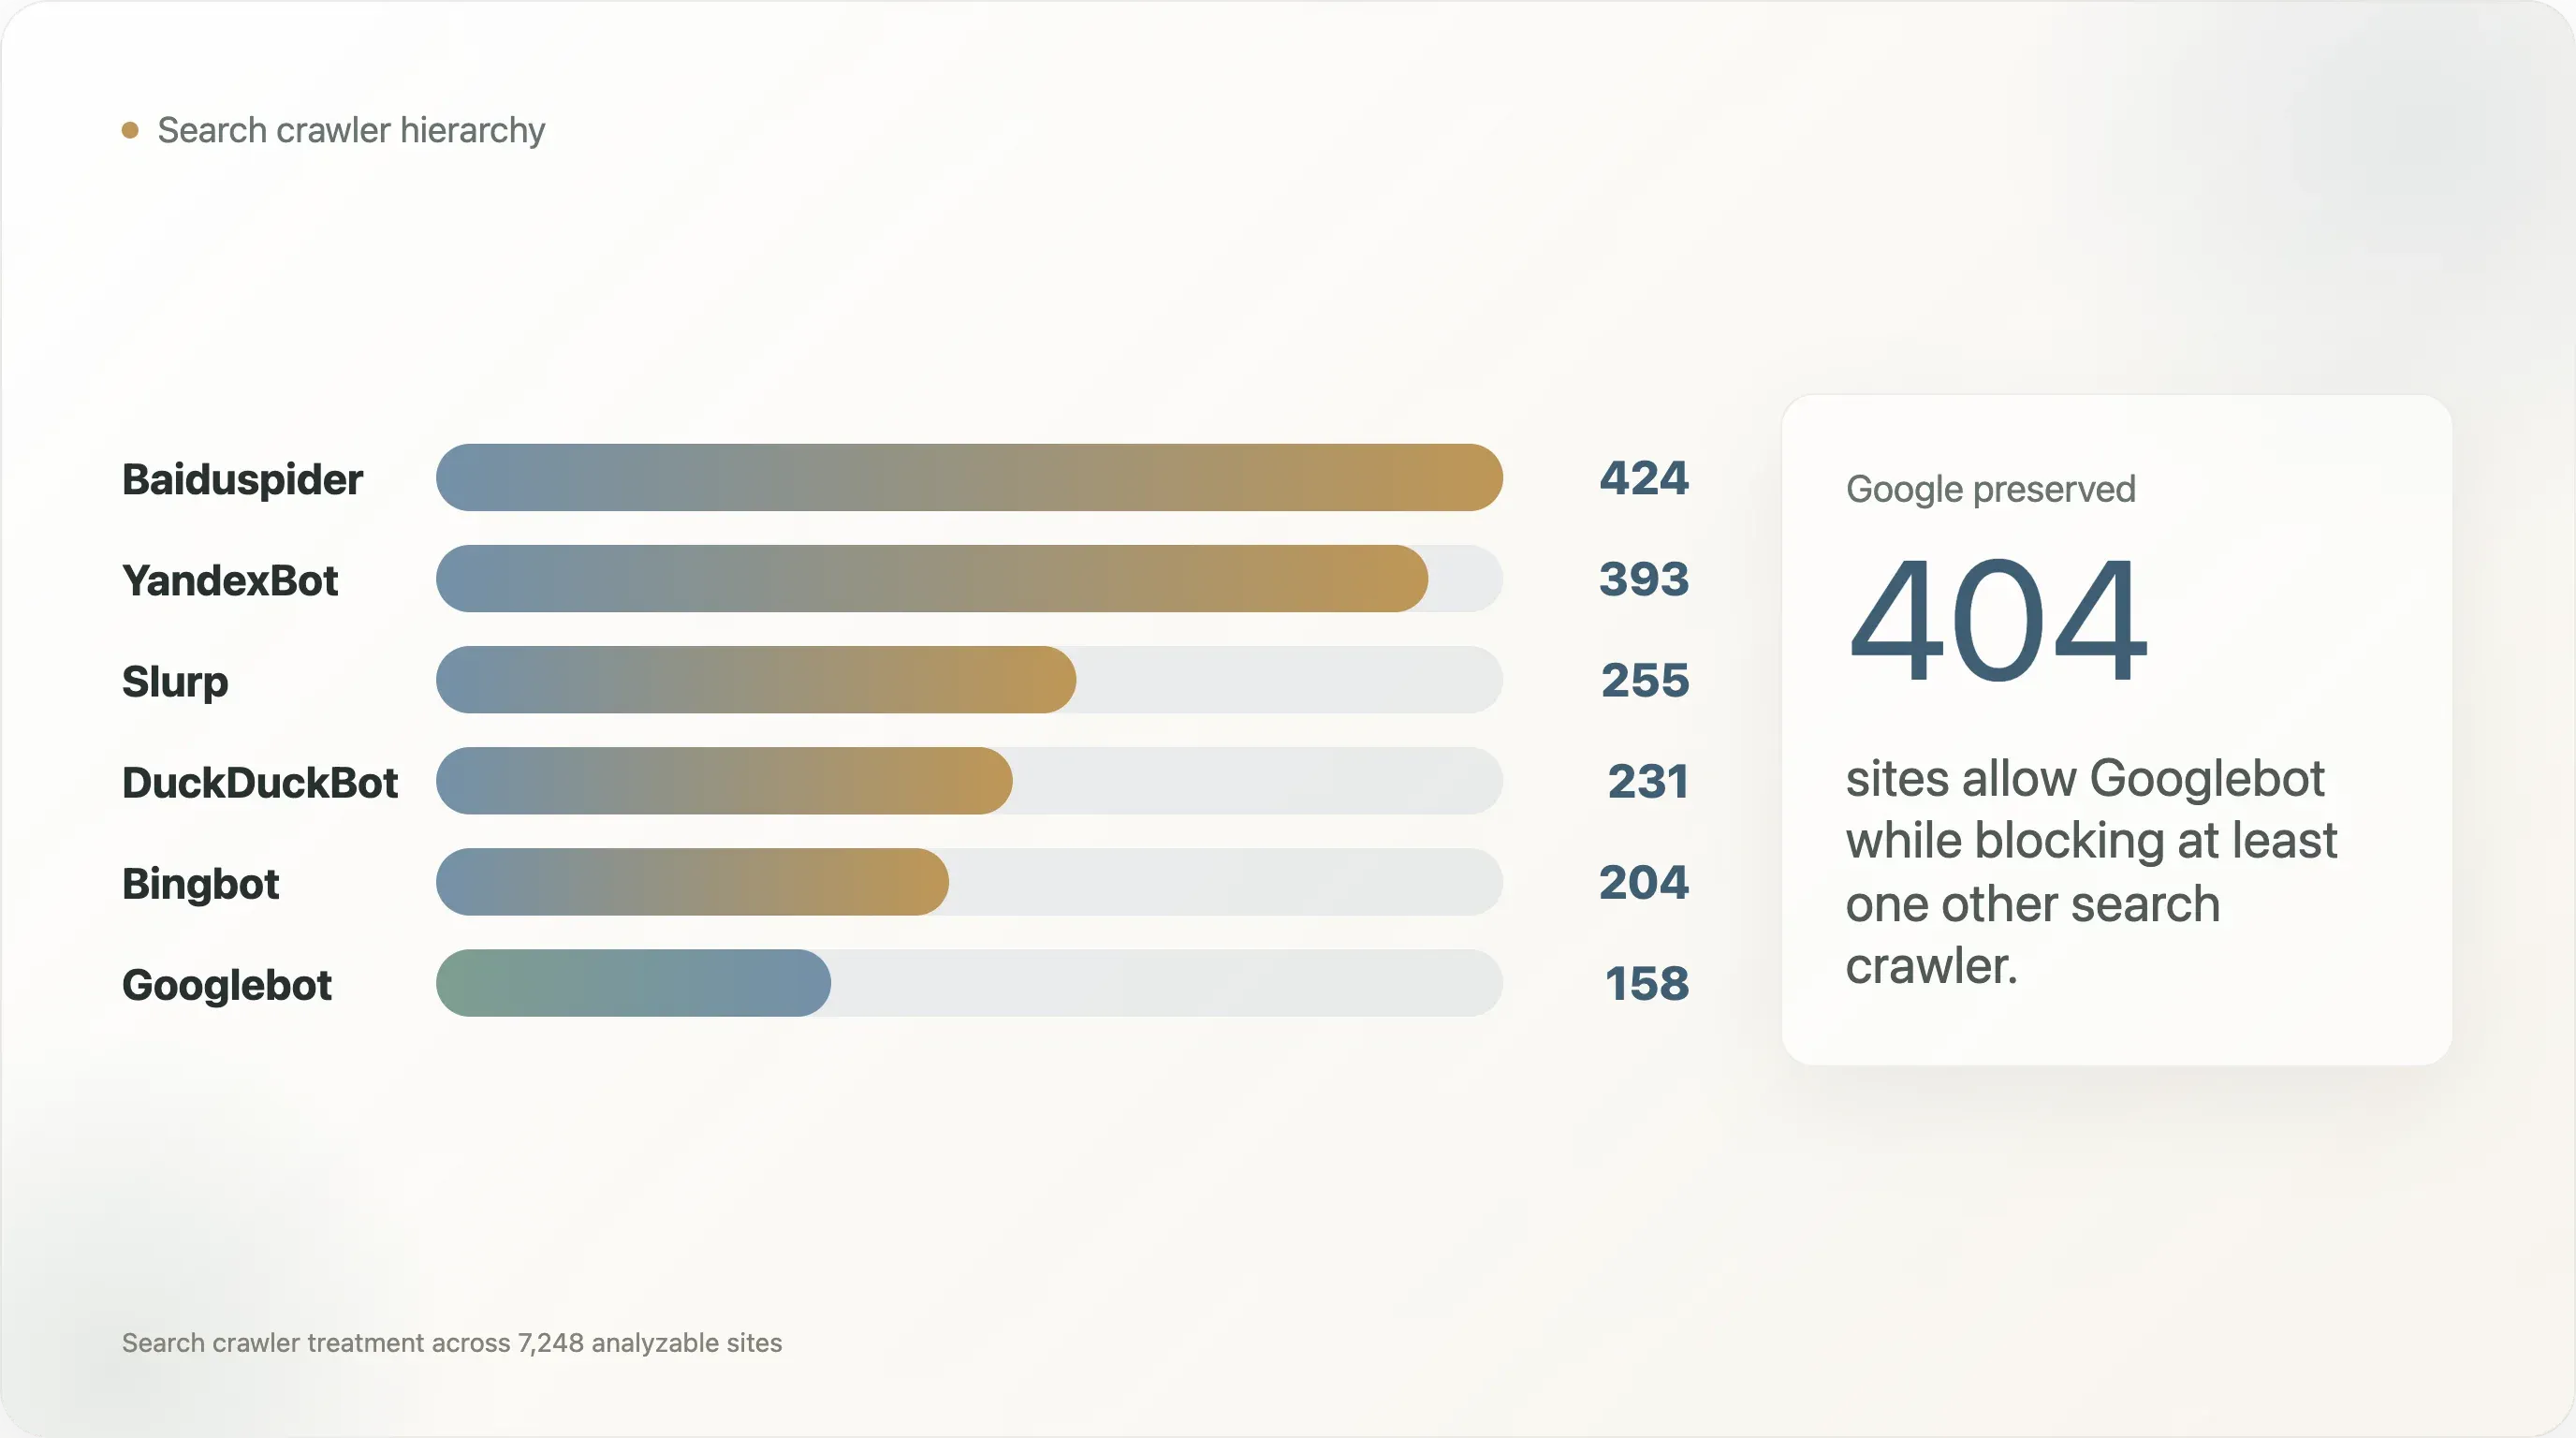
| Crawler wyszukiwarki | Witryny, które go blokują |
|---|---|
| Baiduspider | 424 |
| YandexBot | 393 |
| Slurp | 255 |
| DuckDuckBot | 231 |
| Bingbot | 204 |
| Googlebot | 158 |
Googlebot jest w tym zestawie najmniej blokowany. Baiduspider i YandexBot są blokowane znacznie częściej, a w większości tych przypadków Googlebot pozostaje dozwolony. Spośród 404 witryn, które zezwalają Googlebotowi, a blokują inny crawler wyszukiwarki, 269 blokuje Baiduspider, a 240 blokuje YandexBot.
Przykłady są znane:
| Domena | Zablokowane crawlery wyszukiwarki, gdy Googlebot jest dozwolony |
|---|---|
facebook.com | Baiduspider, YandexBot |
apple.com | Baiduspider |
twitter.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
netflix.com | DuckDuckBot, Slurp |
x.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
tiktok.com | Baiduspider |
baidu.com | Bingbot, DuckDuckBot, Slurp, YandexBot |
washingtonpost.com | YandexBot |
wsj.com | YandexBot |
bilibili.com | DuckDuckBot, Slurp, YandexBot |
temu.com | Slurp |
t-mobile.com | Baiduspider, YandexBot |
To ważne dla debaty o AI, bo pokazuje, że robots.txt nie był neutralnym protokołem powszechnego dostępu nawet przed pojawieniem się crawlerów LLM. Publiczna sieć już miała hierarchię:
- Googlebot jest często utrzymywany, bo ruch z Google Search jest zbyt cenny, by go ryzykować.
- Regionalne crawlery lub crawlery konkurencji są łatwiejsze do zablokowania.
- Niektóre witryny traktują dostęp crawlerów wyszukiwarek jako decyzję podejmowaną według rynku albo dostawcy.
Crawlery AI weszły do ekosystemu, w którym zróżnicowany dostęp był już normą.
To pomaga zrozumieć przejście polityki. Wydawca, który pisze „blokuj Google-Extended, ale zezwól Googlebotowi”, nie wymyśla nowej formy dyskryminacji. Stosuje stary wzorzec do nowej klasy crawlera: zachować dystrybucję, ograniczyć ekstrakcję.
Nierozstrzygnięte pytanie brzmi, czy ten stary wzorzec skaluje się dalej. W wyszukiwaniu było tylko kilka ekonomicznie istotnych crawlerów. W AI tożsamość crawlerów jest rozproszona między dostawców modeli, boty retrieval, brokerów danych, crawlery akademickie, syntetycznych agentów przeglądających i fetchery na poziomie infrastruktury. Liczba nazwanych agentów użytkownika będzie rosła, chyba że ekosystem skonsoliduje się wokół mniejszego zestawu sygnałów opartych na celu.
Właśnie tak kumuluje się dług konfiguracji.
Wniosek 5: Złożoność różni się między sektorami, ale nie tak jak wskaźniki blokowania AI
Oryginalny raport pokazał duży rozrzut sektorowy w blokowaniu AI: newsy blokują często; telekom, administracja i SaaS robią to rzadziej.
Złożoność konfiguracji tnie sieć inaczej.
Wśród wybranych kategorii z wystarczającą liczbą czytelnych plików robots.txt, by porównanie miało sens:
| Kategoria | n | Mediana bajtów | P90 bajtów | Mediana Disallow | P90 Disallow | Mediana User-agent | P90 User-agent |
|---|---|---|---|---|---|---|---|
| ecommerce | 215 | 1 738 | 10 388 | 37 | 164 | 3 | 49 |
| travel | 63 | 2 074 | 27 368 | 41 | 779 | 5 | 34 |
| news | 647 | 1 534 | 7 039 | 19 | 114 | 6 | 68 |
| finance | 121 | 1 002 | 8 337 | 17 | 132 | 2 | 23 |
| academia | 253 | 839 | 3 959 | 14 | 75 | 1 | 11 |
| government | 151 | 1 227 | 3 263 | 13 | 46 | 1 | 4 |
| SaaS | 368 | 485 | 12 606 | 4 | 56 | 1 | 10 |
| dev tools | 119 | 273 | 9 255 | 3 | 58 | 1 | 10 |
Wykres P90 Disallow według kategorii tutaj<<<<<<<<<<<<<<<<<<<<<<<<<
News jest politycznie złożony, bo zapisuje wyraźne reguły AI i tekst prawny. Ale e-commerce i travel są operacyjnie złożone, bo mają duże katalogi, nawigację fasetową, strony wyników wyszukiwania, filtry, ścieżki kont użytkowników i parametryzowane URL-e.
To rozróżnienie jest ważne.
Travel to najczystszy przykład. Ma tylko 63 czytelne pliki w tym wycinku kategorii, ale jego P90 robots.txt ma 27,4 KB, a P90 liczby Disallow wynosi 779, znacznie więcej niż w newsach. To nie znaczy, że witryny travel mają lepiej rozwiniętą politykę AI. To znaczy, że mają więcej powierzchni, na których operatorzy crawlerów mogą niepotrzebnie zużywać budżet: wyszukiwanie dat, strony dostępności, paginację recenzji, przepływy rezerwacji, kombinacje filtrów i zlokalizowane ścieżki zasobów.
SaaS to przeciwna niespodzianka. Mediana pliku to tylko 485 bajtów, ale P90 rośnie do 12,6 KB. Większość witryn SaaS jest otwarta i lekka; mniejszy zestaw ma długie pliki sterujące ścieżkami, często dlatego, że dokumentacja, logowanie, trasy aplikacji i strony marketingowe żyją pod tą samą domeną.
News jest operacyjnie pośrodku, ale politycznie blisko szczytu. Jego P90 liczby User-agent wynosi 68, więcej niż w ecommerce, travel, finance, academia, government, SaaS i dev tools w tej tabeli. To sygnał polityki specyficznej dla botów, a nie tylko higieny ścieżek.
robots.txt wydawcy może być złożony z powodu polityki praw. Plik marketplace może być złożony z powodu zarządzania crawl budgetem. Plik uczelni może być złożony, bo pod jedną domeną zebrały się tysiące starych ścieżek. Plik platformy społecznościowej może być złożony, bo musi jednocześnie wystawiać niektóre powierzchnie i ukrywać inne w ogromnej skali.
Polityka AI nakłada się na wszystko to. Nie zastępuje wcześniejszych powodów, dla których plik jest złożony.
To pomaga wyjaśnić, dlaczego governance robots.txt w erze AI nie da się rozwiązać uniwersalną listą blokad. Podstawowe pliki pełnią różne zadania:
- witryny ecommerce zarządzają duplikatami ścieżek i powierzchniami stanów magazynowych;
- witryny travel zarządzają ofertami, kalendarzami, recenzjami i dynamicznymi stronami wyszukiwania;
- witryny news zarządzają prawami autorskimi, archiwami i postawą licencyjną;
- witryny SaaS i dev tools często chcą widoczności dla AI;
- administracja zwykle potrzebuje publicznego dostępu, ale może mieć też wrażliwe systemy do wykluczenia;
- platformy społecznościowe zarządzają treściami tworzonymi przez użytkowników, powierzchniami profili i problemami nadużyć.
Ta sama reguła dla crawlera AI znaczy coś innego w każdym z tych środowisk.
Wniosek 6: Indeks długu konfiguracji wskazuje ryzyko przeglądu, a nie porażkę moralną
Ta analiza stworzyła prosty wskaźnik długu konfiguracji, aby wskazać pliki robots.txt, które prawdopodobnie trudno przeglądać.
Wskaźnik waży:
- rozmiar pliku;
- liczbę dyrektyw
User-agent; - liczbę dyrektyw
Disallow; - liczbę dyrektyw
Allow; - liczbę dyrektyw spoza rdzenia;
- obecność języka polityki AI;
- mieszankę jawnego blokowania AI oraz języka prawnego lub praw autorskich.
To nie jest wskaźnik poprawności. Plik o dużej złożoności może być całkowicie zamierzony. Plik prosty nadal może być błędny. Chodzi o triage: jeśli plik jest duży, pełen polityk, specyficzny dla botów i pełen wyjątków, zasługuje na mocniejszą dyscyplinę przeglądu.
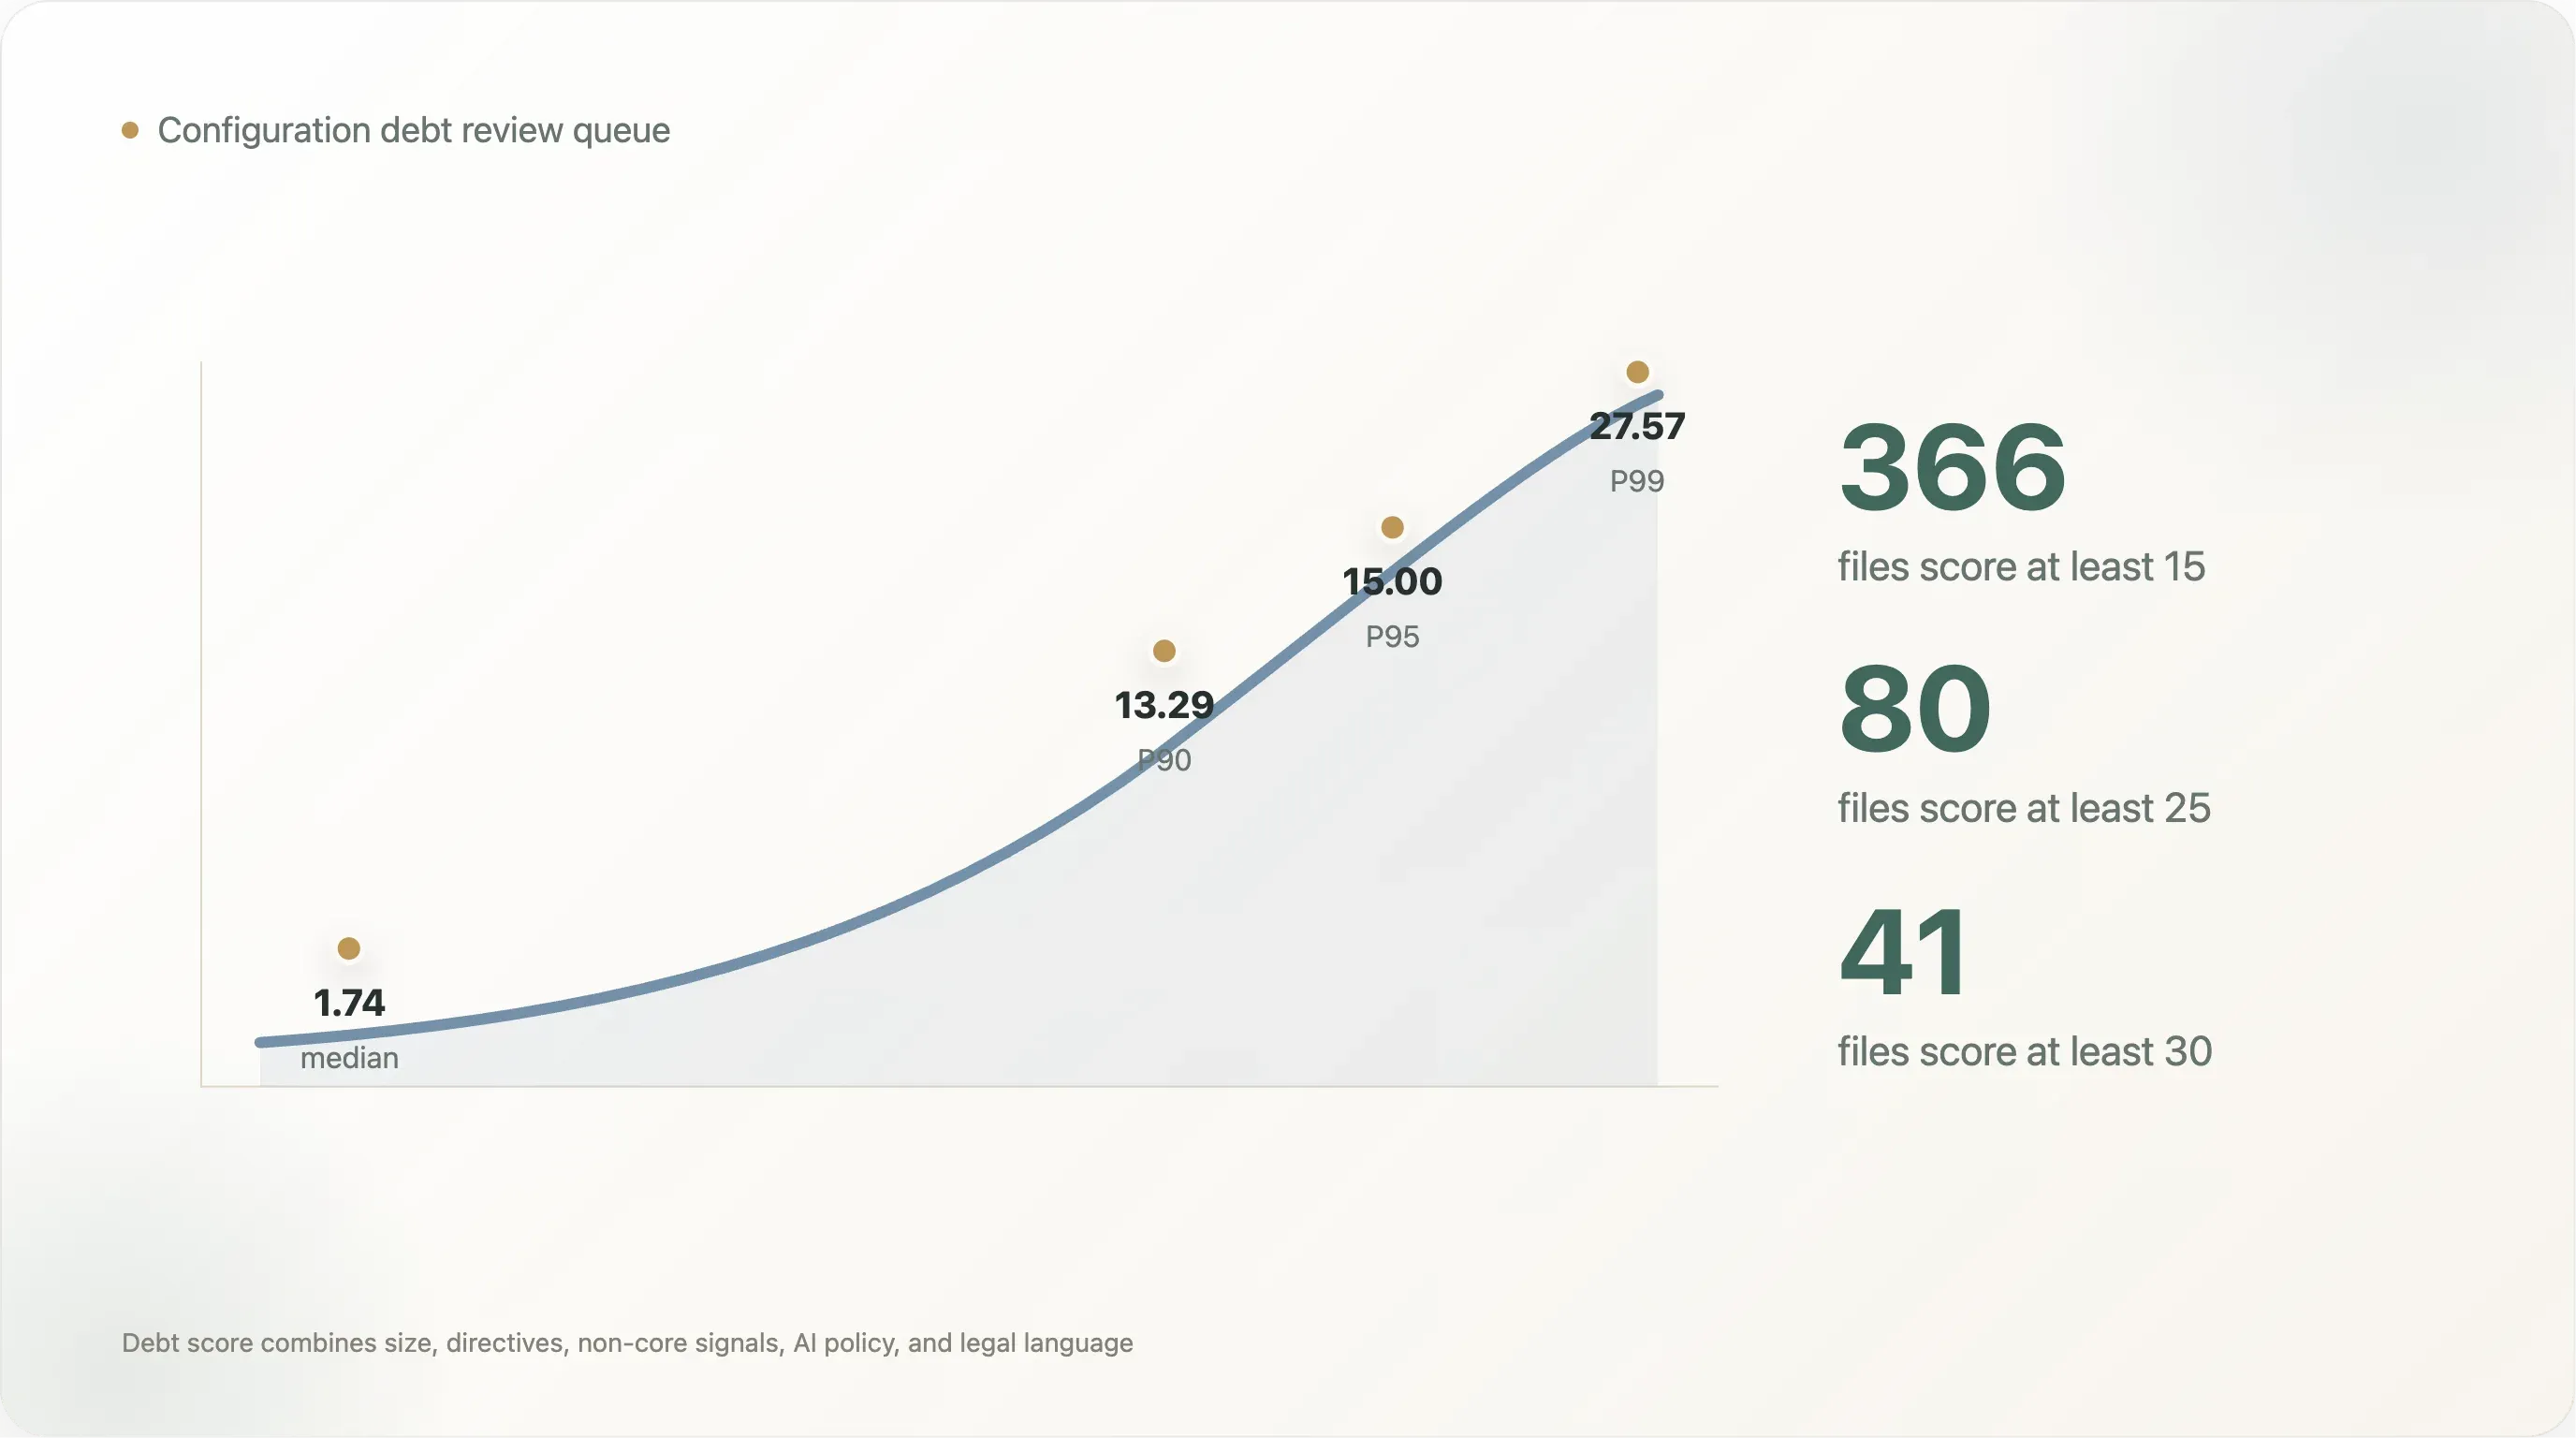
Rozkład wskaźnika jest stromy. Mediana czytelnego pliku to 1,74. P90 wynosi 13,29, P95 to 15,00, a P99 to 27,57. Tylko 366 plików ma wynik co najmniej 15, 80 ma co najmniej 25, a 41 ma co najmniej 30. To praktyczna kolejka przeglądu: nie każda witryna potrzebuje projektu governance, ale górny ogon już tak.
Widok według kategorii pokazuje też, dlaczego pojedyncza etykieta „blokada AI” jest zbyt płaska:
| Kategoria | Mediana wyniku | P90 wyniku |
|---|---|---|
| travel | 4,92 | 28,94 |
| search | 2,97 | 24,23 |
| social | 2,25 | 15,00 |
| news | 4,91 | 14,92 |
| finance | 1,67 | 12,61 |
| SaaS | 0,98 | 11,85 |
| ecommerce | 3,88 | 10,87 |
| government | 1,57 | 6,38 |
Travel i search mają najwyższe wyniki P90, bo mniejsza część plików staje się bardzo duża i bogata w reguły. News ma jedną z najwyższych median, bo język polityki i traktowanie specyficzne dla botów są tam częstsze w całej kategorii. Ecommerce ma wysoki medianowy licznik Disallow, ale jego P90 długu jest niższy niż w travel, bo złożoność koncentruje się bardziej w regułach ścieżek niż w mieszanych sygnałach politycznych i prawnych.
Najwyżej ocenione pliki w tym zbiorze obejmują:
| Domena | Dlaczego ma wysoki wynik |
|---|---|
linkedin.com | Bardzo duży plik, tysiące reguł ścieżek, wiele nazwanych agentów użytkownika, wyraźny język polityki AI |
lnkd.in | Ta sama powierzchnia polityki co infrastruktura shortlinków LinkedIn |
fragrantica.com | Setki bloków dla nazwanych agentów użytkownika plus język polityki AI |
sovcombank.ru | Setki bloków dla agentów użytkownika oraz język prawny/polityczny |
academia.edu | Duża macierz allow/disallow i jawna polityka blokowania AI |
opentable.com | Duży zestaw reguł ścieżek, wiele dyrektyw sitemap, powierzchnia polityki związanej z AI |
etsy.com | Duży plik sterowania ścieżkami ecommerce z ponad 1 600 regułami Disallow |
runescape.com | Prawie 5 000 dyrektyw Disallow pod jedną grupą User-agent |
Nie należy wyśmiewać tych plików za złożoność. Złożoność często odzwierciedla realne potrzeby biznesowe. Ale pokazują one, dlaczego polityka robots.txt zasługuje na taką samą dyscyplinę inżynieryjną jak inne konfiguracje produkcyjne:
- własność powinna być jawna;
- zmiany powinny być recenzowane;
- generowane sekcje powinny być oznaczone;
- komentarze prawne powinny być oddzielane od dyrektyw maszynowych, gdzie to możliwe;
- przypadki testowe powinny potwierdzać oczekiwany dostęp botów dla krytycznych crawlerów;
- historia wersji powinna być zachowana;
- stare nazwy botów powinny być wycofane lub udokumentowane;
- trening AI, retrieval AI, indeksowanie wyszukiwania i archiwizacja powinny być traktowane jako osobne cele.
Ostatni punkt jest najważniejszy. Obecna gramatyka jest zorientowana na User-agent: prosi operatorów stron o wymienianie botów. Potrzeba ery AI jest zorientowana na cel: prosi operatorów stron, by określili, jakie użycia są dozwolone.
To nie jest to samo.
To niedopasowanie wyjaśnia, dlaczego długie listy blokad nie zestarzeją się dobrze. Wydawca może dziś dodać GPTBot, ClaudeBot, CCBot, Google-Extended, Bytespider, Applebot-Extended i PerplexityBot, ale jutro pojawi się nowa nazwa crawlera, agent retrieval albo broker zestawu danych. Polityka oparta na celu pozwoliłaby stronie powiedzieć: „indeksowanie wyszukiwania tak, trenowanie AI nie, retrieval inicjowany przez użytkownika być może” bez zamieniania robots.txt w książkę adresową botów.
Co to oznacza dla governance AI
Debata publiczna często przedstawia robots.txt jako coś znaczącego albo przestarzałego. Dane sugerują bardziej praktyczną odpowiedź:
robots.txt jest znaczący, ale przeciążony.
Jest znaczący, bo używają go duże serwisy, crawlery mogą go parsować, a wybory polityczne są widoczne dla badaczy, dziennikarzy, dostawców i sądów. Oryginalny raport wykazał, że 17,0% analizowalnych czołowych witryn miało świadomie zapisane reguły specyficzne dla AI. To nie jest symboliczny szum.
Jest przeciążony, bo plik musi dziś wyrażać coś więcej niż dostęp botów:
- „Nie trenuj na tej treści.”
- „Możesz używać tej treści do indeksowania wyszukiwania.”
- „Możesz używać tej treści do bieżącego retrieval.”
- „Nie możesz tworzyć z tego cache’owanych zbiorów danych.”
- „To zastrzeżenie prawne obowiązuje na mocy unijnego prawa o text and data mining.”
- „Ta strona zarządzana przez CDN wysyła
Content-Signal: ai-train=no.” - „Ta witryna chce Googlebota, ale nie YandexBota.”
- „Ta witryna ma 1 000 starych ścieżek URL, których nie należy crawlować.”
Gramatyka nie była projektowana do tylu zadań.
Trzy zmiany ograniczyłyby ten dług:
-
Tożsamość crawlera potrzebuje rejestru. Operatorzy stron nie powinni utrzymywać stale rosnącej listy
GPTBot,ClaudeBot,anthropic-ai,CCBot,Google-Extended,Applebot-Extended,Bytespider,OAI-SearchBot,ChatGPT-Useri wielu innych. Bez rejestru polityka zawsze będzie spóźniona wobec zachowania crawlerów. -
Użycia AI potrzebują ustrukturyzowanego słownictwa. Trening, retrieval, indeksowanie, streszczanie, odsprzedaż zbiorów danych, ocena modeli i przegląd inicjowany przez użytkownika to różne użycia. Wyrażanie ich przez nazwy agentów użytkownika zależne od dostawcy jest kruche.
-
Polityka musi być audytowalna. Sieć potrzebuje sposobu, by odróżnić ręcznie napisane zastrzeżenia praw od dziedziczonych domyślnych ustawień CDN, generowanych szablonów CMS, przestarzałych reguł legacy i przypadkowych blokad obejmujących wszystko. Ta różnica ma znaczenie dla zaufania i dla sporów sądowych.
To nie oznacza, że robots.txt należy natychmiast zastąpić. Lepsza droga to warstwowanie: zachować robots.txt jako powierzchnię wykrywania i kompatybilności, ale obok ustandaryzować czytelną maszynowo politykę dla zastosowań związanych z AI.
llms.txt to jedna z prób, ale adopcja w tym zbiorze danych jest nadal niewielka: tylko 83 czytelne pliki wspominają o tym formacie. Content-Signal jest bardziej widoczny, bo Cloudflare może dystrybuować go przez infrastrukturę, a wszystkie 271 plików z Content-Signal w tym skanie zawierały też język polityki AI. Mimo to dystrybucja to nie to samo co konsensus. Trwałe rozwiązanie prawdopodobnie wymaga nudnej machiny standaryzacji: jasnych pól, jasnej semantyki, zobowiązań crawlerów i publicznych zestawów testowych.
Zakończenie
Walka o crawlery AI zamieniła robots.txt w artefakt governance. To jednocześnie użyteczne i ryzykowne.
Użyteczne, bo plik jest publiczny. Badacze mogą go audytować. Wydawcy mogą go zmieniać. Crawlery mogą go respektować. Sądy mogą go czytać. Dostawcy infrastruktury mogą wdrażać go na dużą skalę.
Ryzykowne, bo niesie za dużo.
Mediana pliku robots.txt w Tranco Top 10K jest nadal mała na tyle, by dało się ją zrozumieć. Ale długi ogon wysokiego ruchu w sieci jest pełen dużych, starych, warstwowych, zależnych od dostawców i prawnie obciążonych plików. Setki witryn utrzymują dziś konfiguracje robots.txt, które lepiej rozumieć jako produkcyjne systemy polityk niż proste wskazówki dla crawlerów.
Kluczowa lekcja nie brzmi, że robots.txt zawiódł. Brzmi raczej, że sieć awansowała go bez refaktoryzacji.
Jeśli polityka dostępu dla AI ma opierać się na publicznych deklaracjach czytelnych maszynowo, kolejnym krokiem nie jest kolejna, dłuższa lista blokad. Jest nim lepsza infrastruktura polityki: uprawnienia oparte na celu, stabilna tożsamość crawlerów, szablony podlegające przeglądowi i ślady audytowe.
Do tego czasu warstwa governance AI publicznej sieci będzie nadal opierać się na pliku tekstowym, który nigdy nie miał dźwigać aż tak wiele.
Uwagi o odtwarzalności
Folder dostawy zawiera:
source_data/analysis.json— oryginalne metryki zbiorcze.source_data/site_meta.csv— oryginalna tabela analityczna per witryna.source_data/bot_status.csv— oryginalna tabela polityki domena–bot.source_data/fetch_meta.csv— oryginalne metadane pobrania.source_data/sites.csv— oryginalna tabela domena/kategoria/status.derived_data/robots_complexity_by_site.csv— metryki złożoności per witryna wygenerowane dla tego raportu.derived_data/search_bot_treatment.csv— macierz traktowania crawlerów wyszukiwarek.derived_data/category_complexity_summary.csv— podsumowanie złożoności na poziomie kategorii.derived_data/top_config_debt_sites.csv— top witryn według wskaźnika triage opisanego powyżej.derived_data/summary_metrics.json— wszystkie główne metryki cytowane w raporcie.
Pobierz wszystkie skrypty i zbiory danych
Korekty metodologii, problemy ze zbiorem danych i propozycje dalszych analiz są mile widziane pod adresem support@thunderbit.com. Ten raport został opublikowany niezależnie od jakiegokolwiek stanowiska komercyjnego zajmowanego przez Thunderbit; tworzymy web scraper oparty na AI i mamy strukturalny interes w tym, by robots.txt nadal był znaczącą, czytelną maszynowo umową w publicznej sieci. Dane w tym raporcie bronią się same. — Zespół badawczy Thunderbit, maj 2026.
Wypróbuj Thunderbit do AI Web Scraping Get Started Free



