
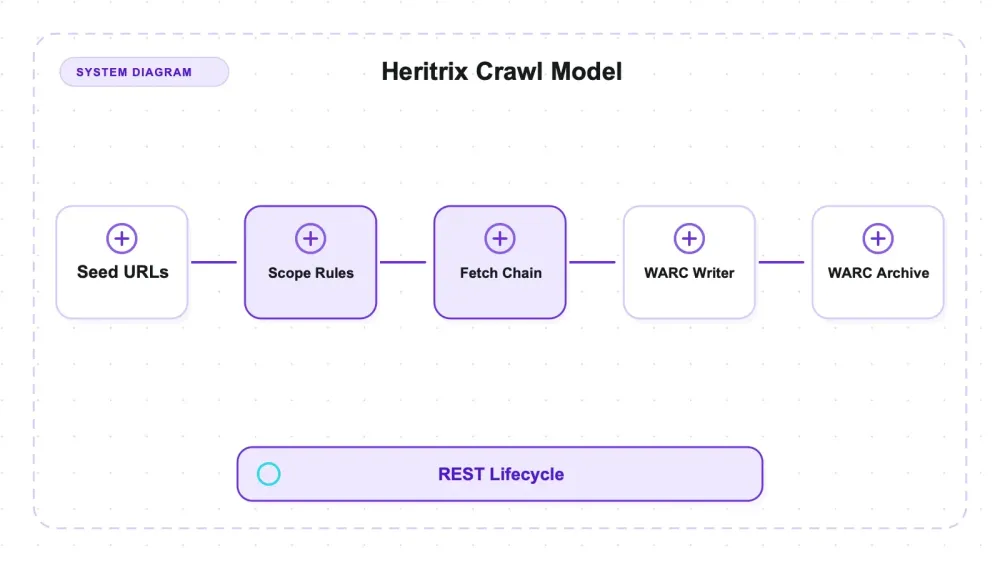
Heritrix to otwartoźródłowy crawler archiwalny Internet Archive — linia oprogramowania stojąca za Wayback Machine, używana produkcyjnie od dwóch dekad. Jego zadaniem jest wierne zapisywanie tego, co udostępnia witryna, do plików WARC, które można odtworzyć wiele lat później. W środku to silnik w Javie, w którym każdy crawl jest grafem beanów Spring zapisanym w XML, a cały cykl życia zadania jest sterowany przez REST API. To nie jest scraper: bez selektorów, bez mapowania pól, bez wierszy na końcu.
Przetestowałem wersję 3.16.0 na kontrolowanym, lokalnym zestawie testowym i policzyłem dokładnie, co faktycznie zapisał — rekord po rekordzie. Najbardziej wyróżnia się kompletność: dwadzieścia pobranych URI wygenerowało sześćdziesiąt jeden rekordów WARC, a każda odpowiedź miała digest ładunku i adres IP przechwycenia, a każdy request był powiązany z odpowiedzią, do której należał — i wszystko to bez grzebania w żadnym przełączniku konfiguracyjnym. Obsługa jest przeciwieństwem tego doświadczenia: 41 MB, 114 plików JAR (lib/ zawiera 142 pliki, a pozostałe 28 to dołączone teksty LICENSE i NOTICE) oraz około 750 linii konfiguracji zadania jeszcze przed pierwszym pobraniem — choć tutaj każdy crawl działał bez interfejsu, wyłącznie przez curl, bez żadnych kliknięć w UI.
Wynik dotyczący miejsca na dysku ujawnił mniej oczyślany domyślny mechanizm. Dwa adresy z testowego zestawu zwracały identyczną zawartość bajt w bajt, a standardowy profil pobrał i zarchiwizował oba w całości: dwa rekordy odpowiedzi i zero rekordów revisit, mimo że obu odpowiedziom przypisano ten sam digest ładunku. Deduplikacja po content-digest działa dopiero wtedy, gdy dodane zostaną procesory historii; w standardowym profilu nie jest włączona i oszczędza miejsce na dysku, a nie transfer.
Czym Heritrix naprawdę jest
Archiwizowanie to nie scraping — i właśnie to pomylenie kategorii warto od razu uporządkować. Heritrix nie daje tabeli z wierszami. Na końcu nie ma CSV. Jego wyjściem jest sama rozmowa HTTP — nagłówki, treść i metadane przechwycenia — zapisana w formacie stworzonym do długoterminowego zachowania, a on sam jest referencyjną implementacją całej tej klasy zadań. Proszenie go o listę cen produktów jest jak proszenie stenotypisty sądowego o streszczenie.
Aktualne liczby na 27 lipca 2026: repozytorium ma 3 285 gwiazdek i 36 otwartych zgłoszeń, a 3.16.0 to najnowsze wydanie, opublikowane 2026-07-03. To dokładnie ta wersja, którą testowałem, więc nie jest to narzekanie na nieaktualną kompilację. Licencja ma jeden haczyk: plik LICENSE jest czystym Apache-2.0, ale detektor GitHuba pokazuje „Other”, bo część dołączonych plików firm trzecich ma własne warunki. Jeśli Heritrix ma wejść do produktu komercyjnego, warto poświęcić na to pięć minut uwagi prawnej, a nie tylko spojrzeć na odznakę w panelu bocznym.
Jedna cecha architektury determinuje wszystko inne: Heritrix nie uruchamia przeglądarki. Pobiera przez HTTP i wyciąga linki z bajtów, które dostał z powrotem. Jego współczesny odpowiednik w archiwizacji, Browsertrix Crawler, działa odwrotnie — używa prawdziwego Chromium i zapisuje to, co faktycznie zrobiła przeglądarka. Oba narzędzia zapisują WARC, ale ta recenzja mierzyła wyłącznie ścieżkę Heritrix bez przeglądarki; nie porównywałem skali ani przepustowości obu systemów.
Łańcuchy, beany i SURT: jak naprawdę składa się crawl
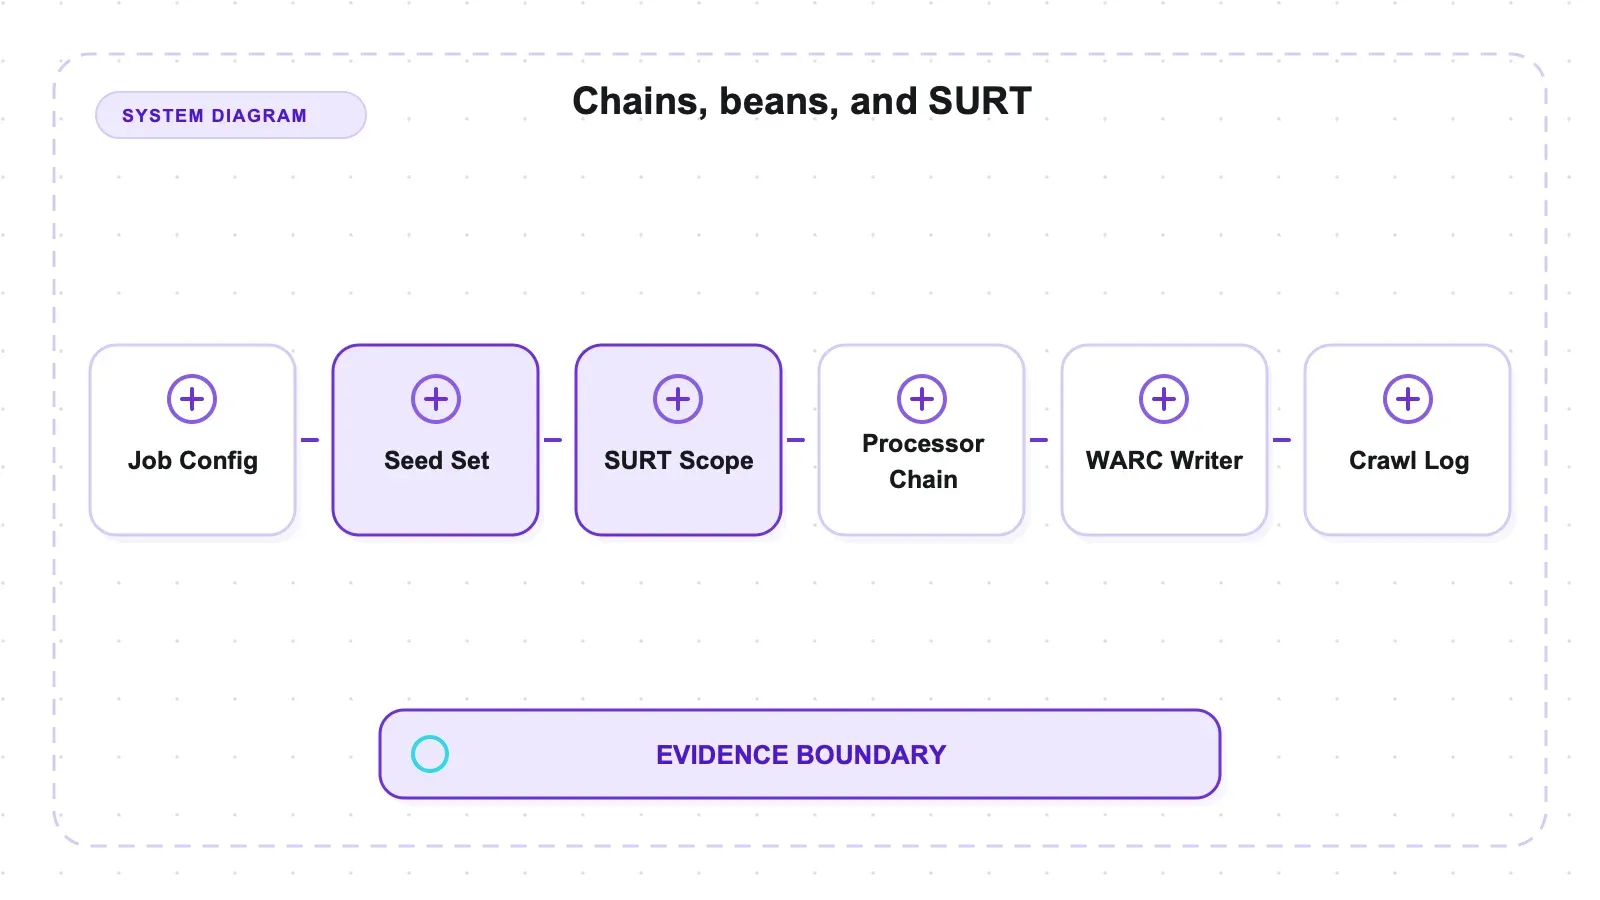
Pod maską zadanie Heritrix to kontekst aplikacji Spring. Nie „skonfigurowane przy użyciu Spring” — ono jest grafem beanów Spring zapisanym w XML, a każdy element crawla można wymienić.
Frontier przechowuje kolejkę URI, podzieloną według hosta. Właśnie dlatego zasada uprzejmości wobec serwera działa tak, jak działa, i wróci to jeszcze później.
Łańcuchy procesorów wykonują pracę w trzech etapach: łańcuch kandydatów (czy ten odkryty URI powinien zostać zaplanowany?), łańcuch pobierania (DNS, robots, pobranie HTTP, ekstrakcja linków) oraz łańcuch dyspozycji (zapis do WARC, aktualizacja stanu). Dodanie nowej funkcji do Heritrix zwykle oznacza wstawienie beanów procesora we właściwym miejscu właściwego łańcucha — dokładnie tak włączyłem deduplikację.
Zakres to stos reguł DecideRules działających na SURT — Sort-friendly URI Reordering Transform, który przepisuje http://www.example.com/a na http://(com,example,www,)/a, aby prefiksy hostów układały się hierarchicznie. Domyślny zakres jest generowany z prefiksów SURT seedów. Reguły akceptują i odrzucają po kolei, a wygrywa ostatnie dopasowanie.
Zapis WARC siedzi w łańcuchu dyspozycji, a uprzejmość wobec serwera jest w frontierze i opiera się na trzech liczbach: delayFactor, minDelayMs, maxDelayMs. Robots są polityką ustawioną po stronie fetchera.
I wszystko to da się sterować przez REST API, co okazało się ważniejsze, niż się spodziewałem.
Najcięższa część to samo uruchomienie
Co trzeba wdrożyć, zanim wykona się pierwsze pobranie:
| Wymiar konfiguracji | Heritrix 3.16.0 |
|---|---|
| Archiwum dystrybucyjne | około 41 MB |
Pliki w lib/ po rozpakowaniu | 142 łącznie: 114 plików .jar i 28 tekstów LICENSE/NOTICE |
| Co uruchomienie odpala | silnik Javy plus osadzony interfejs Jetty pod https://localhost:8443 z certyfikatem self-signed |
| Czas do gotowości REST, na moim komputerze | około dziesięciu sekund |
Domyślna konfiguracja zadania (crawler-beans.cxml) | około 750 linii XML beanów Spring |
Większości tej konfiguracji nigdy nie będziesz dotykać. Ale nie da się jej pominąć, a dwa pola są obowiązkowe, zanim crawler pobierze cokolwiek: seed oraz metadata.operatorContactUrl. Domyślna wartość to placeholder i crawler nie ruszy, dopóki nie zastąpisz jej prawdziwym adresem URL identyfikującym osobę lub zespół uruchamiający crawl.
To wymaganie tworzy punkt odpowiedzialności: operator musi podać kontaktowy URL, zanim crawler wystartuje. Nie dowodzi to, że tożsamość jest prawdziwa, że crawl jest autoryzowany ani że spełnia obowiązujące zasady, ale sprawia, że dane kontaktowe stają się częścią zadania, a nie opcjonalnym zwyczajem.
Dwa ustalenia z konfiguracji naprawdę mnie zaskoczyły.
Działał na nowszym JDK niż minimum podane w dokumentacji. Dokumentacja Getting Started wymaga Java 17 lub nowszej. Heritrix 3.16.0 uruchomił się, wystawił REST API i dokończył każdy crawl w tym zestawie testowym na OpenJDK 26.0.1, bez --add-opens, bez --enable-preview i bez obejść związanych z Security Managerem. To wynik z jednego hosta macOS arm64, a nie pełna macierz zgodności, ale potwierdza, że testowana kompilacja nie była ograniczona do JDK 17 na tej maszynie.
Nigdy nie musisz dotykać UI. Cały cykl życia zadania odbywa się przez REST, a ja zautomatyzowałem wszystko curlem: utworzenie zadania, PUT pliku beanów, build, start, wznowienie, polling aż stan kontrolera pokaże FINISHED, zakończenie i teardown. To jest prawdziwa odpowiedź na pytanie „czy Heritrix da się obsługiwać w pipeline’ie” — tak, bez przeglądarki i bez kliknięć. Większość opisów pokazuje zrzuty ekranu z Jetty UI i sugeruje, że to główny interfejs. To wygoda, nie konieczność.
Jedna uwaga zależna od hosta: ten Mac korzysta z systemowego proxy HTTP przez Surge. Klient Java Heritrix odziedziczył to proxy i wysyłał nawet ruch testowy do 127.0.0.1 przez nie, co powodowało odpowiedzi 503 mimo listy wyjątków w systemie i NO_PROXY. Uruchomienie JVM z -Djava.net.useSystemProxies=false zmieniło wynik z 2×503 na 18×200. To była interakcja ze środowiskiem, nie wada Heritrix; ten flag ma znaczenie tylko wtedy, gdy dziedziczenie systemowych ustawień proxy jest niepożądane.
Co naprawdę trafia do archiwum
Uruchomiłem standardowy profil domyślny na kontrolowanym fixture — lokalnym serwerze ze znanym zestawem endpointów, w tym stronami HTML, łańcuchem trzech poziomów głębokości, robots.txt i sitemapą oraz celowo przygotowanymi trasami 404 i 500 — a potem przeanalizowałem wynikowy WARC rekord po rekordzie zamiast ufać jednemu wierszowi podsumowania.
Dwadzieścia pobranych URI dało sześćdziesiąt jeden rekordów:
| Typ rekordu WARC | Liczba | Co zawiera |
|---|---|---|
warcinfo | 1 | pochodzenie na poziomie crawla, zapisywane raz na plik |
response | 20 | pełna odpowiedź HTTP, nagłówki i body |
request | 20 | dokładne żądanie wysłane przez Heritrix |
metadata | 20 | własne adnotacje przechwycenia Heritrix |
Czysta proporcja 1:1:1 odpowiedź/żądanie/metadane na każdy URI, od razu, bez żadnej konfiguracji z mojej strony. A kompletność na poziomie rekordów wytrzymała inspekcję:
| Kontrola per rekord | Liczba | Dlaczego to ważne |
|---|---|---|
Digest ładunku z prefiksem sha1: w odpowiedziach | 20/20 | — |
WARC-IP-Address w odpowiedziach | 20/20 | adres IP, z którego naprawdę pochodziła treść — dokładnie to chcesz znać po latach, gdy domena zmieni właściciela |
Rekordy request powiązane z odpowiedzią przez WARC-Concurrent-To | 20/20 | Nie „w większości”. Wszystkie. |
A status HTTP został zachowany dosłownie, również brzydkie przypadki: 200 OK, 404 Not Found i 500 Internal Server Error pojawiają się w zapisanych odpowiedziach jako prawdziwe linie statusu, a nie są odrzucane jako błędy.
Ten ostatni punkt oddziela archiwizowanie od scrapingu mocniej niż cokolwiek innego. Scraper traktuje 500 jako błąd do ponowienia albo pominięcia. Archiwizator traktuje to jako to, co serwer powiedział w danej chwili — a to jest fakt, który warto zachować. Wiki Heritrix Output opisuje tę strukturę rekordów; czego nie widziałem nigdzie indziej, to pomiaru liczności i powiązania 20/20 dla znanego zestawu endpointów. To się zgadza.
Wynik deduplikacji, zmierzony z obu stron
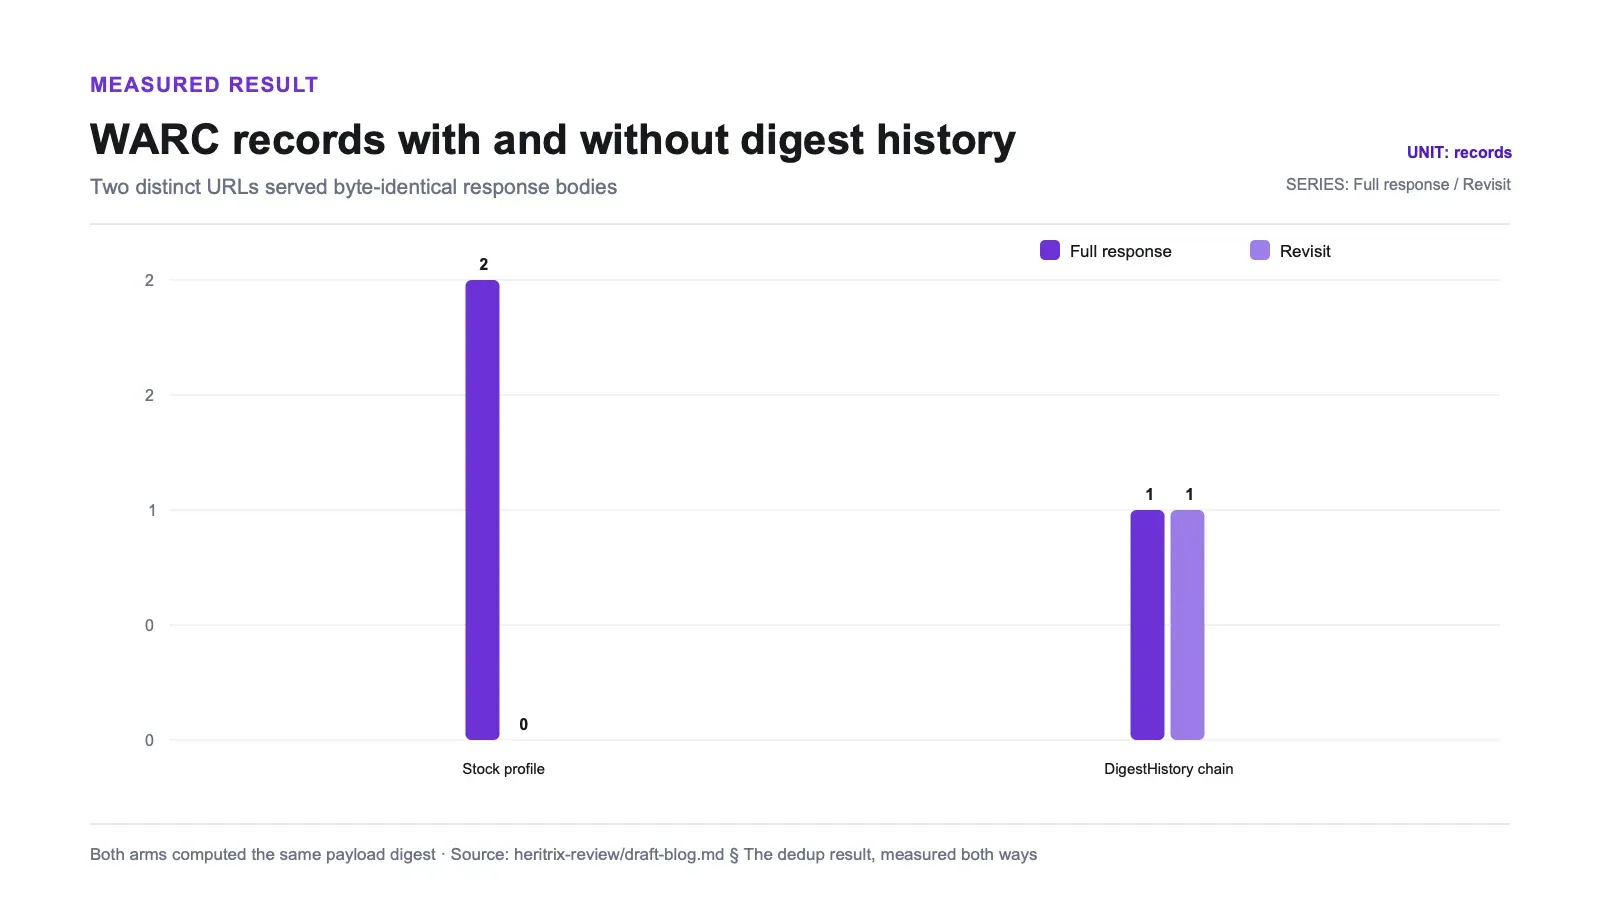
Mój fixture serwował /dup/one i /dup/two z body identycznym bajt w bajt. Różne URL-e, ta sama treść — dokładnie taki przypadek, do którego deduplikacja po content-digest została stworzona. Uruchomiłem to dwa razy: raz ze standardowym profilem, a raz po wstawieniu łańcucha historii digestów (BdbContentDigestHistory, plus ContentDigestHistoryLoader w łańcuchu pobierania i ContentDigestHistoryStorer po zapisie WARC).
| Standardowy profil domyślny | Z łańcuchem ContentDigestHistory | |
|---|---|---|
Zapisane pełne rekordy response | 2 | 1 |
Zapisane rekordy revisit | 0 | 1 |
| Wspólny digest ładunku | tak (oba) | tak |
| Profil revisit | — | identical-payload-digest |
Domyślnie oba odpowiedzi dostały ten sam digest, ale żaden procesor historii nie zareagował i oba ładunki zostały zapisane w pełnej formie. Dodanie łańcucha zmieniło drugie przechwycenie w rekord WARC revisit wskazujący na identyczny digest ładunku — dokładnie taki mechanizm, jaki definiuje specyfikacja WARC 1.1 dla revisitów.
Nic z tego nie jest tajemnicą. Strona wiki Duplication Reduction Processors jasno mówi, że skipIdenticalDigests domyślnie ma wartość false, a deduplikacja niezależna od URL wymaga tych beanów loadera i storer’a. To nie jest ukryte zachowanie odkryte przypadkiem; jak prawie wszystko mierzone tutaj, to udokumentowane działanie Heritrix z liczbą z pierwszej ręki. Luka jest między dokumentacją a tym, w co ludzie wierzą — a z mojego doświadczenia zwykle brzmi to: „Heritrix deduplikuje”, kropka, bez gwiazdki o konfiguracji.
Dwie konsekwencje, które warto zapamiętać:
Deduplikacja działa przy zapisie, nie przy transferze. To już kwestia mechanizmu niż osobnego pomiaru, ale wynika bezpośrednio z tego, jak działają digesty treści: porównać digest można dopiero po pobraniu bajtów, więc drugi URL i tak zostaje pobrany z oryginału. Włączenie tego łańcucha zmniejsza to, co zapisujesz, a nie to, co przesyłasz lub co serwer docelowy musi dostarczyć. Każdy, kto liczy deduplikację jako oszczędność uprzejmości albo pasma, myśli odwrotnie.
Szacunki miejsca na dysku oparte na założeniu „to się zdeduplikuje” mogą być bardzo błędne. Jeśli archiwizujesz witrynę z dużą ilością powielanych szablonów — lustrzane PDF-y, strony docelowe z boilerplate’em, wersje „print” tych samych artykułów — i liczysz pojemność zakładając, że identyczne body się skurczą, standardowy profil może zużyć znacznie więcej miejsca niż wynikałoby z takiego szacunku. Test z dwoma URL-ami pokazuje zachowanie domyślne, a nie jego skutki przy milionie URI; te skutki zależą od odsetka duplikatów, rozmiaru ładunków i sposobu ponownego crawlownia.
Zakres i robots zrobiły dokładnie to, co obiecują
Słowom samego crawlera o tym, czego nie pobrał, warto ufać bardzo umiarkowanie, więc oba te przypadki zmierzyłem przez licznik po stronie serwera — sam target zliczał żądania, niezależnie od tego, co Heritrix zapisał w logach.
| Kontrola | Warunek | Trafienia po stronie serwera na target | Co pokazał log crawl |
|---|---|---|---|
| Zakres | Domyślny scope; seed wskazywał stronę z linkiem do drugiego hosta o odrębnym autorytecie SURT | 0 | host spoza zakresu w ogóle się nie pojawił — czyli został odrzucony na etapie odkrycia, a nie zakolejkowany i potem odrzucony |
| Robots | Domyślna polityka obey; strona główna linkowała do /robots-denied/secret, którego robots.txt w fixture zabraniał | 0 | zapisane jako zablokowane (robots.txt został pobrany) |
| Robots | Kontrola: robotsPolicyName przełączone na ignore, ponowne uruchomienie | 1 | — |
Zakres. W międzyczasie host mieszczący się w zakresie został crawlowny normalnie, więc scope był egzekwowany poprawnie, a nie crawl był po prostu zepsuty. Warto jednak dodać zastrzeżenie: tutaj uruchomiłem wyłącznie wariant z domyślnym zakresem, bez pozytywnej kontroli na rozszerzonym zakresie, więc traktuj to jako potwierdzenie udokumentowanego projektu, a nie dwustronny dowód.
Robots. Link zawsze był osiągalny; tylko polityka robots go zablokowała. Posłuszeństwo jest realne i obejście też jest realne — i to jest właściwy układ, bo niektóre zlecenia archiwizacyjne rzeczywiście mogą nadrzędnie wymagać ignorowania robots, a taka decyzja powinna wymagać świadomego wpisania ignore do pliku konfiguracyjnego.
Uprzejmość: 57,7 sekundy na zarchiwizowanie dwudziestu lokalnych stron
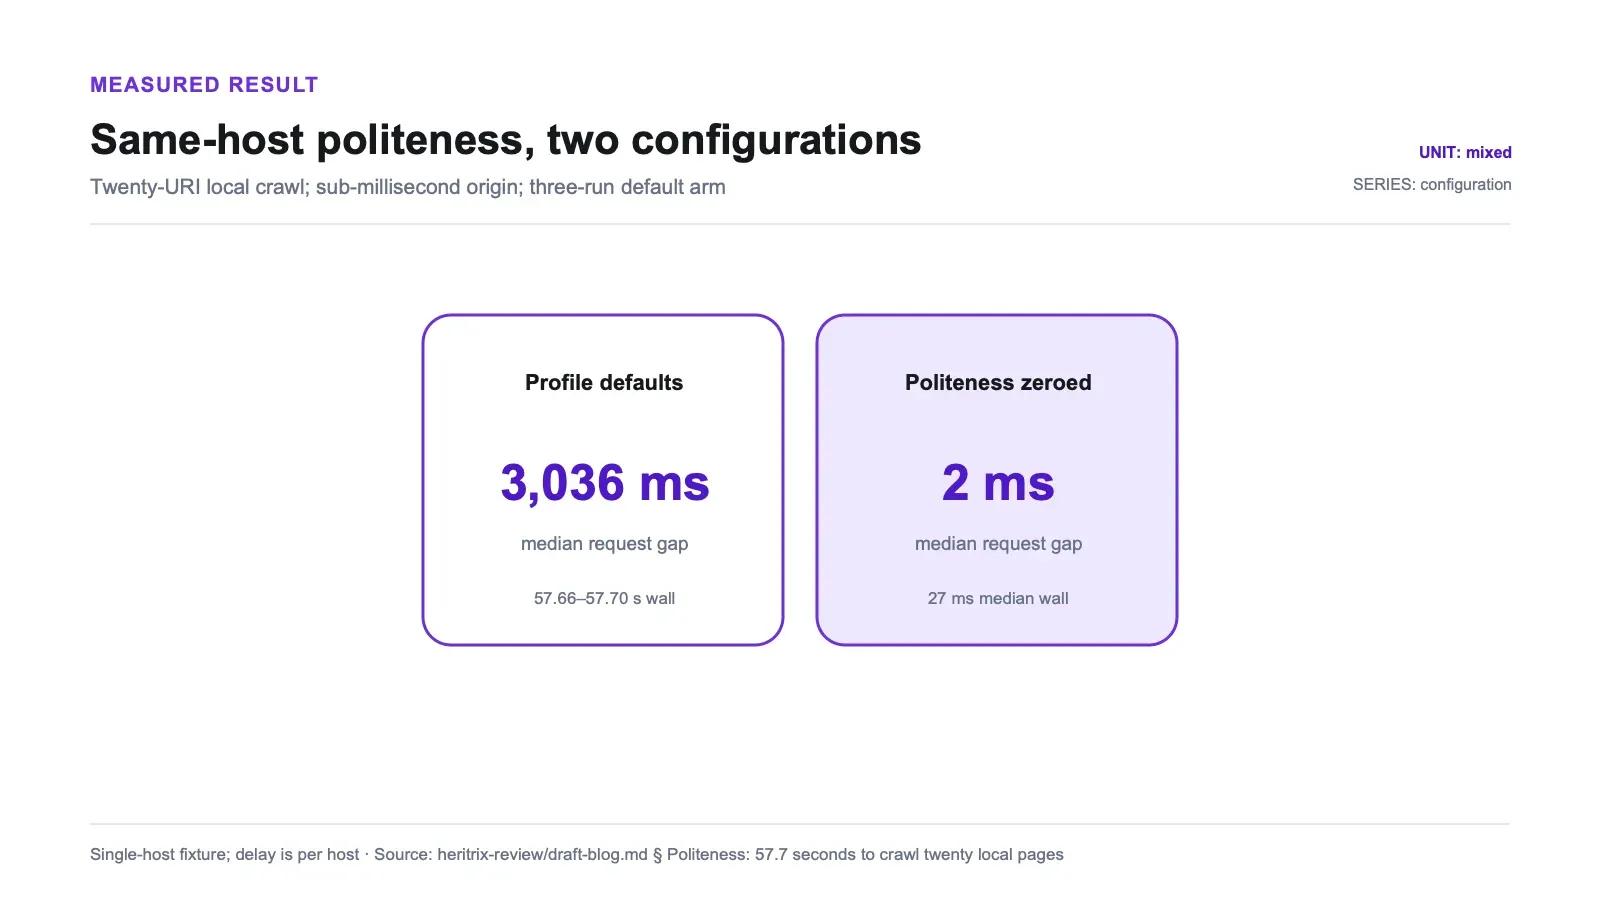
Jedna liczba decyduje o tym, czy Heritrix pasuje do Twojego projektu.
Ten sam fixture, ten sam trzybiegowy pomiar, na jednym lokalnym hoście z opóźnieniem liczonym w mikrosekundach:
| Ustawienie uprzejmości | Mediana przerwy między żądaniami do tego samego hosta | Czas całkowity pełnego crawla 20 URI |
|---|---|---|
Domyślne ustawienia profilu (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3 036 ms (min. 3 021, max. 9 107, w 48 zmierzonych odstępach) | 57,66 s / 57,66 s / 57,70 s (trzy uruchomienia) |
| Uprzejmość wyzerowana | 2 ms | 27 ms (mediana) |
Rzeczywiste opóźnienie ląduje dokładnie na podłodze minDelayMs: przy źródle o opóźnieniu poniżej milisekundy delayFactor × czas_pobrania jest znikome, a minimum dominuje z definicji. Stosunek między wierszami nie jest tu zbyt użyteczny, bo mianownik dla zerowej uprzejmości to zaledwie dziesiątki milisekund i wynik faluje między uruchomieniami. Stabilny wniosek to absolutne minimum: domyślny Heritrix czekał około trzech sekund między żądaniami do tego samego hosta w tym fixture, zamieniając crawl dwudziestu stron w około minutę czasu ściennego.
Jak to poczuć w praktyce. Załóżmy, że biblioteka uniwersytecka musi zarchiwizować rządową witrynę liczącą 50 000 stron, zanim zostanie wyłączona, i wszystko jest na jednym hoście. Przy podłodze 3 sekund na hosta oznacza to 150 000 sekund wymuszonego czekania — około 42 godzin, czyli mniej więcej dzień i trzy czwarte, jeszcze zanim doliczysz sam czas pobierania. To zwykła arytmetyka z mojego zmierzonego minimum 3 036 ms — 50 000 × 3,036 s = 151 800 s = 42,2 h; nawet przy skonfigurowanym minimum 3 000 ms daje to 41,7 h, co zaokrągla się do 42, nie 41. To nie jest zmierzony crawl, ale to jest arytmetyka, której potrzebuje plan projektu.
Dla uczciwości: uprzejmość Heritrix działa per host, bo frontier kolejkowany jest według hostów. Szeroki crawl po tysiącach domen równolegle rozkłada się na te kolejki i nie dziedziczy tego limitu globalnie. Mój fixture był jednym hostem, czyli najgorszym przypadkiem dla tej konkretnej liczby. Jeśli Twój cel archiwizacyjny to jedna duża witryna, ten najgorszy przypadek jest właśnie Twoim przypadkiem.
I to jest cecha, nie wada. To właśnie opóźnienie sprawia, że archiwalny crawler jest czymś, co właściciel strony toleruje, a nie blokuje. Zmniejszenie go to decyzja dotycząca cudzego serwera, a narzędzie tę decyzję pokazuje wprost, zamiast domyślnie iść w agresję.
Czego nie testowałem
Te pomiary obejmują dyscyplinę crawla na kontrolowanym fixture i nic więcej. Poza ich zakresem pozostaje:
- Deduplikacja między crawlami i recrawl. Mierzyłem tylko deduplikację po content-digest wewnątrz jednego crawla. Utrzymywanie bazy historii URI między osobnymi crawlami (
FetchHistoryProcessor+PersistLog) to inny mechanizm i go nie testowałem. - Skala i stabilność długoterminowa. Brak frontieru na milion URI, brak checkpoint-and-restore, brak wielodniowego uruchomienia. Mój fixture mierzy dyscyplinę, nie wytrzymałość.
- Przechwytywanie renderowane przez JavaScript. Domyślne przechwytywanie w Heritrix nie używa przeglądarki i właśnie to mierzyłem. Opcjonalne zachowania oparte na przeglądarce tutaj nie były testowane.
- Uprzejmość wobec źródła o dużym opóźnieniu. Lokalne opóźnienie jest poniżej milisekundy, więc
minDelayMsdominuje z definicji. JakdelayFactorskaluje się wobec wolnego, rzeczywistego serwera, nie wynika z moich danych. - Skuteczność sitemap. robots.txt został pobrany i dyrektywa sitemap została wykonana, ale osobno nie potwierdzałem każdego wpisu
<loc>.
Co warto doprecyzować przed pierwszym produkcyjnym crawl’em
Standardowy profil jest długi, ale decyzje wpływające na znaczenie archiwum są dość zwarte. Zacznij od scope. Seedy generują domyślne prefiksy SURT, a DecideRules mogą je po kolei rozszerzać lub zawężać. Przejrzyj końcową kolejność reguł na reprezentatywnych URL-ach z zakresu i spoza zakresu, a potem zweryfikuj to na podstawie ruchu po stronie serwera albo innego niezależnego logu żądań. Sam raport crawla nie dowodzi, że wykluczony host nigdy nie był kontaktowany.
Następnie zdecyduj, co dla kolekcji oznaczają polityka robots i tożsamość operatora. Testowany domyślny wariant respektował regułę disallow z fixture, a zmiana robotsPolicyName na ignore spowodowała pobranie zablokowanej ścieżki. To przełącznik prosty technicznie, ale istotny instytucjonalnie. Zapisz, kto go zatwierdził i dlaczego, razem z działającym operatorContactUrl; wymagany URL daje właścicielowi witryny drogę powrotną do operatora, ale nie podaje uzasadnienia autoryzacji.
Planowanie miejsca na dysku wymaga własnej, jawnej decyzji. Jeśli identyczne body mają stać się rekordami revisit, dodaj i przejrzyj procesory historii content-digest zanim oszacujesz rozmiar archiwum. Testowany łańcuch wpływał na reprezentację po pobraniu, więc ruch do źródła nadal trzeba liczyć dla obu URL-i. Deduplikacja między crawlami to osobny mechanizm i nie należy jej wnioskować z tego dwukluczowego, jednocrawlnego wyniku. Mały crawl walidacyjny ze znanymi identycznymi body to tani sposób na potwierdzenie, że wdrożony graf beanów tworzy właściwe typy rekordów.
Na koniec traktuj uprzejmość jako wejście do planowania, a nie ostatni suwak do dostrojenia. Na lokalnym fixture z jednym hostem minDelayMs dominowało całkowity czas. Prawdziwy projekt powinien policzyć skonfigurowane minimum per host względem liczby hostów docelowych i terminu kolekcji, a potem przetestować to na reprezentatywnym opóźnieniu. Szerokie crawle i crawle jednej witryny inaczej obciążają frontier podzielony według hostów; ta recenzja mierzyła tylko ten drugi przypadek. Zachowaj też cykl życia REST w runbooku: build, launch, unpause, poll, terminate i teardown to osobne stany, które warto obserwować w automatyzacji.
Plusy i minusy
Plusy
- Domyślna kompletność archiwizacji jest bardzo dobra: 20/20 odpowiedzi z digestem ładunku, adresem IP przechwycenia i pełnym powiązaniem request↔response, bez żadnej konfiguracji.
- Zachowuje odpowiedzi błędowe jako fakty — statusy 200, 404 i 500 zapisane dosłownie.
- Dyscyplina zakresu potwierdzona licznikiem po stronie serwera: zero pobrań spoza zakresu, podczas gdy host w zakresie crawlował normalnie.
- Posłuszeństwo robots naprawdę blokuje pobranie, a świadome
ignoredaje legalnie przewidziane obejście dla wymaganej archiwizacji. - Pełna obsługa bez UI przez REST — tworzenie, build, start, polling, teardown, wszystko przez
curl, bez klikania. - Działa czysto na OpenJDK 26.0.1 bez flag JVM, co jest lepszym poziomem higieny nowoczesnej Javy niż w większości dwudziestoletnich baz kodu.
- Obowiązkowy kontaktowy URL operatora sprawia, że crawler nie może działać anonimowo.
- Każda część crawla jest wymienialnym beanem, dlatego włączenie deduplikacji wymagało trzech wstawek beanów, a nie forka.
Minusy
- Deduplikacja po content-digest jest domyślnie wyłączona i zapisuje identyczne ładunki w całości — realna pułapka przy planowaniu miejsca.
- Wdrożenie jest ciężkie: dystrybucja 41 MB, 114 JAR-ów, silnik Javy plus Jetty i około 750 linii konfiguracji Spring.
- Domyślna uprzejmość narzuca około 3-sekundową podłogę per host; crawl 20 URI na jednym hoście trwał 57,7 s.
- Domyślna ścieżka nie renderuje JavaScriptu, więc treści dostępne wyłącznie po stronie klienta nie zostaną przechwycone.
- Powierzchnia konfiguracji premiuje doświadczenie i karze przypadkowe użycie; nie ma pięciominutowej ścieżki do pierwszego crawla.
- Nic w wyjściu nie jest danymi strukturalnymi. Wyciągnięcie pól z WARC to osobny projekt.
Kto powinien go używać, a kto powinien odejść
Heritrix jest dla instytucji i zespołów, których rezultatem końcowym jest sam archiwum. Biblioteki, archiwa narodowe, zachowanie na potrzeby prawne i compliance, grupy badawcze zbierające sieć jako źródło pierwotne, każdy, kto za pięć lat musi udowodnić, co konkretny URL pokazywał w danym dniu. Jeśli w Twoim słowniku już pojawiają się słowa „WARC”, „replay” i „provenance”, to jest narzędzie, wokół którego zbudowano resztę ekosystemu — a jego ciężar to cena tej interoperacyjności.
Frontier podzielony według hostów i długie doświadczenie w web archivingu sprawiają, że jest on sensownym kandydatem do szerokich crawlów po wielu domenach. To jednak wniosek architektoniczny i historyczny, a nie wynik skalowania z tego testu; przepustowość w długim okresie, odzyskiwanie checkpointów i zachowanie przy milionie URI nie zostały tu sprawdzone.
Pomiń go, jeśli chcesz danych, a nie archiwum. Jeśli Twoim celem jest arkusz z produktami, ofertami albo kontaktami, Heritrix świetnie zapisze strony, które potem i tak będziesz musiał przepuszczać przez osobny pipeline parsera — a zapłacisz za to silnikiem Javy, konfiguracją Spring i 3-sekundową podłogą uprzejmości. Pomiń go też, jeśli celujesz w aplikacje SPA renderowane po stronie klienta, gdzie fetcher bez przeglądarki zapisuje tylko shell, a nie treść; w takim przypadku właściwym narzędziem jest archiwizator oparty na przeglądarce. I pomiń go, jeśli potrzebujesz pierwszego wyniku dziś, bo krzywa wejścia jest realna.
Alternatywy i gdzie pasuje zarządzane API
W obszarze archiwizacji bezpośrednim współczesnym odpowiednikiem jest Browsertrix Crawler — archiwizator oparty na przeglądarce, który steruje Chromium i zapisuje to, co zrobiła przeglądarka. Może przechwycić treści generowane przez JavaScript, których nie ma w domyślnych odpowiedziach HTTP Heritrix, ale wiąże się to z dodatkowym kosztem wdrożenia i działania przeglądarki. Ta recenzja nie przeprowadzała testu head-to-head, więc decyzję zaczyna się od wymagań przechwytywania: stan generowany przez przeglądarkę wskazuje na archiwizator przeglądarkowy; zwykłe zasoby HTTP pozostają naturalną ścieżką Heritrix.
Powiązana recenzja: Recenzja Browsertrix Crawler.
W zupełnie innym rodzaju problemu — nie chcesz archiwum, tylko danych strukturalnych ze stron — porównuj Heritrix z systemami ekstrakcyjnymi po wyniku, a nie traktuj ich jak równoważnych crawlerów. Heritrix jest darmowy i self-hosted: uruchamiasz JVM, sam opiekujesz się plikiem beanów, planujesz dysk i ustawiasz uprzejmość. Taki model pasuje tam, gdzie celem jest zachowanie.
Ujawnienie: Thunderbit jest produktem wydawcy i nie był testowany w tym fixture Heritrix. Należy do kategorii zarządzanej ekstrakcji: jego wynikiem jest treść stron lub rekordy strukturalne, a nie pliki WARC o jakości archiwalnej. Wybierz archiwizator, gdy potrzebujesz odtwarzalnego przechwycenia i pochodzenia; rozważ usługę ekstrakcyjną, gdy rezultatem mają być wiersze albo tekst dokumentów, a zarządzana obsługa jest akceptowalna.
Archiwizacja niesie własne pytanie o uprawnienia, i nie jest ono tym samym, co w scrapingu. Heritrix domyślnie respektuje robots.txt i wymaga, byś się zidentyfikował, zanim pobierze choćby bajt — to dobry punkt wyjścia, ale crawl zgodny z robots nie jest automatycznie crawl’em autoryzowanym. Prawo autorskie, regulaminy, dane osobowe i mandat Twojej instytucji nakładają się na to osobno, a polityka ignore istnieje dla organizacji mających podstawę prawną do jej użycia, nie jako wygodny przełącznik. Jeśli uruchamiasz program archiwizacji, uporządkuj zakres autoryzacji zanim zapełnią się dyski, a jeśli to nowy temat, przeczytaj o prawnych aspektach web scrapingu i archiwizacji.
Wypróbuj Thunderbit do ekstrakcji danych z sieci
Werdykt
Czy warto używać Heritrix? Tak — jeśli Twoim rezultatem ma być archiwum i masz kogoś gotowego nauczyć się beanów Spring.
Fixture daje jasną odpowiedź: standardowy profil konsekwentnie zachowywał odpowiedzi, requesty i metadane przechwycenia; kontrola zakresu i robots wpływały na pobrania po stronie serwera zgodnie z konfiguracją; a cały cykl życia zadania działał przez REST. To są wartościowe cechy w archiwalnym pipeline, w granicach małego, pojedynczego hosta testowanego tutaj.
Koszty operacyjne są równie jasne: dystrybucja Javy i duża konfiguracja Spring, skonfigurowane per-host opóźnienie, które dominowało ten lokalny crawl, oraz deduplikacja po content-digest wymagająca dodatkowych procesorów historii. Zespoły, które potrzebują zgodności z WARC, mogą zaakceptować te koszty; zespoły, które potrzebują wyekstrahowanych pól, powinny zacząć w innej kategorii.
Przed produkcyjnym crawl’em sprawdź łańcuch deduplikacji, ustawienia uprzejmości, scope, politykę robots, tożsamość operatora i założenia dotyczące miejsca na dysku względem rzeczywistej konfiguracji zadania. Standardowy profil to punkt startowy, a nie domyślne stwierdzenie tych decyzji operacyjnych.
Wypróbuj Thunderbit do ekstrakcji danych z sieci Get Started Free
FAQ
Czy operatorContactUrl sprawia, że crawl jest autoryzowany?
Nie. Wymusza dołączenie kontaktowego URL do zadania, co daje operatorom witryny ścieżkę kontaktu, ale nie ustanawia zgody, poprawności tożsamości, statusu praw autorskich ani zgodności regulacyjnej. To nadal decyzje wdrożeniowe poza crawlerem.
Czy deduplikacja po content-digest zmniejsza liczbę żądań do źródła? Nie w testowanej tutaj konfiguracji. Oba URL-e zostały pobrane, zanim można było porównać ich digesty ładunku. Łańcuch historii zmienił sposób reprezentacji drugiego ładunku w zapisie WARC; nie spowodował pominięcia drugiego żądania sieciowego.
Czy Heritrix może działać bez swojego UI?
Tak. Testowany cykl życia — utworzenie, upload konfiguracji, build, start, wznowienie, polling, zakończenie i teardown — działał przez REST API z użyciem curl. Osadzony interfejs Jetty nie był potrzebny.
Czy standardowy profil Heritrix deduplikuje identyczne ładunki? Nie w tej konfiguracji fixture. Standardowy profil zapisał oba identyczne response’y jako pełne rekordy response. Dodanie łańcucha historii content-digest zmieniło drugie przechwycenie w rekord revisit, więc deduplikacja jest decyzją pipeline’u, którą trzeba skonfigurować i zweryfikować, a nie automatycznym domyślnym działaniem.
Jak dobrać opóźnienie uprzejmości? Traktuj lokalne czasy z tego testu jako sprawdzenie mechanizmu, a nie rekomendację produkcyjną. Ustaw opóźnienie na podstawie zasad witryny docelowej, zgody operatora, wydajności serwera, celu crawla oraz własnej polityki ponawiania i współbieżności, a potem potwierdź rzeczywiste odstępy między żądaniami do tego samego hosta w logach.




