
Każda lista typu „najlepsze Proxy API” ryzykuje ten sam błąd kategorialny: wrzuca Bright Data, Thunderbit i Apify do jednego worka, jakby rywalizowały o dokładnie to samo zadanie. A tak nie jest. Jeden produkt może zapewniać routowany dostęp IP, inny zwracać ustrukturyzowany JSON, a jeszcze inny uruchamiać zaplanowany workflow scrapujący. Porównywanie ich po jednej cenie startowej to jak zestawianie węża ogrodowego z oczyszczalnią wody.
Ten poradnik mapuje dziesięć produktów z obszaru proxy, zarządzanego scrapingu, ekstrakcji i platform, opierając się na oficjalnej dokumentacji pobranej 10 sierpnia 2026 r. Nie wyłania jednego uniwersalnego zwycięzcy ani nie powtarza marketingowych deklaracji o skuteczności. Zamiast tego daje Ci sposób na zdefiniowanie poprawnego wyniku, zawężenie shortlisty według kategorii i przeprowadzenie autoryzowanego pilota na własnych celach.
Dlaczego „Proxy API” nie oznacza jednej rzeczy
Oto źródło zamieszania stojące za każdym wątkiem „jakie Proxy API wybrać”: ten termin obejmuje co najmniej cztery naprawdę różne produkty.
Surowa sieć proxy daje Ci adres IP i kontrolę nad routingiem — dalej sam piszesz logikę żądań, obsługujesz ponowienia, renderujesz JavaScript, jeśli trzeba, i parsujesz to, co wróci. To najbliższe podręcznikowej definicji proxy: RFC 9110 opisuje je jako pośrednika przekazującego komunikaty, którego wybiera klient, i nic więcej.
Zarządzane API do odblokowywania lub przeglądarki przejmuje większą część cyklu życia żądania. Wysyłasz URL, usługa dobiera IP, renderuje stronę, jeśli to potrzebne, ponawia próbę w razie błędu i odsyła HTML, zrzut ekranu albo czasem Markdown.
API ekstrakcyjne idzie jeszcze poziom wyżej — dostajesz z powrotem ustrukturyzowany JSON albo czysty tekst, a nie surowy HTML, który trzeba samemu rozbierać.
Platforma do scrapingu opakowuje to wszystko razem z harmonogramami, przechowywaniem danych i często marketplace’em gotowych scraperów.
Dlaczego to ma znaczenie w artykule o wyborze Proxy API? To proste: cena i „skuteczność” nie są porównywalne między tymi kategoriami. Sieć proxy rozliczana ruchem i zarządzane API rozliczane żądaniami rozwiązują różne problemy. Mają różne mianowniki, zakres pracy w cenie i semantykę wyniku, więc ranking oparty na cenie katalogowej byłby mylący. Dlatego każdy profil poniżej zaczyna się od kategorii produktu.
Jeszcze jedna ważna rzecz na wstępie: sam dostęp do proxy nie daje Ci pozwolenia na scrapowanie wszystkiego, na co masz ochotę. Autoryzacja, regulamin celu i obowiązki związane z prywatnością danych to osobny temat od pytania „który dostawca ma największą pulę IP” — i żadne Proxy API, nawet najlepsze, tego nie zmienia.
Jak ocenić te 10 opcji
Nie istnieje uczciwa, stała waga, która działałaby dla każdego zespołu. Archiwum surowego HTML, monitor cen zależnych od lokalizacji i workflow wzbogacania danych w oparciu o strukturę mają inne wymagania. Zacznij od tych kryteriów, przypisz wagi sumujące się do 100 i oceniaj wyłącznie na podstawie własnego pilota albo udokumentowanego wymagania:
| Kryterium | Co mierzyć |
|---|---|
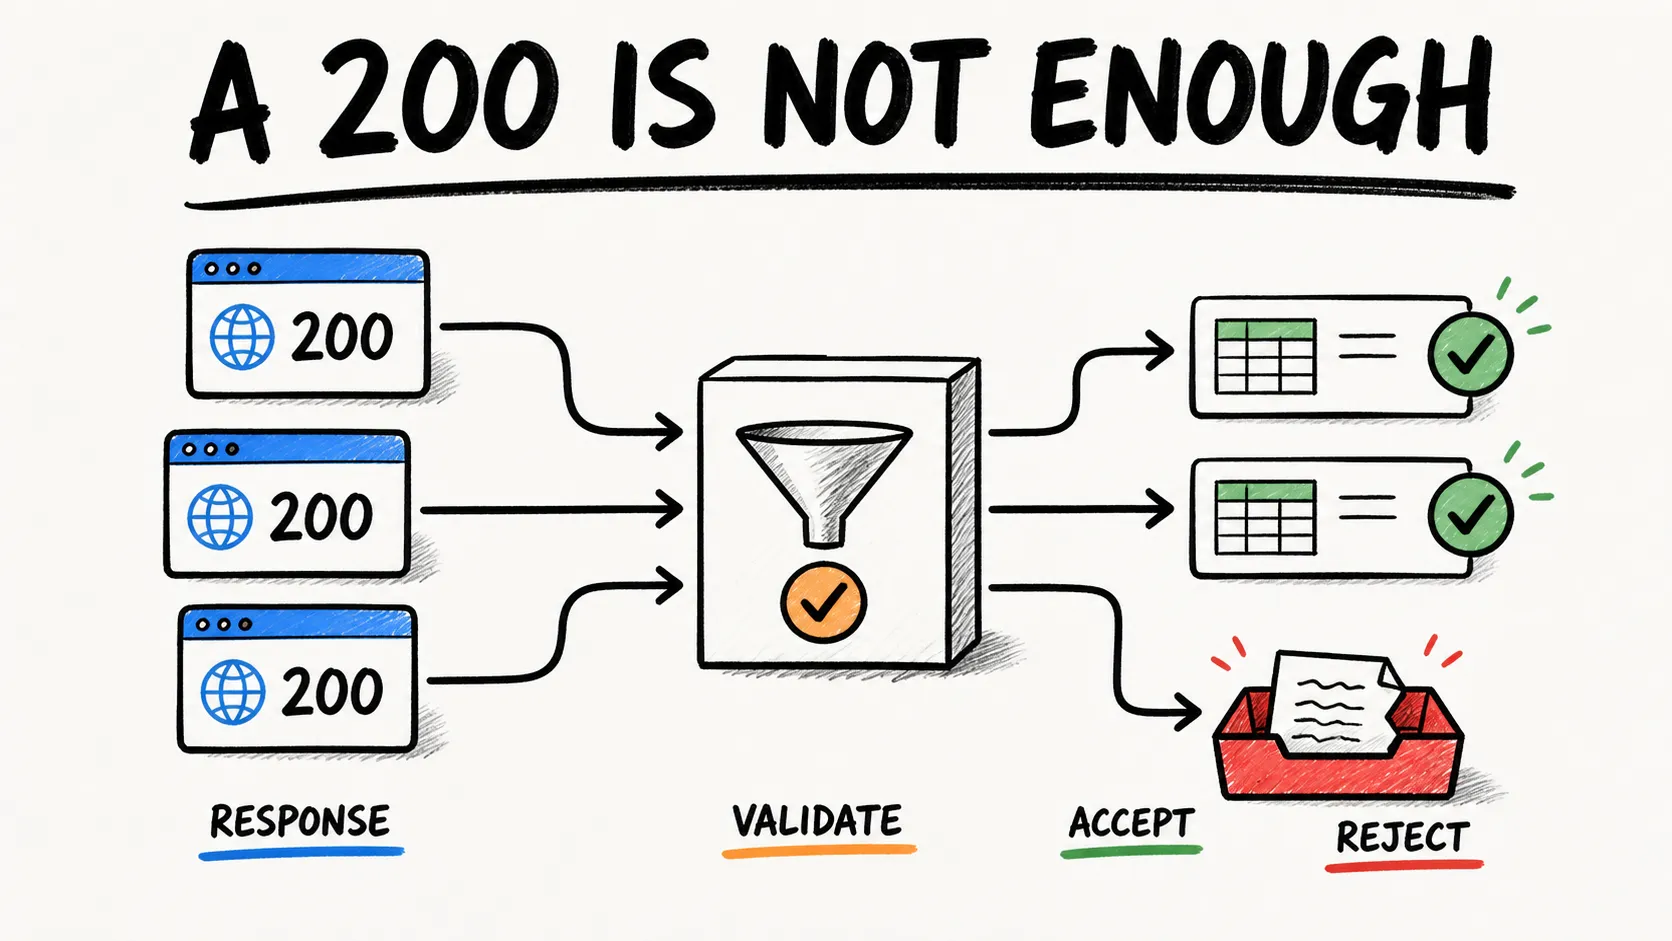
| Wskaźnik poprawnych wyników | Odsetek prób, które przechodzą Twój walidator semantyczny, a nie tylko zwracają HTTP 200 |
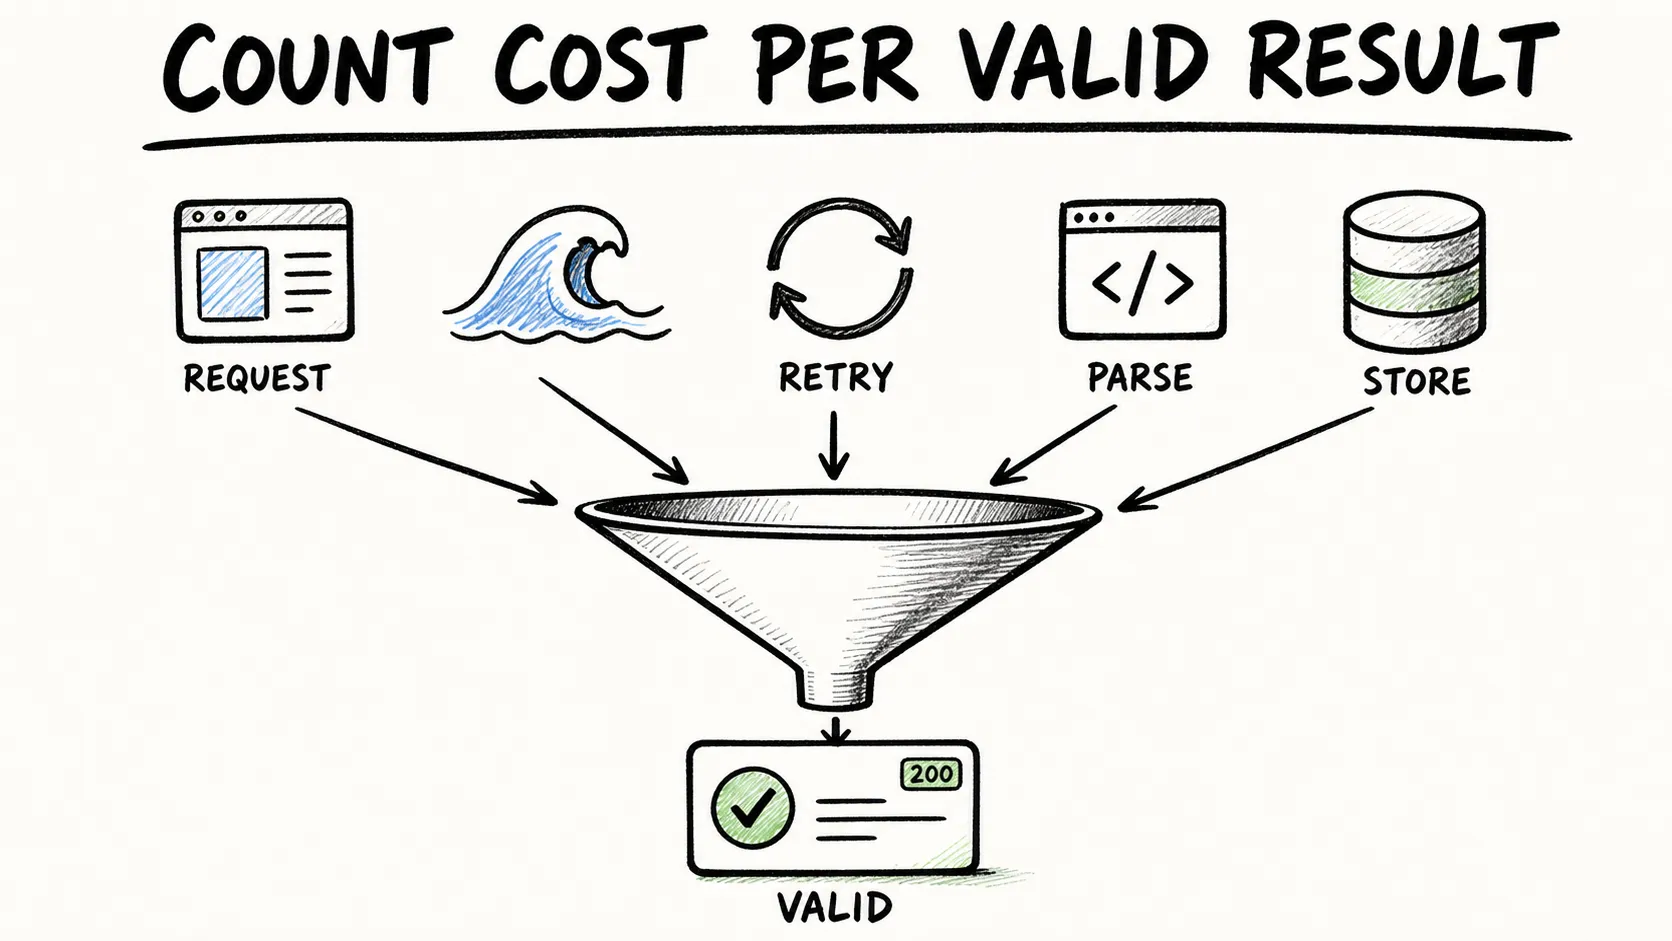
| Koszt za poprawny wynik | Wszystkie koszty żądań, ruchu, renderingu, ponowień, parsowania, przechowywania i pracy operatora podzielone przez liczbę poprawnych wyników |
| Dopasowanie formatu wyjścia | Surowa odpowiedź, renderowany HTML, zrzut ekranu, Markdown albo dane w określonym schemacie |
| Kontrola połączenia i geolokalizacji | Region, miasto, ASN, sesja, rotacja, nagłówki, cookies i protokół, których naprawdę potrzebujesz |
| Obserwowalność i limity | Request ID, nagłówki rozliczanych jednostek, logi, replay, kontrola współbieżności i limity budżetu |
| Dowody zgodności | Oświadczenia o sourcingu, umowy, kwalifikacja celu, audytowalność i proces wsparcia |
| Nakład pracy inżynierskiej | Integracja, utrzymanie parsera, monitoring i czas ręcznych napraw |
Pozostaw nieobsługiwane pola puste albo oznacz je jako „nie dotyczy”. Celem jest decyzja dopasowana do konkretnego obciążenia, a nie wynik udający fałszywą precyzję.
1. Thunderbit
Thunderbit jest wyjątkiem na tej liście, bo to sąsiednie API do ekstrakcji, a nie surowa sieć proxy podpinana do klienta HTTP. Publiczna dokumentacja API opisuje Distill dla Markdown, Extract dla JSON-a zgodnego ze schematem oraz Batch dla asynchronicznych zestawów URL-i. Taka granica może usunąć kilka kroków po drodze, gdy docelowym wynikiem ma być treść albo rekordy, a nie samo połączenie proxy.
Praktyczna różnica pojawia się od razu po wysłaniu żądania. W tradycyjnym Proxy API udany call daje Ci surowy HTML — czyli dopiero połowę pracy. W endpointcie Thunderbit POST /extract przekazujesz docelowy URL i schemat JSON opisujący potrzebne pola, a w odpowiedzi dostajesz już gotowy, uporządkowany JSON zgodny z tym schematem. Bez pisania selektorów CSS, bez utrzymywania parsera, gdy strona w Q3 przebuduje kartę produktu.
To właśnie ta granica produktu jest realnym atutem: wywołujący może zdefiniować schemat wyjścia zamiast utrzymywać osobno proxy, renderer i parser. Nadal wymaga to jednak prawdziwego pilota. Zanim wdrożysz rozwiązanie, zweryfikuj kompletność pól, obsługę celu, opóźnienie, bieżące zużycie jednostek, współbieżność i zachowanie przy błędach na autoryzowanych URL-ach.
Najważniejsze cechy:
- Ustrukturyzowane wyjście domyślnie — JSON zgodny z określonym schematem, a nie surowy HTML
- Udokumentowane sterowanie renderowaniem i routingiem — oceniane w ramach endpointu ekstrakcji, a nie jako osobny produkt proxy
- Granica API HTTP — Distill, Extract i Batch obsługują Markdown, ustrukturyzowany JSON oraz asynchroniczne zestawy URL-i
- Tryb Batch do asynchronicznych zadań na wielu URL-ach, przydatny przy czymś więcej niż kilku stronach
- Ekstrakcja oparta na schemacie, która zmniejsza, ale nie usuwa, potrzeby walidacji i utrzymania na poziomie pól
Jednostka rozliczeniowa: Distill i Extract korzystają z udokumentowanych jednostek na stronę, a nie z przepustowości proxy. Sprawdź aktualne ceny Thunderbit i dokumentację API przed planowaniem budżetu, bo jednostki i plany mogą się zmieniać.
Najlepsze dla: developerów, którzy chcą od razu zweryfikowanych, ustrukturyzowanych danych i nie chcą samodzielnie budować ani utrzymywać pipeline’u z rotacją proxy i parserem.
Gdzie klasyczne Proxy API nadal wygrywa: jeśli potrzebujesz surowego HTML do własnego pipeline’u, masowej archiwizacji albo nietypowego protokołu innego niż HTTP, model ustrukturyzowanego wyjścia w Thunderbit nie będzie właściwym narzędziem — wtedy faktycznie potrzebujesz jednej z dziewięciu kolejnych pozycji.
Pomiń proxy dzięki ekstrakcji opartej na AI Agentowy web scraper Thunderbit sam radzi sobie z renderingiem i blokadami anty-bot, więc wiele zadań nie wymaga osobnego Proxy API. Get Started Free
2. Bright Data
Bright Data jest najbliższe pozycji rynkowego lidera w tej branży, oferując sieci proxy residential, datacenter, ISP i mobile oraz osobny produkt zarządzany o nazwie Web Unlocker. Słowo „osobny” ma tu znaczenie — Bright Data nie jest jednym produktem, tylko całym zestawem, a ceny i zachowanie mocno zależą od tego, który element kupujesz.
Dokumentacja sieci Residential wymienia targetowanie według kraju, regionu, miasta, ZIP i ASN. Web Unlocker to osobna warstwa zarządzana z rozliczaniem pay-per-success i miesięcznym limitem wydatków. To użyteczne mechanizmy, ale ich dokładność i dopasowanie nadal trzeba potwierdzić w pilocie po stronie kupującego; ten przewodnik nie wykonywał międzydostawcowego benchmarku geolokalizacji.
Najważniejsze cechy:
- Typy proxy residential, datacenter, ISP i mobile z precyzyjnym targetowaniem geo
- Zarządzane API Web Unlocker z rozliczeniem pay-per-success i limitami wydatków
- Udokumentowane, dobrowolne oświadczenie o sourcingu dla IP residential
- Pola debugowe (request ID, stan rozliczenia, kraj peer) ułatwiające diagnostykę
Jednostka rozliczeniowa: produkty raw proxy i Web Unlocker korzystają z różnych jednostek. Przed planowaniem budżetu potwierdź dokładny produkt, zobowiązanie, kwalifikację celu i aktualną stawkę na oficjalnych stronach z cenami.
Najlepsze dla: zespołów enterprise, które potrzebują pełnego wyboru typów proxy i są gotowe zarządzać nieco bardziej złożonym portfolio produktów w zamian za skalę.
3. Oxylabs
Oxylabs gra w tej samej lidze co Bright Data — sieci proxy residential, datacenter, ISP i mobile plus osobny produkt Web Unblocker do zarządzanego dostępu. Obsługa sesji wykorzystuje dedykowany nagłówek X-Oxylabs-Session-Id, co daje ciągłość IP w ograniczonym oknie czasu, a to naprawdę przydaje się przy wieloetapowych flow, takich jak stronicowane wyniki wyszukiwania.
Najważniejsze cechy:
- Wiele typów proxy z geo-kontrolami opisanymi przez dostawcę
- Web Unblocker do renderingu JS i zarządzanego odblokowywania, rozliczany obecnie według GB
- Utrzymanie sesji przez nagłówkowe identyfikatory sesji
- Nagłówki job/session w przykładowych odpowiedziach ułatwiające debugowanie
Jednostka rozliczeniowa: strona Web Unblocker pobrana do tego badania korzystała z planów opartych na GB z limitami specyficznymi dla planu; inne produkty Oxylabs używają innych jednostek. Sprawdź ponownie aktualną stronę wybranego produktu.
Najlepsze dla: operacji o dużej skali, które potrzebują różnorodności geo i nie mają problemu z rozliczaniem w GB między produktami.
4. ScrapingBee
ScrapingBee to zarządzane HTML API: wysyłasz URL, otrzymujesz treść strony i zazwyczaj sam odpowiadasz za dalszą walidację oraz parsowanie. Dokumentacja pokazuje system kredytów zależny od funkcji, Auto-Mode, nagłówki kosztów oraz parametr max_cost, który może ograniczyć pojedyncze żądanie Auto-Mode.
Najważniejsze cechy:
- Auto-Mode, który automatycznie eskaluje konfigurację (poziom proxy, rendering) aż do powodzenia
- Parametr
max_cost, który ogranicza wydatki na pojedyncze żądanie - Nieudane próby Auto-Mode we wszystkich konfiguracjach kosztują 0 kredytów
- Nagłówki użycia/kosztu w każdej odpowiedzi do śledzenia w czasie rzeczywistym
Jednostka rozliczeniowa: kredyty różnią się w zależności od renderingu, poziomu proxy i innych włączonych funkcji. Zamiast traktować bazowy plan jako cenę za żądanie, sprawdź aktualną drabinkę kredytową i limity współbieżności.
Najlepsze dla: małych i średnich projektów, w których liczy się szybki start bardziej niż głęboka personalizacja — system kredytów daje naprawdę przewidywalny koszt, gdy już go zrozumiesz.
5. ZenRows
ZenRows łączy w jednym miejscu Universal Scraper API, Scraping Browser i residential proxies, stosując mnożniki żądań za renderowanie JavaScript i użycie premium proxy. Warto jasno zaznaczyć jedną specyfikę: ZenRows zalicza odpowiedzi HTTP 404 i 410 jako „udane” dla celów rozliczeniowych, co jest dobrym przypomnieniem, że „sukces” na fakturze dostawcy i „sukces” w Twoim walidatorze to nie to samo.
Najważniejsze cechy:
- Zestaw narzędzi: scraper API, automatyzacja przeglądarki i proxy residential
- Deklarowane wiele formatów wyjściowych (JSON, Markdown, zrzuty ekranu, plaintext)
- Zarządzane komponenty renderingu i dostępu, których bieżące zachowanie trzeba sprawdzić na autoryzowanych celach
- Limity użycia oparte na URL-ach, które wstrzymują żądania do czasu dokupienia dodatkowej pojemności
Jednostka rozliczeniowa: kredyty za żądania z udokumentowanymi mnożnikami dla funkcji takich jak renderowanie JavaScript i premium proxy. Potwierdź aktualny plan i zasady mnożników.
Najlepsze dla: zespołów, które chcą ocenić scraper API, browser i proxy od jednego dostawcy, testując każdy wybrany produkt na autoryzowanych celach.
Jakie wzorce widać już teraz
Po pięciu narzędziach wzór staje się oczywisty: prawie nikt nie ma granicy produktu dokładnie zgodnej z materiałami marketingowymi. Bright Data i Oxylabs rozdzielają „surowe proxy” od „zarządzanego odblokowywania” na osobne produkty z osobnymi modelami cenowymi, więc strona główna dostawcy nie odpowiada na pytanie „ile to będzie kosztować” — najpierw trzeba wybrać konkretny produkt. ScrapingBee i ZenRows używają rozliczeń kredytowych z narastającymi mnożnikami, co jest bardziej przejrzyste niż ceny za GB, ale nadal wymaga przeczytania drobnego druku dotyczącego tego, co uruchamia mnożnik.
Drugi powtarzalny motyw: „udane żądanie” jest definiowane przez dostawcę, nie przez Ciebie. Liczenie przez ZenRows odpowiedzi 404 jako sukcesów rozliczeniowych nie jest złośliwe — to po prostu niedopasowanie definicji, które ugryzie Cię, jeśli założysz, że „rozliczone jako sukces” znaczy „dane, których potrzebowałem, faktycznie były obecne”.
6. Scrape.do
Scrape.do oferuje zarządzane Web Scraping API z modelem rozliczeń „Successful API Credits” — płacisz tylko za aktualny główny endpoint, ponieważ w nawigacji cenowej firmy osobne produkty proxy i scraping browser są oznaczone jako „coming soon” (warto to sprawdzić, zanim założysz, że Scrape.do sprzedaje dziś surowe proxy). Zakres API obejmuje targetowanie geo, sesje, nagłówki, cookies oraz przełączniki trybu browser/proxy.
Najważniejsze cechy:
- Rozliczenie kredytowe, które zatrzymuje żądania po osiągnięciu miesięcznego limitu (bez niespodziewanego nadmiaru z automatu)
- Dostępny przełącznik premium-network dla kwalifikujących się celów
- Kontrola sesji i geo, którą trzeba sprawdzić na dokładnym workloadzie
- Tryb renderowania browser dla stron ciężkich od JavaScriptu
Jednostka rozliczeniowa: pakietowe successful API credits z miesięcznymi limitami; zweryfikuj aktualne limity planu, współbieżność i zasady dokupowania dodatkowej pojemności.
Najlepsze dla: zespołów dbających o budżet, które chcą zarządzanego API bez wchodzenia w rozliczenia per GB.
7. Smartproxy / Decodo
Smartproxy zmieniło markę na Decodo, a jego aktualna strona z cenami proxy residential dokumentuje plany per-GB i pay-as-you-go z targetowaniem na poziomie ASN oraz sesjami rotacyjnymi i sticky przez HTTP(S)/SOCKS5. Pobierana strona cytuje badania Proxyway jako źródło prezentowanych deklaracji dotyczących wydajności. To użyteczny kontekst, ale nie dowód, że ten sam wynik przeniesie się na inny cel, region, przedział czasu czy konfigurację konta.
Najważniejsze cechy:
- Typy proxy residential, datacenter, ISP i mobile
- Targetowanie na poziomie ASN i lokalizacji
- Obsługa sesji rotacyjnych i sticky przez HTTP(S) oraz SOCKS5
- Deklaracje wydajności oparte na badaniach zewnętrznych, a nie na autoreferencji
Jednostka rozliczeniowa: strona residential pobrana do tego badania dokumentuje opcje per-GB i pay-as-you-go. Potwierdź aktualne stawki i uwzględnione kontrolki na wybranej stronie produktu.
Najlepsze dla: monitoringu e-commerce i operacji średniej skali, które chcą różnorodności proxy bez cen enterprise.
8. Scrapfly
Scrapfly to zarządzane API do scrapingu z opcjonalną funkcją Anti Scraping Protection (ASP). W dokumentacji wprost zaznaczono, że zabezpieczenia po stronie celu się zmieniają, przywrócenie po blokadzie może trwać niepewnie długo, a koszty związane z zasobami mogą się zmieniać. To ważne zastrzeżenie: zarządzany dostęp nie jest gwarancją trwałego dostępu.
Najważniejsze cechy:
- ASP z dynamiczną eskalacją kosztu zależną od trudności celu
- Parametr
cost_budgetoraz ochrona uczciwości dla nieudanych scrapów (wykluczone kody statusu nie obciążają budżetu) - Nagłówki kosztów na poziomie odpowiedzi i panel do replay/debug żądań
- Opcjonalny rendering browser i pule proxy residential
Jednostka rozliczeniowa: kredyty, których koszt może się zmieniać w zależności od puli proxy, renderingu i konfiguracji ASP. Nagłówki odpowiedzi, cost_budget i limity projektu pomagają ten koszt mierzyć i kontrolować.
Najlepsze dla: zespołów, które szczególnie priorytetyzują narzędzia antydetekcyjne i chcą widzieć, ile faktycznie kosztowało każde żądanie w kredytach.
9. Zyte
Zyte (dawniej Scrapinghub, dla tych, którzy są w tej branży od czasu, gdy ta nazwa jeszcze funkcjonowała) oferuje API, które może zwracać surowe odpowiedzi HTTP, renderowany przez przeglądarkę HTML, zrzuty ekranu albo automatycznie wyekstrahowane obiekty strukturalne — zależnie od żądania. Ceny przypisywane są do poziomu celu/żądania, a nie do jednej stawki, i — podobnie jak w kilku innych narzędziach tutaj — odpowiedzi nieudane oraz żądania ograniczone przez rate limit nie są naliczane.
Najważniejsze cechy:
- Wiele trybów wyjścia: HTTP, browser, screenshot lub auto-ekstrakcja
- Natywna integracja ze Scrapy dla developerów Pythona już korzystających z tego ekosystemu
- Limity wydatków i progi blokad, które można ustawić z wyprzedzeniem
- Cennik zależny od poziomu celu/żądania, dopasowany do trudności strony
Cennik: dostępny model pay-as-you-go; dokładna stawka zależy od poziomu celu.
Najlepsze dla: zespołów, które potrzebują zarządzanego API HTTP/browser/extraction, zwłaszcza jeśli już używają Scrapy. Dopasowanie do celu i stabilność poziomu muszą zostać potwierdzone pilotażem.
10. Apify
Apify to mniej Proxy API, a bardziej pełna platforma do scrapingu — compute, gotowe „Actors” (ich termin na pakowane scrapery), harmonogramy, magazyn danych i usługi proxy, wszystko spięte z osobnym rozliczaniem każdej pozycji. To zaleta, jeśli chcesz marketplace gotowych scraperów do popularnych serwisów; to komplikacja, jeśli potrzebowałeś po prostu proxy, a dostałeś platformę.
Najważniejsze cechy:
- Marketplace gotowych Actors do popularnych celów scrapingu
- Dostępne proxy residential, datacenter i SERP jako jeden z komponentów
- Harmonogramy, magazyn danych i webhooki do automatyzacji workflow
- Szczegółowe diagnostyczne kody statusu proxy ułatwiające debugowanie nieudanych żądań
Jednostka rozliczeniowa: prepaid platform usage może obejmować osobne opłaty za compute, Actor, proxy, dataset i storage. Modeluj cały workflow, a nie tylko koszt samej linii proxy.
Najlepsze dla: zespołów, które bardziej potrzebują gotowych scraperów i automatyzacji workflow niż surowej kontroli proxy.
Ukryty problem kosztowy: używaj kosztu za poprawny wynik
Cena katalogowa to tylko jeden licznik. Użyteczny mianownik to nie liczba wysłanych żądań, bajtów transferu ani odpowiedzi HTTP 200. To liczba wyników, które spełniają Twój własny walidator semantyczny.
Zdefiniuj metrykę przed pilotem:
cost_per_1,000_valid = total_pilot_cost / valid_results * 1,000
total_pilot_cost powinien obejmować koszty, które rzeczywiście różnią się między kandydatami: jednostki żądań lub ruchu, mnożniki renderingu i premium routing, ponowienia, parsowanie, compute, storage, monitoring i czas operatora. valid_results powinno liczyć tylko odpowiedzi z wymaganymi polami, właściwą lokalizacją, akceptowalną świeżością oraz bez strony challenge lub consent udającej treść.
Rozważmy celowo hipotetyczny przykład. Dostawca A kosztuje 3,00 USD za pakiet testowy i dostarcza 600 poprawnych rekordów; Dostawca B kosztuje 3,50 USD i dostarcza 950. Ich znormalizowane koszty to 5,00 USD i około 3,68 USD za 1 000 poprawnych rekordów. Te liczby pokazują tylko arytmetykę. Nie są twierdzeniem o żadnym konkretnym dostawcy, klasie celu ani systemie zabezpieczeń.
W przypadku API ekstrakcyjnego, takiego jak Thunderbit, uwzględnij wartość i koszt otrzymania danych w schemacie zamiast surowego HTML. W przypadku surowego proxy uwzględnij pracę parsera i utrzymania po stronie downstream. Żadna z tych granic nie jest zawsze tańsza; odpowiedź zależy od tego, jakiego wyjścia faktycznie potrzebuje workload.
Jeśli chcesz lepiej zrozumieć, jak ekstrakcja oparta na AI radzi sobie z tym inaczej niż scraping oparty na selektorach, nasze omówienie AI web scraping wyjaśnia podejście krok po kroku.
Proxy API vs. AI Scraping API: czy w ogóle potrzebujesz proxy?
Każdy artykuł na pierwszej stronie wyników w tym temacie zakłada, że czytelnik potrzebuje proxy. Żaden nie kwestionuje tej przesłanki — co jest dziwne, biorąc pod uwagę, że wiele osób pyta dziś o coś bardziej podstawowego: czy w ogóle potrzebuję surowego HTML, czy po prostu danych?
| Wymiar | Tradycyjne Proxy API | AI Scraping API (np. Thunderbit) |
|---|---|---|
| Co otrzymujesz | Surowy HTML, który sam parsujesz | Ustrukturyzowany JSON zgodny z Twoim schematem |
| Zachowanie zarządzanego dostępu | Kontrolowane przez Twój stos proxy/klient albo osobny produkt zarządzany | Część usługi ekstrakcyjnej i podlega jej udokumentowanym limitom |
| Parsowanie/ekstrakcja | Budujesz i utrzymujesz parsery | AI wyciąga pola według schematu |
| Utrzymanie przy zmianie layoutu | Twój zespół odpowiada za zmiany selektorów i parserów | Usługa przejmuje więcej logiki ekstrakcji, ale Twój zespół nadal waliduje wynik |
| Najlepsze do | Masowej archiwizacji HTML, własnych pipeline’ów, niszowych protokołów | Danych strukturalnych, ingestion do RAG, list leadów |
| Granica integracji | Endpoint proxy lub API dostawcy | Endpointy HTTP do ekstrakcji, takie jak Distill, Extract i Batch |
Uczciwy wniosek: jeśli Twój pipeline naprawdę potrzebuje surowego HTML, kontroli sesji na poziomie proxy albo własnego stosu żądań, tradycyjne Proxy API może być właściwą granicą. Jeśli wynikiem mają być ustrukturyzowane dane produktowe, rekordy leadów albo wyniki wyszukiwania gotowe do arkusza kalkulacyjnego czy pipeline’u retrieval, API ekstrakcyjne może przenieść routing, rendering i ekstrakcję za jedną granicę usługi. To zmienia sposób myślenia o decyzji, ale nie dowodzi, że którykolwiek model jest uniwersalnie lepszy.
Dla zespołów szukających leadów lub rekordów strukturalnych zamiast surowych stron, przewodniki AI lead generation i AI for sales pokazują typ workflow, w którym naturalnym wyjściem są gotowe wiersze danych.
Sprawdź, czy w ogóle potrzebujesz proxy Darmowy plan obejmuje 6 stron miesięcznie — przetestuj, czy wbudowany rendering Thunderbit poradzi sobie z Twoją stroną docelową, zanim kupisz pojemność proxy. Get Started Free
Kwestie zgodności i sourcingu powinny wejść do oceny
Dostęp techniczny i autoryzacja to dwie różne rzeczy. Przed pilotem udokumentuj, które URL-e organizacja może zbierać, jakie pola są potrzebne, zasady retencji, obowiązki prywatności, obowiązujące warunki celu oraz osobę odpowiedzialną za eskalację. Subskrypcja proxy nie rozszerza tych uprawnień.
W przypadku sieci residential poproś dostawcę o aktualną dokumentację sourcingu i zgód, zasady kwalifikacji celu, wymagania tożsamościowe lub KYC, dowody audytowe oraz proces reakcji, gdy dany zakres IP lub cel staje się niedostępny. Oficjalne oświadczenia dostawcy są użytecznym dowodem, ale nie zastępują niezależnego audytu łańcucha dostaw.
W trakcie pilota zapisuj obserwacje dotyczące regionu i ASN, jeśli są istotne, ale nie wyciągaj wniosku, że pojedynczy lookup dowodzi sourcingu całej sieci. Traktuj rozbieżności jako pytania do dostawcy i zespołu zakupowego. Jeśli zmieni się autoryzacja, nie przejdzie kontrola polityki, zostanie osiągnięty limit ponowień albo zadziała cap budżetowy, zatrzymaj test.
W przypadku usług ekstrakcyjnych i platform odpowiedzialność za sourcing i dostęp nie znika; tylko przenosi się za inną granicę usługi. Kupujący nadal powinien przejrzeć umowy, polityki dozwolonego użycia, zachowanie przy błędach i sposób przetwarzania danych. Ten poradnik ma charakter techniczny i nie stanowi porady prawnej.
Porównanie na pierwszy rzut oka
| Narzędzie | Granica produktu | Typowy wynik | Jednostka rozliczeniowa do weryfikacji | Pytanie do pilota |
|---|---|---|---|---|
| Thunderbit | API ekstrakcyjne | Markdown lub JSON zgodny ze schematem | Jednostki na stronę | Czy wymagane pola pozostają poprawne na różnych szablonach celu? |
| Bright Data | Rodziny surowych proxy plus zarządzany Unlocker | Połączenie, surowa treść lub wynik zarządzany | Ruch lub udane żądania, zależnie od produktu | Jakiego dokładnie produktu i jakich kontroli geo potrzebuje workload? |
| Oxylabs | Rodziny proxy plus Web Unblocker i API scraperów | Połączenie lub zarządzana treść | Zależnie od produktu; pobrana strona Unlocker była rozliczana w GB | Jak rozmiar odpowiedzi i ciągłość sesji wpływają na koszt? |
| ScrapingBee | Zarządzane HTML API | HTML | Kredyty zależne od funkcji | Która konfiguracja działa i ile kosztuje poprawna strona? |
| ZenRows | Scraper API, browser i residential proxies | Wiele formatów opisanych przez dostawcę | Żądania z mnożnikami funkcji | Jak semantyka rozliczania 404/410 wpływa na Twój walidator? |
| Scrape.do | Zarządzane Web Scraping API | Treść strony | Successful API credits | Czy premium, geo, sesja i kontrolki browser pasują do workloadu? |
| Decodo | Rodzina produktów proxy i scrapingowych | Połączenie lub wynik zależny od produktu | GB lub PAYG na pobranej stronie residential | Czy kontrolki lokalizacji, ASN, protokołu i sticky session są wystarczająco dokładne? |
| Scrapfly | Zarządzane API do scrapingu | Treść strony, wynik browser, opcjonalna ekstrakcja | Kredyty zależne od funkcji | Czy budżety kosztów, logi i ochrona przed błędami działają zgodnie z oczekiwaniami? |
| Zyte | Zarządzane interfejsy HTTP, browser, extraction i Scrapy | HTTP, renderowany HTML, zrzuty ekranu lub obiekty | Poziom celu/żądania plus opcje | Czy poziom jest stabilny i czy limity trybów żądań pasują do implementacji? |
| Apify | Platforma scrapingu i marketplace plus proxy | Dane z Actors lub crawlerów | Opłaty za compute, Actor, proxy, storage i dataset | Czy korzyść z workflow uzasadnia pełny koszt platformy? |
Kategorie i jednostki rozliczeniowe powyżej odzwierciedlają oficjalne strony pobrane 10 sierpnia 2026 r. Plany, limity, nazwy i mnożniki funkcji mogą się zmieniać, więc przed planowaniem budżetu sprawdź dokładny produkt.
Schemat decyzyjny: co właściwie scrapujesz?
Najczęstsze pytanie w wątkach o proxy brzmi mniej więcej tak: „Nie wiem, które jest najlepsze, ktoś ma rekomendację?” — po czym pada ogólna lista, która tak naprawdę nie odpowiada na pytanie. Oto próba pokazania czegoś bliższego realnej ścieżce decyzji.
Jakiego wyjścia potrzebujesz?
- Potrzebujesz kontroli nad protokołem proxy, surowych odpowiedzi, własnych nagłówków albo własnego parsera? Zawęź wybór do produktów raw proxy.
- Potrzebujesz renderowanego HTML bez samodzielnego utrzymywania przeglądarki i warstwy retry? Zawęź wybór do zarządzanych API do scrapingu lub browser API.
- Potrzebujesz zweryfikowanych pól, rekordów albo Markdown? Zawęź wybór do API ekstrakcyjnych, w tym udokumentowanych endpointów Distill i Extract w Thunderbit.
- Potrzebujesz harmonogramów, storage, zadań marketplace i operacji zespołowych? Zawęź wybór do platform do scrapingu.
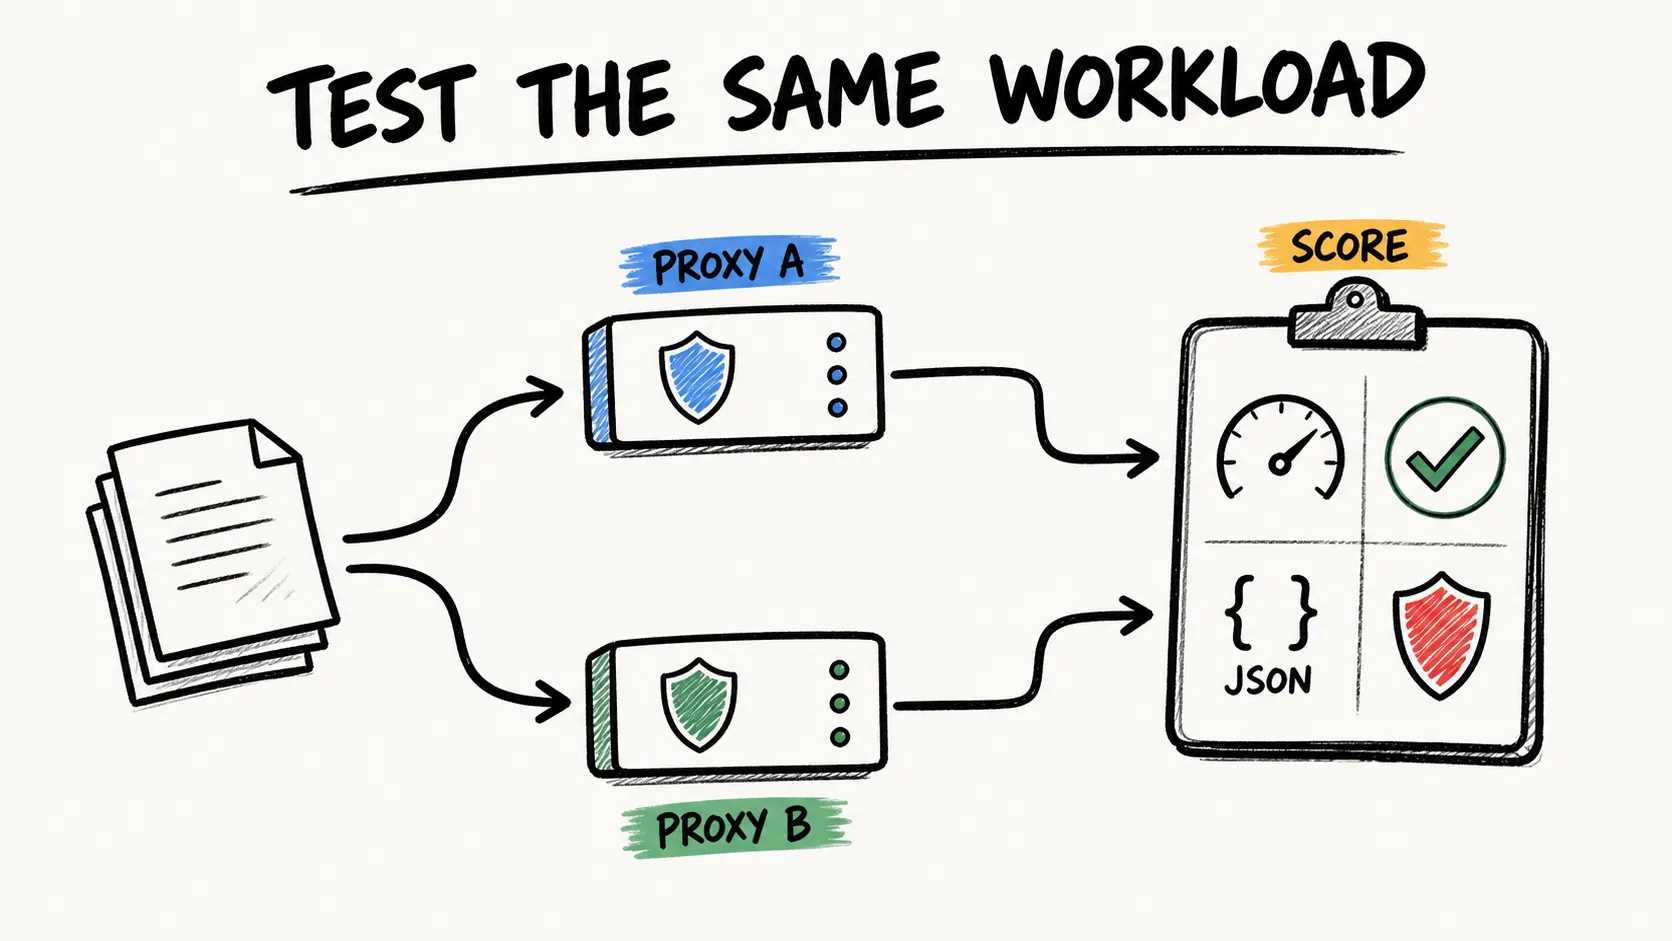
Jakie kontrolki są niepodlegające negocjacji? Zapisz wymagane regiony, czas trwania sesji, zachowanie rotacji, metody żądań, cookies, nagłówki, rendering, zrzuty ekranu, kształt danych, współbieżność, logi i limity wydatków. Usuń kandydatów, którzy nie spełniają twardego wymogu, zanim zaczniesz testować preferencje miękkie.
O jakiej skali mówimy? Nie używaj ogólnego progu liczby stron, aby wybrać dostawcę. Skala wpływa na rozmiar odpowiedzi, współbieżność, mnożniki funkcji, wskaźnik poprawnych wyników, negocjowane zobowiązania i nakład pracy inżynierskiej. Zmodeluj oczekiwany miks szablonów celu i uruchom pilota przy reprezentatywnej współbieżności.
Surowy HTML czy dane strukturalne? To nadal główny punkt rozgałęzienia. Jeśli potrzebujesz surowego HTML do własnego pipeline’u, testuj produkty proxy lub zarządzane HTML. Jeśli wynikiem mają być zweryfikowane wiersze, JSON albo Markdown, testuj granicę ekstrakcyjną jako osobną kategorię zamiast wymuszać porównanie proxy „jeden do jednego”.
Zbuduj własną ważoną kartę oceny
Same listy funkcji nie rozstrzygają decyzji, bo wydajność i koszt zależą od zestawu celów i konfiguracji. Zbuduj kartę oceny na podstawie własnych wymagań i wyników pilota. Poniższe wagi są celowo puste.
| Kryterium | Twoja waga | Ocena dostawcy A (1–5) | Dowód | Ocena dostawcy B (1–5) | Dowód |
|---|---|---|---|---|---|
| Wskaźnik poprawnych wyników | |||||
| Koszt za poprawny wynik | |||||
| Dopasowanie formatu wyjścia | |||||
| Kontrola geo/sesji/żądań | |||||
| Obserwowalność i kontrola budżetu | |||||
| Dowody zgodności i sourcingu | |||||
| Dopasowanie wsparcia i operacji | |||||
| Nakład pracy inżynierskiej i utrzymaniowej | |||||
| Razem | 100 |
Używaj skali 1–5 tylko wtedy, gdy istnieją dowody. Traktuj „nie dotyczy” inaczej niż zero. Opublikuj wagi obok wyniku, aby współpracownicy widzieli, które założenia wpłynęły na rezultat.
Poniższy krótki przykład w Pythonie zamyka się bezpiecznie na brakujących lub nieprawidłowych danych wejściowych. Minimalna liczba 30 prób to tutaj tylko osłona dydaktyczna, a nie uniwersalna teza o wielkości próby statystycznej:
from dataclasses import dataclass

@dataclass(frozen=True)
class PilotResult:
    attempts: int
    valid_results: int
    request_cost: float
    engineering_cost: float = 0.0

    def cost_per_1000_valid(self) -> float:
        if self.attempts < 30:
            raise ValueError("pilot needs at least 30 attempts for this tutorial")
        if not 0 < self.valid_results <= self.attempts:
            raise ValueError("valid_results must be between 1 and attempts")
        if self.request_cost < 0 or self.engineering_cost < 0:
            raise ValueError("costs cannot be negative")
        total = self.request_cost + self.engineering_cost
        return total / self.valid_results * 1000

def weighted_score(weights: dict[str, float], scores: dict[str, float]) -> float:
    if set(weights) != set(scores):
        raise ValueError("every weighted criterion needs a score")
    if abs(sum(weights.values()) - 100.0) > 1e-9:
        raise ValueError("weights must sum to 100")
    if any(not 1 <= score <= 5 for score in scores.values()):
        raise ValueError("scores must be in the 1–5 range")
    return sum(weights[name] * scores[name] for name in weights) / 100
Uruchom co najmniej dwie rundy w różnych momentach przy stałych warunkach. Dla każdej próby zapisuj grupę celu, region, konfigurację, status, wynik walidatora semantycznego, opóźnienie, ponowienia, naliczone jednostki, bajty, request lub job ID oraz powód niepoprawności. Większe zakupy wymagają próby dopasowanej do ryzyka i różnorodności celów zespołu; dydaktyczne minimum nie zastąpi takiego projektu.
Jeśli dopiero zaczynasz przygodę ze scrapingiem i chcesz najpierw poznać podstawy, zanim wejdziesz w porównania dostawców, nasze wprowadzenie do czym właściwie jest web scraping oraz poradnik o web scraping bez kodowania będą dobrym startem.
Wybór Proxy API nie jest tak naprawdę pytaniem „który dostawca jest najlepszy” — to pytanie „która granica produktu pasuje do mojego wymaganego wyniku”, a potem pilota, który potwierdzi, że deklaracje marketingowe dostawcy wytrzymują próbę na Twoich rzeczywistych celach. Dziesięciu dostawców, cztery kategorie produktów i jeden wzór (koszt za poprawny wynik) prowadzą Cię już bardzo daleko. Ostatni kilometr to po prostu wykonanie testu samodzielnie, zamiast polegania na cudzym benchmarku.
Jeśli Twoim realnym celem są dane strukturalne, a nie stos HTML do parsowania, możesz uwzględnić w shortlistcie rozszerzenie Chrome Thunderbit albo API i sprawdzić aktualne limity triala lub planu przed uruchomieniem pilota. Kanał Thunderbit na YouTube również pokazuje walkthrough produktów; traktuj je jako demonstracje, a nie niezależny dowód benchmarkowy.
Wypróbuj agentowego web scrapera Thunderbit Get Started Free
Dowiedz się więcej
- Czym jest web scraping
- AI web scraping
- Web scraping bez kodowania
- Alternatywy dla Instant Data Scraper
- Scraping LinkedIn
FAQ
1. Jaka jest prawdziwa różnica między siecią proxy a API do scrapingu?
Surowa sieć proxy daje Ci adres IP i kontrolę nad routingiem — dalej sam odpowiadasz za rendering, ponawianie prób i parsowanie. API do scrapingu (zarządzane lub oparte na AI) przejmuje większą część tego cyklu i zwraca HTML, JSON albo Markdown w zależności od produktu. To nie są zamienne rozwiązania, a bezpośrednie porównywanie ich cen zwykle prowadzi do mylącego wniosku.
2. Jak mierzyć „success rate” w sposób, który naprawdę ma znaczenie?
Nie licz HTTP 200 jako sukcesu. Zdefiniuj sukces jako „treść lub pola, których faktycznie potrzebowałem, były obecne i poprawne”, a potem testuj na reprezentatywnej próbce prawdziwych celów — nie na demo-site dostawcy.
3. Jak obliczyć koszt za udane żądanie?
Podziel podaną cenę (za żądanie lub za GB) przez zmierzony wskaźnik sukcesu na Twoich konkretnych celach. Tańszy dostawca z niższym success rate może bardzo łatwo okazać się droższy po uwzględnieniu ponowień — policz to, zanim wybierzesz plan.
4. Czy potrzebuję Proxy API, jeśli chcę tylko dane strukturalne, a nie surowy HTML?
Niekoniecznie. API ekstrakcyjne, takie jak Thunderbit, mogą zwrócić ustrukturyzowany JSON i przenieść rendering oraz routing za granicę usługi, co może wyeliminować potrzebę kupowania osobnego surowego proxy do tego workflow. Testuj obsługę celu i poprawność pól. Tradycyjny produkt proxy pozostaje właściwą kategorią wtedy, gdy potrzebujesz surowych odpowiedzi albo kontroli na poziomie proxy.
5. O co powinienem zapytać dostawcę o sourcing IP przed rejestracją?
Poproś o aktualną dokumentację zgód i sourcingu IP residential, polityki dozwolonego użycia, dowody zgodności, audytowalność oraz proces reakcji, gdy subnet lub cel staje się niedostępny. Oświadczenia pierwszej strony powinny być przejrzane przez dział zakupów lub prawników, jeśli skala ryzyka tego wymaga; nie są niezależnym audytem łańcucha dostaw.




